ملاحظة المؤلف: نقارن Qwen4-Max وKimi K3.1 Pro عبر خمسة أبعاد: انفتاح الأوزان، ومهام الطرفية، وتسليم المهام الطويلة، والرؤية والفيديو، وتكلفة كل مليون token، ثم نشرح سبب عدم تطابق درجات Terminal-Bench الرسمية بين الشركتين.
الخلاصة أولاً: إذا كنت تحتاج إلى الحصول على الأوزان للضبط الدقيق أو التكميم أو النشر الخاص، فاختر Kimi K3.1 Pro. وإذا كنت تحتاج إلى API مستضاف، وتهتم في الوقت نفسه بالرؤية والفيديو وتسليم المهام الطويلة، وتريد خفض تكلفة كل مليون token إلى أدنى مستوى، فاختر Qwen4-Max. أما إذا كان الحمل الأساسي لديك هو وكيل سطر أوامر داخل الطرفية، فتفوق Kimi K3.1 Pro واضح حالياً.
هذا ليس تحليلاً وسطاً من نوع «لكل منهما مزاياه». كل الأرقام أدناه مذكورة المصدر: أرقام Qwen مأخوذة من مدونة Alibaba الرسمية ومن المقارنة التي نشرتها الشركة نفسها على الرسم نفسه، وأرقام Kimi من وثائق Moonshot الرسمية، وبيانات الطرف الثالث من لقطة عامة للوحة arena (2026-11-14). وسنشرح في قسم منفصل سبب عدم تطابق درجات المعيار نفسه التي تعلنها الشركتان.
القيمة الأساسية: بعد قراءة هذا المقال، ستحصل على خط فاصل واضح لاختيار النموذج، وستعرف كيف تحوّل ميزتي «أرخص» و«يمكن الحصول على الأوزان» إلى مهامك الخاصة.
الفروقات الجوهرية بين Qwen4-Max وKimi K3.1 Pro
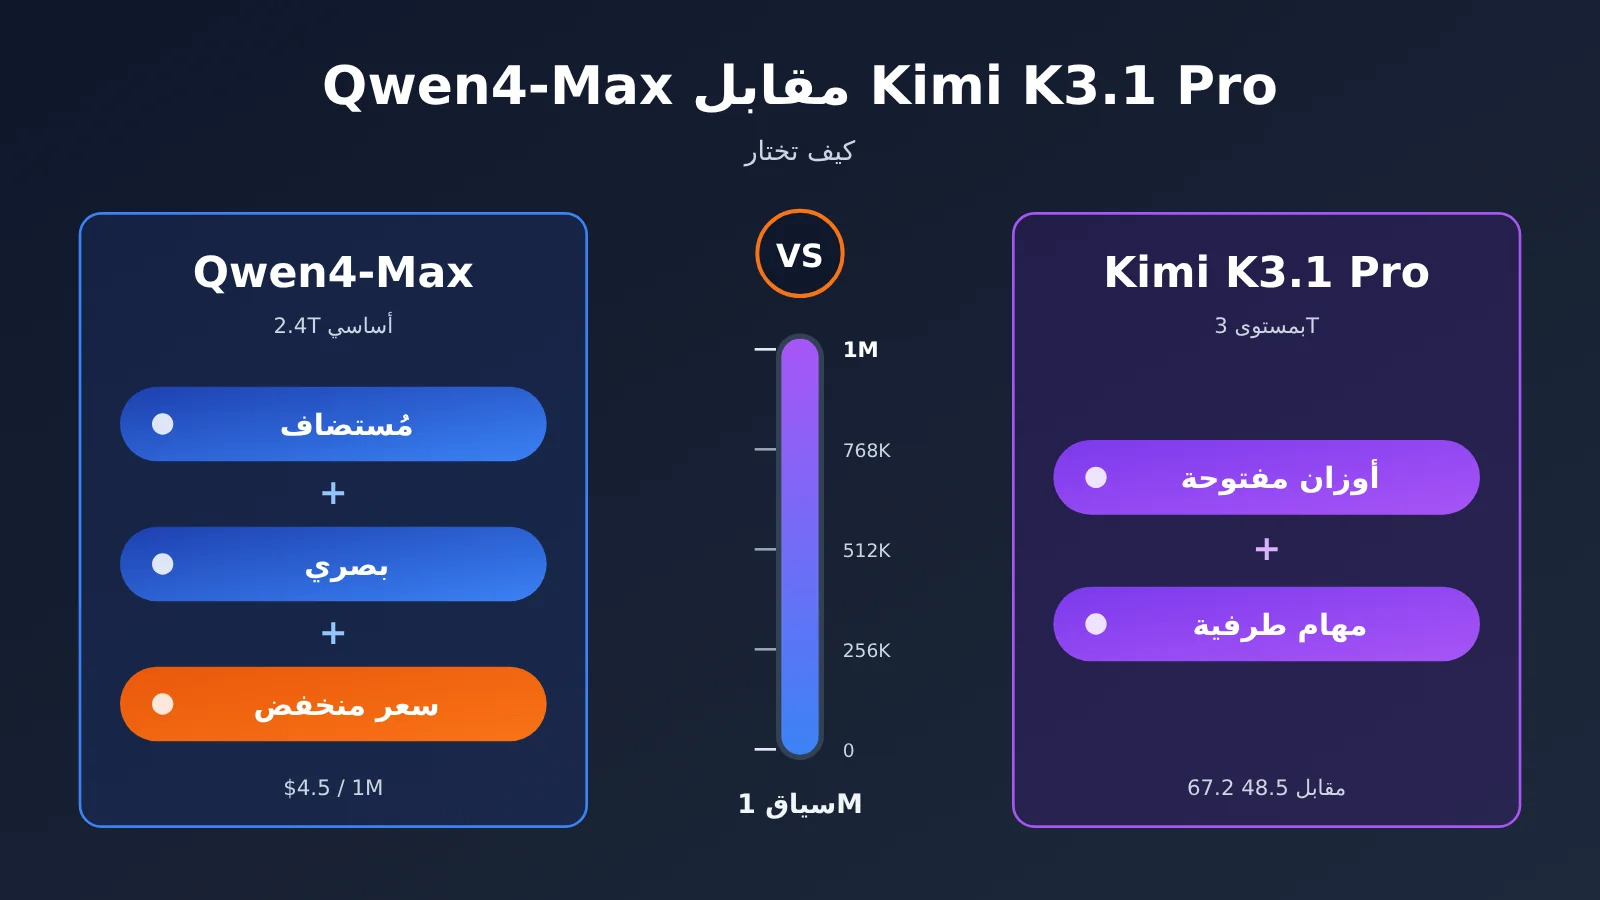
كلا النموذجين طرازان رائدان محليان من النصف الثاني لعام 2026، ونافذة السياق لديهما عند مستوى 1M، والمعاملات الظاهرة متقاربة، لكن التموضع مختلف كثيرًا. يعتمد Qwen4-Max على عمود فقري بحجم 2.4T و71B من المعاملات النشطة، إضافة إلى 328B من N-gram Embedding، ويدعم الرؤية أصلًا، وأقصى إخراج 393K، وأقصى سلسلة تفكير 262K، وقيمة reasoning_effort الافتراضية هي high. أما Kimi K3.1 Pro فهو أول نموذج في سلسلة K3.1، وينتمي إلى فئة 3T، وتصفه الجهة الرسمية بأنه أقوى نموذج مفتوح الأوزان في فئة 3T، مع نافذة سياق تبلغ 1,048,576 token.
| بُعد المقارنة | Qwen4-Max | Kimi K3.1 Pro | التفضيل |
|---|---|---|---|
| الحجم | عمود فقري 2.4T / 71B نشطة + 328B N-gram Embedding | فئة 3T | — |
| الأوزان | المصادر العامة تذكر فقط واجهة API المستضافة عبر QwenCloud | أوزان مفتوحة | Kimi |
| السياق | 1M، أقصى إخراج 393K | 1,048,576 token | متعادل |
| مهام الطرفية (الرسم البياني نفسه لدى علي بابا) | 48.5 | 67.2 | Kimi |
| المهام الطويلة والتسليم القطاعي | متقدم في عدة بنود | AutomationBench أعلى قليلًا | Qwen4 |
| الرؤية والفيديو | رؤية أصلية، ومؤشرات المخططات والفيديو متقدمة | المؤشرات متأخرة | Qwen4 |
| سعر كل 1M من الإخراج | $4.5 | $10 | Qwen4 |
بجملة واحدة: تكمن ميزة Kimi في «قابلية التعديل» و«تشغيل مهام الطرفية»، بينما تكمن ميزة Qwen4 في «اتساع نطاق التسليم» و«التكلفة المنخفضة». وفيما يلي تفصيل على خمسة أبعاد.
هل يمكن تعديل أوزان Kimi K3.1 Pro وQwen4-Max؟
هذا هو الخط الفاصل الأكثر وضوحًا بين الاثنين. فـ Kimi K3.1 Pro نموذج مفتوح الأوزان، ما يعني أن الفرق يمكنها نقله إلى عنقودها الحاسوبي لإجراء ضبط دقيق في مجالها، أو ضغط بالتكميم، أو تقطير، أو حتى نشره دون اتصال في بيئات ذات متطلبات امتثال صارمة. وبالنسبة للفرق التي تحتاج إلى “تعديل النموذج نفسه”، لا يوجد بديل عن هذه الميزة؛ فلا يمكن تعويضها بأعلى الدرجات في الاختبارات المعيارية.
أما Qwen4-Max، فتشير المعلومات المتاحة عنه حتى الآن إلى أنه يُقدَّم فقط عبر QwenCloud على شكل API مُدار، ولا تذكر المواد المرجعية وجود أوزان مفتوحة. ميزة النموذج المُدار أنه يعفيك من إدارة بطاقات الرسوميات وإطار الاستدلال والتوسع والتقلص؛ أما عيبه أنه لا يتيح لك التكييف مع عملك إلا عبر الموجهات والسياق واستدعاء الأدوات. وتجدر الإشارة إلى أن الأوزان المفتوحة بحد ذاتها لا تعني تلقائيًا مزيدًا من الأمان؛ فالأمان يظل معتمدًا على طريقة النشر وضوابط الوصول وعمليات التدقيق لديك.
طريقة التقييم: إذا كنت ستكتفي بـ”استدعاء النموذج”، فقيمة الأوزان المفتوحة بالنسبة لك تكاد تكون صفرًا. وإذا كنت تحتاج صراحةً إلى الضبط الدقيق أو النشر الخاص، فإن Kimi هو الخيار الوحيد في هذه المقارنة، وتُستخدم الأبعاد التالية فقط لتقييم ما إذا كان “كافيًا” أم لا.
Qwen4-Max أم Kimi K3.1 Pro: من الأقوى في مهام سطر الأوامر؟
تشير مهام سطر الأوامر إلى قدرة النموذج على قراءة الملفات وكتابتها، وتنفيذ الأوامر، والتحسين التكراري للإصلاحات بناءً على رسائل الخطأ داخل بيئة سطر الأوامر. وهي السيناريو الأقرب إلى العمل الواقعي بالنسبة إلى وكيل البرمجة. في هذا البند، يتفوق Kimi K3.1 Pro بوضوح: فوفق المقارنة التي نشرتها Alibaba على الرسم البياني نفسه، حصل Qwen4-Max على 48.5 في Terminal-Bench 4.0، بينما حصل Kimi K3.1 على 67.2، بفارق 18.7 نقطة، وهو أكبر تراجع يسجله Qwen4 في الرسم البياني بأكمله.
لماذا تختلف نتائج Terminal-Bench بين المصدرين؟
هناك تفصيل يسهل تفويته: النموذج نفسه، Kimi K3.1 Pro، يحصل على درجات مختلفة في Terminal-Bench 4.0 بين المواد الرسمية للطرفين.
| المصدر | Kimi K3.1 Pro | مراجع أخرى |
|---|---|---|
| وثائق Moonshot الرسمية | 65.7% | Claude Opus 5.5 بنسبة 66.4%، وGPT-6 Astra بنسبة 58.2% |
| مقارنة Alibaba الرسمية على الرسم البياني نفسه | 67.2 | Qwen4-Max بنسبة 48.5 |
كتبت Kimi في موادها الخاصة 65.7%، بينما وضعت Alibaba في رسمها البياني 67.2 أمام Kimi، بفارق 1.5 نقطة. يأتي هذا الفرق من اختلاف harness التقييم (إطار الوكيل، وتعريفات الأدوات، وسياسات المهلة وإعادة المحاولة)، وإعداد reasoning effort، وإصدار مجموعة الأسئلة. ولا يمكن تفسيره على أنه تزوير من أي طرف، ولا يجوز دمج الرقمين في رقم واحد باسم «نتيجة Kimi في مهام سطر الأوامر» عند الاستشهاد. وبالمثل، فإن Claude Opus 5.5 الذي يظهر بنسبة 66.4% في وثائق Moonshot سيكون له رقم آخر عند وضعه ضمن إطار التقييم الخاص بـ Alibaba، لذلك فإن ترتيب النماذج عبر دمج أرقام من وثائق مختلفة غير صالح.
القراءة الصحيحة هي: قارن المواضع النسبية فقط داخل الرسم البياني نفسه وضمن harness واحد. فوفق رواية Moonshot، يأتي Kimi أقل قليلًا من Opus 5.5 وأعلى بوضوح من GPT-6 Astra؛ ووفق رواية Alibaba، يتقدم Kimi على Qwen4-Max بفارق كبير. الاستنتاجان صحيحان، واتجاههما واحد أيضًا، وهو أن قدرات Kimi K3.1 Pro في سطر الأوامر ضمن الصف الأول.
🎯 توصية تقنية: درجات المعايير تتقلب بحسب harness وإعداد effort، وأكثر الطرق موثوقية هي تشغيل جولة لكل نموذج باستخدام إطار الوكيل الخاص بك ومهام حقيقية. ومن خلال APIYI apiyi.com يمكنك استخدام مفتاح API نفسه لاستدعاء
kimi-k3.1-proوغيره من النماذج، مع إبقاء الإطار ثابتًا وتغيير معاملmodelفقط؛ وعندها تكون المقارنة ذات معنى.
هناك بند آخر مرتبط هو بقية مؤشرات مهام البرمجة. ففي الرسم البياني نفسه لدى Alibaba، يتعادل النموذجان تقريبًا في DeepSWE v1.1 (75.7 مقابل 75.5)، وعلى ProgramBench يتقدم Qwen4-Max بـ6.5 نقاط (31.5 مقابل 25.0). كما توثّق وثائق Moonshot الرسمية أن Kimi Code Bench 3.0 Long-horizon سجل 61.2%، بتحسن واضح عن الجيل السابق K3 الذي سجل 55.95%. لذلك فإن الصياغة الدقيقة هي: يتفوق Kimi في التفاعل عبر سطر الأوامر، بينما لا يتراجع Qwen4 في بعض مهام البرمجة غير المعتمدة على سطر الأوامر.
Qwen4-Max و Kimi K3.1 Pro: المهام الطويلة والتسليم في القطاعات الصناعية
إذا كان الوكيل الذي تديره مسؤولًا عن «تسليم عمل كامل» — مثل إعداد تقرير، أو إتمام سير عمل تجاري، أو معالجة مسائل في مجال متخصص — فإن Qwen4-Max يقدم أداءً أفضل في المقارنة ذاتها التي أوردتها Alibaba. ويسرد الجدول أدناه مقتطفات من المؤشرات المتعلقة بالمهام الطويلة وسيناريوهات القطاعات، وفق المقارنة التي أعلنتها Qwen بنفسها.
| المعيار (وفق المقارنة التي أعلنتها Qwen بنفسها) | Qwen4-Max | Kimi K3.1 | الفرق |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 أعلى بـ 7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 أعلى بـ 6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 أعلى بـ 9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 أعلى بـ 12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 أعلى بـ 3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi أعلى بـ 0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 أعلى بـ 4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 أعلى بـ 2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | متقاربان تقريبًا |
النمط في هذه البيانات واضح: يتقدم Qwen4-Max في معظم المهام المهنية وتسليم الوكلاء والمجالات الحيوية والطبية، بفارق يتراوح بين 3 و10 نقاط؛ ولا يتفوق Kimi إلا على AutomationBench-AA بفارق ضئيل قدره 0.8 نقطة، بينما يكاد HLE يتساوى فيه الاثنان. وتجدر الإشارة إلى أن هذه البيانات مأخوذة من إطار تقييم تابع لـ Alibaba، وقد تختلف أرقام Kimi عند استخدام إطار الاختبار الخاص بها.
كما أن الحد الأقصى للإخراج لدى Qwen4-Max البالغ 393K، والحد الأقصى لسلسلة التفكير البالغ 262K، عمليان أيضًا للمهام الطويلة. وهذا يعني أنه يمكن في استدعاء واحد توليد تقرير طويل أو ملف شفرة برمجية طويل، دون الحاجة إلى تقسيمه وإعادة تجميعه بشكل متكرر، ما يقلل مواضع الخطأ في تنسيق الوكلاء.
قدرات الرؤية والفيديو لدى Qwen4-Max وKimi K3.1 Pro
يدعم Qwen4-Max الإدخال البصري أصلاً، ويتجلى ذلك أيضًا في مخطط المقارنة نفسه لدى Alibaba: في معيار فهم المخططات Chartography سجّل Qwen4 نتيجة 54.2 مقابل 50.0 لـKimi، وفي معيار فهم الفيديو Video-Index سجّل Qwen4 نتيجة 68.1 مقابل 63.2 لـKimi، متقدمًا بـ4.2 و4.9 نقطة على الترتيب.
بالنسبة للأعمال التي تحتاج إلى قراءة لقطات الشاشة، وتحليل مخططات التقارير، وفهم تسجيلات الشاشة للمنتجات، أو تحليل محتوى الفيديو، يُعد Qwen4-Max الخيار الأقل عناءً. ورغم أن Kimi حقق نتائج في هذين المجالين أيضًا، فإن الفجوة ستتضخم مع توسع النطاق إذا كانت الرؤية هي الحمل الأساسي.
أما توليد الواجهات الأمامية فيمكن الرجوع فيه إلى بيانات طرف ثالث. في لقطة لوحة arena العامة (2026-11-14) ضمن Code Arena WebDev، حصل Qwen4-Max (xHigh) على 1750 نقطة واحتل المرتبة السادسة، لكنه ما يزال موسومًا بـ Preliminary بعدد أصوات 1,814؛ بينما حصل Kimi K3.1 Pro (Max) على 1686 نقطة واحتل المرتبة 13 بعدد أصوات 5,215، ولم يعد موسومًا بـ preliminary. نتيجة Qwen4 أعلى، لكن العينة أقل، وقد تظل المرتبة متقلبة لاحقًا.
كيف تُحسب تكلفة Qwen4-Max مقارنةً بـ Kimi K3.1 Pro؟
الأسعار الرسمية المعلنة (لكل مليون توكن، بتاريخ 2026-11-16)
| بند الفوترة | Qwen4-Max (QwenCloud) | Kimi K3.1 Pro (Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
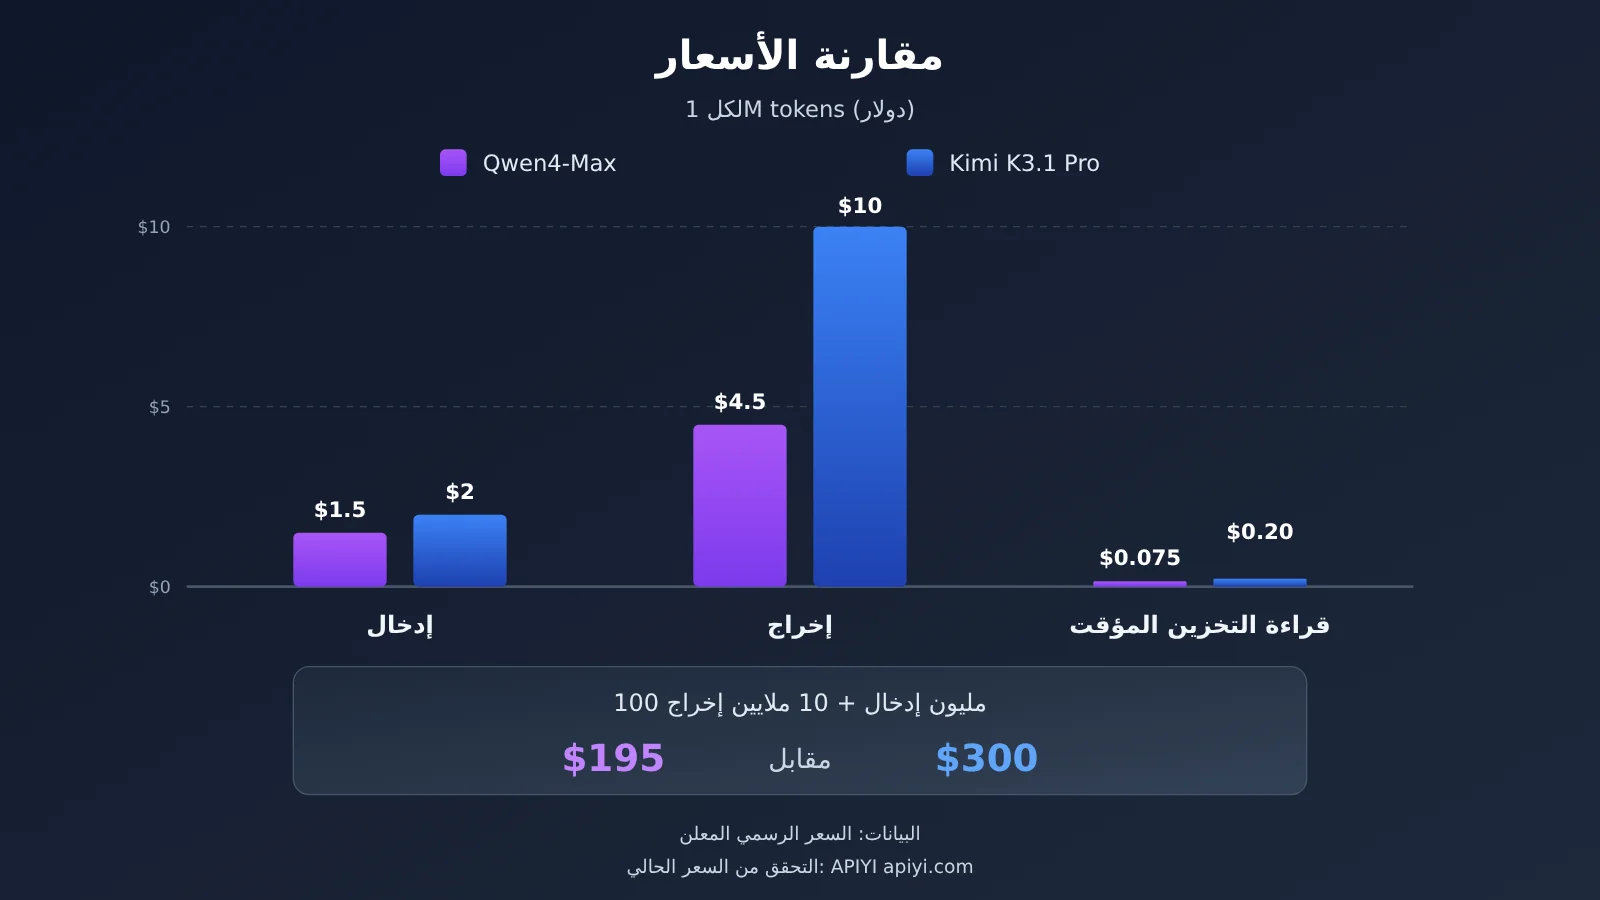
| الإدخال | $1.5 | $2 | $4 |
| الإخراج | $4.5 | $10 | $20 |
| قراءة الذاكرة المؤقتة / إصابة الذاكرة المؤقتة | $0.075 | $0.20 | $0.20 |
| كتابة ذاكرة مؤقتة لمدة 5 دقائق | $1.875 | $2 | — |
| كتابة ذاكرة مؤقتة لمدة ساعة | $3 | $4 | — |
وفقًا للأسعار المعلنة، سعر الإدخال في Qwen4-Max يمثل 75% من سعر Kimi، وسعر الإخراج 45%، أما قراءة الذاكرة المؤقتة فتبلغ 37.5% فقط. وباستخدام حمل نموذجي لعامل ذكي يتكون من «100 مليون توكن إدخال + 10 ملايين توكن إخراج»، يُقدّر أن Qwen4-Max يكلّف نحو $195، بينما يكلّف Kimi K3.1 Pro نحو $300. ولدى Kimi أيضًا وضع Batch بسعر 60% من السعر القياسي، وهو مناسب للمهام الدفعية غير المتصلة. أما نسخة Highspeed فتضاعف السعر مقابل سرعة تزيد بنحو مرتين إلى ثلاث مرات.
رخص التوكن الواحد لا يعني رخص المهمة الواحدة
هذه هي النقطة الأكثر مخالفة للحدس في بُعد التكلفة. تُظهر لقطة arena أن تكلفة المهمة الواحدة في Qwen4-Max (xHigh) تبلغ $4.18، بينما لا تبلغ في Kimi K3.1 Pro (Max) سوى $0.89. سعر التوكن الواحد في Qwen4 أقل، لكن تكلفة المهمة الواحدة أغلى عدة مرات؛ والسبب أن النموذج عند مستوى effort المرتفع يولّد كمية كبيرة من توكنات سلسلة التفكير، فيتجاوز حجم الإخراج Kimi بكثير.
لذا، عند حساب التكلفة الحقيقية، انظر إلى «السعر × استهلاك التوكنات الفعلي». القيمة الافتراضية لـ reasoning_effort في Qwen4-Max هي high؛ وإذا كانت المهمة لا تتطلب استدلالًا عميقًا، فخفّض effort بنفسك كي تتحول ميزة السعر الأقل إلى ميزة في التكلفة الإجمالية.
أسعار APIYI الحالية (2026-11-16)
| معرّف النموذج | الإدخال | الإخراج | قراءة الذاكرة المؤقتة | الحالة |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | متاح |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | متاح |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | متاح |
qwen4-max |
— | — | — | غير متاح بعد، وسنوفّره في أقرب وقت |
الأسعار أعلاه لكل مليون توكن. لا يظهر qwen4-max حاليًا في قائمة الطرازات على APIYI، وسنوفّر هذا النموذج في أقرب وقت؛ وإلى أن يحدث ذلك، يمكنك تجهيز مسار الاستدعاء باستخدام qwen3.8-max أولًا. جميع أسماء الطرازات والأسعار تخضع لقائمة الطرازات على منصة APIYI apiyi.com. وقبل تغيير النموذج، يُفضّل التحقق من الطراز والسعر أولًا، ثم تأكيد بروتوكول الاستدعاء.
كيفية استدعاء Kimi K3.1 Pro وسلسلة Qwen عبر APIYI
توفر APIYI واجهة متوافقة مع OpenAI، ولا يتطلب الاتصال بها سوى ثلاثة تغييرات دون الحاجة إلى استبدال SDK:
- اضبط
base_urlفي العميل علىhttps://api.apiyi.com/v1، بحيث يكون مسار الطلب هو/chat/completions؛ - أدخل مفتاح API الذي حصلت عليه من لوحة تحكم APIYI؛
- اضبط المعامل
modelعلىkimi-k3.1-proأوkimi-k3.1-pro-highspeedأوqwen3.8-max، وبعد إتاحةqwen4-maxيكفي تبديل اسم الطراز مباشرة.
عند إجراء مقارنة A/B، يُنصح بتثبيت الموجه وتعريفات الأدوات ومستوى effort، مع تغيير حقل model فقط، وتسجيل عدد رموز الإدخال والإخراج والتخزين المؤقت في كل استدعاء. بهذه الطريقة يمكنك إعادة إنتاج ظاهرة «تغيّر الدرجات نتيجة تغيّر أداة التقييم (harness)» التي سبق ذكرها، ويمكنك أيضًا حساب التكلفة الحقيقية للمهمة الواحدة لكل من النموذجين في أعمالك.
🚀 بداية سريعة: يحصل المستخدمون الجدد عند التسجيل في APIYI عبر apiyi.com على رصيد تجريبي مجاني. يمكنك استخدام المفتاح نفسه للتبديل بين Kimi وسلسلة Qwen، والتحقق من النتائج بعدد قليل من الطلبات أولاً، ثم تحديد النموذج الأساسي لبيئة الإنتاج.
توصيات الاستخدام لكل من Qwen4-Max وKimi K3.1 Pro
متى تختار Kimi K3.1 Pro
- الاستخدام الخاص والتخصيص الدقيق: عندما تحتاج إلى أوزان مفتوحة للتخصيص في مجال معين، أو الضغط الكمي (quantization)، أو النشر دون اتصال؛
- وكيل برمجي في الطرفية: عندما يكون الحمل الأساسي هو حلقة القراءة والتنفيذ والإصلاح داخل سطر الأوامر؛
- المعالجة الدفعية دون اتصال: عندما يمكنك قبول نتائج غير متزامنة، والاستفادة من خصم Batch بنسبة ٤٠٪ لخفض التكلفة؛
- التفاعل منخفض التأخير: عند الحاجة إلى سرعة، يمكنك اختيار نسخة Highspeed لمقايضة السعر بسرعة أعلى ٢ إلى ٣ مرات.
متى تختار Qwen4-Max
- الاعتماد على الخدمة المستضافة: لا ترغب في صيانة عنقود استدلال، وتحتاج فقط إلى API مستقر؛
- الصور والفيديو: فهم لقطات الشاشة وتحليل الرسوم البيانية وتحليل الفيديو هي المدخلات الأساسية؛
- تسليم المهام الطويلة: توليد التقارير، ووكلاء العمليات التجارية، والأسئلة المتخصصة في المجالات الطبية والبيولوجية وغيرها؛
- الحساسية لتكلفة الـ token: مع ضبط مستوى effort جيدًا، تكون تكلفة كل مليون token هي الأدنى.
نصيحة قرار: Qwen4-Max مقابل Kimi K3.1 Pro
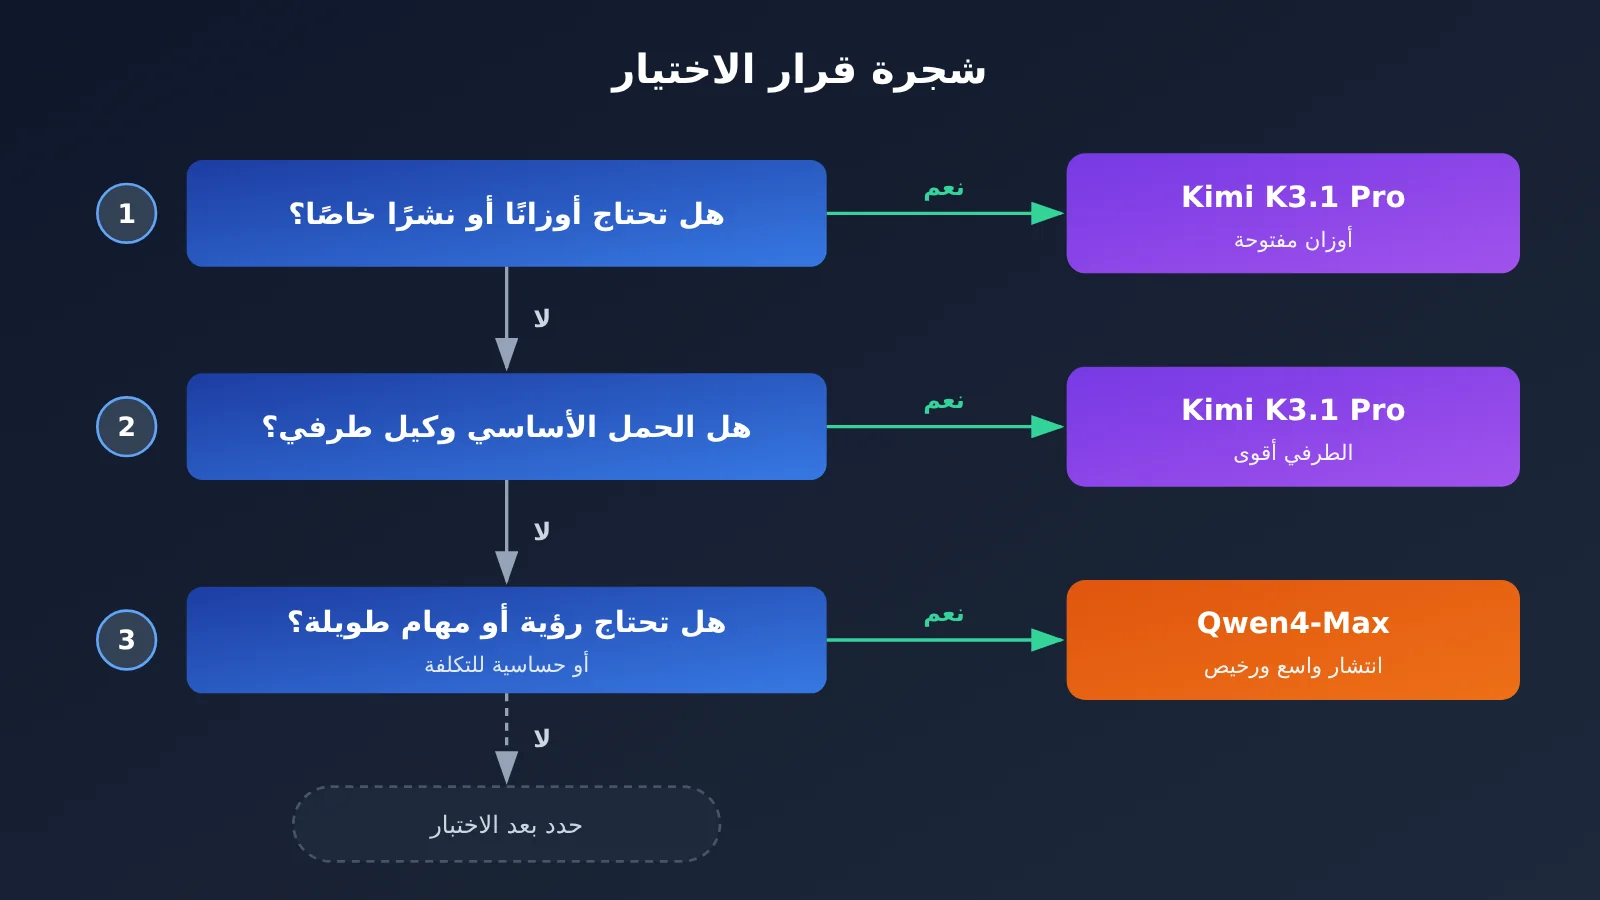
لنختصر الأبعاد الخمسة إلى ثلاثة أسئلة: أولًا، هل يجب أن تحصل على الأوزان؟ إن كانت الإجابة نعم، فاختر Kimi K3.1 Pro مباشرة. ثانيًا، هل الحمل الأساسي هو وكيل سطر أوامر في الطرفية؟ إن كانت الإجابة نعم، فـ Kimi أكثر استقرارًا. ثالثًا، إن لم ينطبق أي مما سبق، فإن Qwen4-Max يتفوق في الرؤية وتسليم المهام الطويلة وسعر الوحدة.
الاستخدام المختلط أيضًا ممارسة شائعة: استخدم Kimi K3.1 Pro للتنفيذ في الطرفية، واستخدم سلسلة Qwen لفهم الصور وتسليم التقارير. هذا التنسيق يتطلب أن يسير النموذجان عبر نفس مجموعة الواجهات، وبوابة موحدة يمكن أن توفر الكثير من أعمال التهيئة.
💡 اقتراح الاختيار: يعتمد الاختيار في النهاية على توزيع مهامك. نوصي بتشغيل جولة مقارنة على APIYI apiyi.com باستخدام مهام حقيقية، وتسجيل معدل النجاح واستهلاك الـ token لدى الجانبين عبر نفس base_url، ثم تحديد النموذج الأساسي.
الأسئلة الشائعة FAQ
س1: ما الفرق الأكبر بين Qwen4-Max وKimi K3.1 Pro؟
Kimi K3.1 Pro نموذج مفتوح الأوزان بمستوى 3T، يمكنك نشره وضبطه الدقيق بنفسك؛ أما Qwen4-Max فيُقدَّم في صورة API مُدارة، ويدعم الرؤية أصلاً، وسعره المعلن أقل. الأول يتفوق في مهام الطرفية (terminal)، والثاني يتفوق في الرؤية وتسليم المهام الطويلة.
س2: ما نتيجة Terminal-Bench لـ Kimi K3.1 Pro بالضبط: 65.7 أم 67.2؟
كلتاهما صحيحة، لكن المعيار مختلف. نسبة 65.7% وردت في وثائق Moonshot الرسمية، و67.2 وردت من التقرير الذاتي لـ Qwen في المقارنة على الرسم البياني نفسه، والفرق ناتج عن أداة الاختبار (harness) ومستوى الجهد (effort) وإصدار مجموعة الأسئلة. عند الاقتباس يجب ذكر المصدر، ولا يجوز الخلط بينهما، ولا تجميع الترتيب من وثائق مختلفة.
س3: هل طول نافذة السياق متساوٍ بينهما؟
متساويان تقريبًا. Kimi K3.1 Pro لديه 1,048,576 token، وQwen4-Max لديه 1M. كما كشف Qwen4-Max إضافيًا عن حد أقصى للمخرجات 393K وحد أقصى لسلسلة التفكير 262K، وهو أنسب للمخرجات الطويلة في مرة واحدة.
س4: لماذا يكون سعر وحدة Qwen4-Max أقل، لكن تكلفة المهمة الواحدة على arena أعلى؟
في لقطة arena، يستخدم Qwen4-Max الإعداد xHigh، ما يستهلك token كثيرًا في سلسلة التفكير، وتبلغ تكلفة المهمة الواحدة $4.18، بينما Kimi K3.1 Pro (Max) تبلغ $0.89. التكلفة الحقيقية = سعر الوحدة × استهلاك token، ولا يمكن الاستفادة من ميزة السعر إلا بخفض `reasoning_effort`.
س5: هل يمكن الآن استدعاء Qwen4-Max عبر APIYI؟
لم يُطرح `qwen4-max` بعد، وسنطرحه في أقرب وقت. حاليًا يمكنك استدعاء `kimi-k3.1-pro` و`kimi-k3.1-pro-highspeed` و`qwen3.8-max` عبر APIYI apiyi.com، وbase_url هو `https://api.apiyi.com/v1`، والموديلات والأسعار وفقًا لقائمة الموديلات على المنصة.
س6: ما أوجه القصور المعروفة في كل من النموذجين؟
يتأخر Qwen4-Max بوضوح في مهام الطرفية (في الرسم البياني نفسه لدى علي: 48.5 مقابل 67.2)، وترتيبه على arena لا يزال Preliminary، وقد يرفع مستوى effort الافتراضي المرتفع تكلفة المهمة الواحدة. أما Kimi K3.1 Pro فسعر مخرجاته أكثر من ضعف Qwen4، ويتأخر في الرؤية والفيديو ومعظم مؤشرات التسليم في المجالات المختلفة.
أهم النقاط في مقارنة Qwen4-Max بـ Kimi K3.1 Pro
- الأوزان هي خط الفصل الحاسم: إذا كنت تريد الضبط الدقيق أو النشر الخاص، فلا خيار أمامك إلا Kimi K3.1 Pro.
- Kimi يتفوق في مهام الطرفية: في مخطط Alibaba نفسه، يتقدم Kimi على Qwen4-Max بـ 18.7 نقطة.
- اقرأ النتائج حسب منهجية القياس: الرقم 65.7 والرقم 67.2 صادران عن harness مختلفين، ولا يمكن استخدامهما معًا.
- Qwen4 يتفوق في التسليم والرؤية: يتقدم في JobBench وAPEX-Agents وVideo-Index وغيرها من الاختبارات.
- سعر Qwen4 أقل: سعر المخرجات يعادل 45% فقط من سعر Kimi، لكن عليك ضبط effort.
- كيف تبدأ: داخل APIYI استخدم نفس المفتاح للتبديل بين
kimi-k3.1-proوسلسلة Qwen لإجراء المقارنة.
الخلاصة
أهم استنتاجات المقارنة بين Qwen4-Max و Kimi K3.1 Pro:
- هل يمكنك تعديل النموذج؟: الأوزان المفتوحة ميزة حصرية لـ Kimi K3.1 Pro؛
- الطرفية والتسليم: Kimi أقوى في agent سطر الأوامر، أما Qwen4-Max فأقوى في تسليم المهام الطويلة والرؤية والفيديو؛
- التكلفة: Qwen4-Max هو الأرخص لكل مليون token، لكن الفاتورة الفعلية تتحدد بما يستهلكه effort من tokens.
درجات الاختبارات المعيارية ترشدك إلى الاتجاه فقط، أما الجواب النهائي فيجب أن تستخلصه من مهامك الخاصة. أنصح بتشغيل جولة مقارنة صغيرة الحجم عبر APIYI على apiyi.com باستخدام واجهة موحدة، وبعد إطلاق qwen4-max يمكنك استبدال اسم النموذج مباشرة ومواصلة التحقق.
📚 المراجع
-
مدونة Qwen4-Max الرسمية: مواصفات النموذج، ونافذة السياق، وأسعار QwenCloud
- الرابط:
qwen.ai/blog?id=qwen4-max - الوصف: تتضمن بيانات مقارنة على الصورة نفسها كما أعلنتها Qwen رسميًا
- الرابط:
-
دليل البدء السريع لـ Kimi K3.1 Pro: الوثائق الرسمية من Moonshot
- الرابط:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md - الوصف: تتضمن الدرجات التي أعلنتها Moonshot رسميًا في Terminal-Bench 4.0 وKimi Code Bench 3.0
- الرابط:
-
أسعار نماذج المحادثة من Kimi: صفحة الأسعار الرسمية من Moonshot
- الرابط:
platform.kimi.ai/docs/pricing/chat.md - الوصف: قواعد الفوترة للإصدار القياسي، وإصدار Highspeed، ووضع Batch
- الرابط:
-
Arena Code Arena WebDev: لقطة من اللوحة العامة، بتاريخ 2026-11-14
- الرابط:
arena.ai - الوصف: ترتيب التصويت من طرف ثالث، وتكلفة المهمة الواحدة
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا أن تتواصلوا معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من المواد يمكنكم زيارة مركز الوثائق docs.apiyi.com