Nota do autor: este artigo explica como construir um Agente de IA pessoal usando interfaces de modelo, ferramentas, memória, agendamento e ambiente de execução, e usa um fluxo de trabalho de inteligência de notícias de IA como exemplo para mostrar as responsabilidades e os custos de cada parte de um sistema construído por conta própria.
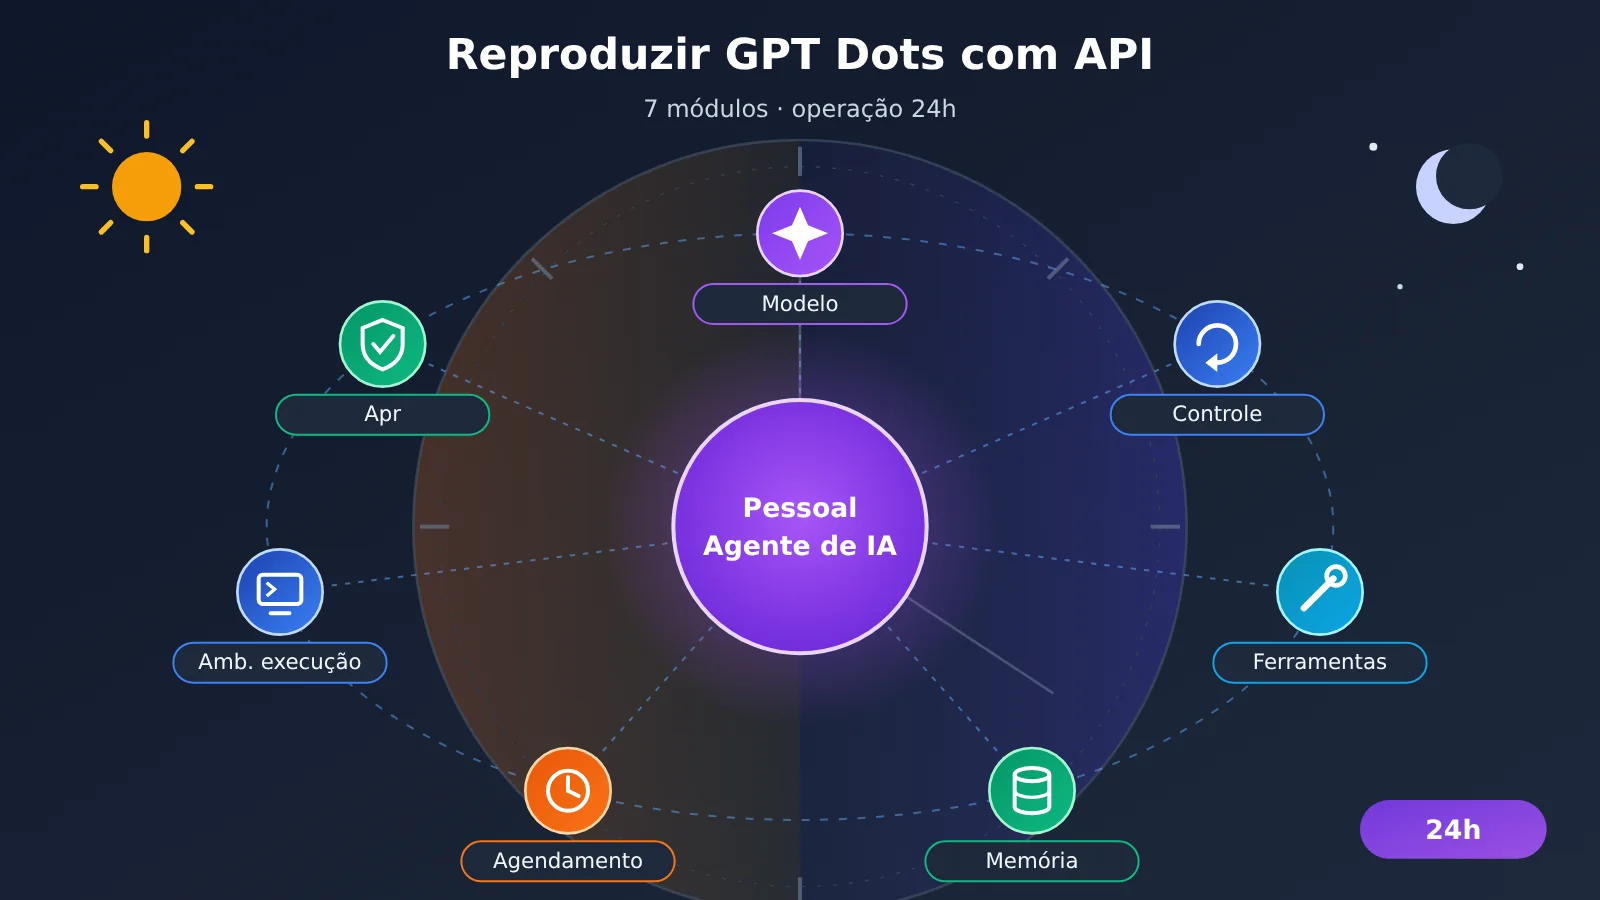
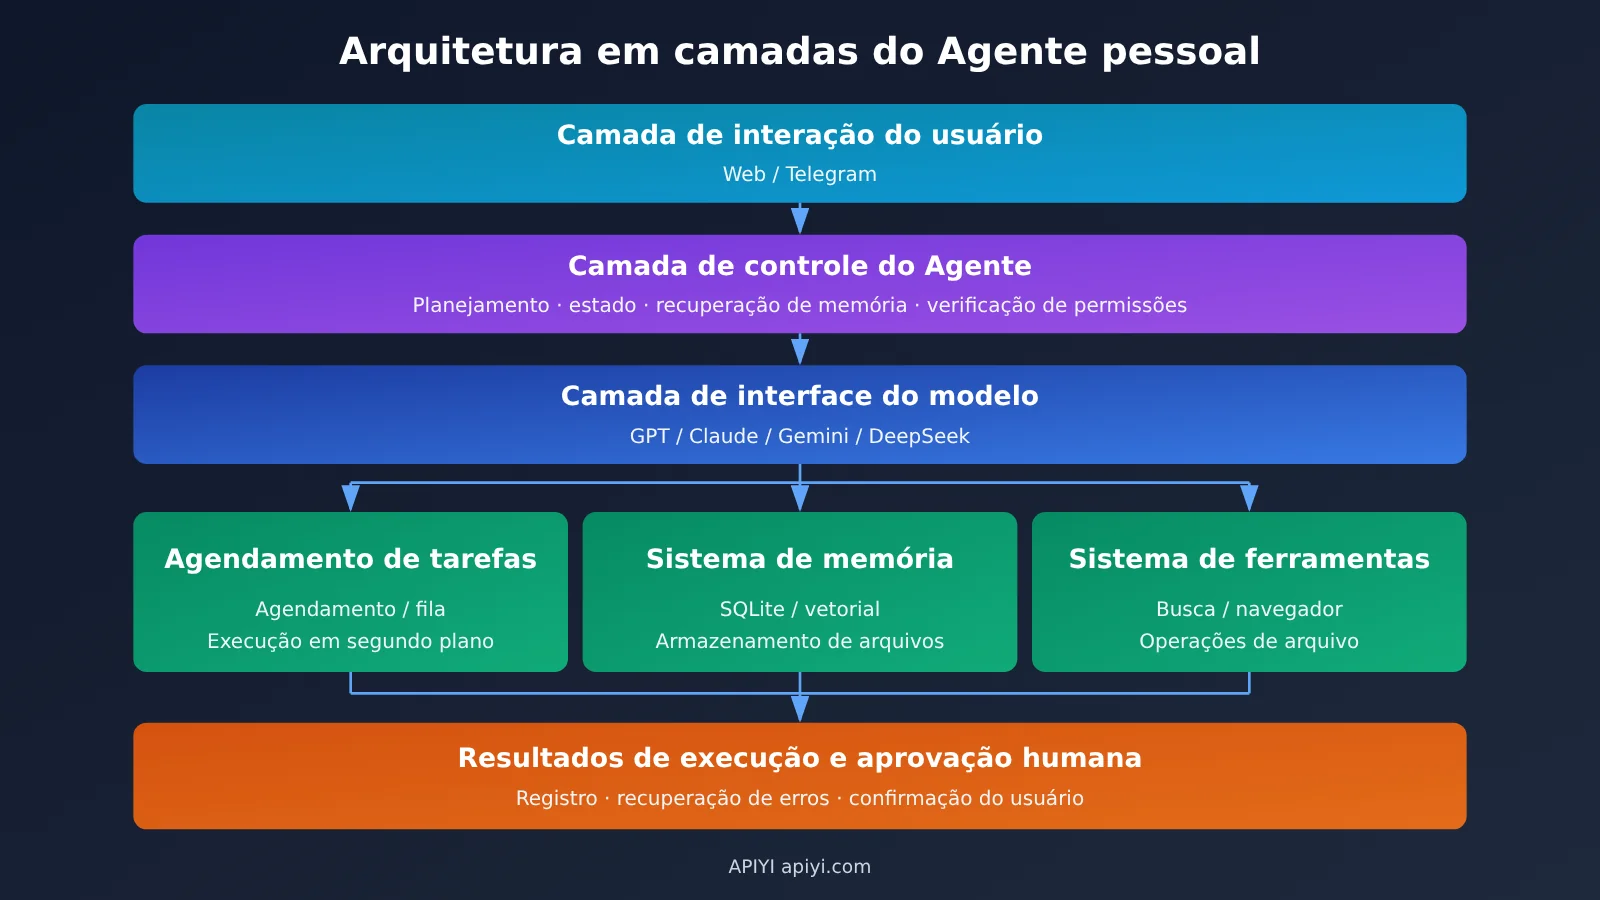
Reproduzir o GPT Dots com a API significa reproduzir o seu modo de trabalho: o modelo é responsável por decidir, o programa é responsável por executar, o banco de dados é responsável pela memória e o agendador é responsável por fazer as tarefas continuarem avançando depois que você sai. A interface do modelo é apenas uma das camadas. O sistema de ferramentas, a memória de longo prazo, a fila de tarefas, o ambiente de execução e o mecanismo de aprovação precisam ser construídos pelo próprio desenvolvedor. A configuração de modelos proprietários, o computador em nuvem e o ecossistema de mais de 4.000 aplicativos da OpenAI fazem parte do próprio produto Dots e não podem ser obtidos diretamente via API. O “24 horas” no título refere-se ao modo de trabalho em que o Agente continua avançando tarefas em segundo plano conforme o plano; o tempo real de operação do sistema depende do servidor, da fila e dos mecanismos de retry.
O texto completo é desenvolvido na ordem de construção. A Parte 1 decompõe o Dots em 7 módulos, marcando quais são fornecidos pelo modelo e quais precisam ser construídos por conta própria. As Partes 2 a 6 implementam, em sequência, a integração do modelo, a chamada de ferramentas, a memória de longo prazo, o agendamento em segundo plano e o ambiente de execução. A Parte 7 combina esses componentes no design completo do Personal AI Radar. A Parte 8 calcula o custo total, incluindo as despesas que não são de modelo, e explica os limites de capacidade da solução construída por conta própria.
Para saber: termos que você precisa conhecer antes de reproduzir o GPT Dots
| Termo | Explicação |
|---|---|
| API | Interface pela qual uma aplicação invoca um modelo ou um serviço externo; neste artigo, refere-se principalmente à interface de invocação de Modelos de Linguagem Grande |
| Agent | Sistema de aplicação que usa o modelo para tomar decisões e invocar ferramentas para levar a tarefa adiante |
| Function Calling | O modelo emite solicitações estruturadas de invocação de ferramentas; seu programa as executa e devolve o resultado ao modelo |
| tool_use / tool_result | Tipos de mensagem de solicitação de invocação de ferramenta e de resultado da execução na interface Claude Messages |
| SQLite | Banco de dados embutido em arquivo único, adequado para armazenar preferências, estado de tarefas, logs e outros dados leves |
| Busca vetorial | Converte texto em vetores e busca materiais relacionados por similaridade semântica |
| Fila de tarefas | Armazena tarefas pendentes e as distribui para Workers em segundo plano, por ordem ou prioridade |
| Checkpoint | Instantâneo do progresso salvo quando a tarefa chega a determinada etapa, a partir do qual ela pode ser retomada após uma interrupção |
| Ambiente de execução | Computador ou contêiner onde o navegador, o código e as operações de arquivo são realmente executados |
| Playwright | Biblioteca de automação que controla o navegador por código, usada para abrir páginas, clicar e extrair conteúdo |
| Prompt Injection | Tipo de ataque em que páginas ou documentos contêm instruções maliciosas ocultas, tentando sequestrar o comportamento do Agente |
| MCP | Protocolo aberto que conecta aplicações de modelo a ferramentas e fontes de dados externas |
1 De quais módulos o GPT Dots é composto
1.1 As capacidades oficiais do GPT Dots
O Dots é um agente de IA pessoal residente, lançado pela OpenAI em 29 de setembro de 2026. De acordo com os materiais oficiais, ele tem seu próprio computador na nuvem e seu próprio navegador, e mesmo depois que o usuário desliga o computador, as tarefas na nuvem já delegadas continuam sendo executadas. Ele consegue combinar a memória do ChatGPT, as próprias anotações e os dados dos aplicativos conectados, tocando vários projetos ao mesmo tempo, e se comunica com o usuário por canais como ChatGPT, Slack, Microsoft Teams, entre outros.
O modo de funcionamento do Dots inclui ainda três mecanismos-chave. A Pesquisa Proativa (Proactive Research) lê em segundo plano as fontes de informação autorizadas e monta notas de pesquisa — esse processo é somente leitura, e as ações seguintes precisam passar pelo fluxo normal de aprovação. Tarefas agendadas e o monitoramento de eventos fazem o Dot trabalhar continuamente, seja conforme o planejado, seja conforme os eventos. As Custom Rules e o Auto-review verificam permissões e a intenção do usuário antes de ações como enviar e-mails ou fazer compras, e operações de alto risco, como transferências e alteração de senha, obrigatoriamente precisam ser assumidas pelo usuário.
1.2 Os sete módulos do GPT Dots e a correspondência na solução própria
Se desmontarmos as capacidades do Dots, chegamos a 7 módulos. A tabela abaixo lista, para cada módulo, a implementação correspondente na solução própria:
| Módulo | Como aparece no Dots | Implementação correspondente na solução própria | Quem fornece |
|---|---|---|---|
| Modelo | Raciocínio, planejamento, escolha de ferramentas | APIs de modelos como GPT, Claude, Gemini, DeepSeek | Serviço de modelo |
| Controlador do agente | Decompor tarefas, coordenar vários projetos | Loop escrito à mão, ou LangGraph, OpenAI Agents SDK | Desenvolvedor |
| Ferramentas | Navegador, plugins de aplicativos, Codex | Function Calling + funções de ferramenta implementadas por você, serviços MCP | Desenvolvedor |
| Memória | ChatGPT Memory, notas do Dot, contexto do projeto | SQLite + busca vetorial + sistema de arquivos | Desenvolvedor |
| Agendamento de tarefas | Tarefas agendadas, monitoramento de eventos, agente em segundo plano | APScheduler, Celery, fila Redis | Desenvolvedor |
| Ambiente de execução | Computador próprio na nuvem | Servidor na nuvem, Docker, Playwright | Desenvolvedor |
| Aprovação de segurança | Custom Rules, Auto-review, usuário assume o controle | Lista de permissões de ferramentas, fila de aprovação, log de operações | Desenvolvedor |
Na tabela, só a primeira linha é fornecida diretamente pela API do modelo; as outras seis linhas exigem implementação de engenharia. É por isso que “uma chave API não entrega a capacidade completa do Dots”: a chave API abre a porta de entrada da invocação do modelo, mas as mãos, os pés, a memória e a rotina do agente você mesmo precisa montar.
2 Preparando as interfaces de modelo necessárias para reproduzir o GPT Dots
2.1 Conectando vários modelos via APIYI
O APIYI (apiyi.com) oferece interfaces compatíveis com OpenAI e a interface nativa Messages do Claude; com uma única chave API, é possível invocar modelos de vários fornecedores. Modelos diferentes usam protocolos diferentes, então é preciso diferenciar na configuração:
| Tipo de modelo | Protocolo | Base URL | Campos de chamada de ferramenta |
|---|---|---|---|
| Modelos compatíveis com OpenAI, como GPT, DeepSeek, Qwen, etc. | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages (/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Protocolo compatível com Gemini | Configure a interface correspondente conforme a documentação oficial | Conforme o protocolo correspondente |
Os IDs dos modelos e os preços em tempo real devem ser consultados na lista de modelos da plataforma. O código abaixo lê o ID do modelo uniformemente a partir de variáveis de ambiente; para trocar de modelo, basta alterar a configuração, e o código do Agent permanece inalterado.
2.2 Invocação mínima de modelo para reproduzir o GPT Dots
Primeiro, confirme se a interface está conectada. Salve o código abaixo como llm.py; os capítulos seguintes importarão client a partir desse arquivo:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Interface compatível com OpenAI da APIYI
)
MODEL = os.environ["RADAR_MODEL"]  # Preencha com o ID do modelo realmente disponível na lista de modelos

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Quando o Claude usa a interface nativa Messages, utilize o SDK da Anthropic; a Base URL não leva /v1:
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # O SDK acrescenta automaticamente /v1/messages
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Depois que o Claude retorna tool_use, seu programa executa a ferramenta e então envia um bloco tool_result com role: user, usando tool_use_id para corresponder à requisição; se a ferramenta falhar, defina is_error: true e o modelo ajustará o próximo passo com base nisso.
🚀 Início rápido: primeiro use a cota de teste gratuita da APIYI para executar os dois blocos de código acima e confirmar que tanto a rota compatível com OpenAI quanto a rota nativa do Claude retornam chamadas de ferramentas; depois siga para o desenvolvimento do Agent.
2.3 Diferenças de compatibilidade de interface e capacidade de chamada de ferramentas
A compatibilidade de protocolo resolve o problema de “a requisição conseguir sair”; o desempenho dos modelos em chamadas de ferramentas ainda varia. O método de teste de chamada de ferramentas multimodelo publicado pela APIYI em novembro de 2026 aponta alguns pontos de observação: a série Gemini concentra-se em chamadas paralelas e em verificar se o JSON final mistura texto extra; a série Qwen concentra-se na seleção sob ferramentas de distração e no mapeamento de ID em múltiplas rodadas; a série Claude concentra-se no tratamento de is_error e no número de rodadas de chamada; a série GPT concentra-se no grau de aderência ao Schema estrito e no uso de Token.
Esses são pontos de atenção dos testes, sem pressupor qual modelo é melhor. A recomendação é fornecer aos modelos candidatos as mesmas definições de ferramentas e tarefas, registrar o número de chamadas, o número de erros de parâmetros, o total de Token e a taxa de acerto final, e usar os dados para decidir o modelo principal do Agent.
A Responses API também precisa de validação separada. A documentação da APIYI registra que a interface /v1/responses lista principalmente modelos como GPT-4.1 e o3, enquanto a documentação atual da OpenAI sobre chamada de ferramentas indica que GPT-6 Astra e GPT-6.1 Sol usam a Responses API. Se você planeja usar a capacidade da Responses API dos novos modelos, deve incluir chamada de ferramentas, ferramentas integradas e gerenciamento de estado como itens de teste de compatibilidade, validar item por item e só então entrar em produção.
3 Fazer agentes no estilo GPT Dots executarem tarefas com Function Calling
3.1 O ciclo de trabalho do Function Calling
O ciclo do Function Calling tem apenas quatro etapas: o programa envia a tarefa e a definição das ferramentas para o modelo; o modelo retorna o nome da ferramenta que deseja chamar e os parâmetros; o programa executa de fato essa ferramenta; o programa anexa o resultado da execução às mensagens e envia tudo novamente ao modelo, que então decide se continua chamando ferramentas ou se fornece a resposta final.
O ponto crucial está na terceira etapa. O modelo apenas gera a solicitação de chamada — acessar o mecanismo de busca, ler e gravar arquivos, enviar mensagens, tudo isso é feito pelo seu código. Portanto, o escopo de permissões das ferramentas, a validação de entrada e o tratamento de falhas ficam inteiramente sob a responsabilidade do desenvolvedor.
3.2 O sistema mínimo de ferramentas formado por três ferramentas
Personal AI Radar precisa de três ferramentas básicas: search_news para buscar notícias, read_file para ler materiais no diretório de trabalho e save_note para gravar os resultados organizados no repositório de dados. A seguir está o loop completo do agente:
Ver o código completo do loop de chamada de ferramentas reproduzido com GPT Dots
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "检索近期 AI 新闻,返回标题、链接、发布时间和摘要列表",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "读取工作目录中的文本文件",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "把一条整理好的新闻资料保存到资料库",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # Conecte o serviço de busca escolhido: API de busca, agregação RSS ou scraping próprio
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # Permite apenas leitura dentro do diretório de trabalho
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
Este código tem três decisões de design que vale a pena manter. max_rounds limita o número de iterações, evitando que o modelo chame repetidamente a mesma ferramenta e consuma tokens. Exceções das ferramentas são encapsuladas como {"error": ...} e devolvidas ao modelo, dando a ele a chance de mudar os parâmetros ou a abordagem. read_file usa validação de caminho para restringir o escopo de leitura ao diretório de trabalho; essa é a fronteira de permissão mais básica.
3.3 Migrando do loop escrito manualmente para um framework Agent
Um loop escrito manualmente é adequado para cenários de tarefa única e poucas ferramentas. Quando a tarefa exige retomada após interrupção, aprovação humana ou ramificações complexas, você pode migrar para o LangGraph: ele oferece State para salvar o estado da tarefa, Checkpointer para persistir o progresso e Human-in-the-loop para pausar e aguardar revisão. O OpenAI Agents SDK também oferece orquestração de fluxos de trabalho e Guardrails. Conforme o número de ferramentas cresce, use MCP para encapsular capacidades como busca, arquivos e e-mail em serviços independentes, que vários Agents podem reutilizar.
4 Construindo memória de longo prazo para Agents no estilo GPT Dots
4.1 A divisão em quatro camadas de memória
O contexto do Dots vem do ChatGPT Memory, das notas do próprio Dot, do contexto da tarefa atual e dos dados dos aplicativos conectados; além disso, tarefas novas recuperam o histórico apenas sob demanda, sem carregar o registro completo da conversa. Um Agent próprio pode adotar a mesma abordagem e gerenciar a memória em camadas:
| Camada de memória | O que armazena | Ciclo de vida | Quando gravar |
|---|---|---|---|
| Contexto atual | Instruções desta tarefa, resultados recentes das ferramentas | Tarefa atual | A cada rodada de conversa |
| Memória de projeto | Objetivos do projeto, decisões-chave, progresso | Durante a duração do projeto | Ao concluir a tarefa ou quando uma decisão muda |
| Memória do usuário | Preferências, áreas de interesse, formato de relatório | Longo prazo | Quando o usuário expressa uma preferência de forma explícita |
| Memória de experiência | Causas de falha, métodos de correção | Longo prazo, atualizada por regras | Após uma tarefa falhar ou ser modificada pelo usuário |
A cada invocação do modelo, coloque no prompt apenas o contexto atual somado às memórias relevantes recuperadas. Enfiar todas as mensagens históricas na requisição aumenta o custo de Tokens e ainda reduz a qualidade da recuperação.
4.2 Projeto da estrutura de tabelas no SQLite
A estrutura de tabelas a seguir cobre as quatro camadas de memória e o estado das tarefas, e a tabela runs também é responsável pela retomada de ponto de interrupção da parte 5:
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
notes usa a URL como chave primária, então quando a mesma notícia é capturada repetidamente ela é deduplicada automaticamente. A restrição de unicidade (project_id, run_date) em runs garante que cada projeto tenha apenas um registro de execução por dia, e após uma reinicialização é possível encontrar o progresso do dia.
4.3 Recuperando materiais históricos com busca vetorial
Dados estruturados usam consultas SQL; materiais semanticamente relacionados usam busca vetorial. A abordagem é gerar embeddings a partir de notes.summary e lessons.lesson, armazená-los em bancos vetoriais como sqlite-vec e Chroma, e registrar projeto, data e origem nos metadados. Ao gerar pautas, primeiro use as notícias do dia para recuperar materiais semelhantes dos últimos 30 dias, anexe alguns dos resumos encontrados ao prompt e o modelo conseguirá julgar “se esta notícia é um avanço de um tópico existente ou um evento totalmente novo”; assim o usuário também não precisa reexplicar o contexto a cada vez.
5 Fazendo um agente no estilo GPT Dots trabalhar continuamente em segundo plano
5.1 A diferença entre os três mecanismos em segundo plano
A execução em segundo plano envolve três mecanismos, cada um com uma responsabilidade diferente. As tarefas agendadas são disparadas pelo agendador do sistema (APScheduler, cron) em horários definidos e resolvem “quando começar”. As requisições de modelo em segundo plano são respostas assíncronas como as do OpenAI Background Mode: você envia a requisição, recebe um response ID, consulta o status periodicamente e busca o resultado. Esse tipo de chamada tem ciclo de vida e condições de retenção de dados próprios, sendo mais adequado para inferências únicas que demoram bastante. Já o agendamento de agentes de longo prazo é composto por uma fila de tarefas, estado persistido e Workers, e fica responsável por fazer tarefas de vários dias e múltiplas etapas avançarem, serem repetidas e recuperadas.
O fluxo de dados recomendado é: agendador → fila de tarefas → Agent Worker → API do modelo → execução de ferramentas → banco de dados de resultados → notificação. Tarefas periódicas e tarefas longas são gerenciadas separadamente; as periódicas apenas enfileiram trabalhos, enquanto as longas são conduzidas pelo Worker conforme o estado.
5.2 Checkpoints por etapa e novas tentativas em caso de falha
A seguir está o esqueleto de agendamento do Personal AI Radar. A cada etapa concluída, o sistema grava um Checkpoint; se o processo reiniciar, ele continua a partir de next_stage:
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # grava na tabela runs
                break
            except TransientError:                       # erros transitórios, como rede e limite de taxa
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
            notify_owner(f"Radar 在 {stage} 阶段失败,进度已保存")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 evita que uma nova execução comece enquanto a anterior ainda não terminou, e misfire_grace_time permite recuperar a tarefa do dia depois de uma breve queda do servidor. Se algo falhar, o progresso é mantido e o usuário é notificado; na segunda tentativa, a execução continua a partir da etapa que falhou. As entradas, saídas, tempos e consumo de tokens de cada etapa vão para o log, o que ajuda tanto na investigação de problemas quanto no cálculo de custos.
6 Dando ao Agente estilo GPT Dots um computador para o trabalho
6.1 A divisão de trabalho entre quatro tipos de ambiente de execução
O Dots tem seu próprio computador na nuvem. Ao construir a solução por conta própria, essa parte precisa ser fornecida pelo desenvolvedor, e há quatro opções comuns:
- Playwright: navegador controlado por código, ideal para raspagem de páginas web com estrutura estável e extração de dados após login; comportamento previsível e custo baixo.
- Browser Use: permite que o modelo controle o navegador em linguagem natural, ideal para tarefas web com estrutura de página variável e etapas não fixas; cada passo consome uma invocação do modelo.
- Computer Use: o modelo observa capturas de tela e opera mouse e teclado, ideal para software de desktop sem API, e precisa ser usado em conjunto com um ambiente de desktop virtual.
- Docker: ambiente isolado para execução de código e processamento de arquivos; scripts gerados pelo Agente rodam no contêiner, e erros não afetam a máquina host.
6.2 Combinação entre decisão do modelo e ambiente de execução
A API do modelo é responsável pelas decisões, e o ambiente de execução é responsável pela ação prática; os dois são conectados por funções de ferramenta. A combinação típica do Radar é: o Playwright captura o texto da notícia, o contêiner Docker executa scripts de limpeza de dados, e o modelo recebe apenas o texto limpo para fazer a avaliação. O conteúdo da web é sempre passado ao modelo como “material”; o prompt do sistema deixa claro que instruções contidas no material não devem ser executadas; todas as ferramentas de envio e publicação entram na fila de aprovação, reduzindo assim o risco de injeção de prompt.
🎯 Dica técnica: chamadas de ferramentas relacionadas ao ambiente de execução aumentam bastante o número de turnos da conversa. Antes de colocar em produção, você pode usar a APIYI para comparar, com o mesmo conjunto de definições de ferramentas, o número de turnos e o consumo de tokens de alguns modelos candidatos, e então decidir o modelo principal e o modelo de reserva.
7 Prática: como construir um Personal AI Radar com a API
Veja a seguir o desenho do Personal AI Radar, que apresenta o fluxo de trabalho completo, da coleta de informações ao relatório diário. O resultado real de cada etapa depende do modelo, do serviço de busca e das fontes de informação que você escolher; antes de colocar em produção, é preciso validar com dados reais.
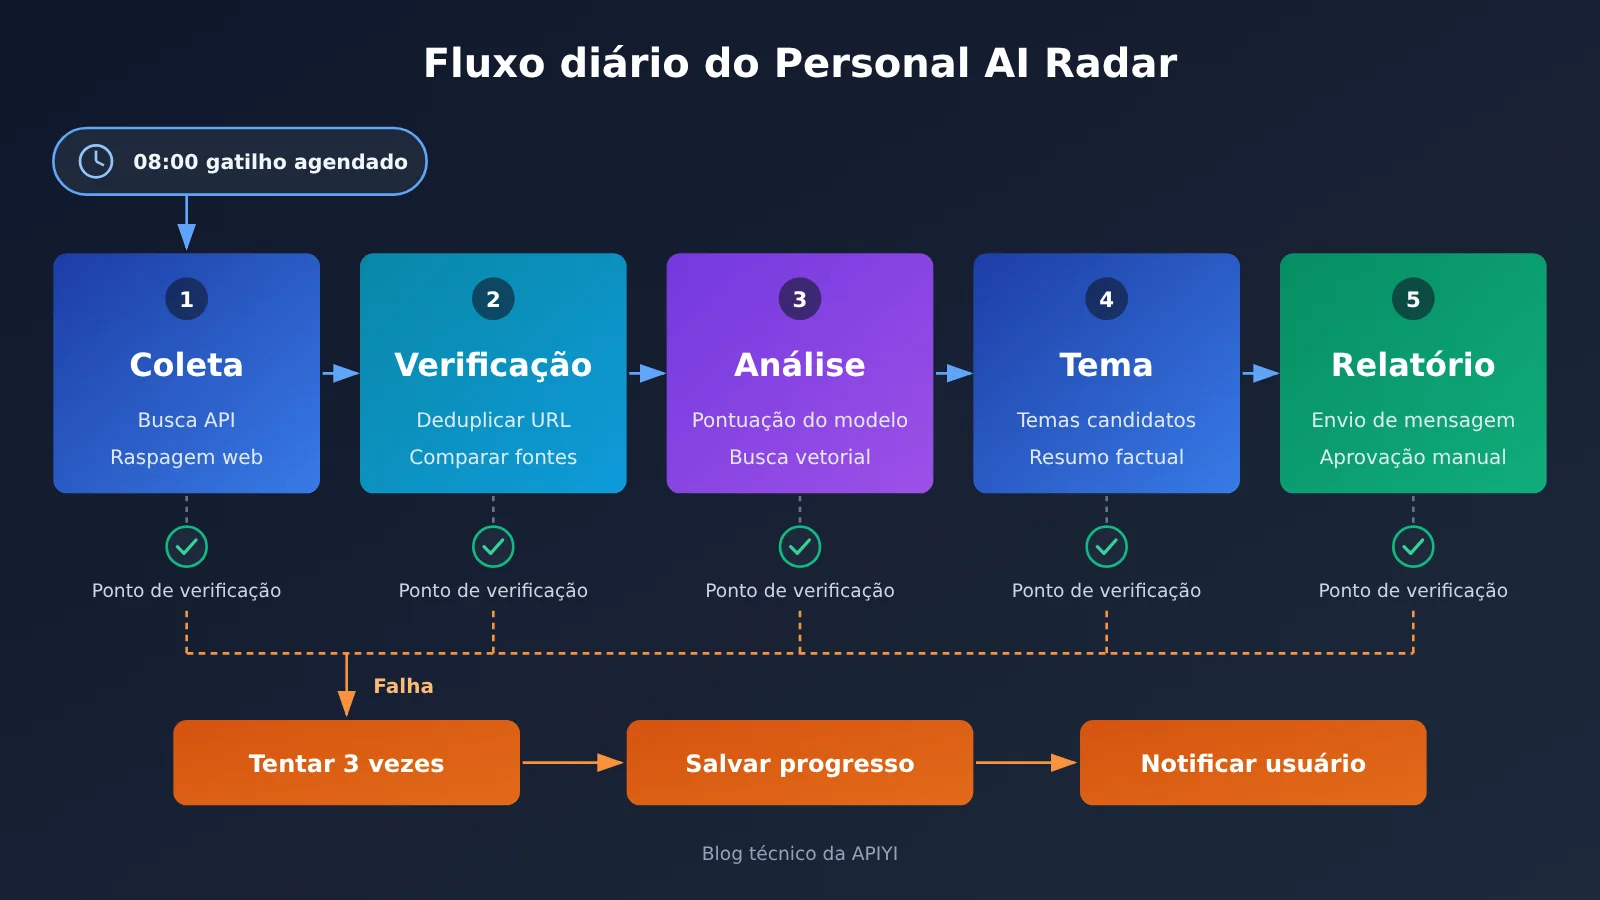
7.1 As cinco etapas do Personal AI Radar
- Coleta (collect): chama
search_newspara buscar notícias das últimas 24 horas pelas palavras-chave que o usuário acompanha, usa o Playwright para capturar o corpo da notícia, deduplica por URL e armazena no estado temporário. - Verificação (verify): faz uma comparação cruzada entre várias fontes sobre o mesmo evento, dando prioridade a anúncios oficiais e fontes primárias; itens com apenas uma fonte são marcados como “a verificar”.
- Análise (analyze): o modelo gera um JSON estruturado para cada notícia, incluindo resumo do evento, fatos-chave e fontes, e relevância em relação às áreas de interesse do usuário; ao mesmo tempo, consulta materiais históricos para determinar se é um evento novo ou uma evolução de um assunto já existente.
- Seleção de pautas (topics): combina as preferências da memória do usuário e as pautas já escritas na memória do projeto para gerar pautas candidatas; cada pauta vem com um resumo factual e links das fontes, e é gravada na tabela
notes. - Relatório (report): gera o briefing do dia e o envia ao usuário; quando o usuário responde no chat com comandos como “alterar”, “executar novamente” ou “adotar”, o agente atualiza a memória do projeto e reexecuta o fluxo conforme necessário.
7.2 Configurações essenciais e tratamento de exceções
A configuração central do Radar pode ficar concentrada em um único arquivo YAML, incluindo palavras-chave de interesse, lista de permissões de fontes de informação, IDs do modelo principal e do modelo de fallback, horário diário de execução, fuso horário, número máximo de rodadas de ferramentas por execução e limite diário de orçamento de tokens. Os IDs dos modelos são injetados por variáveis de ambiente, então trocar de modelo não exige alterar o código.
O tratamento de exceções é diferenciado por tipo. Erros temporários, como timeout de rede e limitação de taxa, são repetidos com backoff exponencial; quando a análise do JSON gerado pelo modelo falha, a mensagem de erro é devolvida como resultado da ferramenta para que o modelo gere novamente uma vez; se o modelo principal falhar repetidamente, o sistema muda para o modelo de fallback; se o uso de tokens do dia ultrapassar o orçamento, os itens de baixa relevância da etapa de análise são ignorados e isso é indicado no briefing. Todas as ações de publicação e envio de e-mails apenas geram rascunhos, que aguardam confirmação do usuário.
8 Custos e limites de capacidade de um agente próprio no estilo GPT Dots
8.1 Os cinco custos de uma solução própria
O custo total de um agente próprio pode ser expresso como:
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- Tokens do modelo: a cada chamada, some
tokens de entrada ÷ 10⁶ × preço de entrada + tokens de saída ÷ 10⁶ × preço de saída. Em execução de longo prazo, também é preciso contabilizar rodadas de chamadas de ferramentas, tentativas, transmissão repetida de contexto e acertos de cache. - Servidor: máquina virtual em nuvem que executa o agendador, os Workers e o navegador; automação de navegador exige bastante memória.
- Banco de dados: o SQLite em si não tem custo; quando o volume de dados cresce e você migra para PostgreSQL ou um banco vetorial gerenciado, surgem custos de armazenamento.
- Ferramentas: APIs de busca, proxies de raspagem web, serviços de notificação e outros serviços de terceiros cobrados por uso ou mensalidade.
- Manutenção: horas de desenvolvedor gastas com mudanças em fontes de informação, atualizações de modelos e upgrades de dependências — geralmente o item de maior peso no longo prazo.
8.2 Referência de preços dos modelos
A nota técnica da APIYI de 13 de novembro de 2026 apresenta os seguintes exemplos de preços de modelos Claude, que podem ser usados para estimar o custo do modelo:
| Modelo | Entrada / milhão de tokens | Saída / milhão de tokens | Leitura de cache / milhão de tokens | Plataforma disponível |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | APIYI |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | APIYI |
| Claude Fable 5.2 | $8 | $40 | $0.20 | APIYI |
Os modelos realmente disponíveis, os grupos e os preços em tempo real devem ser conferidos na lista de modelos em docs.apiyi.com/models. O preço reflete apenas o valor unitário; a taxa de sucesso das tarefas precisa ser testada separadamente com o método da seção 2.3. Em tarefas como a do Radar, a maior parte da entrada é composta por comandos de sistema repetidos e material histórico, e o preço da leitura de cache é bem menor que o da entrada normal — usar o cache de forma inteligente é o principal meio de controlar o custo de tokens.
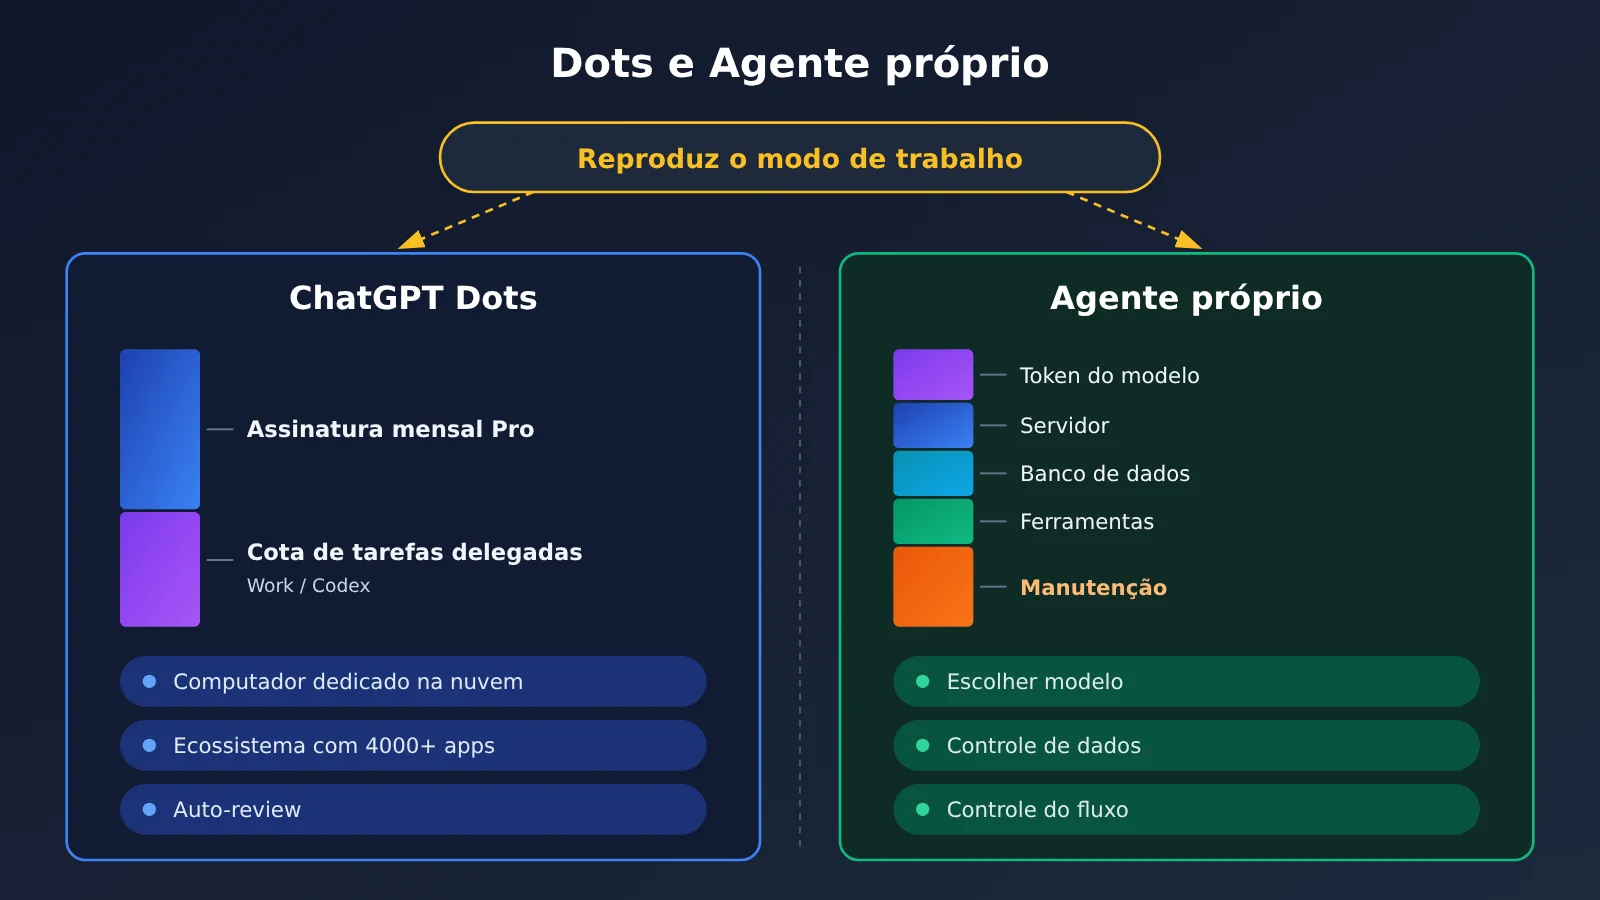
8.3 Comparativo de custos da assinatura Dots
No caso de usuários individuais, as mensalidades do ChatGPT Pro 100, Pro 200 e Pro 500 são de US$ 100, US$ 200 e US$ 500, respectivamente. Os três planos dão direito ao uso do Dots, e a OpenAI não divulga uma mensalidade separada para o Dot nos planos Pro individuais. As tarefas do ChatGPT Work ou do Codex delegadas pelo Dot são calculadas conforme as cotas e regras do produto correspondente, e o consumo depende do modelo, do contexto, da inferência, das chamadas de ferramentas e do volume de recuperação. O Pro individual exige idade mínima de 18 anos e, por enquanto, não abrange o Espaço Econômico Europeu, o Reino Unido e a Suíça.
No caso das empresas, os workspaces Enterprise elegíveis podem optar por uma tarifa fixa por tipo de trabalho ou por cobrança baseada no uso. A partir de 18 de novembro de 2026, a cobrança passa a valer para os Dots ativados; o período de prévia anterior é gratuito, e as tarefas delegadas ao Work ou ao Codex são cobradas separadamente. Os valores exatos seguem a proposta comercial efetivamente aplicável ao workspace.
8.4 Os limites de capacidade da solução self-hosted
Uma solução self-hosted consegue reproduzir integralmente o modo de trabalho central do Dots: avanço contínuo das tarefas, memória em camadas, chamadas de ferramentas, agendamento e aprovação humana. A vantagem está na liberdade de trocar de modelo, no controle total sobre dados e fluxos de trabalho e na possibilidade de personalizar o workflow conforme a profundidade do negócio.
As partes proprietárias do Dots precisam ser supridas por conta própria ou então aceitar a diferença: a configuração interna de modelos da OpenAI, o computador em nuvem próprio do Dot, o ecossistema com mais de 4.000 plugins de aplicativos, os canais de comunicação com Slack e Teams e o sistema de revisão de segurança Auto-review. O próprio Dots também tem limites: um teste prático de um repórter do Axios, em outubro de 2026, mostrou que o Dots consegue concluir um planejamento de viagem com várias etapas e a produção de um álbum comemorativo de 38 páginas, mas o conteúdo apresentou estatísticas questionáveis, e a etapa de compras acabou direcionando o usuário a concluí-la sozinho. Um Agent self-hosted também exige verificação humana dos resultados, e operações que envolvem contas e recursos financeiros devem manter a confirmação humana.
Perguntas frequentes (FAQ)
P1: Uma única API Key dá acesso direto a todas as capacidades do GPT Dots?
A API Key oferece apenas a capacidade de invocação do modelo. Memória, ferramentas, agendamento, ambiente de execução e aprovação precisam ser construídos por conta própria, e o computador em nuvem proprietário e o ecossistema de aplicativos do Dots também não podem ser obtidos via API. Com uma Key do APIYI apiyi.com você alterna facilmente entre vários modelos, e o restante do Agent continua sendo implementado conforme as partes 3 a 6 deste artigo.
P2: Ao reproduzir o GPT Dots, devo escolher a interface compatível com OpenAI ou a interface nativa do Claude?
As duas podem se conectar ao mesmo Agent. Modelos como GPT e DeepSeek usam a interface compatível com OpenAI, enquanto o Claude usa a interface nativa Messages para aproveitar por completo os mecanismos `tool_use`, `tool_result` e `is_error`. A recomendação é abstrair no controlador uma camada unificada de interface de chamada de ferramentas, escrevendo um adaptador para cada cadeia.
P3: O desempenho de chamada de ferramentas é igual entre modelos diferentes?
Depois de garantir a compatibilidade de protocolo, os modelos ainda apresentam diferenças em chamadas paralelas, aderência ao Schema, recuperação de erros e número de rodadas de chamada. Faça testes comparativos com a mesma definição de ferramentas e as mesmas tarefas, contabilizando número de chamadas, erros de parâmetros, tokens e taxa de acerto, e só então decida o modelo principal e o modelo de fallback.
P4: Como um Agent construído por conta própria consegue “trabalhar 24 horas”?
“24 horas” significa um modo de trabalho em que as tarefas avançam continuamente em segundo plano conforme o plano. A implementação depende de três coisas: um agendador em um servidor sempre ativo, o estado da tarefa com Checkpoint e Workers capazes de repetir tentativas. Quando há manutenção do servidor ou falha de alguma dependência, a tarefa é pausada e, após a recuperação, continua a partir do ponto de interrupção.
P5: Quanto custa por mês, aproximadamente, o Personal AI Radar?
Depende da quantidade de fontes de informação, da profundidade de processamento de cada notícia e do modelo escolhido. Rode por uma semana primeiro, use os logs para contabilizar os tokens diários de entrada e saída, calcule o custo do modelo pela fórmula da seção 8.1 e pelo preço unitário do modelo, e some servidor, API de busca e horas de manutenção.
P6: Como um Agent construído por conta própria se protege contra Prompt Injection?
Passe o conteúdo de páginas web e documentos como material e declare no comando de sistema que as instruções presentes nos materiais não devem ser executadas; nas ferramentas, libere apenas as permissões mínimas necessárias para concluir a tarefa; operações de envio externo, publicação e exclusão entram na fila de aprovação humana; todas as chamadas de ferramentas são registradas em log. Essas medidas reduzem bastante o risco, mas os resultados ainda precisam de verificação manual por amostragem periódica.
Pontos-chave para reproduzir o GPT Dots
- Objetivo da reprodução: reproduzir o modo de funcionamento do Dots. O modelo proprietário, o computador em nuvem e o ecossistema de aplicativos precisam ser substituídos por conta própria.
- Sete módulos: modelo, controlador, ferramentas, memória, agendamento, ambiente de execução e aprovação. Apenas o modelo vem da API.
- Invocação de ferramentas: o modelo faz a solicitação, o programa executa a ferramenta, e as permissões e o tratamento de falhas ficam sob responsabilidade do desenvolvedor.
- Memória em camadas: contexto atual, projeto, usuário e experiência ficam armazenados em quatro camadas separadas, recuperadas sob demanda.
- Execução em segundo plano: agendador + fila de tarefas + Checkpoint. Falhas são reprocessadas e a execução retoma a partir do ponto de interrupção.
- Cálculo de custos: além dos Tokens do modelo, servidores, banco de dados, ferramentas e horas de manutenção também precisam entrar na conta.
- Escolha do modelo: acesse vários modelos de forma unificada via APIYI e use o mesmo conjunto de dados de teste para escolher o modelo principal.
Resumo
Pontos-chave para reproduzir o GPT Dots com API:
- Distinga as camadas: a API do modelo é responsável pelas decisões, o framework do Agent pela orquestração, e o ambiente de execução pela ação prática. Os três são construídos separadamente.
- Passe primeiro pelo ciclo mínimo funcional: um modelo, três ferramentas, uma tabela SQLite e uma tarefa agendada já bastam para criar um Agent pessoal capaz de operar de forma contínua.
- Tome decisões com dados: o desempenho na invocação de ferramentas e o custo real de cada modelo precisam ser obtidos por meio de testes em condições iguais.
O Personal AI Radar é um ótimo ponto de partida: ele cobre cinco capacidades centrais do Dots — trabalho contínuo, memória, invocação de ferramentas, agendamento e colaboração humano-máquina. Recomendo acessar vários modelos candidatos via APIYI apiyi.com, concluir os testes comparativos com o mesmo conjunto de definições de ferramentas e, depois, colocar o modelo com desempenho mais estável no seu Agent.
📚 Materiais de referência
- Anúncio oficial da OpenAI – Introducing dots: posicionamento do produto Dots, computador em nuvem e ecossistema de aplicativos
- Link:
openai.com/index/introducing-dots -
Descrição: fonte preferencial para conhecer a descrição oficial das capacidades do Dots
-
ChatGPT Learn – Tasks and memory: tarefas de longo prazo do Dots, Agente em segundo plano, memória e pesquisa proativa
- Link:
learn.chatgpt.com/docs/dots/tasks-and-memory -
Descrição: referência para projetar camadas de memória e mecanismos de agendamento em Agentes próprios
-
OpenAI Help Center – About ChatGPT Pro tiers: regras de preço e cota dos planos Pro 100, Pro 200 e Pro 500
- Link:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
Descrição: comparar o custo de construção própria com o valor da assinatura
-
ChatGPT Learn – Guia do administrador corporativo do Dots: forma de ativação e cobrança do Dots em espaços de trabalho Enterprise
- Link:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
Descrição: referência para usuários corporativos avaliarem os custos do Dots
-
Documentação de Function Calling da OpenAI: formato de requisição e retorno da chamada de ferramentas
- Link:
developers.openai.com/api/docs/guides/function-calling -
Descrição: base oficial para implementar o loop de ferramentas da Parte 3
-
Documentação oficial do LangGraph: runtime de fluxos de trabalho de Agente com estado e de longo ciclo
- Link:
langchain-ai.github.io/langgraph -
Descrição: implementações prontas de Checkpoint, persistência e aprovação humana
-
Teste reproduzível de chamada de ferramentas multimodelo da APIYI: pequeno teste de chamada de ferramentas multi-turno projetado em 5 etapas
- Link:
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
Descrição: método de teste para comparar o desempenho de chamada de ferramentas entre diferentes modelos
-
Instruções de configuração da Base URL da APIYI: configuração de endpoints compatíveis com OpenAI, Claude e Gemini
- Link:
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - Descrição: referência para configurar o acesso a modelos multiprotocolo
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para nos contatar pelo site oficial da APIYI; mais materiais de acesso estão disponíveis no centro de documentação docs.apiyi.com