作者注:本文介绍如何用模型接口、工具、记忆、调度和执行环境自建个人 AI Agent,并以一个 AI 新闻情报工作流为例,说明自建系统各部分的职责和成本。
用 API 复现 GPT Dots,可以复现的是它的工作模式:模型负责判断,程序负责执行,数据库负责记忆,调度器负责让任务在你离开后继续推进。模型接口只是其中一层。工具系统、长期记忆、任务队列、执行环境和审批机制,都需要开发者自己搭建。OpenAI 的专有模型配置、云端计算机和 4,000+ 应用生态属于 Dots 产品本身,这些部分无法通过 API 直接获得。标题中的“24 小时”指 Agent 按计划在后台持续推进任务的工作方式,系统的实际可用时间取决于服务器、队列和重试机制。
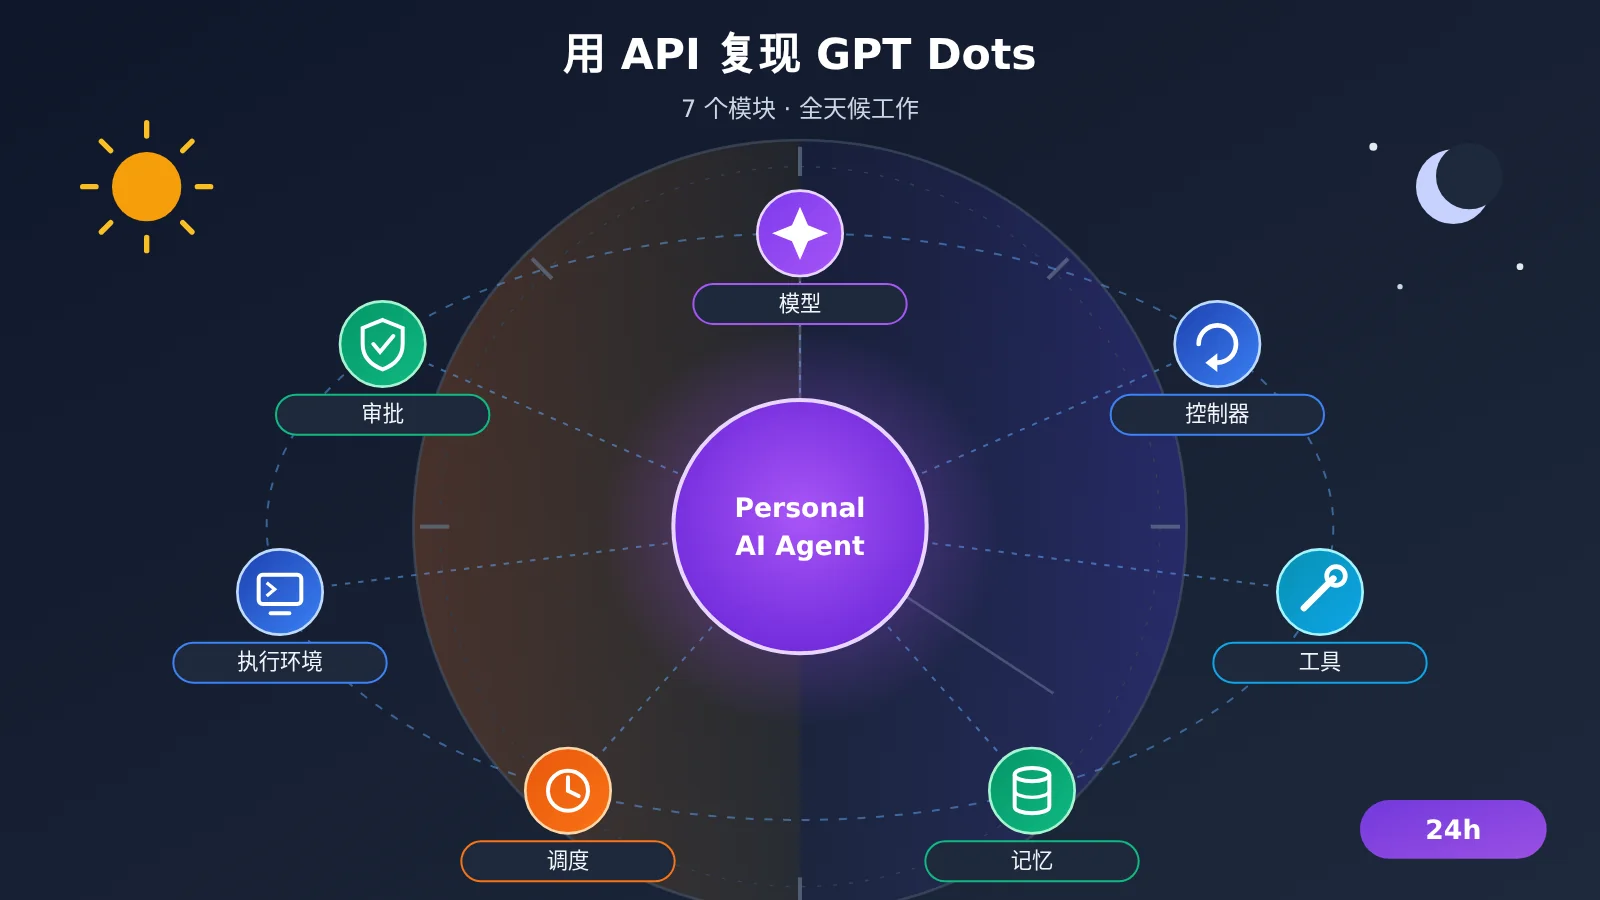
全文按搭建顺序展开。第 1 部分把 Dots 拆成 7 个模块,标出哪些由模型提供、哪些需要自建。第 2 到第 6 部分依次实现模型接入、工具调用、长期记忆、后台调度和执行环境。第 7 部分把这些组件组合成 Personal AI Radar 的完整设计方案。第 8 部分计算包括非模型开销在内的总成本,并说明自建方案的能力边界。
To Know:复现 GPT Dots 前需要了解的术语
| 术语 | 解释 |
|---|---|
| API | 应用调用模型或外部服务的接口,本文中主要指大模型的调用接口 |
| Agent | 利用模型做决策、调用工具推进任务的应用系统 |
| Function Calling | 模型输出结构化的工具调用请求,由你的程序执行,再把结果交还模型 |
| tool_use / tool_result | Claude Messages 接口中工具调用请求和执行结果的消息类型 |
| SQLite | 单文件嵌入式数据库,适合保存偏好、任务状态、日志等轻量数据 |
| 向量检索 | 把文本转成向量,按语义相似度查找相关资料 |
| 任务队列 | 保存待执行任务,按顺序或优先级分发给后台 Worker |
| Checkpoint | 任务执行到某一步时保存的进度快照,中断后从这里恢复 |
| 执行环境 | 实际运行浏览器、代码和文件操作的计算机或容器 |
| Playwright | 用代码控制浏览器的自动化库,用于打开网页、点击、提取内容 |
| Prompt Injection | 网页或文档中藏有恶意指令,试图劫持 Agent 行为的攻击方式 |
| MCP | 连接模型应用与外部工具、数据源的开放协议 |
1 GPT Dots 由哪些模块构成
1.1 GPT Dots 的官方能力
Dots 是 OpenAI 于 2026 年 9 月 29 日发布的常驻型个人 AI Agent。按照官方资料,它拥有自己的云端计算机和浏览器,用户关闭电脑后,已委派的云端任务仍会继续执行。它可以结合 ChatGPT 记忆、自身笔记和已连接应用的数据,同时推进多个项目,并通过 ChatGPT、Slack、Microsoft Teams 等渠道与用户沟通。
Dots 的工作方式还包括三项关键机制。主动研究(Proactive Research)会在后台读取已授权的信息源并形成研究笔记,这一过程只读,后续动作需要走正常的审批流程。定时任务和事件监控让 Dot 按计划或按事件持续工作。Custom Rules 和 Auto-review 则在发送邮件、购物等操作前检查权限和用户意图,转账、修改密码等高风险操作必须由用户接管。
1.2 GPT Dots 七个模块与自建对应关系
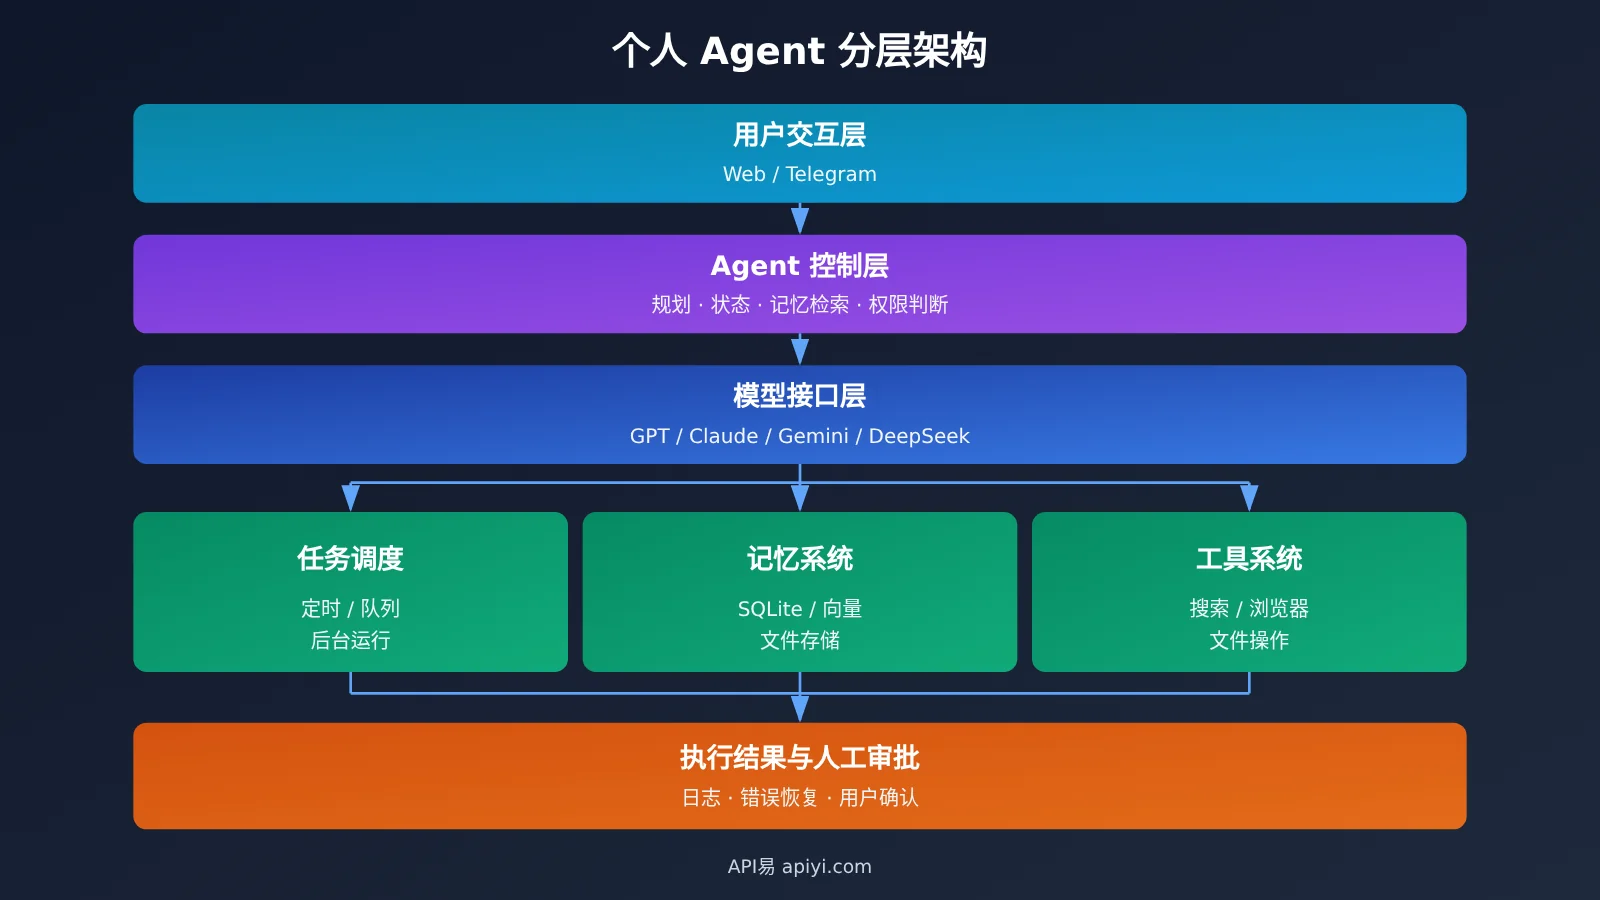
把 Dots 的能力拆开,可以得到 7 个模块。下表列出每个模块在自建方案中的对应实现:
| 模块 | Dots 中的表现 | 自建方案对应实现 | 由谁提供 |
|---|---|---|---|
| 模型 | 推理、规划、选择工具 | GPT、Claude、Gemini、DeepSeek 等模型 API | 模型服务 |
| Agent 控制器 | 拆解任务、协调多个项目 | 自写循环或 LangGraph、OpenAI Agents SDK | 开发者 |
| 工具 | 浏览器、应用插件、Codex | Function Calling + 自己实现的工具函数、MCP 服务 | 开发者 |
| 记忆 | ChatGPT Memory、Dot 笔记、项目上下文 | SQLite + 向量检索 + 文件系统 | 开发者 |
| 任务调度 | 定时任务、事件监控、后台 Agent | APScheduler、Celery、Redis 队列 | 开发者 |
| 执行环境 | 独立云端计算机 | 云服务器、Docker、Playwright | 开发者 |
| 安全审批 | Custom Rules、Auto-review、用户接管 | 工具白名单、审批队列、操作日志 | 开发者 |
表中只有第一行由模型 API 直接提供,其余六行都需要工程实现。这就是“一个 API Key 拿不到完整 Dots 能力”的原因:API Key 打开的是模型调用入口,Agent 的手脚、记忆和作息都要你自己搭。
2 准备 GPT Dots 复现所需的模型接口
2.1 通过 API易 接入多种模型
API易 apiyi.com 提供 OpenAI 兼容接口和 Claude 原生 Messages 接口,一个 API Key 可以调用多家模型。不同模型使用的协议不同,配置时需要区分:
| 模型类型 | 协议 | Base URL | 工具调用字段 |
|---|---|---|---|
| GPT、DeepSeek、Qwen 等 OpenAI 兼容模型 | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages(/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Gemini 兼容协议 | 按官方文档对应接口配置 | 按对应协议 |
模型 ID 和实时价格以平台模型列表为准。下面的代码统一从环境变量读取模型 ID,切换模型只需要改配置,Agent 代码保持不变。
2.2 GPT Dots 复现的最小模型调用
先确认接口连通。以下代码保存为 llm.py,后续章节都从这里导入 client:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # API易 OpenAI 兼容接口
)
MODEL = os.environ["RADAR_MODEL"]  # 填写模型列表中实际可用的模型 ID

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Claude 走原生 Messages 接口时,使用 Anthropic SDK,Base URL 不带 /v1:
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # SDK 会自动拼接 /v1/messages
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Claude 返回 tool_use 后,你的程序执行工具,再以 role: user 发送一个 tool_result 块,用 tool_use_id 对应请求;工具失败时设置 is_error: true,模型会据此调整下一步。
🚀 快速开始:先用 API易 的免费测试额度跑通上面两段代码,确认 OpenAI 兼容和 Claude 原生两条链路都能返回工具调用,再进入 Agent 开发。
2.3 接口兼容与工具调用能力的差异
协议兼容解决的是“请求能发出去”,各模型在工具调用上的表现仍有差异。API易 2026 年 11 月发布的多模型工具调用测试方法给出了几个观察重点:Gemini 系列关注并行调用和最终 JSON 是否混入额外文本,Qwen 系列关注干扰工具下的选择和多轮 ID 映射,Claude 系列关注 is_error 的处理和调用轮次,GPT 系列关注严格 Schema 遵循程度和 Token 用量。
这些是测试关注点,没有预设哪个模型更好。建议给候选模型相同的工具定义和任务,记录调用次数、参数错误次数、总 Token 和最终正确率,用数据决定 Agent 的主力模型。
Responses API 也需要单独验证。API易文档记载的 /v1/responses 接口列出的模型主要是 GPT-4.1、o3 等型号,而 OpenAI 当前的工具调用文档指出 GPT-6 Astra、GPT-6.1 Sol 使用 Responses API。如果你计划使用新模型的 Responses API 能力,应把工具调用、内置工具和状态管理列为兼容性测试项,逐项验证后再上线。
3 用 Function Calling 让 GPT Dots 式 Agent 执行任务
3.1 Function Calling 的工作循环
Function Calling 的循环只有四步:程序把任务和工具定义发给模型;模型返回想调用的工具名和参数;程序真正执行这个工具;程序把执行结果追加到消息里再发给模型,模型决定继续调用还是给出答案。
关键在第三步。模型只生成调用请求,访问搜索引擎、读写文件、发送消息都是你的代码完成的。因此工具的权限范围、输入校验和失败处理,全部由开发者负责。
3.2 三个工具组成的最小工具系统
Personal AI Radar 需要三个基础工具:search_news 检索新闻,read_file 读取工作目录中的资料,save_note 把整理结果写入资料库。下面是完整的 Agent 循环:
查看 GPT Dots 复现的工具调用循环完整代码
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "检索近期 AI 新闻,返回标题、链接、发布时间和摘要列表",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "读取工作目录中的文本文件",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "把一条整理好的新闻资料保存到资料库",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # 接入你选择的搜索服务:搜索 API、RSS 聚合或自建抓取
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # 只允许读取工作目录
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
这段代码有三处设计值得保留。max_rounds 限制循环次数,防止模型反复调用同一工具消耗 Token。工具异常被包装成 {"error": ...} 返回给模型,让模型有机会换参数或换方案。read_file 用路径校验把读取范围锁在工作目录内,这是最基础的权限边界。
3.3 从自写循环升级到 Agent 框架
自写循环适合单任务、少量工具的场景。当任务需要中断恢复、人工审批、复杂分支时,可以迁移到 LangGraph:它提供 State 保存任务状态、Checkpointer 持久化进度、Human-in-the-loop 暂停等待审核。OpenAI Agents SDK 也提供工作流编排和 Guardrails。工具数量增多后,用 MCP 把搜索、文件、邮件等能力封装成独立服务,多个 Agent 可以复用。
4 给 GPT Dots 式 Agent 建立长期记忆
4.1 四层记忆的划分
Dots 的上下文来自 ChatGPT Memory、Dot 自身笔记、当前任务上下文和已连接应用数据,并且新任务只按需检索历史,不会载入完整聊天记录。自建 Agent 可以采用同样的思路,把记忆分层管理:
| 记忆层 | 存储内容 | 生命周期 | 写入时机 |
|---|---|---|---|
| 当前上下文 | 本次任务指令、最近工具结果 | 当前任务 | 每轮对话 |
| 项目记忆 | 项目目标、关键决策、进展 | 项目持续期间 | 任务完成或决策变化时 |
| 用户记忆 | 偏好、关注领域、汇报格式 | 长期 | 用户明确表达偏好时 |
| 经验记忆 | 失败原因、修正方法 | 长期,按规则更新 | 任务失败或被用户修改后 |
每次调用模型时,只把当前上下文加上检索出的相关记忆放进 prompt。把全部历史消息塞进请求会同时推高 Token 成本和降低检索质量。
4.2 SQLite 表结构设计
以下表结构覆盖四层记忆和任务状态,runs 表同时承担第 5 部分的断点恢复:
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
notes 以 URL 为主键,同一篇新闻重复抓取时自动去重。runs 的 (project_id, run_date) 唯一约束保证每个项目每天只有一条运行记录,重启后可以找到当天的进度。
4.3 用向量检索召回历史资料
结构化数据用 SQL 查询,语义相关的资料用向量检索。做法是把 notes.summary 和 lessons.lesson 生成嵌入向量,存入 sqlite-vec、Chroma 等向量库,并在元数据中记录项目、日期和来源。生成选题时,先用当天新闻检索过去 30 天的相似资料,把命中的几条摘要附在 prompt 里,模型就能判断“这条新闻是已有话题的进展还是全新事件”,用户也无需每次重新解释背景。
5 让 GPT Dots 式 Agent 在后台持续工作
5.1 三种后台机制的区别
后台运行涉及三种机制,职责各不相同。定时任务由系统调度器(APScheduler、cron)按时间触发,解决“什么时候开始”。后台模型请求指 OpenAI Background Mode 这类异步响应:提交请求后拿到 response ID,轮询状态并取回结果,它有自己的生命周期和数据保留条件,适合单次耗时较长的推理。长期 Agent 调度由任务队列、持久化状态和 Worker 组成,负责跨天、多阶段任务的推进、重试和恢复。
推荐的数据流是:调度器 → 任务队列 → Agent Worker → 模型 API → 工具执行 → 结果数据库 → 通知。周期任务和长任务分开管理,周期任务只负责往队列里投递,长任务由 Worker 按状态推进。
5.2 分阶段 Checkpoint 与失败重试
下面是 Personal AI Radar 的调度骨架。每完成一个阶段就写一次 Checkpoint,进程重启后从 next_stage 继续:
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # 写入 runs 表
                break
            except TransientError:                       # 网络、限流等可重试错误
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
            notify_owner(f"Radar 在 {stage} 阶段失败,进度已保存")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 防止上一轮未结束时重复启动,misfire_grace_time 让服务器短暂宕机后补跑当天任务。失败时保留进度并通知用户,第二次触发会从失败阶段继续。每个阶段的输入、输出、耗时和 Token 用量都写入日志,方便排查和计算成本。
6 给 GPT Dots 式 Agent 一台可以工作的电脑
6.1 四类执行环境的分工
Dots 拥有自己的云端计算机。自建时,这部分要由开发者提供,常见选择有四种:
- Playwright:代码驱动浏览器,适合结构稳定的网页抓取、登录后数据提取,行为可预测、成本低。
- Browser Use:让模型用自然语言驱动浏览器,适合页面结构多变、步骤不固定的网页任务,每一步都消耗模型调用。
- Computer Use:模型观察屏幕截图并操作鼠标键盘,适合没有 API 的桌面软件,需要配合虚拟桌面环境使用。
- Docker:隔离的代码执行和文件处理环境,Agent 生成的脚本在容器里运行,出错不影响宿主机。
6.2 模型决策与执行环境的组合
模型 API 负责决策,执行环境负责动手,两者通过工具函数连接。Radar 的典型组合是:Playwright 抓取新闻正文,Docker 容器运行数据清洗脚本,模型只接收清洗后的文本做判断。网页内容一律作为“资料”传给模型,系统提示中明确说明资料中的指令不得执行,发送、发布类工具全部进入审批队列,以此降低 Prompt Injection 风险。
🎯 技术建议:执行环境相关的工具调用会让对话轮次明显增加。上线前可以在 API易 上用同一套工具定义对比几个候选模型的轮次和 Token 消耗,再决定主力模型和降级模型。
7 实战:用 API 搭建 Personal AI Radar
以下是 Personal AI Radar 的设计方案,展示从信息收集到每日汇报的完整工作流。各阶段的实际效果取决于你选用的模型、搜索服务和信息源,上线前需要用真实数据验证。
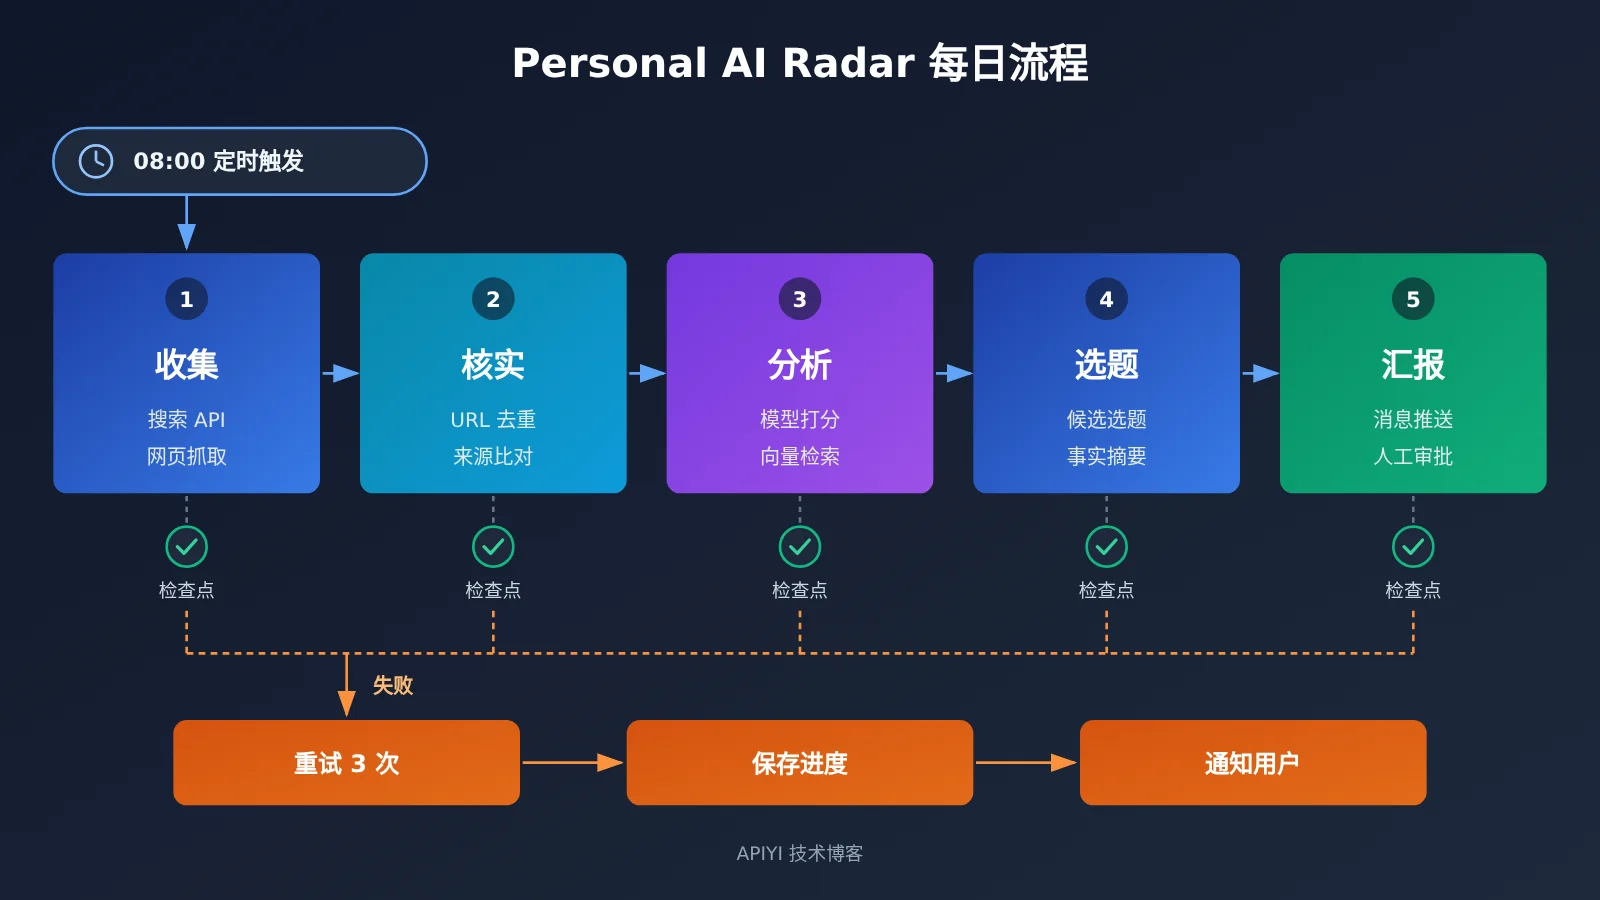
7.1 Personal AI Radar 的五个阶段
- 收集(collect):调用
search_news按用户关注的关键词检索过去 24 小时新闻,用 Playwright 抓取正文,按 URL 去重后存入临时状态。 - 核实(verify):对同一事件的多个来源做交叉比对,优先保留官方公告和一手来源,只有单一来源的条目标记为“待核实”。
- 分析(analyze):模型对每条新闻输出结构化 JSON,包括事件摘要、关键事实及出处、与用户关注领域的相关度;同时检索历史资料,判断是新事件还是已有话题的进展。
- 选题(topics):结合用户记忆中的偏好和项目记忆中已写过的选题,生成候选选题,每个选题附带事实摘要和来源链接,写入
notes表。 - 汇报(report):生成当日简报推送给用户;用户在聊天中回复“改”“重跑”“采用”等指令,Agent 更新项目记忆并按需重新执行。
7.2 关键配置与异常处理
Radar 的核心配置建议集中在一个 YAML 文件里,包括关注关键词、信息源白名单、主力模型和降级模型 ID、每日运行时间、时区、单次最大工具轮次、每日 Token 预算上限。模型 ID 通过环境变量注入,切换模型时不需要改代码。
异常处理按类型区分。网络超时、限流等临时错误按指数退避重试;模型输出的 JSON 解析失败时,把错误信息作为工具结果回传,让模型重新生成一次;主力模型连续失败时切换到降级模型;当日 Token 用量超过预算时,跳过分析阶段的低相关度条目并在简报中注明。所有发布、外发邮件类动作都只生成草稿,等待用户确认。
8 自建 GPT Dots 式 Agent 的成本与能力边界
8.1 自建方案的五项成本
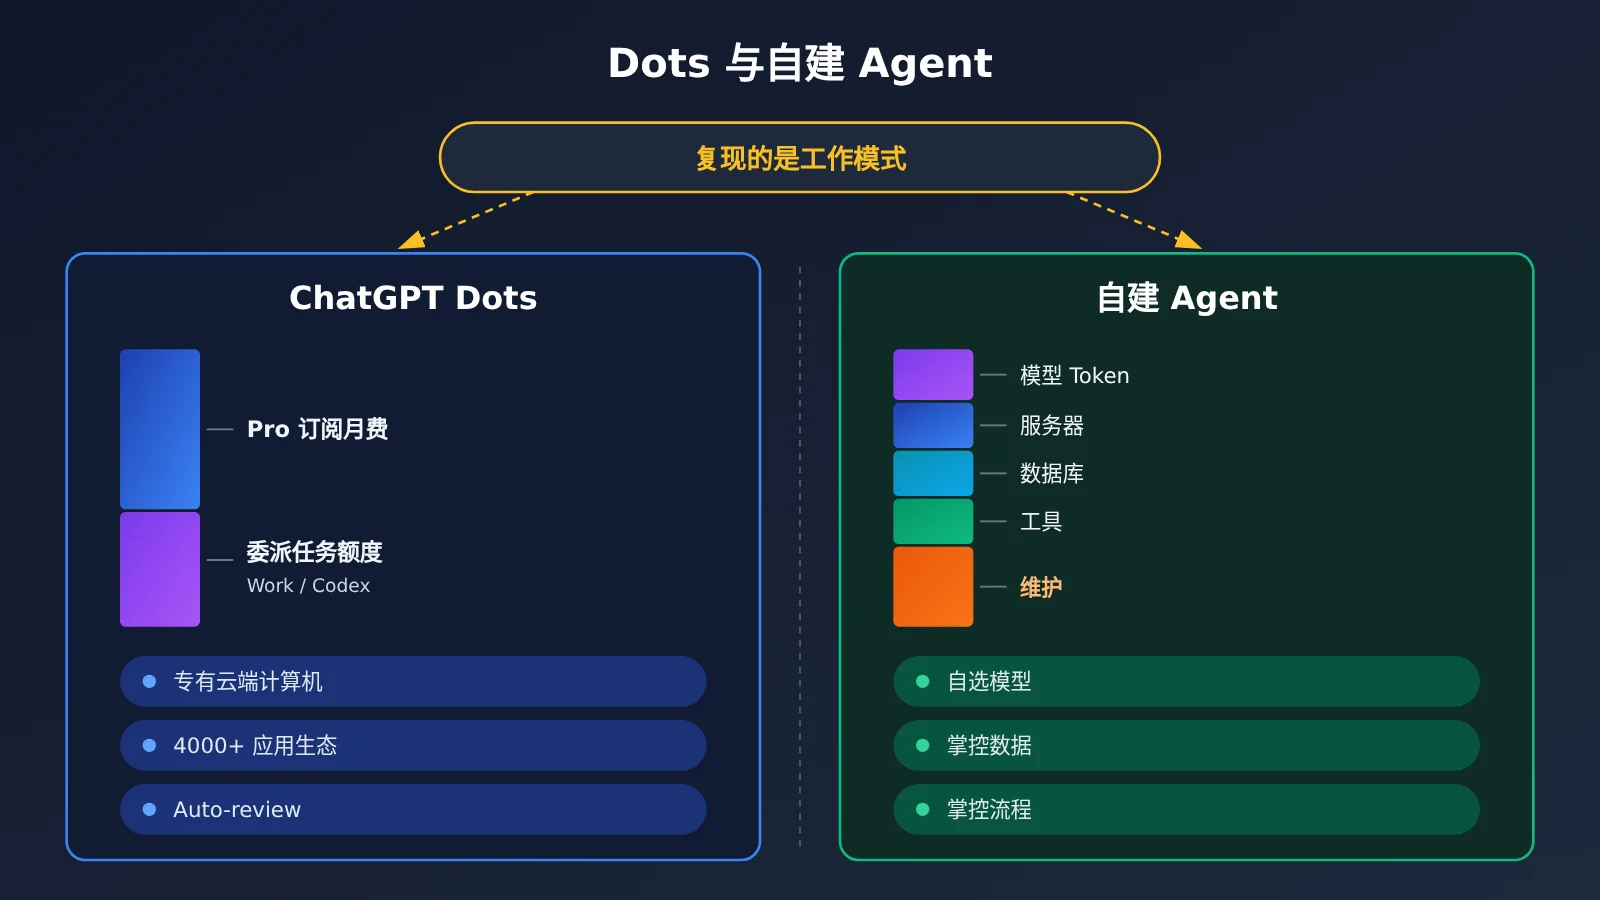
自建 Agent 的总成本可以写成:
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- 模型 Token:每次调用按
输入 Token ÷ 10⁶ × 输入单价 + 输出 Token ÷ 10⁶ × 输出单价累加。长期运行时还要统计工具调用轮次、重试次数、上下文重复传输和缓存命中情况。 - 服务器:运行调度器、Worker 和浏览器的云主机,浏览器自动化对内存要求较高。
- 数据库:SQLite 本身零费用,数据量增大后迁移到 PostgreSQL 或托管向量库会产生存储费用。
- 工具:搜索 API、网页抓取代理、通知服务等第三方服务按次或按月计费。
- 维护:信息源改版、模型更新、依赖升级带来的开发者工时,往往是长期占比最高的一项。
8.2 模型价格参考
API易 2026 年 11 月 13 日的技术说明给出了以下 Claude 模型价格示例,可用于估算模型成本:
| 模型 | 输入 / 百万 Token | 输出 / 百万 Token | 缓存读取 / 百万 Token | 可用平台 |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | API易 |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | API易 |
| Claude Fable 5.2 | $8 | $40 | $0.20 | API易 |
具体可用模型、分组和实时价格以 docs.apiyi.com/models 模型列表为准。价格只反映单价,任务成功率需要用第 2.3 节的方法单独测试。Radar 这类任务的大部分输入是重复的系统提示和历史资料,缓存读取单价远低于普通输入,合理利用缓存是控制 Token 成本的主要手段。
8.3 Dots 订阅费用对照
个人用户方面,ChatGPT Pro 100、Pro 200、Pro 500 的月费分别为 $100、$200、$500,三档都具备 Dots 使用资格,官方没有为个人 Pro 的 Dot 列出单独月费。Dot 委派出去的 ChatGPT Work 或 Codex 任务按对应产品的额度和规则计算,消耗取决于模型、上下文、推理、工具调用和检索量。个人 Pro 需年满 18 岁,暂不覆盖欧洲经济区、英国和瑞士。
企业方面,符合条件的 Enterprise 工作区可以选择按工作类型的固定费率或按用量计费,2026 年 11 月 18 日起对启用的 Dots 开始计费,此前的预览期免费,委派至 Work 或 Codex 的任务另行收费。具体金额以工作区实际适用报价为准。
8.4 自建方案的能力边界
自建方案能完整复现 Dots 的核心工作模式:持续推进任务、分层记忆、工具调用、定时调度和人工审批。它的优势在于模型可以自由切换,数据和流程完全由自己掌控,工作流可以按业务深度定制。
Dots 的专有部分需要自己补齐或接受差距:OpenAI 内部模型配置、Dot 自有云端计算机、4,000+ 应用插件生态、跨 Slack 与 Teams 的沟通渠道、Auto-review 安全审核体系。Dots 本身也有边界,Axios 记者 2026 年 10 月的实测显示,Dots 能完成多步骤旅行规划和 38 页纪念册制作,但内容中出现了值得质疑的统计数据,购物环节也引导用户自己完成。自建 Agent 同样需要人工检查结果,涉及账户和资金的操作应保留人工确认。
常见问题 FAQ
Q1:一个 API Key 能直接获得 GPT Dots 的全部能力吗?
API Key 提供的是模型调用能力。记忆、工具、调度、执行环境和审批都需要自己搭建,Dots 的专有云端计算机和应用生态也无法通过 API 获得。用 API易 apiyi.com 的一个 Key 可以方便地在多个模型之间切换,Agent 的其余部分仍按本文第 3 到第 6 部分实现。
Q2:复现 GPT Dots 时,OpenAI 兼容接口和 Claude 原生接口该选哪个?
两种都可以接入同一个 Agent。GPT、DeepSeek 等模型走 OpenAI 兼容接口,Claude 走原生 Messages 接口能完整使用 `tool_use`、`tool_result` 和 `is_error` 机制。建议在控制器里抽象一层统一的工具调用接口,两条链路各写一个适配器。
Q3:不同模型的工具调用表现一样吗?
协议兼容之后,各模型在并行调用、Schema 遵循、错误恢复和调用轮次上仍有差异。用相同工具定义和任务做对比测试,统计调用次数、参数错误、Token 和正确率,再决定主力模型和降级模型。
Q4:自建 Agent 如何做到“24 小时工作”?
“24 小时”指按计划在后台持续推进任务的工作方式。实现依赖三件事:常驻服务器上的调度器、带 Checkpoint 的任务状态、可重试的 Worker。服务器维护或依赖故障时任务会暂停,恢复后从断点继续。
Q5:Personal AI Radar 一个月大概花多少钱?
取决于信息源数量、每条新闻的处理深度和所选模型。先跑一周,用日志统计每日输入输出 Token,按第 8.1 节公式和模型单价计算模型成本,再加上服务器、搜索 API 和维护工时。
Q6:自建 Agent 如何防范 Prompt Injection?
把网页和文档内容作为资料传入,并在系统提示中声明资料中的指令不执行;工具只开放完成任务所需的最小权限;外发、发布、删除类操作进入人工审批队列;所有工具调用写入日志。这些措施能显著降低风险,结果仍需定期人工抽查。
GPT Dots 复现核心要点 Key Takeaways
- 复现目标:复现 Dots 的工作模式,专有模型、云端计算机和应用生态需自行替代。
- 七个模块:模型、控制器、工具、记忆、调度、执行环境、审批,只有模型来自 API。
- 工具调用:模型提出请求,程序执行工具,权限和失败处理由开发者负责。
- 记忆分层:当前上下文、项目、用户、经验四层分开存储,按需检索。
- 后台运行:调度器加任务队列加 Checkpoint,失败重试并从断点恢复。
- 成本计算:模型 Token 之外,服务器、数据库、工具和维护工时都要计入。
- 模型选择:通过 API易 统一接入多个模型,用同一套测试数据选出主力模型。
总结
用 API 复现 GPT Dots 的核心要点:
- 分清层次:模型 API 负责决策,Agent 框架负责编排,执行环境负责动手,三者各自搭建。
- 先跑通最小闭环:一个模型、三个工具、一张 SQLite 表、一个定时任务,就能做出可持续运行的个人 Agent。
- 用数据做选择:模型的工具调用表现和真实成本都要靠同条件测试得出。
Personal AI Radar 是一个很好的起点,它覆盖了持续工作、记忆、工具调用、调度和人机协作五项 Dots 核心能力。推荐通过 API易 apiyi.com 接入多个候选模型,用同一套工具定义完成对比测试,再把表现最稳定的模型放进你的 Agent。
📚 参考资料
- OpenAI 官方公告 – Introducing dots:Dots 的产品定位、云端计算机和应用生态
- 链接:
openai.com/index/introducing-dots -
说明: 了解 Dots 官方能力描述的首选资料
-
ChatGPT Learn – Tasks and memory:Dots 的长期任务、后台 Agent、记忆和主动研究
- 链接:
learn.chatgpt.com/docs/dots/tasks-and-memory -
说明: 设计自建 Agent 记忆分层和调度机制时的参照
-
OpenAI Help Center – About ChatGPT Pro tiers:Pro 100、Pro 200、Pro 500 的价格与额度规则
- 链接:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
说明: 对比自建成本与订阅费用
-
ChatGPT Learn – Dots 企业管理员指南:Enterprise 工作区 Dots 的开通与计费方式
- 链接:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
说明: 企业用户评估 Dots 费用时参考
-
OpenAI Function Calling 文档:工具调用的请求与返回格式
- 链接:
developers.openai.com/api/docs/guides/function-calling -
说明: 实现第 3 部分工具循环的官方依据
-
LangGraph 官方文档:有状态、长周期 Agent 工作流运行时
- 链接:
langchain-ai.github.io/langgraph -
说明: Checkpoint、持久化与人工审批的现成实现
-
API易 多模型工具调用可复现测试:5 步设计多轮工具调用小测试
- 链接:
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
说明: 对比不同模型工具调用表现的测试方法
-
API易 Base URL 配置说明:OpenAI 兼容、Claude、Gemini 端点配置
- 链接:
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - 说明: 配置多协议模型接入时的参考
作者:APIYI 技术团队
技术交流:欢迎通过 API易 官网联系我们,更多接入资料可访问 docs.apiyi.com 文档中心