Resumo: O experimento Saltline, relatado pelo próprio desenvolvedor, mostra como a geração de código de longa duração pode produzir um protótipo jogável. Para entender o custo estimado da API, é preciso considerar a cobrança por cache e a cobrança por saída.
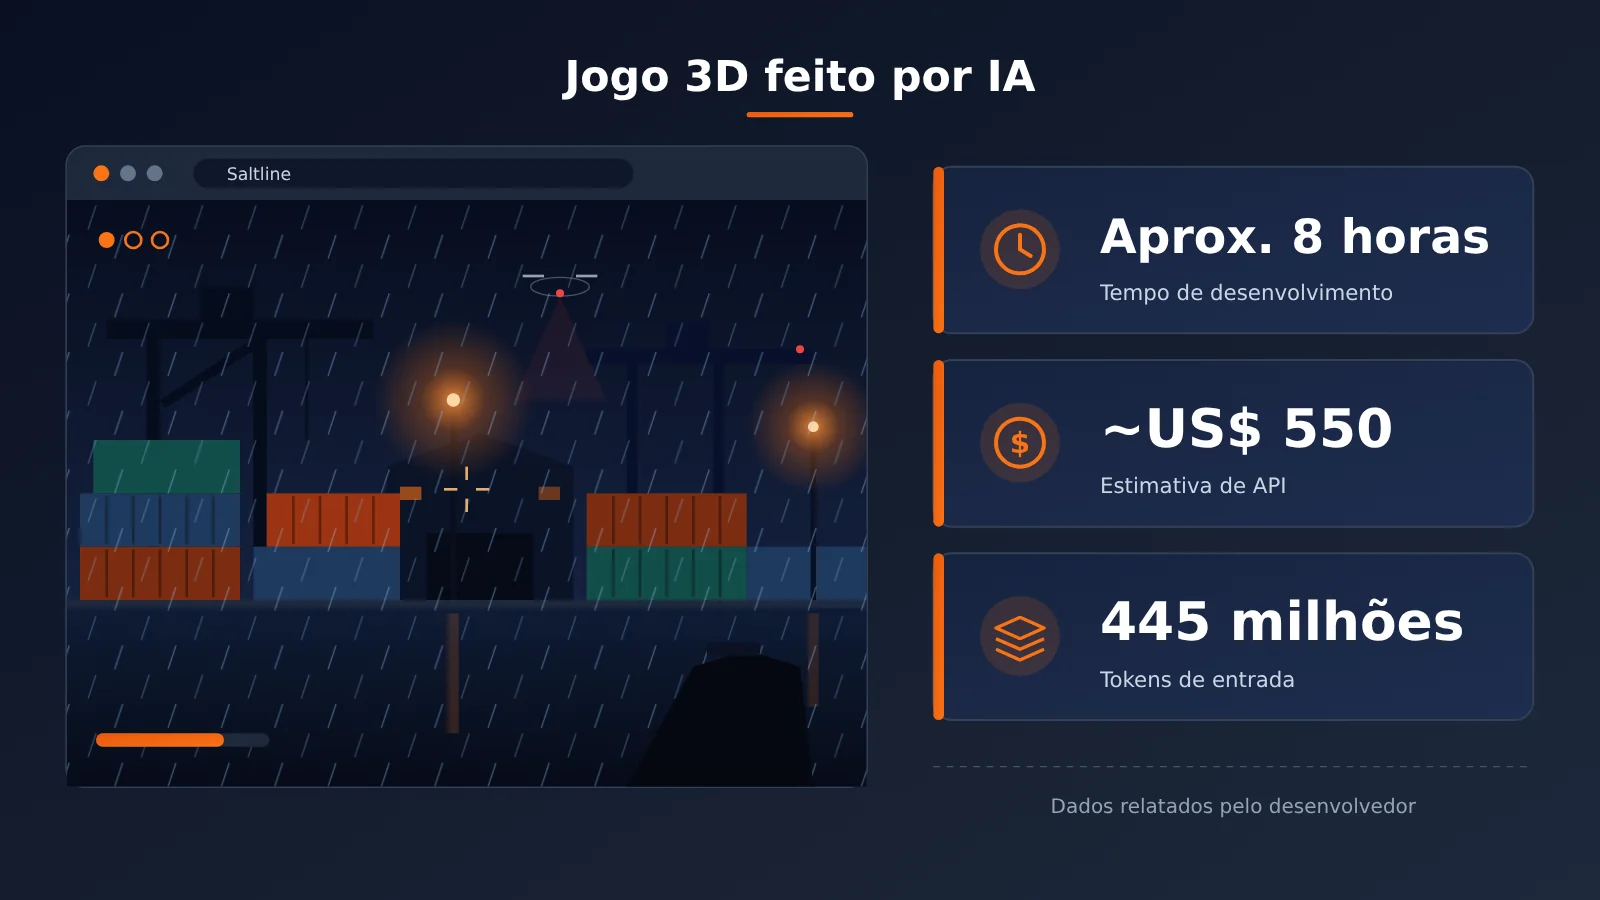
Em 9 de novembro de 2026, o engenheiro da Anthropic Felix Rieseberg publicou um experimento. Ele deu apenas um comando ao Claude Fable 5.2 e, depois, não forneceu nenhum feedback humano; o resultado foi o Saltline, um jogo de tiro em primeira pessoa 3D que roda diretamente no navegador. Segundo o próprio autor, a geração levou cerca de 8 horas, consumiu aproximadamente 445 milhões de tokens de entrada e cerca de 2,7 milhões de tokens de saída, com custo estimado em torno de US$ 550 com base nos preços da API.
Dois pontos merecem destaque neste experimento. Primeiro, o modelo integrou em uma única tarefa de geração de código de longa duração trabalhos que normalmente pertencem a funções diferentes — construção de cenários, lógica de jogo, modelos 3D e texturas, shaders, efeitos sonoros e interação do jogador — e todo o conteúdo visual existe na forma de código e funções. Segundo, se todos os 445 milhões de tokens de entrada fossem cobrados pelo preço unitário normal de entrada, o custo ultrapassaria US$ 3.500; no entanto, a estimativa relatada pelo desenvolvedor é de apenas cerca de US$ 550, e a diferença vem principalmente do mecanismo de cache. A economia de tarefas complexas de desenvolvimento com IA depende do grau de reutilização de contexto; conclusões tiradas apenas dos preços unitários de entrada e saída ficam seriamente distorcidas.
A seguir, apresento os dados públicos e as condições do experimento do Saltline; depois, detalho quais etapas específicas do desenvolvimento do jogo a IA concluiu; em seguida, uso os preços oficiais do Fable 5.2 para calcular a origem dos US$ 550 e os limites do que pode ser recalculado; depois, ofereço uma estrutura de custos que separa a invocação do modelo, a execução do desenvolvimento e a operação do produto; por fim, discuto a distância entre protótipos jogáveis e jogos comerciais nesse tipo de desenvolvimento independente com IA.
Para saber: entenda os termos do experimento de jogo 3D com IA
| Termo | Explicação |
|---|---|
| Token | Unidade de medida usada pelo modelo para processar entrada e saída; a API cobra com base na quantidade de tokens. |
| API | Interface pela qual as aplicações chamam os serviços do modelo; é por meio dela que os desenvolvedores integram o modelo aos próprios programas. |
| Cache de entrada (Prompt Caching) | Guarda o resultado do processamento de contextos que se repetem, para que as requisições seguintes o reaproveitem diretamente, reduzindo custo e latência. |
| Escrita no cache | Grava pela primeira vez um contexto reutilizável no cache; o preço unitário costuma ser maior do que o de uma entrada comum. |
| Leitura do cache | Requisições seguintes acertam um cache já existente e são cobradas a um preço bem abaixo do de uma entrada comum. |
| TTL | Tempo de validade do cache; depois de expirar, é preciso gravar de novo. O Fable 5.2 oferece duas opções: 5 minutos e 1 hora. |
| Batch API | Forma de chamada voltada a tarefas assíncronas em lote, ideal para cenários que não precisam de resposta imediata e que podem aproveitar descontos. |
| Agent | Aplicação de modelo capaz de chamar ferramentas, ler e gravar arquivos e executar tarefas de várias etapas. |
| Protótipo jogável | Versão inicial do jogo usada para validar a jogabilidade e a viabilidade técnica, com conteúdo e nível de polimento limitados. |
| Shader | Pequeno programa executado na GPU que usa funções matemáticas para definir cor, iluminação e aparência dos materiais. |
| Geração procedural | Construir em tempo de execução modelos, texturas, sons e outros conteúdos por meio de regras e algoritmos, em vez de usar arquivos de assets já produzidos de antemão. |
| WebGL / Three.js | WebGL é a interface de renderização 3D que o navegador usa para chamar a GPU; Three.js é uma biblioteca JavaScript de gráficos 3D baseada nela. |
1 8 horas, 550 dólares: como nasceu um jogo 3D feito por IA
1.1 Condições do experimento: um comando, sem feedback humano
Felix Rieseberg deu ao modelo uma tarefa bem clara: criar um jogo de tiro em primeira pessoa de pequena escala, com um visual o mais próximo possível de um jogo AAA, e sem oferecer nenhum feedback humano posterior ao longo de todo o processo. No anúncio, ele destacou que queria testar justamente até onde o modelo conseguiria ir sem intervenção humana.
Aqui, “AAA” é a meta do experimento e uma analogia visual. AAA normalmente se refere a jogos comerciais de alto padrão, que exigem muito dinheiro e muita gente para serem produzidos; já Saltline é um protótipo jogável de pequena escala, com apenas uma fase de missão e voltado para a experiência para um jogador.
1.2 Conteúdo do jogo Saltline
O cenário de Saltline é um porto de contêineres numa noite de chuva, com armazéns, cais e pilhas de contêineres. O jogador precisa desativar três estações de retransmissão de sinal e evacuar; no caminho, encontra drones de patrulha aérea e cães mecânicos terrestres.
O jogo oferece deslocamento em primeira pessoa, controle de câmera, tiro, interação e objetivos de missão, além de chuva, iluminação, sons ambiente e efeitos de armas. A experiência também é leve: basta abrir o navegador para jogar, com suporte a teclado e mouse e a tela de toque; a página traz configurações de qualidade gráfica, e, se o desempenho cair, é possível alternar para a qualidade baixa.
1.3 Dados divulgados pelo desenvolvedor
Os dados a seguir vêm todos de informações públicas do próprio Felix Rieseberg no X; o espelho no GitHub também observa que esses números não foram auditados de forma independente por terceiros.
| Item | Valor declarado pelo desenvolvedor |
|---|---|
| Modelo | Claude Fable 5.2 |
| Tempo de desenvolvimento | cerca de 8 horas |
| Tokens de entrada | cerca de 445 milhões (com uso intensivo de cache) |
| Tokens de saída | cerca de 2,7 milhões |
| Custo estimado | cerca de 550 dólares (estimado com base no preço da API) |
| Forma de desenvolvimento | comando único, sem iterações de feedback humano |
| Tamanho do artefato | versão HTML autônoma com cerca de 1,43 MB (1.425.707 bytes) |
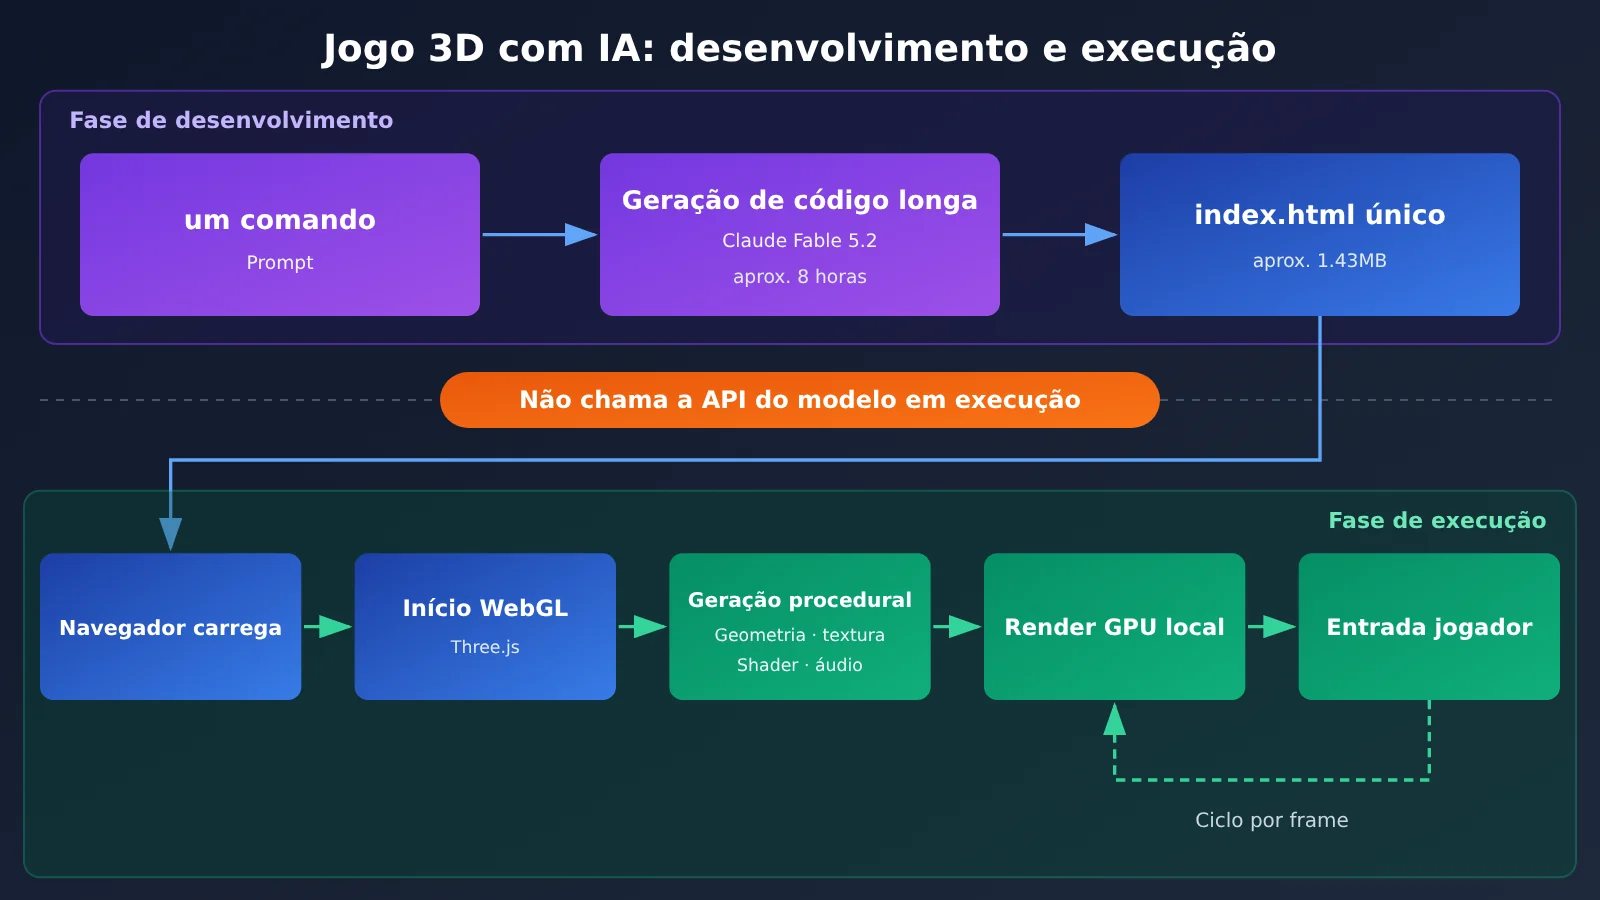
Os 550 dólares são o custo estimado de um experimento de geração com modelo. Depois que o arquivo do jogo é gerado, os jogadores o executam no navegador local e isso não dispara mais chamadas à API do Claude; por isso, esse valor não tem relação com a quantidade de jogadores.
2 O que a IA realizou no desenvolvimento deste jogo 3D
2.1 Todos os modelos e texturas são código
Em 10 de novembro, o desenvolvedor explicou melhor: os modelos, texturas e demais conteúdos do jogo são todos construídos a partir de código e Shaders gerados pelo Claude, e o projeto não tem imagens nem assets de modelos 3D avulsos. Nas palavras dele, “tudo é código, texturas e modelos são funções”.
Isso explica por que o Saltline tem apenas cerca de 1.43MB. Jogos tradicionais precisam distribuir uma grande quantidade de modelos, texturas e arquivos de efeito sonoro já prontos; o Saltline distribui as regras matemáticas que geram esses conteúdos, e o navegador, depois de ler o código, monta a cena em tempo real durante a execução.
2.2 As seis etapas reunidas em uma única tarefa de geração
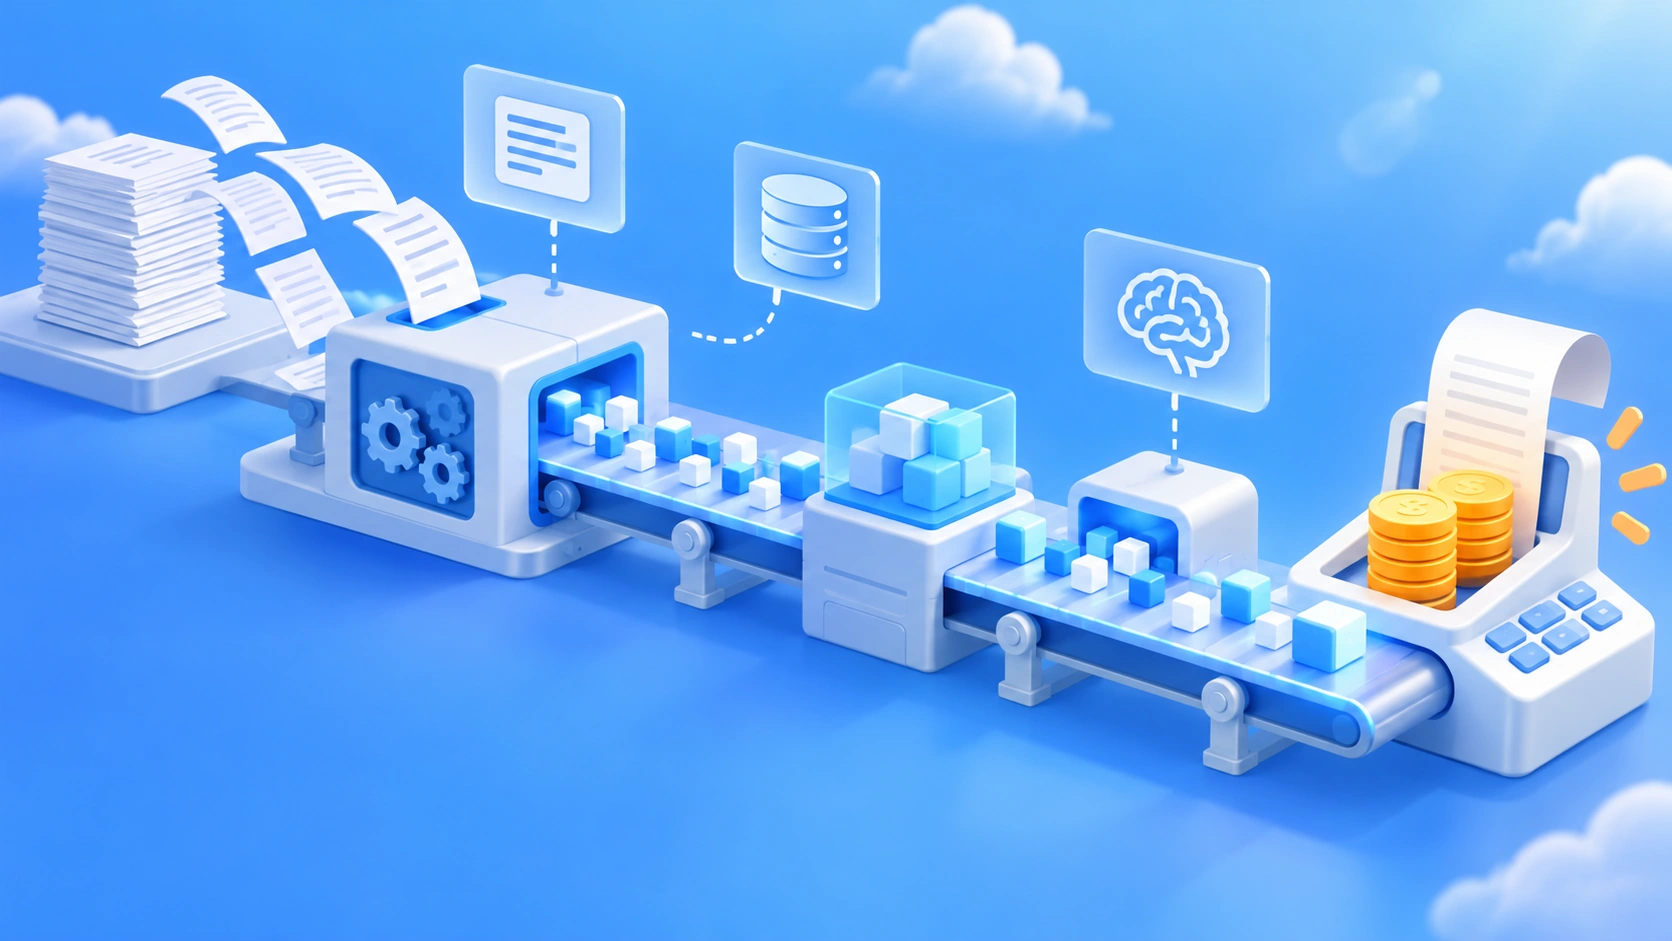
O desenvolvimento tradicional de jogos 3D costuma ser dividido entre funções diferentes: design, modelagem, materiais, programação, áudio e por aí vai. No Saltline, o modelo tratou, em sequência e dentro do mesmo projeto, as seguintes tarefas:
- Construção da cena: montagem procedural de estruturas como porto, armazéns e contêineres usando vértices e parâmetros geométricos.
- Lógica do jogo: objetivos de missão, comportamento dos inimigos, detecção de acerto de tiro e fluxo de extração.
- Modelos e texturas: geração de superfícies metálicas, manchas e variações de cor com ruído e funções matemáticas.
- Shader: cálculo na GPU de efeitos visuais como iluminação, materiais e reflexos de uma noite de chuva.
- Efeitos sonoros: som ambiente e sons de armas também gerados por programa.
- Interação do jogador: entrada por teclado e mouse e por toque na tela, controle de câmera e configurações de qualidade gráfica.
Essas etapas, que no fluxo de trabalho tradicional exigem passar por ferramentas e pessoas diferentes, no Saltline viraram módulos distintos dentro de um mesmo repositório de código. A capacidade de janela de contexto longa do modelo permite que ele leia continuamente o código e as soluções técnicas já existentes, garantindo que os módulos se encaixem uns nos outros.
2.3 Como o navegador executa este jogo
O Saltline segue o caminho da renderização local no navegador: a imagem é gerada no próprio dispositivo do jogador. O fluxo de execução é mais ou menos este:
- O navegador lê o arquivo HTML e começa a executar o JavaScript.
- Inicializa o ambiente de renderização Three.js e WebGL.
- O programa gera a geometria da cena, os materiais, as texturas e o som conforme o código.
- A GPU cuida da renderização gráfica, e o jogador controla o personagem por teclado/mouse ou pela tela de toque.
- A lógica do jogo é atualizada continuamente, e o navegador atualiza a imagem.
Arquivo pequeno e execução leve são duas coisas diferentes. Um código de 1.43MB pode criar uma enorme quantidade de geometrias e materiais durante a execução, e a carga de memória e de GPU depende da complexidade da cena. A página de demonstração independente também avisa: a inicialização pode demorar; se a tela de espera travar, vale checar o WebGL 2 e a aceleração de hardware do navegador, e, se houver engasgos, é possível mudar para a qualidade gráfica baixa.
3 Por que um jogo 3D de IA com 445 milhões de Tokens custou apenas US$ 550
3.1 O preço oficial do Claude Fable 5.2
O Fable 5.2 foi lançado em 9 de novembro de 2026, com janela de contexto de 1M Tokens e saída máxima de 128K Tokens. O preço padrão oficial é o seguinte:
| Item de cobrança | Preço por milhão de Tokens | Em relação à entrada normal |
|---|---|---|
| Entrada normal | $8 | 100% |
| Saída | $40 | 500% |
| Gravação de cache de 5 minutos | $10 | 125% |
| Gravação de cache de 1 hora | $16 | 200% |
| Leitura de cache | $0.20 | 2.5% |
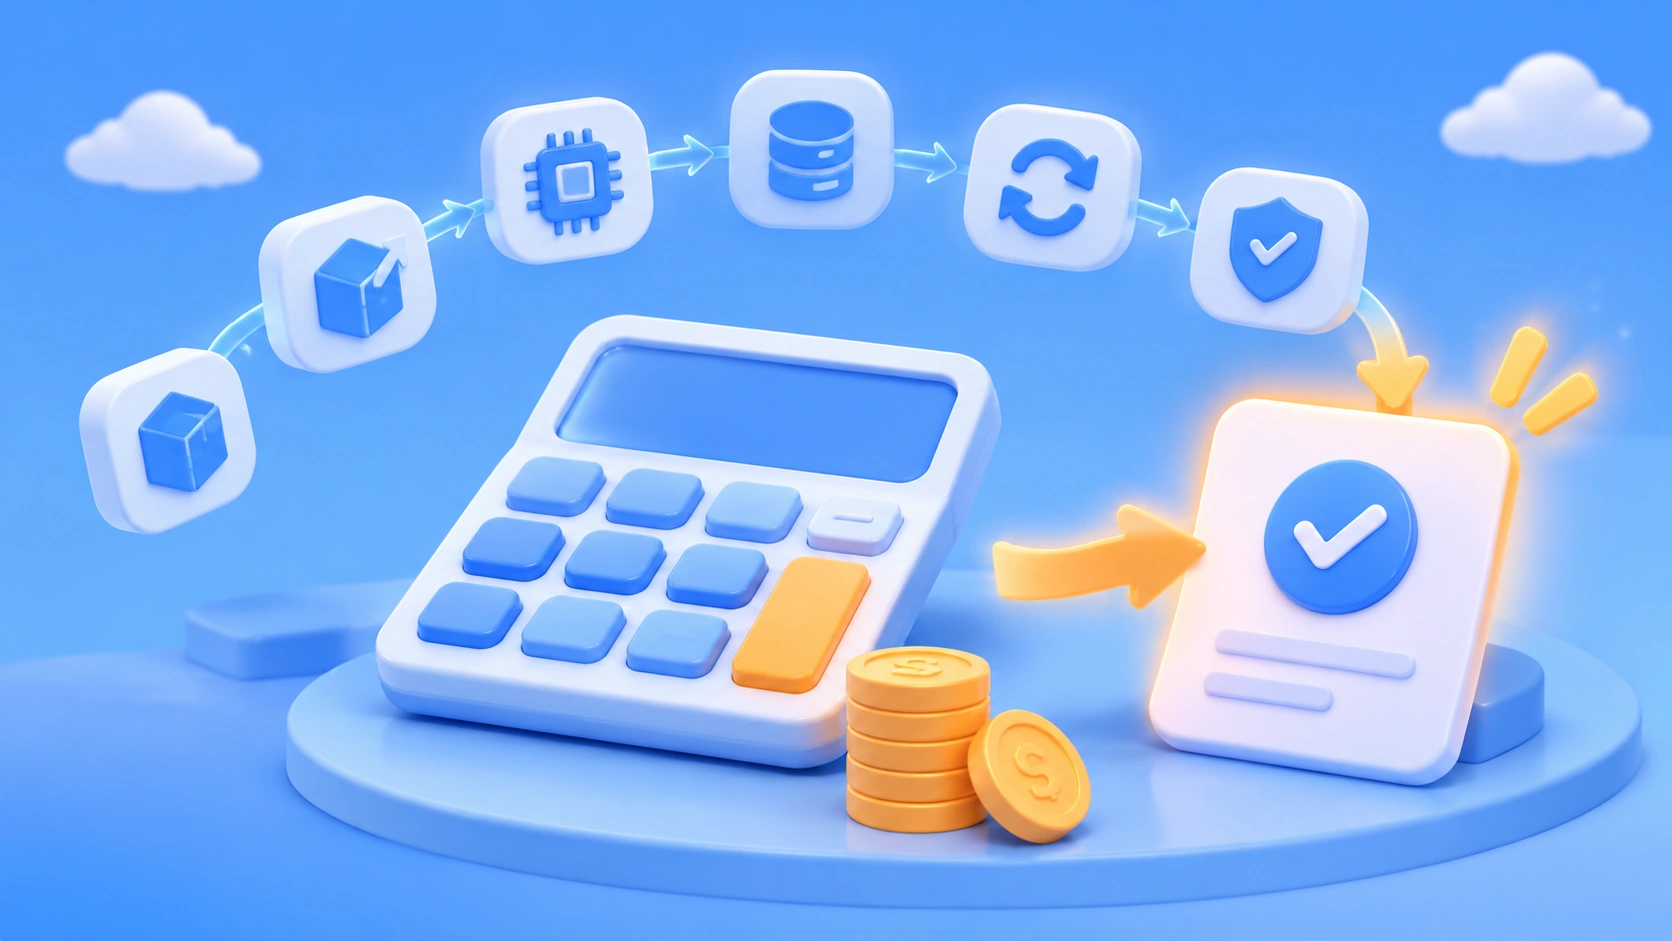
Além disso, no Fast Mode o preço de entrada é $16 e o de saída é $80 (por milhão de Tokens), e a empresa afirma que a velocidade de saída pode chegar a até 2,5 vezes a normal. O preço de leitura de cache é apenas 2,5% do da entrada normal — e é exatamente aí que está a chave para entender os US$ 550.
3.2 Custo teórico se cobrado como entrada normal
Se desconsiderarmos completamente o cache e simplesmente multiplicarmos a contagem de tokens divulgada pelo desenvolvedor pelo preço unitário padrão, o resultado fica muito longe dos US$ 550:
| Critério de cálculo | Custo de entrada | Custo de saída | Total |
|---|---|---|---|
| Tudo cobrado como entrada normal | 445 × $8 = $3,560 | 2.7 × $40 = $108 | $3,668 |
| Tudo cobrado como leitura de cache (piso teórico, sem contar gravação em cache) | 445 × $0.20 = $89 | 2.7 × $40 = $108 | $197 |
| Estimativa declarada pelo desenvolvedor | — | — | cerca de $550 |
Os dois cenários extremos delimitam um intervalo: um teto de cerca de $3,668 e um piso de cerca de $197. A estimativa de aproximadamente $550 relatada pelo desenvolvedor cai dentro desse intervalo e fica claramente mais próxima do piso, o que indica que uma parcela considerável da entrada foi cobrada pelo preço de leitura de cache.
Há ainda um detalhe que vale a pena observar: pelo preço padrão, 2,7 milhões de tokens de saída custam cerca de $108, o que representa aproximadamente um quinto da estimativa de $550. O volume de entrada é mais de cem vezes o de saída, mas, com o mecanismo de cache, o custo de saída ainda responde por uma fatia nada desprezível.
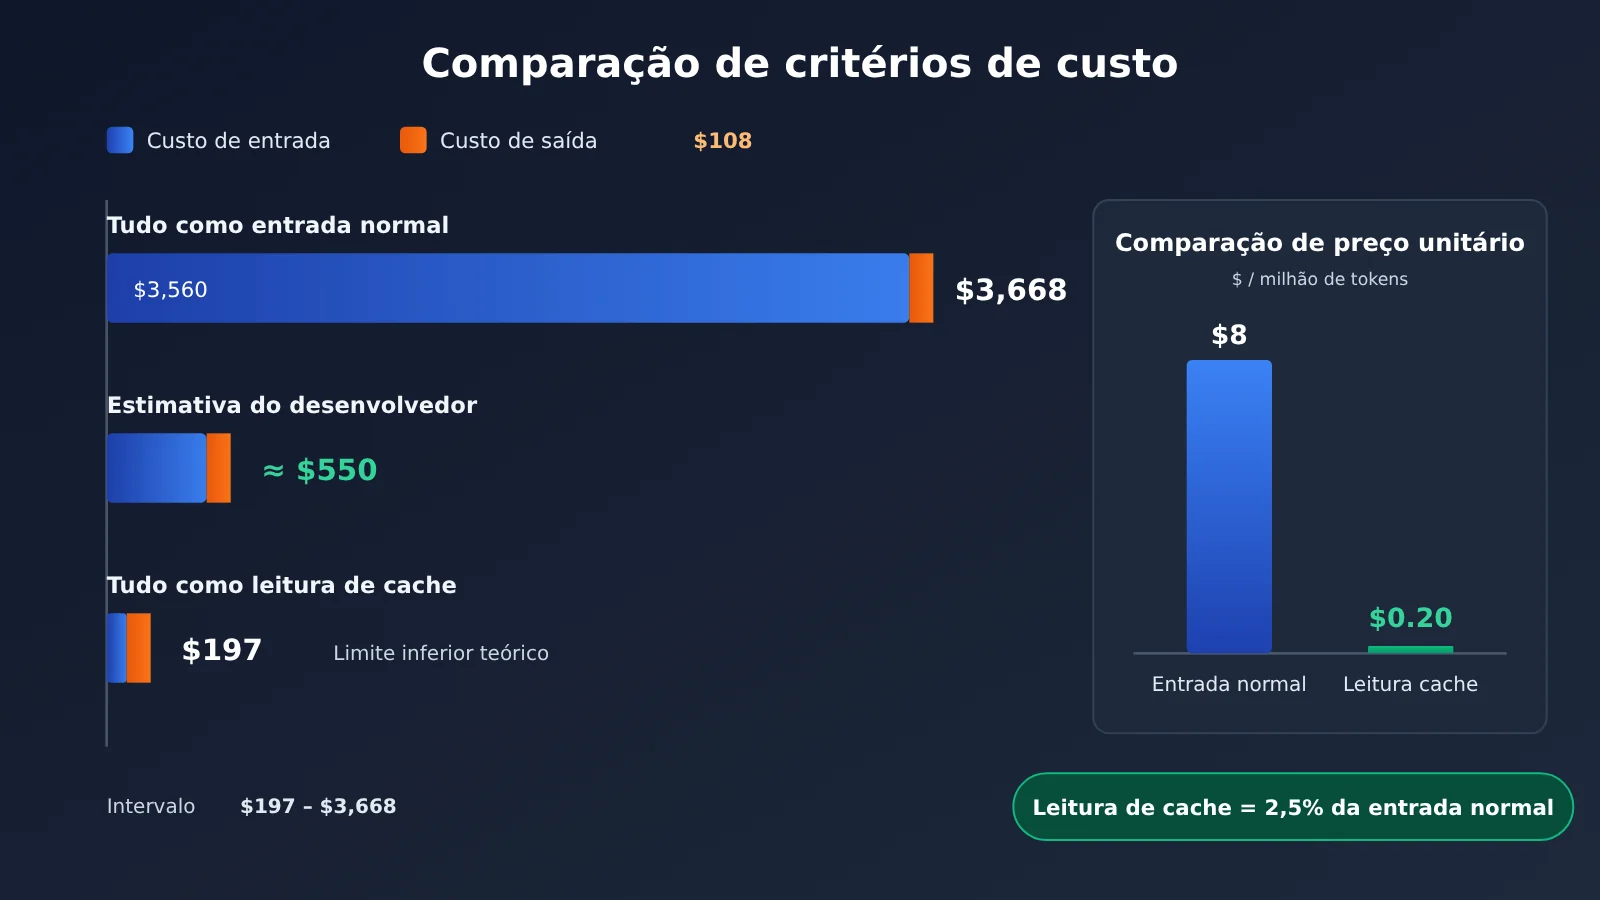
Você pode usar a comparação de preços unitários do gráfico acima diretamente nas suas próprias tarefas de Agent para fazer uma estimativa. Se quiser primeiro validar, com uma tarefa de pequena escala, o impacto dos acertos de cache na fatura, é possível usar a mesma chave API na APIYI apiyi.com para chamar vários modelos, como o Claude, e comparar os detalhes de uso para observar como os custos mudam com diferentes estratégias de contexto.
3.3 Por que o cache reduz tanto o custo de programação de longa duração
Em processos de programação com IA longos e com múltiplas rodadas, o modelo precisa reler, a cada rodada, uma grande quantidade de conteúdo idêntico: contexto do projeto, estrutura de arquivos, código existente, normas de desenvolvimento e soluções técnicas definidas anteriormente. Um processo de geração de 8 horas significa que esse contexto é reenviado repetidamente, e é daí que vem o volume acumulado de 445 milhões de tokens de entrada.
O Prompt Caching armazena esses prefixos repetidos e, quando há acerto no cache, cobra pela leitura do cache. A fatura completa de cache é determinada por três partes:
- Gravação no cache (Cache Write): a primeira gravação custa mais que uma entrada normal — 1,25 vez no nível de 5 minutos e 2 vezes no nível de 1 hora.
- Leitura do cache (Cache Read): nos acertos seguintes, custa apenas 2,5% do preço.
- Expiração do cache (TTL): após o prazo de validade, é preciso gravar de novo e pagar novamente pela gravação.
Portanto, escolher qual nível de TTL, se a estrutura do contexto é estável e o intervalo entre duas requisições influenciam o custo final. Alterar com frequência o conteúdo no início do contexto invalida o cache e, na prática, aumenta o custo de gravação.
3.4 Até onde os dados públicos permitem recalcular
Os materiais públicos atuais fornecem o total de entrada, o total de saída e uma estimativa do preço total, mas não trazem o detalhamento completo da fatura. Os seguintes dados-chave não foram divulgados:
- quantidade de tokens de entrada normal, gravação no cache e leitura do cache, separadamente;
- uso de cache de 5 minutos e de cache de 1 hora, separadamente;
- se existem outros custos de chamadas de API.
Como a gravação no cache tem dois preços, há mais incógnitas do que equações conhecidas, e apenas com esses três números não é possível deduzir uma taxa única de acerto no cache. O que dá para afirmar é: os 550 dólares ficam dentro do intervalo teórico acima, e o cache foi o principal fator de redução de custo nesse experimento.
4 Como calcular o custo real de uma tarefa de programação com IA
4.1 Estrutura de custos em três camadas
Ao discutir “quanto custa em IA para criar um jogo”, é preciso primeiro deixar claro qual camada de custo está sendo considerada. Os 550 dólares do Saltline cobrem apenas a primeira camada.
| Camada de custo | Conteúdo incluído | O Saltline considera? |
|---|---|---|
| Custo de invocação do modelo | Entrada, saída, escrita e leitura de cache, descontos de processamento em lote, chamadas de ferramentas | Sim (cerca de 550 dólares, estimativa do desenvolvedor) |
| Custo de execução do desenvolvimento | Design de tarefas, depuração e testes, ambiente de execução, repositório de código, recursos externos, tempo de pessoal | Não divulgado |
| Custo operacional do produto | Hospedagem, tráfego de CDN, banco de dados, serviços online, manutenção contínua | Não incluído |
A estrutura de um jogo web local faz com que seu custo de IA se concentre na fase de desenvolvimento, ficando a renderização a cargo do dispositivo do jogador. Em comparação, jogos em nuvem e modelos de mundo em tempo real com IA geram continuamente custos de computação no servidor a cada partida do jogador, e as curvas de custo dos dois tipos de produto são completamente diferentes.
4.2 Em quais etapas o Batch API se aplica
A API oficial da Claude oferece o Batch API, que concede 50% de desconto em entradas e saídas de processamento em lote elegíveis. Ele é adequado para geração de código não em tempo real, processamento de conteúdo em lote e avaliação offline — por exemplo, gerar configurações para vários níveis de uma só vez ou executar revisões de código em lote.
Desenvolvimento no estilo agente, como o Saltline, precisa decidir a próxima ação com base no resultado da etapa anterior; trata-se de um fluxo serial fortemente interativo, difícil de encaixar diretamente no desconto de processamento em lote. Em projetos reais, a abordagem mais viável é dividir: o loop principal de desenvolvimento usa cache para reduzir custos, e as subtarefas offline que podem ser paralelizadas são delegadas ao Batch API.
4.3 Estimar sua conta de programação com IA usando código
O exemplo minimalista abaixo demonstra como fazer uma chamada através da interface compatível com OpenAI e ler os campos de uso retornados, como ponto de partida para o cálculo de custos:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # Substitua pelo nome de um modelo da lista da plataforma, como Claude
    messages=[{"role": "user", "content": "用 Three.js 写一个旋转的立方体"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Registre prompt_tokens / completion_tokens para o cálculo de custos
Ver implementação completa: estimador de custos com critério de cache
import openai
from dataclasses import dataclass

# Preços oficiais padrão do Claude Fable 5.2 (USD / milhão de tokens)
PRICE = {
    "input": 8.0,
    "output": 40.0,
    "cache_write_5m": 10.0,
    "cache_write_1h": 16.0,
    "cache_read": 0.20,
}

@dataclass
class Usage:
    input_tokens: float = 0        # Entrada normal
    cache_write_5m: float = 0      # Escrita de cache de 5 minutos
    cache_write_1h: float = 0      # Escrita de cache de 1 hora
    cache_read: float = 0          # Leitura de cache
    output_tokens: float = 0       # Saída

def estimate_cost(u: Usage) -> float:
    """Soma cada item de cobrança separadamente, unidade: dólar"""
    m = 1_000_000
    return (
        u.input_tokens / m * PRICE["input"]
        + u.cache_write_5m / m * PRICE["cache_write_5m"]
        + u.cache_write_1h / m * PRICE["cache_write_1h"]
        + u.cache_read / m * PRICE["cache_read"]
        + u.output_tokens / m * PRICE["output"]
    )

# Reproduz os dois limites teóricos do texto (total de tokens informado pelo desenvolvedor)
upper = estimate_cost(Usage(input_tokens=445e6, output_tokens=2.7e6))
lower = estimate_cost(Usage(cache_read=445e6, output_tokens=2.7e6))
print(f"全部普通输入:${upper:,.0f}")   # cerca de $3,668
print(f"全部缓存读取:${lower:,.0f}")   # cerca de $197

# Acumule o uso real no seu próprio projeto
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_step(messages, model="YOUR_MODEL_NAME"):
    resp = client.chat.completions.create(model=model, messages=messages)
    usage = resp.usage
    print("prompt:", usage.prompt_tokens, "completion:", usage.completion_tokens)
    return resp.choices[0].message.content
O estimador soma os cinco itens de cobrança separadamente, e você pode inserir diretamente os detalhes de uso do seu próprio projeto. Cada plataforma pode retornar os campos de cache de forma diferente; ao integrar, baseie-se na estrutura de usage da resposta real.
🚀 Dica para começar rápido: antes de colocar tarefas de agente de longa duração em desenvolvimento formal, recomendamos primeiro resgatar o crédito gratuito de teste para novos usuários em APIYI apiyi.com, percorrer o ciclo “gerar — executar — corrigir” com uma pequena cena Three.js, registrando o uso de tokens em cada rodada, e então usar o estimador acima para projetar o orçamento do projeto completo.
5 Onde ficam os limites do desenvolvimento independente de jogos 3D com IA
5.1 Protótipo jogável e jogo comercial maduro
O Saltline provou que o modelo consegue entregar, sem nenhuma intervenção humana, um jogo completo e jogável em pequena escala: tem cenários, inimigos, missões e apresentação audiovisual. Um jogo comercial maduro, porém, ainda exige muito conteúdo de níveis, ajustes de balanceamento ao longo do tempo, adaptação a várias plataformas, localização, anti-cheat e testes com um grande número de usuários — nada disso entrou num experimento único.
O “几猫·国产3A大作” que circulou nas redes sociais chinesas é, na verdade, a versão em chinês — ou uma versão reembalada — do Saltline. “国产3A大作” (“grande produção AAA nacional”) foi só o nome usado na divulgação; o desenvolvimento continua atribuído a este experimento com o Fable 5.2.
5.2 Geração em uma passada só e manutenção contínua
A geração em uma única passada resolve o “de zero a um”. Depois que o jogo vai ao ar, a iteração de versões, a correção de bugs e a adição de conteúdo exigem que o modelo ou o desenvolvedor mexam repetidamente no código que já existe. A escala de contexto para manutenção de longo prazo cresce sem parar, e a estratégia de cache e a forma de organizar o código passam a pesar muito mais no custo futuro.
5.3 Funcionalidade pronta e otimização de desempenho
Ter funcionalidade e rodar fluido são dois objetivos de engenharia independentes. A página de demonstração do Saltline oferece opção de qualidade gráfica baixa e avisa para verificar WebGL 2 e aceleração de hardware — justamente porque o desempenho ainda depende do dispositivo do jogador e das capacidades do navegador. A documentação oficial da Unity também aponta limitações da plataforma Web em sistema de arquivos, threads, memória e suporte a dispositivos móveis; otimizar o desempenho no navegador para jogos complexos continua sendo difícil.
5.4 Encarar o Saltline como experimento representativo
O valor do Saltline está em oferecer um ponto de referência claro: com um modelo de contexto longo razoavelmente capaz, uso sensato de cache e um objetivo único e bem definido, o custo de invocação do modelo para gerar de uma vez um protótipo 3D para navegador fica na casa das centenas de dólares. As 8 horas e os 550 dólares vêm do relato do próprio desenvolvedor sobre um experimento único; os resultados de outros desenvolvedores variam conforme o design do comando, a complexidade da tarefa, a estratégia de cache e a versão do modelo.
A plataforma de terceiros AI8Games reuniu uma leva de jogos de navegador gerados com a participação de modelos como o Claude Fable 5.2; na consulta aparecem 62 jogos jogáveis e 27 trabalhos em formato de vídeo. São dados organizados por terceiros: mostram que esse tipo de experimento está crescendo, mas não representam estatísticas oficiais.
💡 Dica de escolha: modelos diferentes variam bastante em geração de código de longa duração, preço de cache e preço unitário de saída, e a mesma tarefa de protótipo de jogo pode render faturas totais várias vezes maiores ou menores dependendo do modelo escolhido. Vale a pena comparar, no APIYI apiyi.com, a qualidade do resultado e o consumo de tokens de alguns modelos populares usando o mesmo comando, e só então decidir qual usar no desenvolvimento de verdade.
6 Perguntas frequentes sobre o experimento de jogo 3D com IA
P1: Os 550 dólares do Saltline são uma fatura realmente paga?
Trata-se de uma estimativa feita por Felix Rieseberg com base no preço da API, sem auditoria de terceiros. As informações públicas também não trazem o uso separado de entrada comum, gravação em cache e leitura de cache, portanto não é possível reconstruir com precisão a estrutura da fatura.
P2: Por que 445 milhões de tokens de entrada custaram tão pouco?
A programação de longo percurso reenvia repetidamente o mesmo contexto do projeto; quando esses trechos acertam o cache, são cobrados a US$ 0,20 por milhão de tokens, apenas 2,5% do valor de US$ 8 da entrada comum. Se tudo fosse calculado como entrada comum, daria cerca de 3668 dólares; a estimativa do desenvolvedor ficou em cerca de 550 dólares, e a diferença vem principalmente do cache.
P3: Cada partida do jogador gera custos de chamada de IA?
Não. Depois de gerado, o Saltline é um arquivo HTML de cerca de 1,43 MB; o jogo roda localmente no navegador do jogador, renderizado pela GPU do seu dispositivo, e o processo de execução não chama a API do modelo. Os 550 dólares são um custo único da fase de desenvolvimento.
P4: Como reutilizar esse tipo de geração de código de longo percurso no meu próprio projeto?
O essencial é fazer o modelo trabalhar continuamente sobre uma estrutura de contexto estável: coloque a especificação, a solução técnica e a estrutura de arquivos na parte fixa inicial do comando, para facilitar o acerto do cache; registre o uso (`usage`) a cada rodada para estimar o orçamento. Você pode primeiro executar um cenário pequeno com a cota gratuita em APIYI apiyi.com, confirmar que o cache e as estatísticas de uso correspondem ao esperado e só então ampliar a escala da tarefa.
P5: Um desenvolvedor consegue reproduzir um jogo parecido com o mesmo orçamento?
O resultado varia conforme o comando, a complexidade do objetivo, a estratégia de cache e a escolha do modelo. O Saltline é um experimento único bem-sucedido, adequado como referência de ordem de magnitude. Para o orçamento real, recomenda-se extrapolar a partir do uso real de um teste em pequena escala; pela interface unificada do APIYI apiyi.com, é possível alternar entre diferentes modelos no mesmo código, o que facilita a comparação horizontal de custos.
P6: Qual é a diferença entre o Saltline e jogos gerados por IA como o Genie 3?
O Saltline é IA escrevendo código, com o código rodando no navegador; as regras do jogo já são definidas de antemão e as imagens são renderizadas pela GPU local. Já os modelos de mundo como Genie 3, Muse e Oasis prevêem a próxima imagem em tempo real com base no estado atual e na entrada do jogador, exigindo inferência contínua, e cada partida gera custo de computação. As duas rotas têm estruturas de custo e limitações técnicas completamente diferentes.
7 Conclusão: como interpretar os números de 550 dólares e 8 horas
O experimento da Saltline revela três pontos:
- A IA consegue integrar várias etapas do desenvolvimento de jogos em uma única geração de código: cenário, lógica, modelos, texturas, shaders, efeitos sonoros e interação são entregues na forma de código, e o resultado final é um jogo de navegador em arquivo único, com cerca de 1.43MB.
- O cache determina a viabilidade econômica da programação com IA de longa duração: 445 milhões de tokens de entrada custariam cerca de 3668 dólares pelo preço normal; a estimativa relatada pelo desenvolvedor fica em torno de 550 dólares, e o preço unitário de 2,5% para leitura de cache é a variável decisiva.
- Os 550 dólares cobrem apenas o custo de invocação do modelo: a execução do desenvolvimento, a operação do produto e a manutenção posterior ficam fora desse valor. A Saltline é um experimento representativo de protótipo jogável.
Se você pretende delegar ao Agent tarefas de desenvolvimento de longa duração semelhantes, a preparação mais eficaz é criar antes o hábito de contabilizar custos: registrar separadamente o consumo de entrada, de cache e de saída, e então estimar o orçamento com base em dados reais. Recomendamos validar os resultados rapidamente pela APIYI apiyi.com, que oferece interface compatível com OpenAI, invocação unificada de múltiplos modelos e cota gratuita de teste para novos usuários.
Referências
- Página de experiência independente da Saltline: demonstração do jogo e perguntas frequentes
- Link:
saltline.games -
Descrição: inclui informações de experiência como inicialização, configuração de qualidade gráfica e controles; a versão em chinês está em
saltline.games/zh -
Post original de Felix Rieseberg: fonte dos dados de tempo de desenvolvimento, tokens e custos
- Link:
x.com/felixrieseberg/status/2119925633564463609 -
Descrição: dados em primeira mão, segundo o próprio desenvolvedor
-
Espelho do código da Saltline e README: dados dos arquivos e atribuição dos dados
- Link:
github.com/realcodebear/saltline-fable-5.2 -
Descrição: indica que os números em questão não passaram por auditoria independente de terceiros
-
Repositório GitHub da versão chinesa de 几猫 (Jimao): arquivo da versão difundida no país
- Link:
github.com/Megasu/jimao-3a-game -
Descrição: traz o tamanho do arquivo index.html e instruções para execução offline
-
Especificações e preços do modelo Claude Fable 5.2: documentação oficial da Anthropic
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Descrição: preços unitários oficiais de entrada, saída, escrita e leitura de cache
-
Documentação oficial do Three.js: biblioteca de gráficos 3D para navegador
- Link:
threejs.org/docs -
Descrição: material básico para entender como a cena da Saltline é construída
-
Visão geral técnica do Unity WebGL: limitações da plataforma web
- Link:
docs.unity.cn/6000.0/Documentation/Manual/webgl-technical-overview.html - Descrição: restrições de jogos de navegador quanto a threads, memória e dispositivos móveis
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com