작성자 주: Alphabet은 자사 모델 API가 분당 약 320억 토큰을 처리한다고 밝혔어요. 이 글에서는 공식 가격, 독립 평가, 비용 시뮬레이션을 바탕으로 Gemini 4 Argon, 3.8 Flash, 3.5 Flash-Lite를 비교하고, 성공 기준을 충족한 작업 하나당 총비용을 계산해 봅니다.
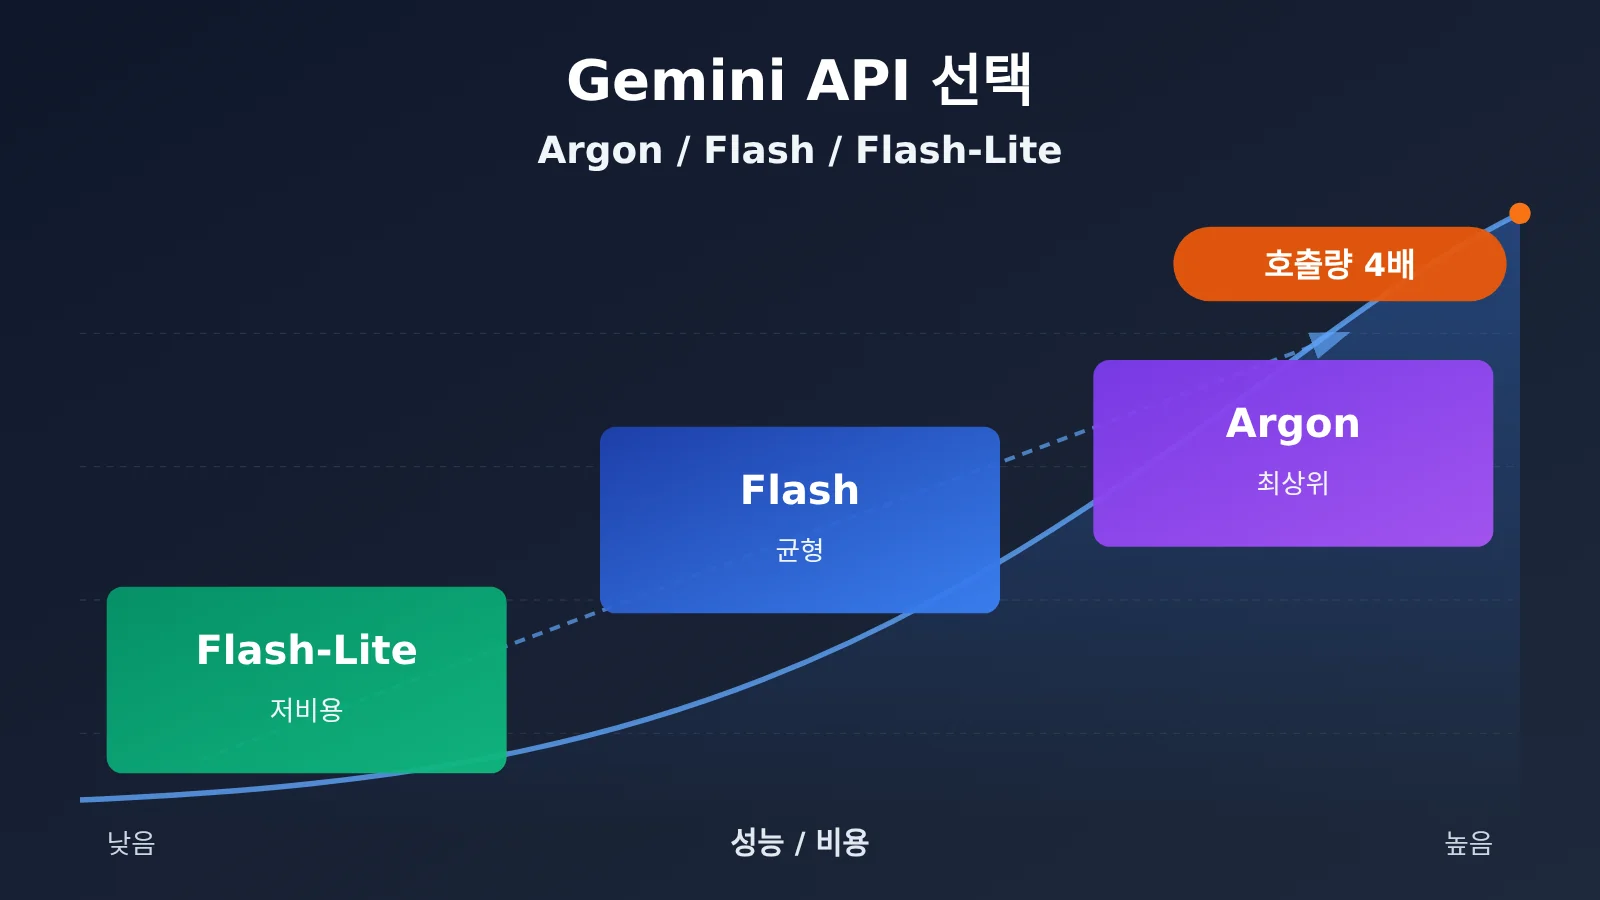
2026년 10월 28일, Alphabet CEO Sundar Pichai는 3분기 실적 발표에서 자사 모델 API가 현재 분당 약 320억 토큰을 처리하며, 전년 동기 대비 4배 이상 증가했다고 밝혔어요. 이 수치는 개발자와 기업의 Gemini API 전체 사용량을 보여주며, 특정 모델 하나의 성과를 뜻하는 것은 아닙니다.
이 글은 무조건 가장 강력한 모델을 추천하는 글이 아니에요. 호출량이 늘어나면 비용과 모델 선택의 영향도 그만큼 커집니다. 모델 등급을 잘못 선택하면 월 청구액이 몇 배로 달라질 수 있고, 성능이 부족해 재시도를 반복하다 보면 오히려 비용이 더 들 수도 있어요.
이 글에서 얻을 수 있는 것: Gemini 모델인 Argon, Flash, Flash-Lite의 성능, 가격, 속도와 적합한 활용 사례를 비교합니다. 직접 따라 할 수 있는 업무 테스트 방법도 소개하므로, 모델을 선택하는 데 참고할 수 있어요.
Gemini API 호출량 급증: 핵심 정보 한눈에 보기
| 항목 | 내용 |
|---|---|
| 발표일 | 2026년 10월 28일(Alphabet 2026년 3분기 실적 발표) |
| 발표자 | Alphabet CEO Sundar Pichai |
| 핵심 데이터 | 자사 모델 API가 분당 약 320억 토큰을 처리하며, 공개된 이전 분기 수치보다 약 40% 증가하고 전년 대비 4배 이상 성장 |
| 현재 주력 API 모델 | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| 영향 범위 | Gemini Developer API로 애플리케이션을 구축하는 모든 개발자와 기업 |
분당 320억 토큰이 Gemini API 개발자에게 의미하는 것
사용량이 급증했다는 건 모델이 실제 운영 환경에 대규모로 도입됐다는 뜻이에요. 하지만 모든 프로젝트에서 가장 비싼 플래그십 모델을 써야 한다는 의미는 아니에요. 모델을 선택할 때는 작업 복잡도, 출력 품질 요구사항, 요청량, 응답 속도, 토큰 소비량, 비즈니스의 오류 허용 범위, 긴 컨텍스트와 도구 호출의 필요성, 향후 가격 변동까지 고려해야 해요.
특히 이 글에서 Flash는 Gemini 3.8 Flash를, Flash-Lite는 Gemini 3.5 Flash-Lite를 가리켜요. 이전 버전인 Gemini 2.5 Flash 시리즈와 혼동하지 마세요. 또 전 세계 호출량이 아무리 많아도 개인 개발자의 할당량이 무제한이라는 뜻은 아니에요. 호출 제한은 뒤에서 따로 살펴볼게요.
Argon, Flash, Flash-Lite: Gemini 모델 3종의 포지셔닝
Google은 비용과 성능에 따라 세 가지 등급의 모델을 제공해요. 아래 표는 공식 모델 사양 페이지를 바탕으로 정리한 내용이에요.
| 항목 | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| API ID | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| 공식 포지셔닝 | 플래그십 추론 모델 | 효율과 성능의 균형 | 낮은 지연 시간, 저비용, 높은 처리량 |
| 컨텍스트 윈도우 | 약 100만 토큰 | 입력 1,048,576토큰 | 입력 1,048,576토큰 |
| 기본 최대 출력 | 65,536토큰(긴 출력 메커니즘으로 확장 가능) | 65,536토큰 | 65,536토큰 |
| 사고 수준 | low / medium / high, 기본값 medium | low / medium / high, 기본값 medium | minimal / low / medium / high, 기본값 minimal |
| 도구 기능 | 함수 호출, 구조화된 출력, Search Grounding, 코드 실행 | 함수 호출, 구조화된 출력, 코드 실행, 파일 검색, Search Grounding | 구조화된 출력, 함수 호출, 캐싱 |
| 입력 모달리티 | 텍스트, 이미지, 오디오, 동영상, PDF | 텍스트, 이미지, 오디오, 동영상, PDF | 텍스트, 이미지, 오디오, 동영상, PDF |
| 무료 API 계층 | 제공하지 않음 | 제한적인 무료 계층 | 제한적인 무료 계층 |
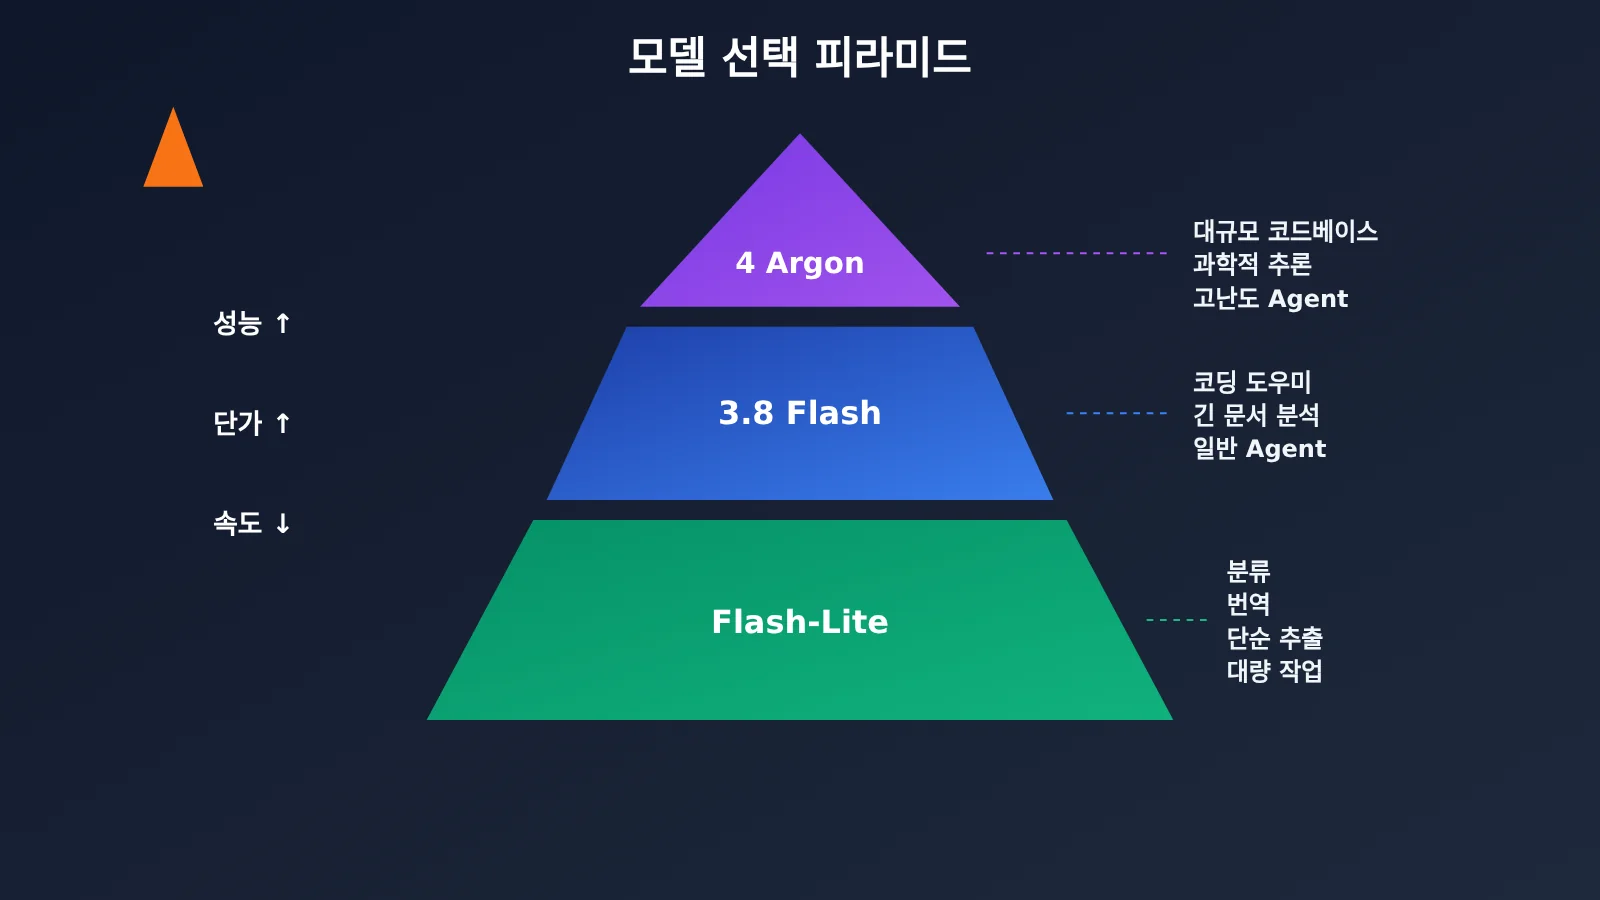
Gemini 모델 3종의 성능 범위
Argon은 2026년 10월 13일에 정식 출시됐으며, 주로 복잡한 소프트웨어 엔지니어링, 수학·과학 추론, 자율적인 다단계 Agent와 긴 출력 생성에 적합해요. 긴 출력 기능은 별도의 메커니즘과 실행 설정이 필요하므로, 모든 요청에서 100만 토큰을 바로 반환할 수 있는 것은 아니에요.
3.8 Flash도 추론 능력을 갖추고 있어요. 단순히 “생각하지 못하는 저렴한 버전”은 아니에요. 일반적인 코딩 어시스턴트, 긴 문서 분석, 콘텐츠 작성, 에이전트 워크플로에 적합해요. 2026년 7월 21일 출시된 3.5 Flash-Lite는 분류, 번역, 간단한 추출, 문서 파싱, Agent 내부의 간단한 하위 작업에 최적화됐어요. 어느 정도의 코딩과 추론 작업도 처리할 수 있지만, 고성능 모델과 비교하면 주로 복잡한 작업에서의 성능, 안정성, 비용 대비 효용에 차이가 있어요.
Gemini API 공식 가격: Argon, Flash, Flash-Lite의 비용 차이
다음은 Gemini Developer API 표준 유료 요금제의 공식 가격이에요. 단위는 미국 달러/100만 토큰이며, 서드파티 플랫폼의 추가 요금, 기업 계약 및 도구 호출 비용은 포함하지 않아요.
| 모델 | 입력 | 출력 | 캐시 적중 입력 | 가격 유효 기간 |
|---|---|---|---|---|
| Gemini 4 Argon(현재) | $2.00 | $10.00 | $0.10 | 2026-11-30까지 |
| Gemini 4 Argon(조정 후) | $4.00 | $20.00 | $0.20 | 2026-12-01부터 |
| Gemini 3.8 Flash(현재) | $0.75 | $3.75 | $0.075 | 2026-12-31까지 |
| Gemini 3.8 Flash(조정 후) | $1.50 | $7.50 | $0.15 | 2027-01-01부터 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | 공식적으로 가격 인상일 미표기 |
현재 가격을 기준으로 Argon의 입력 단가는 Flash의 약 2.67배, Flash의 입력 단가는 Flash-Lite의 2.5배예요. Argon의 출력 단가는 Flash-Lite의 4배이고요. Argon과 Flash는 현재 프로모션 가격이 적용 중이며, 각각 2026년 11월 30일과 12월 31일에 종료된 후 단가가 두 배로 올라요. 장기 프로젝트의 연간 예산을 세울 때는 반드시 조정 후 가격으로 계산해야 해요.
놓치기 쉬운 세부 사항도 있어요. Google은 모델 내부의 사고 토큰도 출력 요금에 포함해요. 사용자가 볼 수 있는 답변의 길이만으로 요금이 결정되는 게 아니며, 사고 수준을 높게 설정하면 출력 비용이 크게 늘어날 수 있어요. 실시간 응답이 필요하지 않은 작업이라면 Batch API를 사용할 수 있어요. 세 모델 모두 입력과 출력 단가가 표준 가격보다 50% 저렴하지만, 실행 방식과 대기열 제한은 실시간 요청과 달라요.
Gemini 모델 3종의 독립 벤치마크 및 속도 비교
다음 데이터는 독립 제3자 평가 플랫폼인 Artificial Analysis의 결과예요. 모두 Intelligence Index v5.0 체계를 기준으로 했으며, 이전 버전인 v4.x 점수는 포함하지 않았어요.
| 지표 | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| 종합 능력 지수 v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| 관측된 출력 속도 | 초당 약 80여 토큰 | 초당 약 120~140토큰 | 초당 약 400여 토큰 |
| 이용 가능한 채널 | Google 공식 API, APIYI apiyi.com | Google 공식 API, APIYI | Google 공식 API, APIYI |
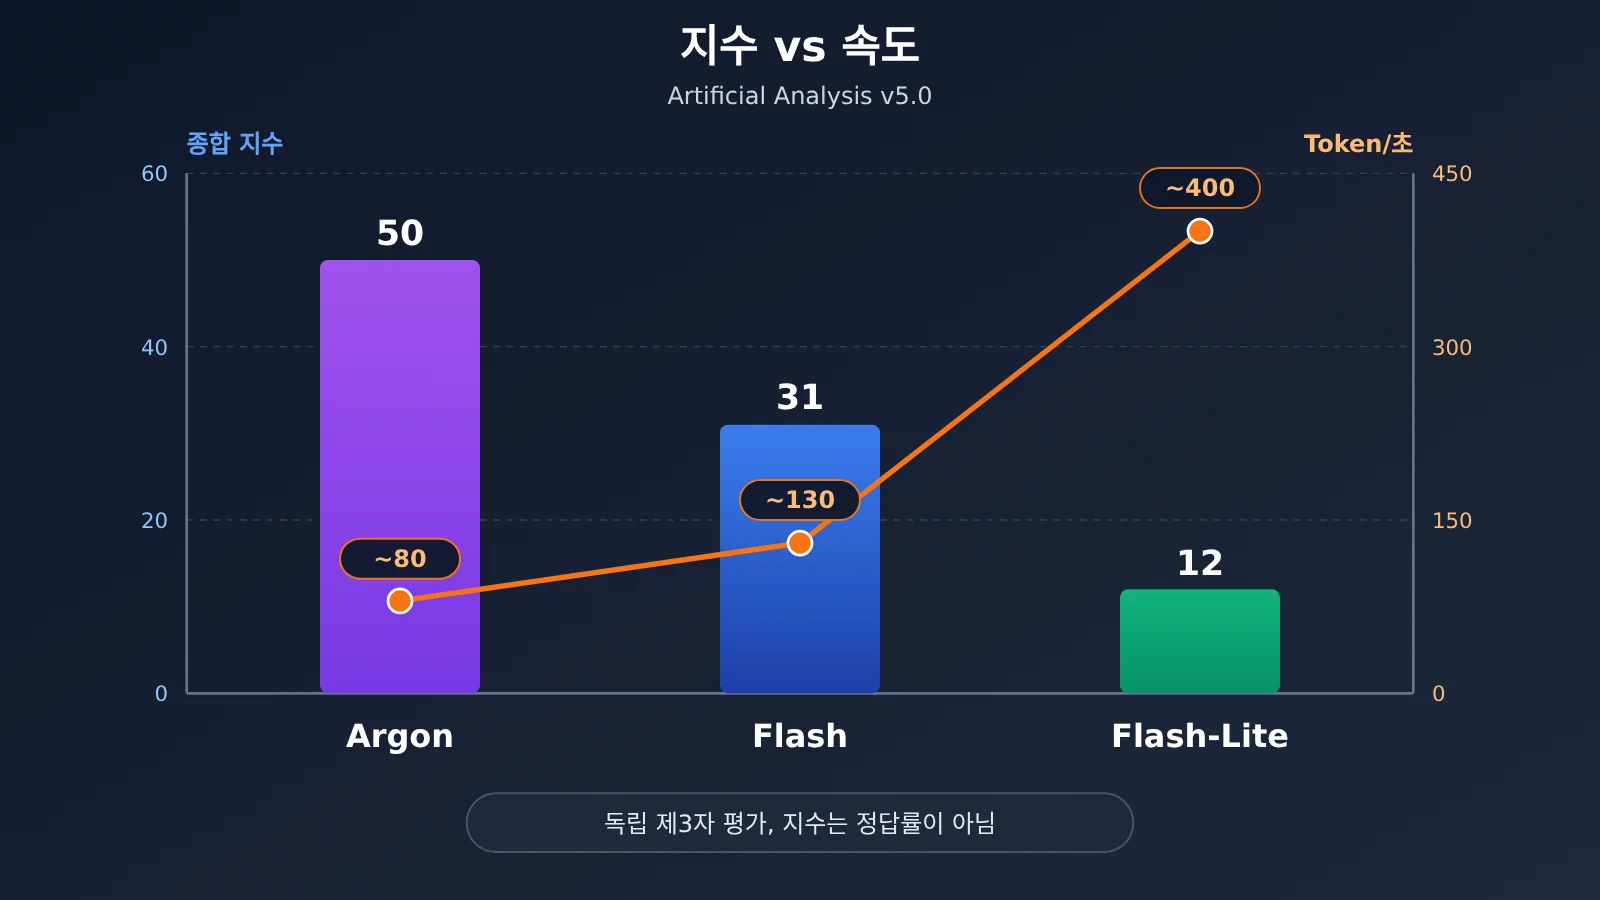
이 데이터를 올바르게 이해하려면 세 가지를 주의해야 해요.
- 지수는 정답률이 아니에요: 50, 31, 12는 평가 체계 내부의 지수 점수로, “50%를 맞혔다”는 뜻이 아니에요.
- 복잡한 작업에서는 성능 차이가 뚜렷해요: 복잡한 프로그래밍과 자동화 벤치마크에서는 Argon이 가장 뛰어나고, Flash가 중간, Flash-Lite가 그 뒤를 이어요. 그렇다고 Argon이 모든 단순 업무에서도 더 낫다는 뜻은 아니에요. 분류나 형식 정리 같은 작업에는 세 모델 모두 충분할 수 있어요.
- 속도를 바로 소요 시간으로 환산할 수는 없어요: 처리 속도는 서비스 상태에 따라 달라져요. 실제 소요 시간은 추론 시간, 첫 토큰 지연, 도구 호출, 대기열, 네트워크 변동의 영향도 받아요.
💡 비교 시 참고하세요: 벤치마크 점수는 모델 성능의 대략적인 차이만 보여줘요. 최종 판단 기준은 실제 업무에서의 성과예요. APIYI apiyi.com에서 하나의 API 키로 Gemini 모델 3종을 전환하며 직접 준비한 샘플로 비교해 볼 수 있어요.
Gemini API 비용 시뮬레이션: Argon, Flash, Flash-Lite의 요금 차이는?
아래는 이론적인 예시이며, 실제 청구 내역이 아니에요. 출력 토큰에 모든 사고 토큰이 포함되어 있다고 가정하고, 캐시·검색 도구·재시도 비용을 제외해 2026년 10월 표준 요금으로 계산했어요.
| 시나리오 | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 하루 1,000회, 회당 입력 5,000 / 출력 1,000토큰(일일 비용) | $20.00 | $7.50 | $4.00 |
| A: 위 조건으로 30일 연속 사용 | 약 $600 | 약 $225 | 약 $120 |
| B: 10만 건 분류, 건당 입력 1,000 / 출력 200토큰 | $400 | $150 | $80 |
| B에 Batch API 사용(단가 50% 할인) | 약 $200 | 약 $75 | 약 $40 |
시나리오 B는 같은 토큰 사용량에서 단가 차이만 보여줘요. 실제로는 모델마다 사고 토큰, 출력 길이, 재시도 횟수가 다르기 때문에 Flash-Lite에 $80을 쓰면 Argon에 $400을 쓴 것과 같은 품질을 얻을 수 있다고 단정할 수 없어요. 또한 Argon과 Flash의 프로모션 요금이 종료되면 표에서 두 모델의 비용은 모두 두 배가 돼요.
영향 분석: Gemini API에서 토큰 단가만 보면 안 되는 이유
개발자에게 미치는 영향
모델의 ‘가격’은 적어도 세 단계로 나눠 볼 수 있어요. 첫 번째는 토큰 단가, 두 번째는 입력·출력·사고 토큰과 반복되는 컨텍스트, 재시도를 포함해 작업에 실제로 소비되는 토큰이에요. 세 번째는 기준을 충족하는 작업 하나를 완료하는 총비용으로, 성공률과 수동 검토, 실패 후 재시도, 완료 시간, 오류로 인한 비즈니스 손실까지 고려해야 해요.
Flash-Lite가 단순 분류에서 이미 비즈니스 기준을 충족한다면 Argon으로 바꾸는 건 낭비예요. 반대로 복잡한 코드 작업이 Flash-Lite에서 반복해서 실패하지만 Argon에서는 더 적은 재시도로 완료된다면, Argon의 종합적인 가성비가 더 높을 수 있어요. 이는 모델 선택 원칙에 따른 조건부 추론이지, 세 모델의 실제 성공률을 통계적으로 비교한 결론은 아니에요.
커뮤니티의 피드백도 이 점을 보여줘요. 한 Reddit 사용자는 OpenCode 환경에서 Argon High로 리버스 엔지니어링을 수행하면서 한 번에 약 90만 토큰을 소비했지만, 작업을 완료하지 못했다고 해요. 개인 테스트이므로 업계 평균으로 볼 수는 없지만, 복잡한 에이전트 워크플로가 토큰을 대량으로 소비하고도 성공을 보장하지는 않는다는 점을 일깨워줘요. 또 다른 사용자는 소비자용 구독에서 Argon이 사용량 한도에 빠르게 도달했다고 했어요. 이는 Gemini 구독 상품의 사용 경험이므로 Developer API의 사용 한도와 동일하게 볼 수 없어요.
업계에 미치는 영향
- 멀티 모델 계층화가 기본 아키텍처로 자리 잡아요: Google Cloud는 이미 멀티 모델 오케스트레이션과 Smart Routing을 소개하며, 작업을 분배해 기업 비용을 낮추는 방법을 공개했어요.
- 평가 지표가 ‘단가’에서 ‘기준을 충족하는 작업당 비용’으로 바뀌어요: 호출량이 많을수록 순위표보다 비즈니스 테스트 세트를 기반으로 모델을 선택해야 해요.
- 예산 검토 주기가 짧아져요: 프로모션 요금이 차례로 종료되므로 팀은 분기마다 모델 구성과 예산을 검토해야 해요.
개발자는 Argon, Flash, Flash-Lite 중 무엇을 선택해야 할까요?
모든 상황에서 가장 좋은 모델은 없어요. 아래 추천은 각각의 조건을 충족한다는 전제에서 참고해 주세요.
- 대규모 데이터 분류(예: AI 뉴스 10만 건을 출시, 업데이트, 가격, 정책 등으로 분류): 먼저 Flash-Lite를 사용해 보세요. 샘플 테스트에서 정확도와 형식 준수율이 기준에 미달하면 3.8 Flash로 올려 쓰면 돼요.
- 긴 자료의 구조화(재무 보고서나 기술 문서를 정리해 팩트 테이블로 만들기): 먼저 3.8 Flash를 사용해 보세요. Lite보다 이해력이 뛰어나고 Argon보다 저렴해요. 문서 간 모순을 찾아내거나 어려운 추론이 필요한 경우에는 Argon을 선택적으로 호출하세요.
- 복잡한 코드 프로젝트(대규모 코드베이스 이해, 다단계 리팩터링): 먼저 Argon을 사용해 보세요. 공식 포지셔닝과 독립적인 코딩 벤치마크 모두에서 더 강력하지만, 실제 프로젝트에서 성공률과 도구 실행 결과, 비용을 확인해야 해요.
- 대량의 간단한 번역: 먼저 Flash-Lite를 사용해 보세요. 법률이나 의료처럼 높은 전문성이 필요한 콘텐츠에는 반드시 품질 검사를 추가해야 해요. 저렴하다는 이유로 사람의 검토 없이 사용해서는 안 돼요.
- 기업용 에이전트: 한 가지 모델만 사용하는 것은 권장하지 않아요. Flash-Lite는 분류, 추출, 형식 표준화를, 3.8 Flash는 일반적인 계획 수립과 다단계 워크플로를, Argon은 어려운 추론과 복잡한 문제 해결을 맡길 수 있어요. 이는 권장하는 엔지니어링 전략이지, Google의 필수 요구사항은 아니에요.
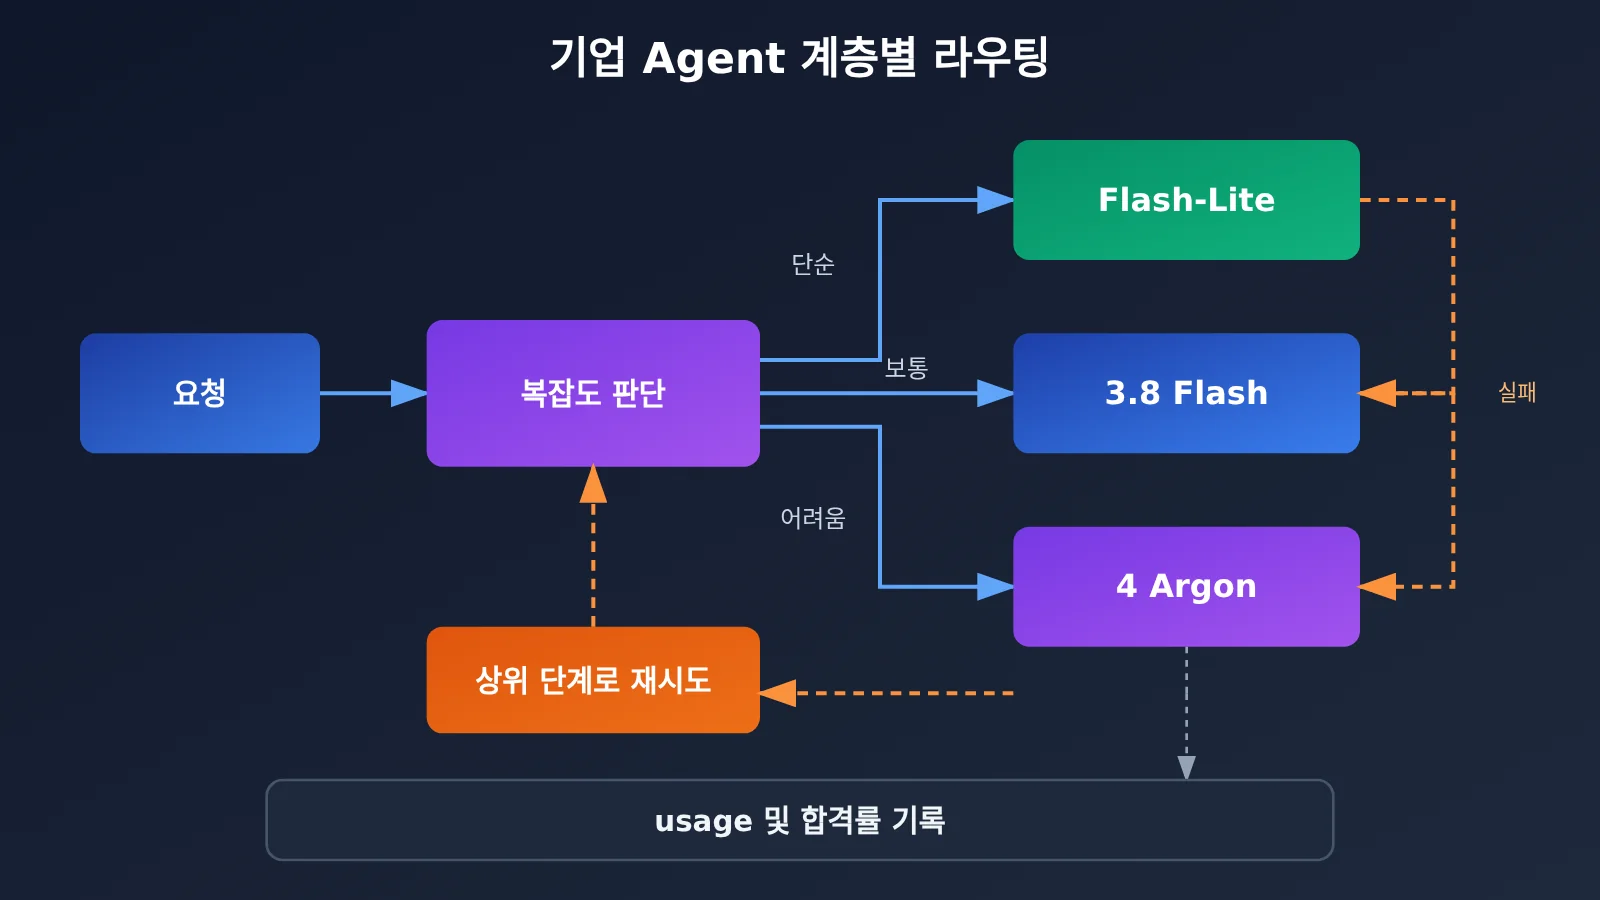
🎯 선택 팁: 계층형 라우팅의 핵심은 세 모델 사이를 낮은 비용으로 전환하는 것이에요. APIYI apiyi.com은 OpenAI 호환 인터페이스를 제공하므로
model파라미터 하나만 바꿔 모델을 전환할 수 있어요. 소규모 비교 테스트를 먼저 진행하기에도 적합해요.
빠르게 시작하기: API로 Gemini 모델 3종 호출하기
최소 예제
OpenAI SDK로 호출할 수 있어요. model만 바꾸면 Argon, Flash, Flash-Lite를 전환할 수 있습니다.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
단계별 라우팅과 비용 추정 전체 코드 보기
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 빠른 시작: 먼저 APIYI apiyi.com에서 신규 사용자 무료 테스트 크레딧을 받아 보세요. 대표 샘플 100~300개로 세 모델을 비교한 뒤 운영 환경의 기본 모델을 결정하는 것을 추천해요. 서드파티 플랫폼의 가격, 크레딧, 캐시 지원은 Google 직접 연결과 다를 수 있으니 해당 플랫폼의 정책을 확인하세요.
Gemini API 운영 환경 배포 전 주의사항
- 호출 제한: Gemini API는 RPM, TPM, RPD 기준으로 호출을 제한해요. 개별 API 키가 아닌 프로젝트 단위로 계산하며, 어느 하나라도 초과하면 오류가 발생합니다.
- 사고 토큰: 출력 가격에는 사고 토큰이 포함돼요. 사용량 메타데이터를 확인하고, 눈에 보이는 답변 길이로 비용을 추정하지 마세요.
- 캐시: Argon은 암시적 캐시만 지원하고 명시적 캐시는 지원하지 않아요. Flash와 Flash-Lite는 캐시를 지원하며, 실제 요금은 설정에 따라 달라집니다.
- 무료 티어 데이터: 무료 티어의 데이터는 제품 개선에 사용될 수 있어요. 기업의 민감한 데이터는 무료 티어에 넣지 말고, 운영 환경에 배포하기 전에 서비스 약관을 확인하세요.
- 테스트 지표: 성공률, 사실 정확도, 구조 준수율, 환각 발생 건수, 평균 및 꼬리 지연 시간, 실제 토큰 사용량, 재시도 횟수, 적합한 결과를 얻은 작업당 비용을 기록하세요. 기본 사고 수준이 다르므로 보고서에 실제 사용한 설정을 명시해야 해요.
Gemini API 모델 선택 FAQ
Q1: Gemini 4 Argon, 3.8 Flash, 3.5 Flash-Lite는 각각 어떤 모델인가요?
세 모델은 현재 Google Gemini API의 주요 모델로, 각기 다른 용도에 맞춰져 있어요. Argon은 최상위 추론 모델이고, 3.8 Flash는 성능과 효율의 균형을 갖춘 모델이며, 3.5 Flash-Lite는 낮은 지연 시간과 비용, 높은 처리량에 초점을 맞춘 모델이에요. 세 모델 모두 약 100만 토큰의 입력 컨텍스트를 지원하며, 텍스트를 출력해요.
Q2: Argon과 Flash의 할인 가격은 언제 끝나나요?
Argon의 현재 가격은 2026년 11월 30일까지 적용되며, 12월 1일부터 입력, 출력, 캐시 단가가 모두 두 배로 올라요. 3.8 Flash는 2026년 12월 31일까지 현재 가격이 적용되고, 2027년 1월 1일부터 두 배로 올라요. Flash-Lite는 현재 공식적으로 비슷한 가격 인상 날짜가 명시되어 있지 않아요.
Q3: Artificial Analysis의 50점은 정답률이 50%라는 뜻인가요?
아니요. 50, 31, 12는 Intelligence Index v5.0의 종합 지수 점수이며, 정답률이 아니에요. 모델 간의 대략적인 성능 차이를 비교하는 데 적합하지만, 여러분의 비즈니스 성공률로 바로 환산할 수는 없어요.
Q4: 세 가지 Gemini 모델을 저렴하게 비교하려면 어떻게 해야 하나요?
여러 모델을 지원하는 OpenAI 호환 인터페이스를 사용하는 것을 추천해요. APIYI apiyi.com에 가입해 API 키와 무료 크레딧을 받은 뒤, 이 글의 예제에서 `model`을 세 가지 API ID로 차례로 바꿔 보세요. 같은 샘플에 대해 usage와 합격률을 기록하면 돼요.
Q5: Reddit에서는 Argon을 몇 번만 사용해도 한도가 소진된다는데, API도 그런가요?
해당 후기는 소비자용 Gemini 구독 서비스에 관한 것으로, Developer API의 한도와는 달라요. API 할당량은 결제 등급, 프로젝트 상태, 모델에 따라 다르며 RPM/TPM/RPD 기준으로 계산돼요. 통합 플랫폼을 통해 호출할 때는 해당 플랫폼의 할당량 규칙도 확인해야 해요. APIYI apiyi.com 콘솔에서 실제 사용 가능한 모델과 과금 방식을 확인할 수 있어요.
Q6: 세 모델의 알려진 단점은 무엇인가요?
Argon은 단가가 가장 높고 속도가 가장 느리며, 일반 무료 등급이 없어요. 복잡한 에이전트 작업에서는 토큰을 많이 소모할 수 있어요. 3.8 Flash는 가장 어려운 터미널 및 코딩 벤치마크에서 Argon과 성능 차이가 커요. Flash-Lite는 복잡한 코딩과 자동화 작업에 약하며, 전문 분야 번역에는 사람의 검토가 필요해요.
Gemini API 모델 선택 핵심 요약
- 뉴스 배경: Google 자체 모델 API의 분당 처리량은 약 320억 토큰에 달해요. 이는 전체 모델의 성장세이지, 단일 모델의 성과는 아니에요.
- 세 가지 모델의 역할: Argon은 복잡한 추론, 3.8 Flash는 균형 잡힌 주력 업무, Flash-Lite는 높은 처리량이 필요한 가벼운 작업을 담당해요.
- 가격 차이: 현재 입력 단가는 각각 $2 / $0.75 / $0.30이며, Argon과 Flash는 프로모션 가격이 끝나면 두 배로 올라요.
- 평가 결과 해석: AA v5.0 지수는 각각 50 / 31 / 12예요. 정답률이 아닌 지수이므로 간단한 작업에서는 성능 차이가 크지 않을 수도 있어요.
- 숨은 비용: 사고 토큰은 출력 토큰에 포함돼요. 여기에 캐시, 재시도, 도구 사용 비용까지 더해져 최종 요금이 결정돼요.
- 시작 방법: APIYI apiyi.com에서 하나의 키로 세 모델을 전환하며 100~300개의 샘플로 비교 테스트할 수 있어요.
정리
Gemini API 호출량이 급증한 것은 대규모 언어 모델이 본격적인 대규모 운영 단계에 들어섰다는 뜻이에요. 하지만 모델 선택의 핵심은 달라지지 않았어요.
- 작업별로 모델을 나누세요: 분류와 번역에는 Flash-Lite, 문서 구조화에는 3.8 Flash, 복잡한 코드와 난도 높은 에이전트 작업에는 Argon을 먼저 테스트해 보세요.
- 기준을 충족한 작업당 비용을 살펴보세요: 최적화해야 할 것은 토큰 100만 개당 최저 단가가 아니라, 기준을 충족한 작업 하나를 완료하는 데 드는 총비용이에요.
- 가격 변경일을 확인하세요: Argon은 11월 30일, Flash는 12월 31일에 프로모션 가격이 종료돼요. 예산은 변경 후 가격을 기준으로 산정하세요.
개발자에게 필요한 것은 언제나 가장 강력하거나 가장 저렴한 모델이 아니라, 수용 가능한 비용으로 업무를 안정적으로 처리하는 모델 조합이에요. 먼저 APIYI apiyi.com의 무료 크레딧으로 세 모델을 비교 테스트한 뒤, 프로덕션 환경의 라우팅 전략을 정해 보세요.
📚 참고 자료
- Alphabet 2026년 3분기 실적 발표 CEO 메시지: 분당 320억 토큰 데이터 출처
- 링크:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
설명: 뉴스 배경과 API 사용량 증가에 관한 최초 발표
-
Gemini API 공식 가격: 세 모델의 표준, 캐시 및 Batch 가격
- 링크:
ai.google.dev/gemini-api/docs/pricing -
설명: 프로모션 가격 종료일과 사고 토큰 과금 안내 포함
-
Gemini 모델 사양 문서: Argon / 3.8 Flash / 3.5 Flash-Lite
- 링크:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
설명: 컨텍스트, 출력 한도, 사고 수준 및 도구 활용 기능
-
Artificial Analysis 모델 비교: 독립적인 제3자 평가 v5.0
- 링크:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
설명: 종합 지수, 세부 벤치마크 및 속도 측정 결과
-
Gemini API 호출 제한과 사고 메커니즘: RPM/TPM/RPD 및 사고 설정
- 링크:
ai.google.dev/gemini-api/docs/rate-limits -
설명: 서비스 출시 전 꼭 확인할 할당량과 사고 토큰 규칙
-
Google Cloud 멀티 모델 오케스트레이션: Smart Routing과 Agent 비용 관리
- 링크:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - 설명: 기업용 계층별 라우팅에 관한 공식 가이드
작성자: APIYI 기술팀
기술 문의: APIYI 공식 홈페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.