작성자 주: OpenAI의 12시간 Prompt Cache가 GPT-6 API 비용에 미치는 영향을 해석하고, 손익분기 공식과 5가지 판단 기준으로 어떤 시나리오에서 캐시를 켜면 비용이 절감되고 어떤 시나리오에서는 효과가 제한적인지 설명합니다.
OpenAI가 Prompt Cache에 12시간 캐시 보존 기능을 새로 추가했어요. GPT-6 API를 호출하는 팀이라면 원가를 다시 계산해 볼 만한 신호예요. 예전에는 캐시가 보통 몇 분 정도의 유휴 시간에만 유효해서, 저빈도 요청은 할인을 거의 받지 못했죠. 이제 캐시 윈도우가 길어지면서 “몇 시간 지나서야 다시 돌아오는” 요청들도 캐시에 적중할 기회가 생겼어요.
이건 “캐시만 켜면 자동으로 반값”이라는 마케팅 문구가 아니에요. 캐시로 비용이 절감되는지는 프리픽스가 안정적인지, 요청 간격이 얼마나 긴지, 단일 프리픽스가 얼마나 큰지, 그리고 캐시 쓰기에 추가 비용이 붙는지에 따라 달라져요. 이 글에서는 간단한 손익분기 공식을 통해 우리 비즈니스에 12시간 캐시를 켜야 할지 판단할 수 있게 도와드릴게요.
핵심 가치: 5분 만에 12시간 Prompt Cache의 메커니즘 변화를 이해하고, 5가지 기준으로 GPT-6 API 캐시가 언제 실제로 비용을 절감하는지 판단하는 방법을 익힐 수 있어요.
OpenAI 12시간 Prompt Cache 핵심 정보 한눈에 보기
먼저 표 하나로 이번 업데이트의 핵심 정보를 정리해 볼게요. 공식 가격과 파라미터는 계속 조정되기 때문에, 표에서 과금 비율과 관련된 부분은 모두 OpenAI 공식 문서와 가격 페이지를 기준으로 확인하시는 게 좋아요.
| 정보 항목 | 상세 내용 |
|---|---|
| 업데이트 내용 | Prompt Cache에 12시간 캐시 보존 옵션 추가 |
| 배포 주체 | OpenAI |
| 관련 모델 | GPT-6 API 등 Prompt Caching을 지원하는 모델(공식 모델 목록 기준) |
| 과금 로직 | 캐시에 히트된 입력 토큰은 일반 입력보다 낮은 단가로 과금, 구체적인 할인율은 공식 가격 페이지 기준 |
| 핵심 변화 | 캐시가 “분 단위 유휴 시 소멸”에서 최대 12시간 보존으로 연장 |
| 영향 범위 | 긴 시스템 프롬프트, Agent 도구 정의, RAG 고정 지식, 멀티턴 대화 등 |
Prompt Cache는 어떻게 동작하나요
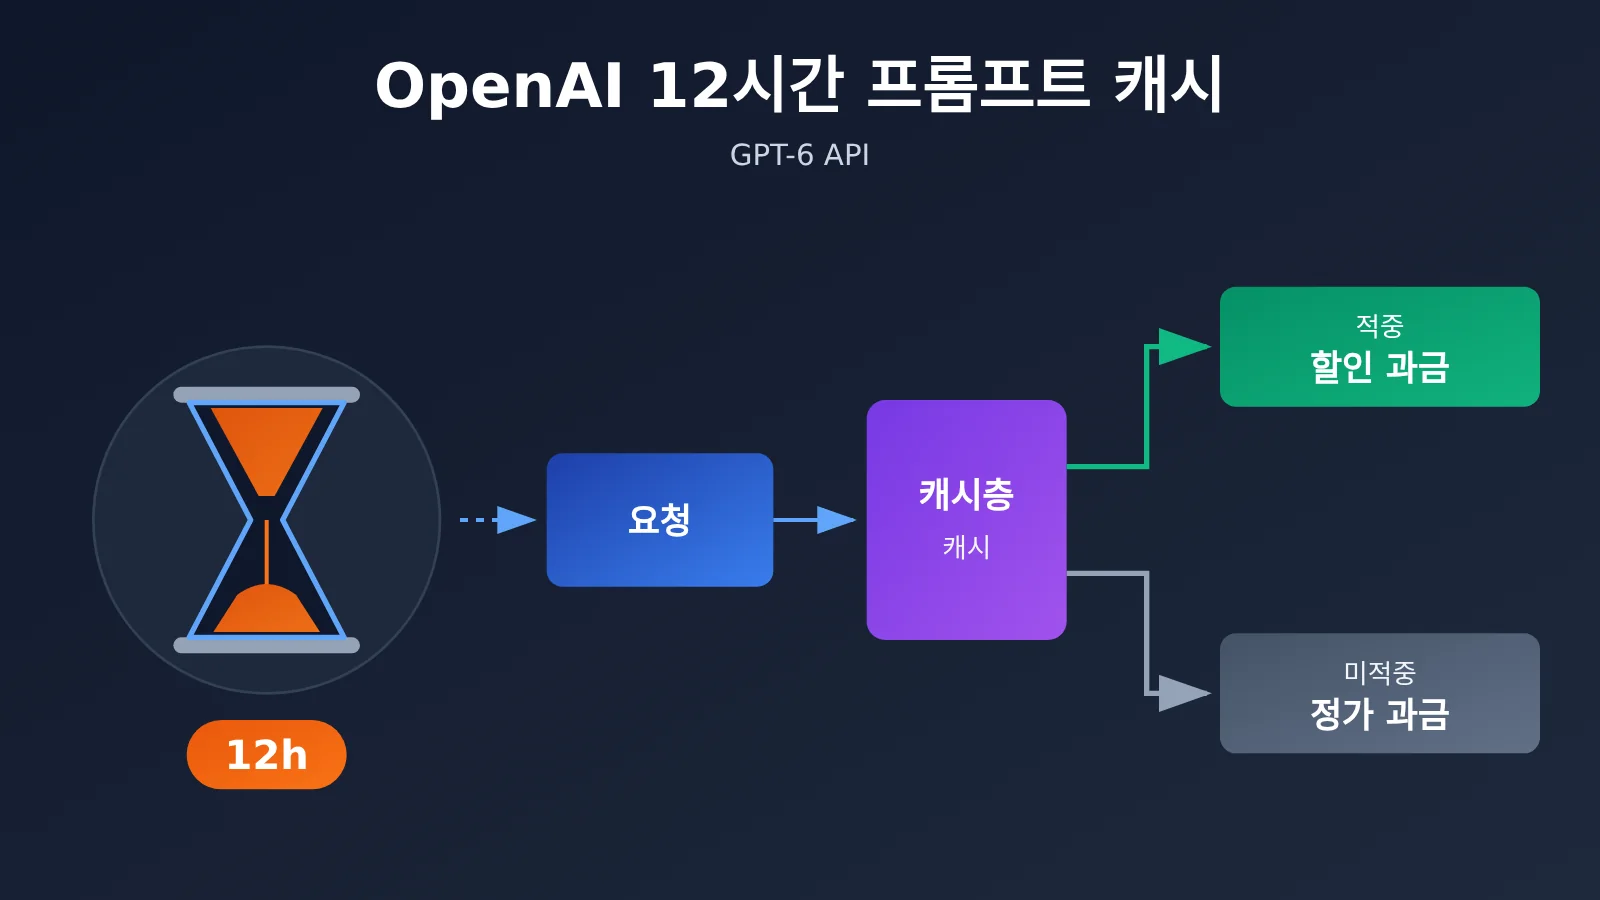
OpenAI의 Prompt Caching은 “프리픽스 매칭” 방식이에요. 요청의 앞부분(시스템 프롬프트, 도구 정의, 고정 문서 등)이 최근 어떤 요청과 완전히 일치하고, 길이가 공식 규정의 최소 임계값에 도달하면 이 부분의 토큰이 캐시 히트로 인식되어 할인된 가격으로 과금돼요. 첫 토큰 지연도 눈에 띄게 줄어들고요.
특히 주의할 점은, 캐시는 “첫 번째 토큰부터 연속으로 일치하는” 부분만 인정한다는 거예요. 프리픽스 중간에 타임스탬프나 사용자 ID가 하나라도 끼어들면 그 뒤 내용은 전부 히트되지 않아요. 그래서 “캐시를 켜느냐 마느냐”보다 프롬프트 구조를 어떻게 설계하느냐가 더 중요해요. 정적 콘텐츠는 앞에, 동적 콘텐츠는 맨 뒤에 배치하세요.
12시간 캐시와 단기 캐시의 차이
과거의 단기 캐시는 유휴 상태가 몇 분만 이어져도 삭제됐기 때문에, 고빈도로 연속되는 요청만 안정적으로 히트될 수 있었어요. 12시간 보존은 “히트 윈도우”를 분 단위에서 반나절 단위로 확장한 것으로, 저빈도 시나리오의 비용 구조를 곧바로 바꿔 놓아요.
| 비교 항목 | 기본 단기 캐시 | 12시간 캐시 |
|---|---|---|
| 보존 기간 | 분 단위 유휴 후 소멸 | 최대 약 12시간 |
| 적합한 요청 빈도 | 고빈도·연속 요청 | 중저빈도·간헐적 요청 |
| 대표적인 수혜 시나리오 | 실시간 고객 상담, 배치 연속 호출 | 사용자가 몇 시간 뒤 세션으로 복귀, 일중 정기 작업 |
| 히트율 안정성 | 트래픽 변동에 크게 영향받음 | 트래픽 저점에 더 유리 |
| 추가 비용 | 보통 쓰기 추가 요금 없음 | 추가 요금 여부는 공식 설명 기준 |
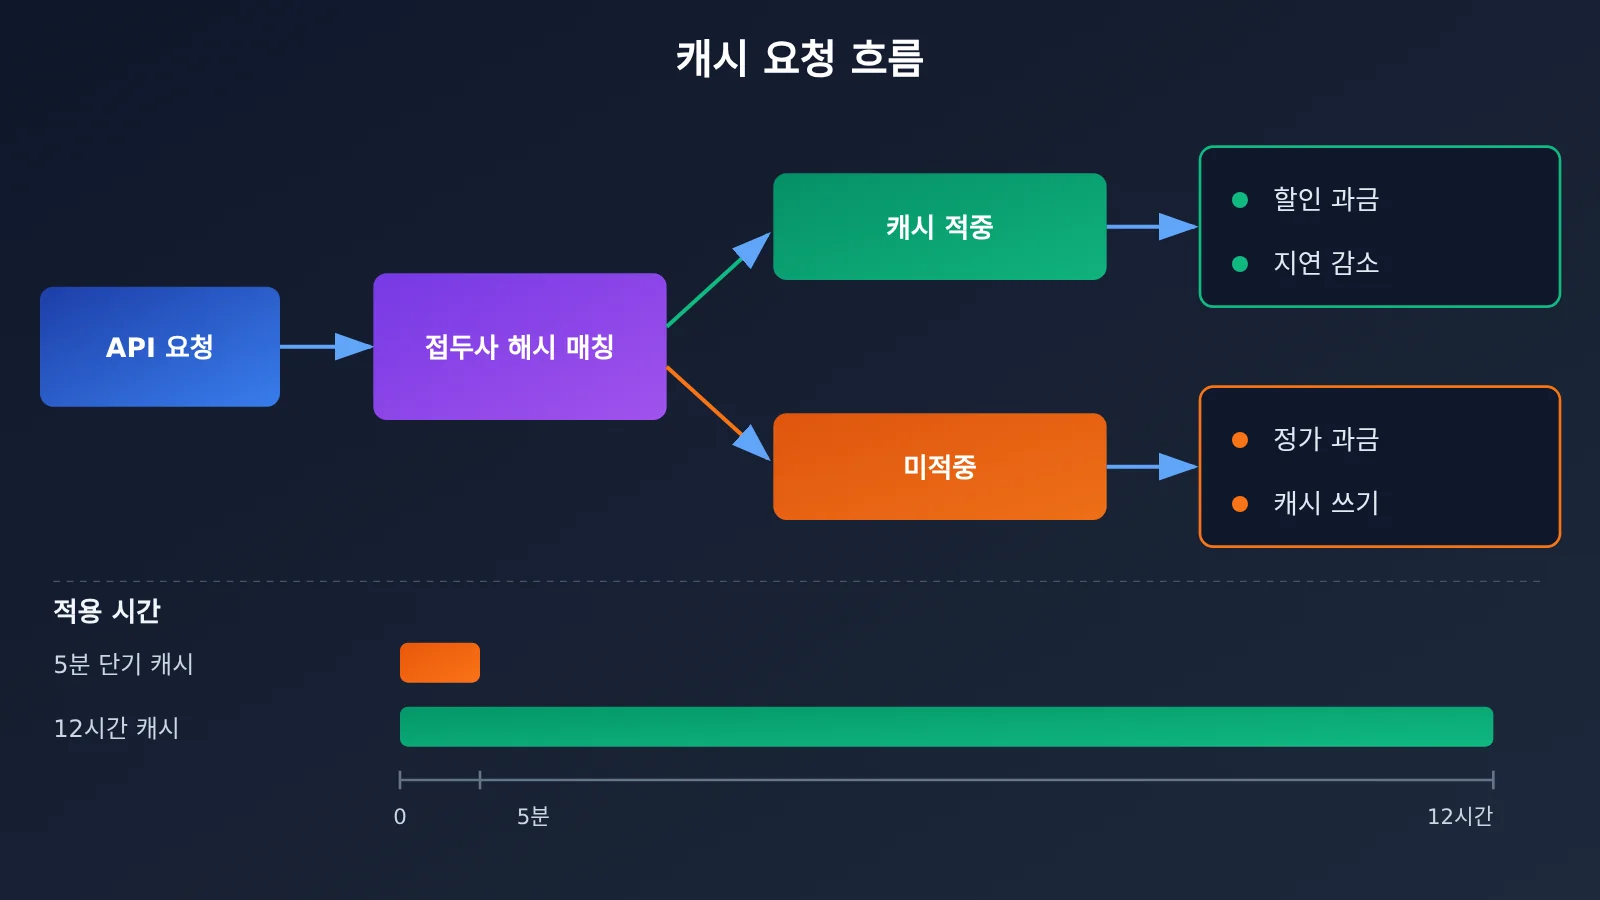
많은 글에서 “캐싱이 비용을 아껴준다”고만 말할 뿐, 얼마나 아끼는지, 어떤 조건에서 아끼는지는 알려주지 않아요. 아래에서는 하나의 범용 공식으로 이 문제를 정량화해 볼 텐데, 여러분은 자신의 비즈니스 파라미터만 대입하면 됩니다.
프롬프트 캐시 손익분기 공식 유도
다음 변수를 정의해 볼게요.
L: 캐시할 수 있는 접두사(프리픽스)의 토큰 수P: 일반 입력 단가d: 캐시 적중 단가가 일반 단가에 대한 비율 (0 < d < 1)w: 캐시 최초 기록 시 붙는 부가 비용 비율 (부가 요금이 없으면 w = 0)N: 캐시 유효 기간 내에 동일 접두사가 호출된 횟수
캐시를 사용하지 않으면 접두사 총비용은 N × L × P입니다. 캐시를 사용하면 첫 호출은 기록 비용으로 청구되고, 이후 호출은 적중 단가로 청구되므로 총비용은 L × P × (1 + w) + (N − 1) × L × P × d가 됩니다.
두 식을 빼면 아주 간결한 손익분기 조건이 나옵니다. 바로 N > 1 + w / (1 − d) 입니다. 이 공식은 두 가지를 말해줘요. 기록에 부가 요금이 없다면(w = 0) 동일 접두사가 유효 기간 안에서 한 번만 재사용돼도 곧바로 비용이 절감되기 시작합니다. 반대로 기록에 부가 요금이 붙으면 재사용 횟수가 특정 임계값을 넘어야 손익분기에 도달하는데, 할인 폭이 클수록(d가 작을수록) 손익분기에 더 빨리 닿습니다.
시나리오별 손익분기 계산
아래에서는 “가상 파라미터”로 간단한 예시 계산을 해볼게요. 공식 사용법을 설명하기 위한 것일 뿐, OpenAI의 실제 가격을 뜻하지는 않습니다. 캐시 적중가가 일반가의 일정 비율이라고 가정하고, 쓰기 부가 요금이 있을 때와 없을 때의 손익분기 호출 횟수를 각각 살펴보겠습니다.
| 시나리오 가정 | 쓰기 부가 요금 w | 적중 할인 d | 손익분기 필요 호출 횟수 N | 결론 |
|---|---|---|---|---|
| 쓰기 부가 요금 없음 | 0 | 무관 | N > 1 | 1회만 재사용해도 절감 |
| 소액 쓰기 부가 요금 | 낮음 | 할인 큼 | 약 2회 | 대부분의 시나리오에서 유리 |
| 높은 쓰기 부가 요금 | 높음 | 할인 작음 | 3회 이상 | 재사용이 많은 시나리오에서만 유리 |
계산 결과를 보면, 12시간 캐시의 진짜 가치는 “할인율 자체”가 아니라 N을 크게 만들어 준다는 데 있어요. 몇 시간에 한 번씩만 들어오던 요청은 짧은 캐시 아래에서는 N이 사실상 1이라 비용 절감은커녕 논할 거리도 없죠. 하지만 12시간으로 늘리면 동일 접두사가 하루 안에 여러 번 재사용되면서 절감 효과가 비로소 나타납니다.
🚀 빠른 시작: 실제 트래픽에서 손익분기 공식을 검증해 보고 싶다면, APIYI(apiyi.com)에서 동일한 API 키로 여러 모델의 캐시 적중 상황을 비교해 보는 걸 추천해요. 이 플랫폼은 OpenAI 호환 인터페이스를 제공하며, 신규 사용자는 무료 테스트 크레딧을 받을 수 있습니다.
GPT-6 API에서 프롬프트 캐시 적중을 검증하는 방법
캐시가 실제로 비용을 절감하는지 판단하는 가장 신뢰할 수 있는 방법은 응답의 usage 필드를 읽는 거예요. OpenAI 호환 인터페이스는 usage.prompt_tokens_details.cached_tokens에 이번 요청에서 캐시에 적중한 토큰 수를 반환하므로, 이 값을 기준으로 실제 적중률을 계산할 수 있어요.
아주 간단한 예제
아래 코드는 같은 프리픽스를 가진 요청을 두 번 연속 보내고, 두 번째 요청의 cached_tokens가 0보다 큰지 확인해요:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, OpenAI 호환
)

SYSTEM_PROMPT = "你是资深技术顾问……(此处放置超过最小缓存阈值的固定长提示词)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # 플랫폼 모델 목록에 있는 실제 이름을 사용하세요
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"第 {i+1} 次提问:如何优化接口成本?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"第 {i+1} 次请求,命中缓存 token 数:{cached}")
전체 구현 코드 보기(적중률 통계 및 캐시 라우팅 키 포함)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """静态内容放最前面,动态内容放最后,保证前缀稳定"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key는 같은 프리픽스 요청을 동일한 캐시로 라우팅하는 데 도움을 줍니다
        # 12시간 보존을 활성화하려면 OpenAI 공식 문서에 따라 해당 파라미터를 추가하세요
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["如何设计缓存友好的 Prompt?", "工具定义应该放在哪里?", "如何统计命中率?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"整体缓存命中率:{stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"请求 {idx}: prompt={p}, cached={c}")
권장: 먼저 소규모 트래픽으로 하루 정도 실행하면서 전체 적중률과 요청 간격 분포를 집계한 뒤, 프로덕션 환경에서 12시간 캐시를 전면 활성화할지 결정하세요. APIYI(apiyi.com)에서 테스트 크레딧을 받으면 이런 검증을 바로 완료할 수 있고, 공식 계정을 여러 개 따로 개설할 필요도 없어요.
12시간 프롬프트 캐시의 5가지 비용 절감 판단 기준
손익분기 공식을 실제 비즈니스에 적용해 보면, 아래 5가지 판단 기준으로 정리할 수 있어요. 충족하는 조건이 많을수록 12시간 캐시를 켰을 때의 이득이 더 뚜렷해집니다.
- 프리픽스가 충분히 길어야 해요: 캐시할 수 있는 고정 부분이 공식 최소 임계값을 넘어야 하고, 길수록 할인 총액도 커져요. 수백 토큰짜리 짧은 프롬프트는 캐시에 적중해도 절약되는 비용이 매우 제한적이에요.
- 프리픽스가 충분히 안정적이어야 해요: 시스템 프롬프트, 도구 정의, 스키마 순서가 하루 동안 그대로 유지되어야 해요. 프롬프트를 자주 개편하면 캐시가 반복해서 무효화돼요.
- 요청 간격이 12시간 안에 들어와야 해요: 같은 프리픽스가 몇십 분에서 몇 시간마다 한 번씩 호출된다면, 바로 이 구간이 12시간 캐시가 짧은 캐시보다 더 큰 증분 절감 효과를 내는 지점이에요.
- 재사용 횟수가 손익분기 임계값을 넘어야 해요:
N > 1 + w / (1 − d)로 계산해서, 하루 중 재사용 횟수가 임계값보다 안정적으로 높은지 확인하세요. - 입력 비용 비중이 높아야 해요: 청구서의 대부분이 출력 토큰에서 나온다면 캐시는 입력 측만 최적화하므로 전체 절감 폭이 희석될 수 있어요.
비즈니스 시나리오별 12시간 캐시 적합도
| 비즈니스 시나리오 | 요청 간격 특성 | 짧은 캐시 효과 | 12시간 캐시의 추가 가치 |
|---|---|---|---|
| 실시간 고객 상담 챗봇 | 고빈도 연속 | 이미 양호 | 보통, 주로 트래픽 저점을 보완 |
| 기업 지식 베이스 RAG | 중간 빈도, 고정 문서 프리픽스 | 변동 폭 큼 | 뚜렷함, 하루 중 여러 번 고정 지식 재사용 |
| 코딩 에이전트 세션 | 사용자가 간헐적으로 세션에 복귀 | 자주 무효화됨 | 매우 높음, 긴 컨텍스트를 여러 시간에 걸쳐 재사용 |
| 일일 정기 배치 처리 | 몇 시간마다 배치 1회 | 거의 효과 없음 | 매우 높음, 같은 템플릿으로 하루에 여러 배치 |
| 일회성 긴 문서 분석 | 한 번만 호출 | 효과 없음 | 거의 없음, N = 1이라 손익분기 불가 |
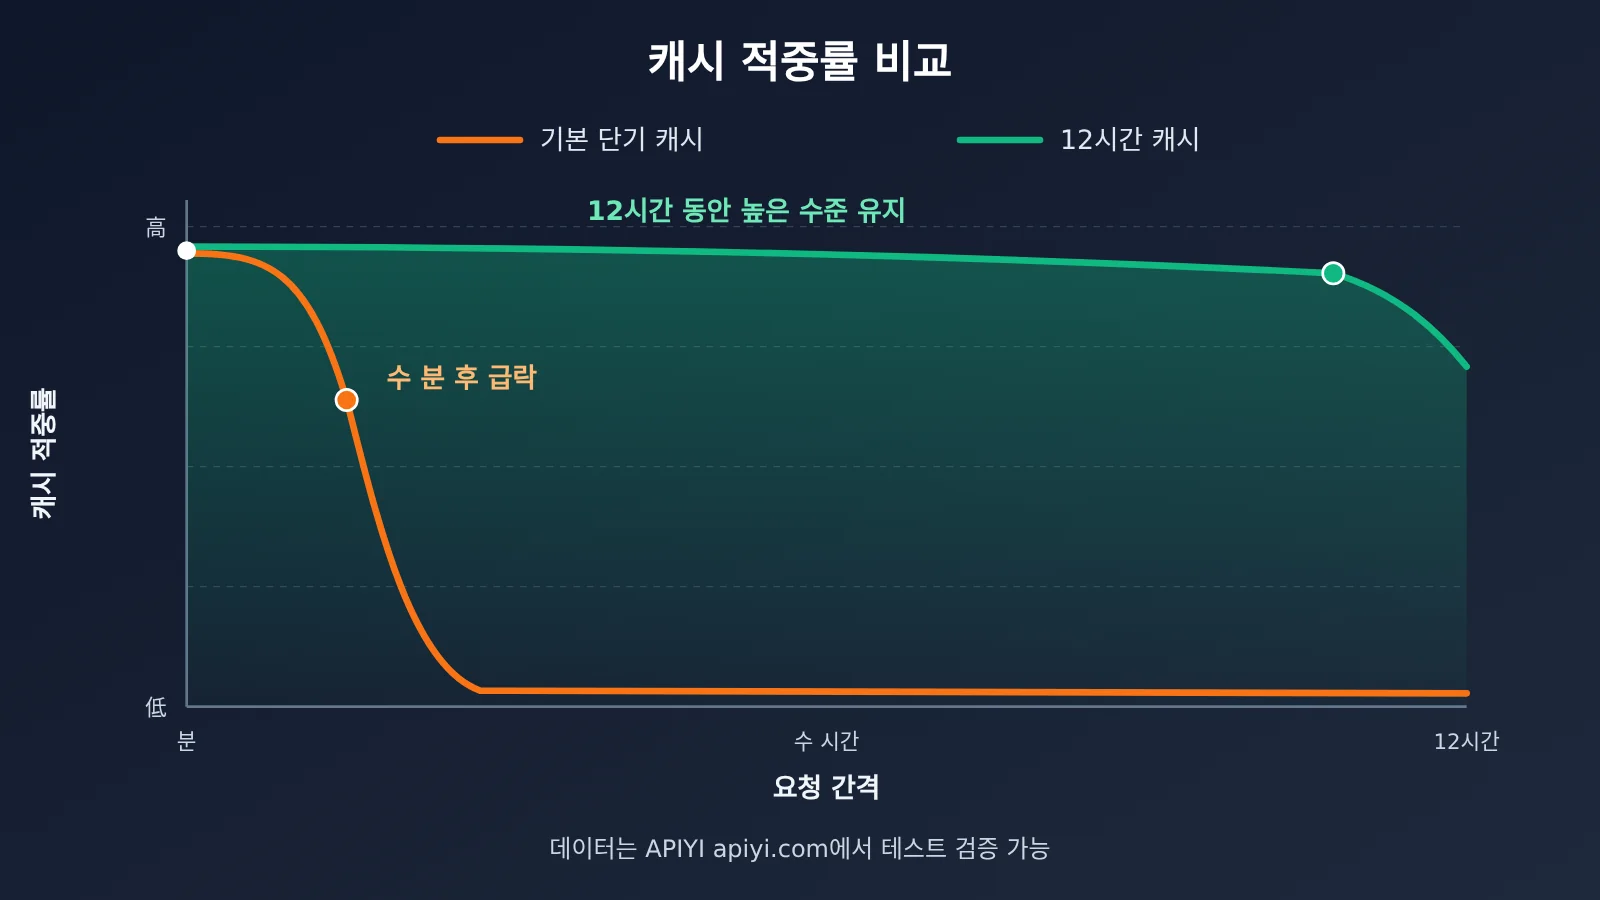
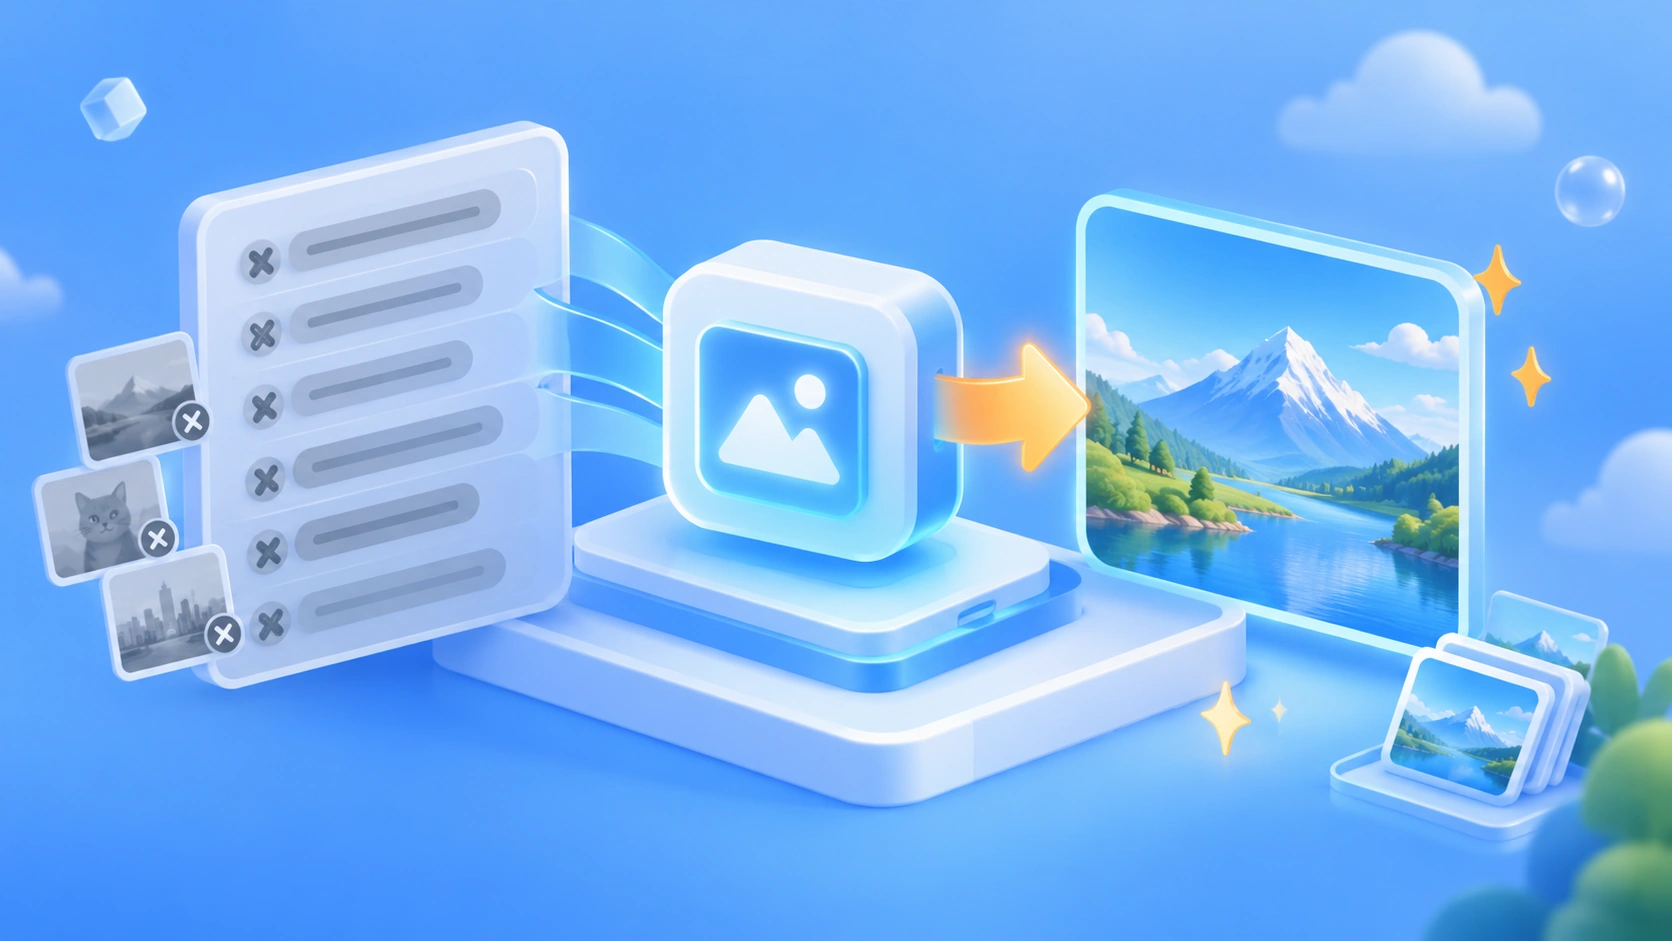
비교 설명: 위 그림은 요청 간격에 따라 두 캐시 전략의 적중률 추세가 어떻게 달라지는지 보여줘요. 실제 적중률은 프리픽스 안정성과 트래픽 분포에 따라 달라지므로, 자신의 실제 요청 로그로 비교해 보는 걸 권장해요.
OpenAI 12시간 프롬프트 캐시 영향 분석
개발자에게 미치는 영향
- 프롬프트 엔지니어링이 “캐시 엔지니어링”으로 확장돼요: 시스템 프롬프트, 도구 정의, 고정 지식을 안정적인 프리픽스 블록으로 정리하고 버전을 명시적으로 관리해야 해요. 작은 수정 하나로 전체 캐시가 무효화되지 않도록 하는 게 중요해요.
- 비용 평가가 “단가”에서 “실질 단가”로 이동해요: 같은 GPT-6 API라도 캐시 적중률이 높은 팀과 낮은 팀은 1,000회 요청당 실제 비용 차이가 크게 벌어질 수 있어요. 이제
cached_tokens모니터링은 기본 지표가 되어야 해요. - 긴 컨텍스트 에이전트가 더 현실적인 선택지가 돼요: 프로그래밍 어시스턴트나 연구형 에이전트는 컨텍스트가 아주 긴 경우가 많아요. 예전에는 사용자가 잠깐 자리를 비웠다 돌아오면 전부 다시 계산해야 했지만, 이제는 시간 단위를 넘겨 재사용할 수 있어서 긴 세션의 경제성이 눈에 띄게 좋아져요.
- 지연도 함께 개선돼요: 캐시에 적중한 요청은 첫 토큰 지연이 더 낮아서, 상호작용 경험이 중요한 제품에는 추가 이점이에요.
업계에 미치는 영향
- 캐시가 모델 가격 경쟁의 축이 돼요: 주요 벤더가 각자 프롬프트 캐시 방안을 제공하고 있고, 보존 기간·할인 폭·캐시 쓰기 비용 부과 여부가 개발자가 모델을 고를 때 중요한 기준이 되고 있어요.
- 통합 플랫폼의 멀티모델 비교 가치가 커져요: 벤더마다 캐시 규칙 차이가 커서, 통합 인터페이스에서 실제 청구 내역을 비교해 보는 것이 공식 정가만 보는 것보다 훨씬 참고할 만해요.
- RAG 아키텍처는 재평가될 수 있어요: 긴 문서 프리픽스를 반나절 동안 저비용으로 재사용할 수 있게 되면, 일부 중소 규모 지식베이스 시나리오는 “검색 청크” 방식에서 “전체 구간을 컨텍스트에 넣고 캐시하는” 방식으로 옮겨갈 수 있어요.
멀티모델 캐시 방안 선택 가이드
| 모델 계열 | 캐시 특징(각 사 공식 문서 기준) | 적합한 시나리오 | 사용 가능 플랫폼 |
|---|---|---|---|
| GPT-6 API | 자동 프리픽스 캐시, 12시간 보존 옵션 추가 | 긴 시스템 프롬프트, 에이전트 세션 | APIYI(apiyi.com), OpenAI 공식 |
| Claude 시리즈 | 캐시 브레이크포인트를 명시적으로 표시해야 하며, 다양한 보존 기간 지원 | 캐시 위치를 세밀하게 제어하는 시나리오 | APIYI, Anthropic 공식 |
| Gemini 시리즈 | 암시적·명시적 컨텍스트 캐시 지원 | 초장문 문서, 멀티모달 컨텍스트 | APIYI, Google 공식 |
💡 선택 가이드: 모델마다 캐시 규칙 차이가 크니, 같은 업무용 프롬프트로 여러 모델에서 적중률과 청구서를 직접 테스트한 뒤 성능과 함께 비교해 결정하는 걸 권해요.
자주 묻는 질문 FAQ
Q1: OpenAI 12시간 프롬프트 캐시란 무엇인가요?
OpenAI 프롬프트 캐싱 메커니즘의 보존 기간 연장 옵션이에요. 동일한 접두사를 가진 요청은 최대 약 12시간 동안 캐시에 적중할 수 있고, 적중된部分의 입력 토큰은 할인된 가격으로 과금되며 첫 토큰 지연 시간도 줄어들어요.
Q2: 12시간 캐시와 기본 단기 캐시는 어떤 차이가 있나요?
기본 단기 캐시는 몇 분간 유휴 상태가 되면 바로 만료되기 때문에, 고빈도 연속 요청에만 적합해요. 반면 12시간 캐시는 중저빈도, 간헐적인 요청까지 커버하죠. 실시간 고객 상담처럼 고빈도인 시나리오에서는 둘의 차이가 크지 않지만, Agent 세션이나 정기 배치 처리처럼 몇 시간 간격이 벌어지는 시나리오에서는 12시간 캐시의 증분 효과가 확실히 드러나요.
Q3: 12시간 캐시를 켜면 무조건 비용이 절감되나요?
꼭 그렇지는 않아요. 캐시 쓰기에 추가 요금이 없다면, 동일한 접두사가 유효 기간 내에 한 번이라도 재사용되면 바로 절감이 시작돼요. 추가 요금이 있다면 `1 + w / (1 − d)`를 넘는 재사용 횟수가 있어야 본전을 뽑을 수 있고요. 일회성 호출, 접두사가 자주 바뀌는 경우, 접두사가 아주 짧은 경우에는 효과가 매우 제한적이에요.
Q4: GPT-6 API의 캐시 적중률을 어떻게 높이나요?
핵심 원칙은 “정적 콘텐츠는 앞에, 동적 콘텐츠는 뒤에”예요:
– 시스템 프롬프트, 도구 정의, 고정 문서는 메시지 맨 앞에 두고 순서를 바꾸지 않기
– 타임스탬프, 사용자 ID, 검색 결과 같은 동적 콘텐츠는 맨 뒤에 배치하기
– 같은 유형의 요청에는 고정된 캐시 라우팅 키를 사용해서 동일 캐시로 라우팅될 확률 높이기
– 프롬프트 개편은 한꺼번에 배포하고, 하루에도 여러 번 자잘하게 수정하는 것은 피하기
Q5: API를 통해 12시간 캐시 효과를 빠르게 테스트하려면?
다중 모델을 지원하는 API 집계 플랫폼을 활용한 테스트를 추천해요:
1. APIYI apiyi.com 에 접속해 계정을 등록하세요
2. API 키와 무료 테스트 크레딧을 발급받으세요
3. 본문의 코드 예제를 사용하되(base_url은 `https://api.apiyi.com/v1`로 교체), `cached_tokens`를 읽어 적중률을 확인하세요
APIYI는 OpenAI 호환 인터페이스를 사용하기 때문에, 키 하나로 GPT, Claude, Gemini의 캐시 성능을 비교할 수 있어요.
Q6: 프롬프트 캐시에 알려진 제약 사항이 있나요?
캐시는 최소 길이 임계값을 충족하는 연속 접두사에만 적용되고, 입력 측 비용만 최적화할 뿐 출력 토큰은 할인이 안 돼요. 캐시는 “최선 노력(best-effort)” 방식의 메커니즘이라서, 동시성이 높거나 트래픽 라우팅이 바뀌면 미스가 발생할 수 있어요. 적중률을 100% 보장으로 여기면 안 되고요. 12시간 보존의 구체적인 과금 방식과 지원 모델은 OpenAI 공식 문서를 기준으로 확인하세요.
12시간 Prompt Cache 핵심 요점 Key Takeaways
- 메커니즘 본질: 접두사 완전 일치 기반으로, 적중된 입력 토큰은 할인된 가격으로 과금돼요
- 핵심 변화: 보존 기간이 분 단위에서 약 12시간으로 연장되어 저빈도 요청까지 커버해요
- 본전 회수 공식: 재사용 횟수 N > 1 + w / (1 − d) 를 넘어야 비용 절감이 시작돼요
- 최대 수혜 시나리오: Agent 장기 세션, 지식 베이스 RAG, 일중 정기 배치 처리
- 수익 제한 시나리오: 일회성 호출, 짧은 접두사, 잦은 개편이 있는 프롬프트
- 실행 핵심: 정적 콘텐츠를 앞에 배치하고, cached_tokens로 적중률을 지속 모니터링하세요
- 검증 방식: APIYI apiyi.com을 통해 실제 트래픽으로 소규모 테스트한 후 전체 활성화하세요
요약
OpenAI 12시간 Prompt Cache가 GPT-6 API 비용에 미치는 핵심 영향은 다음과 같아요:
- 비용 절감의 핵심은 재사용 횟수: 12시간 윈도우 덕분에 중저빈도 요청도 동일 접두사를 여러 번 재사용할 수 있게 되었고, N을 1에서 끌어올리는 것이 진정한 증분 가치예요.
- 쓰기 비용이 본전 회수 기준을 결정: 쓰기 추가 비용이 없으면 거의 확실히 이득이지만, 추가 비용이 있다면 본전 회수 공식으로 산출해야 해요.
- Prompt 구조가 스위치보다 중요: 정적 콘텐츠 전면 배치, 버전 관리, 적중률 모니터링을 해야 캐시 할인이 실제 청구서에 반영돼요.
긴 시스템 프롬프트와 Agent 세션처럼 수익성이 높은 시나리오부터 시작해서, 하루 정도 실제 트래픽을 돌려 적중률을 확인한 뒤 전체 확대 범위를 결정하는 것을 권장해요. APIYI apiyi.com을 통해 여러 모델의 캐시 효과를 빠르게 비교해 보세요. 플랫폼에서 무료 테스트 크레딧과 통합 OpenAI 호환 인터페이스를 제공한답니다.
📚 참고 자료
- OpenAI Prompt Caching 공식 가이드: 캐시 메커니즘, 최소 임계값 및 usage 필드 설명
- 링크:
platform.openai.com/docs/guides/prompt-caching -
설명: 캐시 적중 규칙과 최신 보존 기간 파라미터를 확인할 수 있는 권위 있는 출처예요
-
OpenAI API 가격 페이지: 모델별 일반 입력, 캐시 입력 및 출력 단가
- 링크:
openai.com/api/pricing -
설명: 비용 회수 공식에 대입할 때는 이 페이지의 실시간 가격을 기준으로 하세요
-
OpenAI API Reference: Chat Completions 및 Responses 인터페이스 파라미터 설명
- 링크:
platform.openai.com/docs/api-reference - 설명: prompt_cache_key 등 캐시 관련 파라미터의 구체적인 사용법을 확인할 수 있어요
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 연락해 주세요. 더 많은 모델 연동 및 비용 최적화 방안을 안내해 드려요