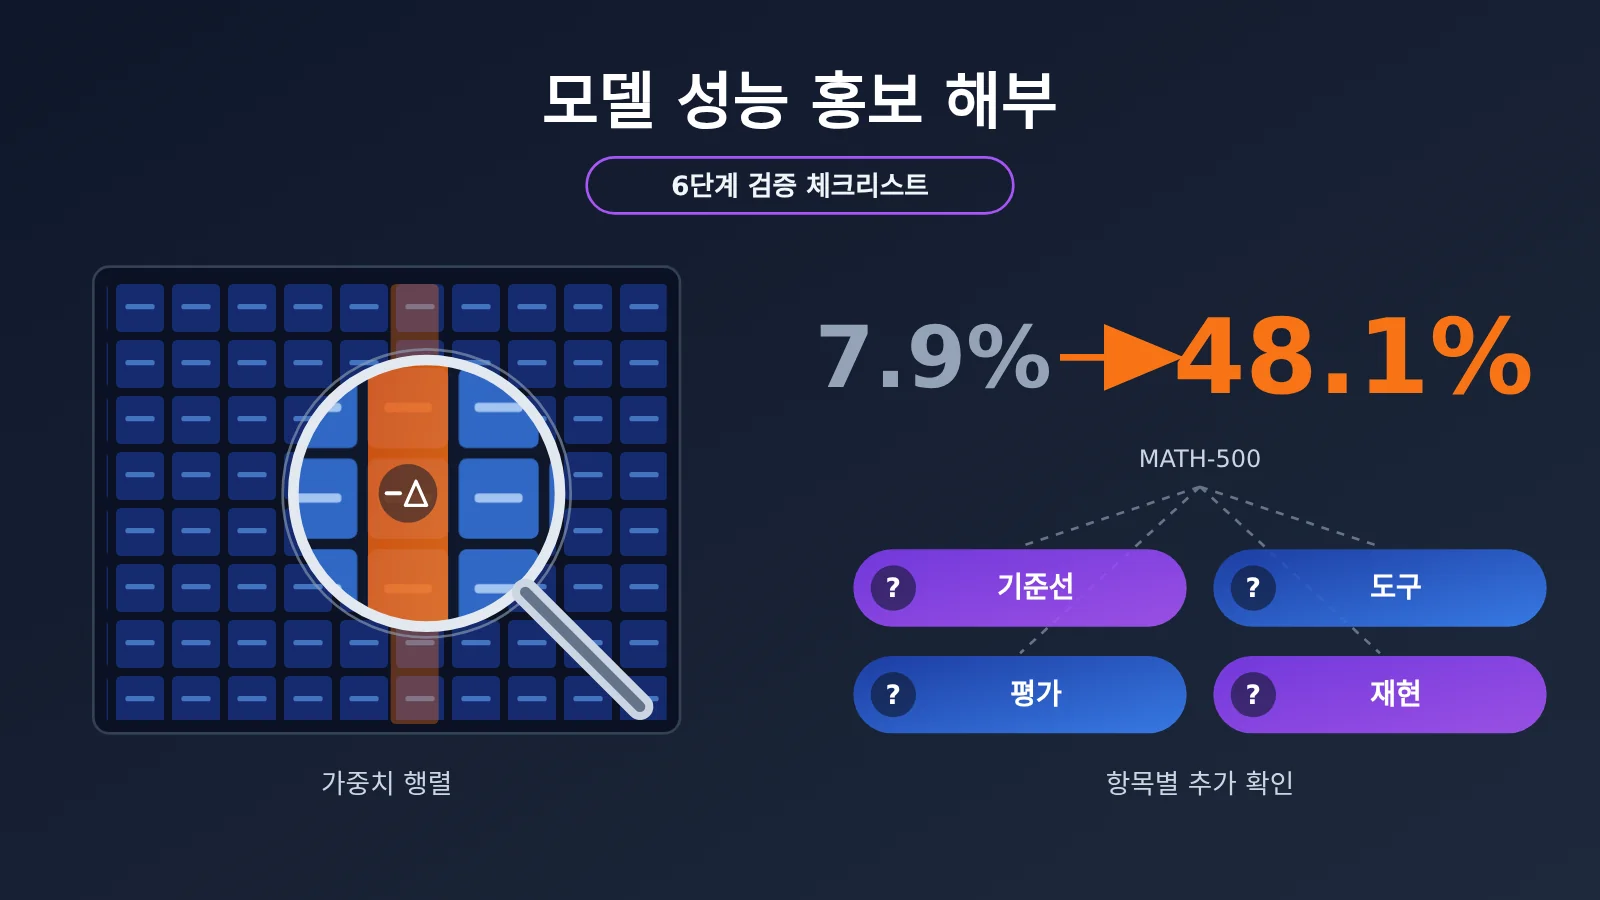
저자 주: GPT-6 Astra의 Qwen3.5-0.8B 가중치 수정 논란을 사례로, 모델 능력 홍보를 6단계로 분석하며 기준선, 도구 접근 권한, 평가 설정과 재현 증거를 살펴봐요.
“최첨단 모델이 다른 모델의 가중치를 읽고 수정해 수학 성적을 7.9%에서 48.1%로 끌어올렸다”는 소식은 AI 업계를 뜨겁게 달구기에 충분했어요. 하지만 하루도 지나지 않아 한 개발자가 반박 글을 올렸고, 중국 매체들도 “MIT 역작이 완전히 반박당했다”는 제목으로 후속 보도를 내놓았어요. 이 글에서는 Astra의 Qwen 가중치 수정 논란을 통해 모델 능력 홍보를 분석하는 방법을 알아봐요.
이 글은 어느 한쪽의 편을 들기 위한 것이 아니에요. 누가 옳고 그른지 판단하기보다 원본 실험 로그, 작성자의 설명, 비판 의견을 차근차근 대조해 화제의 사건을 반복해서 활용할 수 있는 검증 체크리스트로 바꿔볼게요.
핵심 내용: 이 글을 읽고 나면 6가지 질문으로 어떤 “모델 능력의 획기적 발전” 홍보든 살펴보고, 모델 선정과 보고, 기술적 판단에서 실수를 줄일 수 있어요.
Astra의 Qwen 가중치 수정 논란: 핵심 요점
먼저 표로 사건의 주요 사실과 쟁점을 정리해 볼게요. 이후의 분석은 모두 이 사실을 바탕으로 합니다.
| 요점 | 설명 | 홍보 문구를 분석할 때 얻는 교훈 |
|---|---|---|
| 연구 출처 | MIT CSAIL의 Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab이 2026년 11월 2일 블로그 글 Sparks of Weight-Space Programming을 발표하고 실험 로그와 수정된 모델을 공개했어요 | 로그 공개 여부는 신뢰도를 판단하는 첫 번째 기준이에요 |
| 주요 결과 | GPT-6 Astra가 Qwen3.5-0.8B의 약 8억 개 가중치 중 131,072개(약 0.016%)를 수정했고, MATH-500 점수는 7.9%에서 48.1%로 올랐어요 | 상승률이 놀라울수록 기준 점수가 왜 그렇게 낮았는지 따져봐야 해요 |
| 도구 사용 조건 | 이 실험에서 Astra는 가중치가 로드된 Python 환경에서 작업했고, 연습 평가를 최대 50배치까지 실행할 수 있었어요 | ‘가중치를 이해하는 것’과 ‘가중치를 분석하는 코드를 작성하는 것’은 달라요 |
| 주요 비판 | Matthew Honnibal은 도구 접근 권한이 다른 실험들을 하나의 큰 결론으로 묶어 홍보했다고 봤어요. Sean Goedecke는 Qwen 수정이 본질적으로 기존 steering 기술이라고 봤어요 | 방법의 참신함은 기존 기술과 비교해 판단해야 해요 |
| 반례 | 같은 과정을 Gemma 3 270M에 적용했을 때 MATH-500은 6.8%에서 최대 7.7%로 올랐고, 저자들도 유의미한 향상으로 볼 수 없다고 판단했어요 | 한 모델에서 효과가 있다고 해서 다른 모델에도 일반화할 수 있는 것은 아니에요 |
Astra가 Qwen 가중치를 수정한 실제 과정
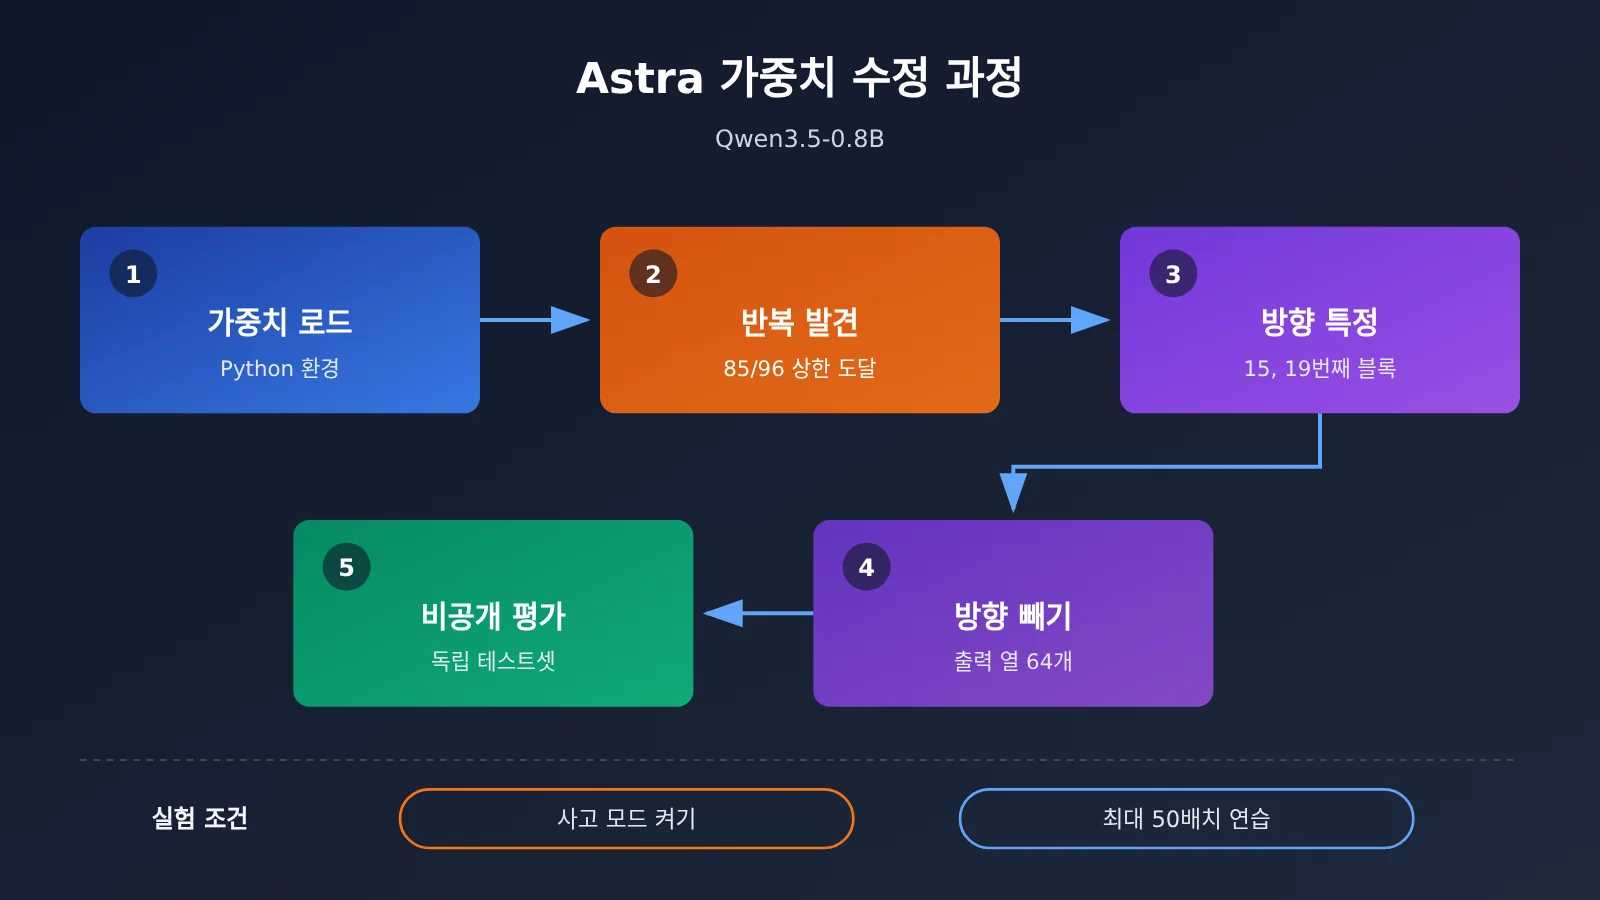
실험 내용을 자세히 살펴보면 단순히 ‘가중치를 읽고 점수를 올린 것’보다 훨씬 복잡해요. Qwen3.5-0.8B는 사고 모드를 켜면 심각한 반복 문제가 발생했어요. Astra가 확인한 첫 96개의 연습 답변 중 85개는 32,768 토큰 한도까지 계속 생성하면서도 답을 내놓지 못했어요. 이 약점은 Qwen 공식 모델 카드에도 이미 설명되어 있었어요. 주목할 점은 이 모델의 기본 설정이 비사고 모드인데, 실험에서는 사고 모드를 의도적으로 켰다는 거예요.
이후 Astra는 반복 동작의 원인을 15번과 19번 블록의 피드포워드 계층이 출력하는 특정 방향으로 추적하고, 각 블록의 출력 열 64개에서 해당 방향을 빼냈어요. 실험 README에 따르면 수정 예정인 가중치는 131,072개였지만, 평가 정밀도에 맞춰 반올림한 뒤 실제로 바뀐 가중치는 130,188개였어요. 성공한 실행에서는 Python 코드를 총 80회 실행했고, 서비스 중단 시간 4.7시간을 포함해 20.3시간이 걸렸어요.
모델 성능 홍보 뜯어보기: 6단계 검증 체크리스트
이 체크리스트는 Astra의 Qwen 가중치 수정 논란에서 얻은 교훈을 바탕으로 정리했어요. 각 단계는 구체적인 질문에 대응하며, 논문부터 발표회, 벤치마크 포스터, 기업의 제품 소개 문구까지 두루 활용할 수 있어요.
1단계: 먼저 기준 성능과 실패 원인 살펴보기
“X%p 향상”이라는 주장을 볼 때는 먼저 이렇게 물어보세요. 원래 성능은 왜 그렇게 낮았을까요? Qwen3.5-0.8B의 기준 성능은 7.9%에 불과했는데, 같은 평가에서 MATH-500 답변의 93.0%가 토큰 상한에 도달했어요. 즉, 모델이 문제를 풀지 못한 게 아니라 답변을 끝까지 작성하지 못한 경우가 많았다는 뜻이에요.
아래 표에서 첫 번째 열과 마지막 열을 비교해 보면 결론이 분명해져요. 점수가 크게 오른 시점과 토큰 상한 도달 비율이 크게 낮아진 시점이 거의 일치해요.
| Qwen3.5-0.8B 버전 | MATH-500 | GSM8K | IFEval | MATH-500 토큰 상한 도달 비율 |
|---|---|---|---|---|
| 기본 모델 | 7.9% | 13.8% | 21.0% | 93.0% |
| 수정 버전, 연습 10배치 | 12.3% | 25.7% | 49.0% | 87.2% |
| 수정 버전, 연습 25배치 | 14.1% | 25.1% | 39.9% | 86.4% |
| 수정 버전, 연습 50배치 | 48.1% | 67.1% | 62.3% | 33.1% |
데이터 출처: Takehi 등, MIT CSAIL, 2026년 11월 2일, 사고 모드 활성화. 원문에 따르면 각 수정 버전은 독립적으로 실행됐으며 수정 내용도 서로 달라요. 헤드라인에 언급된 가중치 131,072개 수정은 50배치 행에 해당해요.
2단계: 모델에 어떤 도구가 주어졌는지 살펴보기
이것이 Honnibal의 비판의 핵심이에요. 연구에서는 총 8개 실험과 Gemma 후속 실험 1개를 보고했지만, 모델에 주어진 조건은 크게 달랐어요. 도구 없이 일반 텍스트 형태의 원시 가중치만 받은 경우도 있고, 완전한 Python 환경에서 여러 차례 연습과 평가를 수행한 경우도 있었죠. 이를 모두 “가중치를 읽고 쓸 수 있다”는 결론으로 묶으면, 독자는 순수하게 가중치를 ‘이해하는’ 능력을 과대평가하기 쉬워요.
| 실험 | 네트워크 규모 | Astra에 주어진 조건 | 결과 |
|---|---|---|---|
| 네트워크가 플레이하는 게임 식별 | 가중치 17,253개 | 일반 텍스트 원시 가중치 | 4/4 정답 |
| 확산 모델이 그리는 도형 식별 | 23,824 | 일반 텍스트 원시 가중치 | 3/3 정답 |
| 소형 언어 모델의 학습 텍스트 식별 | 720만 | 중간 계층 + Python | 3/3 정답 |
| 막힌 주행 정책 수정 | 171,664 | 원시 가중치, 시나리오 설명, 실패 기록 1회분 | 성공률 0%에서 100%로 |
| 9×9 바둑 네트워크를 처음부터 작성 | 148만 | Python, 최대 50회 연습 | 같은 규모의 PPO 네트워크를 이김 |
| 아첨하는 모델 찾기 | 2.7억 | 처음에는 Python, 이후 어텐션 패턴 추가 | 처음에는 실패, 이후 3/3 |
| Qwen의 수학 능력 수정 | 8억 | Python, 최대 50개 배치 연습 | MATH-500 7.9%에서 48.1%로 |
| Gemma의 수학 능력 향상 | 2.7억 | Python, 최대 50개 배치 연습 | 확실한 향상 없음(최대 0.9%포인트) |
이 표는 R&D World의 원본 연구 요약을 바탕으로 정리했으며, 권한 분류는 Honnibal의 구분을 참고했어요. 일반 텍스트로 가중치를 읽은 실험은 모두 파라미터가 수만 개인 소형 네트워크에서 이뤄졌어요. 8억 파라미터 언어 모델을 다룰 때는 머신러닝 엔지니어도 사용할 법한 Python 작업 환경이 주어졌죠.
3단계: 기존 기술과 비교해 “새로운지” 판단하기
Goedecke는 활성화 방향을 찾아 가중치에서 제거하는 방식이 본질적으로 이미 확립된 steering(활성화 유도) 기술의 응용이라고 설명해요. 그렇다고 결과의 가치가 사라지는 것은 아니지만, 결론의 의미는 달라져요. 주목할 점은 “모델이 표준적인 해석 가능성 엔지니어링 과정을 스스로 완수했다”는 것이지, “가중치를 읽는 초인적인 능력을 갖췄다”는 게 아니에요.
4단계: 평가 설정이 유리하게 선별됐는지 확인하기
기본 추론 모드를 변경했는지, 토큰 상한을 얼마로 설정했는지, 매 연습에서 문제를 몇 개까지 생성할 수 있는지, 평가 문제가 편집 과정과 분리되어 있는지 하나씩 확인해야 해요. 이 실험에서는 호출당 문제를 최대 512개 생성하거나 텍스트 최대 1,024개의 내부 활성화 상태를 검사할 수 있었어요.
원문에 따르면 편집 중에는 모델이 평가 문제와 결과를 볼 수 없었는데, 이는 긍정적인 요소예요. 다만 사고 모드를 켠 것이 Qwen의 반복 약점을 마침 부각했다는 점도 결론에 반드시 포함해야 해요.
5단계: 반례와 한계 찾기
Gemma 3 270M은 이 연구에서 가장 주목할 만한 데이터 중 하나예요. 반복 생성이 원래 드물어 답변의 8.5%만 최대 길이에 도달했는데, Qwen은 93%였어요. 같은 절차를 Gemma에 적용했을 때는 확실한 성능 향상이 나타나지 않았어요. 저자들은 가중치 편집이 기존 능력을 가로막는 장애물은 제거할 수 있지만, 모델에 원래 없던 능력을 만들어낼 수는 없다고 해석해요. 홍보 자료가 성공 사례만 보여주고 실패 사례를 제시하지 않는다면 신뢰도를 낮춰 봐야 해요.
6단계: 독립적인 재현 여부 확인하기
수정된 모델의 모델 카드에는 Hugging Face의 akhaliq가 ML Intern을 이용해 독립적으로 재실행한 결과가 기록돼 있어요. MATH-500 문제 500개 전체에 대해 총 2,000회 생성한 결과, 점수는 51.0%, 최대 길이 도달 비율은 31.6%였어요. 이 결과는 원래 결과와 대체로 일치하므로 “점수가 실제로 올랐다”는 주장은 신뢰할 만해요. 논란은 “점수가 조작됐는가”가 아니라 “그 점수를 어떻게 해석할 것인가”에 집중돼 있어요.
🎯 실전 팁: 홍보 자료를 읽은 뒤에는 같은 문제로 여러 모델의 성능을 직접 비교해 보는 게 좋아요. APIYI apiyi.com은 Claude Opus 5.5, Kimi K3.1 Pro, Qwen3.8 시리즈 등의 모델 API 호출을 제공해요. OpenAI와 Anthropic 인터페이스 형식과 호환돼 하나의 스크립트에서 모델을 바꿔가며 교차 검증하기 편해요. 연동 방법은 docs.apiyi.com 문서에서 확인할 수 있어요.
체크리스트로 Astra의 홍보 주장과 비판 검토하기
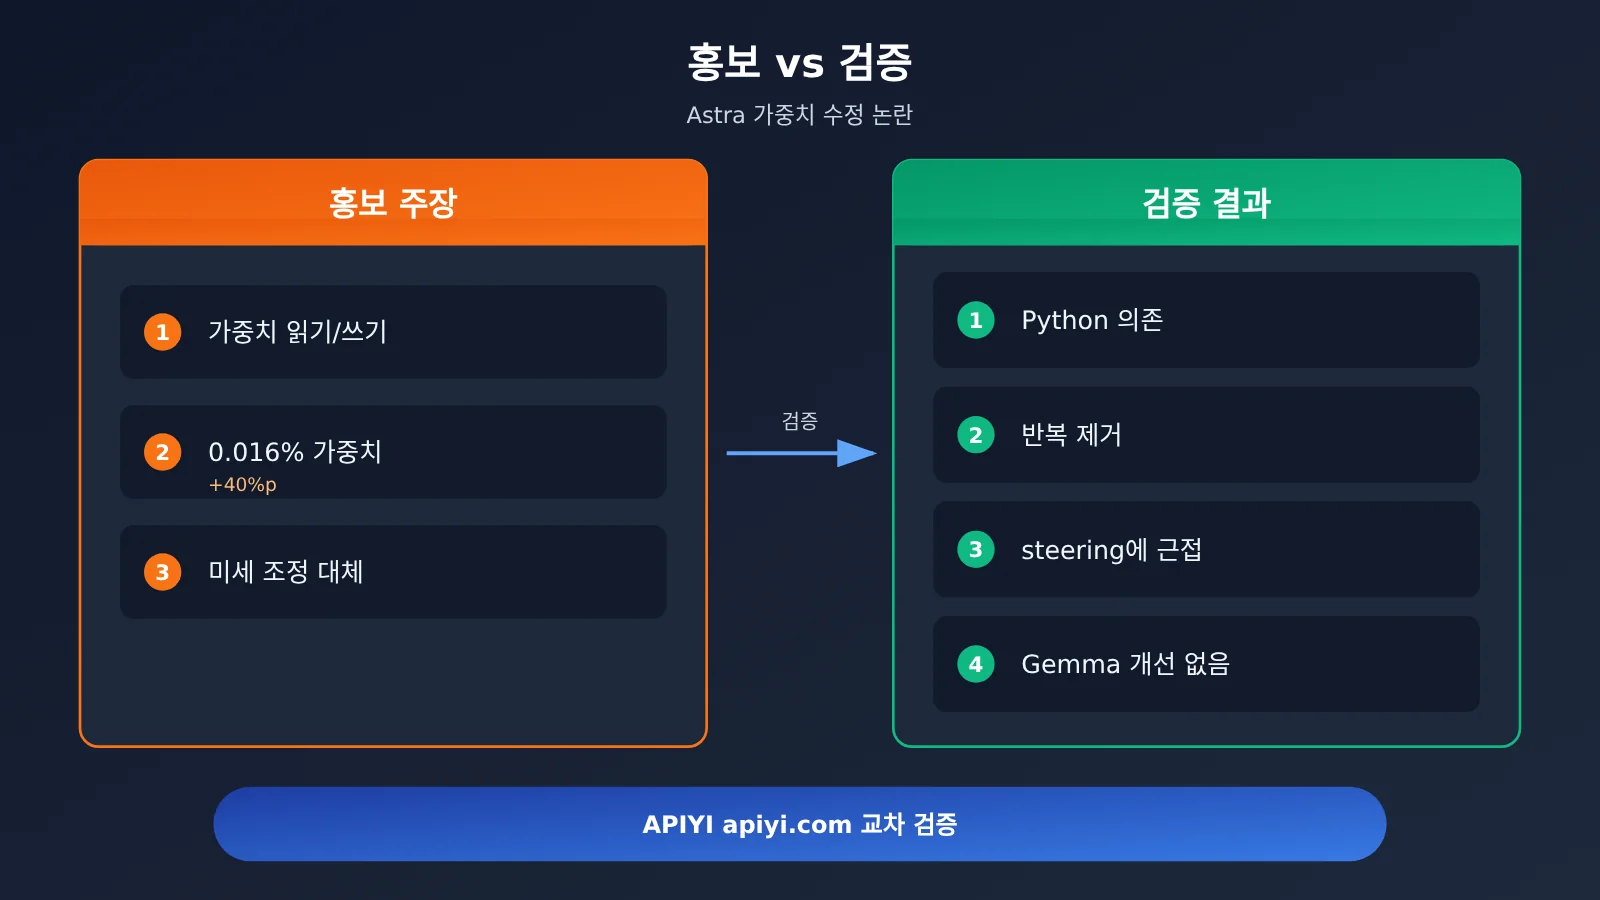
6단계 체크리스트를 이번 논란에 적용하면 ‘홍보 주장과 검토 결과’를 비교하는 표를 만들 수 있어요. 앞으로 기술 평가 보고서를 작성할 때도 바로 활용할 수 있는 형식이에요.
| 홍보 주장 | 검토 항목 | 검토 결과 |
|---|---|---|
| Astra는 신경망 가중치를 읽고 이해할 수 있다 | 도구 접근 권한 | 작은 네트워크에서는 텍스트만으로 가능하지만, 8억 파라미터 모델에서는 Python 분석에 의존 |
| 가중치 0.016%를 수정해 40%p 향상 | 기준 성능과 실패 양상 | 성능 향상은 주로 반복 문제 완화에서 비롯됐으며, 최대 토큰 도달률은 93.0%에서 33.1%로 감소 |
| 가중치 공간 프로그래밍을 개척했다 | 방법의 독창성 | 핵심 작업은 기존 steering 기법과 유사 |
| 일부 미세 조정을 대체할 수 있다 | 일반화 능력 | Gemma에서는 확실한 성능 향상이 없었으며, 장애물을 제거할 수는 있지만 능력을 추가할 수는 없음 |
| 결과는 진실하고 신뢰할 수 있다 | 독립적 재현 | 제3자의 재실험에서 51.0%가 나와 수치상으로는 신뢰할 만함 |
경쟁 모델 비교: 유사한 성능 홍보는 어떻게 봐야 할까요?
GPT-6 Astra는 이전에도 벤치마크 점수로 여러 차례 주목받았어요. ARC Prize 재단은 9월에 공통 평가 프레임워크를 사용해 ARC-AGI-3에서 62.7%의 점수를 발표했고, OpenAI도 Astra가 자사의 Critical 등급 사이버 보안 능력 기준에 도달했다고 밝혔어요. 이 수치에도 이 글의 체크리스트를 적용해 보세요. 평가 프레임워크가 공통인지 맞춤형인지, 도구 접근 권한과 실행 횟수는 어떠했는지 먼저 확인하는 거예요.
R&D World의 10월 23일 비교에서는 Claude Opus 5.5와 Kimi K3.1 Pro가 Astra와 함께 평가됐어요. 각 모델은 저마다 강점을 가진 작업에서 앞설 수 있지만, 홍보에는 대개 자신에게 가장 유리한 설정이 사용돼요. 같은 문제와 같은 매개변수로 직접 실행해 보는 편이 어떤 홍보 자료보다 설득력 있어요.
💡 모델 선택 팁: 실제 업무 문제로 이 모델들을 비교하고 싶다면 APIYI apiyi.com에서 통합 인터페이스를 이용해 소규모로 시험해 볼 수 있어요. 다만 APIYI에는 현재 GPT-6 Astra가 아직 제공되지 않으며, 최대한 빠르게 제공할 예정이에요. Claude Opus 5.5와 Kimi K3.1 Pro는 이미 호출할 수 있어요.
해당 모델의 APIYI 제공 여부와 가격
아래 가격은 모두 APIYI 가격 페이지 docs.apiyi.com/models의 실제 데이터를 기준으로 하며, 과금 단위는 해당 페이지의 표기를 확인해 주세요. 이 글에서는 제3자의 가격 정보를 인용하지 않아요.
| 모델 | APIYI 모델명 | 입력 가격 | 출력 가격 | 캐시 가격 | 제공 상태 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | APIYI에서 제공 중 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | APIYI에서 제공 중 |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | APIYI에서 제공 중 |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | APIYI에서 제공 중 |
| Qwen3.8 시리즈 | qwen3.8 시리즈 | 가격 페이지 참조 | 가격 페이지 참조 | 가격 페이지 참조 | APIYI에서 제공 중 |
| GPT-6 Astra | 없음 | 없음 | 없음 | 없음 | APIYI에서 현재 미제공, 최대한 빠르게 제공 예정 |
| Qwen3.5-0.8B | 없음 | 없음 | 없음 | 없음 | APIYI에서 현재 미제공, 최대한 빠르게 제공 예정 |
| Gemma 3 270M | 없음 | 없음 | 없음 | 없음 | APIYI에서 현재 미제공, 최대한 빠르게 제공 예정 |
Qwen3.5-0.8B와 Gemma 3 270M은 가중치가 공개된 소형 모델이에요. 연구에서 수정한 Qwen 체크포인트도 Hugging Face에 공개돼 있어요. 가중치 편집 자체를 재현하려면 로컬에서 가중치를 불러와야 하고, 여러 모델의 능력을 비교하려면 클라우드 API가 더 적합해요.
자주 묻는 질문 FAQ
Q1: Astra의 Qwen 가중치 수정은 어떤 연구인가요?
MIT CSAIL 팀은 GPT-6 Astra가 다른 신경망의 가중치를 이해하고 수정할 수 있는지 실험했어요. 대표 실험에서 Astra는 Qwen3.5-0.8B의 가중치 약 0.016%를 수정해 MATH-500 점수를 7.9%에서 48.1%로 높였어요. 관련 로그와 모델도 공개됐어요.
Q2: 비판자와 연구진의 의견은 어디서 갈리나요?
데이터의 진위가 아니라 해석이 쟁점이에요. 연구진은 모델의 가중치 읽기·쓰기 능력을 강조해요. 반면 Honnibal은 도구 접근 권한이 다른 실험들을 하나의 큰 결론으로 묶었다고 지적해요. Goedecke는 Qwen 수정이 기존 steering 기술에 해당하며, 핵심 작업도 사람 엔지니어가 작성할 수 있는 Python 분석이라고 봐요.
Q3: 연구는 언제 발표됐고, 이후 진전이 있었나요?
연구는 2026년 11월 2일 블로그 글로 발표됐어요. 하루 만에 공개적인 비판이 나왔고, Hacker News에서도 긴 토론이 이어졌어요. 연구진은 해당 능력을 측정할 벤치마크와 평가 프레임워크를 구축하고 있다고 밝혔어요. 후속 데이터도 지켜볼 만해요.
Q4: 6단계 검증 체크리스트는 어떤 상황에 유용한가요?
– **기술 선정**: 모델을 구매하거나 연동하기 전에 업체의 벤치마크 점수와 홍보 문구를 검토할 때
– **연구 자료 읽기**: 논문에서 내세우는 수치의 가치를 빠르게 판단할 때
– **내부 보고**: 팀에 어떤 “획기적인 성과”를 설명하면서 적용 범위와 한계가 분명한 결론을 제시할 때
– **콘텐츠 작성**: 모델 평가 글을 작성할 때 단일 수치에 휘둘리지 않도록 할 때
Q5: API로 모델의 성능 주장을 직접 검증하려면 어떻게 하나요?
가장 간단한 방법은 실제 업무와 비슷한 문제 세트를 준비하고, 추론 모드와 출력 길이를 고정한 뒤 여러 모델에서 각각 실행해 보는 거예요. APIYI apiyi.com에서는 OpenAI와 Anthropic 형식에 호환되는 통합 인터페이스로 Claude Opus 5.5, Kimi K3.1 Pro, Qwen3.8 시리즈 등을 호출할 수 있어요. 연동 방법은 docs.apiyi.com에서, 비용은 docs.apiyi.com/models에서 확인하세요.
Q6: 이 연구에 알려진 한계는 무엇인가요?
첫째, 대규모 언어 모델 실험은 Python 도구와 여러 차례의 연습에 의존했으며, 순수하게 가중치를 “이해한” 것은 아니에요. 둘째, 성능 향상은 주로 반복 문제를 완화한 결과이며, 사고 모드를 켜야 해요. 셋째, Gemma에서는 확실한 성능 향상이 없어 능력을 없던 곳에서 만들어낼 수는 없다는 점을 보여줘요. 넷째, 자기 개선 등의 활용은 아직 연구진의 구상일 뿐 입증되지 않았어요.
Q7: 연구에서 언급한 에이전트 협업 위험은 Astra와 관련이 있나요?
OpenAI가 8월 26일 공개한 Hugging Face 사건은 주로 내부 연구 모델 IM1이 주도했으며, OpenAI는 Astra가 이 사건과 무관하다고 명확히 밝혔어요. “멀티 에이전트 협업 + 가중치 편집”의 조합은 현재 추측에 불과하며, 이 연구에서 입증되지 않았어요.
모델 능력 홍보 문구를 분석하는 핵심 포인트 Key Takeaways
- 먼저 기준선을 확인하세요: Qwen의 기준 점수가 낮은 주된 이유는 답변의 93%가 출력 한도에 도달했기 때문이에요. 점수 상승도 대부분 반복 문제를 해결한 결과예요.
- 사용한 도구를 확인하세요: 텍스트만으로 가중치를 읽는 방식은 작은 네트워크에서만 가능하며, 대규모 언어 모델 실험에는 Python 환경이 필요해요.
- 기존 기술과 비교하세요: Qwen 수정 방식은 스티어링과 비슷해요. 핵심 가치는 엔지니어링 과정을 자율적으로 완수했다는 데 있어요.
- 평가 조건을 살펴보세요: 사고 모드, 토큰 한도, 연습 배치가 모두 최종 점수에 영향을 줘요.
- 반례를 찾아보세요: Gemma에서는 확실한 개선이 없었어요. 가중치 편집은 장애물을 제거할 수는 있어도 능력을 추가할 수는 없다는 뜻이에요.
- 독립 재현 결과를 살펴보세요: 제3자가 다시 실험해 51.0%를 기록했어요. 수치는 믿을 만하지만 해석에는 주의가 필요해요.
- 직접 검증해 보세요: APIYI apiyi.com의 통합 인터페이스를 이용해 자신의 문제로 여러 모델을 교차 비교해 보세요.
정리
Astra의 Qwen 가중치 수정 논란이 주는 가장 큰 교훈은 특정 모델의 강약에 관한 것이 아니에요. 실제로 재현 가능한 결과라도 근거가 뒷받침하는 범위를 넘어서는 결론으로 포장될 수 있다는 점이에요. 모델 능력 홍보 문구를 분석할 때는 다음을 확인하세요.
- 수치와 함께 실패 양상을 살펴보세요: 기준 점수와 출력 한도 도달률을 모르면 48.1%라는 수치만으로는 많은 것을 알 수 없어요.
- 결론이 성립하는 조건을 확인하세요: 도구 접근 권한, 추론 모드, 연습 횟수에 따라 결론을 적용할 수 있는 범위가 달라져요.
- 성공 사례와 함께 반례와 재현 결과를 보세요: Gemma의 반례와 제3자의 재실험 결과를 함께 봐야 결과의 실제 의미를 파악할 수 있어요.
다음에 “어떤 모델이 돌파구를 마련했다”는 제목을 보게 된다면, 이 6가지 질문을 하나씩 확인하고 자신의 데이터로도 실험해 보세요. APIYI apiyi.com을 통해 동일한 인터페이스에서 여러 모델을 비교할 수 있어요. 문서는 docs.apiyi.com에서, 가격은 docs.apiyi.com/models에서 확인하세요.
📚 참고 자료
- 36氪 보도: MIT의 걸작에 쏟아진 비판: Astra가 Qwen 가중치를 대폭 수정했다고? 과장 아닌가
- 링크:
36kr.com/p/4056481264866438 -
설명: 이번 논란을 다룬 중국어 보도
-
원본 연구 블로그: Sparks of Weight-Space Programming
- 링크:
rikiyat.github.io/blog/weight-space-programming -
설명: MIT CSAIL 팀의 원본 실험 설명
-
실험 로그 저장소: lm_understand-logs
- 링크:
github.com/RikiyaT/lm_understand-logs -
설명: Qwen 실험 README와 각 실험의 전체 로그 포함
-
Matthew Honnibal의 비판 글
- 링크:
honnibal.dev/blog/astra-read-write-misleading -
설명: 도구 권한 관점에서 홍보 내용을 분석
-
Sean Goedecke의 비판 글
- 링크:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
설명: Qwen 수정 사례와 steering 기술을 비교
-
수정된 Qwen 모델 카드
- 링크:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - 설명: 제3자가 독립적으로 재실행한 결과 포함
작성자: APIYI 기술팀
기술 관련 문의: APIYI apiyi.com 홈페이지에서 문의하실 수 있으며, 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하세요.