작성자 주: 새 모델이 공개된 뒤, 자체 장기 작업으로 교체할 가치가 있는지 어떻게 검증할까요? 이 글은 이 질문을 실행 가능한 5단계 프로세스로 나눠 봅니다.
새 모델은 거의 매달 공개되고, 벤치마크 리더보드도 계속 갱신되고 있어요. 2026년 11월 정식 공개된 텐센트 훈위안 Hy4를 예로 들면, 공식 설명에 따르면 이 모델은 프리뷰 버전보다 에이전트 능력과 장기 작업에 맞춘 최적화를 했고, 여러 벤치마크에서 오픈소스 모델 상위권에 들었어요. 하지만 개발자에게 진짜 질문은 하나예요. 내 작업에서 지금 쓰는 모델보다 더 나은가? 이 글에서는 자체 장기 작업 기반의 새 모델 대조 검증 방법을 소개할게요. 하루이틀이면 데이터로 뒷받침된 결론을 낼 수 있게 도와드려요.
또 하나의 벤치마크 해설은 아니에요. 리더보드는 범용 능력을 재지만, 여러분의 비즈니스가 재는 건 이거예요. 여러 단계로 된 일을 처음부터 끝까지 해낼 수 있는지, 오류가 나면 스스로 복구할 수 있는지, 작업 한 건을 끝낼 때마다 얼마가 드는지.
핵심 가치: 이 글을 읽고 나면 작지만 정확한 장기 작업 검증 세트를 만들고, 6개 지표로 신모델과 기존 모델을 비교하고, 실제 과금을 반영해 “성공적인 결과물 1건당 비용”을 계산한 뒤, 교체할지 말지 결정할 수 있어요.
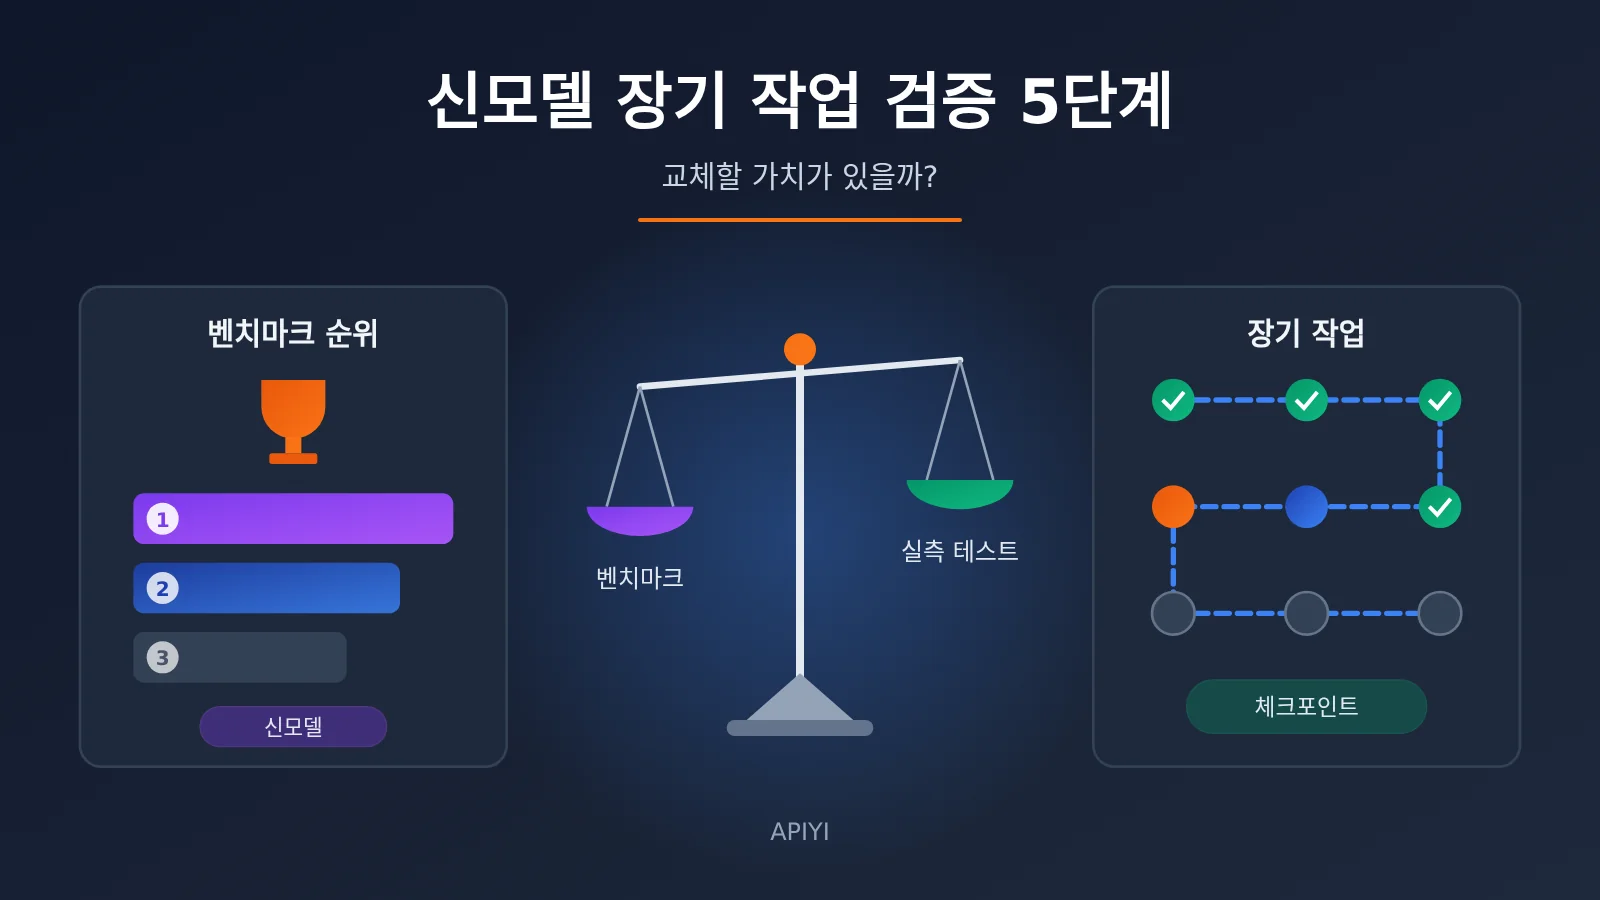
새 모델 장기 과제 검증의 핵심 포인트
작업에 들어가기 전에, 장기 과제 검증과 일반적인 단일 턴 테스트의 차이를 먼저 짚어볼게요. 단일 턴 테스트는 “한 번의 답변이 얼마나 훌륭한가”를 보지만, 장기 과제 검증은 “수십 단계를 지나도 목표가 여전히 남아 있는가”를 봐요.
| 핵심 포인트 | 설명 | 가치 |
|---|---|---|
| 자체 과제 사용 | 실제 업무에서 3~5개의 다단계 과제를 추출해 사용하고, 공개 문제는 쓰지 않아요 | 결론이 곧바로 비즈니스 성과와 연결돼요 |
| 고정 대조군 | 현재 운용 중인 모델과 새 모델을 같은 과제, 같은 툴체인에서 실행 | 프롬프트와 환경 차이를 배제 |
| 과정 지표 우선 | 목표 유지, 자기 교정, 인간 개입 횟수를 기록 | 벤치마크 점수로는 보이지 않는 안정성 문제를 발견 |
| 납품 기준 비용 산정 | “성공적 납품 1회”를 단위로 token 비용을 산정 | 단가만 보다가 오판하는 것을 방지 |
| 모델 교체 기준 설정 | “얼마나 개선되어야 교체할 가치가 있는가” 기준을 미리 정해두기 | 단 하나의 인상적인 사례로 판단이 흔들리는 것을 방지 |
장기 과제 검증이 벤치마크 점수보다 신뢰할 수 있는 이유
공개 리더보드의 문제는 대개 폐쇄적이고 단계가 짧지만, 실제 Agent 업무는 정반대예요. 참고 평가에서 Hy4에 주어진 장기 과제는 조사, 개발, 검토, 재작업을 거쳐 플레이 가능한 3D 게임까지 완성하는 것이었고, 중간에 참조 영상과 새 요구사항까지 추가됐어요. 이런 과제는 단계가 계속 늘어나는 상황에서 모델이 최초 계획을 기억하고, 완료된 일과 미완료된 일을 구분하며, 중간 결과가 예상과 다를 때 계획을 조정할 수 있는지를 시험해요.
또 하나 눈여겨볼 점은 “모델 + 툴체인”의 시너지 효과예요. 같은 평가에서 Hy4는 WorkBuddy 안에서 30분 만에 PPT 14개, Excel 하나, 19페이지짜리 Word 문서 하나를 생성했어요. 평가자도 모델은 이해·계획·판단을 담당하고, 툴체인은 읽기·계산·렌더링·쓰기를 담당한다고 분명히 밝혔어요. 이 말은 새 모델을 검증할 때 반드시 자신의 툴체인 안에서 실행해야 하며, 환경을 떠난 결론은 참고 가치가 제한적이라는 뜻이에요.
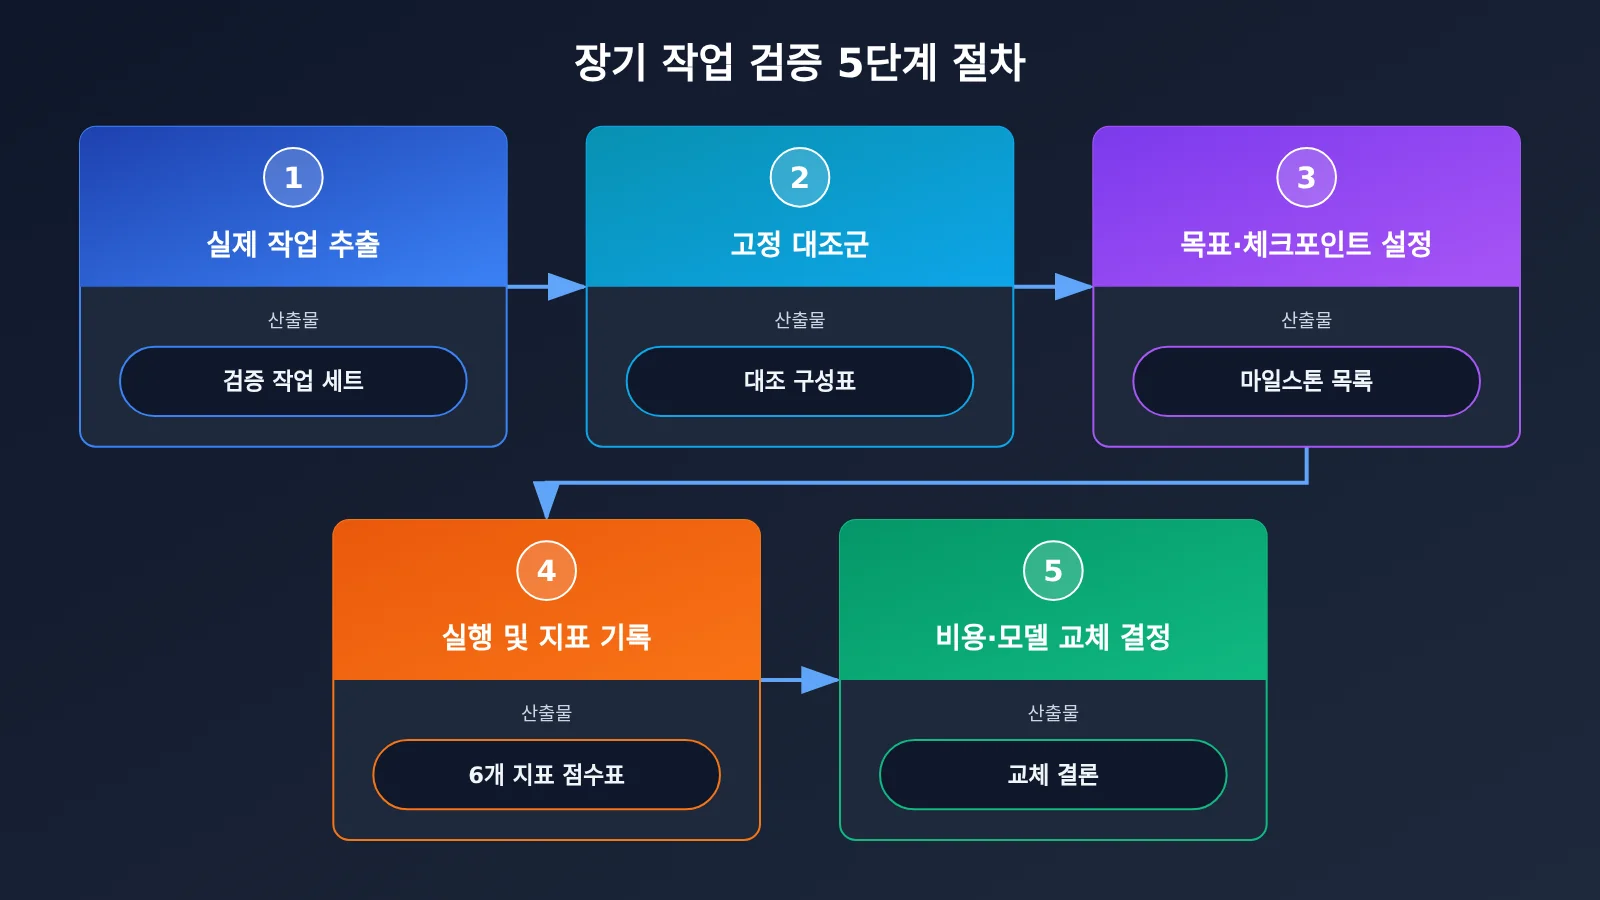
새 모델 장기 작업 검증 빠르게 시작하기: 5단계 프로세스
아래 프로세스는 특정 프레임워크에 의존하지 않아요. 모델 호출이 통합 인터페이스를 사용한다면, 적은 비용으로 모델을 바꿔가며 비교할 수 있어요.
1단계: 실제 업무에서 장기 작업 추출하기
검증 세트는 많기보다 ‘비슷한가’가 중요해요. 3~5개의 작업을 골라서, 여러분의 업무에서 가장 흔하고, 가장 인력이 많이 들고, 가장 실수가 잦은 세 가지 유형의 시나리오를 커버하는 게 좋아요. 각 작업은 ‘최소 10단계 이상, 도구 호출 필요, 명확한 산출물 존재’라는 세 가지 조건을 만족하는 게 좋아요.
다음과 같은 전형적인 장기 작업 유형을 참고해서 자신만의 버전을 설계할 수 있어요:
- 문서 배치 처리 유형: 십여 편의 자료가 담긴 폴더를 주고, 각 문서를 요약하고 보고 자료를 생성한 뒤 표와 보고서로 취합하도록 요구해요.
- 애플리케이션 개발 유형: 요구사항 설명에서 출발해 개발, 자체 테스트, 수정을 거쳐 최종적으로 실행 가능한 산출물을 전달해요.
- 멀티모달 복제 유형: 스크린샷이나 화면 녹화를 업로드하고, 모델이 내용을 이해한 뒤 대응하는 인터페이스나 인터랙션을 재현하도록 요구해요.
- 컴퓨터 조작 유형: 모델이 화면을 보고, 버튼을 찾아 클릭하고 입력하면서 소프트웨어를 넘나드는 조작 프로세스를 완료하게 해요.
2단계: 대조군과 실행 환경 고정하기
대조 실험의 핵심은 “변수 하나만 바꾸는 것”이에요. 기존 모델과 신규 모델은 반드시 동일한 시스템 프롬프트, 동일한 도구 정의, 동일한 입력 자료를 사용해야 해요. 각 작업마다 최소 3회 이상 실행해서 평균값과 최악값을 함께 확인하는 걸 권장해요. 장기 과제는 단일 턴 질의응답보다 무작위성이 훨씬 크기 때문이에요.
| 설정 항목 | 권장 설정 | 설명 |
|---|---|---|
model |
현역 모델 vs 신규 모델 | 유일하게 변경이 허용되는 파라미터 |
temperature |
두 그룹 동일하게 유지, 낮은 값 권장 | 무작위성이 결론에 끼치는 간섭 감소 |
max_tokens |
작업의 최대 출력 길이에 여유를 두고 설정 | 잘림으로 인한 모델 성능 오판 방지 |
도구 정의 tools |
완전히 동일한 함수 목록과 설명 | 도구 설명의 차이가 호출 동작에 크게 영향 |
| 시스템 프롬프트 | 동일 버전 사용, 신규 모델에 맞춰 튜닝하지 않음 | 먼저 “기본 상태(out-of-the-box)”를 측정하고, 그다음 튜닝 후 성능을 측정 |
| 반복 횟수 | 작업당 최소 3회 | 최고 성적이 아닌 안정성 관찰 |
프로젝트에서 OpenAI 스타일과 Anthropic 스타일 인터페이스를 동시에 사용한다면, 모델을 바꾸는 일은 곧 SDK를 바꾸고, 인증 방식을 바꾸고, 요청 형식을 바꾸는 일이 되어 대조 실험이 상당히 번거로워져요. 통합 API 집계 플랫폼을 통해 호출하면 model 필드만 수정해서 전환을 완료할 수 있어요.
🚀 빠른 시작 가이드: APIYI apiyi.com은 본문에 등장하는 주요 모델 API 호출을 제공하며, OpenAI와 Anthropic 인터페이스 형식을 모두 호환해요. 대조 실험을 할 때
model파라미터만 교체하면 기존 모델과 신규 모델 사이를 전환할 수 있어요. 접속 방식,base_url, 인증 설정은 APIYI 문서 센터 docs.apiyi.com을 기준으로 삼아 주세요.
3단계: 작업에 목표 기준점과 체크포인트 설정하기
장기 작업에서 가장 흔한 실패 유형은 “할 줄 몰라서”가 아니라 “하다 보니 무엇을 해야 하는지 잊어버리는 것”이에요. 참고 평가에서는 /goal 명령으로 모델이 항상 구체적인 목표를 유지하도록 제약했는데, 이 아이디어는 어떤 검증 환경에도 적용할 수 있어요. 작업을 시작할 때 최종 목표를 분명히 적고, 결과물을 몇 개의 검증 가능한 마일스톤으로 나누면 돼요.
“사실적인 3D 미니 게임” 작업을 예로 들면, 평가자는 목표를 5가지로 나눴어요. 게임 장면, 비주얼과 손맛, 사운드와 게임플레이, 워크플로, 최종 결과물이에요. 여러분의 작업도 이렇게 나눠야 하고, 각 마일스톤에는 “완료/미완료”를 객관적으로 판단할 수 있는 체크포인트를 하나씩 두면 이후 채점이 훨씬 간단해져요.
4단계: 실행하고 6가지 지표 기록하기
매 실행마다 전체 대화와 도구 호출 로그를 남긴 다음, 아래 표에 따라 점수를 매기세요. 앞의 4개 항목은 “끝낼 수 있는가”를, 뒤의 2개 항목은 “비용 대비 효율이 좋은가”를 측정해요.
| 지표 | 측정 방법 | 평가 방식 |
|---|---|---|
| 작업 완료율 | 완료한 체크포인트 수 / 전체 체크포인트 수 | 백분율, 3회 평균 |
| 목표 유지도 | 후반부에도 초기 목표를 중심으로 진행했는지, 누락이나 탈선이 없었는지 | 1-5점 수동 평가 |
| 자기 교정 능력 | 중간에 오류(에러, 테스트 실패)가 발생한 뒤 스스로 수정할 수 있었는지 | “오류 발생 횟수 / 자체 복구 횟수” 기록 |
| 수동 개입 횟수 | 사람이 추가 설명을 하거나 방향을 바로잡아야 했던 턴 수 | 횟수가 적을수록 좋음 |
| 소요 시간 | 시작부터 결과물 전달까지의 실제 경과 시간 | 분 단위, 도구 실행 시간 포함 |
| 1회 전달 비용 | 총 token 비용 / 성공적 전달 횟수 | 실제 과금 기준으로 산정 |
“수동 개입 횟수”는 특히 중요해요. 참고 평가의 결론은 Hy4가 대부분의 일상 업무와 창작 작업에서는 거의 한 번에 결과물을 내놓지만, 컴퓨터 조작이 많고 프로세스가 복잡한 작업에서는 의도를 이해하도록 여러 차례 상호작용이 필요하다는 것이었어요. 바로 이 차이를 여러분의 작업에서 수치화해야 해요. 개입이 한 번 발생한다는 건 인건비가 한 번씩 더 드는 셈이니까요.
5단계: 비용을 산정하고 모델 교체를 결정하기
비용 산정은 입력·출력 단가만 비교하는 것이 아니라 “성공적으로 전달된 1회”를 기준으로 해야 해요. 단가는 저렴하지만 두 번 다시 실행해야 하는 모델은 실제 비용이 더 높을 수 있죠. 장기 실행 작업에는 또 하나의 특징이 있어요. 컨텍스트가 이전 내용을 반복해서 함께 전달하기 때문에 캐시 적중률이 총비용에 큰 영향을 줍니다.
계산 방식은 다음과 같아요. 단일 작업 비용 = 캐시 미적중 입력 토큰 × 입력 단가 + 캐시 적중 입력 토큰 × 캐시 단가 + 출력 토큰 × 출력 단가이고, 여기에 여러 번 실행한 총비용을 성공 전달 횟수로 나눕니다. 각 모델의 입력 단가, 출력 단가, 캐시 가격 및 과금 기준은 APIYI 가격 페이지 docs.apiyi.com/models의 실제 데이터를 기준으로 해 주세요. 이 글에서는 가격 변동으로 인한 오해를 피하기 위해 구체적인 수치를 제시하지 않습니다.
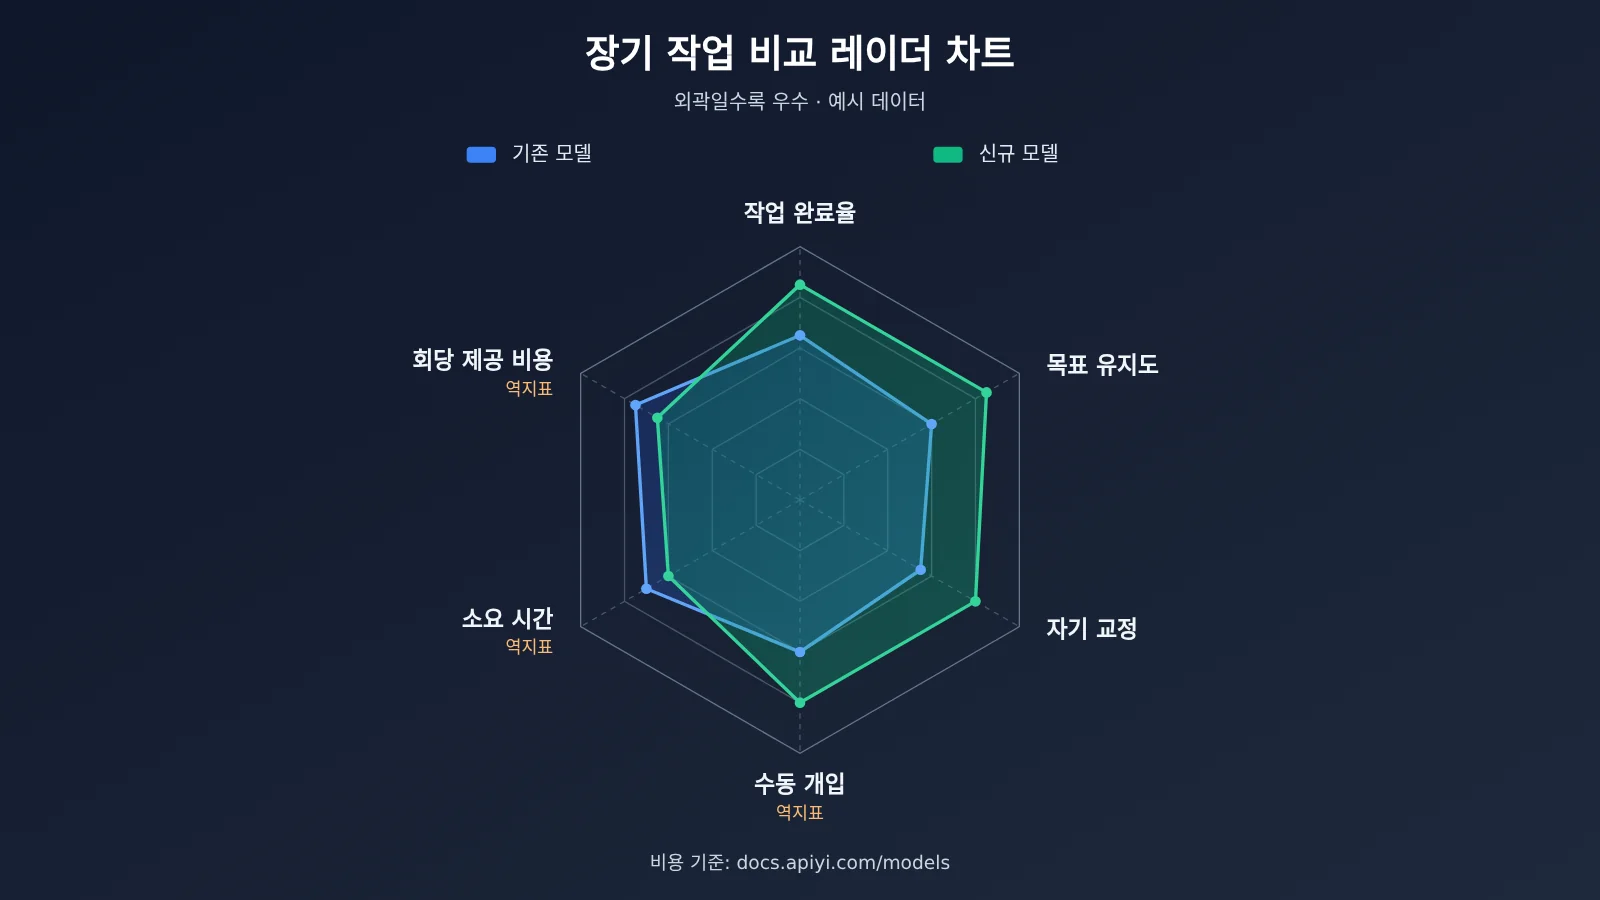
💰 비용 산정 팁: 비교할 때는 기존 모델과 신규 모델을 모두 같은 플랫폼에서 호출하는 것이 좋아요. 사용량 통계와 과금 기준이 일치해야 계산한 “1회 전달 비용”을 비교할 수 있습니다. APIYI의 가격 페이지 docs.apiyi.com/models에는 각 모델의 입력, 출력, 캐시 가격이 나와 있어 바로 산정 근거로 사용할 수 있어요.
새 모델 장기 작업 검증의 의사결정 기준
데이터를 다 돌린 뒤 가장 걱정되는 건 “각자 장단점이 있어 결정을 못 내리는 상황”이에요. 실험을 시작하기 전에 의사결정 규칙을 미리 적어두는 걸 권해요. 아래 표를 출발점으로 삼고, 비즈니스 민감도에 따라 임계값을 조정하면 됩니다.
| 비교 결과 | 권장 결정 | 이유 |
|---|---|---|
| 완료율이 뚜렷이 상승하고, 1회 납품 비용은 비슷하거나 하락 | 바로 전환 | 품질과 비용이 동시에 개선됨 |
| 완료율이 뚜렷이 상승했지만 비용도 상승 | 시나리오별 전환 | 고가치·고난도 작업에만 새 모델 사용 |
| 완료율은 비슷하고 비용이 뚜렷이 하락 | 그레이 전환 | 저위험 작업부터 대체하고 일정 기간 관찰 |
| 완료율은 비슷하지만 개입 횟수가 감소 | 전환 우선 고려 | 절약되는 인력이 보통 토큰 비용보다 더 가치 있음 |
| 완료율이 하락하거나 안정성이 나빠짐 | 당분간 전환 보류 | 다음 버전을 기다리거나 프롬프트를 조정한 뒤 재테스트 |
간과하기 쉬운 또 하나의 차원은 새 기능이 가져오는 작업 재구성이에요. 예를 들어 Hy4는 이번에 시각 이해 기능이 추가돼 화면 녹화를 직접 읽고 프레임별로 분석할 수 있으며, 자신이 생성한 결과물을 계속 스크린샷으로 찍어 스스로 피드백하며 개선할 수도 있어요. 기존 워크플로에서 사람이 스크린샷을 텍스트 설명으로 바꿔야 했다면, 새 모델이 가져오는 건 “같은 작업을 더 잘한다”가 아니라 “전체 프로세스에서 한 단계가 줄어든다”일 수 있어요. 이런 이득은 별도로 기록하고, 기존 작업 점수만으로 평가하지 마세요.
주요 모델과 비교할 때의 선택 가이드
비교 실험을 할 때는 보통 새 모델을 현역 모델과 같은 수준의 다른 후보들과 함께 돌립니다. 아래 표는 모델 선택 사고방식을 정리한 것이며, 구체적인 성능은 직접 장기 작업에서 실측한 결과를 기준으로 하세요.
| 후보 유형 | 적합한 장기 작업 | 검증 포인트 | 사용 가능한 플랫폼 |
|---|---|---|---|
| 새로 출시된 오픈소스/중국산 모델 | 사무 문서 일괄 처리, 중국어 시나리오 에이전트 | 목표 유지도, 가성비 | APIYI apiyi.com 등 |
| 현역 주력 폐쇄형 모델 | 복잡한 프로그래밍, 고난도 추론 | 품질 기준선으로 활용 | APIYI apiyi.com 등 |
| 멀티모달 역량 모델 | 스크린샷/화면 녹화 재현, 인터페이스 이해 | 시각 이해 정확도, 자기 수정 | APIYI apiyi.com 등 |
| 경량 고속 모델 | 하위 작업 분배, 형식 정리 | 소요 시간과 비용 | APIYI apiyi.com 등 |
💡 선택 제안: 후보 하나만 현역 모델과 비교하지 마세요. 통일된 인터페이스 아래 두세 개 후보를 같은 검증 세트에 넣으면 “시나리오별 조합 사용”이라는 더 나은 해법을 찾는 경우가 많아요. APIYI는 여러 주요 모델을 통일된 방식으로 호출할 수 있어 이런 조합안을 빠르게 적용하기 좋습니다.
자주 묻는 질문 FAQ
Q1: 새 모델의 장기 작업 검증이란 무엇인가요?
장기 작업 검증은 여러 단계로 구성되고, 도구 호출이 필요하며, 명확한 결과물이 있는 실제 작업으로 모델을 테스트하는 것을 말해요. 단일 턴 응답의 품질이 아니라, 모델이 연속된 단계에서 목표를 유지할 수 있는지, 오류가 발생한 뒤 스스로 복구할 수 있는지, 그리고 최종 전달 비용이 얼마인지에 주목해요.
Q2: 장기 작업 검증과 공개 벤치마크를 보는 것의 차이는 무엇인가요?
벤치마크는 범용 능력을 가로로 비교하는 데 가치가 크지만, 문제가 여러분의 비즈니스와 차이가 크고 대부분 짧은 체인의 작업이에요. 장기 작업 검증은 여러분의 도구 체인과 데이터 위에서 직접 실행되기 때문에 목표를 잊어버리는 문제, 도구 오용, 사람이 반복적으로 교정해야 하는 문제 등을 드러낼 수 있어요. 두 가지를 함께 쓰는 게 가장 안전해요. 먼저 리더보드로 후보를 추리고, 자체 작업으로 최종 결정을 내리는 거죠.
Q3: 새 모델이 출시된 뒤 언제부터 검증을 시작하는 게 좋을까요?
출시 후 가능한 한 빨리 ‘즉시 사용’ 테스트를 한 차례 돌려보는 걸 권해요. 많은 신모델이 한정 무료나 체험 기간을 제공하기 때문이에요. 참고 자료에 따르면 Hy4는 WorkBuddy에서 11월 4일부터 15일까지 한정 무료 기간이 있었어요. 첫 라운드 결과가 괜찮다면, 시간을 들여 새 모델에 맞게 프롬프트를 조정한 뒤 두 번째 라운드 테스트를 진행하세요.
Q4: 검증 세트에는 작업이 몇 개쯤 있어야 충분한가요?
비즈니스에 매우 밀접한 작업 3~5개면 대체로 방향성 결론을 내리기에 충분해요. 안정성을 보려면 각 작업을 3회씩 반복하세요. 개수를 늘리는 것보다, 가장 자주 발생하고 인력이 가장 많이 들며 실수가 가장 잦은 시나리오를 작업이 포괄하도록 하고, 각 작업에 명확한 검사 지점을 설계하는 게 더 중요해요.
Q5: 여러 모델을 저렴하게 오가며 비교하려면 어떻게 해야 하나요?
가장 간편한 방법은 통합 인터페이스 플랫폼을 통해 호출하는 거예요. APIYI apiyi.com은 OpenAI와 Anthropic 두 가지 인터페이스 형식을 모두 호환해서, 모델을 바꿀 때는 `model` 파라미터만 수정하면 되고 도구 정의와 프롬프트는 바꿀 필요가 없어요. 구체적인 연동 절차는 문서 센터 docs.apiyi.com에서 확인할 수 있어요.
Q6: 장기 작업의 비용은 어떻게 계산해야 정확한가요?
‘성공 1회당 전달 비용’으로 계산해야 해요. 즉, 여러 번 실행한 총 토큰 비용을 성공적으로 전달한 횟수로 나누는 것이고, 여기에 캐시 적중과 미적중 입력 부분을 구분해야 해요. 각 모델의 단가와 캐시 가격은 APIYI 가격 페이지 docs.apiyi.com/models의 실제 데이터를 기준으로 하세요. 같은 플랫폼의 통일된 과금 기준을 쓰면 비교가 더 공정해져요.
Q7: 장기 작업 검증에는 어떤 한계가 있나요?
첫째, 표본이 적어서 한 번의 놀라운 결과나 실패가 우연일 수 있으니 반복 실행해야 해요. 둘째, 사람이 매기는 점수에는 주관이 개입되니 두 사람이 독립적으로 채점한 뒤 평균을 내는 걸 권해요. 셋째, 결과가 도구 체인에 크게 의존하므로 Agent 프레임워크를 바꾸면 다시 테스트해야 해요. 또한 모델 능력의 상한은 테스트 작업의 난이도에 좌우되는 경우가 많아서, 검증 세트에 주기적으로 더 어려운 작업을 추가해야 해요.
새 모델 장기 실행 과제 검증 핵심 포인트
- 내 업무로 직접 검증하기: 실제 다단계 과제 3~5개가 어떤 순위표보다 모델 전환 효과를 더 잘 보여줘요.
- 변수는 하나만 바꾸기: 기존 모델과 새 모델에 같은 프롬프트, 도구, 입력을 쓰고 과제마다 최소 3회 실행하세요.
- 목표 기준점은 필수:
/goal아이디어를 참고해 마일스톤을 쪼개세요. 체크포인트가 객관적일수록 평가도 정확해져요. - 6가지 지표로 전체 보기: 완료율, 목표 유지, 자기 교정, 개입 횟수, 소요 시간, 전달 비용을 확인하세요.
- 전달 기준으로 비용 계산: 캐시 적중을 구분하고, APIYI 가격 페이지 docs.apiyi.com/models를 과금 기준으로 삼으세요.
- 프로세스 재구성에 주목: 시각 이해 같은 새 기능은 기존 프로세스의 수작업 단계를 바로 없앨 수 있어요.
정리
새 모델 장기 실행 과제 검증의 핵심 요점은 다음과 같아요.
- 과제는 실제여야: 검증 세트는 비즈니스에서 가져오고, 빈도가 높고 시간이 많이 들며 오류가 나기 쉬운 시나리오를 커버하세요.
- 비교는 엄격하게: 환경을 고정하고 반복 실행하며, 모델 전환 기준을 미리 정하세요.
- 비용 계산은 제대로: 성공적인 단일 전달 비용과 수동 개입 횟수로 실제 이익을 측정하세요.
새 모델이 출시될 때마다 워크플로를 다시 살펴볼 기회가 생겨요. 순위표와 데모 영상에 끌려다니기보다 하루이틀 시간을 내서 내 장기 실행 과제로 확실한 답을 내는 편이 좋아요. APIYI apiyi.com을 통해 기존 모델과 새 모델을 같은 인터페이스에 넣어 빠르게 비교해 보세요. 연결 안내는 docs.apiyi.com에서, 과금 데이터는 docs.apiyi.com/models를 기준으로 확인하면 돼요.
📚 참고 자료
- 爱范儿 – 텐센트 Hy4 실측: Hy4의 장기 작업, 멀티모달, 컴퓨터 조작 실측 사례
- 링크:
ifanr.com/1687613 -
설명:
/goal목표 제약, 장기 게임 개발, 문서 일괄 처리 등 참고할 만한 테스트 설계를 제공해요. -
APIYI 문서 센터: 모델 연동 및 인터페이스 형식 설명
- 링크:
docs.apiyi.com -
설명: OpenAI 및 Anthropic 호환 인터페이스 설정 방법을 확인할 수 있어요.
-
APIYI 모델 가격 페이지: 각 모델의 입력, 출력, 캐시 가격
- 링크:
docs.apiyi.com/models - 설명: 비용 산정의 유일한 가격 기준이에요.
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.