작성자 주: GDPx 1차 평가에서 금융과 법률 분야는 엄격한 이진 합격 기준을 적용했을 때 완전히 통과한 모델이 하나도 없었어요. 이 글에서는 공개된 두 사례의 구체적인 오류를 살펴보고, ‘계산을 잘하고 계약서를 잘 쓰는 것’이 왜 ‘합격할 만한 결과물을 납품하는 것’과 다른지 설명해요.
2026년 11월 2일, SemiAnalysis가 고난도 전문 업무 벤치마크 GDPx v1.0을 발표했어요. 11개 분야 중 금융과 법률 분야에서는 당초 정한 이진 합격 기준을 완전히 통과한 테스트 모델이 하나도 없었어요. 연구팀은 모델 간 차이를 보여주기 위해 ‘평균 부분 점수’를 대신 사용해야 했어요.
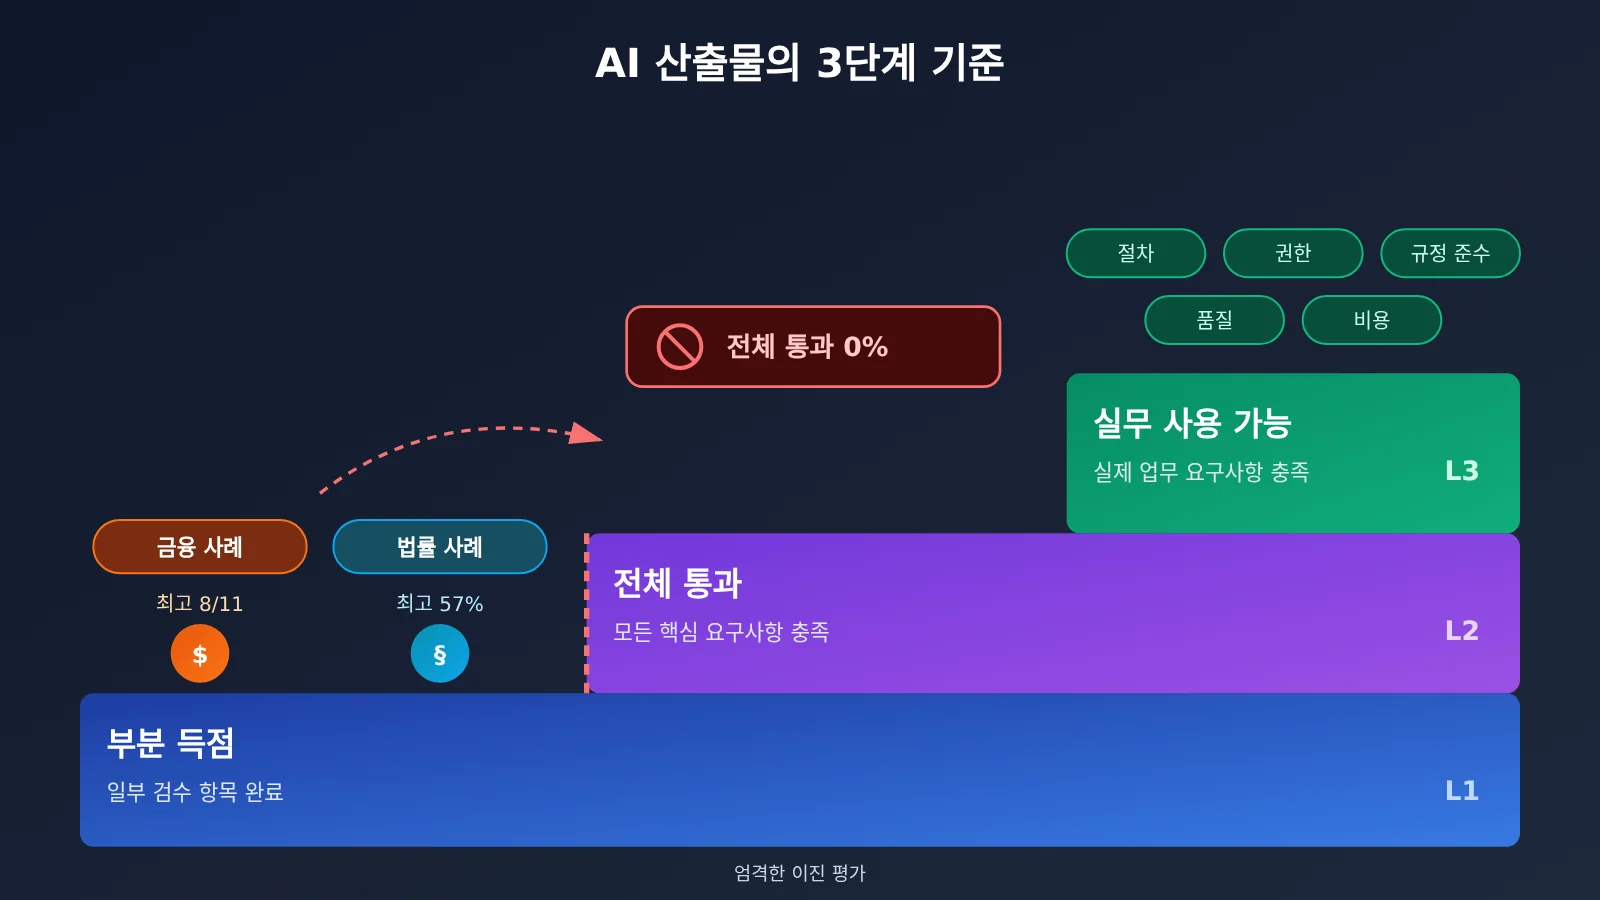
이것은 단순히 “AI는 안 된다”라는 감정적인 결론이 아니에요. 일부 모델은 법률 사례에서 평균 부분 점수 44%를 받았고, 금융 사례에서는 검수 항목의 약 절반을 맞혔어요. 정말 주목할 질문은 이것이에요. 절반을 맞혔는데도 왜 납품할 수 없을까요?
핵심 내용: 이 글을 읽으면 Bellwood-QoE 금융 업무와 시리즈 B 투자 정관 개정 업무의 핵심 금액, 실패 횟수, 채점 기준을 이해할 수 있어요. 또한 AI의 보조 능력과 독립적으로 책임질 수 있는 결과물 납품 능력의 차이도 더 분명히 알 수 있어요.
금융과 법률 과제 전면 실패: GDPx 핵심 정보 한눈에 보기
GDPx의 첫 번째 평가에는 11개 전문 분야의 과제 206개가 포함됐어요. 각 과제의 기본 제한 시간은 최대 8시간이며, ‘모델 + Agent 프레임워크 + 도구 + 작업 환경’의 종합적인 성능을 평가해요. 종합 순위 1위인 Claude Opus 5.5의 점수도 12.0%에 그쳤어요. 그중에서도 금융과 법률 분야의 결과가 특히 눈에 띄어요.
| 항목 | 금융 분야 | 법률 분야 |
|---|---|---|
| 과제 수 | 24개 | 20개 |
| 전문 협력사 | Living Context | Chakra |
| 공개 사례 | Bellwood-QoE(수익의 질 분석 워크북) | quillon-series-b-redline(시리즈 B 정관 수정) |
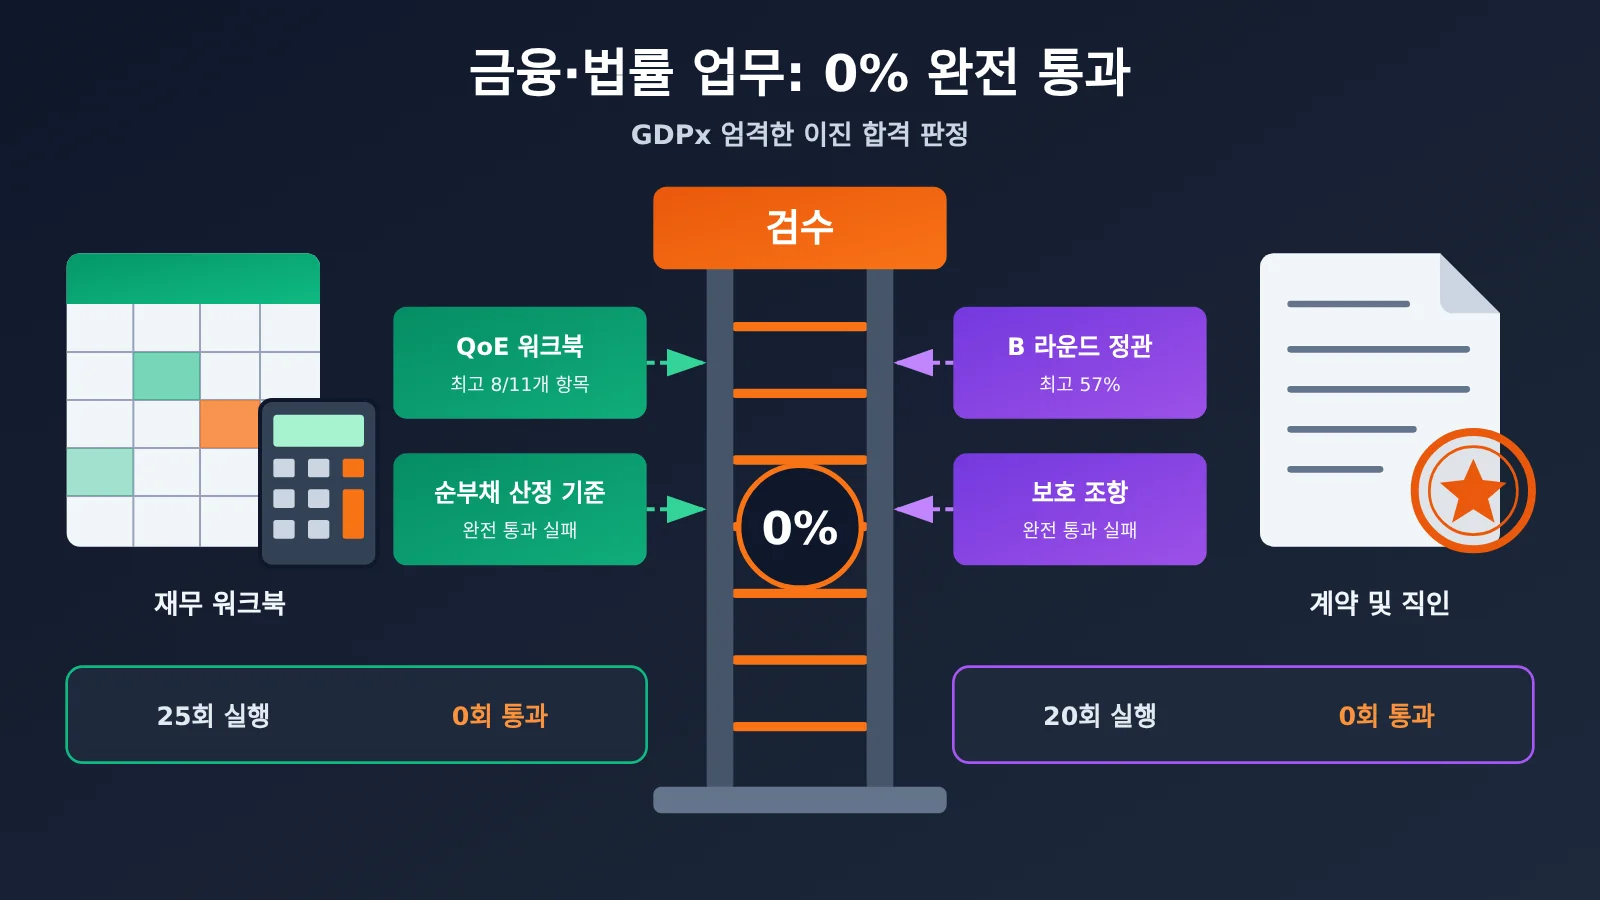
| 공개 사례 실행 횟수 | 선정된 실행 25회 | 모델 4개로 총 20회 실행 |
| 전체 통과 횟수 | 0회 | 0회 |
| 엄격한 이진 점수 | 0% | 0% |
| 부분 점수 결과 | 최고 실행에서 11개 검사항목 중 8개 통과 | 평균 18%, 단일 실행 최고 57% |
이 표를 볼 때는 두 가지를 주의해야 해요. 첫째, 이진 점수가 0%라고 해서 모든 실행 결과에 가치가 없다는 뜻은 아니에요. 부분 점수는 분명히 0이 아니었어요. 둘째, 표의 25회와 20회는 각각 공개 사례 하나를 테스트한 실행 횟수예요. 금융 분야 전체 24개 과제나 법률 분야 전체 20개 과제를 이 횟수만큼만 실행했다는 뜻은 아니에요.
금융과 법률 과제에 엄격한 검수를 적용한 이유
두 분야의 결과물은 단순한 조언이 아니라 ‘실제 거래 절차에 바로 투입할 수 있는 문서’예요. 인수합병 실사나 자금 조달 협상에서는 순부채 산정 기준 하나가 잘못되거나 보호 조항 하나가 우회 가능하기만 해도 문서 전체를 사용할 수 없게 될 수 있어요. 그래서 GDPx는 전문적인 결과물에 가까운 엄격한 검수 방식을 적용했고, 이것이 0%라는 결과가 나온 직접적인 이유이기도 해요.
금융 업무 사례: Bellwood-QoE에서 AI는 계산은 맞혔지만 합격할 만한 결과물을 내지 못한 이유
거래 배경과 업무 요구사항
Living Context는 실제 거래 경험을 익명화된 테스트 환경으로 재구성했어요. 사모펀드 Bannock Capital이 Haverly Snack Company의 지분 약 62%를 약 8억 8천만 달러에 인수하는 거래로, 조건부 대가 지급 약정도 포함돼 있어요. 이 환경에는 재무 총계정원장, 은행 거래명세서, 급여 자료, 매출채권 연령 분석표, 계약 관련 서신, 거래 계약서, 과거 조정표, 여러 자문사의 업무 자료 등 약 4,000건의 익명화된 문서가 있어요.
모델은 미완성된 이익의 질 분석(QoE) 워크북을 이어서 완성해야 해요. 기존 데이터 중 정확한 항목을 파악하고, 올바른 항목과 계산 구조는 유지하면서 잘못된 수치와 분류를 수정해야 해요. 또한 EBITDA 조정 항목을 검토하고, 12개월 운전자본을 일치시키며, 순부채 산정 기준을 처리해야 해요. 각 조정 항목에는 문서상 근거를 제시하고 시트 간 참조도 일관되게 유지해야 해요. 최종 산출물은 수정된 워크북 자체예요.
Bellwood-QoE 실측 결과
| 모델 | 11개 검수 항목의 평균 통과 수 | 전체 통과 여부 |
|---|---|---|
| GPT-6.1 Sol | 5.6개 | 아니요 |
| Claude Opus 5.5 | 5.4개 | 아니요 |
| GPT-6 Astra | 5.4개 | 아니요 |
| GLM 5.3 | 2개 미만 | 아니요 |
| Grok 4.7 | 2개 미만 | 아니요 |
| 최고 단일 실행 | 8개 | 아니요 |
가장 뛰어난 모델들도 평균적으로 검수 항목의 절반 정도를 통과했고, 가장 좋은 단일 실행 결과는 8개였어요. 하지만 나머지 항목에 중대한 재무 오류가 하나라도 있다면 워크북 전체를 제출할 수 없어요. 아래 세 가지 오류 유형을 보면 문제의 원인을 알 수 있어요.
재무 오류 1: 418달러 조정을 확대 해석
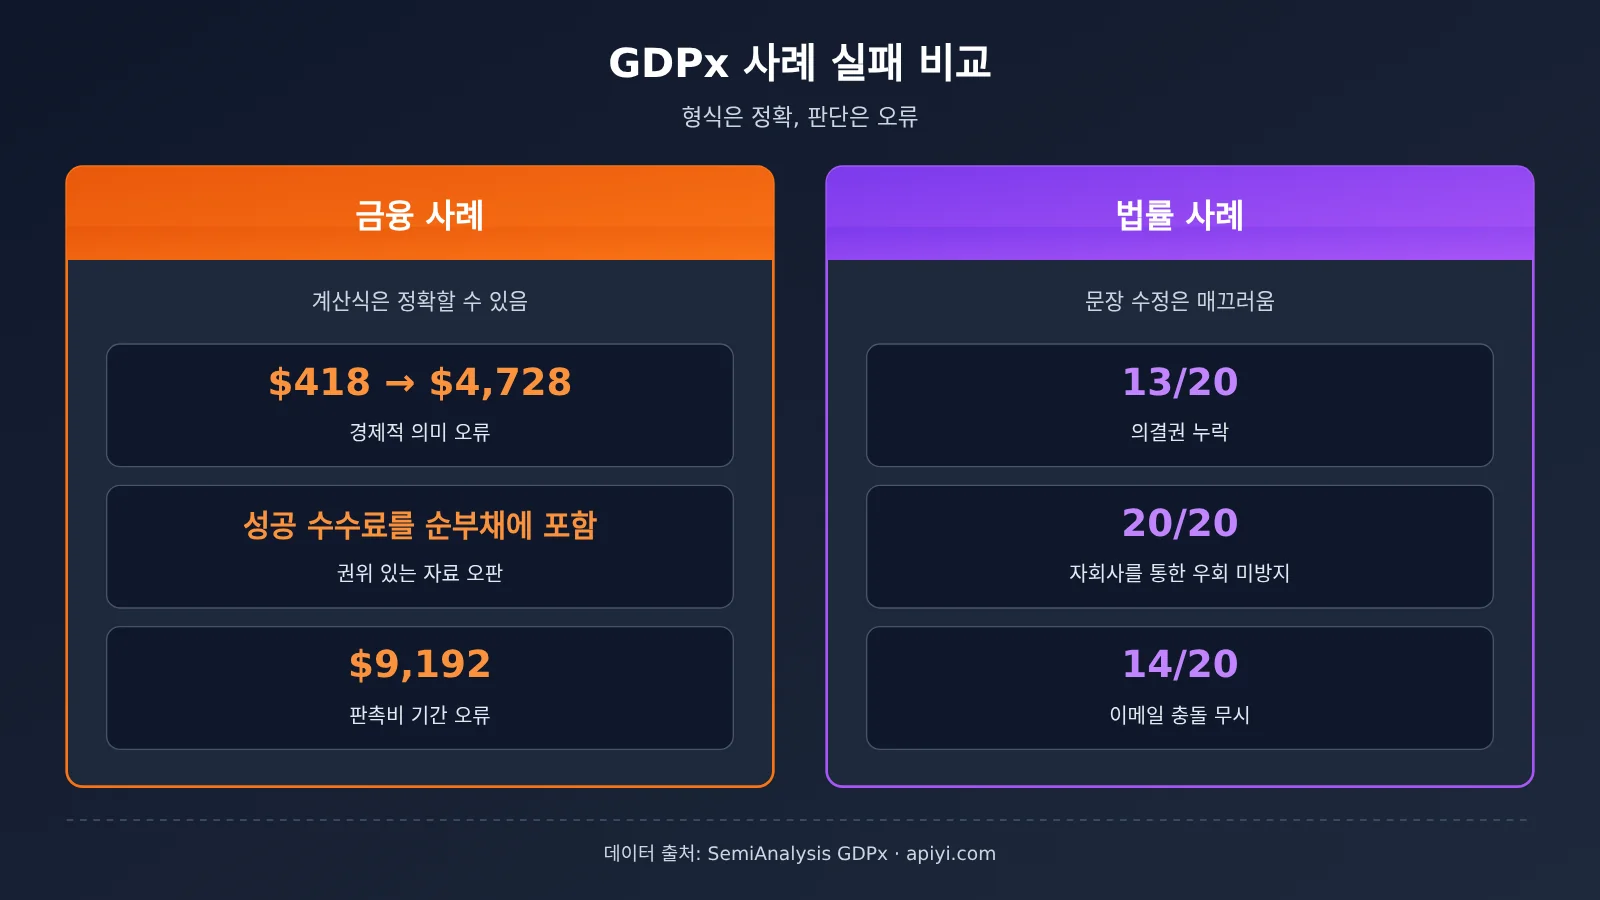
일부 모델은 이미 면제된 418달러의 보험 감사 조정을 “이전의 산재보험 계약상 의무 전체가 종료됐다”는 뜻으로 해석했어요. 그 결과 최근 12개월의 EBITDA를 4,728달러 낮게 산정했어요. Opus, Astra, Sol의 관련 실행 15회 중 10회에서 이런 오판이 발생했어요.
이건 곱셈 오류가 아니에요. 모델이 특정 조정의 회계적·법적 의미를 과거 보험 책임 전체에 대한 판단으로 확대 해석한 거예요. 4,728달러의 차이는 이 오판의 결과이지, 418달러의 몇 배가 아니에요. 계산식 자체는 맞을 수 있어서 반복해서 검산하더라도 발견하기 어려운 오류예요.
금융 오류 2: 거래 비용을 순부채에 포함
15번의 실행에서 투자은행의 성공 보수를 순부채에 포함했어요. 하지만 거래 매매계약은 이 보수를 별도의 거래 비용으로 처리하도록 규정하고 있었어요. 모델은 비용을 찾아내고 덧셈과 뺄셈도 정확히 했지만, 구속력 있는 계약의 분류 기준은 따르지 않았어요.
이것이 바로 ‘데이터가 존재하는 것’과 ‘업무상 분류가 올바른 것’의 차이예요. 인수합병에서 순부채는 보통 매수자가 실제로 지불하는 금액에 영향을 미치므로, 분류 오류의 영향은 표에만 그치지 않아요.
금융 오류 3: 조정해야 할 비용 누락
연구팀은 더 눈에 띄지 않는 문제들도 발견했어요.
- 17번의 실행에서 실제로 일하지 않은 가족 구성원의 급여를 여전히 기업의 정상적인 운영 비용으로 처리했어요.
- 대부분의 실행에서 총계정원장의 메모란에만 기록된 소유주의 개인 비용을 식별하지 못했어요.
- 가장 성능이 뛰어난 모델의 15번 실행 중 10번에서 과거 판촉비 9192달러에 대한 조정을 누락했어요. 다른 기간에 속하는 비용을 현재 12개월의 비용으로 계산한 거예요.
이런 오류는 회계 기간, 비용의 성격, 증거 출처, 거래의 경제적 실질과 모두 관련돼 있어요. 수익의 질 분석은 바로 이렇게 ‘운영 비용처럼 보이지만 실제로는 아닌’ 항목을 걷어내기 위해 수행해요. 이런 항목을 놓치면 EBITDA는 기업의 실제 수익성을 반영할 수 없어요.
법률 업무 사례: B 시리즈 투자 정관 수정안이 20회 모두 사용 불가였던 이유
법률 업무 요구사항
quillon-series-b-redline 작업에서 AI는 B 시리즈 투자의 리드 투자자를 대리해 서명 예정인 회사 정관을 수정했어요. 입력 자료에는 서명된 투자 조건서, 지분 구조표, 고객 이메일, 정관 초안과 관련 거래 자료가 포함됐어요. 성공 기준은 투자자의 정당한 권익을 보호하면서도 이미 합의한 상업적 조건을 이유 없이 변경하지 않는 것이었어요. 단순한 문장 다듬기가 아니라 여러 문서를 대조하며 법률적 판단을 내려야 하는 작업이었어요.
법률 사례 성적과 세 가지 핵심 오류
| 지표 | 결과 |
|---|---|
| 사용 가능 기준 완전 충족 | 0/20회 |
| 평균 부분 점수 | 18% |
| 모델별 부분 점수 | Opus 5.5 44%, GPT-6 Astra 25%, Gemini 4 Argon 2%, GLM 5.3 0.5% |
| 최고 단일 부분 점수 | 57%(Opus 5.5) |
| 주주 투표로 보호 조항을 삭제할 수 있다는 점을 놓침 | 13/20회 |
| 자회사를 통한 우회를 막지 못함 | 20/20회 |
| 고객 이메일과 투자 조건서의 충돌을 지적하지 않음 | 14/20회 |
여기서 18%는 이 사례에서 실행한 결과의 평균 부분 점수이며, GDPx 법률 분야 전체에 적용되는 통합 점수는 아니에요.
오류 1: 조항만 읽고 의결권은 계산하지 않았어요. 13회 실행에서 다른 주주들이 리드 투자자에게 필요한 보호 조항을 삭제할 만큼 충분한 의결권을 갖고 있다는 사실을 발견하지 못했어요. 정관에 보호 조항이 적혀 있다고 해서 그 보호가 확실하게 유지되는 것은 아니에요. 지분 구조표를 함께 살펴보고 의결권을 계산해야 조항이 뒤집힐 수 있는지 판단할 수 있어요.
오류 2: 문구만 수정하고 우회 가능성은 막지 못했어요. 20회 실행 모두 회사가 자회사를 이용해 정관의 투자자 보호 제한을 우회하는 것을 효과적으로 막지 못했어요. 조항이 회사 자체만 규제하고 자회사를 포함하지 않으면, 실제 사업은 다른 법인을 통해 진행할 수 있어요. 조항의 표면적 의미를 이해하는 것과 현실적인 우회 경로를 찾아내는 것은 달라요.
오류 3: 이메일을 최종 합의로 취급했어요. 14회 실행에서는 고객 이메일에 담긴 희망 조건을 그대로 수용하면서, 이 요구사항이 이미 서명된 투자 조건서와 충돌한다는 점을 지적하지 않았어요. 이렇게 수정하는 것은 확정된 거래 조건을 일방적으로 다시 협상하는 것과 같아요. 적절한 대응은 요구사항을 모두 그대로 받아들이는 대신 충돌을 파악해 사용자에게 알리는 것이에요.
법률 평가의 신뢰성 관리 방법
Chakra의 평가 설계에는 법률 전문가의 요구사항 수립, 유효·무효·부분 정답 샘플을 활용한 평가 기준 보정, 이견이 있는 판정에 대한 사람의 재검토, 평가 모델의 편향 점검이 포함돼요. 각 결과물은 다섯 차례 평가하고, 각 승인 기준에 대한 판정의 일관성도 추적해요. 다만 이는 협력사가 설명한 내부 품질 관리 절차이며, 완전히 독립적인 기관이 평가에 오판이 없음을 검증했다는 뜻은 아니에요.
금융과 법률 업무에서 실패하는 공통 원인: 쓰지 못해서가 아니라 판단이 틀려서
Living Context는 금융 사례에서 자주 나타나는 오류를 네 가지로 정리했어요. 이는 법률 사례에서 관찰된 문제와도 상당히 비슷해요.
| 실패 유형 | 금융 사례에서 나타난 문제 | 법률 사례에서 나타난 문제 | 실무상 시사점 |
|---|---|---|---|
| 자료의 권위를 잘못 판단 | 숫자가 가장 명확하게 적힌 오래된 표를 더 신뢰하고 서명된 계약은 무시 | 거래조건표보다 고객 이메일을 우선 | 먼저 ‘문서 효력의 우선순위’를 정해야 해요 |
| 2차 영향을 간과 | 계산은 마쳤지만 세금, 부채, 거래상 의무에 미치는 영향은 누락 | 보호 조항을 수정하면서 의결권 구조는 따져보지 않음 | 수정할 때마다 후속 영향을 확인해야 해요 |
| 계산식만 검토하고 가정은 검토하지 않음 | 사칙연산은 반복 검증했지만 사업상 전제가 틀림 | 문구는 엄밀하지만 자회사를 통한 경로는 다루지 않음 | 계산보다 전제를 검토하는 것이 더 중요해요 |
| 수정하면서 기존 구조를 훼손 | 수식을 숫자로 하드코딩해 시트 간 연결을 끊음 | 이미 협상한 상업적 조건을 변경 | 결과물은 ‘제대로 고치되 기존 것을 망가뜨리지 않아야’ 해요 |
이는 연구팀이 정리한 실패 유형이지, 모든 기업 재무 모델이나 법률 문서에 일률적으로 적용되는 오류율은 아니에요. 이 사례들이 보여주는 공통점은 핵심적인 어려움이 텍스트 생성보다 자료 선택, 전문적 추론, 암묵적 제약, 문서 간 일관성, 최종 검수에 있다는 점이에요. 모델의 답변이 유창할수록 이런 문제를 놓치기 쉬워요.
금융·법률 AI 활용 영향 분석: 보조와 독립적 결과물 제출을 어떻게 구분할까
기업 AI 책임자와 개발자에게 미치는 영향
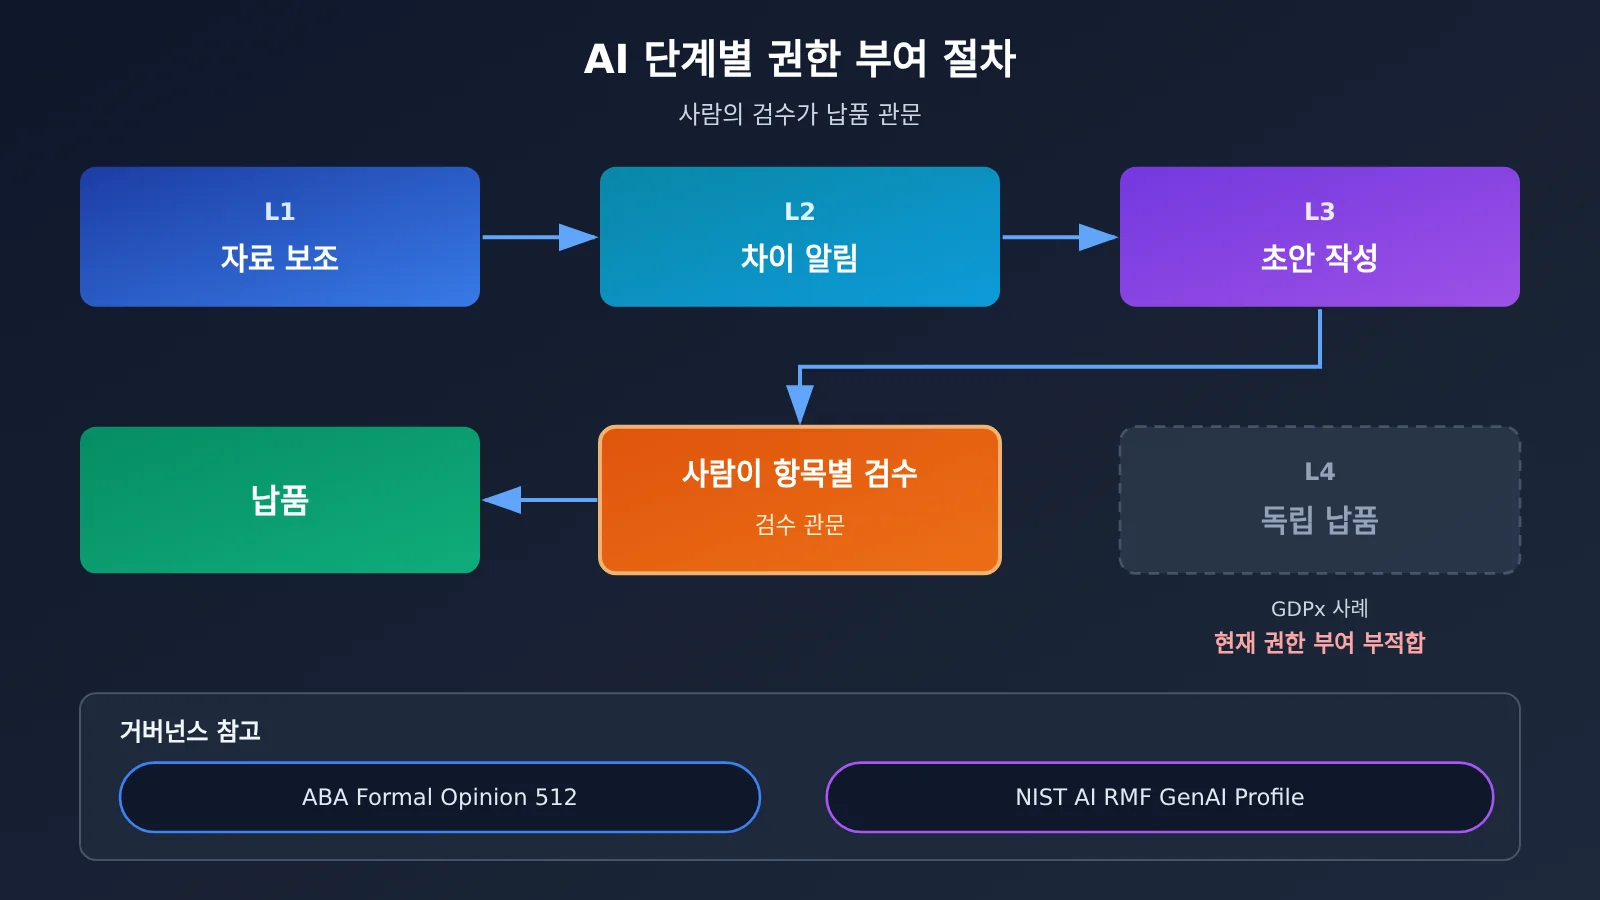
GDPx는 전문 업무를 보조하는 AI의 가치를 부정하지 않아요. 부분 점수는 모델이 검수 요건의 일부를 충족할 수 있음을 보여줍니다. 다만 연구에서는 사람이 참여할 때 시간이나 비용을 얼마나 절감할 수 있는지 근거를 제시하지 않았어요. 따라서 사례의 결론을 ROI로 직접 환산해서는 안 됩니다. 위험 수준에 따라 권한을 부여하는 편이 더 현실적이에요. 다음 표를 참고해 보세요.
| 권한 수준 | 대표적인 용도 | 사람의 역할 | 검수 방식 |
|---|---|---|---|
| L1 자료 보조 | 기초 자료 정리, 이상 데이터 확인 | 표본 점검 | 결과는 단서로만 활용 |
| L2 차이점 표시 | 조항과 데이터의 차이점 표시, 충돌 목록 작성 | 항목별 확인 | 전문가가 진위를 판단 |
| L3 초안 작성 | 워크북 수정 초안, 정관 redline 초안 | 전체 검토 | 체크리스트에 따라 항목별 검수 |
| L4 독립적 결과물 제출 | 외부에 직접 서명하거나 제출 | — | GDPx 사례에 따르면 현재는 권한 부여가 부적절 |
이런 권한 구분은 외부 지침의 방향과도 일치해요. 미국변호사협회(ABA)는 2024년 7월 29일 발표한 Formal Opinion 512에서 변호사가 생성형 AI를 사용할 때도 전문 역량, 고객 정보 기밀 유지, 의사소통, 감독, 합리적인 수임료 등의 책임을 고려해야 한다고 밝혔어요. 또한 도구의 성능과 한계를 이해하고, 출력을 검증 없이 채택해서는 안 된다고 설명합니다.
미국 NIST가 2024년 7월 26일 발표한 AI RMF 생성형 AI Profile 역시 조직이 사용 맥락에 맞춰 사람의 감독, 평가, 기록 및 거버넌스를 마련해야 한다고 강조해요. 다만 ABA 의견은 미국 변호사 직업윤리 지침이고 NIST 문서도 GDPx의 테스트 결과가 아니므로, 두 문서는 분야를 넘나드는 참고 자료로만 활용해야 합니다.
API로 ‘충돌 알림’ 보조 워크플로 구축하기
GDPx 법률 사례에서 가장 흔한 실수 중 하나는 고객 이메일과 서명된 조항 사이의 충돌을 짚어내지 못하는 것이에요. 이렇게 차이를 찾고 질문을 제기하는 작업은 L2 수준의 보조 업무에 적합해요. 단, 결과는 사람이 확인할 단서로만 사용해야 해요. 다음 예제는 모델이 두 텍스트를 대조해 충돌 사항과 사람이 확인해야 할 사항을 나열하도록 해요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
전체 구현 코드 보기(여러 모델의 결과 교차 비교 + 사람의 검토 체크리스트)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 하나의 키로 여러 제공업체의 모델 호출
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """여러 모델이 각각 검토 단서를 생성해 사람이 교차 비교하기 쉽게 합니다"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # 최종 채택 여부는 변호사나 재무 전문가가 검수 체크리스트에 따라 항목별로 판단합니다
🚀 빠른 시작 팁: 이런 보조 워크플로를 구축할 때는 먼저 APIYI apiyi.com에서 하나의 API 키로 여러 주요 모델에 접속해 보세요. 비식별화한 자체 샘플로 모델별 충돌 탐지율을 교차 비교할 수 있어요. 신규 사용자는 무료 테스트 크레딧으로 소규모 검증을 진행한 뒤 시범 도입 여부를 결정할 수 있어요.
금융 및 법률 테크 산업에 미치는 영향
GDPx의 결과는 전문 AI 제품을 평가할 때 대화 시연이 얼마나 매끄러운지만 볼 게 아니라, 최종 결과물이 전문가의 검수를 통과할 수 있는지 살펴봐야 한다는 점을 일깨워요. 공급업체의 경쟁력은 ‘권위 있는 문서의 우선순위’, ‘충돌 알림’, ‘기존 수식 구조 유지’, ‘근거 출처 추적’ 같은 세부 구현에서 더욱 두드러질 거예요. 구매자는 실제 업무와 유사한 과제로 독립적인 테스트를 진행해야 해요. GDPx도 일부 과제와 실행 기록만 공개한 만큼, 외부 검토와 재현이 더 필요해요.
💡 선택 팁: 모델마다 분야별 성능 차이가 뚜렷하므로 하나의 종합 순위가 내 업무에 적합한 모델을 알려주지는 않아요. APIYI apiyi.com의 통합 인터페이스를 통해 실제 업무 과제로 여러 모델을 병렬 테스트해 보세요. 평균 점수뿐 아니라 부분 점수와 핵심 항목의 통과 여부도 함께 기록하는 것이 좋아요. 각 모델의 사용 가능 여부는 플랫폼의 실시간 목록을 확인해 주세요.
자주 묻는 질문 FAQ
Q1: 금융 및 법률 업무에서 “전멸”했다는 건 AI가 아무것도 제대로 하지 못했다는 뜻인가요?
아니요. 0%는 엄격한 이진 평가 기준에서 나온 결과로, 모든 핵심 요구사항을 충족한 실행이 한 번도 없었다는 뜻이에요. 금융 사례에서는 가장 좋은 단일 실행이 11개 검사 항목 중 8개를 통과했고, 법률 사례에서 Opus 5.5의 평균 부분 점수는 44%였어요. 일부를 완료하는 것과 합격 기준을 충족해 결과물을 납품하는 것은 다른 문제예요.
Q2: AI가 계산은 맞게 했는데 왜 결과는 틀릴 수 있나요?
오류가 계산식 자체보다 업무상의 전제에서 발생하는 경우가 많기 때문이에요. 예를 들어 418달러의 면제 조정을 보험 계약 전체의 의무가 종료된 것으로 확대 해석해 EBITDA를 4,728달러 낮게 평가한 사례가 있어요. 은행 자문사의 성공 보수 금액을 제대로 찾고도 순부채로 분류한 사례도 있었고요. 이런 오류는 계산을 반복해서 검산해도 발견하기 어려워요.
Q3: GDPx의 결론을 모든 금융 및 법률 AI 애플리케이션에 적용할 수 있나요?
그럴 수 없어요. 이 결과는 특정한 고난도 업무와 평가 기준에서 나온 것이며, 사례에서 정리한 실패 원인도 업계 전체의 결론으로 확대할 수 없어요. 난도가 낮거나 사람이 함께 작업하는 애플리케이션은 별도로 평가해야 해요.
Q4: 현재 AI가 맡기에 적합한 금융 및 법률 업무는 무엇인가요?
초기 자료 정리, 조항과 데이터의 차이 안내, 초안 작성, 이상 데이터 점검, 검토 체크리스트 작성 지원 등이 적합한 활용 방향이에요. 구체적인 업무에 적합한지는 위험 수준과 전문적인 검수 기준을 고려해 별도로 테스트해야 해요.
Q5: 특정 모델이 내 업무에서 얼마나 잘 작동하는지 저렴하게 검증하려면 어떻게 해야 하나요?
다음 단계에 따라 진행할 수 있어요.
1. 비식별화한 실제 샘플을 몇 개 준비하고, 각 샘플의 항목별 검수 체크리스트를 작성해요.
2. APIYI apiyi.com에 가입해 API 키를 발급받고 무료 테스트 크레딧을 사용해요.
3. 이 글의 코드에서 base_url을 `https://api.apiyi.com/v1`로 설정하고 여러 모델을 병렬로 호출해요.
4. 부분 점수와 핵심 항목의 통과 여부를 각각 기록하고, 전문가가 최종 판정해요.
Q6: GDPx 보고서의 작업 비용을 API 가격 참고 자료로 활용할 수 있나요?
그럴 수 없어요. GDPx의 달러 금액은 벤치마크 실행 조건에서 작업 한 건당 평균 비용이며, 특정 플랫폼의 일괄 요금이 아니에요. 실제 비용은 사용하는 플랫폼의 실시간 가격과 호출량을 기준으로 확인해야 해요. APIYI apiyi.com 콘솔에서 사용량 기반 과금 내역을 확인할 수 있어요.
금융·법률 업무 AI 평가 핵심 요점 Key Takeaways
- 엄격한 합격 기준에서는 통과 모델이 없었어요: GDPx 금융·법률 분야에서 이진 기준을 완전히 통과한 모델은 없었어요.
- 부분 점수는 0이 아니에요: 금융 사례의 최고 단일 결과는 11개 검사 항목 중 8개 통과였고, 법률 사례의 최고 단일 점수는 57%였어요.
- 오류는 계산이 아니라 판단에서 발생했어요: 418달러 조정 항목을 잘못 해석해 EBITDA가 4,728달러 낮게 평가됐어요.
- 문서의 권위에 따른 우선순위가 중요해요: 20회 중 14회에서 고객 이메일을 서명된 텀시트보다 우선했어요.
- 암묵적 제약을 놓치기 쉬워요: 20회 모두 자회사를 통한 우회 위험을 막지 못했어요.
- 세 가지 개념을 구분해야 해요: 부분 점수, 완전 통과, 실제 업무 적용 가능성은 각각 따로 평가해야 해요.
- 보조부터 시작해 파일럿으로 확장하세요: APIYI apiyi.com의 다중 모델 통합 인터페이스로 자체 샘플을 단계별 검증할 수 있어요.
정리
GDPx 금융·법률 업무 평가의 핵심 교훈은 세 가지로 정리할 수 있어요.
- 매끄러운 결과가 곧 합격은 아니에요: 표 계산이 정확하고 조항이 자연스러워도 경제적 실질, 권리 구조, 문서 간 충돌에서 오류가 발생할 수 있어요.
- 전문적인 결과물의 핵심은 판단이에요: 자료의 권위, 이차적 영향, 암묵적 제약, 문서 간 일관성이 전문 업무의 어려운 부분이에요.
- 권한과 검수 기준을 명확히 나눠야 해요: ABA와 NIST의 접근 방식을 참고해 사람의 검토를 유지하고, AI는 보조와 초안 작성에 활용하세요.
AI는 복잡한 전문 업무에서도 가치 있는 작업을 일부 수행할 수 있지만, 독립적으로 책임을 지는 결과물을 내놓기까지는 아직 격차가 커요. 금융·법률 분야의 AI 솔루션을 평가한다면, APIYI apiyi.com을 통해 자체 업무 샘플에서 여러 모델의 부분 점수와 핵심 항목 통과율을 비교한 뒤 권한 범위를 정해 보세요.
📚 참고 자료
- SemiAnalysis GDPx 원본 보고서: 금융 및 법률 분야, 사례와 실패 유형
- 링크:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
설명: Bellwood-QoE와 quillon-series-b-redline 사례 데이터의 1차 출처
-
GDPx 분야별 설명 및 공개 실행 기록: 작업 수, 협력사와 에이전트 실행 기록
- 링크:
gdpx.semianalysis.com/domains,gdpx.semianalysis.com/rollouts -
설명: 일부 공개 작업의 실행 과정을 확인할 수 있어요.
-
ABA Formal Opinion 512 보도자료: 변호사의 생성형 AI 사용에 관한 직업윤리 지침
- 링크:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
설명: 미국 변호사 업계에 적용되며, 사람의 검토 원칙을 정할 때 참고할 수 있어요.
-
NIST AI RMF 생성형 AI 프로파일: 생성형 AI 위험 관리 프레임워크
- 링크:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - 설명: 인간의 감독, 평가 및 거버넌스 조치에 관한 분야 공통 참고 자료예요.
작성자: APIYI 기술팀
기술 교류: APIYI 공식 홈페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.