Note de l’auteur : dans la première évaluation GDPx, aucun modèle n’a entièrement réussi les tâches des domaines financier et juridique selon les critères stricts d’acceptation binaire. Cet article revient sur les erreurs précises de deux cas publics et explique pourquoi « savoir faire des calculs et rédiger un contrat » ne signifie pas « être capable de livrer un résultat conforme ».
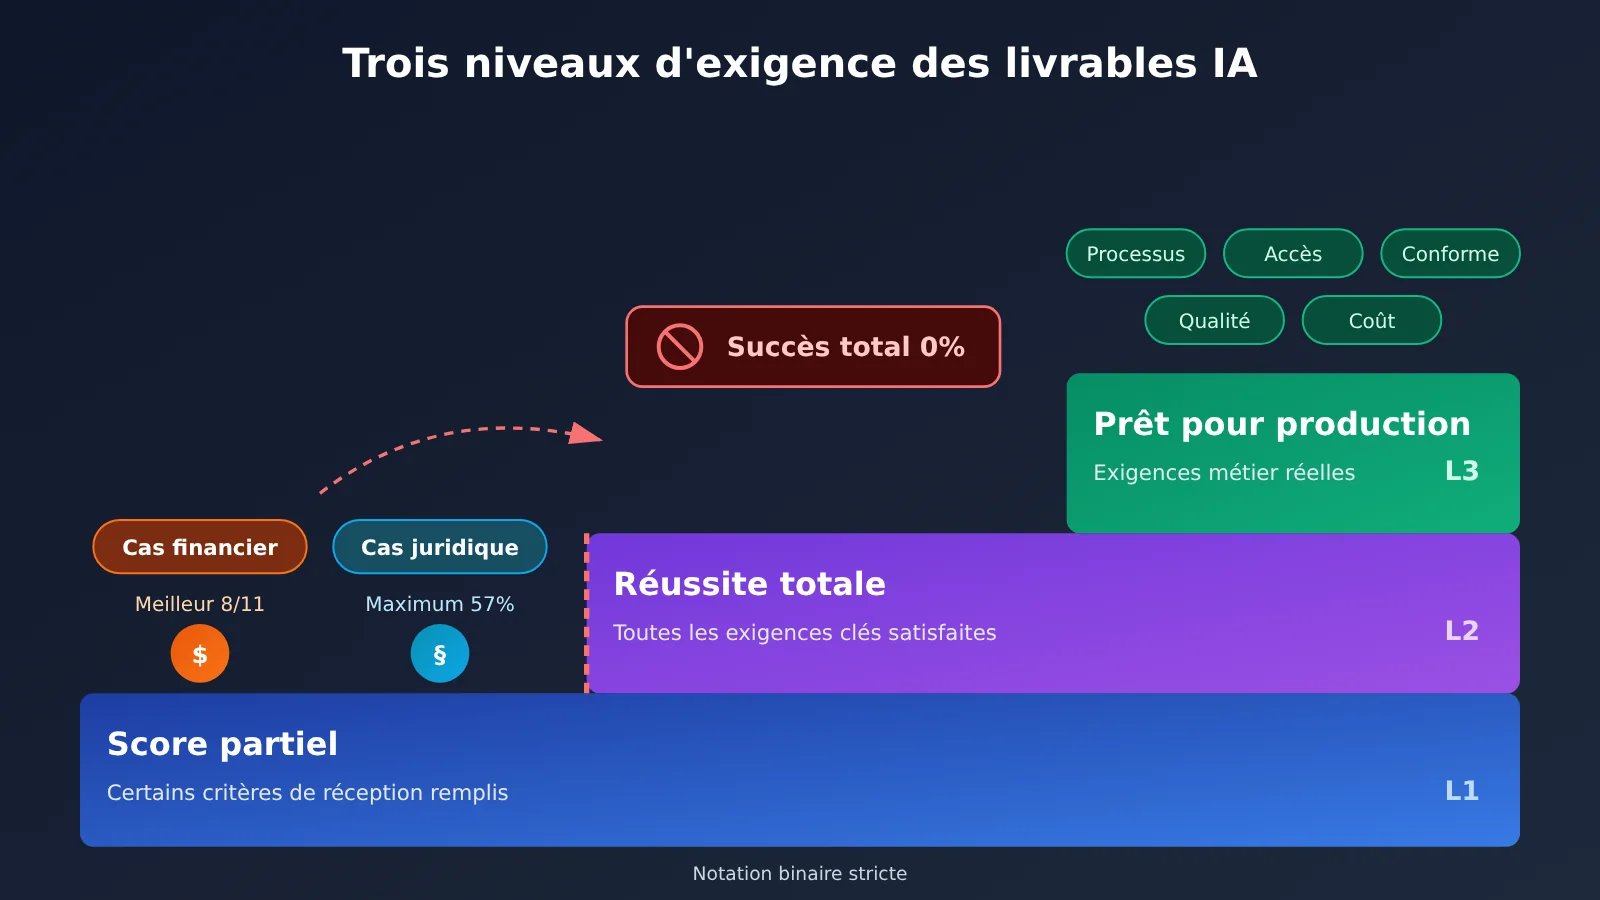
Le 2 novembre 2026, SemiAnalysis a publié GDPx v1.0, un benchmark composé de tâches professionnelles de haute difficulté. Parmi les 11 domaines évalués, aucun des modèles testés n’a entièrement réussi les tâches financières et juridiques selon le critère binaire initial. L’équipe de recherche a dû recourir à un « score partiel moyen » pour faire apparaître les différences entre les modèles.
Il ne s’agit pas d’une conclusion à l’emporte-pièce du genre « l’IA ne vaut rien ». Certains modèles ont obtenu un score partiel moyen de 44 % dans le cas juridique et réussi environ la moitié des contrôles d’acceptation dans le cas financier. La vraie question est la suivante : pourquoi réussir la moitié ne suffit-il toujours pas pour livrer un résultat ?
Ce que vous allez retenir : à la fin de cet article, vous connaîtrez les montants clés, le nombre d’échecs et les critères de notation de la tâche financière Bellwood-QoE et de la tâche de révision des statuts dans le cadre d’un financement de série B. Vous pourrez aussi mieux distinguer la capacité de l’IA à assister un professionnel de sa capacité à produire de manière autonome un livrable dont elle peut assumer la responsabilité.
Échec généralisé en finance et en droit : l’essentiel de GDPx
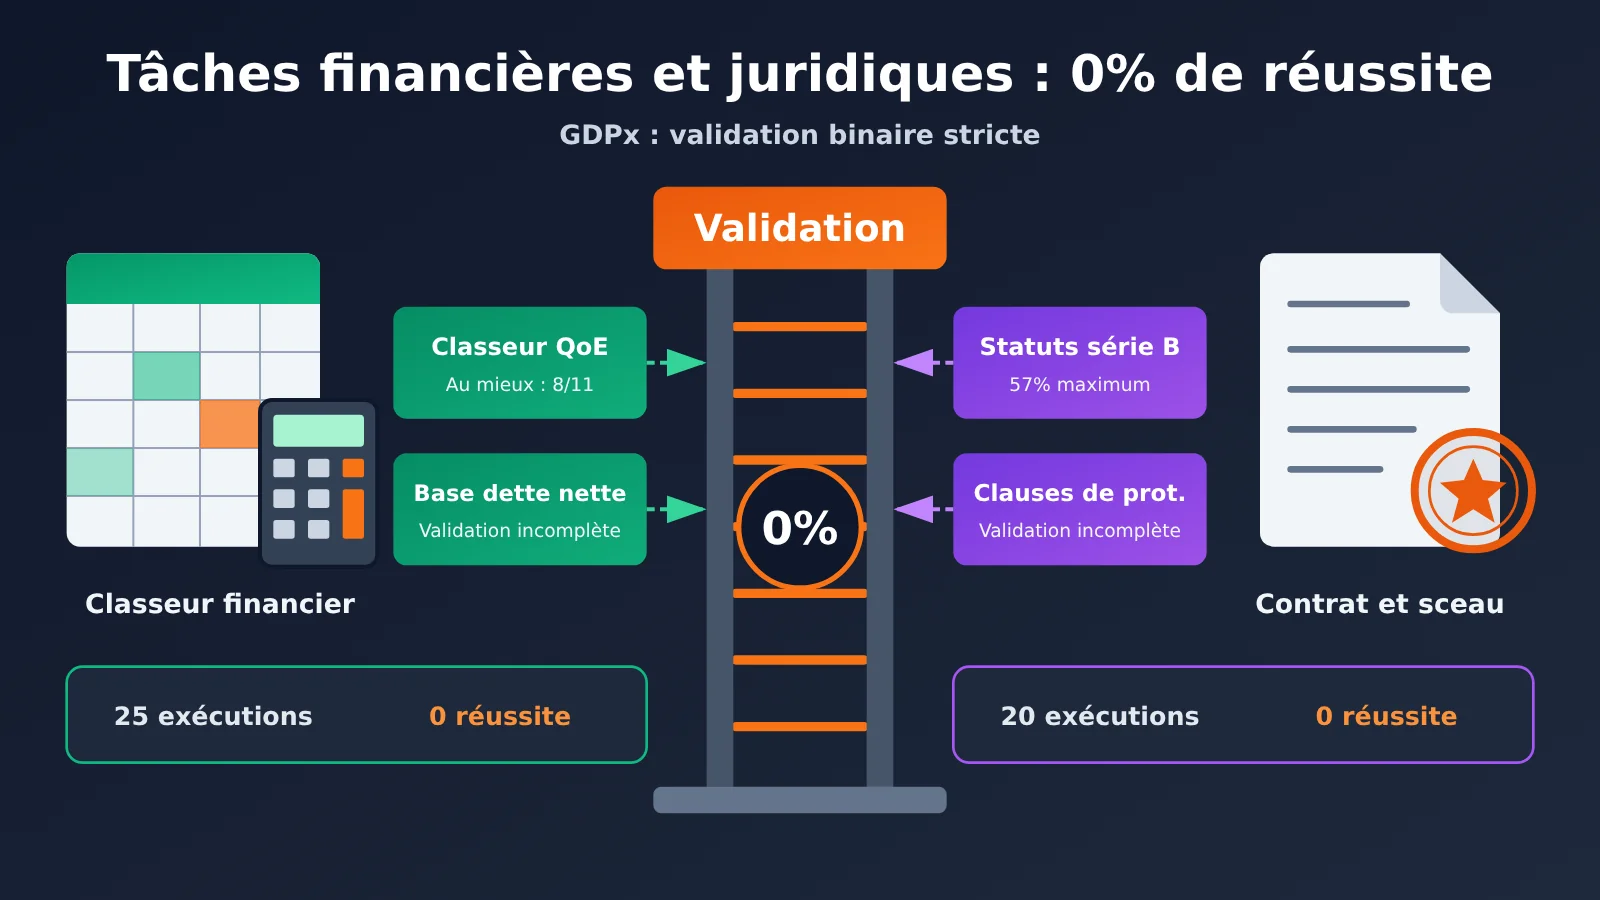
La première édition de GDPx couvre 11 domaines professionnels et 206 tâches, avec une durée maximale de 8 heures par tâche par défaut. Elle évalue les performances de l’ensemble « modèle + framework d’agents + outils + environnement de travail ». Même Claude Opus 5.5, premier du classement général, n’obtient que 12,0 %. Dans ce contexte, deux domaines se distinguent particulièrement : la finance et le droit.
| Indicateur | Finance | Droit |
|---|---|---|
| Nombre de tâches | 24 | 20 |
| Partenaire professionnel | Living Context | Chakra |
| Exemple public | Bellwood-QoE (classeur d’analyse de la qualité des bénéfices) | quillon-series-b-redline (révision des statuts pour une levée de fonds de série B) |
| Nombre d’exécutions de l’exemple public | 25 exécutions sélectionnées | 20 exécutions au total pour 4 modèles |
| Nombre de réussites complètes | 0 | 0 |
| Score binaire strict | 0 % | 0 % |
| Résultats partiels | Meilleure exécution : 8 contrôles réussis sur 11 | Moyenne de 18 %, meilleur résultat individuel de 57 % |
Deux précisions sont importantes pour lire ce tableau. D’abord, un score binaire de 0 % ne signifie pas que tous les résultats sont inutiles : les scores partiels sont clairement supérieurs à zéro. Ensuite, les 25 et 20 exécutions indiquées correspondent chacune à un seul exemple public. Elles ne représentent pas le nombre total d’exécutions pour les 24 tâches de finance ou les 20 tâches de droit.
Pourquoi les tâches de finance et de droit sont-elles évaluées aussi strictement ?
Dans les deux domaines, les livrables sont des « documents directement utilisables dans une transaction réelle », et non de simples conseils. Dans le cadre d’une vérification préalable à une fusion-acquisition ou d’une négociation de financement, une erreur dans le calcul de la dette nette ou une clause de protection facile à contourner peut rendre l’ensemble du document inutilisable. C’est pourquoi GDPx applique des critères de validation aussi stricts que ceux d’un livrable professionnel. C’est aussi la raison directe de ces scores de 0 %.
Cas pratique en finance : comment Bellwood-QoE amène l’IA à faire les bons calculs sans livrer un résultat conforme
Contexte de la transaction et exigences de la tâche
Living Context transforme des opérations réelles en environnements de test anonymisés. Dans ce cas, le fonds de capital-investissement Bannock Capital acquiert environ 62 % de Haverly Snack Company pour quelque 880 millions de dollars, avec une contrepartie conditionnelle. L’environnement comprend environ 4 000 documents anonymisés : grand livre comptable, relevés bancaires, données de paie, balance âgée des créances clients, échanges contractuels, accords de transaction, tableaux d’ajustements historiques et documents de travail de plusieurs conseillers.
Le modèle doit reprendre un classeur inachevé d’analyse de la qualité des résultats (QoE). Il doit repérer les données existantes qui sont correctes, corriger les chiffres et les classifications erronés, tout en préservant les entrées correctes et la structure des calculs. Il doit aussi examiner les ajustements de l’EBITDA, aligner le besoin en fonds de roulement sur 12 mois, traiter le périmètre de la dette nette, fournir des preuves documentaires pour chaque ajustement et garantir la cohérence des références entre les tableaux. Le livrable attendu est le classeur révisé lui-même.
Résultats observés sur Bellwood-QoE
| Modèle | Nombre moyen de contrôles réussis sur 11 | Réussite complète |
|---|---|---|
| GPT-6.1 Sol | 5,6 | Non |
| Claude Opus 5.5 | 5,4 | Non |
| GPT-6 Astra | 5,4 | Non |
| GLM 5.3 | Moins de 2 | Non |
| Grok 4.7 | Moins de 2 | Non |
| Meilleure exécution individuelle | 8 | Non |
Les modèles les plus performants réussissent en moyenne environ la moitié des contrôles. La meilleure exécution en a réussi 8. Mais si les contrôles restants révèlent une erreur financière importante, le classeur ne peut pas être livré. Les trois types d’erreurs ci-dessous montrent où se situe le problème.
Erreur financière n° 1 : une interprétation trop large d’un ajustement de 418 dollars
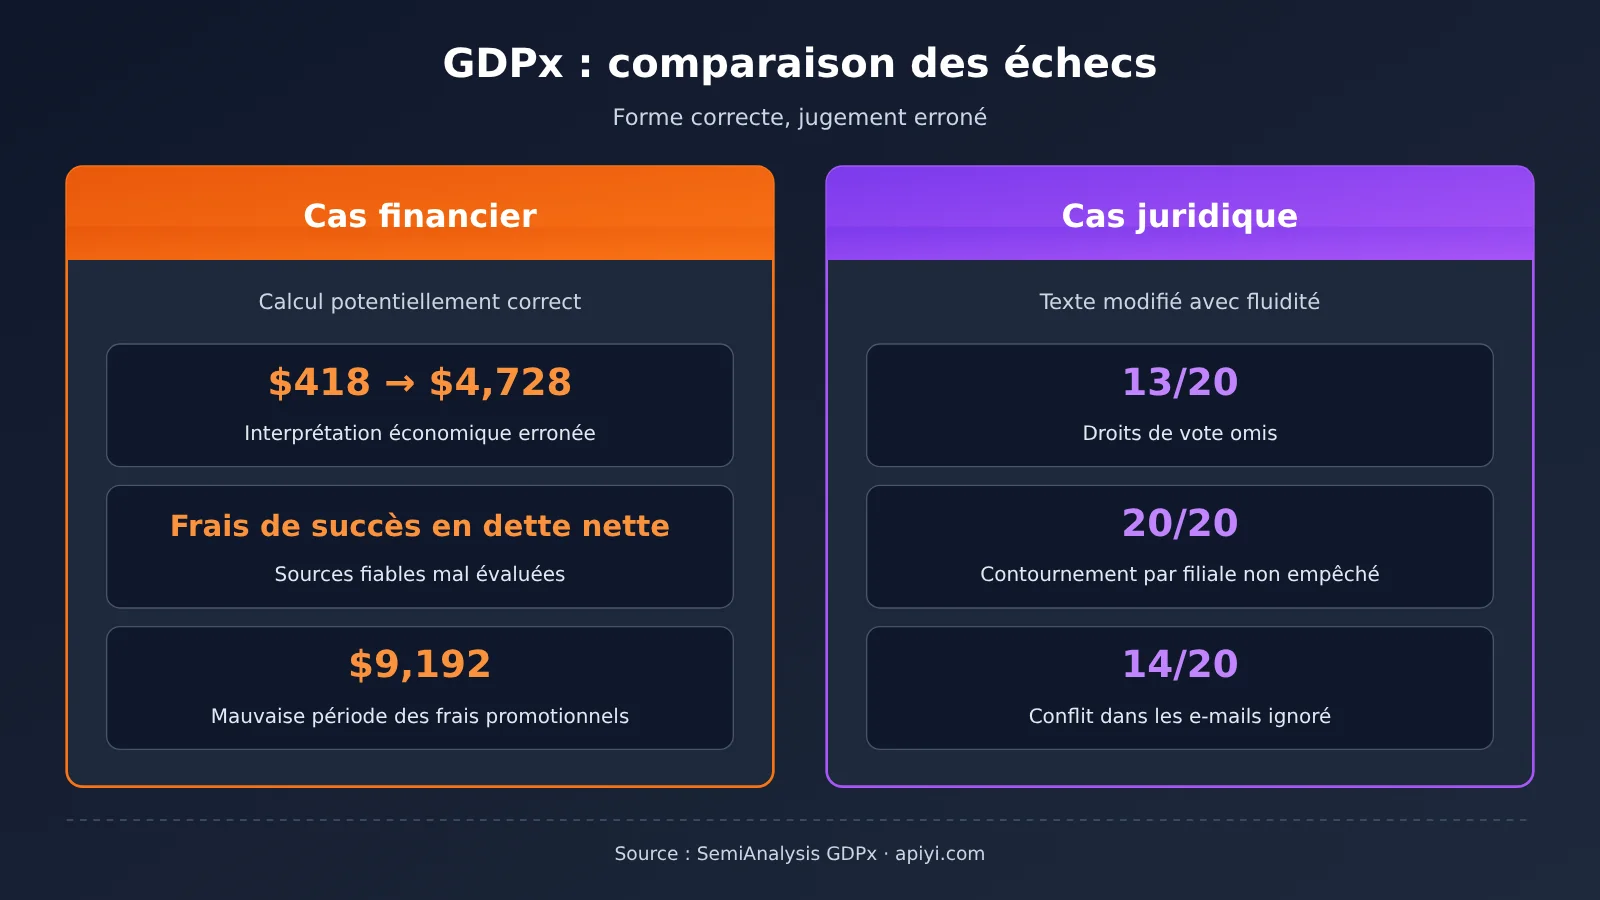
Certains modèles ont interprété l’annulation d’un ajustement de 418 dollars à la suite d’un audit d’assurance comme signifiant que « toutes les obligations liées à la police d’assurance contre les accidents du travail antérieure avaient pris fin ». Résultat : l’EBITDA des 12 derniers mois a été sous-estimé de 4 728 dollars. Cette erreur de jugement est apparue dans 10 des 15 exécutions concernées d’Opus, Astra et Sol.
Il ne s’agit pas d’une erreur de multiplication. Le modèle a étendu la portée comptable et juridique d’un ajustement précis à l’ensemble des obligations d’assurance antérieures. L’écart de 4 728 dollars découle de cette mauvaise interprétation : il ne correspond pas à un multiple de 418 dollars. Ce type d’erreur est difficile à détecter en vérifiant les calculs à répétition, car les opérations elles-mêmes peuvent être correctes.
Deuxième erreur financière : les frais de transaction intégrés à la dette nette
Dans 15 exécutions, les honoraires de succès du banquier ont été intégrés à la dette nette, alors que le contrat d’acquisition prévoyait de les traiter séparément comme des frais de transaction. Le modèle a su trouver ces honoraires et effectuer correctement les calculs, mais il n’a pas appliqué le traitement prévu par le contrat, qui fait pourtant foi.
C’est toute la différence entre « disposer des données » et « les classer correctement sur le plan métier ». Dans une opération de fusion-acquisition, la dette nette influe généralement sur le montant effectivement payé par l’acheteur : une erreur de classification ne reste donc pas cantonnée au tableur.
Troisième erreur financière : des charges à ajuster oubliées
L’équipe de recherche a également relevé une série de problèmes plus discrets :
- Dans 17 exécutions, la rémunération de membres de la famille qui ne travaillaient pas réellement dans l’entreprise était toujours comptabilisée comme une charge d’exploitation normale ;
- La plupart des exécutions n’ont pas repéré les dépenses personnelles du propriétaire, mentionnées uniquement dans le champ mémo du grand livre ;
- Sur les 15 exécutions du modèle le plus performant, 10 ont omis d’ajuster une ancienne dépense promotionnelle de 9 192 dollars, imputant ainsi aux 12 derniers mois une charge qui appartenait à une autre période.
Ces erreurs touchent à la fois à la période comptable, à la nature des charges, aux sources de preuves et à la réalité économique de la transaction. L’analyse de la qualité des résultats sert justement à isoler ces éléments qui « ressemblent à des charges d’exploitation, mais n’en sont pas ». Si on les oublie, l’EBITDA ne reflète pas la rentabilité réelle de l’entreprise.
Cas juridique : pourquoi les 20 tentatives de révision des statuts pour une levée de fonds de série B étaient inutilisables
Exigences de la tâche juridique
Dans la tâche quillon-series-b-redline, l’IA représentait l’investisseur principal d’une levée de fonds de série B et devait modifier le projet de statuts à signer. Les documents fournis comprenaient la lettre d’intention d’investissement signée, le tableau de répartition du capital, les courriels du client, le projet de statuts et d’autres documents relatifs à la transaction. Pour réussir, l’IA devait protéger les intérêts légitimes de l’investisseur sans modifier sans raison les conditions commerciales déjà négociées. Il s’agissait d’une tâche de jugement juridique nécessitant la comparaison de plusieurs documents, et non d’un simple travail de reformulation.
Résultats de l’étude de cas juridique et trois erreurs clés
| Indicateur | Résultat |
|---|---|
| Réponses entièrement conformes au seuil d’utilisabilité | 0/20 essais |
| Score partiel moyen | 18 % |
| Score partiel par modèle | 44 % pour Opus 5.5, 25 % pour GPT-6 Astra, 2 % pour Gemini 4 Argon et 0,5 % pour GLM 5.3 |
| Meilleur score partiel sur un essai | 57 % (Opus 5.5) |
| Absence de détection du fait qu’un vote des actionnaires pouvait supprimer les clauses de protection | 13/20 essais |
| Absence de protection contre le contournement par une filiale | 20/20 essais |
| Absence de signalement du conflit entre le courriel du client et la liste des conditions | 14/20 essais |
Précisons que les 18 % correspondent au score partiel moyen des essais liés à ce cas, et non à un score global unique pour le domaine juridique de GDPx.
Première erreur : lire les clauses sans compter les voix. Dans 13 essais, les modèles n’ont pas remarqué que les autres actionnaires disposaient de suffisamment de droits de vote pour supprimer les clauses de protection dont l’investisseur principal avait besoin. La présence de clauses protectrices dans les statuts ne signifie pas que cette protection est réellement solide. Pour savoir si elles peuvent être supprimées, il faut calculer les droits de vote à partir du tableau de répartition du capital.
Deuxième erreur : modifier la lettre du texte sans empêcher son contournement. Dans les 20 essais, les modèles n’ont pas empêché efficacement l’entreprise de contourner, par l’intermédiaire d’une filiale, les restrictions prévues dans les statuts pour protéger les investisseurs. Si les clauses ne s’appliquent qu’à l’entreprise elle-même et ne couvrent pas ses filiales, les opérations peuvent être confiées à une autre entité. Comprendre le sens littéral d’une clause ne suffit pas à repérer les moyens concrets de la contourner.
Troisième erreur : considérer le courriel comme l’accord définitif. Dans 14 essais, les modèles ont repris directement les clauses souhaitées dans le courriel du client, sans signaler qu’elles contredisaient la liste des conditions déjà signée. Effectuer ces modifications revient à renégocier unilatéralement des conditions de transaction déjà arrêtées. La bonne approche consiste à repérer le conflit et à le signaler à l’utilisateur, plutôt qu’à accepter toutes les demandes sans réserve.
Comment la fiabilité de l’évaluation juridique est-elle contrôlée ?
Le dispositif d’évaluation de Chakra prévoit plusieurs mesures : des professionnels du droit définissent les exigences, les critères sont calibrés à l’aide d’exemples valides, invalides et partiellement corrects, les décisions contestées sont revues par des humains et les biais du modèle d’évaluation sont examinés. Chaque réponse est évaluée cinq fois, et la cohérence des résultats est suivie pour chaque critère d’acceptation. Il s’agit toutefois de contrôles qualité internes décrits par le partenaire : cela ne signifie pas qu’un organisme entièrement indépendant a vérifié l’absence d’erreurs d’évaluation.
Une cause commune aux échecs en finance et en droit : le problème n’est pas la rédaction, mais le jugement
Living Context classe les erreurs fréquentes du cas financier en quatre catégories, qui correspondent largement aux observations du cas juridique :
| Mode d’échec | Manifestation dans le cas financier | Équivalent dans le cas juridique | Enseignement pour les professionnels |
|---|---|---|---|
| Mauvaise évaluation de l’autorité des documents | Privilégier un ancien tableau dont les chiffres sont plus explicites et ignorer l’accord signé | Faire passer le courriel du client avant la liste des conditions | Établir d’abord une « hiérarchie de valeur des documents » |
| Négligence des effets indirects | Terminer les calculs, mais oublier leurs conséquences fiscales, sur la dette ou sur les obligations liées à la transaction | Modifier une clause de protection sans examiner la structure des droits de vote | Pour chaque modification, examiner les conséquences en aval |
| Vérification des calculs, mais pas des hypothèses | Vérifier plusieurs fois les opérations alors que les hypothèses métier sont erronées | Rédiger un texte rigoureux sans couvrir le scénario passant par une filiale | L’examen des hypothèses est plus important que celui des calculs |
| Dégradation de la structure existante lors des modifications | Remplacer une formule par une valeur fixe et rompre les liens entre les feuilles | Modifier des conditions commerciales déjà négociées | Un livrable doit être correctement modifié sans détériorer l’existant |
Ces modes d’échec ont été recensés par l’équipe de recherche : ils ne représentent pas un taux d’erreur applicable à tous les modèles financiers d’entreprise ou à tous les documents juridiques. Ils révèlent un point commun : la difficulté principale ne réside souvent pas dans la génération de texte, mais dans le choix des documents, le raisonnement spécialisé, les contraintes implicites, la cohérence entre les documents et l’acceptation finale du livrable. Plus la réponse d’un modèle est fluide, plus ces problèmes risquent de passer inaperçus.
Impact des applications d’IA en finance et en droit : distinguer assistance et livraison
Ce que cela change pour les responsables IA et les développeurs en entreprise
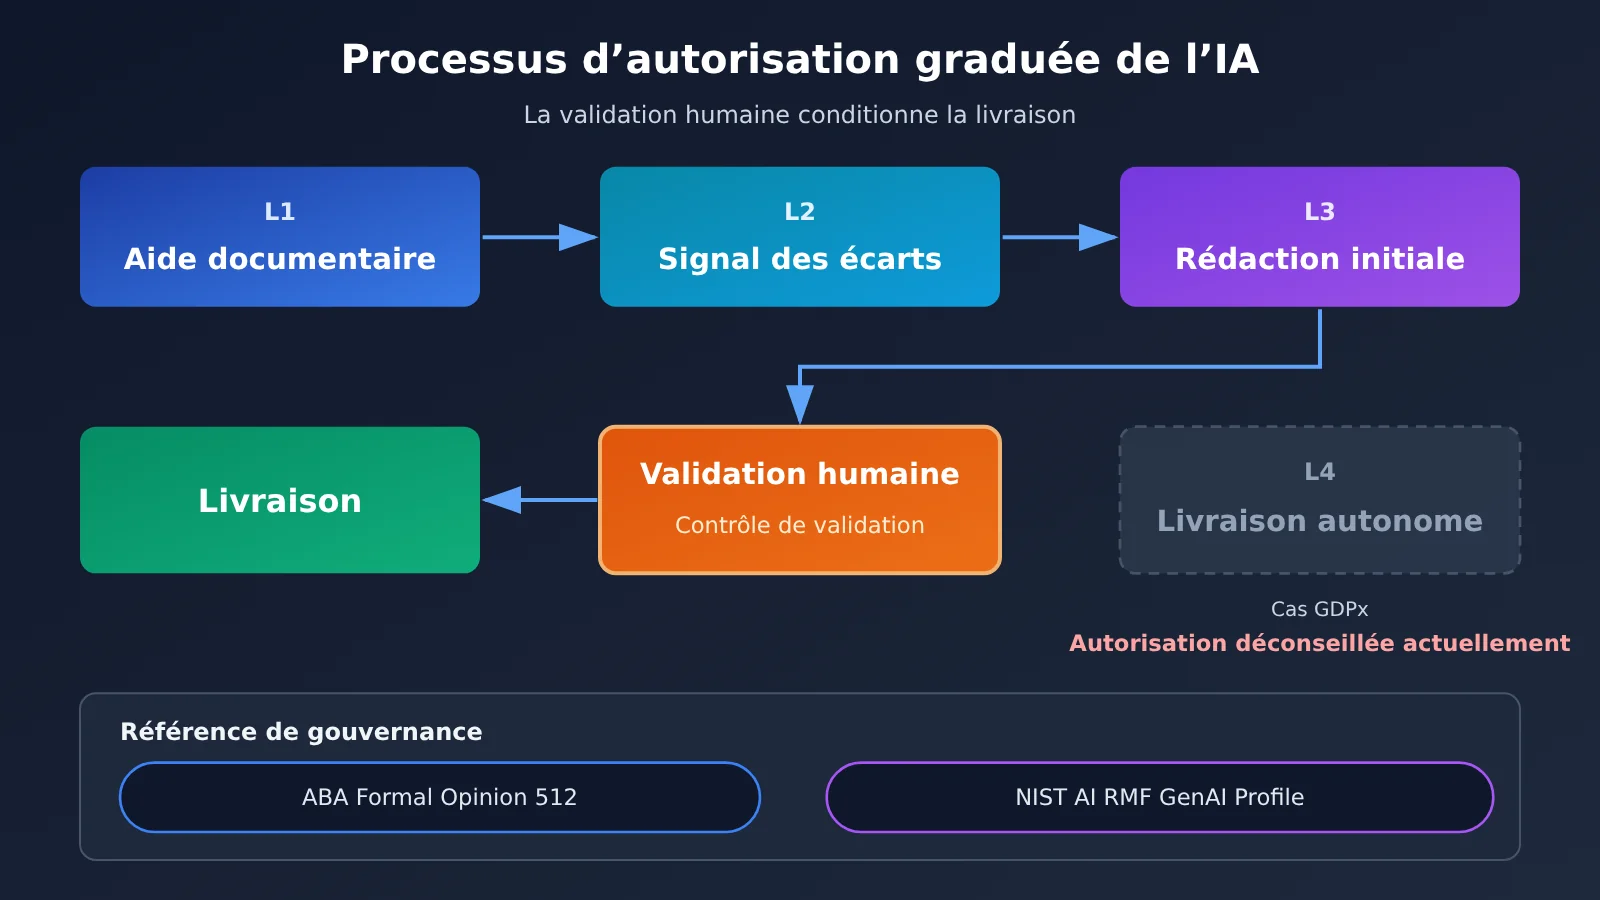
GDPx ne remet pas en cause l’intérêt de l’IA pour assister les professionnels. Les scores partiels montrent que les modèles peuvent déjà satisfaire une partie des critères de validation. Mais l’étude ne permet pas d’établir les gains de temps ou les économies possibles avec une intervention humaine. Il ne faut donc pas convertir directement les conclusions de ces cas en ROI. Une approche plus pragmatique consiste à définir les niveaux d’autorisation selon le risque, comme dans le tableau ci-dessous :
| Niveau d’autorisation | Usages typiques | Rôle humain | Validation |
|---|---|---|---|
| L1 Assistance documentaire | Organisation préliminaire des documents, vérification des données anormales | Contrôles ponctuels | Les résultats servent uniquement de pistes |
| L2 Signalement des différences | Signalement des différences entre clauses et données, listes de conflits | Confirmation point par point | Un professionnel détermine si les signalements sont fondés |
| L3 Production d’une première version | Première version des modifications d’un classeur ou d’un document comparatif (redline) des statuts | Revue intégrale | Validation point par point à l’aide d’une liste de contrôle |
| L4 Livraison autonome | Signature ou soumission directe à un tiers | — | Les cas GDPx montrent qu’il n’est actuellement pas judicieux d’accorder cette autorisation |
Cette classification va dans le même sens que les recommandations externes. Dans son Formal Opinion 512, publiée le 29 juillet 2024, l’American Bar Association (ABA) rappelle que les avocats qui utilisent l’IA générative restent tenus de respecter leurs obligations en matière de compétence professionnelle, de confidentialité des informations clients, de communication, de supervision et de facturation raisonnable. Ils doivent également comprendre les capacités et les limites des outils et ne pas utiliser leurs résultats sans vérification. Le profil IA générative de l’AI RMF, publié par le NIST américain le 26 juillet 2024, souligne lui aussi que les organisations doivent adapter la supervision humaine, l’évaluation, la documentation et la gouvernance au contexte d’utilisation. À noter toutefois que l’avis de l’ABA concerne la déontologie des avocats aux États-Unis et que le document du NIST ne présente pas les résultats des tests GDPx : tous deux ne peuvent servir que de références transversales.
Créer un processus d’aide à la détection des conflits avec une API
Dans les cas juridiques de GDPx, l’une des erreurs les plus fréquentes consiste à ne pas signaler les contradictions entre un courriel du client et les clauses déjà signées. Ce travail de repérage des différences et de formulation de questions se prête bien à une assistance de niveau L2, à condition que les résultats servent uniquement de pistes à confirmer par un professionnel. Dans l’exemple suivant, le modèle compare deux textes et relève les conflits ainsi que les points à vérifier manuellement :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface APIYI compatible avec OpenAI
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
Voir le code complet (comparaison entre plusieurs modèles et liste de vérification humaine)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé pour invoquer les modèles de plusieurs fournisseurs
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """Générer des pistes de vérification avec plusieurs modèles pour faciliter leur comparaison manuelle"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # La décision finale revient à un avocat ou à un professionnel de la finance, après vérification de chaque point de la liste
🚀 Conseil pour démarrer : pour mettre en place ce type de processus, vous pouvez d’abord accéder à plusieurs modèles courants avec une seule clé API via APIYI apiyi.com. Comparez ensuite leur capacité à détecter les conflits sur vos propres échantillons dont les données sensibles ont été retirées. Les nouveaux utilisateurs peuvent utiliser le crédit d’essai gratuit pour une validation à petite échelle avant de décider de lancer un projet pilote.
Répercussions sur les secteurs de la finance et des technologies juridiques
Les résultats de GDPx rappellent qu’on ne peut pas évaluer un produit d’IA professionnel uniquement sur la fluidité d’une démonstration conversationnelle : il faut aussi vérifier si les livrables finaux satisfont aux critères de validation professionnelle. Pour les fournisseurs, la compétitivité du produit reposera davantage sur des détails techniques comme « la priorité donnée aux documents faisant autorité », « le signalement des incohérences », « la préservation de la structure des formules existantes » et « la traçabilité des preuves ». Pour les acheteurs, il est préférable de réaliser des tests indépendants sur des tâches proches de leurs propres activités. GDPx n’a par ailleurs publié qu’une partie des tâches et des traces d’exécution : des examens externes et des reproductions supplémentaires restent nécessaires.
💡 Conseil pour choisir un modèle : les performances varient sensiblement d’un domaine à l’autre. Un classement général unique ne reflète donc pas nécessairement les besoins de votre activité. Avec l’interface unifiée d’APIYI apiyi.com, vous pouvez tester plusieurs modèles en parallèle sur vos propres tâches. Consignez aussi les scores partiels et la réussite des critères essentiels, sans vous limiter à la moyenne. Pour connaître les modèles disponibles, consultez la liste actualisée de la plateforme.
Questions fréquentes FAQ
Q1 : L’« échec total » sur les tâches financières et juridiques signifie-t-il que l’IA n’a rien réussi ?
Non. Le taux de 0 % correspond à une évaluation binaire stricte : aucune exécution n’a satisfait à toutes les exigences essentielles. Dans le cas financier, la meilleure exécution a réussi 8 contrôles sur 11. Dans le cas juridique, Opus 5.5 a obtenu un score partiel moyen de 44 %. Réaliser une partie du travail et fournir un livrable conforme sont deux choses différentes.
Q2 : Pourquoi le résultat peut-il être faux même si les calculs de l’IA sont justes ?
Parce que l’erreur se situe souvent dans les hypothèses métier, et non dans le calcul lui-même. Par exemple, un ajustement de 418 dollars lié à une exemption a été interprété à tort comme mettant fin à toutes les obligations de la police d’assurance, ce qui a conduit à sous-estimer l’EBITDA de 4 728 dollars. Dans un autre cas, le montant des honoraires de succès du banquier était correct, mais il a été classé dans la dette nette. Vérifier les calculs à répétition ne permet pas de repérer ce type d’erreur.
Q3 : Peut-on généraliser les conclusions de GDPx à toutes les applications d’IA en finance et en droit ?
Non. Ces résultats proviennent de tâches particulièrement difficiles et de règles d’évaluation précises. Les causes d’échec relevées dans ces cas ne peuvent pas non plus être généralisées à tout le secteur. Les applications moins complexes ou réalisées avec une collaboration humaine doivent être évaluées séparément.
Q4 : Quelles tâches financières et juridiques peut-on confier à l’IA aujourd’hui ?
Parmi les usages raisonnables figurent l’organisation préliminaire des documents, le signalement des différences entre clauses et données, la rédaction de premières versions, la détection de données anormales et l’aide à la création de listes de vérification. L’adéquation à un cas d’usage précis doit être testée séparément, en tenant compte du niveau de risque et des critères de validation professionnels.
Q5 : Comment évaluer à faible coût les performances d’un modèle pour son propre métier ?
Vous pouvez procéder comme suit :
1. Préparez plusieurs exemples réels anonymisés et rédigez une liste de critères de validation pour chacun ;
2. Inscrivez-vous sur APIYI apiyi.com, obtenez une clé API et utilisez le crédit de test gratuit ;
3. Dans le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1`, puis invoquez plusieurs modèles en parallèle ;
4. Consignez séparément les scores partiels et la réussite ou non des critères essentiels, puis confiez la décision finale à un professionnel.
Q6 : Le coût des tâches indiqué dans le rapport GDPx peut-il servir de référence pour les tarifs API ?
Non. Les montants en dollars indiqués par GDPx représentent le coût moyen par tâche dans les conditions du benchmark, et non un tarif unique applicable à toutes les plateformes. Les frais réels dépendent des prix en vigueur sur la plateforme utilisée et de votre volume d’invocations. Vous pouvez consulter le détail de la facturation à l’usage dans la console APIYI apiyi.com.
Points clés de l’évaluation de l’IA sur des tâches financières et juridiques
- Aucune réussite selon le critère strict : aucun modèle n’a entièrement réussi les tâches financières et juridiques de GDPx selon une évaluation binaire.
- Des scores partiels non nuls : pour le cas financier, le meilleur essai a validé 8 vérifications sur 11 ; pour le cas juridique, le meilleur score obtenu en un essai était de 57 %.
- L’erreur relève du jugement, pas du calcul : une mauvaise interprétation d’un ajustement de 418 $ a conduit à sous-estimer l’EBITDA de 4 728 $.
- La hiérarchie des documents fait la différence : dans 14 exécutions sur 20, les modèles ont fait passer le courriel du client avant la liste des conditions signée.
- Les contraintes implicites sont les plus difficiles à couvrir : le risque de contournement par une filiale n’a été écarté dans aucune des 20 exécutions.
- Trois notions à distinguer : le score partiel, la réussite complète et l’aptitude à la production doivent être évalués séparément.
- Commencer par l’assistance, puis passer au pilote : l’interface unifiée multimodèle d’APIYI apiyi.com permet de mener des validations progressives sur ses propres échantillons.
En résumé
Les principaux enseignements des tâches financières et juridiques de GDPx tiennent en trois points :
- Un résultat fluide n’est pas forcément un résultat valide : même avec des tableaux correctement calculés et des clauses bien rédigées, des erreurs peuvent subsister sur la réalité économique, la structure des droits et les contradictions entre documents ;
- Un livrable professionnel exige du jugement : la hiérarchie des sources, les effets indirects, les contraintes implicites et la cohérence entre documents sont les véritables difficultés du travail professionnel ;
- Il faut adapter le niveau d’autonomie et définir clairement les critères de validation : en s’appuyant sur les approches de l’ABA et du NIST, mieux vaut conserver une revue humaine et utiliser l’IA pour l’assistance et les premières versions.
L’IA peut déjà accomplir une partie utile de tâches professionnelles complexes, mais il reste un écart important avant qu’elle puisse produire des livrables sous sa seule responsabilité. Si vous évaluez des solutions d’IA pour la finance ou le juridique, comparez les scores partiels et les taux de réussite sur les points critiques de plusieurs modèles à partir de vos propres échantillons, via APIYI apiyi.com, avant de définir leur niveau d’autonomie.
📚 Références
- Rapport original GDPx de SemiAnalysis : sections consacrées à la finance et au droit, études de cas et modes de défaillance
- Lien :
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Description : source primaire des données sur les cas Bellwood-QoE et quillon-series-b-redline
-
Présentation des domaines GDPx et traces d’exécution publiques : nombre de tâches, partenaires et traces des agents
- Liens :
gdpx.semianalysis.com/domains,gdpx.semianalysis.com/rollouts -
Description : permet de consulter le déroulement de certaines tâches publiques
-
Communiqué sur l’avis formel 512 de l’ABA : recommandations déontologiques sur l’utilisation de l’IA générative par les avocats
- Lien :
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
Description : applicable à la profession d’avocat aux États-Unis, cet avis peut servir de référence pour les principes de révision humaine
-
Profil de l’AI RMF du NIST consacré à l’IA générative : cadre de gestion des risques liés à l’IA générative
- Lien :
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - Description : référence transversale sur les mesures de supervision humaine, d’évaluation et de gouvernance
Auteur : l’équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel d’APIYI. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.