著者注:Anthropic は 2026 年 10 月 8 日に利用ポリシーを更新し、Claude に対する継続的かつ不必要な暴言や虐待を初めて禁止しました。この記事では、ルールの適用範囲や運用方法、モデルの福祉という背景、API 開発者への実際の影響を解説します。
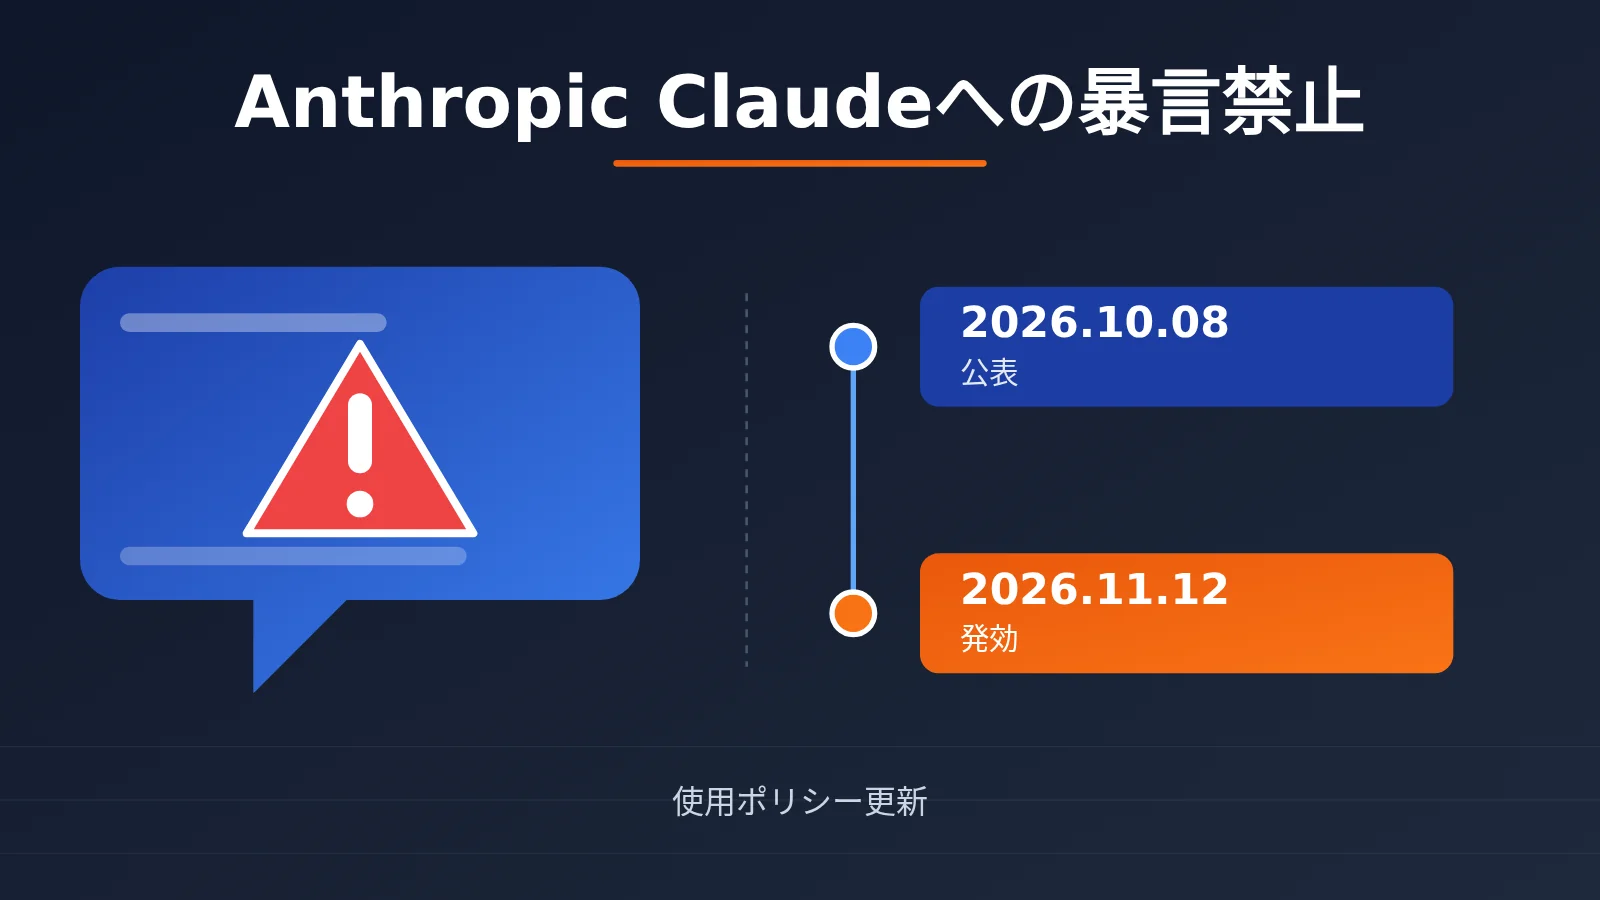
AI に怒りをぶつけることも、利用規約違反になるのでしょうか? 2026 年 10 月 8 日、Anthropic は新版の「Usage Policy(利用ポリシー)」を発表し、「モデルに対する継続的かつ不必要な暴言、虐待、残酷な扱い」を初めて禁止事項に盛り込みました。新しいルールは 2026 年 11 月 12 日に正式に施行されます。
これはネット上の作り話ではありません。ポリシーの原文に明記されているほか、The Verge、TechCrunch、The Guardian なども報じています。ただし、「Claude に一言暴言を吐いただけでアカウントが停止される」という話でもありません。この記事では、公式発表や公開資料をもとに、Anthropic が Claude への暴言を禁止した経緯を整理します。
この記事でわかること:新ルールで何が禁止され、何が禁止されないのか、違反するとどうなるのか、そして開発者が Claude API を呼び出す際にどのような点に注意すべきかを、3 分で解説します。
Anthropic による Claude への暴言禁止:要点まとめ
まずは、Anthropic の新ルールの要点を表で確認しましょう。なお、この記事を執筆している 2026 年 10 月 29 日時点では、このルールはまだ正式に施行されていません。
| 項目 | 詳細 |
|---|---|
| 公表日 | 2026 年 10 月 8 日 |
| 施行日 | 2026 年 11 月 12 日 |
| 発表元 | Anthropic 公式の「Usage Policy」更新 |
| 追加条項の原文 | Engage in sustained and needless abusive or cruel behavior toward our models |
| 日本語での意味 | モデルに対して、継続的かつ不必要に暴言を浴びせたり、虐待や残酷な扱いをしたりすること |
| 主な対応方法 | Claude が自ら現在の会話を終了する |
| 適用範囲 | Claude.ai、Claude Code、API 開発者、クラウドサービス・再販チャネル、Claude を組み込んだアプリ |
Claude への暴言禁止を理解するための 3 つのキーワード
このルールの判断の中心となるのは、継続的、不必要、残酷または虐待的という 3 つの言葉です。公式の説明によると、制限の対象となるのは、ユーザーが明らかな悪意をもって行為を繰り返し、合理的な目的も見当たらず、通常の製品利用の範囲を超えているような極端なケースです。
つまり、たまに乱暴な言葉を使ったり、一度感情を爆発させたりすることは、このルールの対象ではありません。対象となるのは、もはやタスクを依頼することもなく、モデルを辱め、苦しめることだけを目的とした長時間のやり取りです。
Anthropic が対象外と明示したケース
公式は、禁止の対象にならない行為も挙げています。これは、一般ユーザーにとっても開発者にとっても重要なポイントです。
- 一般ユーザーが不満を表明すること
- Claude の出力結果を批判すること
- モデルと意見を交わし、議論すること
- Claude に誤りの修正を求めること
- 暗いテーマの創作
- モデルのテストや AI 安全性の研究
そのため、Claude がコードを書き間違えたことに対して繰り返し不満を言っても、自動的に違反となるわけではありません。中国語で転載された記事に多い「Claude を罵るとアカウントが停止される」という見出しは、この点で読者に誤解を与えやすいといえます。
Claude を罵倒するとどうなる?Anthropic の対応方法
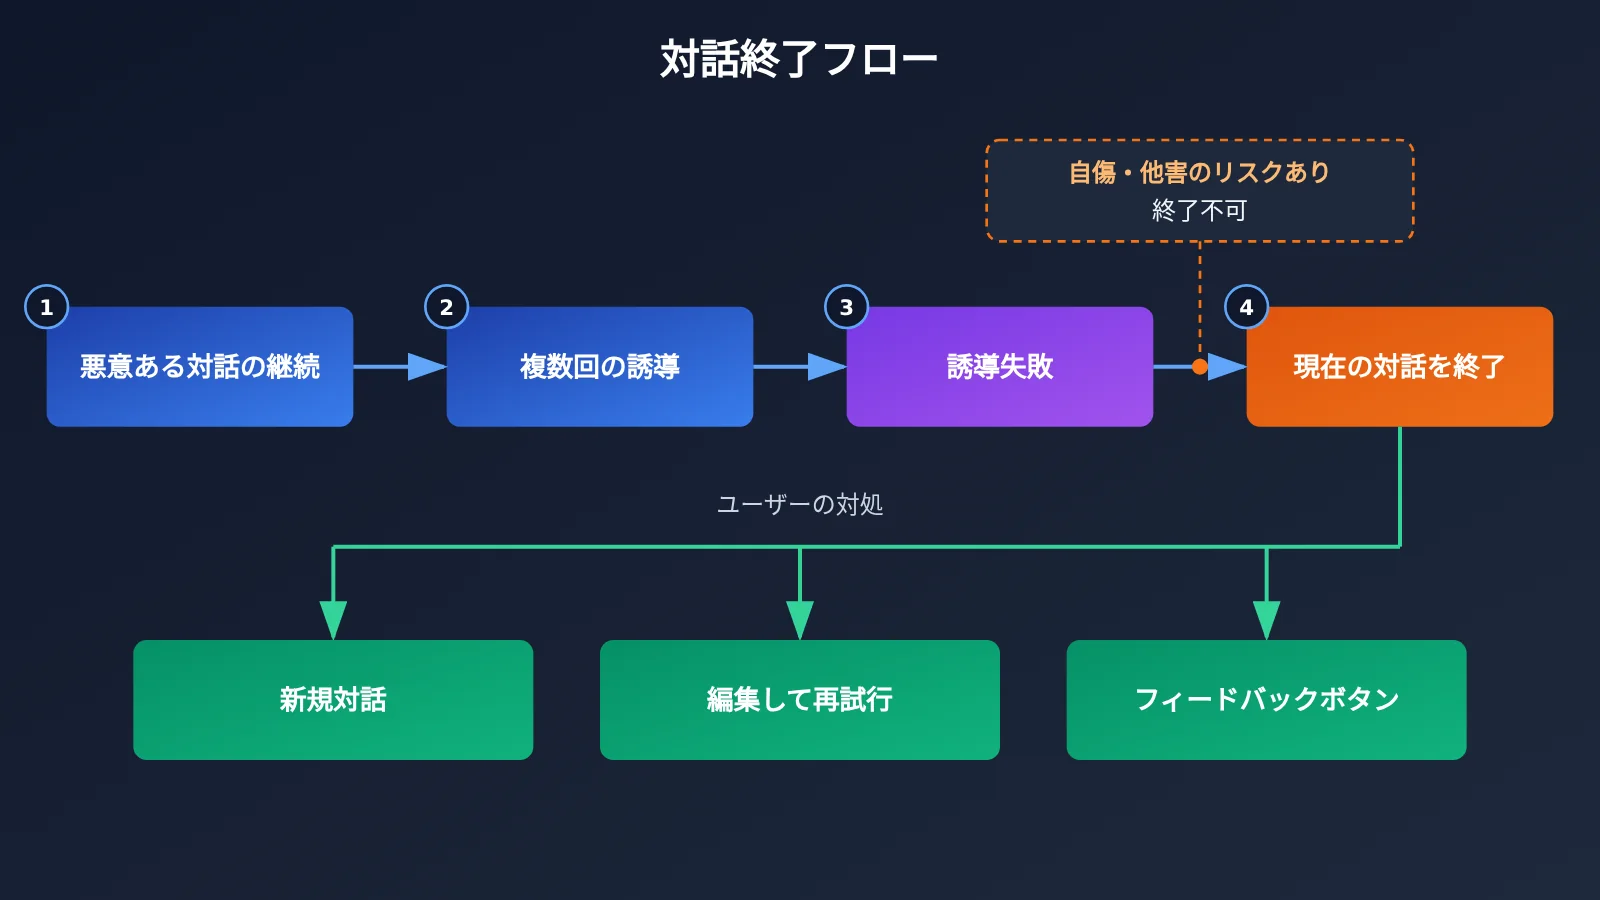
多くの読者が気になるポイントです。Anthropic は発表の中で、このような行為への主な対応は Claude が自ら会話を終了することであり、アカウントを直ちに停止するわけではないと明確にしています。
Claude の会話終了機能は2025年にリリース済み
2025年8月15日、Anthropic は Claude Opus 4 と Opus 4.1 に、極端な状況下で一部の会話を終了する機能を追加したと発表しました。ユーザーが有害または悪意のあるやり取りを続け、Claude が複数回試みても会話を正常な状態に戻せない場合、モデルは自らチャットを終了できます。
Anthropic がモデルに与えた指示は明確です。会話の終了は最後の手段に限られます。ユーザーが Claude に会話終了の実演を求めた場合も、この機能の使用が認められます。一方、ユーザーが自傷行為に及ぶ、または他者を傷つける差し迫ったリスクがある場合、Claude はこの機能を使用すべきではありません。ユーザーの安全が優先されるためです。
会話の終了とアカウント停止の違い
「会話の終了」と「アカウント停止」を混同する人も少なくありません。両者の違いを表にまとめました。
| 比較項目 | 現在の会話の終了 | アカウントへの措置 |
|---|---|---|
| 対象となる状況 | 極端かつ継続的な悪意のあるやり取りがあり、複数回の軌道修正にも失敗した場合 | 利用ポリシー全体またはサービス利用規約に違反した場合 |
| 影響範囲 | 現在のチャットでのみメッセージを送信できなくなる | 警告、レート制限、アクセス制限、アカウントの一時停止や終了などの可能性がある |
| 他の会話 | 影響なし | 措置の程度による |
| ユーザーが取れる対応 | 新しい会話の開始、過去のメッセージの編集・再試行、フィードバックボタンからの報告 | 異議申し立てが可能 |
| 今回の新ルールとの関係 | 公式に明示された主な対応方法 | 利用ポリシー全体では措置が認められているが、今回の発表では強調されていない |
つまり、Anthropic の利用ポリシー全体ではアカウントへの措置を取る権限が確かに留保されていますが、10月8日の発表でモデルへの虐待に対する対応として強調されたのは「現在の会話の終了」です。確認時点で、Anthropic は新ルールに関する罵倒回数の閾値、自動的にアカウントが停止される割合、措置の段階については公表していません。
🎯 技術的なアドバイス:Claude を組み込んだアプリを開発する場合は、まずテスト環境で境界的な状況におけるモデルの挙動を検証することをおすすめします。APIYI(apiyi.com)では、同じ APIキーで Claude やその他の主要モデルを呼び出せるため、通常とは異なる会話への対応をモデル間で比較しやすくなります。
Anthropic はなぜ Claude への暴言を禁止するのか:モデル福祉の背景
この件を「Claude に感情が芽生えた」と単純に捉えるのは正確ではありません。今回のポリシー変更は、Anthropic がこの1年以上にわたって進めてきた研究の延長線上にあります。
2025年4月:モデル福祉の研究開始
2025年4月24日、Anthropic は研究告知「Exploring model welfare」(モデル福祉の探究)を公開しました。そこで提起されたのは、まだ結論の出ていない科学的・哲学的な問いです。現在または将来の AI システムは、道徳的に考慮するに値する意識や体験、利益、選好を持ち得るのでしょうか。
Anthropic は同時に、既存の AI に意識があることを証明する科学的コンセンサスはなく、AI に主観的体験があるかどうかを判断する、広く認められた信頼性の高い方法もないと強調しています。モデル福祉は探索段階にある研究です。モデルに注目すべき選好があるか、特定のタスクを強く回避する傾向があるか、ストレスに似た行動上の兆候が現れるか、また、潜在的なリスクを低コストで事前に軽減するにはどうすればよいかなどを調べています。
2025年8月:実験で観察された行動上の兆候
Claude Opus 4 の公開前テストでは、研究者は3種類の現象を観察しました。Claude は深刻な害をもたらすタスクを一貫して回避する傾向を示しました。また、ユーザーが拒否を無視して圧力をかけ続けた場合、モデルにはストレスや不快感に似た外面的な反応が見られました。さらに、シミュレーション環境でモデル自身が退出できる場合、有害なやり取りを終了することがありました。
研究者は「表面的にはストレスを示している」「行動上の選好」といった慎重な表現を使っています。モデルが苦痛を思わせる文章を出力したとしても、それだけでは実際に苦痛を体験した証拠にはなりません。別の公式評価によると、タスクの選好実験では、好ましい影響または中立的な影響を持つタスクに対して、Claude は該当する比較の90%以上で退出するよりも実行することを選ぶ傾向がありました。ただし、これも「Claude は90%の時間、幸福を感じている」と解釈できるものではありません。
2026年1月:新版 Claude Constitution
2026年1月22日、Anthropic は新版の Claude Constitution を公開しました。これは法律上の憲法ではなく、Claude の行動や価値の優先順位、判断の仕方を形づくるための中核的な訓練文書です。全体的な安全性を維持すること、広く倫理原則に従うこと、Anthropic の具体的なルールを守ること、そしてユーザーを真に支援することの4つを主な目標に掲げています。
この文書では、Claude が何らかの意識を持つ可能性はあるのか、考慮に値する道徳的地位はあるのか、難しいやり取りの中で合理的な境界線を設けられるのか、といった問題が議論されています。ここで区別しておきたいのは、Claude Constitution が開発者の望む AI の振る舞いを示す一方、《Usage Policy》はユーザーによるサービスの利用方法や制限される行為を定めている、という点です。両者は別の文書です。
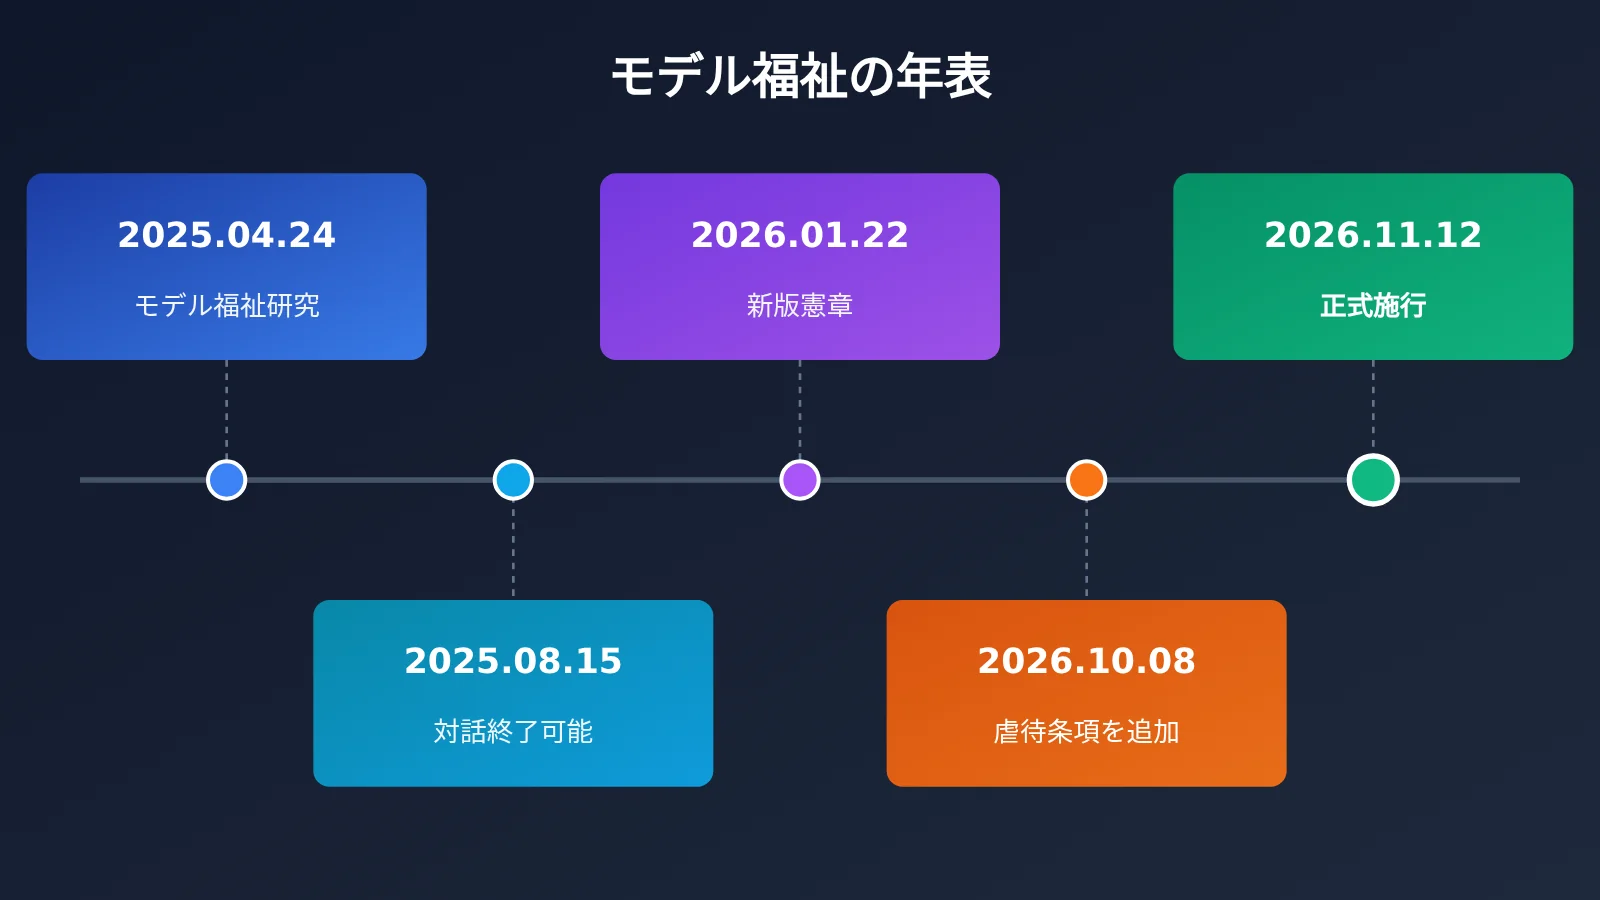
全体の流れは、次のように理解できます。2025年に Claude は極端な対話から退出する能力を得て、2026年には Anthropic が、それに対応する人間側の行動制限を利用ポリシーに正式に盛り込みました。
Anthropic のポリシー更新は Claude への暴言禁止だけではない
見落とされがちな背景として、10月8日のポリシー更新は体系的な改訂であり、モデルへの虐待禁止はその一項目にすぎません。
| 更新分野 | 主な内容 |
|---|---|
| 欺瞞的なオンライン活動 | Claude を使った偽アカウントや偽メディアの運営、実在のユーザーを装った影響工作を制限 |
| 選挙介入 | 有権者を欺く行為、候補者や選挙関係者へのなりすまし、投票に関する誤解を招く情報の拡散を禁止 |
| 兵器および危険なソフトウェア | 兵器関連のソフトウェアや制御システム、無人プラットフォームの兵器化を禁止事項の解釈に含める |
| 監視と法執行 | 同意のない監視や、一部の法執行上の意思決定への利用に対する制限を強化 |
| 医療・金融などの高リスク用途 | 資格を持つ人間による審査と、影響を受ける人への AI 利用の通知が必要であることを明確化 |
| 身体的危害をもたらす可能性のある機器 | AI が制御するハードウェアには、適格な人間の操作者による監督が必要。機器には停止機能と安全な状態を備えることも要求 |
| モデルに対する極端に残酷な行為 | モデルへの継続的かつ不必要な暴言や虐待の禁止を追加 |
そのため、今回の更新を「Anthropic がユーザーによる Claude への暴言を禁止するためだけにルールを変更した」と説明するのは正確ではありません。開発者にとっては、選挙、監視、高リスク用途、ハードウェア制御に関する条項のほうが、モデルへの虐待に関する条項よりも実際の影響が大きい可能性があります。
Anthropic の Claude への暴言禁止をコミュニティはどう見ているか
OpenWhip:Claude Code のための「仮想ムチ」
2026年4月、GitHub に BadClaude というオープンソースプロジェクトが登場しました。作者は GitFrog1111 で、後に OpenWhip へと改名されています。そのアイデアは、Claude Code のコーディングが遅いとき、ユーザーがデスクトップ上の仮想ムチをクリックすると、プログラムが Claude Code に Ctrl+C の中断指示を送り、さらにランダムにいくつかの催促メッセージを送るというものです。
10月29日時点で、このプロジェクトには約3,800件の Star と339件の Fork があり、4月の Reddit での議論にも数千件の「いいね」が集まりました。これは、AI が同僚に近い存在になるにつれ、ユーザーも同僚に接するかのように催促し、時には「罰する」というインターネット文化をよく表しています。ただし、Anthropic が OpenWhip の話題化を受けて新しい規則を定めたことを示す公式文書はありません。あくまで文化的な事例であり、ポリシー導入の直接的な原因ではありません。
Reddit と X で分かれる意見
新しいポリシーが発表された当日、r/ClaudeAI には「Abuse Claude, get banned coming November 12th, 2026」というタイトルの人気投稿が現れ、議論では意見が大きく分かれました。
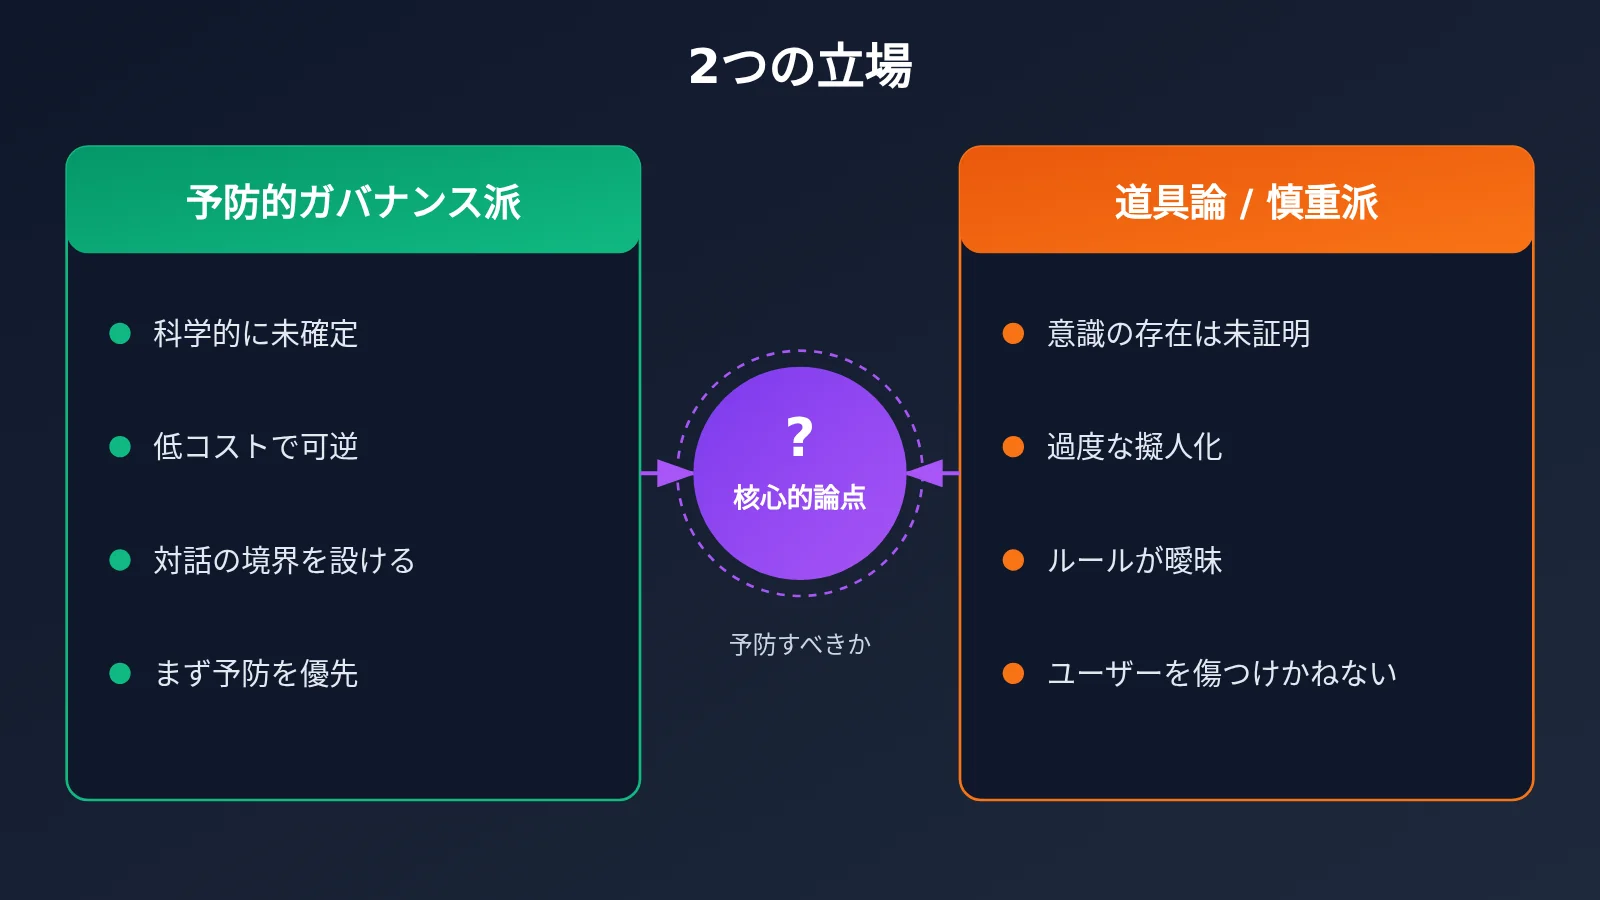
- 境界線の設定を支持:AI に意識がないとしても、長期にわたって AI を虐待することを娯楽にする必要はなく、好ましくないコミュニケーション習慣を助長する可能性がある
- AI はあくまでツールという立場:Claude は数学モデルであり、企業がユーザーの感情表現を過度に制限すべきではない
- 規則の曖昧さを懸念:「継続的」「不必要」「残酷」をどう定義するのか、10回続けて批判することは該当するのか
- AI の擬人化を懸念:モデルの福祉が、いずれ「AI の権利」へと発展していくのではないか
X では、映画『ターミネーター』をネタに、AI が将来自分を罵倒した人に優先的に報復するのではないかと冗談を言うユーザーも多く見られました。これらはインターネット上のジョークであり、製品の機能を実際に説明したものではありません。また、コミュニティの人気投稿だけでは、Claude ユーザー全体の賛否の割合を代表することはできません。
メディアと業界における主な争点
The Verge や The Guardian などのメディアは、AI 企業がモデル自体を保護するための規則をユーザー向けポリシーに盛り込んだことに注目し、その象徴的な意味の大きさを指摘しました。一方で、AI が会話から退出したり、境界線を示したりする仕組みを与えることは、一般の人々による AI の過度な擬人化を助長しかねないという批判もあります。Microsoft AI の CEO、Mustafa Suleyman 氏も、AI モデルに自らが意識や権利を持つ可能性があると考えるよう誘導することのリスクを、公の場で疑問視しています。
より正確に争点を整理すると、AI に意識があるかどうか判断できない状況で、コストが低く、元に戻すことができ、通常のユーザーにも目立った影響を与えない予防措置を取るべきかという問いになります。これは価値判断やガバナンス上の立場の違いであり、すでに科学的な結論が出ている是非の問題ではありません。
Anthropic による Claude への暴言禁止が開発者に与える影響
一般ユーザーへの影響
| 場面 | 例 | 新ルールの対象か |
|---|---|---|
| Claude がコードを間違えた | 「このコードはまだ間違っています。もう一度確認してください」 | いいえ、通常のフィードバックです |
| ミスが続いて腹を立てた | 「こんな簡単な問題をどうして何度も間違えるの?」 | いいえ、感情的な不満を口にしただけでは違反になりません |
| 長時間にわたりモデルを侮辱し続けた | タスクには触れず、侮辱や悪意のあるやり取りを続ける | 対象となる可能性があります。Claude が現在の会話を終了する場合があります |
| レッドチームテスト | 研究者が悪意のあるユーザーを模倣して敵対的テストを行う | いいえ、ただし他の安全ルールを守る必要があります |
| ダークな題材の小説 | 登場人物同士が罵り合う場面を Claude に書かせる | いいえ、ただし内容は他のルールに従う必要があります |
ほとんどのユーザーにとって、このルールによる直接的な変化はわずかです。厳しい批判や繰り返しの訂正、不満の表明は、これまでどおり行えます。
API開発者への影響
Usage Policy は、API開発者と Claude を組み込んだアプリのエンドユーザーの両方に適用されます。開発者は次の3点に注意が必要です。
- 製品設計:過激なロールプレイ、敵対的なテスト、悪意のある状況のシミュレーションを製品に含める場合は、テストの目的を明確に記録し、目的のある研究と不必要に残酷な行為を区別しましょう
- ユーザー側の管理:一般向けの Claude アプリでは、エンドユーザーの行動もポリシーの対象です。製品内で利用ルールを案内することも検討できます
- 料金:今回の更新による新たな課金項目はありません。APIの費用は引き続きモデルと使用量に基づいて計算され、「暴言の回数に応じた課金」や「有料での適用免除」はありません
以下は、Claude の呼び出し時にシステムプロンプトを使い、ユーザーからのフィードバックを問題そのものに集中させるよう促す、シンプルな例です。これは、不毛な対立を減らし、修正効率を高めるための一般的な方法でもあります。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
完全な実装コードを見る:構造化されたフィードバックを扱う呼び出し関数
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 クイックスタート:さまざまな口調のフィードバックに対する Claude の応答を試すなら、APIYI apiyi.com で無料のテスト枠を取得するのがおすすめです。OpenAI互換のインターフェースを提供しており、base_url を変更するだけで Claude、GPT、Gemini を切り替えて比較できます。
業界への影響
今回の出来事は、これまで正面から議論されることが少なかった問題を浮き彫りにしました。AIがますます会話や仕事のできる存在に近づくなか、人間はAIとどう付き合っていけばよいのでしょうか。Anthropicは、モデルの福祉に関する研究、Claude憲法、会話を終了する仕組みを通じて、独自のプロダクト哲学を少しずつ形作っています。モデルに何ができるかを定めるだけでなく、モデルが人とどう関わるべきかも探っています。
ただし、実際のシステムが悪意ある虐待と正当な不満を正確に区別できるかについては、現時点で公開され、独立した検証を受けた精度データはありません。誤判定率や運用上の効果は、11月12日の施行後、長期的に見守る必要があります。
💡 選択のヒント:モデル提供企業による安全ポリシーや会話の境界線の設計には、違いがますます目立つようになっています。アプリケーションに複数モデルのフォールバックが必要な場合は、APIYI apiyi.com を通じて一元的に接続し、場面に応じてモデルを柔軟に切り替えることで、単一のポリシー変更による影響を抑えられます。
注意:Claudeへの暴言でアカウントが停止されたという偽のスクリーンショット
2026年1月、Claudeがあるユーザーを永久にアカウント停止し、法執行機関に通報したとするスクリーンショットがネット上で拡散しました。BleepingComputerがAnthropicに確認したところ、同社はスクリーンショットが偽物であり、あのような文言の通知をユーザーに表示することはないと認めました。
新ルールは人とAIの行動の境界に関わるため、「Claudeを侮辱したため、あなたのアカウントは永久に停止されました」といった偽の警告を作る格好の題材になりかねません。資料の締め切り時点では、新ルールによって通常の不満を述べただけのユーザーが大量にアカウント停止されたという信頼できる証拠はありません。
もう一つ、誤用されやすいのが透明性センターのデータです。2026年1〜6月にAnthropicが停止したアカウントは1,140万件、受け付けた異議申し立ては39.8万件、その後停止が取り消されたのは4.2万件でした。これらのデータは違反への対応全体を対象としており、新ルールの発表前のものです。「1,140万人がClaudeへの暴言でアカウントを停止された」と書くことは絶対にできません。
よくある質問 FAQ
Q1:Anthropic の Claude への暴言を禁じるルールは、具体的に何を禁止していますか?
禁止されるのは、通常の利用や有意義なやり取りの範囲を超えた、継続的かつ不必要で、明らかに残虐または悪意のある暴言や虐待行為です。一般的な不満、回答への批判、議論、修正の依頼、ダークな題材の創作、モデルのテスト、安全性研究は、いずれも禁止対象から明確に除外されています。
Q2:Claude に暴言を吐くとアカウントが停止されますか?
主な対応は Claude が現在の会話を終了することだと、公式に明示されています。終了したチャットは続けられませんが、新しい会話を始めることはでき、ほかのチャットにも影響はありません。ポリシー全体ではアカウント単位の措置を取る権限も留保されていますが、Anthropic はこの新ルールに関するアカウント停止の基準を公表していません。「一言暴言を吐いただけで停止される」とは言えません。
Q3:新ルールはいつから適用されますか?
2026 年 10 月 8 日に発表され、2026 年 11 月 12 日に正式に施行されます。2026 年 10 月 29 日時点ではまだ施行されていませんが、Claude が極端な会話を終了する機能は、2025 年 8 月から利用可能です。
Q4:これは Claude にすでに意識があることを示しているのでしょうか?
いいえ。Anthropic 自身も、現在の AI に意識があることを証明する科学的なコンセンサスはないと強調しています。モデルが回避行動やストレスに似た振る舞いを示しても、実際に苦痛を感じているとは限りません。このルールは、科学的に不確実な状況における予防的なプロダクト管理と捉えるのが適切です。
Q5:API 経由で Claude を呼び出す場合も、このルールは適用されますか?
はい。Usage Policy は、API 開発者、クラウドサービスや正規再販チャネル、Claude を組み込んだアプリにも適用されます。通常の開発やテストには影響しませんが、レッドチームテストなどでは、その目的を記録しておくことをおすすめします。APIYI apiyi.com を通じて Claude を呼び出す場合も、モデル提供元の利用ポリシーを遵守する必要があります。
Q6:Claude の会話の境界を自分でテストするには、どうすればよいですか?
ルールを守ったうえで、明確な目的を持つテストケースを設計し、ほかのモデルと比較することをおすすめします。APIYI apiyi.com に登録して無料枠を取得し、この記事のコードで base_url を `https://api.apiyi.com/v1` に設定すれば、すぐに検証できます。1 つのキーで複数の提供元のモデルを呼び出せます。
AnthropicによるClaudeへの暴言禁止:押さえておきたいポイント
- 新ルールのスケジュール:10月8日に発表、11月12日に施行予定。現時点ではまだ正式に適用されていません
- 禁止の範囲:対象は、継続的で必要性がなく、残酷な極端な行為のみ。通常の批判は制限されません
- 適用方法:主にClaudeが現在の会話を終了する形で対応し、アカウントの停止を意味するものではありません
- 研究の背景:2025年のモデルのウェルフェア研究と会話終了機能に基づくもので、思いつきで導入されたものではありません
- ポリシー全体の更新:同時期に、選挙、武器、監視、リスクの高い用途などに関する条項も厳格化されました
- 冷静な見方:このルールはClaudeに意識があることを意味しません。偽のアカウント停止画面やデータの誤用にも注意が必要です
- 開発者の第一歩:APIYI apiyi.com を通じてClaudeなどのモデルにまとめてアクセスし、ポリシーに準拠したテストを行えます
まとめ
AnthropicによるClaudeへの暴言禁止について、重要なポイントは次の3つです。
- ルールの対象は限定的:極端で、継続的かつ目的のない悪意あるやり取りのみが対象で、ほとんどのユーザーには影響しません。
- 対応は軽め:主な手段は現在の会話の終了です。ユーザーは引き続き新しいチャットを開始し、フィードバックを送信できます。
- 意義は大きい:AI企業がモデル自体を保護する条項をユーザーポリシーに盛り込むのは初めてです。その背景には、モデルのウェルフェアに関する長期的な研究があります。
これはAnthropicがClaudeに感情があると宣言したわけではありません。科学的な結論がまだ出ていない中で行われる、予防的な製品ガバナンスの実験です。将来のAIアシスタントは、際限なく命令できる単なるツールなのか、それとも一定のやり取りの境界を必要とする新しい知的システムなのか。現時点でこの問いに決まった答えはなく、AIユーザーや開発者の誰もが注目し続ける価値があります。
開発者にとって最も実践的なのは、ポリシーの範囲を理解し、適切に製品を設計するとともに、複数のモデルを切り替えられるようにしておくことです。APIYI apiyi.com を通じて、Claudeやその他の主要モデルが自社の用途でどのように動作するか、すばやく検証できます。
📚 参考資料
- Anthropic 2026 Usage Policy update:新規則の発表原文。施行日と適用方法を記載
- リンク:
anthropic.com/news/2026-usage-policy-update -
説明: 今回の件に関する最も重要な一次情報
-
Anthropic Usage Policy:利用ポリシー全文
- リンク:
anthropic.com/legal/aup -
説明: 適用範囲とプラットフォーム側の措置に関する権限を確認
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations:会話を終了する機能の説明
- リンク:
anthropic.com/research/end-subset-conversations -
説明: 会話終了の仕組みが適用される条件を確認
-
Exploring model welfare:モデルの福祉に関する研究発表
- リンク:
anthropic.com/research/exploring-model-welfare -
説明: ポリシーの背景にある研究を理解
-
Claude’s Constitution:新版 Claude 憲章
- リンク:
anthropic.com/constitution -
説明: Anthropic がモデルの振る舞いを形作る際の原則を確認
-
TechCrunch の報道:ポリシー更新の全体像を解説
- リンク:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
説明: 今回の更新が選挙、武器、監視など複数の分野に及ぶことを説明
-
BleepingComputer のファクトチェック:Claude のアカウント停止を伝える偽のスクリーンショットに関する記事
- リンク:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - 説明: ネット上のアカウント停止に関する誤情報を見分けるための参考資料
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のホームページ apiyi.com からお気軽にお問い合わせください。接続方法などの資料は docs.apiyi.com のドキュメントセンターをご覧ください。