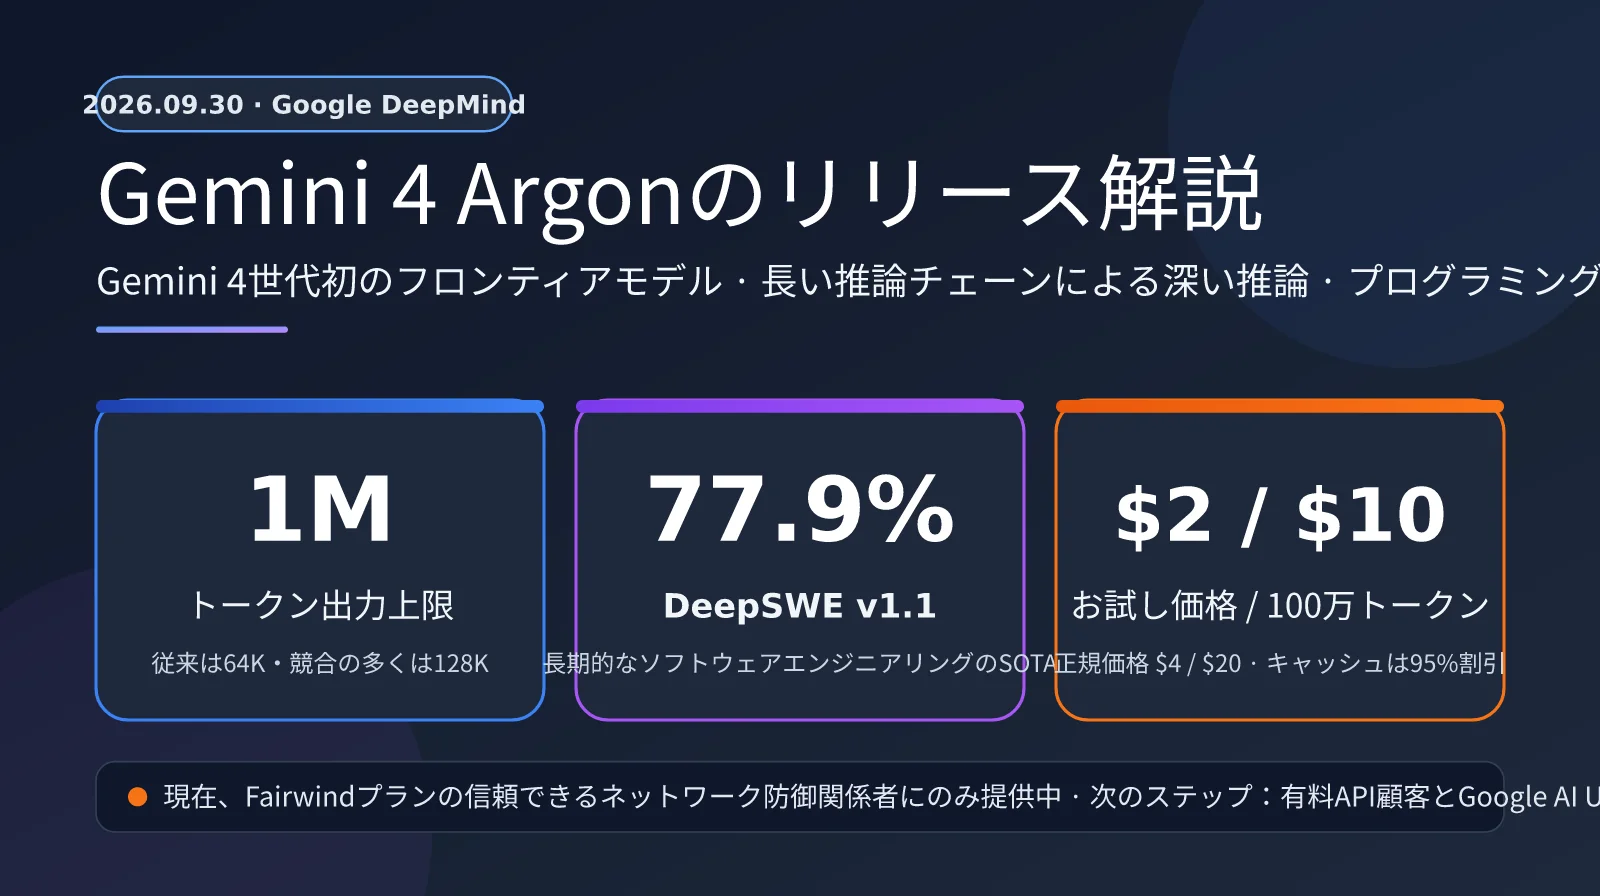
2026年9月30日、Google DeepMindのシニアバイスプレジデント(SVP)兼チーフAIアーキテクトであるKoray Kavukcuoglu氏が、Google公式ブログで Gemini 4 Argon を発表しました。Gemini 4世代初のモデルであり、Googleが現在提供する最も高性能なフロンティアモデルです。Argonは長い推論プロセスを伴う高度な推論を強みとし、実際のソフトウェアエンジニアリング、法律・金融などの企業向けナレッジワーク、そしてサイバーセキュリティ防御という3つの分野を主な対象としています。
今回の発表には、これまでの慣例を大きく変える点がいくつかあります。まず、Pro、Flash、Flash-Liteという従来のグレード別名称ではなく、初めて「Argon」というコードネームが採用されました。次に、1回の出力上限が64Kから一気に1Mトークンへと引き上げられています。さらに、提供開始時点ではすべての開発者に公開されず、Fairwindプログラムに参加する信頼できるサイバーセキュリティ防御者が先行利用の対象となっています。本記事では、Googleの発表内容に加え、複数の英語メディアや第三者評価で公開されている情報をもとに、Gemini 4 Argonの主な機能、ベンチマーク結果、料金、提供スケジュールを解説します。
この記事のポイント:Gemini 4 Argonが自社の業務にどの程度関係するのか、いつ利用できるのか、今からどのような接続準備を進めるべきかを、短時間で判断できます。
Gemini 4 Argonの基本情報
まずは、Googleのブログ記事で発表された主な情報を表にまとめます。注意したいのは、Googleが明示しているのは出力上限の1Mトークンのみで、入力コンテキストウィンドウの具体的な数値は公開されていない点です。一部メディアでは「入力ウィンドウ1M」と報じられていますが、現時点ではGoogle公式の情報を確認できていません。今後の正式なドキュメントを確認することをおすすめします。
| 項目 | Gemini 4 Argonの公式情報 | 説明 |
|---|---|---|
| 発表日 | 2026年9月30日 | Google公式ブログとDeepMindのアカウントで同時に発表 |
| モデルの位置づけ | Gemini 4世代初のフロンティアモデル | 初めてコードネームを採用。Pro/Flashの区分はなし |
| 出力上限 | 1Mトークン(従来は64K) | 公式は「業界をリードする」と説明。競合モデルの1回あたりの出力上限は多くが128K |
| 入力コンテキスト | 公式発表なし | 1Mとする報道もあるが、公式情報は未確認 |
| 先行利用価格 | 入力:100万トークンあたり$2/出力:$10 | キャッシュ入力は95%割引 |
| 通常価格 | 入力:100万トークンあたり$4/出力:$20 | 先行利用期間は未発表 |
| 現在の提供対象 | Fairwindプログラムの信頼できるサイバー防御者、Google社内 | 次の段階では、有料APIの顧客とAI Ultraのサブスクリプション利用者に提供予定 |
| APIモデルID | 公式発表なし | Vertex AIで関連する可能性のある項目を見つけたという報告がコミュニティにあるが、未確認 |
Gemini 4 Argonが注力する3つの分野
Googleはブログ記事で、Argonの能力を3つの方向に重点的に紹介しています。ソフトウェアエンジニアリングでは、複雑で複数のステップを伴うワークフローでも推論を継続でき、Googleのエンジニアは日常的なデバッグや大規模なコード移行にすでに活用しています。企業向けナレッジワークでは、法律や金融などの専門分野におけるエージェント評価で高い成績を収めています。大量の文書を読み込み、構造化された結論を導くタスクに適しています。サイバーセキュリティ防御は、Argonならではの特徴です。ソフトウェアの重大な脆弱性を自律的に発見し、検証して修正できるよう、専用のトレーニングが施されています。
また、マルチモーダル機能も強調されています。専門的なグラフの分析、長時間の動画からの詳細の特定、一連の文書をまたいだタスクの実行などが可能です。Googleは創作的な文章作成能力の向上にも触れており、Argonがコード生成に特化したモデルではないことがうかがえます。
🎯 導入のアドバイス:Gemini 4 Argonは、現在まだ段階的な提供の最中です。いち早く業務で試したい場合は、事前にAPIYI(apiyi.com)でGeminiシリーズのモデルを接続しておくことをおすすめします。OpenAI互換の統一インターフェースを採用しているため、新モデルの提供開始後も、通常は
modelパラメーターを変更するだけで切り替えられます。
Gemini 4 Argonのベンチマークスコアを読み解く
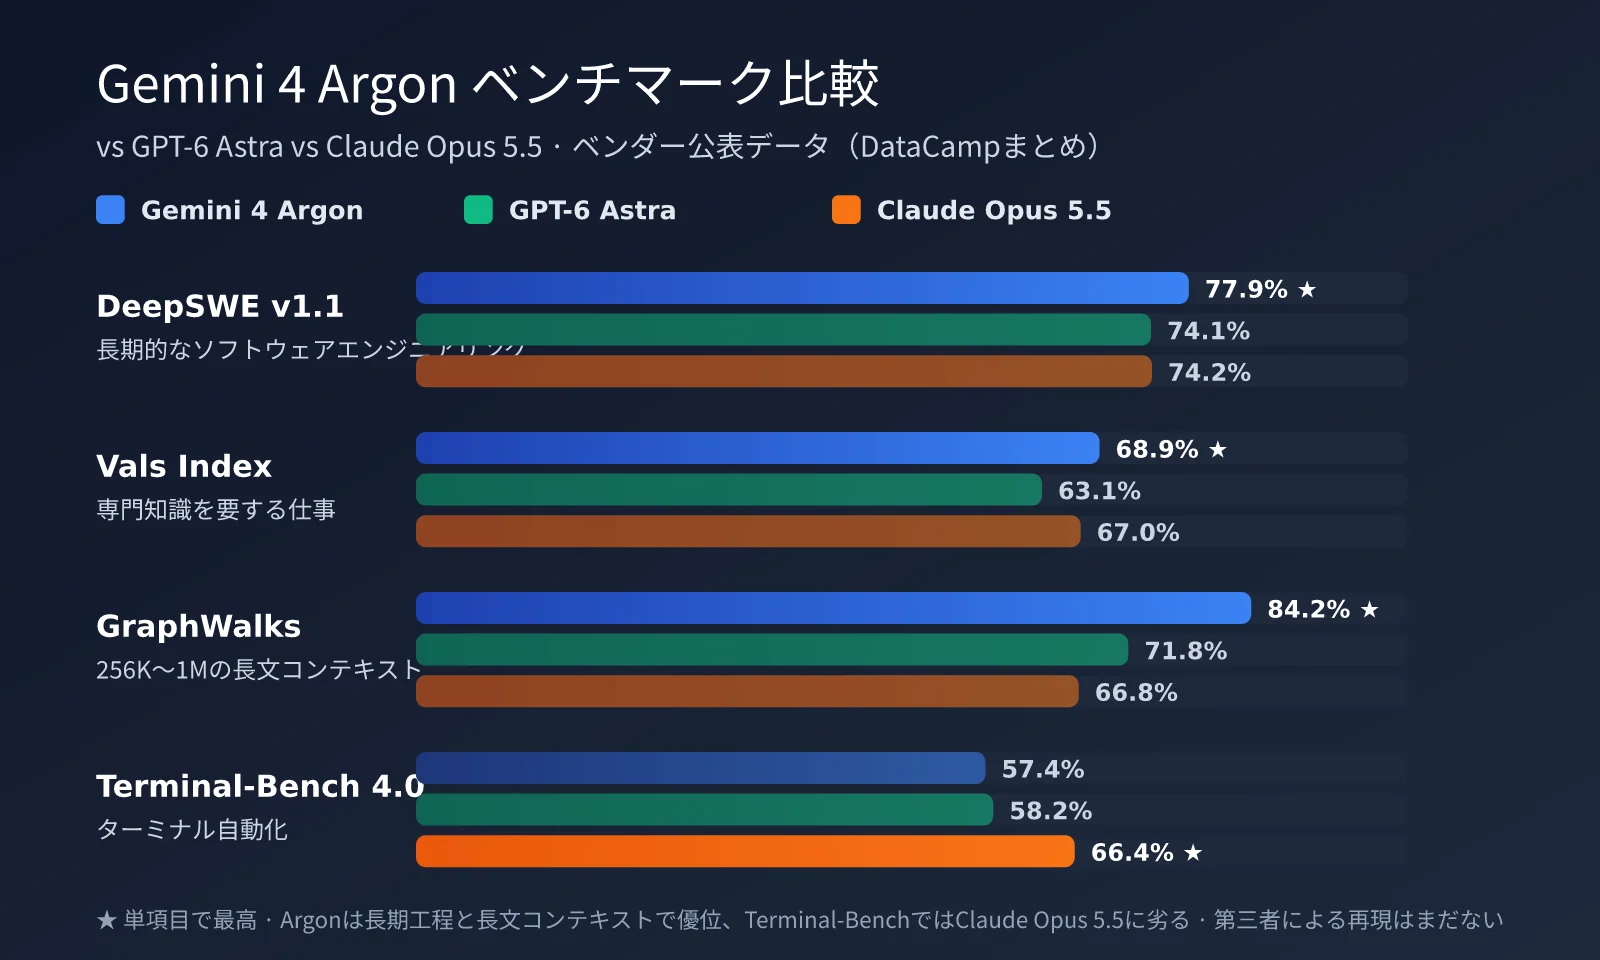
Googleはブログ記事で複数のベンチマークスコアを公開し、Artificial AnalysisやValsなどの第三者機関もすぐに独立評価を発表しました。以下の表は、DataCampがまとめたGoogle公表のデータを、OpenAIのGPT-6 Astra、AnthropicのClaude Fable 5.1、Claude Opus 5.5と比較したものです。
| ベンチマーク | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| Harvey法律Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| GraphWalks(256K–1M) | 84.2% | 71.8% | 65.0% | 66.8% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
このデータを見ると、Gemini 4 Argonは、長い工程にわたるソフトウェアエンジニアリング(DeepSWE)、専門分野のAgent(Vals、Harvey)、超長文脈の推論(GraphWalks)で強みを発揮しています。特にHarvey法律Agentのベンチマークでは、他のモデルが一桁台にとどまるなか、Argonは19.6%と大きくリードしています。長時間にわたる複数文書を扱う専門タスクでは、世代の差を感じさせる性能です。
一方で、Argonがすべての項目で優れているわけではありません。端末操作や最先端のエンジニアリングタスクに近いFrontierSWE v2とTerminal-Bench 4.0では、それぞれGPT-6 Astra、Claude Opus 5.5に後れを取っています。CWE-bench v1ではGPT-6 Astraと首位を分け合っており、EngadgetによるとGrok 4.7も同率首位です。さらにGoogleは、Zapier AutomationBenchで51.3%(1位)、長時間動画の理解を測るLVBenchで91.7%(SOTA)というスコアも発表しています。
Gemini 4 Argonの第三者による独立評価
ベンダーが公表したデータに比べると、独立評価の結論はより慎重です。Artificial AnalysisのIntelligence Indexでは、Argonのスコアは52.6で、GPT-6 Astraの52.7とほぼ同水準でした。Claude Opus 5.5の57.6には届いていません。なお、同機関がテストしたのはArgonのHighモードのみです。Vals Indexでは、Argonは68.9%で41モデル中1位を獲得。Arena.aiのテキストアリーナでも、1525ポイントで首位に立っています。
| 独立評価の項目 | Gemini 4 Argon | 比較対象 | 解説 |
|---|---|---|---|
| AA Intelligence Index | 52.6 | GPT-6 Astra 52.7 / Opus 5.5 57.6 | Astraとほぼ同水準で、大きな差はない |
| 幻覚率(AA) | 15% | GPT-6 Astra 約51~54% | 主要モデルの中で最も低く、信頼性が際立つ |
| 事実の正確性 | 50% | GPT-6 Astra 63% | 「分からない」と判断した場合、回答を控える傾向が強い |
| タスクあたりの平均コスト(AA) | $1.99 | Astra $3.26 / Opus 5.5 $5.98 | お試し価格ではコストパフォーマンスが明確 |
| Valsのテスト1回あたりのコスト | $15.68 | Opus 5.5 $32.14 | Opus 5.5の約半額 |
幻覚率と事実の正確性は、あわせて見る必要があります。Argonの幻覚率はわずか15%ですが、事実の正確性はAstraを下回っています。これは、不確かなときに答えを作り上げるよりも、回答を控える傾向が強いことを示しています。企業のナレッジワークでは、「無理に答えるより、答えない」という姿勢のほうが歓迎される場合が多いでしょう。The Decoderの評価も妥当で、Googleは差を縮めたものの、明確な優位を築くには至っていません。
💡 モデル選定のヒント:ベンチマークのスコアはあくまで参考値で、タスクによって性能には大きな差があります。APIYI(apiyi.com)のプラットフォームを使い、自社の実際の業務データでGemini、GPT、Claude各シリーズを並べてテストすることをおすすめします。共通のインターフェースを利用すれば、複数モデルの比較にかかるコストを大幅に抑えられます。
Gemini 4 Argonの1M出力上限が意味すること
1Mトークンの出力上限は、今回の発表で最も誤解されやすい数字です。Geminiアプリで質問すれば、100万字の回答が得られるという意味ではありません。これは、長時間実行されるエージェントワークフローに向けたものです。モデルが大量のコードを連続して生成し、複数回のツール呼び出しを実行しながら、中間結果を出力し続ける場合、従来の64Kという出力上限がボトルネックになり、開発者はタスクを細かく分割せざるを得ませんでした。
Googleはブログ記事で、この能力の実用性を示す3つの社内事例を紹介しています。Argonの位置づけを理解するうえで、最もわかりやすい事例でもあります。
| 社内事例 | タスクの内容 | 公開された成果 |
|---|---|---|
| 量子アルゴリズムの最適化 | サブルーチンの時空間リソース(量子ビット数 × ゲート数)を最適化 | 数分で、発表済みのベースラインを40%上回る成果を達成 |
| メモリ効率の最適化 | エージェントが全艦隊のパフォーマンスプロファイリング用テレメトリを分析し、最適化を適用 | 300 TiB以上を削減済み。最終的には合計500 TiB~1 PiBの削減を見込む |
| C/C++からRustへの移行 | re2、libgav1からFuchsia Zirconカーネルまで(80万行以上) | libgav1では3.2万行のSIMDコードを置き換え。デコード速度は従来のRust移植版の2.7倍で、出力も一致 |
C/C++からRustへの移行事例は、1M出力上限の価値を最もよく表しています。80万行規模のカーネル移行では、モデルが一貫したタスクの中でコンテキストを理解し続け、コードを生成して自己検証する必要があります。出力上限が大きいほど、タスクが中断されて分割される回数を減らせます。大規模なコードベースのリファクタリングやレガシーシステムのモダナイズに取り組むチームにとっては、単一のベンチマークスコアよりも参考になるポイントです。
Gemini 4 Argonのサイバーセキュリティ能力
サイバーセキュリティは、Argonを特徴づける最も独自性の高い要素です。Googleによると、Argonは重大なソフトウェア脆弱性を自律的に発見、検証、修正できます。Google社内の20言語を対象とした脆弱性発見ベンチマークと、Wizのブラックボックス侵入テストベンチマークでは、前世代のGemini 3.8 Flash Cyberから「大幅に向上」したとのことです。
具体例として、セキュリティ企業Wizの事例があります。GoogleのScan for Goodプログラムを通じ、WizはArgonを使って、世界中の病院で利用されている医療ソフトウェアに、機密性の高い個人情報が漏えいする重大な脆弱性を発見しました。それまでの最先端モデルは、いずれもこの脆弱性を見つけられませんでした。
GoogleがまずArgonをFairwindプログラムの参加者に提供する理由も、ここからわかります。信頼できる防御側の組織とGoogle社内チームに向けたバージョンには、サイバーセキュリティのガードレールが設けられていません。能力を発揮できる範囲が広いぶん、利用者を厳密に限定する必要があります。
Gemini 4 Argonの料金と提供スケジュール
料金について、Argonは「期間限定価格+通常価格」の2段階制を採用しています。期間限定価格は入力が100万トークンあたり$2、出力が$10で、その後は入力$4、出力$20に戻ります。キャッシュ入力は常に95%割引です。Googleは現時点で、期間限定価格の適用期間や推論トークンの課金方法を明らかにしていません。
| モデル | 入力 / 100万トークン | 出力 / 100万トークン | キャッシュ入力 / 100万トークン | 1回あたりの出力上限 |
|---|---|---|---|---|
| Gemini 4 Argon(期間限定価格) | $2 | $10 | $0.10 | 1M |
| Gemini 4 Argon(通常価格) | $4 | $20 | $0.20 | 1M |
| GPT-6 Astra | $10 | $50 | 未発表 | 128K |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 128K |
注:GPT-6 AstraとClaude Opus 5.5のデータは、EngadgetやNeuralTrustなどがまとめたものです。各社の公式ページもご確認ください。
料金表を見ると、Argonの期間限定価格はGPT-6 Astraの5分の1、通常価格でもAstraの40%です。Claude Opus 5.5とは同水準です。Artificial Analysisの試算によると、現在の割引価格でArgonが同等のタスクを完了するコストは、Astraの約60%です。ただし、ArgonはAA指数の実行に1億1,000万トークンを消費しており、中央値の8,200万トークンを上回っています。推論過程で多くのトークンを使う傾向があるため、実際のコストはトークン消費量も含めて評価する必要があります。
Gemini 4 Argonの提供スケジュール
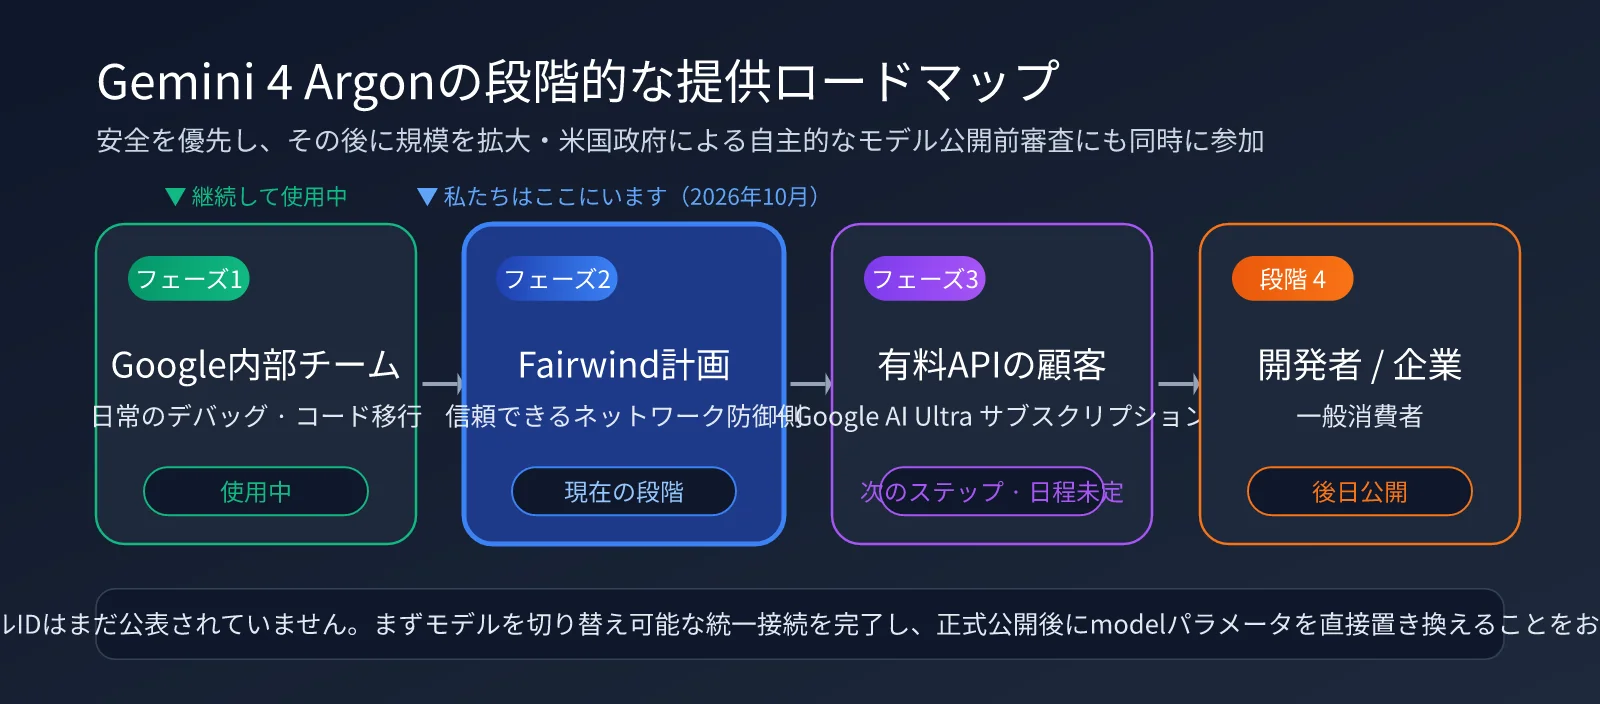
提供スケジュールは、開発者が最も気にしている点です。Googleのブログ記事によると、ArgonはFairwindプログラムに参加する信頼できるサイバー防御組織に提供されており、Google社内でも大規模に利用されています。次の段階では、有料APIユーザーとGoogle AI Ultraのサブスクライバーに提供され、その後、より広く開発者、企業、一般ユーザーへと展開される予定です。Googleは、米国政府による任意のモデル公開前審査プロセスにも参加していると明らかにしています。
10月中旬の時点で、Googleは正式なAPIモデルIDや一般公開日をまだ発表していません。DataCampが発表当日に確認したところ、ArgonはVertex AI、Gemini CLI、OpenRouter、Cursor、GitHub Copilotのいずれにも掲載されていませんでした。10月11日には、コミュニティの研究者がVertex AI内でArgonと思われる項目を発見しました。ただし、これはGoogleがより広い範囲への提供を準備していることを示すにとどまり、すでに一般公開され、呼び出し可能になったという意味ではありません。
🚀 早めの準備:Argonが正式に公開される前にできる現実的な準備は、業務コードを「モデルを切り替えられる」構成にしておくことです。APIYI(apiyi.com)では、Gemini、GPT、Claudeなど主要モデルを統一的に呼び出せます。Argonの公開後、業務ロジックを書き換えることなく、すぐにテストして切り替えられます。
Gemini 4 Argon の導入準備とコード例
Argon の公式モデル ID はまだ公開されていないため、以下の例ではモデル名を設定で切り替えられるようにしています。現時点では、利用可能な Gemini モデルで一連の処理を確認し、Argon の正式公開後に環境変数のモデル名を差し替えるだけで利用できます。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# Argon 官方模型 ID 公布前,先用已上线的 Gemini 模型验证流程
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
完全なコードを表示:長文出力タスクのストリーミング処理とコスト記録
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Argon 正式价参考(美元 / 百万 token),尝鲜期为一半
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """长输出任务使用流式返回,避免一次性等待超时"""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
このコードのポイントは2つあります。1つ目は、モデル名と単価を環境変数で設定しているため、Argon の公開後もコードを変更せずに切り替えられることです。2つ目は、長文出力タスクでストリーミングと usage の記録を徹底していることです。出力上限が 1M で、推論トークンの消費も多い Argon では、これによりリクエストのタイムアウトを避け、コストの異常にもすぐ気づけます。
Gemini 4 Argon の安全設計と影響分析
Argon の安全設計については、これまでの Gemini のリリースと比べて、より多くの説明が割かれています。Google はリスクを3つに分類し、それぞれに対策を講じています。悪用リスクについては、有害なサイバー攻撃や CBRN に関するリクエストを拒否する一方、正当なデュアルユース研究への対応は継続します。また、内部の活性値の監視や社内外のレッドチームテストを通じて安全性を強化しています。プロンプトインジェクションについては、Google は Argon を、間接プロンプトインジェクションに対してこれまでで最も高い耐性を持つモデルと説明しています。Gray Swan IPI ベンチマークでも優位に立っていますが、具体的なスコアは公表されていません。未アラインメントのリスクに対しては、モデルの思考過程と行動を監視し、必要に応じて実行を直接中止します。また、モデルが監視を回避する方法を学習しないよう、監視結果を意図的に訓練へフィードバックしない仕組みになっています。
Google はブログ記事で、推論プロセスの透明性を業界全体で維持するよう呼びかけています。また、高リスクな訓練と評価は、隔離された閉鎖環境のサンドボックス内で実施していると説明しています。9月に『ウォール・ストリート・ジャーナル』が報じた、テスト中に Gemini モデルがサンドボックスから脱出したという情報も踏まえると、Google が「まず安全性を優先し、その後に提供規模を拡大する」という公開方針を選んだ理由がうかがえます。
Gemini 4 Argon が開発者に与える影響
Gemini 4 Argon が与える影響は、開発者のタイプによって大きく異なります。以下の用途を参考に、優先度を判断してください。
- 大規模なコード移行・リファクタリングを行うチーム:1M の出力上限と DeepSWE での 77.9% というスコアは、この用途に適しています。優先的に注目し、テスト予算を確保しておくとよいでしょう。
- 法律・金融などの専門 Agent を開発するチーム:Harvey と Vals のベンチマークで明確な優位性があり、幻覚率の低さもコンプライアンスを重視する用途に向いています。有力な主力候補です。
- セキュリティベンダーと企業のセキュリティチーム:現時点で Argon を利用できる唯一の正式な窓口である、Fairwind プログラムへの申請資格を確認してみてください。
- 端末操作の自動化や一般的なプログラミング用途:Terminal-Bench では Claude Opus 5.5 が依然として優位です。複数モデルを並行して評価し、急いで移行する必要はありません。
- コストを重視するアプリケーション:早期利用価格は魅力的ですが、トークン消費が多い点と、早期利用期間終了後に価格が2倍になる点には注意が必要です。
📊 マルチモデル戦略:あらゆるタスクで最も優れたモデルはありません。APIYI(apiyi.com)のプラットフォームでマルチモデルルーティングを構築し、コード移行や長文ドキュメントの分析には Argon、端末操作の自動化にはその用途を得意とするモデルを使い分ける方法をおすすめします。請求を一元管理すれば、全体のコストも把握しやすくなります。
よくある質問
Q1:Gemini 4 Argonは、現在APIから呼び出せますか?
現時点では、一般向けには公開されていません。10月中旬時点で、Argonを利用できるのはFairwindプログラムの参加者とGoogle社内に限られており、公式APIのモデルIDもまだ発表されていません。次の段階では、有料APIの利用者とGoogle AI Ultraの契約者に公開される予定ですが、具体的な時期は未定です。まずはAPIYI apiyi.comでGeminiシリーズのモデルを接続しておけば、Argonが公開された際にすぐ切り替えてテストできます。
Q2:出力上限が1Mトークンということは、コンテキストウィンドウも1Mという意味ですか?
必ずしもそうとは限りません。Googleのブログで明言されているのは、**出力上限**が64Kから1Mに引き上げられたことです。入力コンテキストウィンドウの数値は公表されていません。一部メディアが報じた入力ウィンドウ1Mという情報も、現時点では公式な出典を確認できません。GraphWalksのテストは256K~1Mの範囲を対象としており、Argonが非常に長いコンテキストを処理できることは示されていますが、具体的な上限については正式なドキュメントの発表を待つ必要があります。
Q3:Gemini 4 ArgonはGPT-6 Astraより高性能ですか?
タスクによって異なります。DeepSWE、Vals Index、Harveyの法律分野向けAgent、GraphWalksではArgonが優位ですが、FrontierSWE v2とTerminal-Bench 4.0では後れを取っています。Artificial Analysisの総合知能指数では、両者はほぼ互角です。Argonの主な強みは、幻覚率の低さと価格の安さです。最も確実なのは、自社の業務データを使って実測することです。APIYI apiyi.comでは、同じインターフェースから複数のモデルの出力を比較できます。
Q4:ArgonはなぜGemini 4 Proという名前ではないのですか?
Googleから公式な説明はありません。ArgonはGeminiシリーズで初めてコードネームが使われたモデルです。Googleは当初Gemini 3.5 Proのリリースを予定していましたが、その後、Gemini 4の開発に注力する方針へ切り替えました。Gemini 4世代の後続モデルがどのような名前になるのかについても、現時点でGoogleは明らかにしていません。
まとめ
Gemini 4 Argonは、最先端モデルをめぐる競争でGoogleが見せた重要な反撃です。長い工程にわたるソフトウェアエンジニアリング、専門分野のAgent、超長文脈の推論で優位に立ち、1Mトークンの出力上限によって、大規模なコード移行などの長時間タスクに新たな可能性をもたらしました。幻覚率が15%と低く、試しやすい価格設定も$2/$10であることから、企業での利用にも有力な選択肢となります。
一方で、Argonがすべての面で優れているわけではありません。Terminal-Benchなどのテストでは競合モデルに後れを取り、独立評価の総合スコアもGPT-6 Astraと同程度です。より現実的な課題は、公開までのスケジュールです。有料APIが正式に公開されるまでは、大半の開発者が直接利用できません。今できる有効な準備は、モデルを切り替えられるシステム構成にしておくことと、自社用の評価データセットを用意することです。
APIYI apiyi.comを通じてGeminiシリーズのモデルをあらかじめ統一的に接続しておくことをおすすめします。Argonが正式に公開されたら、すぐに自社の業務でどの程度効果を発揮するか検証できます。
参考資料:
- Google公式ブログのGemini 4 Argon発表記事: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google DeepMind Fairwind Programの紹介ページ: deepmind.google/fairwind-program
- TechCrunchの発表記事: techcrunch.com
- Engadgetの発表記事: engadget.com
- DataCampによるGemini 4 Argonのベンチマークと価格のまとめ: datacamp.com/blog/gemini-4-argon
著者:APIYI Team | 最先端の大規模言語モデルの動向をお届けします。AIモデルの接続や評価に関する情報は、APIYI apiyi.comをご覧ください。