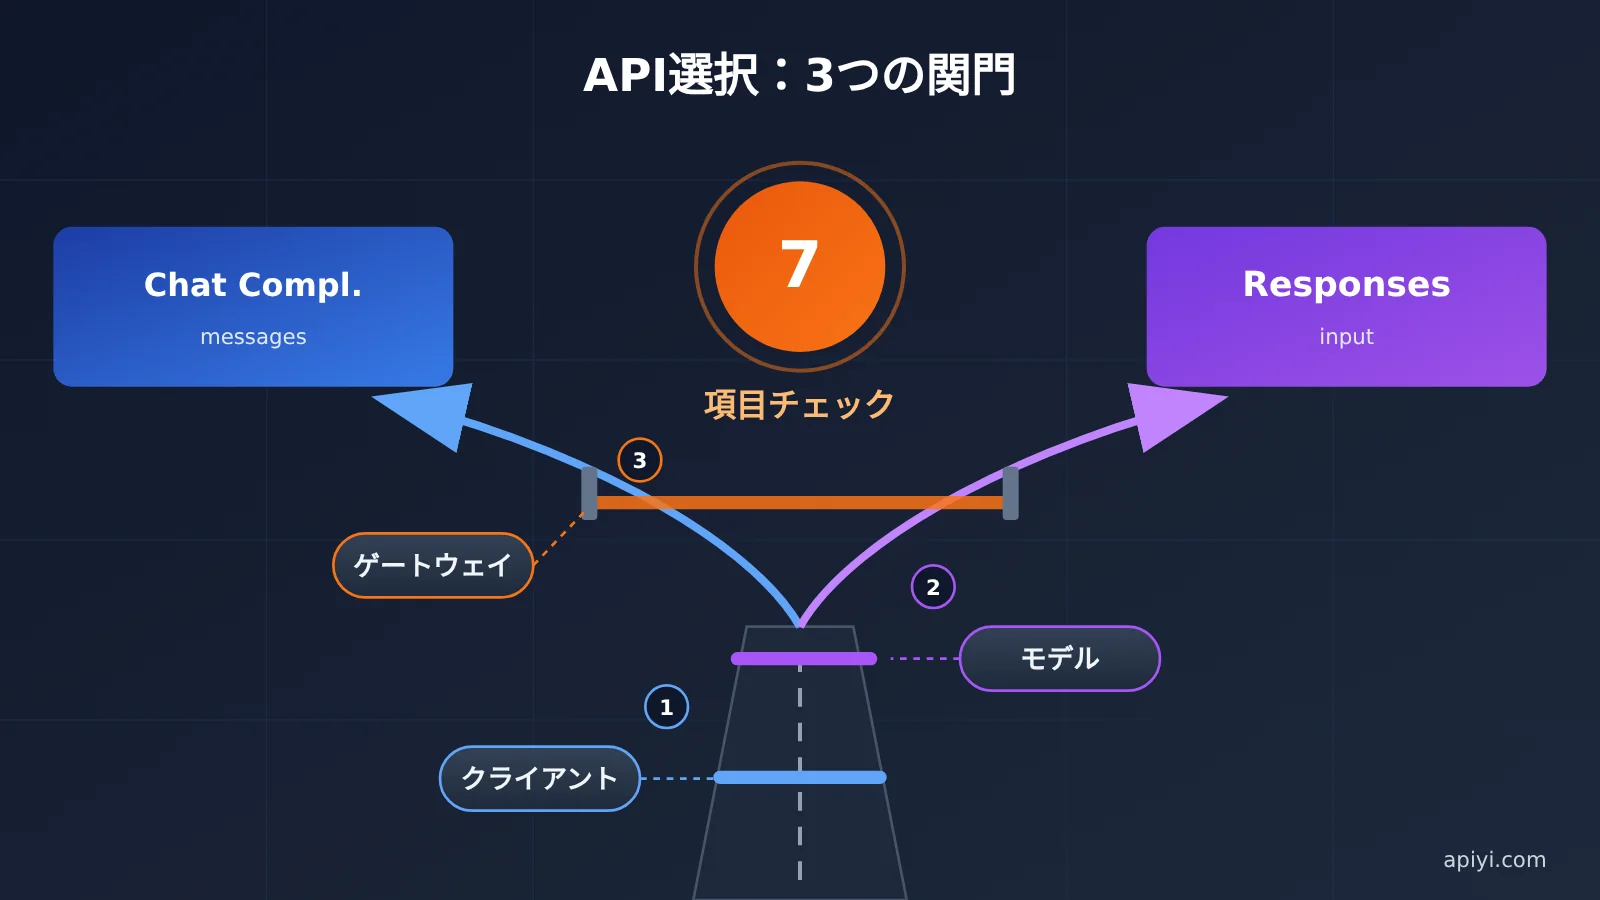
結論から言うと、Responses と Chat Completions のどちらを選ぶかは、インターフェースの新しさではなく、クライアント、モデル、ゲートウェイの3つによって決まります。クライアントは送信できるリクエストを、モデルは必要な機能を提供するエンドポイントを、ゲートウェイはリクエストがそのまま上流に届くかどうかをそれぞれ決めます。
そのため、新しいモデルを利用するためだけに、無理にインターフェースを変更する必要はありません。次の判断基準を覚えておきましょう。クライアントが対応していなければ、どれほど新しいインターフェースでも使わない。モデルが1つのエンドポイントにしか対応していなければ、もう一方を無理に使わない。 以下の7項目のチェック、シナリオ別の判断表、ロールバックチェックリストを使えば、ツール呼び出し、推論パラメータ、ストリーミングイベントの非互換性を公開前に発見できます。
Responses と Chat Completions の違いとは
2つの API の大きな違いは、データモデルにあります。Chat Completions はメッセージ配列を中心に、Responses はレスポンスオブジェクトを中心に設計されています。
Chat Completions のリクエストは messages が中心で、各メッセージに role と content を指定します。そのほか、よく使われるフィールドには temperature、max_tokens、tools、stream があります。ステートレスなため、履歴は呼び出し側で管理します。レスポンスでは choices から message や finish_reason を取り出し、使用量は usage で確認します。SDK やクライアントの対応範囲が最も広いのも特徴です。
Responses のリクエストは input が中心で、tools、reasoning、previous_response_id などを指定できます。レスポンスには output 配列、output_text、status、id、usage が含まれます。一部の新しい推論モデルやツール機能は Responses でのみ提供されていますが、すべてのモデル、SDK、クライアント、ゲートウェイが対応しているわけではありません。
| 確認項目 | Chat Completions | Responses | 移行時のリスク |
|---|---|---|---|
| エンドポイントとリクエスト形式 | /v1/chat/completions、messages を使用 |
/v1/responses、input を使用 |
パスやリクエストボディが合わず、解析コードが動作しない |
| 複数ターンの状態管理 | 呼び出し側が履歴全体を渡す | previous_response_id で前のターンを参照できる |
状態の期限切れ、コンテキストの不整合 |
| 推論とトークンのパラメータ | max_tokens または max_completion_tokens |
reasoning で推論を設定 |
パラメータが無視される、またはエラーになる |
| ツール呼び出し | tools とメッセージ内のツール結果 |
output 内のツール項目と対応する結果項目 |
呼び出し ID の対応付けを誤り、Agent のループが中断する |
| ストリーミングイベント | SSE の差分チャンク | 型付きの SSE イベント | 早期終了、テキストの結合ミス |
| マルチモーダル入力 | 一般的に image_url のコンテンツ項目 |
一般的に input_image などの入力項目 |
画像やファイルが受け付けられない |
| 互換性 | クライアントやゲートウェイの対応範囲が広い | クライアント、ゲートウェイ、モデルによる | Base URL を設定できてもエンドポイントを呼び出せない |
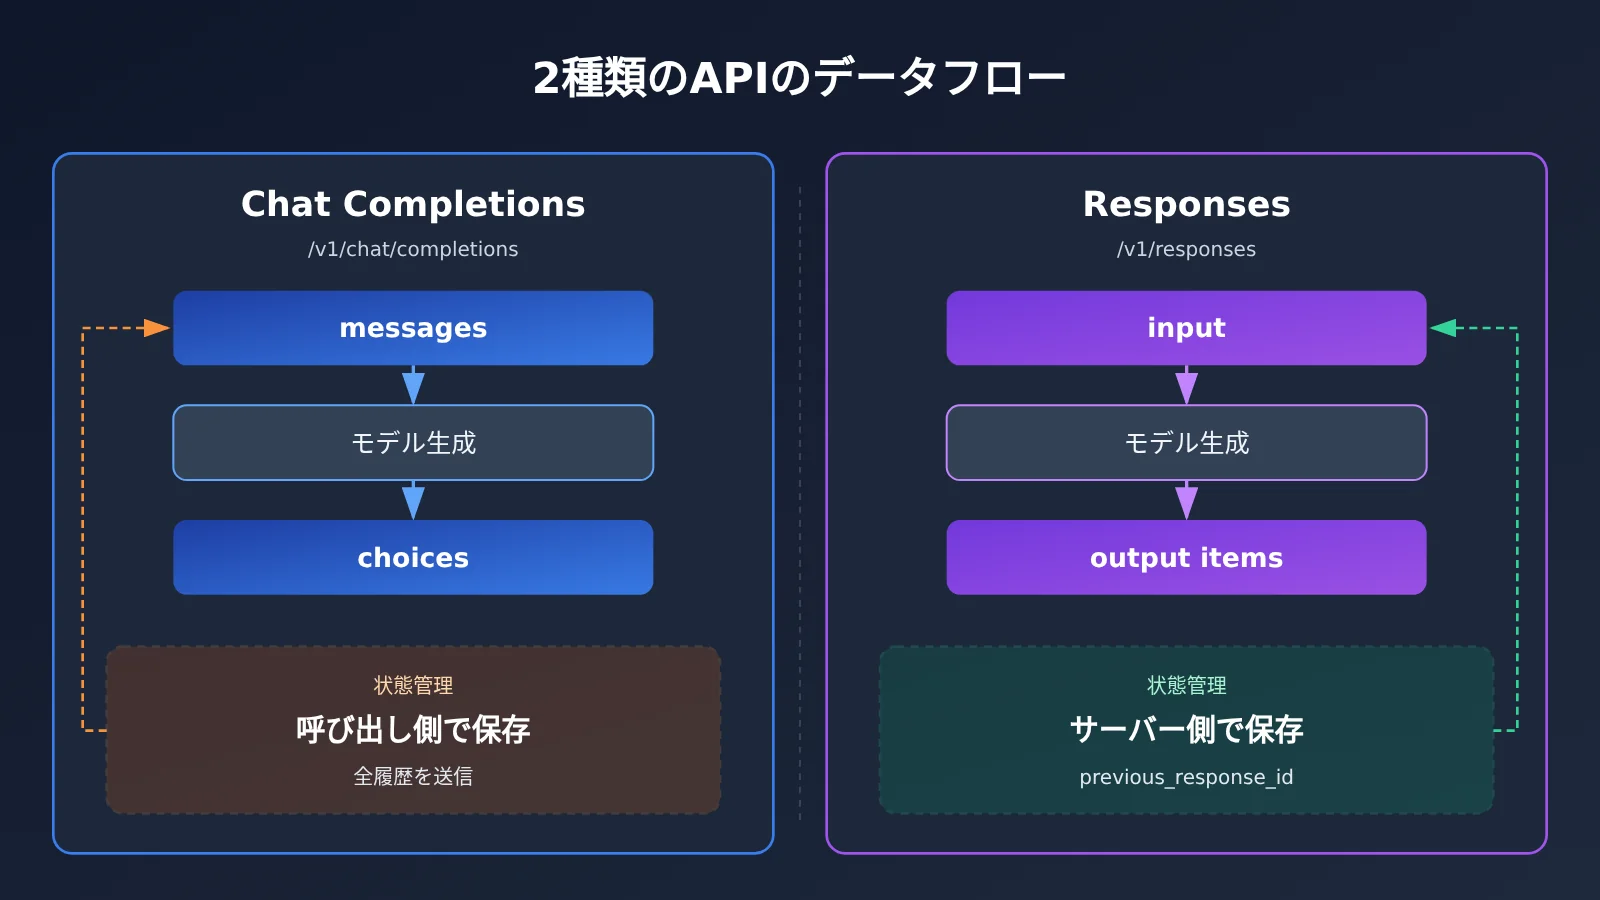
選ぶ際は次の順番で確認しましょう。条件が競合する場合は、クライアントとモデルが正常に動作することを優先します。
- まずクライアントを確認:Chat Completions、Responses、またはベンダー独自の形式のどれに対応しているか。
- 次にモデルを確認:対象モデルが特定のエンドポイントでのみ提供されていないか、組み込みツールや推論項目に依存していないか。
- 次にゲートウェイを確認:対象エンドポイントを中継できるか、モデルのマッピングやログ記録ができるか。
- 最後にコストを確認:同じタスクで、2つの API のトークン、キャッシュ、リトライのコストに違いがあるか。
導入時のアドバイス:比較表はリスクを把握するための目安です。個々のモデルがどのエンドポイントに対応しているかは、実際の環境で確認しましょう。まずは APIYI apiyi.com のコンソールで対象モデルを確認し、そのうえで検証方法を決めるとよいでしょう。
リクエスト層の確認方法:Responses導入時のチェック1〜3
リクエスト層で確認すべきことはシンプルです。エンドポイント、状態、パラメータの3つが正しく設定されていなければ、ツールやストリーミングのテストに進んでも意味がありません。
チェック1:ResponsesとChat Completionsのエンドポイントとリクエスト形式
ここでは、リクエストが正しいパスに送られているか、リクエストボディとレスポンスの解析処理も対応する構造に変更されているかを確認します。
- 違い:一方は
/v1/chat/completions、もう一方は/v1/responsesを使います。前者はmessagesを渡してchoicesを読み取り、後者はinputを渡してoutputを読み取ります。 - 陥りやすい落とし穴:パスだけを変更し、解析処理を変更しないことです。リクエストは成功していても、アプリケーションのコードが
choices[0].messageを取得できず、モデルが何も返していないように見えることがあります。 - 検証方法:最小限のテキストリクエストをそれぞれのエンドポイントに送り、ステータスコード、レスポンスのトップレベルフィールド、
usageを記録します。APIYIのOpenAI互換インターフェースを使う場合、Base URLはhttps://api.apiyi.com/v1です。対象のエンドポイントとモデルが利用可能かどうかは、コンソールとドキュメントで確認してください。 - 選び方:モデルが両方をサポートし、テキストだけが必要なら、既存のインターフェースを使い続けます。モデルが特定のエンドポイントしか提供していない場合は、そのエンドポイントに合わせて実装を変更します。
チェック2:Chat CompletionsとResponsesの複数ターンにわたる状態管理
状態をどこに保持するかによって、トラブルシューティングの方法やコンテキストの制御しやすさが変わります。
- 違い:Chat Completionsでは毎ターン完全な
messagesを渡します。Responsesではprevious_response_idで前のターンのレスポンスを参照し、状態の一部をサーバー側に任せることができます。 - 陥りやすい落とし穴:送信する内容が少なければ課金も減ると考えることです。過去のコンテキストが引き続き入力トークンに計上されるかどうかは、公式ドキュメントと実際の請求で確認してください。もう一つの落とし穴は状態の有効期限です。長時間のタスクを再開するとき、古いresponse idが使えなくなっている可能性があります。
- 検証方法:3ターン続けて会話し、3ターン目で1ターン目の情報を参照できることを確認します。次に、時間が経過したidを使って失敗時の挙動をテストし、エラーを識別できるか確認します。ゲートウェイの背後に複数の上流接続先がある場合は、idをリクエスト間で継続して使えるかも確認してください。対応状況はゲートウェイに依存します。
- 選び方:コンテキストを完全に管理し、監査や切り詰めをしやすくしたい場合は、履歴全体を渡すほうがシンプルです。長い会話やAgentループでサーバー側の状態管理が実際に役立つ場合は、Responsesを検討します。
チェック3:Responsesへの移行時における推論・トークンパラメータ
パラメータの最大のリスクは、エラーになることではなく、エラーが出ないまま無視されることです。リクエストは成功しても、推論設定が反映されていない場合があります。
- 違い:
max_tokensは一部の新しいモデルでmax_completion_tokensに置き換えられており、古いフィールドは無視されるか、エラーになる可能性があります。推論の強度を指定するパラメータの名前も、ベンダーやインターフェースによって異なり、reasoning effortやthinkingなどの形式が一般的です。 - 陥りやすい落とし穴:同じパラメータテンプレートをすべてのモデルに使うことです。クライアントやゲートウェイが未知のフィールドを破棄すると、レスポンスは正常に見えても、推論の深さや出力上限が設定した値と異なる場合があります。
- 検証方法:出力上限と推論の強度を一つずつ変更し、返される内容の長さ、
usage、エラーメッセージを比較します。差が見られない場合は、まずパラメータがそのまま転送されていないか、モデルが対応していない可能性を疑い、公式ドキュメントとゲートウェイの説明を確認します。 - 選び方:ベンダー単位で大まかに分類するのではなく、「モデル+エンドポイント」ごとにパラメータの対応表を管理します。アプリケーションが
reasoningの設定に依存する場合は、そのフィールドをそのまま渡せるインターフェースのパスを優先します。
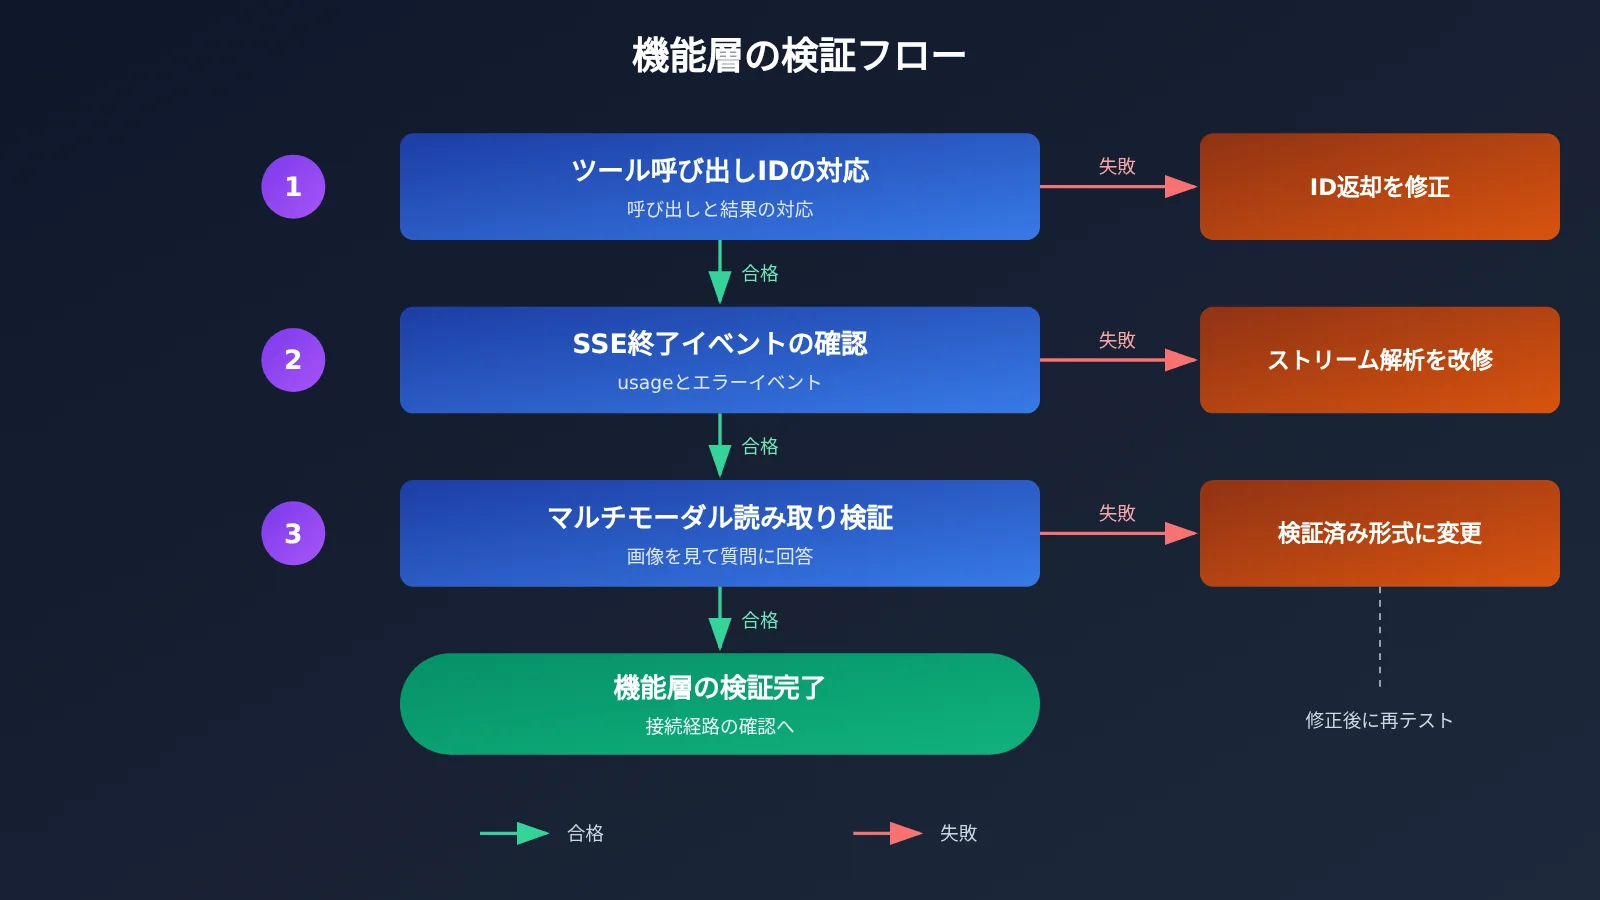
機能面の確認方法:Chat Completions 移行のチェック 4〜6
機能面の結論は、両方のインターフェースで同じ機能を実現できる場合でも、解析コードは基本的にそのまま流用できないということです。
チェック 4:Chat Completions と Responses のツール呼び出し
Chat Completions はツール呼び出しに対応しています。移行時に確認すべきなのは、ツールのスキーマ、呼び出し ID、結果の返し方です。
- 違い:どちらもツールを定義できますが、構造が異なります。Chat Completions では通常、assistant メッセージの
tool_callsに呼び出しが含まれます。一方、Responses では呼び出しがoutput項目として返され、結果も対応する入力項目として返す必要があります。具体的なフィールドは公式ドキュメントを確認してください。 - 陥りやすい落とし穴:並列呼び出しで最初のツールだけを処理したり、呼び出し ID を書き換えてから結果を返したりすることです。モデルの次の処理でエラーが発生する場合もあれば、誤った結果を使って推論を続ける場合もあり、後者は原因を特定しにくくなります。
- 検証方法:単一ツールのケースと並列ツールのケースを用意し、それぞれの呼び出し ID がそのまま返され、結果が正しく対応付けられているか確認します。さらに、意図的にツールを失敗させ、Agent ループが正常に終了するかを確認します。
- 選び方:既存のツールチェーンが安定しており、組み込みツールも不要なら、Chat Completions を使い続けます。対象モデルの組み込みツールが Responses でしか提供されていない場合は、移行したうえで解析レイヤーを書き直します。
チェック 5:Responses と Chat Completions のストリーミングイベント
ストリーミングでは「テキストが出力されるか」だけでなく、終了処理やエラー処理も検証する必要があります。
- 違い:どちらも SSE をベースにしていますが、イベントの種類と終了マーカーが異なります。Chat Completions は主に増分チャンクを扱い、Responses は異なる種類のイベントを使ってテキスト、ツール、完了状態を区別します。
- 陥りやすい落とし穴:「
dataを受信したら終了」と判断したり、テキストの増分だけを連結し、ツール引数の増分やエラーイベントを処理しなかったりすることです。その結果、回答が途中で切れたり、ツール引数を完全に組み立てられなかったりする可能性があります。 - 検証方法:SSE の生データを最初から最後まで取得し、増分の順序、終了イベント、
usageが現れる位置、途中でエラーが発生した場合の挙動を確認します。ゲートウェイがイベントを変換またはバッファリングする場合は、ゲートウェイ経由の通信でもう一度取得します。 - 選び方:クライアントのストリーミングパーサーが Chat Completions 形式にしか対応していない場合は、そのまま Responses に切り替えないでください。切り替えるなら、まず SDK を更新するか、解析レイヤーを改修します。
チェック 6:Responses 導入時のマルチモーダル入力
マルチモーダルのフィールドはインターフェースとベンダーの両方によって決まるため、テキストが正常に動作しても、画像やファイルも使えるとは限りません。
- 違い:画像のフィールドには
image_url、input_image、base64 などがあり、ファイルや音声の入力方法もインターフェースやベンダーによって変わります。 - 陥りやすい落とし穴:従来のコンテンツ片の構造をそのまま使ったり、URL と base64 の両方が使えると決めつけたりすることです。ゲートウェイが形式を変換する際にも、サイズ、エンコーディング、ファイル形式の違いが問題になる場合があります。
- 検証方法:URL 画像、base64 画像、使用したいファイル形式について、それぞれ最小限のリクエストを送り、モデルが実際に内容を読み取ったか確認します。ステータスコードだけを見るより、画像を見なければ答えられない質問にモデルが答えられるかを確認するほうが確実です。
- 選び方:画像の理解だけが必要なら、現在のクライアントで動作確認済みの形式を優先します。ファイルや音声の機能が特定のエンドポイントに依存する場合は、公式ドキュメントとゲートウェイの対応状況を確認してください。
接続経路の確認方法:Responses 互換性のチェック 7
接続経路のチェックで押さえたいのは、Base URL を設定できるからといって、クライアント、SDK、ゲートウェイがすべて Responses に対応しているとは限らない、という点です。
チェック 7:SDK、クライアント、ゲートウェイの Responses 互換性
リクエストはクライアント、SDK、ゲートウェイ、モデルの4層を経由します。どれか1層でも対応していなければ、新しいインターフェースを利用できません。
| 接続経路の層 | 確認すること | よくある誤解 |
|---|---|---|
| クライアント | 対象のエンドポイントに対応しているか、バージョンは十分に新しいか | Base URL の設定項目があるので、Responses にも対応していると思い込む |
| SDK | 対象のメソッドやイベント型が実装されているか | リクエストを送信できるので、ストリーミングやツールも解析できると思い込む |
| ゲートウェイ | 対象のエンドポイントを中継しているか、別途有効化が必要か | OpenAI 互換なので、すべての OpenAI エンドポイントを網羅していると思い込む |
| モデルマッピング | モデル ID がリストにあるか、マッピングが必要か | 公式のモデル名が使えるので、ゲートウェイでも同じ名前だと思い込む |
- 違い:Chat Completions は最も幅広く対応しています。Responses を利用できる範囲は、クライアント、SDK、ゲートウェイ、モデルの組み合わせによって異なります。
- 陥りやすい落とし穴:クライアントが気づかないうちにパスを
/chat/completionsに組み立てていたり、ゲートウェイが一部のフィールドしか中継していなかったりする場合があります。問題の調査時にモデル名だけを見ていると、モデルの能力不足だと誤解しがちです。 - 検証方法:まず業務コードを介さず、API デバッグツールで最小限のリクエストを送信します。次にクライアントから同じリクエストを送り、実際のパス、リクエストボディ、レスポンスを比較します。
- 選び方:接続経路のどれか1層でも対象のエンドポイントに対応していなければ、当面は既存のインターフェースを使い続けるか、実際に対応している形式に切り替えましょう。
複数のモデルを利用する場合、ゲートウェイによってクライアント側の改修を減らせると便利です。APIYI apiyi.com では、1つのキーで OpenAI、Claude、Gemini など複数のモデルを呼び出せます。OpenAI API 標準に加え、Claude、Gemini のネイティブ形式にも対応しているため、クライアントがサポートするプロトコルで接続でき、モデルごとに別々の接続設定を用意する必要がありません。
モデル ID は記憶を頼りに入力したり、他のプラットフォームの命名をそのまま使ったりしないようにしましょう。移行前に APIYI apiyi.com のコンソールにあるモデル一覧で、モデル ID と利用可能なエンドポイントを確認してください。料金と利用可否についても、コンソールとドキュメントを確認しましょう。この手順にかかる時間はわずかですが、「モデルが存在しない」「エンドポイントに対応していない」といったエラーの多くを防げます。
Responses と Chat Completions:用途別の選び方
用途にもよりますが、シンプルなタスクの多くは Chat Completions で十分です。新しい機能が必要になった段階で Responses への移行を検討しましょう。
| シーン | 推奨インターフェース | 理由 | あわせて確認すること |
|---|---|---|---|
| コーディング Agent(Claude Code、Codex CLI、Cline など) | クライアントが対応する形式に合わせて選択 | クライアントのプロトコル実装によって利用できる経路が決まります。多くは現在も Chat Completions または Anthropic Messages が中心です | 現在のバージョンのプロトコル設定、ツール呼び出し、ストリーミング解析 |
| 新しい OpenAI 推論モデルと組み込みツールの併用 | Responses を優先 | 一部の推論機能やツール機能は Responses でのみ提供されています | ゲートウェイがエンドポイントを中継しているか、組み込みツールが利用できるか |
| 長い対話や Agent ループ | Responses を検討 | サーバー側の状態管理によって、データの重複転送を減らせる可能性があります | 状態の有効期限、一貫性、実際のトークンコスト |
| カスタムツール呼び出し | 既存の安定したインターフェースを継続利用 | Chat Completions もツール呼び出しに対応しており、移行コストの大部分は解析処理にかかります | 並列呼び出し、呼び出し ID の対応付け、エラーの返却 |
| 複数モデルへの統一的な接続 | 複数の形式に対応するゲートウェイを優先 | モデルごとにクライアントを変更せずに済みます | モデルのマッピング、ログ、モデルごとのパラメータの違い |
| 読み取り専用の質疑応答や簡単な分類 | Chat Completions | 機能は十分で、対応範囲が広く、変更コストも低く抑えられます | 出力上限のパラメータが対象モデルに対応しているか |
この表は、まず該当するシーンを探し、次に最後の列を確認する使い方がおすすめです。例えば、対象モデルが Responses のみを提供していて、クライアントが Chat Completions にしか対応していない場合、フィールドを無理に書き換えるべきではありません。クライアントをアップグレードするか、別のクライアントに切り替えるか、その経路で利用できる別のモデルを選びましょう。
コストは最後に判断します。Responses が必ずしも安いとは限りません。キャッシュのヒット率、リトライ回数、実際のトークン使用量はいずれも費用に影響します。同じタスクで請求額を比較してこそ、意味のある結論が得られます。
選び方のヒント:複数の候補モデルがある場合は、同じプロンプトとツールのユースケースで比較してみましょう。APIYI apiyi.com を通じて同じ APIキーでモデルを切り替え、新規ユーザー向けの無料テスト枠を使って小規模に検証すれば、初期の接続や設定にかかる手間を減らせます。
Responses と Chat Completions のよくある質問 FAQ
これらの質問に共通する答えは、まず実際の接続経路を確認してから判断することです。
Q1:新しいモデルは Responses でしか使えませんか?
必ずしもそうではありません。具体的なモデルとゲートウェイによります。一部の新しい推論モデルやツール機能は Responses でのみ提供されますが、Chat Completions を引き続きサポートするモデルもあります。導入前に、公式ドキュメントとゲートウェイのモデル説明を確認してください。
Q2:Chat Completions でもツール呼び出しは使えますか?
使えます。Chat Completions はツール呼び出しに対応しています。違いがあるのは、フィールドの構造、結果の返却形式、状態管理です。Responses への移行時には、通常、ツールの解析コードを調整する必要があり、そのまま再利用することはできません。
Q3:ゲートウェイが Responses に対応していない場合はどうすればよいですか?
まず、対象モデルが Chat Completions またはベンダー固有の形式でも利用できるか確認してください。利用できるなら、既存の接続経路を維持できます。モデルが Responses のみに対応している場合は、そのエンドポイントをサポートするゲートウェイに切り替えるか、直接接続する必要があります。APIYI apiyi.com を利用する場合は、コンソールとドキュメントで対象モデルが対応するエンドポイントを確認できます。
Q4:移行後に課金額が変わったのはなぜですか?
よくある原因には、コンテキストの受け渡し方法や推論トークン数の変化、キャッシュヒットの違い、ツール呼び出しによるやり取りの増加、失敗時のリトライなどがあります。調査する際は、同じタスクで `usage` を比較し、APIYI apiyi.com の利用ログでモデル、リクエスト数、トークン消費量を確認してください。
Q5:どのような場合にロールバックすべきですか?
重要な処理経路での失敗、ツール結果の取り違え、ストリーミングの頻繁な途切れが発生した場合や、成功率・レイテンシ・コストが基準値から大きく外れ、短期間で原因を説明できない場合は、ロールバックを検討すべきです。リリース後に判断を巡って議論することのないよう、ロールバック基準は移行前に決めておきましょう。
Responsesへの移行とロールバックのチェックリスト
移行のポイントは、小さな単位で検証し、旧経路を残したうえで、ベースラインを基準に継続か切り戻しかを判断することです。
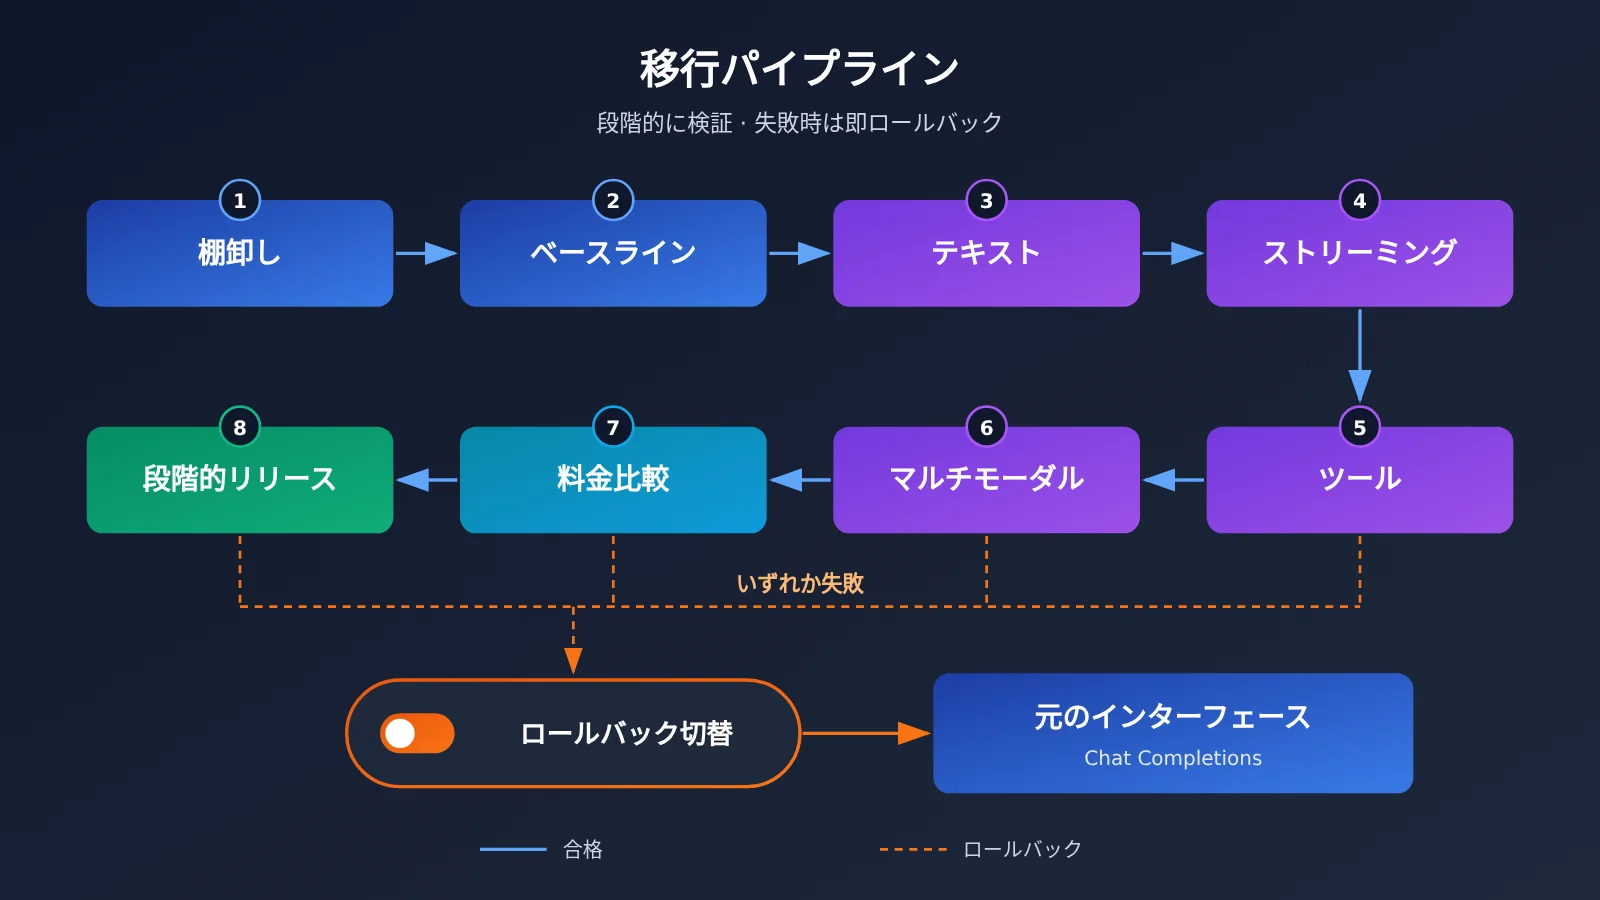
Responsesへの移行前後の検証チェックリスト
- バージョンの棚卸し:クライアント、SDK、ゲートウェイのバージョンを一覧にし、対象のエンドポイントがサポートされているか確認します。
- 対応関係の確認:エンドポイント、モデルID、推論パラメータ、トークン関連のパラメータを照合します。
- ベースラインの記録:元のインターフェースの成功率、レイテンシ、トークンコストを記録します。
- 旧経路の維持:元のインターフェースの設定とモデルIDを残し、スイッチや環境変数で切り替えられるようにします。コードに固定で書き込まないようにしましょう。
- まずテキストを検証:最小限のテキストリクエストが成功し、レスポンスを正しく解析できることを確認します。
- 次にストリーミングを検証:差分をつなぎ合わせて完全な出力を得られ、終了イベントとエラーイベントを正しく処理できることを確認します。
- 次にツールを検証:単一ツールと並列ツールの両方が動作し、呼び出しIDと結果が正しく対応していることを確認します。
- 最後にマルチモーダルを検証:画像やファイルなど、実際に使用する入力をモデルが正しく読み取れることを確認します。
- 請求内容を確認:トークン課金とキャッシュを比較し、差異の理由を説明できるようにします。
- 少量のトラフィックで段階的にリリース:まず重要度の低いトラフィックを少量流し、差異や失敗事例を記録します。
移行の検証段階では、新旧のリクエスト結果を並べて確認することをおすすめします。APIYI apiyi.com のコンソールでは使用量と請求額を確認できます。ログを使って、段階的リリース中のリクエストにおけるモデルや消費量が想定どおりか照合しましょう。異常があれば元のインターフェース設定に切り戻し、失敗事例を使って問題を再現します。
Chat Completionsへのロールバックを判断する条件
| 観察項目 | 推奨アクション | ロールバックの判断 |
|---|---|---|
| テキストリクエストの失敗 | 段階的リリースを中断し、エンドポイントと解析処理を確認 | 短期間で修正できない場合はロールバック |
| ストリーミングの途中切断、または終了しない | 元のSSEイベントと比較 | ユーザーへの出力に影響する場合は直ちにロールバック |
| ツール呼び出しの対応付けミス | 呼び出しIDと結果の返却形式を確認 | 誤った操作につながる可能性がある場合は直ちにロールバック |
| 推論パラメータが反映されない | パラメータがそのまま渡されているか、モデルが対応しているか確認 | 出力品質に影響し、代替設定もない場合はロールバック |
| コストがベースラインから乖離 | トークン、キャッシュ、リトライを分析 | チームが事前に設定した閾値を超え、理由を説明できない場合はロールバック |
ResponsesとChat Completionsを選ぶ際の要点
- 選択の順序:クライアント、モデル、ゲートウェイの順に確認し、最後にコストを比較します。
- 対応機能の範囲:Responsesはその専用機能に依存するモデルに適していますが、すべてのモデルが対応しているわけではありません。
- ツール呼び出し:Chat Completionsでもツール呼び出しは可能です。移行時はフィールドと対応付けが重要になります。
- 検証の順序:テキスト、ストリーミング、ツール、マルチモーダルの順に検証します。
- ロールバックの前提:旧設定を削除せず、ベースラインを事前に記録し、スイッチで切り替えられるようにします。
まとめ:ResponsesとChat Completionsの最終判断
既存のChat Completionsの処理経路が安定し、機能も十分であれば、新しいモデルを接続できる限り、インターフェースを変えるためだけに移行する必要はありません。対象モデルや組み込みツールがResponsesに依存する場合は、7項目のチェックに沿って段階的に動作を確認しましょう。最後に、これだけは覚えておいてください。クライアントが対応していなければ、どんなに新しいインターフェースでも使わない。モデルが一方のエンドポイントにしか対応していなければ、もう一方を無理に使わない。
作業に取りかかる際は、まずAPIYI apiyi.com でモデルIDとエンドポイントの対応状況を確認し、最小限のリクエストでチェックリストを一通り検証してから、トラフィックを増やすかどうか判断しましょう。
著者:APIYI技術チーム
技術交流:APIYIのトップページからお気軽にお問い合わせください。接続に関する資料は、ドキュメントセンター docs.apiyi.com でもご覧いただけます。