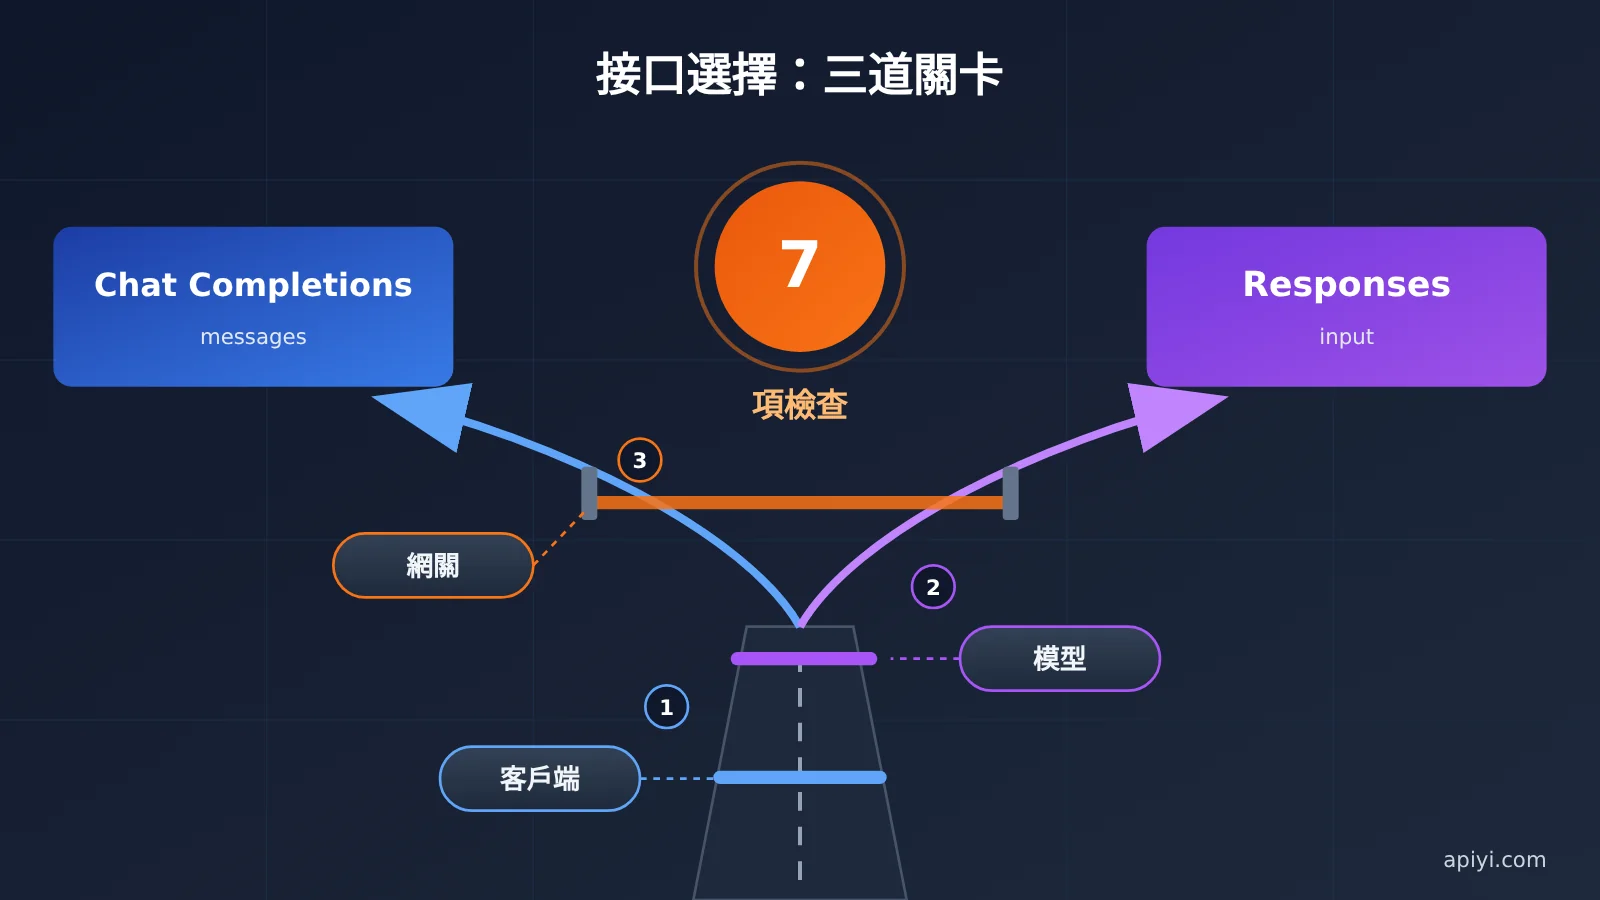
先給結論:Responses 還是 Chat Completions,不取決於哪個接口更新,而是由 客戶端、模型、網關三者共同決定。客戶端決定你能發出什麼請求,模型決定哪個端點能提供所需能力,網關決定這條請求能否原樣到達上游。
所以,不要爲了接一個新模型就強行改接口。記住這句判斷:客戶端不支持,再新的接口也不要用;模型只支持一個端點,就不要硬套另一個。 下面的 7 項檢查、場景決策表和回滾清單,可以幫你在上線前發現工具調用、推理參數或流式事件的不兼容。
Responses 和 Chat Completions 到底差在哪
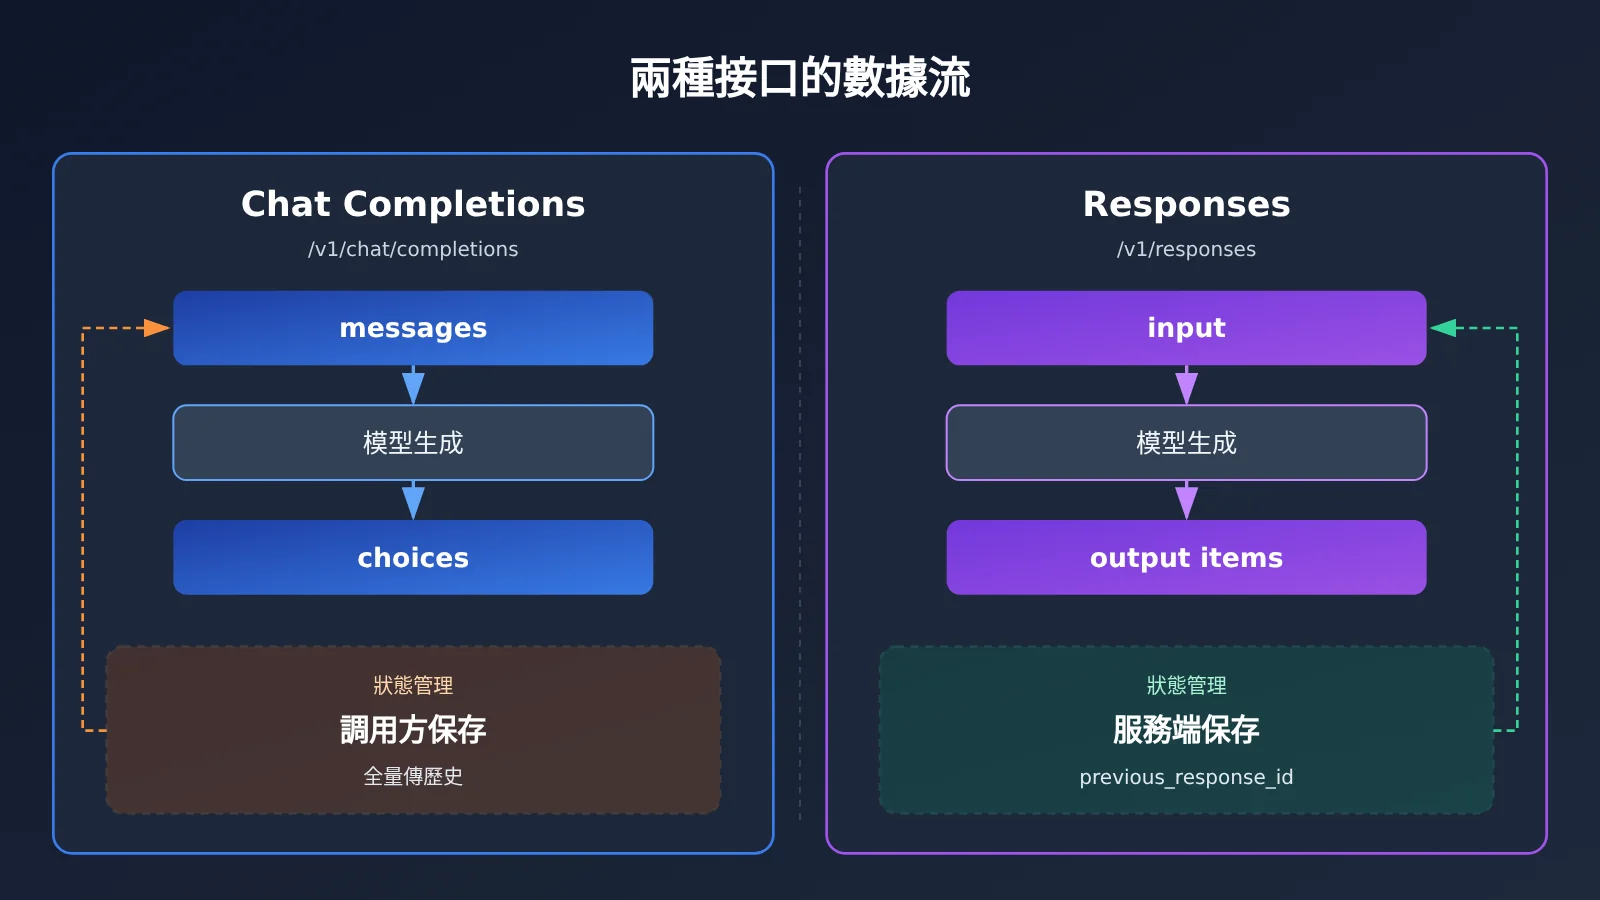
兩種接口的核心差別在於數據模型:Chat Completions 圍繞消息數組,Responses 圍繞響應對象。
Chat Completions 的請求以 messages 爲中心,每條消息帶 role 和 content,常見字段還有 temperature、max_tokens、tools、stream。它是無狀態的,歷史由調用方維護,響應則從 choices 裏取 message、finish_reason,用量看 usage。它的 SDK 和客戶端支持面最廣。
Responses 的請求以 input 爲中心,可以帶 tools、reasoning、previous_response_id,響應裏是 output 數組、output_text、status、id 和 usage。部分新推理模型和工具能力只在 Responses 提供,但不是所有模型、SDK、客戶端和網關都支持它。
| 檢查項 | Chat Completions | Responses | 遷移風險 |
|---|---|---|---|
| 端點與請求形狀 | /v1/chat/completions,使用 messages |
/v1/responses,使用 input |
路徑或請求體不匹配,解析代碼失效 |
| 多輪狀態 | 調用方全量傳歷史 | 可用 previous_response_id 引用上一輪 |
狀態過期、上下文不一致 |
| 推理與 token 參數 | max_tokens 或 max_completion_tokens |
通過 reasoning 配置推理 |
參數被忽略或直接報錯 |
| 工具調用 | tools 加消息內的工具結果 |
output 中的工具項加對應結果項 |
調用 ID 配對錯誤,Agent 循環中斷 |
| 流式事件 | SSE 增量片段 | 帶類型的 SSE 事件 | 提前結束、文本拼接錯誤 |
| 多模態輸入 | 常見 image_url 內容片段 |
常見 input_image 等輸入項 |
圖片或文件被拒絕 |
| 兼容性 | 客戶端和網關覆蓋廣 | 取決於客戶端、網關和模型 | 能填 Base URL,卻調不通端點 |
選擇時按這個順序判斷,三者衝突時,優先保證客戶端和模型能跑通:
- 先看客戶端:它支持 Chat Completions、Responses,還是廠商原生格式。
- 再看模型:目標模型是否只在某個端點提供,是否依賴內置工具或推理項。
- 再看網關:是否代理目標端點,能否做模型映射和日誌記錄。
- 最後看成本:同樣的任務,兩種接口的 token、緩存和重試成本是否不同。
接入建議:對比表只能幫你定位風險,具體模型支持哪個端點,還要回到實際環境確認。可以先在 API易 apiyi.com 控制檯查看目標模型,再決定走哪條驗證路徑。
請求層怎麼查:Responses 接入的檢查 1-3
請求層的結論很簡單:端點、狀態和參數三項沒對齊,後面的工具和流式都不用測。
檢查 1:Responses 與 Chat Completions 的端點和請求形狀
這一項要確認的是,請求發到了正確路徑,請求體和響應解析也都換成了對應結構。
- 差異:一個走
/v1/chat/completions,一個走/v1/responses;前者傳messages、讀choices,後者傳input、讀output。 - 容易踩的坑:只改路徑、不改解析。請求可能已經成功,業務代碼卻取不到
choices[0].message,表面上看像是模型沒有返回內容。 - 怎麼驗證:用一條最小文本請求分別打兩個端點,記錄狀態碼、響應頂層字段和
usage。走 API易 的 OpenAI 兼容接口時,Base URL 使用https://api.apiyi.com/v1,目標端點和模型是否可用以控制檯和文檔爲準。 - 怎麼選:模型兩邊都支持、業務只需要文本時,繼續用現有接口;模型只開放某個端點時,就按該端點改造。
檢查 2:Chat Completions 與 Responses 的多輪狀態管理
狀態放在哪裏,決定了排障方式,也影響上下文的可控程度。
- 差異:Chat Completions 每輪傳完整
messages;Responses 可以用previous_response_id引用上一輪響應,把部分狀態交給服務端。 - 容易踩的坑:把少傳內容等同於少計費。歷史上下文是否繼續計入輸入 token,要以官方文檔和實際賬單爲準。另一個坑是狀態過期,長任務恢復時,舊的 response id 可能已經無法使用。
- 怎麼驗證:連續跑三輪對話,確認第三輪能引用第一輪的信息;再用一個放置較久的 id 測試失敗路徑,看錯誤是否可識別。網關背後如有多條上游線路,還要確認 id 能否跨請求繼續使用,以網關支持爲準。
- 怎麼選:需要完全掌控上下文、方便審計和裁剪時,全量傳歷史更直接;長對話或 Agent 循環確實能從服務端狀態受益時,再評估 Responses。
檢查 3:Responses 遷移時的推理與 token 參數
參數最大的風險往往不是報錯,而是被靜默忽略,請求成功了,推理配置卻沒有生效。
- 差異:
max_tokens在部分新模型上已被max_completion_tokens取代,舊字段可能被忽略或報錯。推理強度在不同廠商、不同接口上的名稱也不同,常見的有 reasoning effort 和thinking等形式。 - 容易踩的坑:把一套參數模板用於所有模型。客戶端或網關如果丟棄了未知字段,返回看起來正常,推理深度和輸出上限卻可能不是你設定的值。
- 怎麼驗證:逐個改變輸出上限和推理強度,對比返回長度、
usage和錯誤信息。沒有差異時,先懷疑參數未被透傳或未被該模型支持,再查官方文檔和網關說明。 - 怎麼選:按“模型 + 端點”維護參數映射表,不按廠商粗略歸類。業務依賴
reasoning配置時,優先選擇能原樣傳遞該字段的接口路徑。
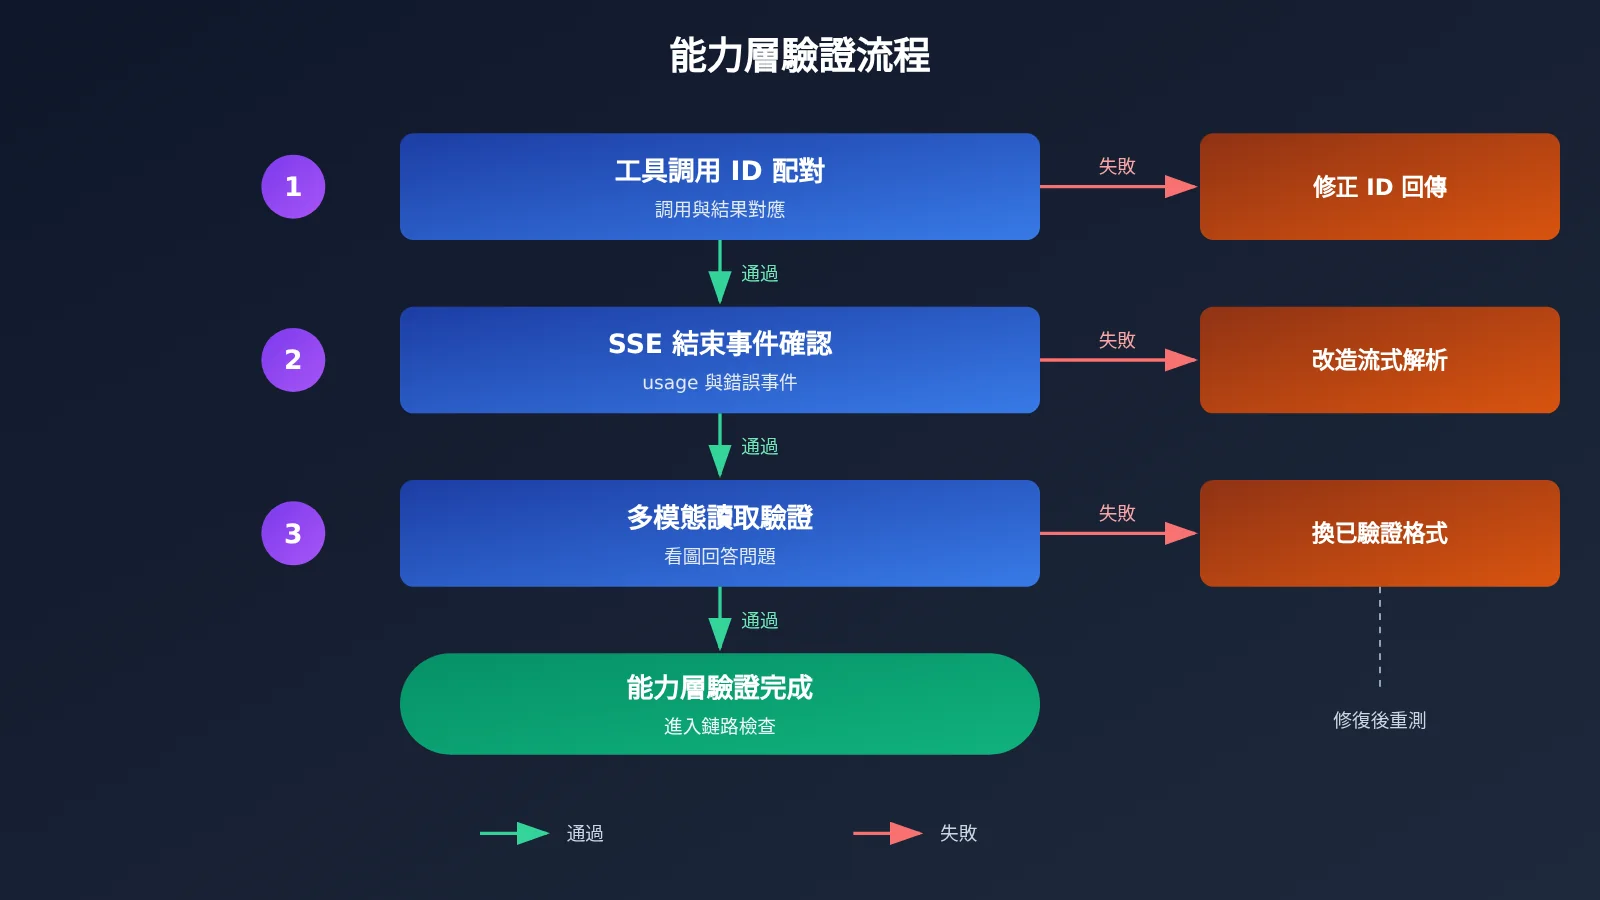
能力層怎麼查:Chat Completions 遷移的檢查 4-6
能力層的結論是:兩種接口都可能跑通同一個功能,但解析代碼基本不能直接複用。
檢查 4:Chat Completions 與 Responses 的工具調用
Chat Completions 支持工具調用,真正要遷移的是工具 schema、調用 ID 和結果回傳方式。
- 差異:兩者都有工具定義,但結構不同。Chat Completions 的調用通常出現在 assistant 消息的
tool_calls中;Responses 的調用作爲output項返回,結果也要用對應的輸入項回傳。具體字段以官方文檔爲準。 - 容易踩的坑:並行調用時只處理第一個工具,或把調用 ID 改寫後再回傳。模型下一輪可能報錯,也可能拿錯結果繼續推理,後者更難排查。
- 怎麼驗證:準備一個單工具用例和一個並行工具用例,檢查每個調用 ID 是否原樣回傳、結果是否一一配對。再故意讓工具返回失敗,確認 Agent 循環能正常收尾。
- 怎麼選:現有工具鏈穩定、沒有內置工具需求時,留在 Chat Completions;目標模型的內置工具只在 Responses 提供時,再遷移並重寫解析層。
檢查 5:Responses 與 Chat Completions 的流式事件
流式不能只看“有沒有吐字”,結束和錯誤處理同樣要驗證。
- 差異:兩者都基於 SSE,但事件類型和結束標記不同。Chat Completions 以增量片段爲主,Responses 通過不同類型的事件區分文本、工具和完成狀態。
- 容易踩的坑:用“收到
data就結束”判斷完成,或者只拼接文本增量、不處理工具參數增量和錯誤事件。結果可能是回答被截斷,工具參數也拼不完整。 - 怎麼驗證:抓取一次完整 SSE 原文,覈對增量順序、結束事件、
usage出現位置和中途錯誤的表現。網關如果轉換或緩衝事件,要在經過網關的鏈路上再抓一次。 - 怎麼選:客戶端的流式解析器只認 Chat Completions 格式時,不要直接切到 Responses;要切換,就先升級 SDK 或改造解析層。
檢查 6:Responses 接入時的多模態輸入
多模態字段由接口和廠商共同決定,文本跑通並不代表圖片和文件能跑通。
- 差異:圖片字段可能是
image_url、input_image或 base64,文件和音頻的輸入方式也會隨接口、廠商變化。 - 容易踩的坑:沿用舊的內容片段結構,或者假定 URL 和 base64 都能使用。網關轉換格式時,也可能遇到大小、編碼或文件類型上的差異。
- 怎麼驗證:分別用 URL 圖片、base64 圖片和目標文件類型發最小請求,確認模型真的讀取了內容。讓模型回答一個只有看到圖片才能回答的問題,比只看狀態碼可靠。
- 怎麼選:只有圖片理解需求時,優先走當前客戶端已驗證的格式;文件或音頻能力依賴特定端點時,以官方文檔和網關支持爲準。
接入鏈路怎麼查:Responses 兼容性的檢查 7
鏈路檢查的結論是:能填 Base URL,不等於客戶端、SDK 和網關都支持 Responses。
檢查 7:SDK、客戶端與網關的 Responses 兼容性
一次請求要經過客戶端、SDK、網關、模型四層,任何一層不支持,新接口都用不起來。
| 鏈路層 | 要確認什麼 | 常見誤判 |
|---|---|---|
| 客戶端 | 是否支持目標端點,版本是否夠新 | 有 Base URL 配置項,就以爲支持 Responses |
| SDK | 是否封裝目標方法和事件類型 | 請求能發出,就以爲流式和工具也能解析 |
| 網關 | 是否代理目標端點,是否需要單獨開通 | OpenAI 兼容,就以爲覆蓋所有 OpenAI 端點 |
| 模型映射 | 模型 ID 是否在列表中,是否需要映射 | 官方模型名可用,就以爲網關中名稱相同 |
- 差異:Chat Completions 的兼容面最廣;Responses 的可用範圍取決於客戶端、SDK、網關和模型的組合。
- 容易踩的坑:客戶端悄悄把路徑拼成
/chat/completions,或者網關只代理了部分字段。排查時如果只看模型名,很容易把問題誤判爲模型能力不足。 - 怎麼驗證:先繞開業務代碼,用接口調試工具發最小請求;再用客戶端發同樣的請求,比較實際路徑、請求體和響應。
- 怎麼選:鏈路中任何一層不支持目標端點,就先保留現有接口,或換用它實際支持的格式。
多模型場景下,網關最好能減少客戶端的改造面。API易 apiyi.com 支持一個 Key 調用 OpenAI、Claude、Gemini 等多家模型,同時兼容 OpenAI API 標準以及 Claude、Gemini 原生格式,客戶端可以按自身支持的協議接入,不必爲每個模型單獨適配一套接入配置。
模型 ID 不要憑記憶填寫,也不要直接照搬其他平臺的命名。遷移前到 API易 apiyi.com 控制檯的模型列表確認模型 ID 和可用端點,價格和可用性同樣以控制檯和文檔爲準。這一步花費的時間很少,卻能排除一大類“模型不存在”或“端點不支持”的錯誤。
Responses 還是 Chat Completions:按場景怎麼選
按場景看,大多數簡單任務留在 Chat Completions 就夠了,確實依賴新能力時再轉向 Responses。
| 場景 | 推薦接口 | 理由 | 還要確認什麼 |
|---|---|---|---|
| 編程 Agent(Claude Code、Codex CLI、Cline 等) | 按客戶端支持的格式選擇 | 客戶端的協議實現決定可用路徑,多數仍以 Chat Completions 或 Anthropic Messages 爲主 | 當前版本的協議配置、工具調用和流式解析 |
| 新 OpenAI 推理模型加內置工具 | 優先 Responses | 部分推理和工具能力只在 Responses 提供 | 網關是否代理端點,內置工具是否可用 |
| 長對話或 Agent 循環 | 可評估 Responses | 服務端狀態可能減少重複傳輸 | 狀態過期時間、一致性、實際 token 成本 |
| 自定義工具調用 | 沿用現有穩定接口 | Chat Completions 同樣支持工具調用,遷移成本主要在解析層 | 並行調用、調用 ID 配對、錯誤回傳 |
| 多模型統一接入 | 優先選支持多種格式的網關 | 避免爲每個模型改一遍客戶端 | 模型映射、日誌、各模型的參數差異 |
| 只讀問答或簡單分類 | Chat Completions | 能力足夠,兼容面廣,改造成本低 | 輸出上限參數是否適配目標模型 |
這張表的使用方法是先找場景,再看最後一列。比如目標模型只提供 Responses,而你的客戶端只支持 Chat Completions,這時不應硬改字段,而要升級客戶端、換客戶端,或者換一個該路徑可用的模型。
成本放在最後判斷。Responses 未必更便宜,緩存命中、重試次數和實際 token 用量都會影響結果,只有在相同任務上對比賬單,結論纔有意義。
選擇建議:手上有多個候選模型時,可以用同一組提示詞和工具用例做對比。通過 API易 apiyi.com 用同一個 Key 切換模型,再結合新用戶的免費測試額度完成小規模驗證,能減少前期的接入和配置工作。
Responses 與 Chat Completions 常見問題 FAQ
這些問題的共同答案是:先看實際鏈路,再下結論。
Q1:新模型是不是隻能用 Responses?
未必。這取決於具體模型和網關,部分新推理模型或工具能力只在 Responses 提供,也有模型繼續支持 Chat Completions。接入前以官方文檔和網關的模型說明爲準。
Q2:Chat Completions 還能不能用工具調用?
能用。Chat Completions 支持工具調用,差別在於字段結構、結果回傳格式和狀態管理。遷移到 Responses 時,工具解析代碼通常需要調整,不能直接複用。
Q3:網關不支持 Responses 怎麼辦?
先確認目標模型是否也能走 Chat Completions 或廠商原生格式;能走,就保留現有路徑。模型只提供 Responses 時,需要換用支持該端點的網關或直連路徑。使用 API易 apiyi.com 時,可在控制檯和文檔中確認目標模型的端點支持情況。
Q4:遷移後計費爲什麼變了?
常見原因包括上下文傳遞方式變化、推理 token 變化、緩存命中不同、工具調用增加輪次,以及失敗重試。排查時按同一任務對比 `usage`,再到 API易 apiyi.com 的用量日誌中核對模型、請求量和 token 消耗。
Q5:什麼時候該回滾?
核心鏈路失敗、工具結果錯配、流式頻繁截斷,或者通過率、延遲、成本明顯偏離基線且短期無法解釋時,就該回滾。回滾標準要在遷移前定好,避免上線後臨時爭論。
Responses 遷移與回滾清單
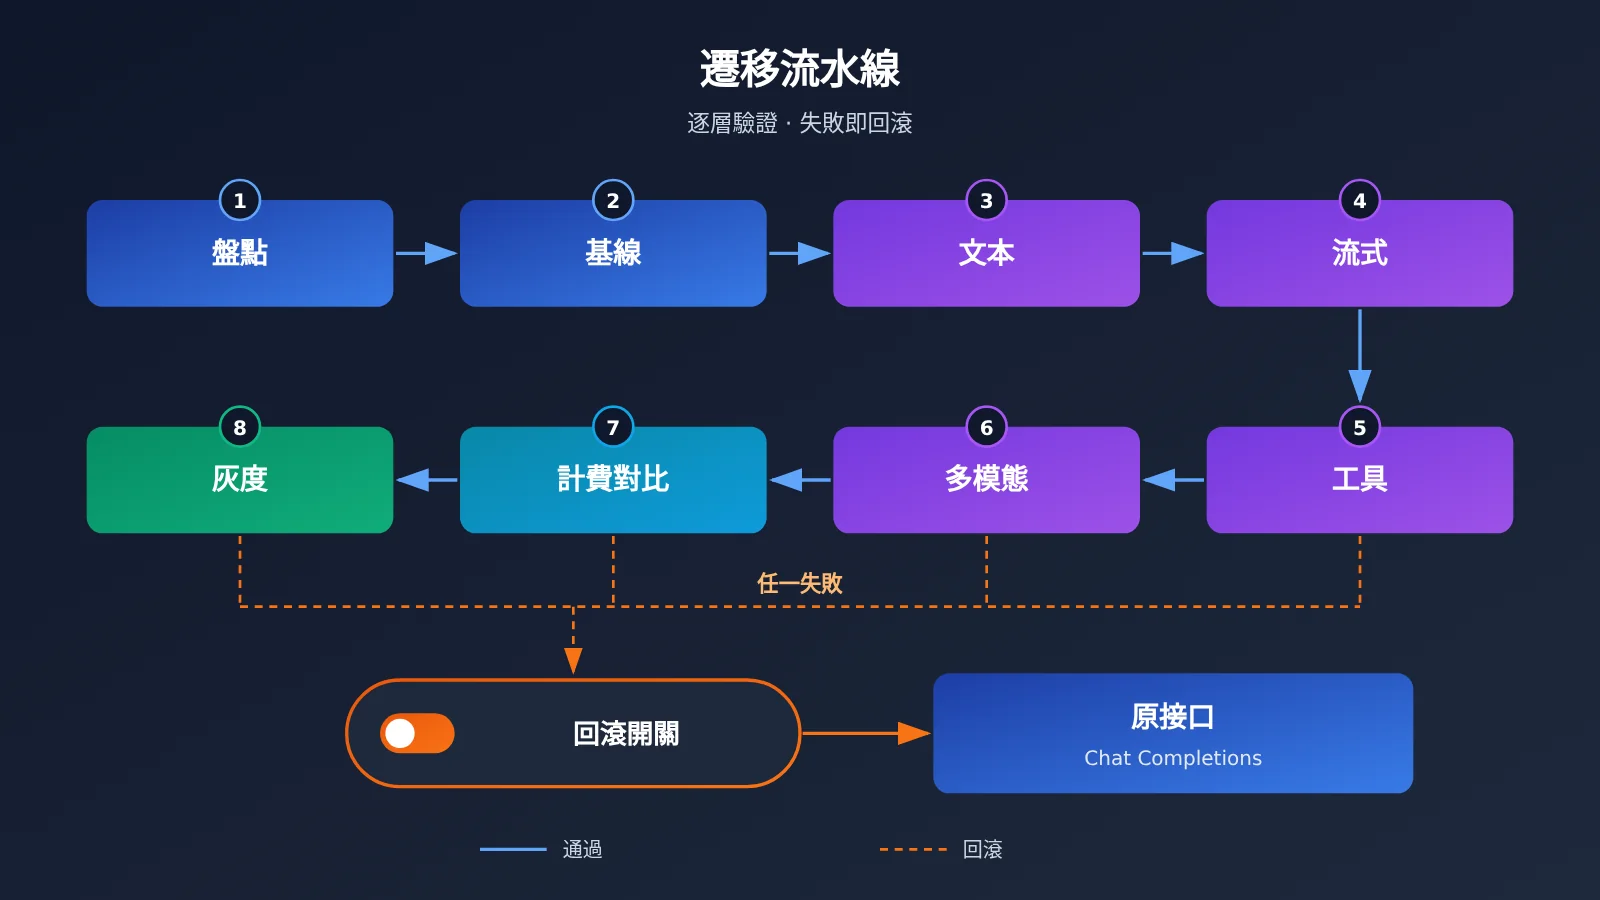
遷移的結論是:小步驗證、保留舊路徑、用基線決定去留。
Responses 遷移前後的驗證清單
- 盤點版本:列出客戶端、SDK 和網關版本,確認目標端點受支持。
- 確認映射:覈對端點、模型 ID、推理參數和 token 參數。
- 記錄基線:保存原接口的通過率、延遲和 token 成本。
- 保留舊路徑:保留原接口配置和模型 ID,用開關或環境變量切換,不要改死在代碼裏。
- 先驗證文本:最小文本請求通過,響應解析正確。
- 再驗證流式:增量拼接完整,結束事件和錯誤事件處理正確。
- 再驗證工具:單工具、並行工具都能跑通,調用 ID 和結果配對正確。
- 最後驗證多模態:圖片、文件等實際用到的輸入能被模型正確讀取。
- 解釋賬單:對比 token 計費和緩存,差異能被說明。
- 小流量灰度:先放少量非關鍵流量,同時記錄差異和失敗案例。
遷移驗證階段,建議把新舊請求的結果放在一起看。API易 apiyi.com 控制檯提供用量和賬單查看能力,可以用日誌覈對灰度請求的模型、消耗是否符合預期;一旦異常,就切回原接口配置,再用失敗案例復現問題。
Chat Completions 回滾觸發條件
| 觀察項 | 建議動作 | 回滾判斷 |
|---|---|---|
| 文本請求失敗 | 暫停灰度,檢查端點和解析 | 短期無法修復時回滾 |
| 流式截斷或不結束 | 對比原始 SSE 事件 | 影響用戶輸出時立即回滾 |
| 工具調用錯配 | 檢查調用 ID 和回傳格式 | 可能產生錯誤操作時立即回滾 |
| 推理參數未生效 | 覈對透傳和模型支持 | 影響輸出質量且無替代配置時回滾 |
| 成本偏離基線 | 分析 token、緩存和重試 | 超出團隊預設閾值且無法解釋時回滾 |
Responses 還是 Chat Completions 核心要點
- 選擇順序:先客戶端,再模型,再網關,最後比較成本。
- 能力邊界:Responses 適合依賴其專屬能力的模型,但並非所有模型都支持。
- 工具調用:Chat Completions 能做工具調用,遷移重點在字段和配對。
- 驗證順序:先文本,再流式,再工具,最後多模態。
- 回滾前提:舊配置不刪除,基線提前記錄,切換靠開關完成。
總結:Responses 還是 Chat Completions 的最終判斷
現有 Chat Completions 鏈路穩定、功能夠用時,新模型能接就不必爲了換接口而換接口。目標模型或內置工具依賴 Responses 時,再按 7 項檢查逐層打通。最後記住這句話:客戶端不支持,再新的接口也不要用;模型只支持一個端點,就不要硬套另一個。
準備動手時,可以先通過 API易 apiyi.com 確認模型 ID 和端點支持,用最小請求跑完清單,再決定是否放量。
作者:API易技術團隊
技術交流:歡迎在 API易網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心