作者注:回答一個賬單問題。模型標價這幾個月降得很快,寫代碼的 Agent 卻仍然貴在同一列。價格按 2026-10-26 能打開的官方價目表,以及 API易 模型價格頁覈對。96% 這個數是第三方作者自己的估算,不是本文實測。
2026-06-26 到 2026-09-29,大約四個月,OpenAI 和 Anthropic 輪着改價。Max Woolf 在 2026-10-25 把這條時間線寫在 minimaxir.com/2026/10/cheap-llms,標題裏的幅度是最多 80%。他在文中寫道,寫代碼的 Agent 裏,緩存讀佔總 token 花費的 96%–99%,因爲每一輪都會把此前的對話從緩存裏再讀一遍,命中率大約 90%–100%,隨推理服務商而變。原文沒有附上可複覈的請求日誌。本文把這句話當作第三方說法,不用它代替你自己的用量。
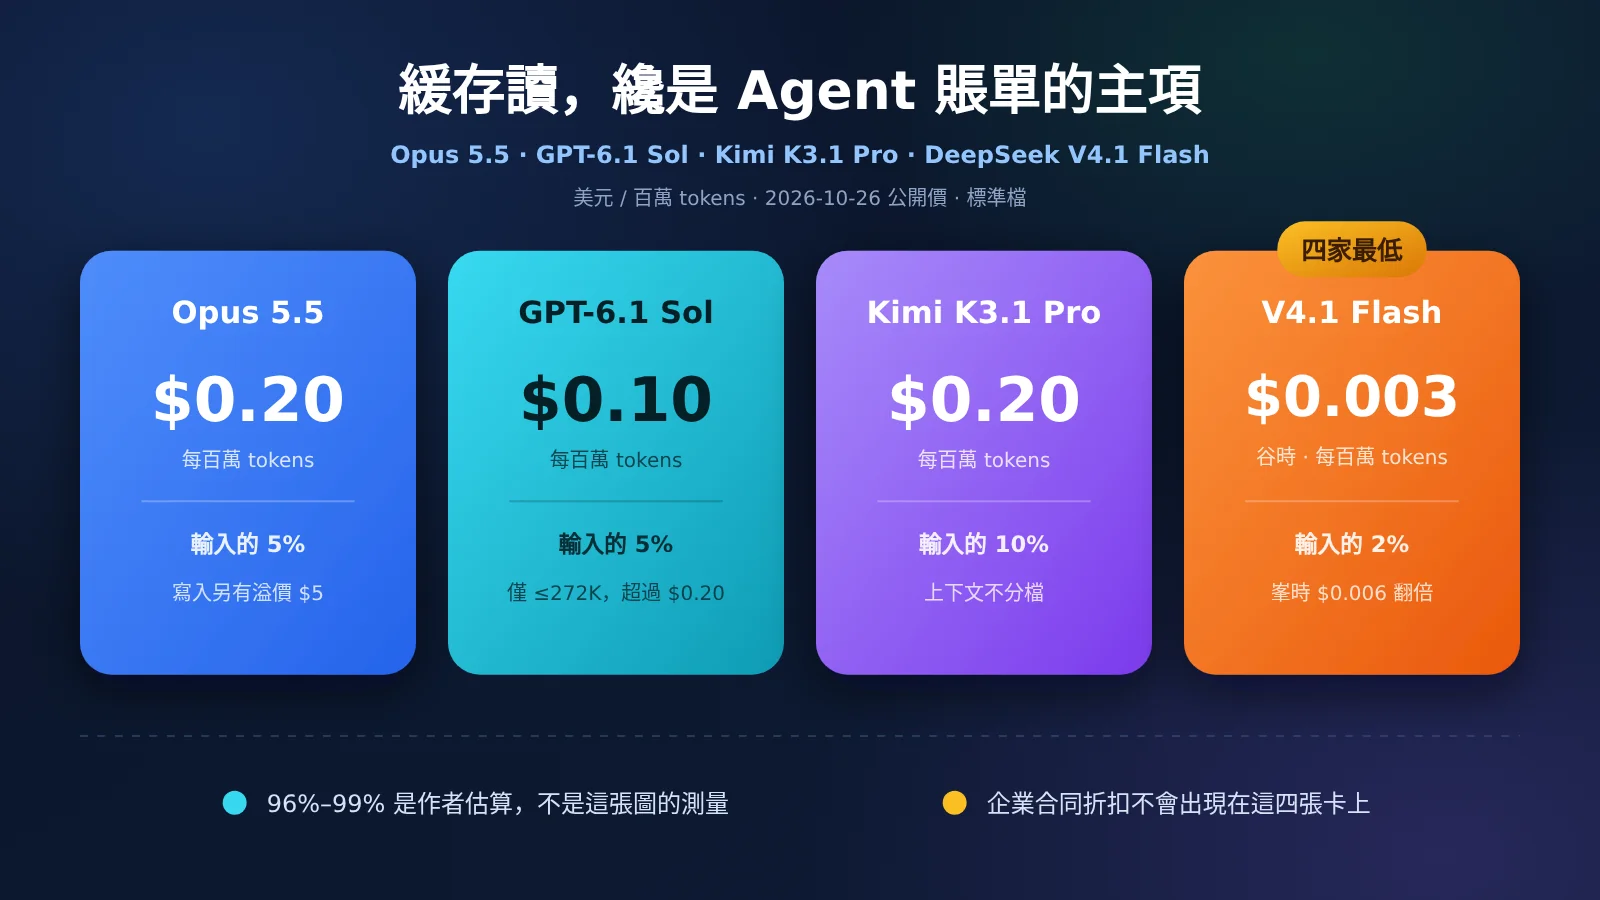
同一窗口裏,現在還能和官方價目表對上的緩存讀是:Claude Opus 5.5 爲 $0.20,GPT-6.1 Sol 在輸入不超過 272K 時爲 $0.10,Kimi K3.1 Pro 爲 $0.20,DeepSeek V4.1 Flash 谷時 $0.003、峯時 $0.006。單位都是美元每百萬 tokens。
這不是一份看起來各有千秋的折中表。 前綴穩定、輸入通常低於 272K 的編碼循環,閉源三家裏先看 GPT-6.1 Sol 的緩存讀。要再低一個數量級,看 DeepSeek 的谷時緩存讀。Opus 5.5 和 Kimi 的緩存讀相同,差別在未命中輸入、輸出和寫入溢價。
核心價值: 看完可以按命中率而不是按輸入價選模型,並知道報道里的企業折扣爲什麼對不上小團隊的賬單。
💡 選擇建議: 四家都可以在 API易 apiyi.com 用同一把 Key 換模型名試跑。新賬號有免費測試額度。先固定前綴,再看用量裏的緩存讀,不要拿一次短對話下結論。
四家緩存讀價格差在哪裏?
先看緩存讀,再看它佔未命中輸入的比例。比例決定長會話裏這一列有多“便宜”。Opus 5.5 和 GPT-6.1 Sol 的短上下文都是輸入價的 5%,Kimi K3.1 Pro 是 10%,DeepSeek V4.1 Flash 是 2%。絕對價差比這個比例更大:谷時 Flash 的 $0.003,是 Sol 短上下文 $0.10 的 1/33,是 $0.20 的 1/67。
| 模型 | 緩存讀 | 佔未命中輸入 | 未命中輸入 | 輸出 |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol,輸入 ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol,輸入 >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash 谷時 | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash 峯時 | $0.006 | 2% | $0.30 | $1.20 |
單位都是美元每百萬 tokens,只取標準檔,不含 Batch、Fast、區域加價。Opus 5.5 來自 Anthropic 價目表,緩存命中按輸入的 0.05 倍計價。GPT-6.1 Sol 來自 OpenAI 標準價,短上下文指輸入不超過 272K tokens,超過後緩存讀、輸入、輸出一起跳檔,輸出是 $15 而不是 $20。Kimi 來自 Moonshot 公開卡片,上下文不分檔。DeepSeek 來自官方定價頁,模型名是 deepseek-flash,版本 DeepSeek-V4.1-Flash-1017。峯時是週一到週五 UTC 01:00–04:00 和 06:00–10:00,不含中國法定節假日,換算成北京時間是 09:00–12:00 和 14:00–18:00。兩段之間的 12:00–14:00 仍是谷時。週末和中國法定節假日全天按谷時。
API易 的模型價格頁 docs.apiyi.com/models 在 2026-10-25 的目錄裏,claude-opus-5-5 是 $4 / $20 / $0.20,gpt-6.1-sol 是 $2 / $10 / $0.10,並註明超過 272,000 tokens 後輸入變爲 $4,kimi-k3.1-pro 是 $2 / $10 / $0.20。DeepSeek 被拆成兩行:deepseek-v4.1-flash 與 deepseek-flash 是 $0.30 / $1.20 / $0.006,與官方峯時一致;deepseek-v4-1-flash-260910 是 $0.15 / $0.60 / $0.003,與官方谷時一致。官方峯谷按請求到達時間切換,目錄把兩套數字做成了不同模型行。調用前以控制檯裏的模型名爲準。
緩存讀只是賬單的一半。寫入價決定前綴一過期要不要再付一次溢價。下表的短檔、長檔不能橫比分鐘數:OpenAI 的短檔已經是 30 分鐘,Anthropic 和 Kimi 的短檔是 5 分鐘。
| 模型 | 短檔寫入 | 長檔寫入 | 前綴怎麼進緩存 |
|---|---|---|---|
| Opus 5.5 | 5 分鐘,$5,輸入的 1.25 倍 | 1 小時,$8,輸入的 2 倍 | 請求裏要帶 cache_control |
| GPT-6.1 Sol,≤272K | 30 分鐘,$2.50,輸入的 1.25 倍 | 12 小時,$5,輸入的 2.5 倍 | 價目表單列寫入;前綴必須穩定 |
| Kimi K3.1 Pro | 5 分鐘,$2,等於輸入價 | 1 小時,$4,按 2 倍推算 | 默認自動,5 分鐘;更長間隔要指定 1 小時 |
| V4.1 Flash | 無單獨寫入價 | 無 | 第一次按未命中,之後按緩存讀 |
Kimi 官網首頁卡片寫的緩存寫入是 $2,對應默認 5 分鐘檔。1 小時檔 $4 來自 API易 Kimi 文檔裏的配置價,該頁寫明緩存檔位尚未在當輪實測裏驗證結算。上一代 Kimi K3 的官方說明裏,1 小時寫入是 5 分鐘的 2 倍,K3.1 Pro 按同一倍率就是 $4。控制檯若不一致,以控制檯爲準。高速版 kimi-k3.1-pro-highspeed 的輸入和輸出翻倍,緩存讀仍是 $0.20。前綴命中很多時,兩檔的差距會被縮小。
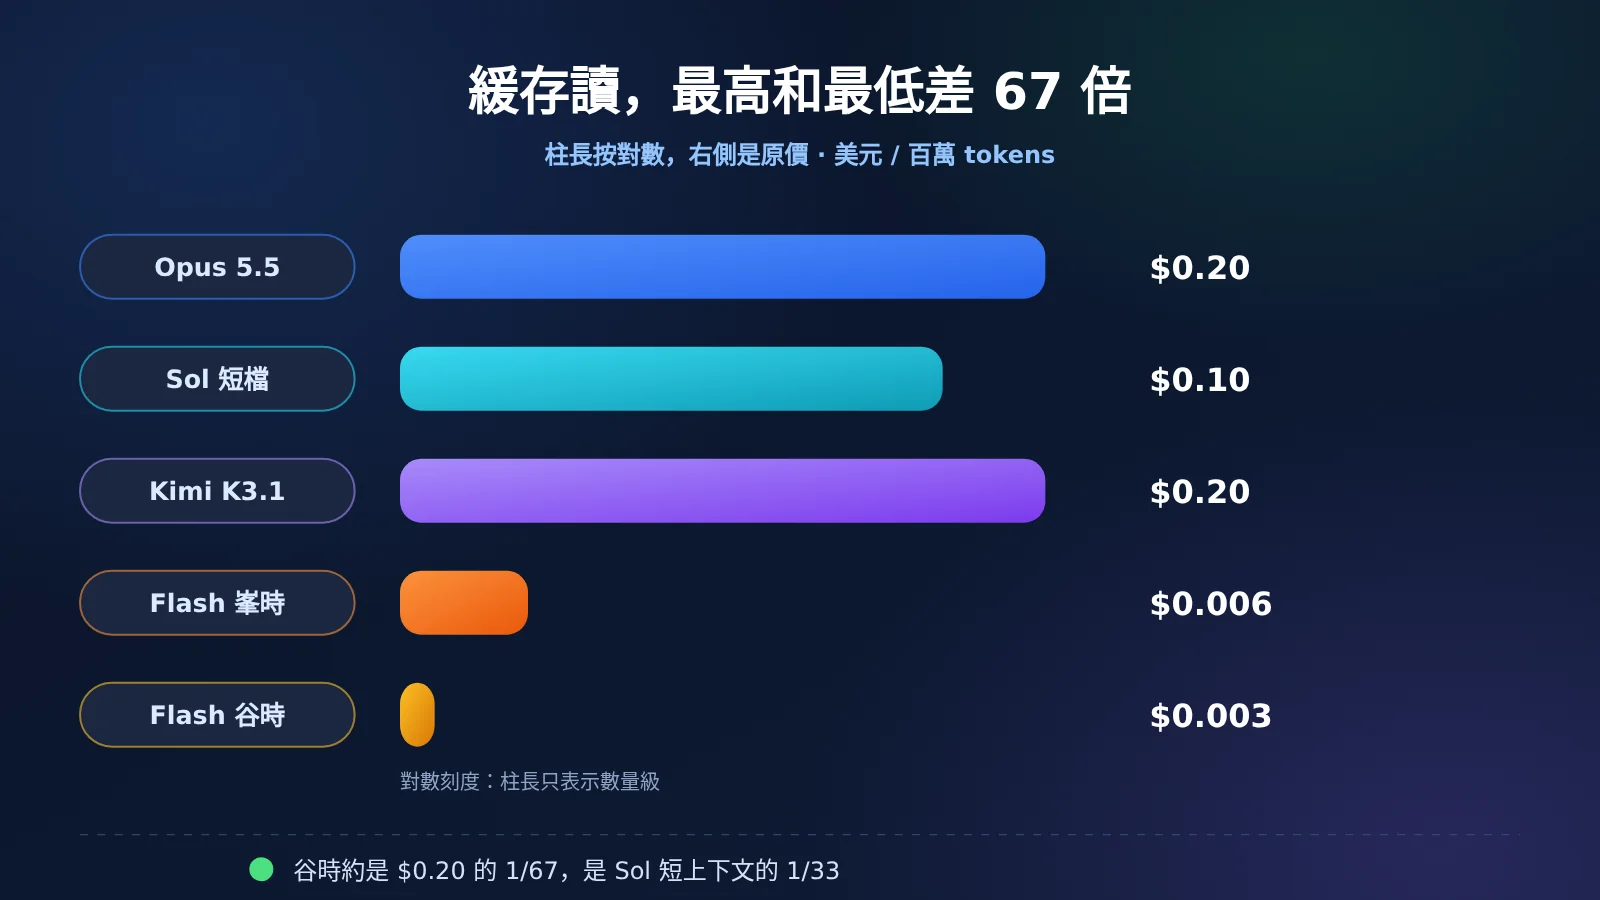
圖裏的柱長只幫助看數量級。結算仍用原價乘 token 數。同一把 Key 換模型之後,以 API易 控制檯的緩存讀列爲準,不要用這張圖估算金額。
寫代碼 Agent 的賬單爲什麼要單列緩存讀?
Agent 每一輪都會把系統提示、工具定義和此前對話再送一遍。前綴沒變的部分,有機會按緩存讀計價。前綴變了,從變化的那個位置往後按未命中,有的廠商還要再付寫入。所以輸入價下降 20%,不代表一輪編碼的賬單下降 20%。緩存讀若是 token 裏最大的一堆,該看的就是緩存讀那一列。
Max Woolf 的 96%–99% 說的是“總 token 花費”。英文 expenditure 可以理解成錢,也可以理解成 token 消耗。原文沒有給出分母。另一份第三方測量把口徑寫清楚了:WorkloadBench 在 2026-10-16 更新,長時編碼任務裏,提示詞 token 有 89%–96% 來自緩存。GPT-6.1 Sol 與 Claude Opus 5.5 的中位數都是 95%,範圍分別是 91%–98% 和 94%–99%。來源是 workloadbench.brenhq.com/cache。那是提示詞 token 的佔比,分母不含輸出,更不是美元佔比。兩份材料不能加成一個“賬單的 96%”。
美元佔比通常更低,因爲輸出單價是緩存讀的幾十倍到上百倍。下面用一組寫明的假設重算,只爲看結構,不是作者的原始明細,也不是本文跑出來的日誌。假設 40 輪,每輪緩存讀 120,000 tokens,新增未命中 1,500 tokens,輸出 800 tokens,會話開始另有 40,000 tokens 寫入一次。這 40,000 不重複計入未命中。DeepSeek 沒有寫入價,這 40,000 按未命中記。每輪輸入大約 12 萬,落在 Sol 的短上下文檔。
token 合計 4,932,000,其中緩存讀 4,800,000,約佔 97%。這隻說明在“前綴長、輪次多、單輪輸出短”的假設下,token 個數可以落到作者說的區間附近。
| 模型 | 緩存讀 | 未命中 | 輸出 | 寫入或首次未命中 | 合計 | 緩存讀佔美元 |
|---|---|---|---|---|---|---|
| Opus 5.5,5 分鐘寫入 | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | 約 47% |
| GPT-6.1 Sol,≤272K,30 分鐘寫入 | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | 約 47% |
| Kimi K3.1 Pro,5 分鐘寫入 | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | 約 65% |
| V4.1 Flash 谷時 | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | 約 30% |
| V4.1 Flash 峯時 | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | 約 30% |
Opus 與 Sol 的短上下文四項單價正好是 2 倍關係,所以佔比相同,合計正好是一半。Kimi 的緩存讀是輸入的 10% 而不是 5%,同樣的 token 結構裏,緩存讀佔到約 65%,合計 $1.48,介於兩者之間。Flash 谷時合計大約 $0.049,峯時翻倍。因爲緩存讀只有未命中的 2%,這組假設里美元大頭回到輸出,大約四成,緩存讀大約三成。旗艦三家裏,緩存讀仍是這張示意賬單裏最大的一筆。Flash 省的是整張賬單的數量級,不是同一套 96% 的美元結構。
前綴若每輪都在變,上表作廢。時間戳、隨機排的工具列表、插在系統提示中間的用戶名,都會把命中打掉。那時要比的是未命中價和寫入價。Opus 的 5 分鐘寫入是輸入的 1.25 倍,Sol 的 30 分鐘寫入也是 1.25 倍,12 小時寫入是 2.5 倍。Kimi 的 5 分鐘寫入等於輸入價,沒有短檔溢價。DeepSeek 第一次就是未命中價。
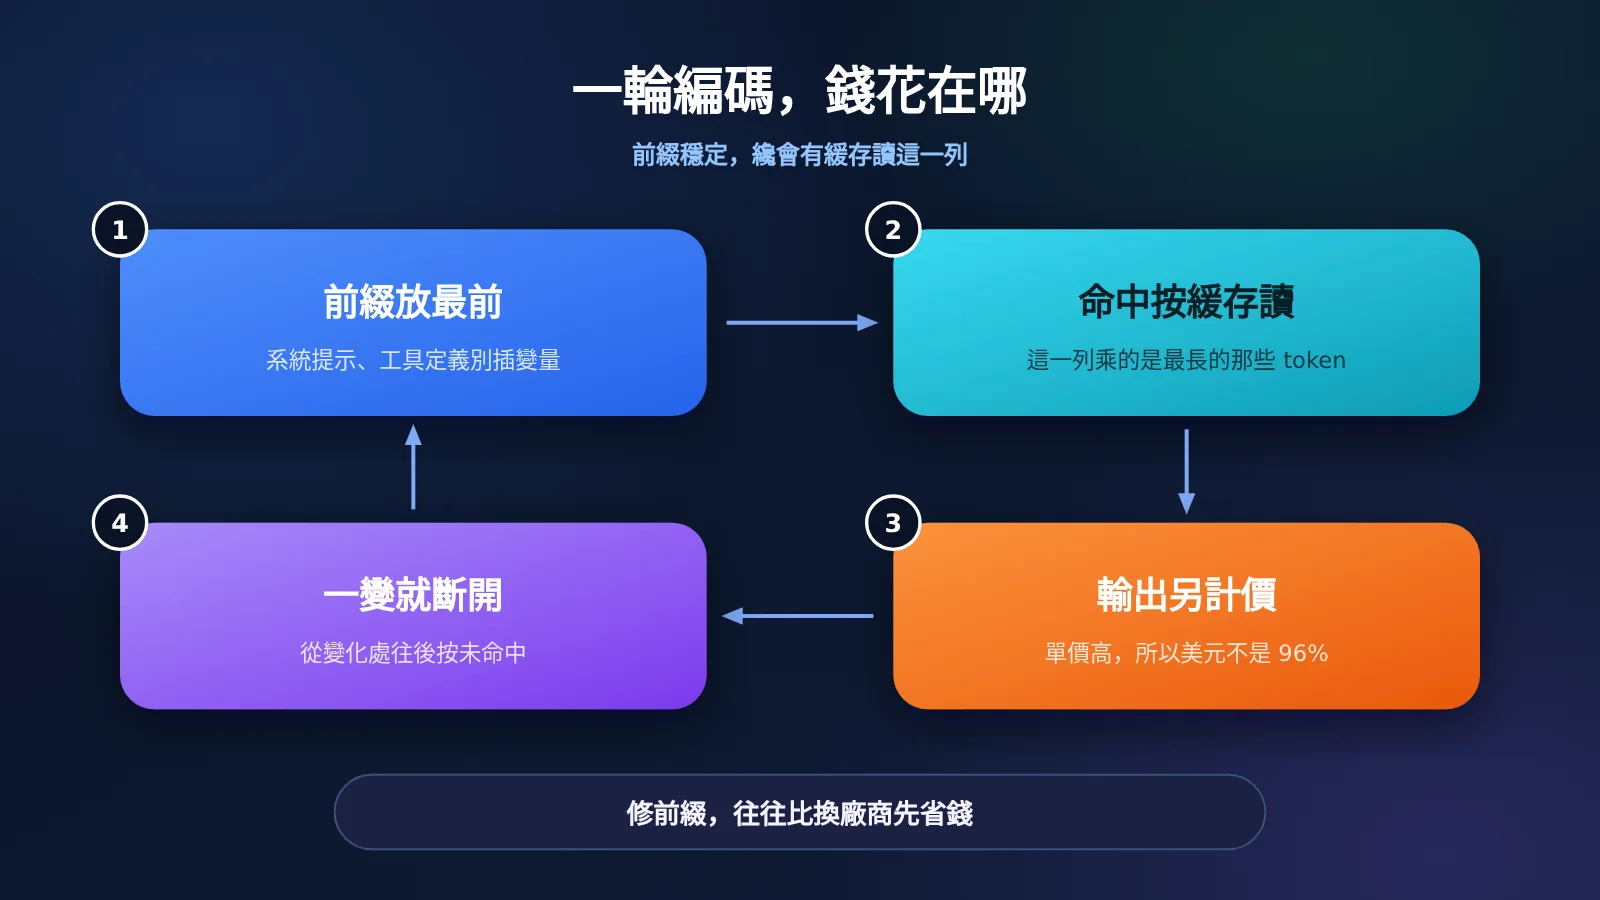
修前綴往往比換廠商更先省錢。工具列表保持順序穩定,動態內容放到消息末尾,同一會話的間隔不要超過短檔 TTL。這些做完,再拿緩存讀單價做選擇。
這四個月的降價時間線說明了什麼?
“最多降了 80%”有兩處對得上,都不要理解成所有模型統一打兩折。第一處是 Max Woolf 所記:2026-07-30,OpenAI 把 GPT-5.6 Luna 從 $1 / $6 / $0.10 降到 $0.20 / $1.20 / $0.02,輸入和緩存讀都是大約 80%。第二處是 Sol 這條產品線的緩存讀,從 2026-06-26 GPT-5.6 Sol 的 $0.50,到 2026-09-29 GPT-6.1 Sol 的 $0.10,也是 80%。型號已經從 5.6 換成 6.1,不是同一 SKU 貼了一張八折標籤。
| 日期 | 他記錄的變動 | 輸入 / 輸出 / 緩存讀 |
|---|---|---|
| 2026-06-26 | OpenAI 發佈 GPT-5.6 Sol 與 Luna | Sol $5 / $30 / $0.50 |
| 2026-06-30 | Anthropic 發佈 Sonnet 5,當時稱開賣價是臨時的 | $2 / $10 / $0.20 |
| 2026-07-24 | Anthropic 發佈 Opus 5 | $5 / $25 / $0.50 |
| 2026-07-30 | GPT-5.6 Luna 降價 | $0.20 / $1.20 / $0.02 |
| 2026-08-21 | GPT-5.6 Sol 臨時降約 20%,爲期三個月 | $4 / $20 / $0.40 |
| 2026-09-01 | Fable 5.1,緩存讀低於 6 月的 Fable 5 | $10 / $50 / $0.25 |
| 2026-09-22 | 同一天發佈 GPT-6 Sol 與 Opus 5.5 | Sol $2 / $10 / $0.20;Opus 5.5 $4 / $20 / $0.20 |
| 2026-09-29 | GPT-6.1 Sol,緩存讀再減半 | $2 / $10 / $0.10 |
上表是 Max Woolf 的整理,三列順序都是輸入、輸出、緩存讀。本文覈對過的是結尾兩行的現價:Opus 5.5 的 $4 / $20 / $0.20 與 Anthropic 價目表一致;GPT-6.1 Sol 的 $2 / $10 / $0.10 與 OpenAI 標準檔、短上下文一致。更早的幾行沒有逐條翻公告,引用時請回到他的原文。
他對 Opus 5.5 還有一句總成本降 40%–60%。官方價目表能覈對的是三項單價:相對 Opus 5,輸入和輸出各降 20%($5 到 $4,$25 到 $20),緩存讀從 $0.50 降到 $0.20,降了 60%。40%–60% 是他按使用結構估算的區間,不是官方的統一折扣。Anthropic 的原話是 Opus 5.5 的推理計算少於 Opus 5,定價反映了這一點。這句話是廠商自述。
他還寫道,DeepSeek V4.1 Flash 在 DeepSeek 自己的接口上大約是 $0.15 / $0.60 / $0.003。這組數字與官方谷時一致,峯時要翻倍。Kimi K3.1 Pro 他寫成 $2 / $10 / $0.20,與官網卡片一致。文中的 Artificial Analysis 分數,Kimi 55、Opus 5.5 爲 58、Flash 爲 45,是第三方指數,不是本文的編碼評測,選型不要只看這三分。
小團隊拿不到企業折扣時怎麼選模型?
公開價之外,還有一層只有大客戶看得到的折扣。AI Weekly 在 2026-10-24 轉述 The Information:OpenAI 給出 30% 以上的折扣,拿下一份每年超過 1 億美元的合同,Replit 把大部分 AI 支出從 Anthropic 轉到 OpenAI。報道稱 Anthropic 沒有延續此前給 Replit 的折扣。報道沒有附上這三家的公開確認。Replit CEO Amjad Masad 在 TechCrunch Disrupt 上的說法是,決定基於成本、合作關係和性能。同一報道還寫道,Claude 型號仍可選用,OpenAI 成爲 Agent 的默認。同文提到 Rippling 的編碼用量從 Anthropic 轉向 OpenAI,對方把原因歸於成本。這些都是報道,不是三家聯合發佈的價目。
小團隊對不上這種合同。沒有每年 1 億美元的承諾,就換不來報道里的 30%。即便把 30% 機械地打在 Opus 的緩存讀上,$0.20 變成 $0.14,仍然高於 GPT-6.1 Sol 短上下文的公開價 $0.10。報道沒有寫明折扣打在緩存讀、未命中還是總價上,這個比較只說明數量級:公開的緩存讀價,已經夠小團隊做第一輪選擇。
| 會話特徵 | 先看誰 | 原因 |
|---|---|---|
| 前綴穩定,輸入通常低於 272K,要閉源編碼模型 | GPT-6.1 Sol | 緩存讀 $0.10,三家裏最低 |
| 單次輸入會超過 272K | 不要沿用 $0.10 | Sol 緩存讀變爲 $0.20,輸出變爲 $15 |
| 緩存讀預算與 Opus 相同,希望未命中和輸出更低 | Kimi K3.1 Pro | 緩存讀同爲 $0.20,輸入輸出是 $2 / $10,且不分檔 |
| 命中率高,任務能避開峯時 | DeepSeek V4.1 Flash 谷時 | 緩存讀 $0.003,賬單差一個數量級 |
| 必須卡在工作日北京時間 9 點到 12 點、14 點到 18 點 | 按峯時重算 Flash | 緩存讀 $0.006,其餘單價也翻倍 |
| 前綴每輪都在變 | 先改前綴 | 緩存讀列用不上 |
能力不在這張表裏排序。Max Woolf 認爲 Opus 5.5 強於更貴的 Fable 5.1,這是他的使用判斷。DeepSeek 官方寫明 deepseek-flash 現在由 DeepSeek-V4.1-Flash-1017 承接,舊的 deepseek-v4-flash 名字仍可用、按 Flash 計價,而 deepseek-v4-pro 仍單獨在賣。官方沒有給出 Flash 與 Pro 的能力排序。失敗成本高於 token 差價時,用貴的模型。失敗成本低於差價時,用 Flash 把循環跑完。
💰 成本優化: 目錄價是默認標價。API易 apiyi.com 的控制檯會按所在分組顯示折後價,充值活動另計,規則寫在價格頁上。那是公開規則,不是銷售談下來的年框合同。實際扣費以控制檯爲準。
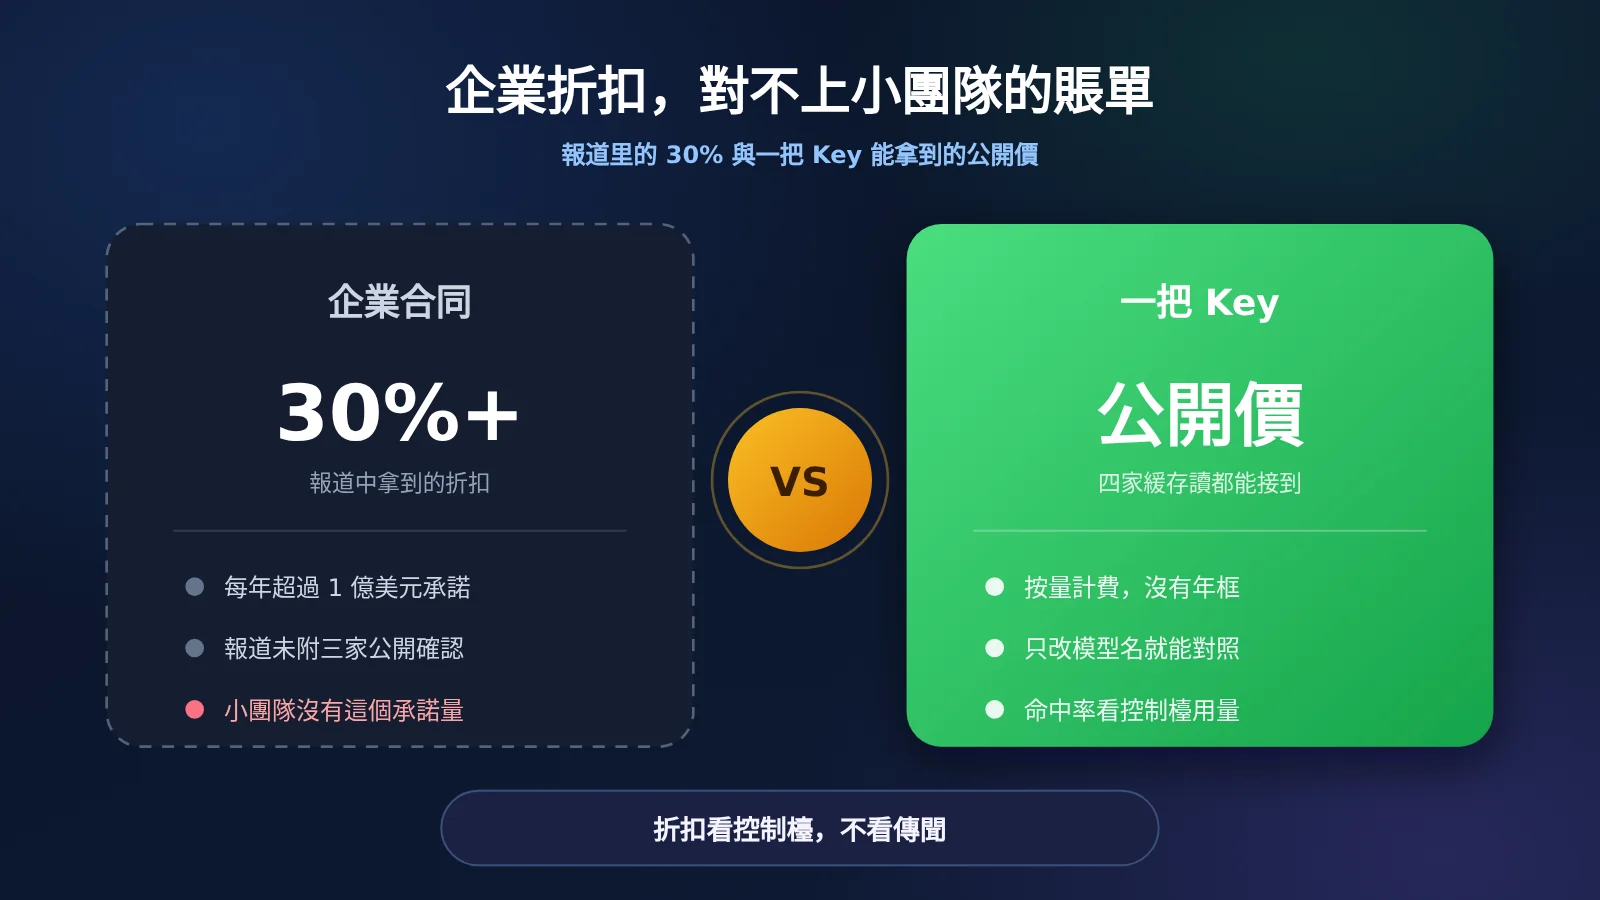
左半邊的 30% 和 1 億美元來自報道,不能當成可下單的價格。右半邊纔是小團隊能執行的路徑。
怎樣用一個 Key 覈對四家的緩存讀?
價格頁建議,GPT-5 及以後的模型優先走 /v1/responses,多輪緩存更容易命中。Chat Completions 仍可用。下面的示例用 Chat Completions,是爲了 gpt-6.1-sol、kimi-k3.1-pro、deepseek-flash 可以只改模型名。Opus 5.5 的緩存不是這條路徑的默認行爲。Anthropic 現在的開啓方式,是在請求頂層放一個 cache_control,或把斷點放在內容塊上。API易 對 claude-opus-5-5 同時提供 chat 和 messages。要緩存計價,走 messages,並帶上 cache_control。只用 Chat Completions 時,不要把目錄上的 $0.20 當成已經生效。
- 裝好基礎件: 沒裝過 SDK 就先跑一次
pip install openai;文件開頭寫import os和from openai import OpenAI。Key 放進環境變量APIYI_API_KEY,不要寫進倉庫。 - 建客戶端: 一行
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"),根地址只改這一處。 - 固定前綴:
STABLE_PREFIX裝系統提示和工具定義,逐字不改;user_turn裝這一輪新增的動態內容,永遠排在最後一條。 - 發請求:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}])。把model換成kimi-k3.1-pro或deepseek-flash,就是另外兩家。 - 讀用量: 先
details = resp.usage.prompt_tokens_details,再cached = getattr(details, "cached_tokens", 0) or 0,最後print(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens),三個數依次是提示詞 token、命中緩存 token、輸出 token。
連續跑多輪,用命中 token 除以提示詞 token,就是你自己的命中率。再用各家的緩存讀單價乘命中量,纔是這一列的美元。Kimi 文檔寫明其緩存檔是配置價,結算以控制檯爲準。DeepSeek 若要谷時那一檔,模型名改看目錄裏的 deepseek-v4-1-flash-260910,不要假設 deepseek-flash 會隨時鐘自動改價。
Key 放在環境變量 APIYI_API_KEY,不要寫進倉庫。免費測試額度適合把同一段前綴在四個模型名上各跑幾輪,只比較用量結構。能力不夠時再加輪次,而不是先把四家都跑滿一個長倉庫。
緩存讀對比的常見問題
Q1:96% 是不是說緩存讀佔了賬單金額的 96%?
不是本文的結論。Max Woolf 寫的是緩存讀佔總 token 花費的 96%–99%,沒有公開分母,屬於第三方估算。WorkloadBench 測到的是提示詞 token 的 89%–96%,不含輸出。按本文的示意假設,token 約佔 97%,美元在 Opus 和 Sol 上大約 47%,在 Kimi 上大約 65%,在 Flash 上大約 30%。
Q2:爲什麼 Sol 的緩存讀有時是 $0.10,有時是 $0.20?
看單次請求的輸入長度。不超過 272K tokens 時,OpenAI 標準檔緩存讀是 $0.10。超過之後是 $0.20,同時未命中輸入變爲 $4,輸出變爲 $15。API易 目錄行寫的是短上下文的 $2 / $10 / $0.10,並註明超過 272,000 tokens 後輸入變爲 $4。長上下文的輸出和緩存讀以 OpenAI 標準檔爲準,控制檯若分檔顯示,以控制檯爲準。
Q3:DeepSeek 爲什麼有兩套緩存讀?
官方按峯谷計價,谷時是峯時的一半。谷時緩存讀 $0.003,峯時 $0.006。峯時是工作日北京時間 09:00–12:00 和 14:00–18:00,已從官方的 UTC 窗口換算,不含中國法定節假日。週末和節假日全天是谷時。API易 目錄用兩個模型行分別列出這兩套數字。
Q4:企業客戶的 30% 折扣,小團隊能不能申請到?
報道里的折扣綁在每年超過 1 億美元的合同上,而且報道里沒有三家的公開確認。小團隊沒有這個承諾量。比較公開的緩存讀價,已經能做第一輪選擇。分組折後價和充值活動以 API易 控制檯爲準,不要把它們說成同一份企業折扣。
Q5:怎樣用一個 Key 把四家都接上?
在 API易 apiyi.com 建一把 Key,請求根地址用 `https://api.apiyi.com/v1`。`gpt-6.1-sol`、`kimi-k3.1-pro`、`deepseek-flash` 可以走 Chat Completions,只改模型名。`claude-opus-5-5` 要緩存計價時走 `messages`,並帶 `cache_control`。GPT-5 及以後若要更高的多輪命中,價格頁建議改走 `/v1/responses`。
Q6:緩存讀便宜,是不是就該把默認模型換成 Flash?
只在失敗成本低於差價時。谷時示意賬單大約是 Sol 的二十分之一量級($0.0486 對 $1.02),峯時大約十分之一。若 Flash 多跑幾輪才能完成同一件事,輪次會把差價喫回去。先用免費額度在同一前綴上對比完成輪次,再決定默認模型。
Q7:寫入價會不會比緩存讀更貴?
前綴經常過期、命中次數很少時會。Opus 和 Sol 的短檔寫入都是輸入的 1.25 倍,Sol 的 12 小時檔是 2.5 倍。Kimi 的 5 分鐘寫入等於輸入價。命中兩三輪之後,緩存讀才變成主要項。間隔不穩定的任務,先把 TTL 選對,再比緩存讀。
緩存讀對比的核心要點
- 96% 是第三方估算: Max Woolf 沒有公開日誌。美元佔比要自己乘單價。
- 先看緩存讀,再看是否跳檔: Sol 超過 272K 後,緩存讀從 $0.10 變爲 $0.20。
- Opus 和 Kimi 的緩存讀同爲 $0.20: Kimi 的未命中和輸出更低,短檔寫入沒有溢價。
- Flash 的優勢是數量級: 谷時 $0.003,峯時 $0.006,美元結構不再由緩存讀獨佔。
- 企業 30% 對不上小團隊: 那是報道中的年框。公開價已經夠做第一輪選擇。
- 一把 Key 只負責接上四家: 在 API易 apiyi.com 換模型名,命中率以控制檯用量爲準。
總結
這四個月裏,公開降價最多到 80%,落點主要在 Luna 的標價,以及 Sol 產品線的緩存讀從 $0.50 到 $0.10。寫代碼的 Agent 仍要把緩存讀單列出來。按 2026-10-26 的官方價,短上下文裏 GPT-6.1 Sol 的緩存讀是 $0.10,Opus 5.5 和 Kimi K3.1 Pro 是 $0.20,DeepSeek V4.1 Flash 谷時 $0.003、峯時 $0.006。96%–99% 只作爲 Max Woolf 的說法引用。示意賬單裏,token 可以接近這個區間,美元則要低一截。
報道中的企業折扣需要年承諾,小團隊拿不到。把四家接到同一把 Key 上,用自己的命中率乘公開的緩存讀價,比等待一份 30% 的合同更直接。推薦在 API易 apiyi.com 上先跑同一段穩定前綴,再決定默認模型。
作者: APIYI 技術團隊
技術交流: 歡迎通過 APIYI 網站首頁聯繫。模型單價以 docs.apiyi.com 文檔中心的模型價格頁爲準。
參考資料
- Max Woolf,降價時間線與 96%–99% 的估算
- 鏈接:
minimaxir.com/2026/10/cheap-llms -
說明: 2026-10-25。96%–99% 是作者自己的說法,不是本文實測。
-
Anthropic 模型價格
- 鏈接:
platform.claude.com/docs/en/about-claude/pricing -
說明: Opus 5.5 的輸入、輸出、緩存讀和兩檔寫入。
-
OpenAI 模型價格
- 鏈接:
developers.openai.com/api/docs/pricing -
說明: GPT-6.1 Sol 的短上下文、長上下文、緩存讀和寫入。272K 爲官方短、長分界。
-
DeepSeek 模型價格
- 鏈接:
api-docs.deepseek.com/quick_start/pricing -
說明:
deepseek-flash的峯谷命中價、未命中價和輸出價。 -
Kimi API
- 鏈接:
platform.kimi.ai -
說明: Kimi K3.1 Pro 的輸入、輸出、緩存命中和默認寫入價。
-
AI Weekly 對 Replit 合同的轉述
- 鏈接:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
說明: 30% 以上折扣和每年超過 1 億美元,來自對 The Information 的報道,條款未經三家公開確認。
-
WorkloadBench 的緩存 token 佔比
- 鏈接:
workloadbench.brenhq.com/cache - 說明: 2026-10-16。提示詞 token 來自緩存的比例,不是美元佔比。