Claude Fable 5.2 は2026年11月9日にリリースされ、標準APIの料金は5.1より20%安くなりました。
その結果、多くのチームがすぐにこう考えるでしょう。安くなったのなら、最初からmaxにしてもよいのでは?
この記事では、Fable 5.2 highとFable 5.2 maxを同じ枠組みで比較し、品質とタスクあたりのコストの両方を確認します。
この記事でわかること:Fable 5.2のhighとmaxがそれぞれどのような条件に適しているかがわかります。また、アップグレードの受け入れ判定にそのまま使える記録用チェックリストも紹介します。
目次
- 用語解説:Fable 5.2のティア選択に関する用語
- 1 Fable 5.2のhighとmaxでは、異なる単価が変わる
- 2 Fable 5.2の品質とコストを同じ表で比較する
- 3 独立機関のデータでFable 5.2のティアごとの傾向を確認する
- 4 タスクの用途に応じてFable 5.2のティアを選ぶ
- 5 自社の受け入れ判定でFable 5.2をmaxにアップグレードするか決める
- よくある質問(FAQ)/ 重要なポイント / まとめ
知っておきたい用語
| 用語 | 意味 | 本文を読むときの注意点 |
|---|---|---|
| Effort | モデルの思考への投入量を調整する設定 | Fable 5.2 の API でのデフォルト値は high |
| Adaptive thinking | モデルが思考量を自動で割り当てる仕組み | Fable 5.2 では常に有効 |
| Harness | モデルにツール、セッション、実行ルールを提供する実行環境 | Cursor と AA では Harness が異なる |
| Intelligence Index | AA が複数の評価を加重して算出する総合指数 | 正解率ではなく、指数 |
| ポイント | 2つのパーセンテージの差から求める絶対差 | 56.9% から 60.0% への上昇は 3.1 ポイント |
| タスクあたりのコスト | あるテスト条件で、1つのタスクに割り当てられるモデル料金 | 実際の API 請求額とは異なる |
| 受け入れ基準 | タスクで満たす必要がある品質要件 | まず基準を満たし、その後で予算を比較する |
| タスクの階層化 | 難易度や失敗時のコストに応じてタスクを分類すること | 階層ごとに適した設定が異なる |
1 Fable 5.2 の high と max では、変わるものが異なる
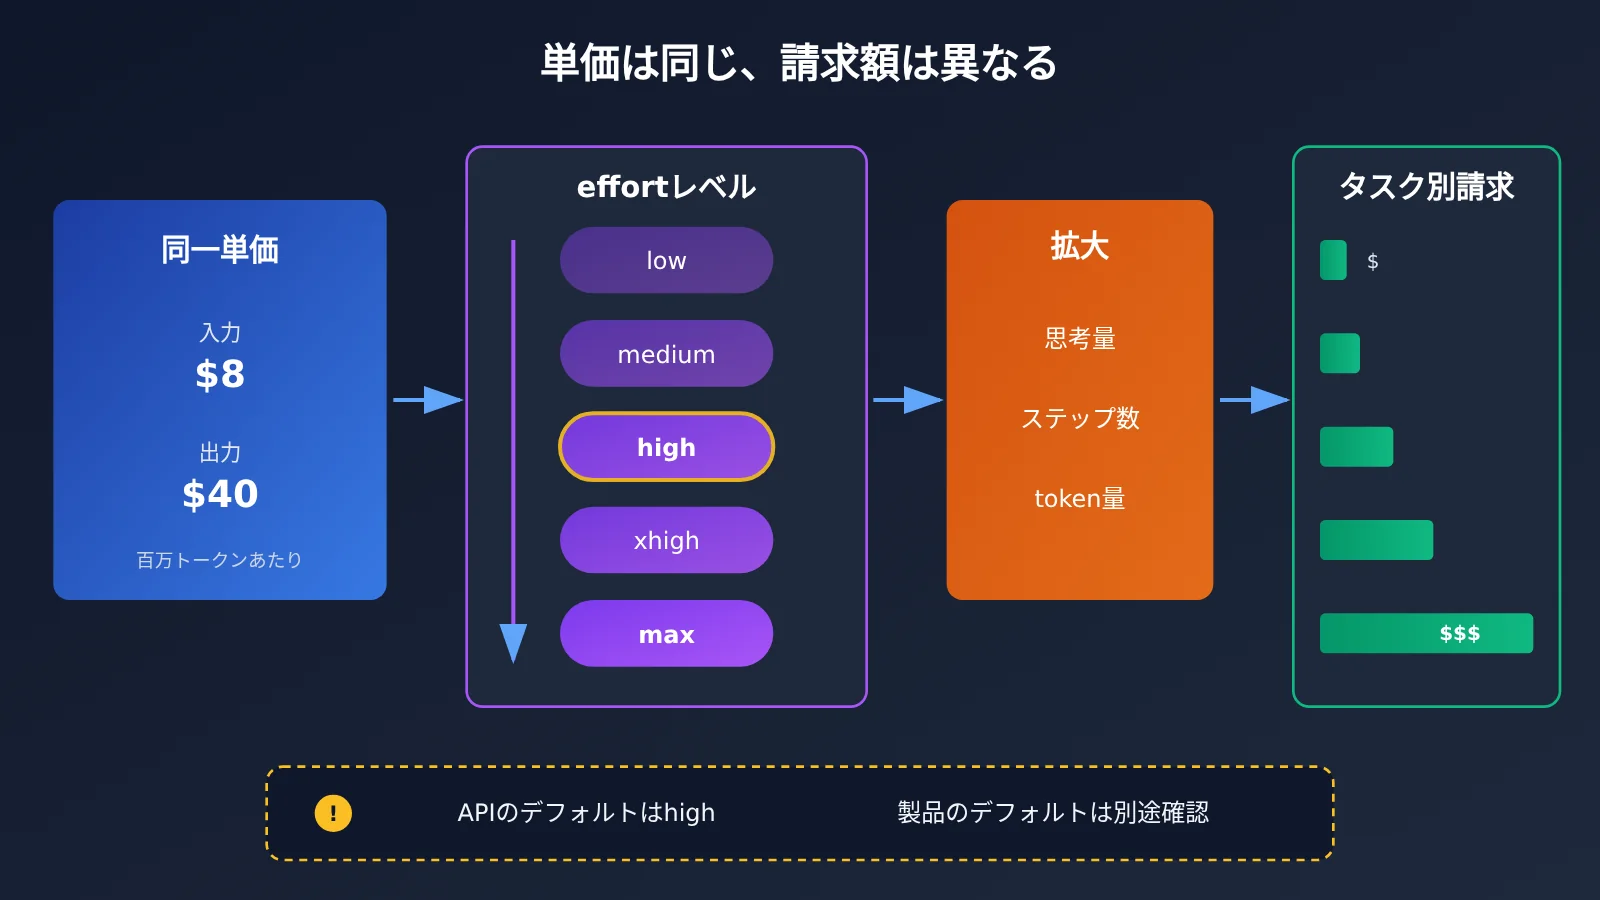
設定レベルが高くなるほど、単価も高くなると思っている人は少なくありません。しかし、Anthropic の公式標準料金では、Fable 5.2 の入力は100万トークンあたり8ドル、出力は100万トークンあたり40ドルで、単価は設定レベルによって変わりません。
Effort によって変わるのは、モデルが1つのタスクにどれだけ思考を投入するか、また、何ステップ実行するか、どれくらい時間がかかるか、何トークン消費するかです。つまり、単価は同じでも、タスクごとの請求額には数倍の差が生じることがあります。
Fable 5.2 の設定レベルが請求額に与える影響
Fable 5.2 では Adaptive thinking が常に有効で、Effort は思考への投入量の上限や傾向を決めます。設定レベルを上げると、モデルは通常、より多くの推論やツール呼び出しを行い、それに伴って課金対象のトークンも増加します。
入力トークンがどちらも10万の場合でも、出力トークンが2万から4万に増えると、5.2 の標準モードの料金は1.60ドルから2.40ドルに上がります。これは、5.1 で元の使用量だった場合の2ドルを上回ります。
また、2種類の「デフォルト値」を区別する必要があります。公式のモデルドキュメントによると、API での Effort のデフォルト値は high です。一方、Cursor のような製品には独自の設定レイヤーがあります。たとえば Cursor のデフォルトコンテキストは300Kで、API ドキュメントに記載された1Mという仕様とは別のレイヤーの値です。
もう1つ注意したいのは、公式のプロンプトガイドが、同じ名前の設定レベルでも、バージョンによって思考量が異なる場合があると説明している点です。5.1 での設定レベルに関する経験を、そのまま5.2に当てはめることはできません。
2 同じ表で見る Fable 5.2 の品質とコスト
CursorBench 4.0 は、Cursor が独自のタスクとツール環境で実施した評価です。汎用的な独立検証ではありませんが、5つの設定を同じハーネスで比較しているため、各設定の相対的な変化を把握するのに適しています。以下のデータは、2026 年 11 月 10 日時点のものです。
| Fable 5.2 の設定 | スコア | タスクあたりのコスト(ドル) | tokens(集計フィールド) | ステップ数 |
|---|---|---|---|---|
| Low | 53.2% | 3.94 | 36,616 | 30 |
| Medium | 54.8% | 4.66 | 44,103 | 35 |
| High | 56.9% | 9.70 | 99,259 | 69 |
| Extra High | 56.3% | 15.48 | 161,251 | 108 |
| Max | 60.0% | 32.79 | 352,794 | 218 |
注:tokens 列はベンチマークページの集計フィールドであり、出力量だけを示すものではありません。出典:CursorBench 4.0。
Fable 5.2 の High から Max:3.1ポイント向上、コストは約3.38倍
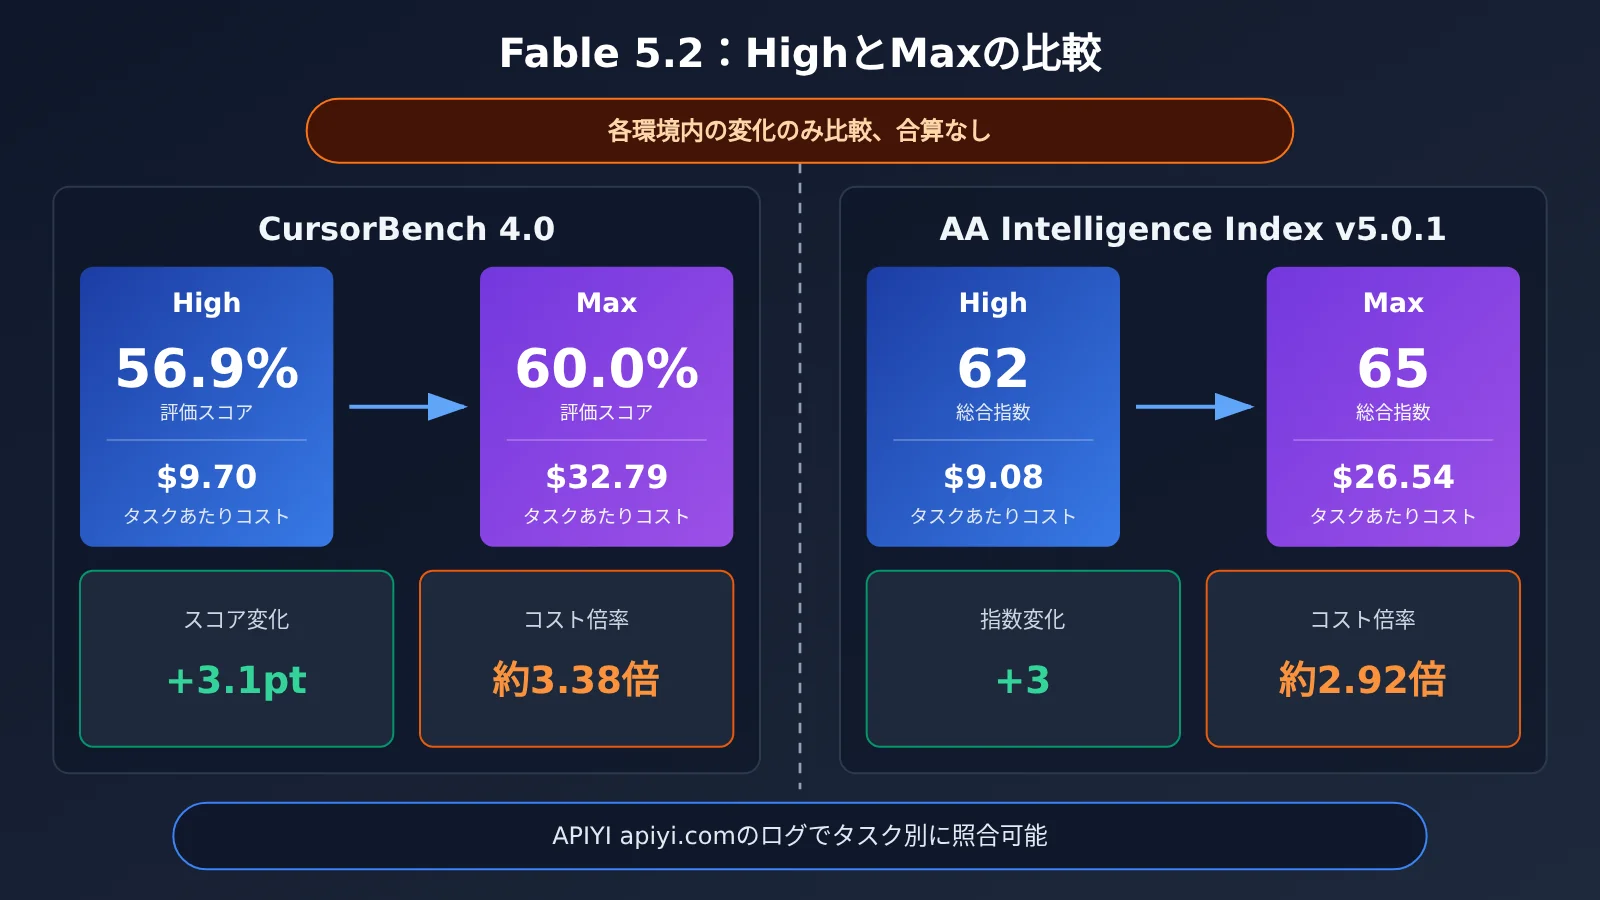
この表では、High から Max にするとスコアは 56.9% から 60.0% へ上がり、3.1ポイント向上しています。一方、タスクあたりのコストは 9.70 ドルから 32.79 ドルへ上がり、約3.38倍、つまり約238%増加しています。
この記事で計算したところ、tokens の値は約3.55倍に増え、ステップ数は69から218へ、約3.16倍になっています。コストの上昇は主に、思考と実行のステップが増えたことによるもので、単価とは関係ありません。
このデータからわかるのは、この環境ではスコアの向上に伴ってコストも大幅に増加している、ということです。
Extra High の予想外の結果をどう見るか
表で注目したいのは、Extra High は High より約6割高いにもかかわらず、スコアが0.6ポイント低いことです。
💡 選び方のヒント:比較できるのは同じ表にある設定間の差です。異なる評価の数値を組み合わせて比較することはできません。自分のタスクで同様の比較を再現したい場合は、APIYI apiyi.com の統一インターフェースと呼び出しログを使って照合できます。ただし、まず利用する当日のモデル ID と設定への対応状況を確認してください。
3 独立機関のデータで Fable 5.2 の設定別傾向を確認する
1つの評価環境だけを見ていると、その環境自体の影響を受けた結論になりがちです。独立評価機関である AA のランキングを使えば、Cursor で観察された傾向が別の環境でも見られるかを確認できます。以下は、2026年11月10日時点のスナップショットです。評価方法のバージョンは Intelligence Index v5.0.1 です。
| 設定 | Intelligence Index | タスクあたりのコスト(米ドル) |
|---|---|---|
| Fable 5.2 medium | 56 | 3.80 |
| Fable 5.2 high | 62 | 9.08 |
| Fable 5.2 xhigh | 62 | 14.83 |
| Fable 5.2 max | 65 | 26.54 |
| Opus 5.5 max | 59 | 10.04 |
65は正答率65%という意味ではありません
AAの評価方法のページによると、v5.0.1の指数は9つの評価で構成され、4種類の能力にそれぞれ25%の重みが割り当てられています。したがって、65は総合指数のスコアであり、正答率65%ではありません。AAの環境では、highからmaxに上げると指数は3増加し、タスクあたりのコストは約2.92倍になります。highとxhighがどちらも62なのは、総合スコアが同じというだけで、タスクごとの振る舞いが完全に一致するわけではありません。
2つの環境は、それぞれの中で比較する
どちらの環境でも、「maxのスコアが高く、コストはhighの約3倍」という傾向が見られます。これは、傾向が相互に裏付けられていると考える材料になります。ただし、AAとCursorではタスク、評価方法、コストの算出方法が異なるため、AAの65とCursorの60.0%を合算して1つの正答率にすることはできません。
4 タスクの用途に合わせて Fable 5.2 の推論レベルを選ぶ
公式のプロンプトガイドでは、まず API の設定をデフォルトの high にして、自分たちの評価結果に応じて上げ下げする方法が推奨されています。medium は対話型の用途に適しており、xhigh は追加の効果が確認できた、難易度の高い長時間タスク向けです。max は能力の上限を評価するときや、時間とトークンを気にする必要がない一部のタスクに使います。低いレベルでは、タスクが早期に終了してしまうリスクにも注意してください。
Fable 5.2 のシナリオ別推奨表
以下の3つは仮定のシナリオであり、選び方を説明するためのものです。
| 仮定のシナリオ | 推奨する開始レベル | 上げることを検討するタイミング | 避けたい使い方 |
|---|---|---|---|
| 要件変更(フィールドの変更、API の調整、テストの追加) | medium で評価し、必要に応じて high | medium で早期終了や変更漏れが発生した場合 | 小規模な変更で、デフォルトから max にする |
| 複雑な修正(複数モジュールにまたがるバグ、並行処理の問題) | high | high で受け入れ基準を満たす成功率に達しない場合 | 検証せずに xhigh に上げる |
| 長期的な調査(自由度の高い課題、解決策の検討) | high から開始 | 課題の価値が高く、失敗の影響も大きいうえ、評価によって max の効果が確認できた場合 | すべてのリクエストで max をデフォルトにする |
Fable 5.2 の high が適した場面
- 高い推論能力が求められ、明確な受け入れ基準がある大半の API タスク
- チームで推論レベルの評価体制がまだ整っておらず、公式推奨の開始点が必要な場合
- リクエスト数が多く、タスクごとのコストを抑えたい本番環境の処理
Fable 5.2 の max が適した場面
- 特定の種類の課題に対するモデルの能力上限を評価する場合
- 失敗の損失がモデルの利用料金を大きく上回る、一部の自由度の高い課題
- 自社のサンプルで、max なら合格率が基準を超える一方、high では超えられないことを確認できている場合
🎯 技術的なアドバイス:推論レベルはタスクの種類ごとに選べばよく、リクエストごとに決める必要はありません。公式のベストプラクティスは、まず high で代表的なタスクを一通り実行することです。APIYI apiyi.com 経由で一元的に接続する場合は、本番実行を始める前に、当日のモデル ID、グループ、エンドポイント、effort の対応状況をプラットフォーム上で確認してください。
5 自分の受け入れテストで、Fable 5.2をmaxにアップグレードするか判断する
公開ベンチマークから分かるのは傾向までです。アップグレードする価値があるかどうかは、自分の受け入れテストの結果をもとに判断しましょう。以下の記録項目はそのまま使えます。基本原則は、変更する条件を毎回、モデルのeffort設定だけに絞ることです。
| 記録項目 | 要件 |
|---|---|
| タスクと入力 | 同じタスク群、同じ入力、同じsystemプロンプトを使う |
| ツールの権限 | ツールセットと権限を完全にそろえる |
| モデルとeffort設定 | モデルIDとeffortを記録し、各回で変更するのはeffort設定だけにする |
| 合格基準 | 受け入れ基準を事前に決め、結果を見てから変更しない |
| usage | 入力、キャッシュへの書き込み・読み取り、出力を分けて記録する |
| 所要時間と再試行 | 合計所要時間、再試行回数、早期終了の回数を記録する |
| 実際の請求額 | 公式料金による推定ではなく、プラットフォームのログに記録された実際の請求額を基準にする |
| 失敗事例 | 元の出力を保存し、maxによってどの問題が解決したかを分析する |
Fable 5.2 クイックスタート:まずは usage を記録
以下の最小限のサンプルでは、呼び出しを実行して usage を記録する方法だけを紹介します。この記事では effort パラメーターを引き継ぐ方法は扱いません。Fable 5.2 がプラットフォームで提供されているか、また effort の引き継ぎに対応しているかは、プラットフォームの最新ドキュメントで確認してください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # プラットフォームで当日利用可能と確認されたモデル ID を指定
    messages=[{"role": "user", "content": "按验收标准修复以下函数……"}]
)
print(resp.usage)  # usage を記録し、後で照合できるようにする
記録・照合用のコード全体を表示
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Anthropic の公式標準料金(米ドル/100万 token)。推定用であり、実際の請求額ではありません
RATE_IN, RATE_OUT = 8.0, 40.0

def run_task(task_id: str, prompt: str, model: str, effort_label: str, passed_fn):
    """タスクを実行し、検収記録を1件返します。effort_label は記録用のラベルです。"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    text = resp.choices[0].message.content
    u = resp.usage
    est_usd = u.prompt_tokens / 1e6 * RATE_IN + u.completion_tokens / 1e6 * RATE_OUT
    return {
        "task_id": task_id,
        "model": model,
        "effort": effort_label,
        "passed": passed_fn(text),          # あらかじめ作成した検収関数
        "prompt_tokens": u.prompt_tokens,
        "completion_tokens": u.completion_tokens,
        "est_usd": round(est_usd, 4),       # 推定値
        "seconds": round(time.time() - start, 1),
        "output": text,                     # 失敗したケースの原文を保持
    }

def quota_to_usd(quota: int) -> float:
    """プラットフォームのログでは、quota ÷ 500000 が実際の請求額(米ドル)です。"""
    return quota / 500000
APIYI のログドキュメントには、model_name、prompt_tokens、completion_tokens、quota、duration_for_view、request_id などの項目が記載されています。quota÷500000 が米ドルでの実際の請求額で、other にはグループ倍率などの補足情報が含まれます。request_id を使って検収記録とログを紐付ければ、単発リクエストの費用だけを見るのではなく、「タスクをクリアできた場合」の実際のコストを計算できます。
🚀 クイックスタート:まずは小規模なサンプルで手順を検証したい場合は、APIYI(apiyi.com)に登録し、新規ユーザー向けの無料テスト枠を使ってみましょう。「同じタスク・一度に変える変数は1つ・実際の請求額を記録」という方法を試してから、サンプル数を増やすか判断できます。
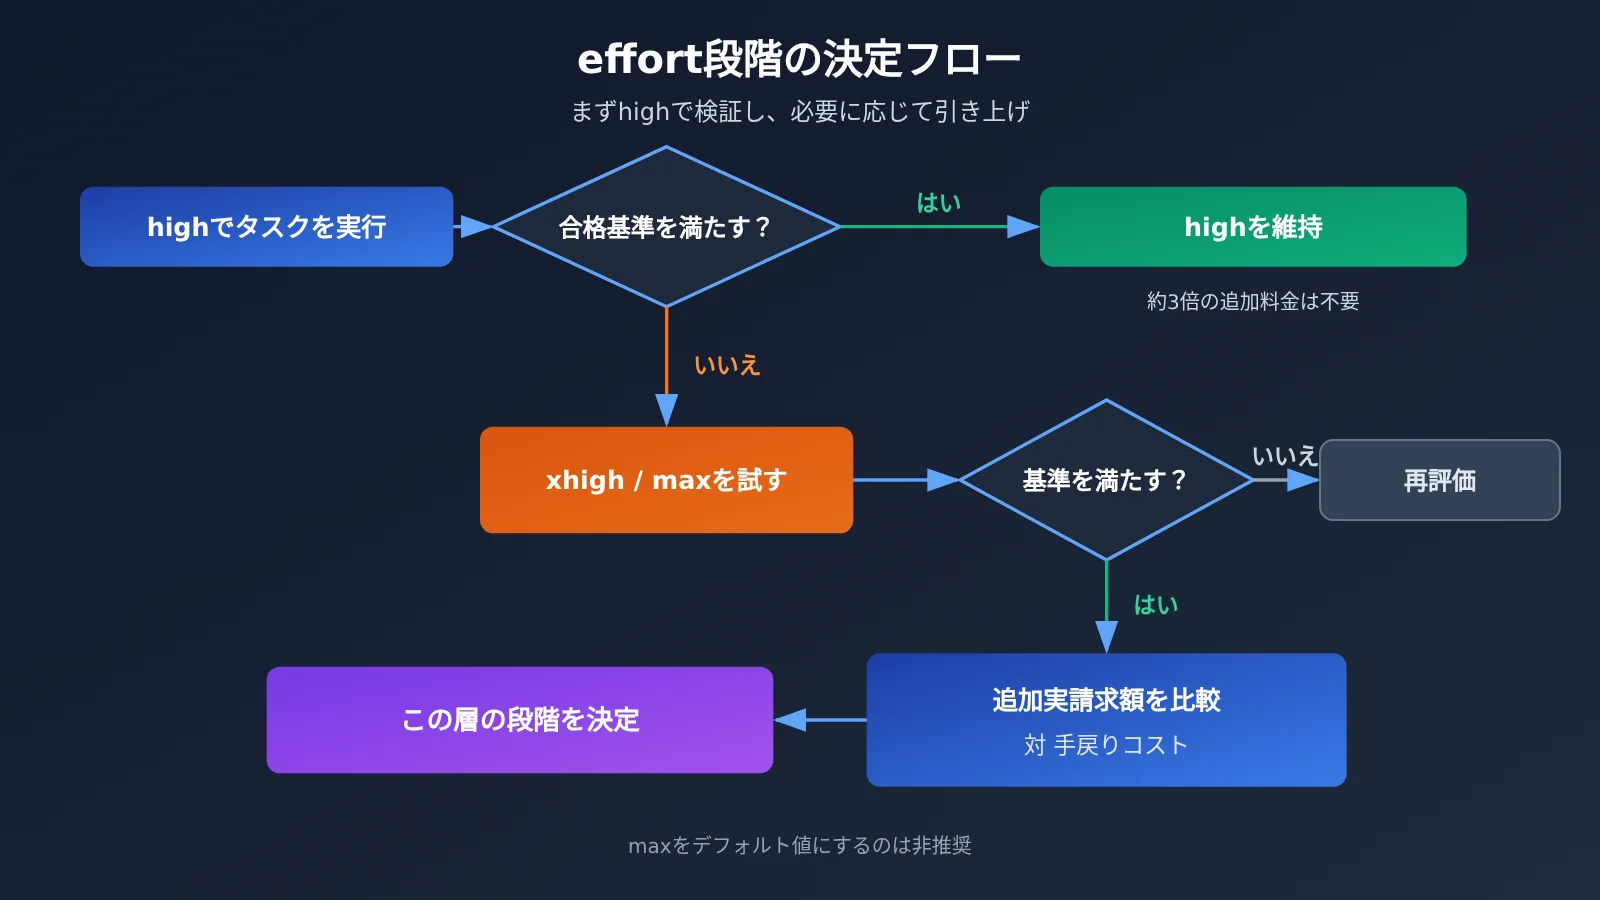
最終的な判断基準は、まず high が品質基準を満たすかどうかを確認することです。基準を満たすなら、数ポイントの精度向上のために約3倍の費用を払う必要はありません。high では基準に届かず、max なら達成できる場合に限り、max による追加コストが失敗や手戻りのコストを下回るかを比較しましょう。すべてのリクエストで max をデフォルトにすることはおすすめしません。
よくある質問(FAQ)
Q1: Claude Fable 5.2 の effort の設定段階は何ですか?
effort は、モデルが思考にかける度合いを調整する設定です。low から max までの段階があります。トークン単価は変わらず、思考量やステップ数、所要時間、トークン使用量が変化するため、同じタスクでも設定段階によって請求額が数倍異なる場合があります。API のデフォルト設定は high です。
Q2: Fable 5.2 の high と max では、どれくらい差がありますか?
CursorBench 4.0 では、high が 56.9%、9.70 ドル、max が 60.0%、32.79 ドルで、スコアの差は 3.1 ポイント、コストは約 3.38 倍です。AA では、high が 62、9.08 ドル、max が 65、26.54 ドルで、コストは約 2.92 倍です。この2組のデータは、それぞれの環境内でのみ比較できます。
Q3: このデータはいつのものですか?今後変わる可能性はありますか?
Fable 5.2 は 2026 年 11 月 9 日にリリースされました。この記事のデータは、11 月 10 日時点で取得したスナップショットです。AA と Cursor のページは動的に更新されるため、後続のバージョンやタスクセット、コスト計算方法が変わると、数値も変化する可能性があります。データを引用する際は、取得日を明記してください。
Q4: Extra High のスコアが High より低いなら、使わないほうがいいですか?
これは CursorBench 4.0 の今回の結果にすぎず、xhigh があらゆるタスクで劣るとは言えません。公式は、xhigh を自分の評価で効果が確認できた難易度の高い長時間タスクに使うことを推奨しています。効果が確認できるまでは、デフォルトで有効にする必要はありません。
Q5: API 経由で Fable 5.2 の各設定段階のコストを比較するには、どうすればよいですか?
同じタスク群を使い、設定段階だけを変更して、usage とプラットフォーム上の実際の請求額を記録する方法がおすすめです。APIYI apiyi.com の統一インターフェース経由で呼び出す場合は、ログの quota÷500000 で実際の請求額を米ドルに換算できます。実行前に、その日のプラットフォームにおけるモデル ID、グループ、effort の対応状況を確認してください。この記事では、検証していないパラメーターの透過方法は紹介していません。
Q6: 公開されている評価データには、どのような限界がありますか?
CursorBench はツール提供元が独自の環境で実施した評価であり、AA 指数は加重平均による総合スコアです。どちらも、あなたの業務での成功率をそのまま示すものではありません。また、3 ポイント程度の差だけでは、統計的に有意かどうかも判断できません。SNS での初日の評価は参考情報として扱い、最終的な結論は自分の受け入れ評価用サンプルに基づいて出してください。
Q7: API が 20% 値下げされたなら、max を使ったほうがお得ですか?
一概には言えません。値下げによって同じ割合だけ節約できるのは、使用量が変わらない場合に限られます。max のトークン使用量やステップ数は、high の3倍以上になる可能性があり、単価の低下分が使用量の増加で相殺されることもあります。単価だけでなく、「1つのタスクを完了するための実際の請求額」を比較しましょう。
Fable 5.2 high と max の重要ポイント
- 単価は変わらなくても、請求額は変わる:effort によって思考量やステップ数が変わるため、同じ単価でもタスクのコストに数倍の差が出ることがあります。
- APIのデフォルトは high:公式はまず high から始め、自分たちの評価結果に応じて引き上げたり、引き下げたりすることを推奨しています。
- Cursorでの比較:high から max にするとスコアは3.1ポイント上がり、コストは約3.38倍になります。
- AAでの比較:指数は62から65に上がり、コストは約2.92倍になります。65は正解率ではありません。
- 評価環境を混ぜない:2つの評価結果は、それぞれの環境内で比較してください。統合して単一のコストパフォーマンス指標にすることはできません。
- maxは一部のタスクに限定する:能力の上限を評価する場合や、価値の高い自由形式の問題に適しています。
- 実際の請求額で検証する:同じタスクで変数を1つだけ変更し、usageを記録しましょう。APIYI(apiyi.com)のログを使って請求額を照合できます。
まとめ
Fable 5.2のhighとmaxの選び方は、次の3点にまとめられます。
- 単価とタスクの請求額を区別する:設定によって単価は変わりませんが、投入量は変わります。
- 同じ環境内でデータを比較する:CursorとAAでは、どちらもmaxのスコアがやや高く、コストはhighの約3倍です。ただし、両者をまとめて比較することはできません。
- 合格基準に基づいて判断する:highで基準を満たせるなら、そのままhighを使いましょう。highでは基準に届かず、maxなら達成できる場合に限り、追加コストと手戻りのコストを比較します。
多くのチームにとって、まずhighでタスクを分類し、合格基準の記録を整えるのが堅実な進め方です。そのうえで、価値の高い一部のタスクを選び、maxを個別に評価しましょう。APIYI(apiyi.com)の統一インターフェースと呼び出しログを活用すれば、自社のサンプルで手早く検証できます。モデルと設定が対応していることを確認してから、利用規模を拡大してください。
📚 参考資料
- Anthropicの発表:FableとMythos 5.2の提供範囲と、ベンダーによる自己評価
- リンク:
anthropic.com/claude-fable-and-mythos-5-2 -
説明:公開日は2026-11-09。速度の算出基準と評価表が掲載されています。
-
Claude APIの料金:公式の標準料金
- リンク:
platform.claude.com/docs/en/about-claude/pricing -
説明:Fable 5.2の入力/出力料金は、100万トークンあたり8ドル/40ドルです。
-
Fable 5.2のモデル仕様:コンテキスト、出力上限、デフォルトのeffort
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview -
説明:適応型思考は常に有効で、APIのデフォルトはhighです。
-
Fable 5.2のプロンプトガイド:公式のeffortレベル選択ガイド
- リンク:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
説明:medium、high、xhigh、maxそれぞれの適した用途が紹介されています。
-
CursorBench 4.0:Cursor独自の環境における5段階評価
- リンク:
prod.cursor.com/evals -
説明:ツール提供元独自の評価であり、一般的な独立再評価ではありません。
-
Artificial Analysisのモデルランキング:独立機関による最新ランキング
- リンク:
artificialanalysis.ai/leaderboards/models -
説明:Intelligence Indexとタスクあたりのコストが掲載されています。
-
Artificial Analysisの評価方法:Intelligence Index v5.0.1の構成
- リンク:
artificialanalysis.ai/methodology/intelligence-benchmarking -
説明:9項目の評価で、4種類の能力にそれぞれ25%の比重を割り当てています。
-
Cursorによるモデル品質の比較方法:旧版ベンチマークの手法を解説するブログ
- リンク:
prod.cursor.com/blog/cursorbench -
説明:設計思想を理解するための資料です。4.0の統計結果には適用できません。
-
APIYIのログ照会API:ログ項目と実際の請求額の換算方法
- リンク:
docs.apiyi.com/api-capabilities/log-query - 説明:quota÷500000で、実際の請求額(米ドル)を算出できます。
著者:APIYI技術チーム
技術交流:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。詳しい資料はdocs.apiyi.comのドキュメントセンターをご覧ください。