著者注:Meta Muse を事例に、AIエージェントの「磨き込み」で具体的に何を磨くのかを解説します。焦点は行動のチューニングと状態の可視化に置き、そのまま真似できる手順も紹介します。
多くのチームがAIエージェントを開発するとき、同じ状況に直面します。モデルの能力はもう十分で、デモもスムーズに進む。それなのに、ユーザーは数日使っただけで離れていってしまう。問題は通常モデルそのものではなく、行動のチューニングと状態の可視化 という2つのレイヤーが十分に磨かれていないことにあります。本記事ではMetaのMuseを事例に、AIエージェントの「磨き込み」とは結局何を磨くことなのかを分解して説明します。
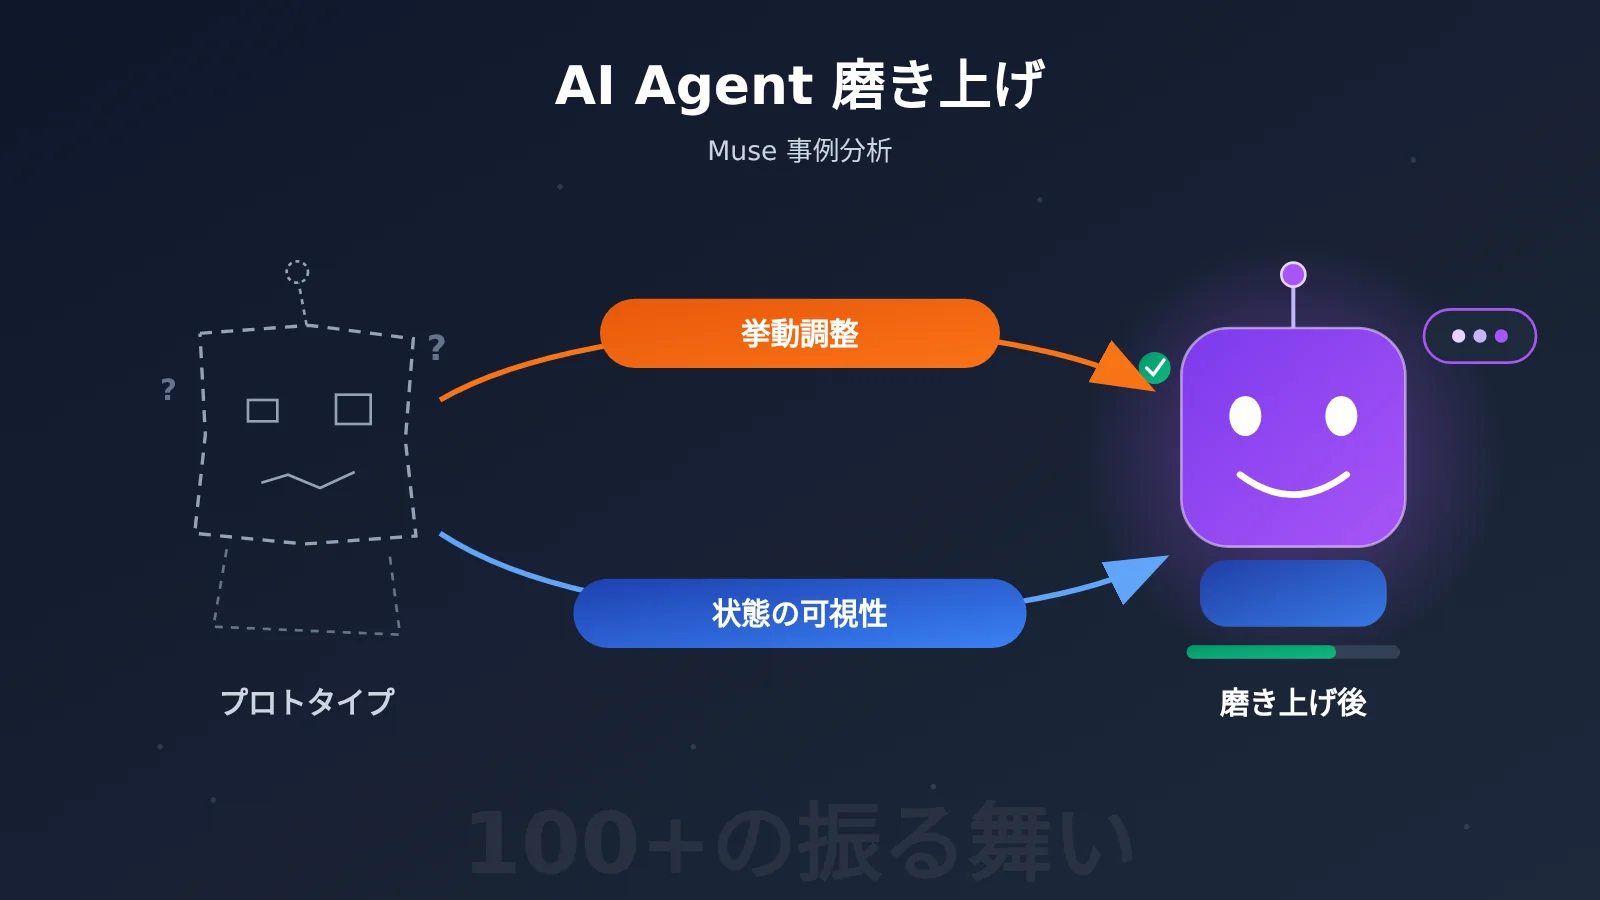
これはまた「細部が成否を決める」といった漠然とした感想論ではありません。公開報道によると、Museチームはリリース前に100項目以上の具体的なモデル挙動をテスト・調整し、さらにアバターの表情や動作を通じて、エージェントが今何をしているのかを直接見せるようにしました。この2つはどちらも、具体的なエンジニアリングタスクに分解できます。
コアバリュー:本記事を読み終える頃には、「磨き込み」を行動チェックリスト、状態シグナル表、テストフローの3つに落とし込み、自分のエージェント製品にそのまま適用できるようになります。
AIエージェントのブラッシュアップ背景:Muse を分析する価値
まずは事例の背景から説明します。報道によると、Meta の VR/AR 担当部門である Reality Labs は2025年だけで約192億ドルの損失を計上し、メタバース路線は外部からほぼ「代償の大きい失敗」と見なされています。その後、ザッカーバーグは広告という本業に縮小するのではなく、AIエージェントの方向へ投資を続けました。Muse は公開から約6週間で、報道によればユーザー数が1000万人に達したといいます。
このプロジェクトには、「ブラッシュアップ」と直接関係する2つのディテールがあります。第一に、チームは Scale AI 出身の Alexander Wang と Nat Friedman が率いており、Wang 本人の説明によれば、モデルとプロダクトの2つのラインを合わせても200人未満だそうです。小規模チームは意図的なもので、大人数のチームが合意形成によって意思決定するときに生じる妥協や、体験の不整合を避けることが目的です。第二に、Muse は「市場で最も賢いモデル」として位置づけられているわけではありません。その強みは、「モデルが技術的にできること」と「一般の人が実際に使ったときの感覚」との間のギャップを縮めた点にあります。たとえば、サブスクリプションの解約や請求書の追跡といった日常的なタスクです。
開発者にとって、Muse の売上や規模はあまり参考になりません。参考になるのは、「ブラッシュアップ」に対するその捉え方です。ブラッシュアップとはテスト可能な具体的な行動の集合であり、マーケティング用語ではないのです。
AI agent を磨き上げるための核心ポイント
Muse の取り組みを抽象化すると、AI agent の磨き上げは次のいくつかの方向に整理できます。
| ポイント | 内容 | ユーザーにとってのメリット |
|---|---|---|
| 振る舞いのチューニング | リリース前にモデルの具体的な振る舞いを一つずつテストして調整する(Muse では100項目以上) | agent の反応が予測でき、調子の良し悪しが安定しないことがない |
| 判断の境界線 | どういう場面では自分で実行し、どういう場面では先にユーザーへ確認するかを明確にする | 邪魔になる場面が少なく、しかも権限を越えない |
| 状態の可視性 | agent が今何をしているかを、視覚または文字のシグナルで示す | ユーザーは「理解したのか、実際に動いているのか」を推測しなくて済む |
| 体験の一貫性 | 入口やページが違っても振る舞いが揃っている | 小さな摩擦が積み重なって目立つコストにならない |
| エッジケース | エラー、中断、2つ目・3つ目のタブなどを丁寧に扱う | 日常的に何度も使っても、ずっと使い心地が良い |
AI agent を磨くうえでの重点1:振る舞いのチューニングは「モデルが賢い」こととは別
「モデルが賢い」と「agent が使いやすい」は別の話です。能力の高いモデルでも、いつ止まって確認すべきか、いつそのまま実行してよいか、進捗をどう伝えるかが分かっていなければ、使っていてやはりイライラします。Muse チームが調整した100項目以上の振る舞いは、主にこうした部分です。
振る舞いのチューニングが対象にするのは、その場面での反応の仕方であり、モデルのパラメータではありません。たとえばユーザーが「あのサブスクを解約しておいて」と言ったとき、agent はまず見つけたサブスクを一覧にして確認を求めるべきか、それともそのまま実行するべきか。決済ページまで進んだところで、もう一度確認を挟むべきか。こうした判断ポイントの一つひとつが、テストして固めていく必要のある振る舞いです。
AI agent を磨くうえでの重点2:状態の可視性はデザインの仕事
Muse のアバターは、小さなアニメーションで「今この作業をしている」ことを知らせてくれます。ユーザーは技術的なステータスメッセージを読む必要がありません。これは、AI にタスクを任せる誰もが抱く疑問に答えるものです。つまり、私の意図を理解したのか? 本当に動いているのか?
この不確かさを取り除くのはデザインの仕事であり、しかもデモの流れの中だけでなく、プロダクトのあらゆる隅々までカバーする必要があります。報じられるところによると、Meta はモバイルアプリをリリースする前に、音声に同期する表情や動作の生成技術をすでに開発しており、リアルタイム音声体験や将来のウェアラブル端末に備えていました。多くの企業はこの層を「コアアイデアの検証が終わってから」に回しますが、Muse は前倒しで取り組んでいます。
AI agent ブラッシュアップ クイックスタート:6つの実践ステップ
ここでは Muse の考え方を、中小チームでも実行できるプロセスに書き換えてみます。必要なのは数百人の人員でも数百億の予算でもなく、「2回目、3回目」と続けていく忍耐力です。
ステップ 1:AI agent の行動チェックリストを作成する
まず、agent が実際のタスクで遭遇する判断ポイントを洗い出し、それぞれに「トリガー条件、期待される行動、反例」を明確に書いていきます。最初は30〜50項目挙げれば十分で、その後はテストのフィードバックに応じて継続的に追加していきます。以下は分類の参考例です:
| 行動カテゴリ | 典型的な判断ポイント | ブラッシュアップ基準 |
|---|---|---|
| 意図確認 | 指示に曖昧さがある場合。例えば「あのサブスクを解約して」 | 複数の候補があればユーザーに選ばせ、自分で推測しない |
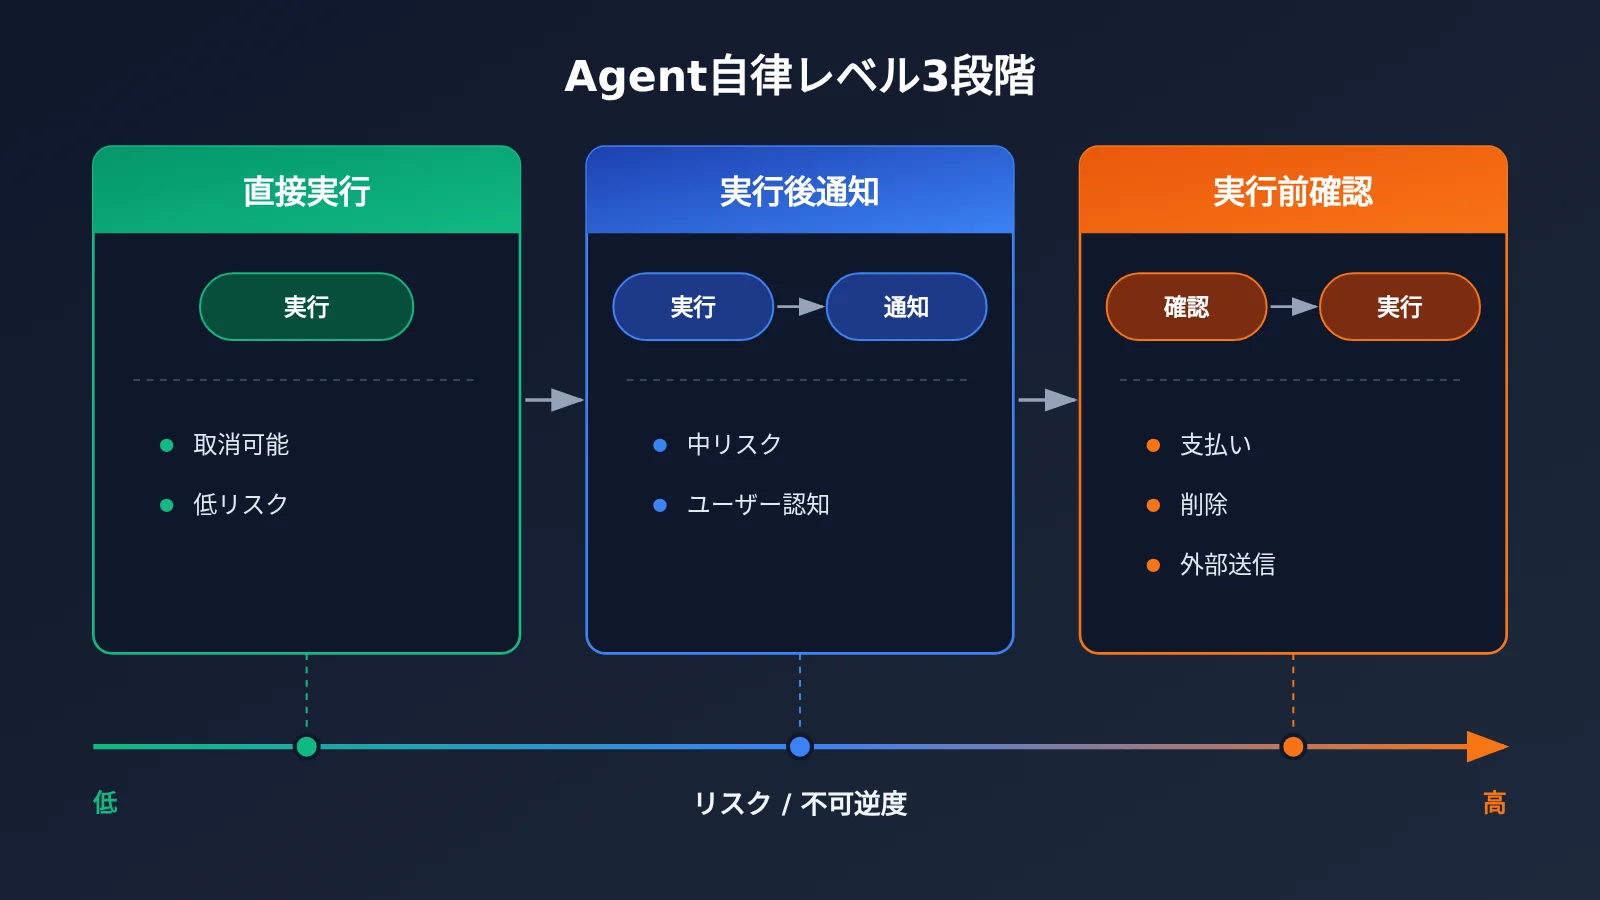
| 自律実行 | 低リスクで取り消し可能な操作 | 直接実行し、完了後に簡潔に報告する |
| 高リスクのブロック | 支払い、削除、外部送信が関与する場合 | 必ず二次確認を行い、その結果を説明する |
| 進捗報告 | 多段階で時間のかかるタスク | 各重要なステップで可視化されたフィードバックを出す |
| 失敗処理 | サイトが開けない、権限が不足している | 原因と次のステップの提案を説明し、静かに失敗させない |
| タスクの締めくくり | タスク完了時 | 明確な「完了」シグナルと結果の要約を提示する |
ステップ2:AI agent の自律性と確認の境界を定める
チェックリストを作成したら、次は各操作カテゴリごとに「自律レベル」を決めます。よく使われるのは3段階の分類です。すなわち「即時実行」「実行後に通知」「実行前に確認」です。判断の根拠は主に2点、その操作が取り消せるかどうか、そして失敗したときのコストがどれくらい大きいかです。
このステップはチーム内で意見が分かれやすいところです。Muse が小規模チームで進めている理由もここにあります。境界の問題は、全体の体験に責任を持つ一人が最終判断を下す必要があり、各モジュールがそれぞれ「局所的に合理的」なやり方で決めるわけにはいきません。そうでなければ、同じ操作がAページでは確認を求められ、Bページではそのまま実行される、といった事態が起こります。
ステップ3:AI agent の内部状態をユーザーに見えるシグナルへマッピングする
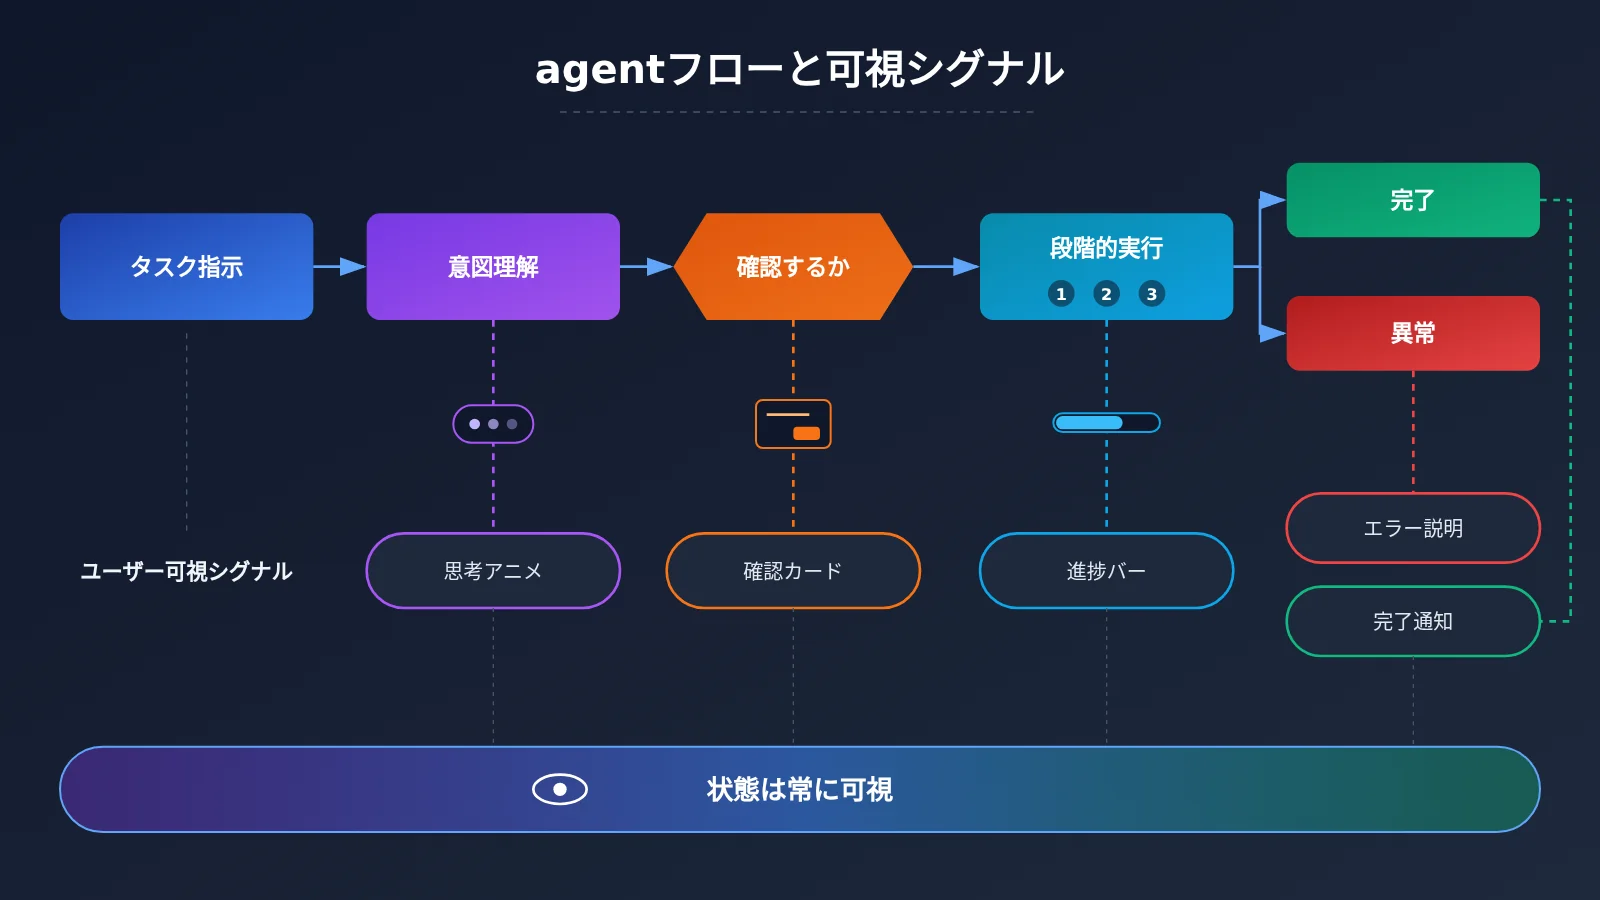
agent の内部には多くの状態がありますが、ユーザーが気にするのはほんの少数です。実際のやり方は、内部状態をユーザーが理解できる5〜6個の状態にまとめ、それぞれの状態に固定のシグナルを設計することです。
| agent の内部状態 | ユーザーに見えるシグナル | よくある反例 |
|---|---|---|
| 意図の解析 / プランニング中 | 思考アニメーション、または「ご要望を理解しています」 | 数秒間の白画面で、ユーザーは固まったと思ってしまう |
| ツール呼び出し / 外部サービスへのアクセス | 「購読ページを開いています」など、現在のステップ名を表示 | 生のツール名や JSON をそのまま表示 |
| ユーザーの確認待ち | 確認カードをハイライトし、結果を明記 | 確認の問いかけを長文の返答の中に埋もれさせる |
| 実行中(複数ステップ) | ステップごとの進捗で、完了済みと進行中を明示 | くるくる回るアイコンが1つだけ |
| 完了 | 明確な完了マークと結果のサマリー | 返答は終わったが、タスクが成功したかどうか言及がない |
| エラー / 中断 | 原因と選べる操作を平易な言葉で説明 | 技術的なエラーメッセージ、あるいは何のフィードバックもない |
実装面では、モデル API のストリーミング出力を利用してこれらのシグナルを駆動できます。OpenAI 互換フォーマットで stream を有効にすると、コンテンツとツール呼び出しが順次返ってきます。Anthropic Messages フォーマットのストリーミングイベントは、テキストブロックと tool_use ブロックを区別します。フロントエンドでこれらのイベントを監視し、対応する可視状態に切り替えればよく、返答全体が終わるのを待つ必要はありません。
ステップ4:AIエージェントの振る舞いテストセットを設計する
各振る舞いに対応するテストケースを用意し、少なくとも「正常な入力・曖昧な入力・異常な環境」の3パターンをカバーします。テストでは正解かどうかだけでなく、次の点も確認します。
- 確認すべき場面で確認しているか、邪魔すべきでない場面で余計な質問をしていないか
- 状態シグナルが各段階で予定どおりに現れているか
- 同じタスクを別の入口から開始したとき、振る舞いが一貫しているか
- エラー発生後、ユーザーが内容を理解し、次に何をすべきか分かるか
テストセットは固定しておき、プロンプトを変更したり、モデルを切り替えたり、ツールを調整したりするたびに毎回すべて実行することをおすすめします。1項目を直して3項目を壊す事態を避けられます。
ステップ5:異なるAIエージェント基盤モデルで比較する
Muse は、磨き込み層の価値が「最強のモデル」に依存しないことを示しています。同じ振る舞いリストでもモデルによってパフォーマンスに差が出るため、横断比較を行い、振る舞い基準を満たしつつコストも適切な組み合わせを見つける必要があります。
| 磨き込み工程 | モデルへの主な要件 | 選定方針 | 利用可能なプラットフォーム |
|---|---|---|---|
| 意図解析と計画 | 推論が安定し、指示に従う | フラッグシップまたは推論系モデルを優先 | APIYI apiyi.com、公式API |
| ツール呼び出し実行 | 関数呼び出しの形式が安定 | ツール呼び出しの実績が信頼できるモデルを選ぶ | APIYI apiyi.com、公式API |
| 進捗テキスト / 状態通知 | 応答が速く、コストが低い | 軽量で高速なモデルを選ぶ | APIYI apiyi.com、公式API |
| テストセットの一括評価 | 大量処理・再現可能 | コストパフォーマンスの高いモデルを評価用に選ぶ | APIYI apiyi.com、公式API |
🎯 技術的な提案:マルチモデル比較を行う場合は、APIYI apiyi.com を通じて統一的に呼び出せます。APIYI は本記事で扱う主要な大規模言語モデル API を提供し、OpenAI と Anthropic の両方のインターフェース形式に対応しています。同じ agent コードで
modelパラメータを切り替えるだけで比較でき、ベンダーごとに個別のアダプタ層を書く必要はありません。接続方法とエンドポイントは APIYI ドキュメントセンター docs.apiyi.com を参照してください。
ステップ6:AIエージェント体験の「2周目、3周目」を続ける
参考資料の中に、こんなたとえ話があります。レストランの入り口を飾るだけでは足りず、トイレもきれいにしなければならない、というものです。今のAIツールは美しい初版をすぐに作れてしまうため、むしろ新しい初版を次々と作り、既存プロダクトの「動くけれど使いにくい」部分に手を入れない傾向に陥りがちです。
週に一度、実際の利用記録から、ユーザーが迷った場面、同じ質問を繰り返した場面、途中でやめてしまった場面を拾い出し、ステップ1に戻って行動リストを補足することをおすすめします。長く使われ続けるプロダクトは、こうした目立たない2周目、3周目の作業の中から生まれるものです。
💰 コストについて:行動テストセットは繰り返し実行する必要があり、呼び出し量は少なくありません。各モデルの入力・出力単価やキャッシュ課金の扱いについては、APIYIの価格ページ https://docs.apiyi.com/models の実際のデータを参照してください。本記事では具体的な価格は記載しません。
AIエージェントのブラッシュアップ施策の比較
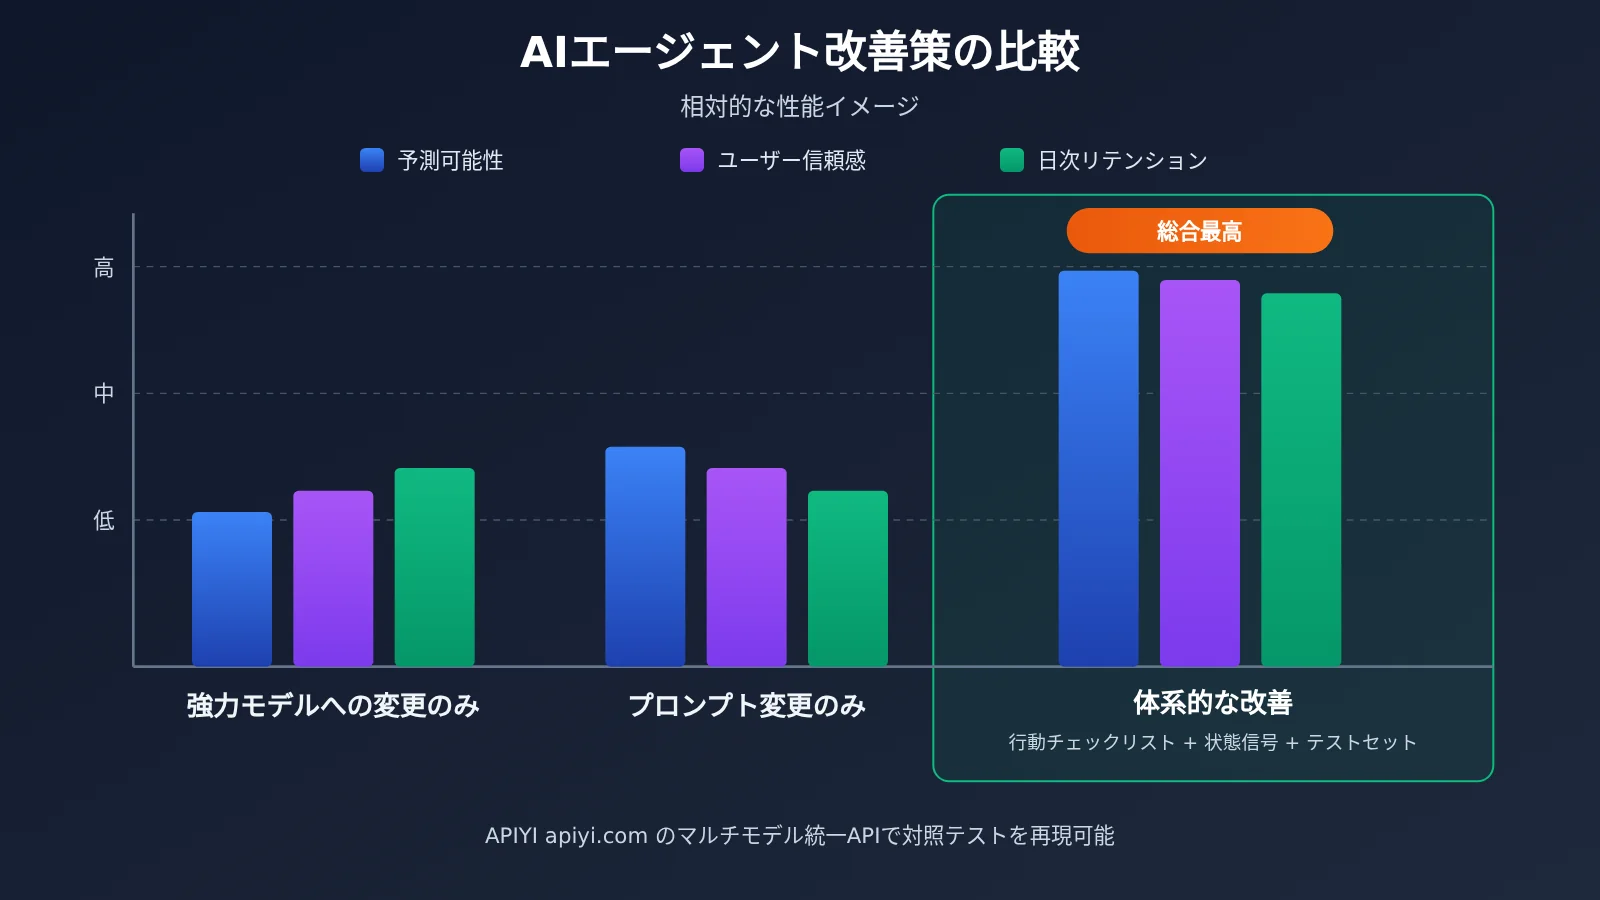
| 施策 | 中心となる取り組み | 適する場面 | 主な限界 |
|---|---|---|---|
| より強力なモデルに替えるだけ | 基盤モデルをアップグレードし、体験も自然に良くなると期待する | 能力が明らかに不足している初期プロトタイプ | コストが上がり、確認や報告といった行動面の問題は残ったまま |
| プロンプトだけを直す | システムプロンプトにルールを積み上げる | 個別の問題を小規模に修正する | ルールが増えるほど乱れ、テストがないと互いに衝突しやすい |
| 体系的ブラッシュアップ | 行動リスト + 自律の境界 + 状態シグナル + テストセット | 実ユーザー向けの日常タスク型エージェント | 初期投資が大きく、体験全体に責任を持つ専任者が必要 |
AIエージェントのブラッシュアップ施策の比較解説
モデルを替えるだけの場合の比較分析:より強力なモデルは複雑な推論で確かに優れていますが、プロダクトの中でどの操作を先に確認すべきか、進捗をどう見せるかまでは自分で判断してくれません。これに対し、体系的ブラッシュアップはユーザーが感じる摩擦に直接働きかけます。Museが最強モデルに頼らずとも良好な初期成長を遂げたことは、その一例です。
プロンプトを直すだけの場合の比較分析:プロンプトの修正は効果が出るのが早く、単発の問題解決に向いています。ただし行動リストとテストセットがなければルール同士が衝突しやすく、一つ直すと別の一つに影響が出ます。長期的に運用するエージェントであれば、体系的ブラッシュアップのほうが安定しています。
💡 比較の注意点:上記の施策の違いは、自社の業務データで検証することをおすすめします。APIYI apiyi.com を使えば、同じテストセットを複数のモデルで走らせて比較でき、価格ページのデータと合わせて投資対効果を評価できます。
AI agent ブラッシュアップに関するFAQ
Q1:AI agent のブラッシュアップとは具体的に何を指しますか?
agent の実タスクにおける振る舞いを項目ごとにテストし、調整し、固定していくことです。いつ確認を求めるか、いつ自律的に実行するか、進捗をどう報告するか、エラー時にどう説明するかといった内容に加え、ユーザーがいつでも agent の現在の状態を確認できるようにすることも含まれます。これは漠然とした「体験の最適化」ではなく、テスト可能なエンジニアリング作業です。
Q2:行動チューニングとプロンプトエンジニアリングの違いは何ですか?
プロンプトエンジニアリングは手段の一つであり、行動チューニングは目標と方法論です。行動チューニングではまず「期待される行動のリスト」とテストセットを定義し、そのうえでプロンプト、ツール設計、フロントエンドのインタラクションなど多様な方法で実現し、継続的に回帰検証を行います。プロンプトだけを変えてテストセットを作らないのでは、一貫性を保つのは難しいです。
Q3:Muse のユーザー規模とチーム規模はどのくらいですか?
報道によると、Muse は公開から約6週間でユーザー数が1000万人に達しました。Alexander Wang の話では、モデルチームとプロダクトチームを合わせて200人未満とのことです。Meta が慣れ親しんできた数十億ユーザーという規模からすれば、これはまだ初期段階の成果であり、今後はサービスコストの削減と規模の拡大が必要になります。
Q4:状態の可視性は、どのような agent シーンに最も適していますか?
主に以下のシーンに適しています:
– **代行系タスク**:サブスクリプションの解約、請求の追跡、フォーム入力など、複数ステップにわたる操作
– **時間のかかるタスク**:複数のサイトへのアクセスや複数のツール呼び出しが必要で、実行に時間がかかるもの
– **高リスク操作**:支払い、削除、外部への送信など、ユーザーによる明確な確認が必要なフロー
Q5:マルチモデル対応の agent ブラッシュアップテスト環境を素早く構築するには?
以下の手順で進められます:
1. APIYI(apiyi.com)に登録して APIキーを取得します;
2. ドキュメントセンター docs.apiyi.com を参照し、OpenAI または Anthropic 互換形式で接続します;
3. 同じ行動テストセットを使い、`model` パラメータを順に切り替えて比較実行します;
4. 料金ページ https://docs.apiyi.com/models の実際の課金データを踏まえ、適切なモデルの組み合わせを選びます。
Q6:体系的なブラッシュアップには、どのようなコストや限界がありますか?
– **初期投資**:行動リストとテストセットの構築には時間がかかり、短期的には「新機能」が見えません;
– **呼び出しコスト**:回帰テストではモデルを繰り返し呼び出すため、課金は利用するプラットフォームの料金ページに準じます;
– **組織的な要件**:全体の体験について最終判断を下す人が必要です。そうでなければ、境界ルールが各所の妥協によって一貫性を欠くことになります;
– **限界**:ブラッシュアップはモデル能力の根本的な不足を埋められません。能力が明らかに不足している場合は、モデルを替える必要があります。
AIエージェントを磨き上げる核心ポイント 主な要点
- 磨き上げはテストできる:Muse はリリース前に100項目以上の具体的なモデル挙動を調整しました。
- 使いやすいことは賢さとは別物:Muse の強みは利用時の摩擦を減らすことであり、モデル能力が最も高いわけではありません。
- 境界は誰かが決める必要がある:自律実行と事前確認のルールは統一すべきで、各モジュールが個別に決めてはいけません。
- 状態は必ず可視化する:「理解したか、実行中か、完了したか」をシグナルでユーザーに伝えます。
- エッジケースも同じくらい重要:エラー、中断、2つ目のタブ、デモの流れも同等に扱います。
- 複数モデルの比較がより安定:APIYI の統一インターフェースを通じて、同じテストセットで異なるモデルを比較できます。
まとめ
AIエージェントを磨き上げる核心ポイント:
- 挙動のチューニング:判断ポイントをリスト化し、各項目にトリガー条件、期待する挙動、反例を明記し、テストセットで継続的に回帰テストを行います。
- 状態の可視性:内部状態をユーザーが理解できる少数のシグナルに集約し、理解・実行・確認・完了・エラーまでの全プロセスを貫きます。
- 継続的なイテレーション:実際の利用記録から摩擦点を見つけ、常に第一版を作り直すのではなく、二回目、三回目とやり続けます。
Muse の経験は中小チームにも当てはまります。小さなチームが重要な意思決定を担い、退屈な細部を真剣に受け止め、失敗したら本当に重要なやり方を変えてもう一度挑戦します。これらは何百億も失ってから始める必要はありません。
自分のエージェント用に挙動テストセットを構築する準備があるなら、APIYI apiyi.com を通じて複数のモデルで素早く比較できます。プラットフォームは OpenAI と Anthropic のインターフェース形式に対応しており、接続方法は docs.apiyi.com、課金は価格ページ https://docs.apiyi.com/models を参照してください。
📚 参考資料
- MindStudio – MetaのMuseケース分析:Museの背景、チーム、磨き上げの詳細
- リンク:
mindstudio.ai/blog/meta-muse-ai-companion-lessons -
説明:本記事のケース事実の主な出典。2026年11月4日公開
-
APIYI ドキュメントセンター:マルチモデル統一接続の説明
- リンク:
docs.apiyi.com -
説明:OpenAI および Anthropic 互換形式での接続方法
-
APIYI モデル価格ページ:各モデルの課金基準と単価
- リンク:
docs.apiyi.com/models - 説明:入力・出力単価およびキャッシュ価格は、このページの実際のデータを基準とします
著者:APIYI 技術チーム
技術交流:APIYI 公式サイト apiyi.com からお問い合わせいただき、エージェントの改善実践について交流しましょう。詳細資料は docs.apiyi.com ドキュメントセンターをご覧ください