著者注:3つのパーソナルAgentの公開実測結果をもとに、Agentの実行力不足の背景にあるインターフェース層の問題を分解し、ツール呼び出し・エラー耐性とリトライ・フォーマット互換・コスト管理の修正チェックリストを提示します。
36Krは2026年11月4日に『個人Agentがテーブルについたとき、誰が先に弱みを見せたのか?』を公開し、3つのパーソナルAgentを同じテーブルに並べて実測しました。こうした横断比較から得られる結論は、たいてい同じです。Agentに足りないのは「話す力」ではなく「やり遂げる力」だということです。本記事が焦点を当てるのは、Agentの実行力不足の多くはインターフェース層に由来するという点であり、モデルそのものだけの問題ではありません。
これは「どのAgentがより賢いか」を競うランキング記事ではありません。 元記事の具体的な採点をなぞるのではなく、こうした実測でよく見られる実行失敗を5つの類型に整理し、それぞれをAgentのインターフェース設計で改善できる箇所に対応づけていきます。
本記事の価値:読み終えるころには、自分でAgentを構築するときにまずどのインターフェースパラメータを確認すべきか、失敗をどう扱うか、そしてOpenAIとAnthropicの2種類のインターフェースフォーマットをどうスムーズに切り替えるかが分かるはずです。
Agent インターフェースにおける実行力の弱点:核心ポイント
個人向け Agent の目標は、チケット予約、メール整理、資料の集約、Web ページ操作など、ユーザーの代わりに物事を丸ごと完遂することです。途中のどこか 1 ステップでも失敗すれば、ユーザーが受け取る印象は「やり切れていない」になります。実測でよく見られる失敗現象を掘り下げていくと、ほぼ次の 5 種類のインターフェースの問題に行き着きます。
| 実行力の弱点 | 典型的な症状 | インターフェース層の根本原因 | 改善の方向 |
|---|---|---|---|
| ツール呼び出しが不安定 | ツールの選択ミス、パラメータの欠落、不正なフォーマット | ツールの説明が曖昧で、スキーマに制約がない | ツールセットを絞り込み、厳密なパラメータスキーマを書く |
| 多段タスクの途中で断線 | 3〜4 ステップ目で目標を忘れる | コンテキスト管理が雑で、ツールの結果が正しく返送されない | メッセージ履歴を規約化し、中間結果を圧縮する |
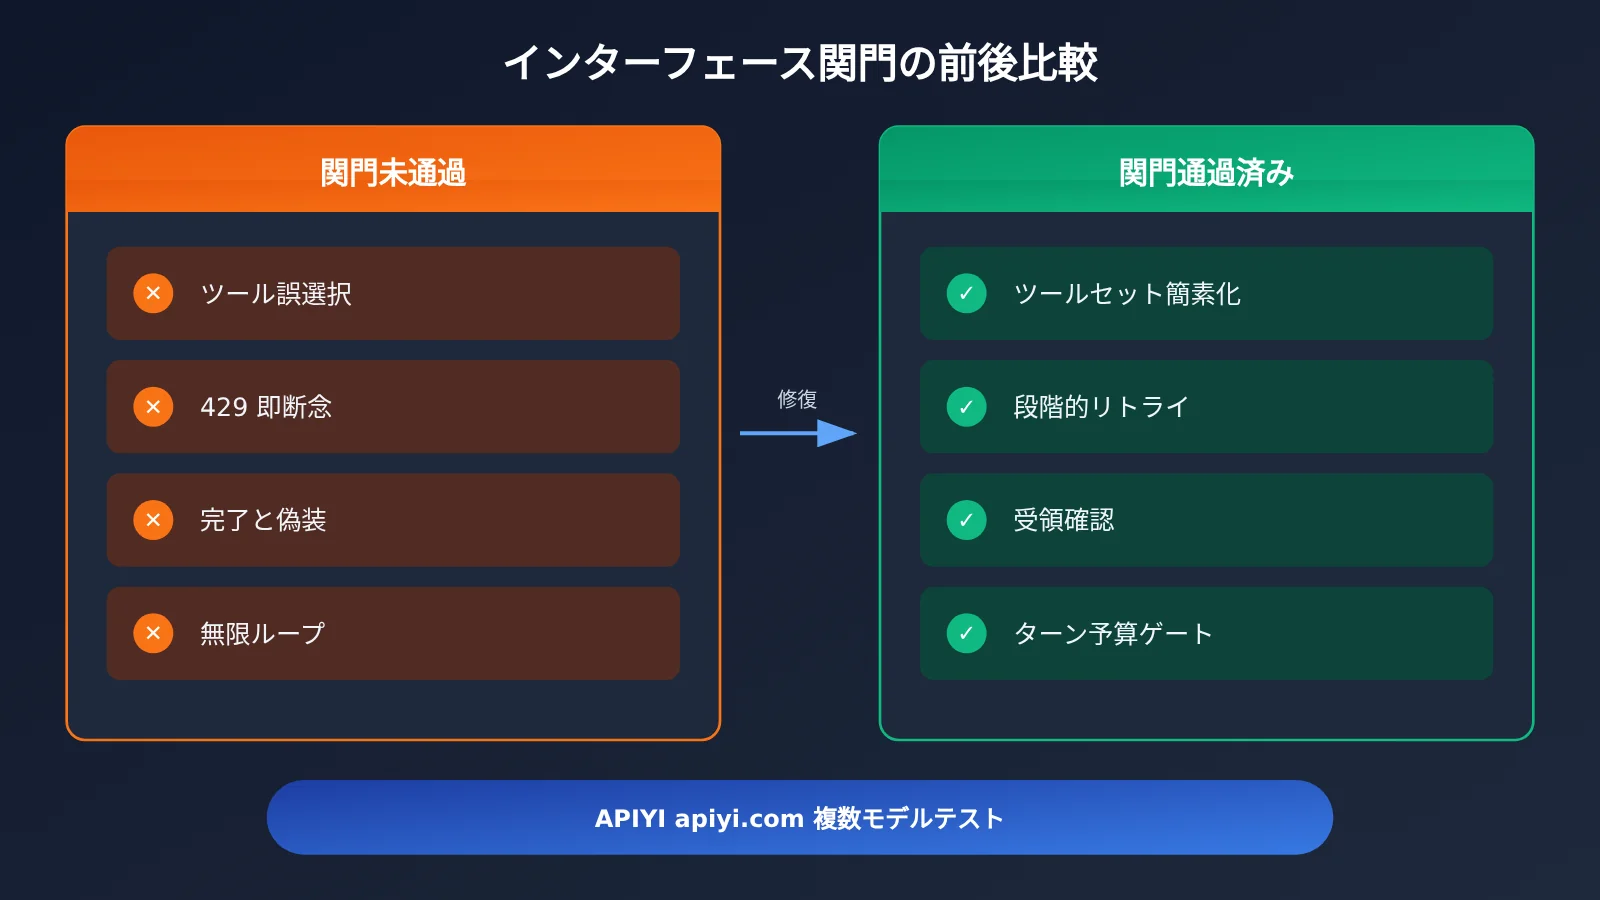
| 外部失敗にフォールバックがない | レート制限やタイムアウトに遭うとすぐ諦める、あるいは完了したと偽る | エラー種別を区別せず、リトライ戦略もない | ステータスコード別に段階的リトライし、タイムアウトとフォールバックを追加する |
| 結果が検証できない | 「完了しました」と返すが、実際には何もしていない | 実行レシートと状態検証が欠けている | 各ステップで構造化されたレシートを要求する |
| コストと遅延が制御不能 | ループ呼び出しで、1 タスクで大量の token を消費する | ステップ数上限がなく、キャッシュも活用していない | 最大ターン数を設定し、モデルを階層的に使い分け、キャッシュを活用する |
Agent インターフェースの弱点:重点解説
最初の 2 種類の弱点はモデル能力の問題に見えますが、実はエンジニアリングの工夫で大半を解決できます。ツール呼び出しが不安定になる最もよくある原因は、一度に何十個ものツールをモデルに詰め込み、しかも説明が互いに重複していることです。それではモデルが誤選択するのも当然でしょう。ツールを現在のタスクに本当に必要な範囲まで絞り、各パラメータに型・enum 値・必須かどうかを明記すれば、エラー率は通常はっきり下がります。多段タスクの断線は、多くの場合ツール結果の返送に原因があります。プロトコルに従って結果を対応する呼び出し ID に紐付けなければ、モデルは前のステップが成功したかどうかを確認できません。
後半 3 種類の弱点は純粋なエンジニアリングの問題です。合格した Agent は「失敗したらどうするか」と「どうやってやり遂げたことを証明するか」を明確に理解していなければなりません。実測でユーザーを最も失望させるのは失敗そのものではなく、失敗した後に成功したふりをすることです。したがって、インターフェース層のレシート機構とエラー分级(エラーの段階分け)は、より大きなモデルに替えるよりも有用です。
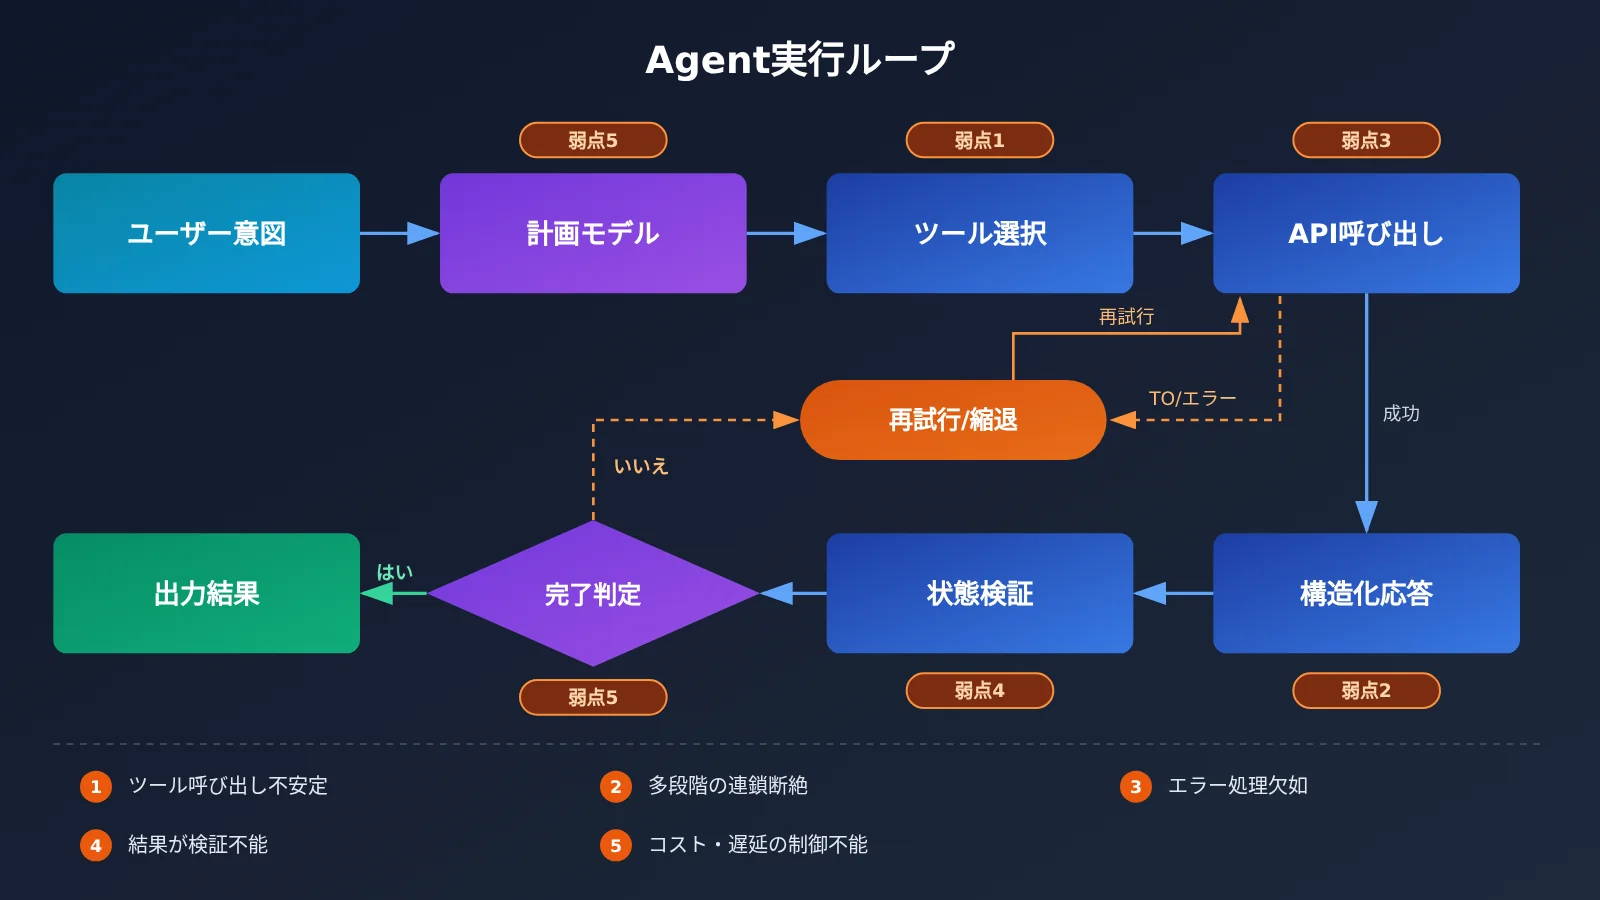
Agentインターフェースのクイックスタート:5ステップのクリアチェックリスト
以下の手順は特定のフレームワークに依存しません。Agentループを自作する場合でも、既存のAgentフレームワークを使う場合でも適用できます。本記事の方針に従い、ここではコードは掲載せず、重要な設定はすべて表で説明します。
ステップ1:Agentインターフェースの入口を統一する
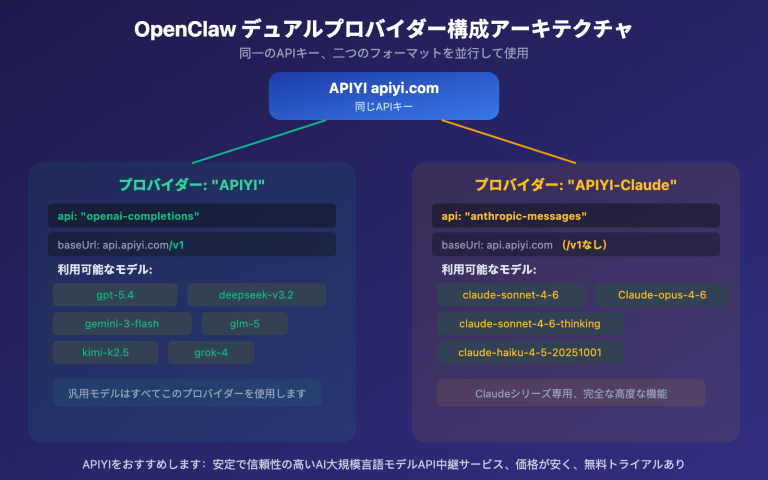
Agentでは通常、「計画には高性能モデル、実行には高速モデル」という組み合わせが必要です。モデルごとに個別のベンダーへ接続すると、認証、エラー形式、課金基準がそれぞれ異なり、トラブルシューティングのコストが高くなります。手間を抑えるには、OpenAIとAnthropicの両方のインターフェース形式に互換性のある統合エントリーポイントを使い、base_url、api_key、modelを変更するだけでモデルを切り替えられるようにするのがおすすめです。
| 設定項目 | 役割 | 推奨値 |
|---|---|---|
base_url |
インターフェースアドレス | サービス提供元のドキュメントに従います。たとえばAPIYIドキュメント docs.apiyi.com に記載されているアドレス |
api_key |
認証情報 | 環境変数に保存し、プロンプトやログには書き込まないでください |
model |
モデル名 | 計画用と実行用を分けて設定し、個別に差し替えられるようにします |
timeout |
1回のリクエストのタイムアウト | タスクの種類に応じて設定し、長い出力を伴うタスクでは適度に緩めます |
max_retries |
SDKの自動リトライ回数 | 小さめの値に保ち、業務層側で段階的なリトライを実装します |
🚀 クイックスタート:APIYIは本記事で扱う主要な大規模言語モデルのAPI呼び出しを提供しており、OpenAIとAnthropicの2種類のインターフェース形式に同時対応しています。既存のSDKは
base_urlを変更するだけで接続できます。接続方法はAPIYIドキュメントセンター(docs.apiyi.com)をご覧ください。
ステップ2:Agentのツール呼び出しパラメータを厳密に定義する
ツール呼び出しは、Agentの実行力を左右する最初の関門です。パラメータを厳密に定義するほど、モデルが「自由奔放に」動く余地は小さくなり、エラー率も下がります。
| パラメータ | 意味 | 実践的なアドバイス |
|---|---|---|
tools |
呼び出し可能なツールのリスト | 1ターンでは現在のフェーズに必要なツールだけを公開し、説明には「いつ使うか、いつ使わないか」を明記する |
tool_choice |
ツール選択ポリシー | 特定のアクションを強制実行する必要がある場合はツールを指定し、オープンな質疑応答では自動に設定する |
| パラメータschema | ツールの入力パラメータ構造 | 必須フィールドはrequiredに書き、enumで表現できるものは自由テキストにしない |
response_format |
構造化出力 | 最終的な返答はJSON構造を要求し、プログラムで検証しやすくする |
max_tokens |
出力上限 | Anthropic形式では必須で、タスクに応じて見積もる必要がある |
temperature |
ランダム性 | 実行系のステップでは低めに設定し、同じ入力で異なるアクションになる状況を減らす |
ステップ3:OpenAIとAnthropicのフォーマット差異を処理する
多くのAgentがモデルを切り替えた後に「突然バカになった」ように見えるのは、原因はモデルではなく、2つの形式のツールプロトコルが異なるため、結果の返却がずれてしまうことにあります。次の表は、特につまずきやすい差異をまとめたものです。
| 比較項目 | OpenAI Chat Completions形式 | Anthropic Messages形式 |
|---|---|---|
| システムプロンプトの位置 | messages内に置き、roleをsystemにする | トップレベルのsystemパラメータを使用する |
| ツール定義 | type: functionにfunctionオブジェクトを加える |
name、description、input_schema |
| モデルが呼び出しを開始 | アシスタントメッセージ内のtool_calls |
コンテンツブロックのタイプがtool_use |
| ツール結果の返却 | roleがtoolのメッセージで、tool_call_idを付ける |
userメッセージ内のtool_resultコンテンツブロックで、tool_use_idに対応する |
| 出力上限 | max_tokensは任意 |
max_tokensは必須 |
2つの形式に優劣はありません。重要なのは、Agent内部では1種類の中間表現だけを維持し、リクエスト時に該当する形式へ変換することです。両方の形式に対応した入口、たとえばAPIYIを使えば、ClaudeシリーズはネイティブのAnthropic形式で、その他のモデルはOpenAI形式で動かし、それぞれ最も完全なツール呼び出し能力を保つことができます。
ステップ 4:Agent インターフェースの失敗に備えたフォールバック設計
「失敗したらすぐ諦める」と「失敗したのに成功したふりをする」は、実測で最もユーザー体験を損なう2つのパターンです。正しいやり方は、まずエラーの種類ごとにレベル分けし、そのうえでリトライするのか、フォールバックするのか、それとも正直にユーザーへ伝えるのかを決めることです。
| エラー種類 | よくある原因 | Agent の対応方針 |
|---|---|---|
| 400 パラメータエラー | ツール引数が不正、メッセージ形式のずれ | むやみにリトライせず、エラー情報をモデルに返して1回だけ修正させる |
| 401 / 403 認証エラー | Key の失効、権限不足 | ただちに終了し、ユーザーに設定の確認を促す |
| 429 レート制限 | 同時実行数が多すぎる、またはクォータ不足 | 指数バックオフでリトライし、必要なら代替モデルに切り替える |
| 5xx サーバーエラー | 上流サービスの一時的な変動 | 上限を決めて数回リトライし、超えたらフォールバック |
| タイムアウト | 長い出力、またはネットワークの揺らぎ | ストリーミング出力に変更する、またはタスクを分割してからリトライ |
もうひとつ見落とされがちなポイントがあります。副作用のあるツールは冪等性を必ず確保するということです。メール送信、注文、データベース書き込みといった操作では、リトライ前に前回の実行がすでに反映されているかを確認してください。そうしないと、Agent は同じ処理を二度実行してしまいます。
ステップ 5:Agent に実行レシートとコストゲートを追加する
各ツールは実行後に、少なくとも「成功したかどうか」「何をしたか」「主要な結果の識別子」の3項目を含む構造化レシートを返すべきです。Agent がタスク完了を宣言する前に、モデルではなくプログラム側でレシートを照合します。これにより、「完了したふり」を仕組みとして防げます。
コスト面では3つのゲートを追加することをおすすめします。最大ループ回数、タスクごとのトークン予算、重複呼び出しの検出です。計画・実行・分類といった作業は、それぞれ異なるグレードのモデルに割り当てるとよいでしょう。長いシステムプロンプトとツール定義はできるだけ安定させておくと、プロンプトキャッシュを活用できます。入力・出力・キャッシュの具体的な単価や課金基準については、APIYI の料金ページ https://docs.apiyi.com/models の実際のデータをご確認ください。本記事では検証していない価格の数値は一切記載しません。
💡 アドバイス:構築フェーズでは、まず少量のトラフィックでクローズドループ全体を回し、それから徐々にツールを追加していきましょう。APIYI apiyi.com なら、同じ Key のまま複数モデルのツール呼び出し安定性を素早く比較でき、切り替えは
modelフィールドを変更するだけです。
Agent インターフェースのレイヤー別選定リファレンス
実行力の高い Agent は、めったに 1 つのモデルだけで動かすことはありません。役割ごとにレイヤーを分けることで、安定性を高めながらコストも管理しやすくなります。
| 役割レイヤー | 能力要件 | 選定方針 | 利用可能なプラットフォーム | 価格の参考 |
|---|---|---|---|---|
| 計画レイヤー | 長いコンテキスト、複雑な推論、タスク分解 | 推論能力の高いフラッグシップモデルを選ぶ | APIYI apiyi.com、公式 API | APIYI の価格ページを参照 |
| 実行レイヤー | ツール呼び出しが安定、応答が速い | ツール呼び出しの安定性に優れたミドルクラスのモデルを選ぶ | APIYI apiyi.com、公式 API | APIYI の価格ページを参照 |
| 軽量レイヤー | 意図分類、フォーマット検証、要約圧縮 | 低遅延・低コストの小型モデルを選ぶ | APIYI apiyi.com、公式 API | APIYI の価格ページを参照 |
実際にどのモデルが使えるのか、最新のモデル名は何かについては、APIYI のドキュメント docs.apiyi.com をご確認ください。自分の実際のタスクでそれぞれサンプルをまとめて実行し、ツール呼び出しの成功率、平均ターン数、1 タスクあたりの消費量を集計したうえで、各レイヤーでどのモデルを使うかを決めることをおすすめします。公開ベンチマークだけで判断しないようにしましょう。
よくある質問 FAQ
Q1:Agent の「インターフェースの関門」とは何ですか?
Agent が「考えをまとめる」段階から「やり遂げる」段階へ進む間に通過しなければならないエンジニアリング層を指し、ツール定義、呼び出しプロトコル、エラー処理、結果の受領確認、コスト管理などを含みます。モデルは意思決定を担い、インターフェース層はその意思決定を確実に実行へ落とし込む役割を担います。ここを突破できなければ、モデルがどれだけ強力でも「実行力が低い」という結果になってしまいます。
Q2:実行力の低さはモデルの問題ですか、それともインターフェースの問題ですか?
両方ありますが、インターフェースの問題は過小評価されがちです。ツールの選択ミス、パラメータ形式の誤り、処理の途切れ、失敗したのに完了したと偽る、といった問題の多くは、schema を厳密にし、結果の返却を標準化し、受領確認の検証を追加することで緩和できます。まずインターフェース層をしっかり作り込み、そのうえで本当にモデルを替える必要があるかを判断することをおすすめします。
Q3:3つのパーソナル Agent の実測テストはどんなトレンドを示していますか?
36Kr の 2026 年 11 月のこの実測レポートは、パーソナル Agent がすでに「誰が本当にタスクをやり切れるか」を競う段階に入り、比較の重点が対話品質から実行のクローズドループへ移ったことを示しています。各製品の具体的な結果については原文をご参照ください。本記事では汎用的なエンジニアリングの示唆のみを抽出しています。
Q4:OpenAI 形式と Anthropic 形式はどちらを選ぶべきですか?
モデルに応じて選びます。Claude シリーズはネイティブの Anthropic 形式を使用し、ツール呼び出しやキャッシュなどの機能をフルに活用できます。その他の多くのモデルは OpenAI 形式のほうが汎用性が高いです。APIYI は両方の形式に対応しているため、Agent 内部で統一的な中間表現を維持し、リクエスト時にモデルに応じて変換できます。
Q5:自分の Agent に複数のモデルを素早く接続するには?
1. APIYI apiyi.com に登録して APIキーを取得します;
2. docs.apiyi.com のドキュメントに従って `base_url` を設定します;
3. 計画層と実行層それぞれに `model` を設定し、同じタスク群で比較テストを行います。
一連の流れで SDK を変更する必要はなく、設定項目を調整するだけで済みます。
Q6:Agent のコストはどう見積もりますか?価格はどこで確認できますか?
まず 1 タスクあたりの平均ターン数、入力 token、出力 token を集計し、それに対応するモデルの単価を掛けます。入力・出力・キャッシュの単価および課金の基準は、APIYI の価格ページ https://docs.apiyi.com/models の実際のデータを基準にしてください。モデルによって差が大きいため、必ず実際のページで計算してください。
Q7:ツールが増えると Agent の動作が不安定になります。どうすればいいですか?
タスクのフェーズに応じてツールを動的に公開し、1 ターンにつきモデルには少数の関連ツールだけを渡します。軽量なモデルでルーティング分類を行い、該当するツールのサブセットを実行モデルに渡す方法も有効です。ツールの説明に適用範囲を明記するほうが、サンプルを大量に積み上げるよりも効果的です。
Q8:インターフェース層を整えた後、まだどんな制約がありますか?
インターフェース層は安定性を大きく向上させますが、モデル自体の推論の上限や、サードパーティのサイトやサービスの変化までは解決できません。長いチェーンになるタスクでは、特に決済・削除・外部への送信といった不可逆な操作については、人手による確認ポイントを残すことをおすすめします。
Agent インターフェース実行力の要点
- 実行力のボトルネックは多くがインターフェース層にある:ツールの選択ミス、チェーンの途切れ、完了の虚偽報告、その多くにはエンジニアリング的な解決策がある
- ツールセットは少ないほどよい:段階的にツールを公開し、パラメータの schema は厳格なほど安定する
- フォーマットの差異は隔離する:内部では統一表現を使い、リクエスト時に OpenAI や Anthropic フォーマットへ変換する
- エラーは必ず分類する:400 は修正、429 はバックオフ、5xx はフォールバック、副作用のある操作は冪等にする
- 完了はプログラムが判定する:構造化された応答に加えて状態検証を行い、「偽の完了」を根絶する
- コストにはゲートを設ける:ターン数の上限、token の予算、モデルの階層的な使い分け、料金は APIYI の料金ページを基準とする
- 導入の道筋:APIYI の統一エントリ経由で複数モデルに接続し、
base_urlとmodelを変更するだけで比較できる
まとめ
3 種類のパーソナル Agent の実測は、開発者に一つの気づきを与えました。Agent の競争の焦点は「会話できる」ことから「最後までやり遂げられる」ことへと移りつつあります。実行力を補うために最も費用対効果が高い投資は、まずインターフェースの関門を突破することです。
- ツール呼び出し:ツールを精選し、schema を引き締め、結果の返却を標準化する
- フォールトトレランス:エラーの分類、限定的なリトライ、冪等性の保護
- 検証可能性と制御可能性:構造化された応答、プログラムによる検証、コストのゲート
まず実際のタスクを一つ取り上げて完全なクローズドループを走らせ、その後徐々に能力を拡張していくことをおすすめします。APIYI apiyi.com 経由での接続がおすすめです。OpenAI と Anthropic のインターフェースフォーマットに互換性があり、異なるモデルの実行安定性を比較しやすいからです。ドキュメントは docs.apiyi.com をご覧ください。料金は https://docs.apiyi.com/models を基準とします。
📚 参考資料
- 36氪:個人向けAgentが主役の座に、先に弱みを見せたのは誰か?:3種類の個人向けAgentの実測レポート
- リンク:
36kr.com/p/4055385191224452 -
説明:本記事のテーマの出典です。具体的な製品と実測結果については原文をご参照ください
-
APIYI ドキュメントセンター:接続設定と利用可能モデルの説明
- リンク:
docs.apiyi.com -
説明:
base_urlの設定、OpenAI形式およびAnthropic形式での接続方法 -
APIYI モデル価格ページ:モデルの単価と課金基準
- リンク:
docs.apiyi.com/models - 説明:本記事の価格に関する内容は、すべてこのページの実際のデータに基づいています
作者:APIYI 技術チーム
技術的な相談:APIYI 公式サイト apiyi.com からお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com のドキュメントセンターもご覧いただけます