著者注:Microsoft Copilot が公開した合成企業環境の手法を例に、合成環境、自動クエリ生成、品質検証の3層構造を解説します。あわせて、中小チームが参考にできる評価セットの構築手順とチェックリストをまとめました。
企業内のAIアシスタントやナレッジアプリケーションをリリースする際、評価担当者はしばしばこんな問題に直面します。実際の性能を最もよく測れるのは自社のメールや議事録、プロジェクト文書ですが、機密情報を含むためテストには使えません。一方、汎用ベンチマークのスコアだけでは、業務シナリオに潜む問題を測れません。この記事では、Microsoft Research が2026年10月30日に公開したブログを例に、合成企業環境 + 自動クエリ生成 + 品質検証による評価セットの構築手法を解説します。
これは公式の宣伝をそのまま紹介する記事ではありません。Microsoft が公開した内容は手法の枠組みが中心で、プロンプトやツールのコードは提供されておらず、これらのデータセットにおける Copilot の具体的な評価指標も明かされていません。この記事では、原文に明記されている内容と筆者の推論を区別したうえで、中小チームが参考にできる手順に整理します。
この記事で得られること:合成企業評価セットの3層構造がそれぞれ何を解決するのか、なぜ時間軸と業界への適合が欠かせないのかを理解できます。また、チェックリストを使って自分たちの評価プロセスの不足点を見つけられます。
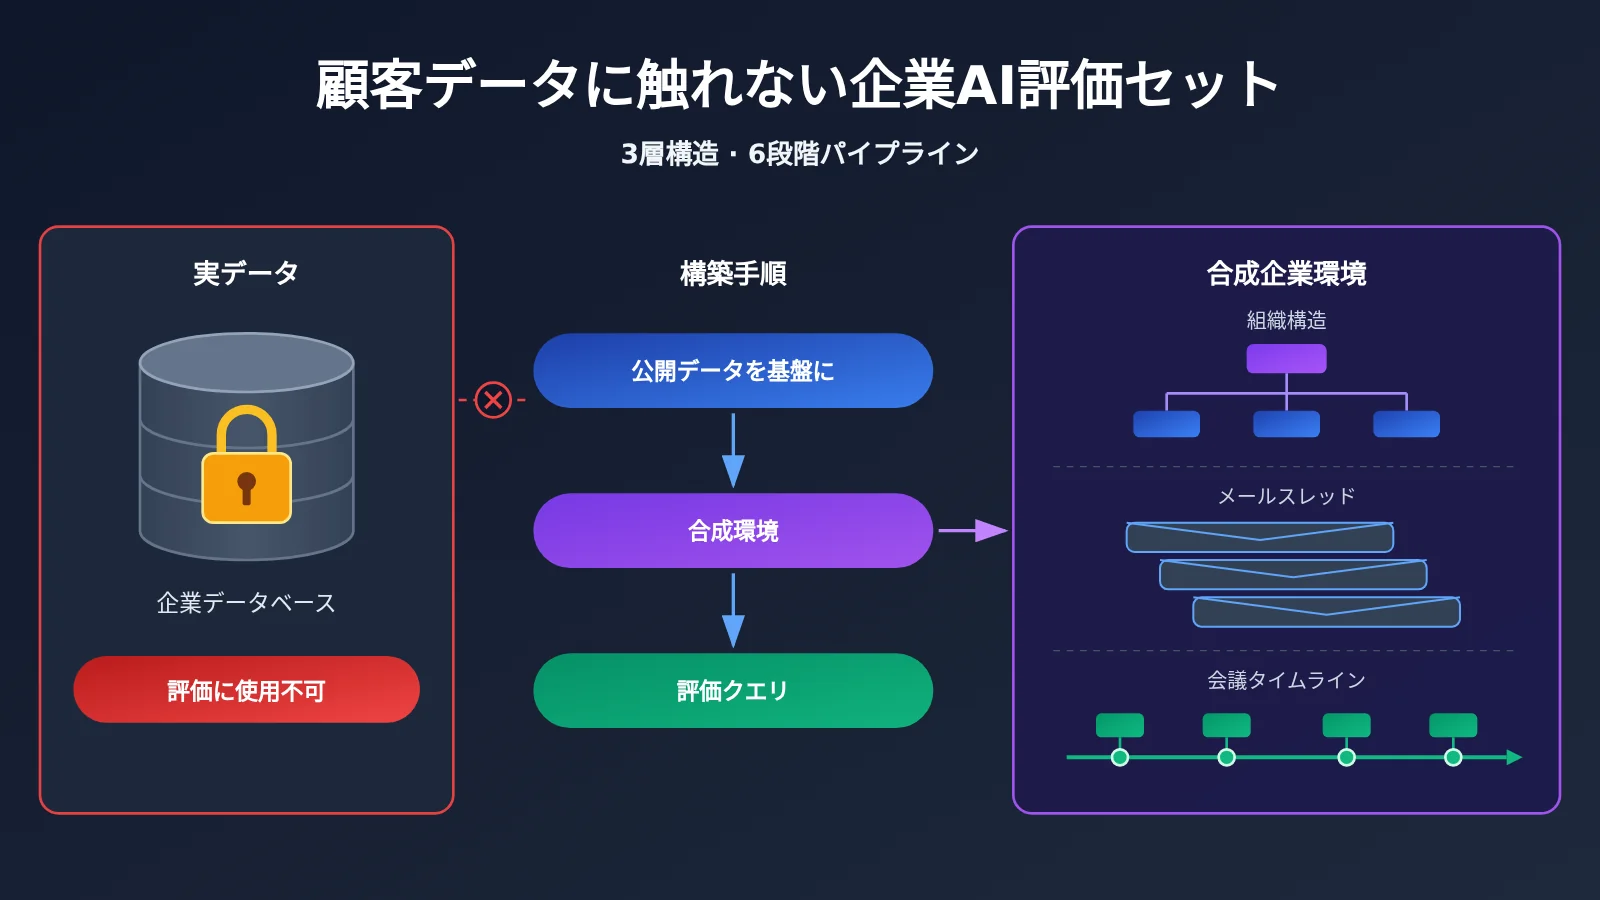
合成エンタープライズ環境を使った評価セットの要点
Microsoft はこの仕組みを Industry Evaluation Data Generation Platform(業界向け評価データ生成プラットフォーム)と呼んでいます。原文によると、3つの柱を、エンドツーエンドの自動化によってつなぎ合わせた構成です。
| 構成要素 | 原文での説明 | 解決する課題 |
|---|---|---|
| 合成エンタープライズ環境 | ユーザー、会議、メール、文書、組織構造を含む Copilot ワークスペースを模擬。顧客データは一切使わない | プライバシーに触れることなく、評価可能な「土台」を用意する |
| 自動クエリ生成パイプライン | 汎用的なクエリのアイデアを、業界に特化し、環境内のデータに即した質問に変換する | データに即したクエリを数千件手作業で作るコストを抑える |
| 構造化された品質フレームワーク | 合成データが要件を満たしているかを複数の観点から評価する | 「あまりにも不自然な」データから誤った結論を導くのを防ぐ |
| エンドツーエンドの自動化 | 同じ設定からまったく同じデータセットを再生成できる | バージョン間の回帰比較やチーム間の一貫性を確保する |
なぜ汎用ベンチマークでは企業向け AI アプリケーションの問題を測れないのか
企業の利用シーンで難しいのは、一問一答ではなく組織のコンテキストです。ユーザーが「今回のセキュリティレビュー会議のアクションアイテムを各チーム向けに整理して」と頼んだ場合、モデルは誰が参加し、誰がどのモジュールを担当し、会議でどのような具体的な項目が議論されたかを把握したうえで、回答に議事録の原文を引用する必要があります。原文では、医療機関が Copilot に会議の要約とアクションアイテムの抽出を依頼する例を挙げ、回答が正確で、漏れがなく、根拠に基づいているかを検証しています。
汎用ベンチマークには、報告系統やプロジェクトの履歴、コミュニケーションの習慣、業務分野ごとのプロセスが含まれていません。そのため、「A 部門の決定を B 部門のものとして扱う」「部門横断の会議で重要な結論を見落とす」といった、企業特有の失敗を測れません。Microsoft の考え方は、実データを使えないのであれば、構造も振る舞いも実際の企業に似た環境を作ろう、というものです。
公開データを使って合成企業環境の土台を作る
大規模言語モデルだけに頼って組織構造をゼロから作ると、役割の種類が限られ、報告系統が平坦になり、仕事内容も画一的になりがちです。Microsoft は、3種類の公開データを使って合成環境を現実に近づけています。これらのデータソースはすべて、同社の法務・ポリシー部門による審査と承認を受けています。
| 公開データソース | 原文での用途 | 中小チーム向けの代替案 |
|---|---|---|
| O*NET 職業データベース(米国労働省) | 従業員の役割と職責をより現実的にし、役割ごとの業務活動の組み合わせや頻度を調整し、業界に合わせた業務フローを作る | 自業界の公開求人票や職業分類基準を使って、役割のリストを整理する |
| オンライン求人情報 | 実際の職種名、報告系統の階層、部門構成を把握する | 対象業界の公開求人票(JD)を集め、職位や部門構造を抽出する |
| SEC 公開書類 | 組織規模、事業部門の構造、財務状況を決める | 上場企業の年次報告書にある事業セグメントや従業員規模の記述を参考にする |
Microsoft の用語では、各シミュレーション用ワークスペースを「tenant」(テナント)と呼びます。テナントは、独立したユーザー、データ、設定を持つ、分離された組織環境です。原文では、これらの環境は拡張可能なベースラインであり、各チームがその上に環境を構築していけることを強調しています。
時間軸:「先週の木曜日に何が決まったか」にはなぜ実際の時間構造が必要なのか
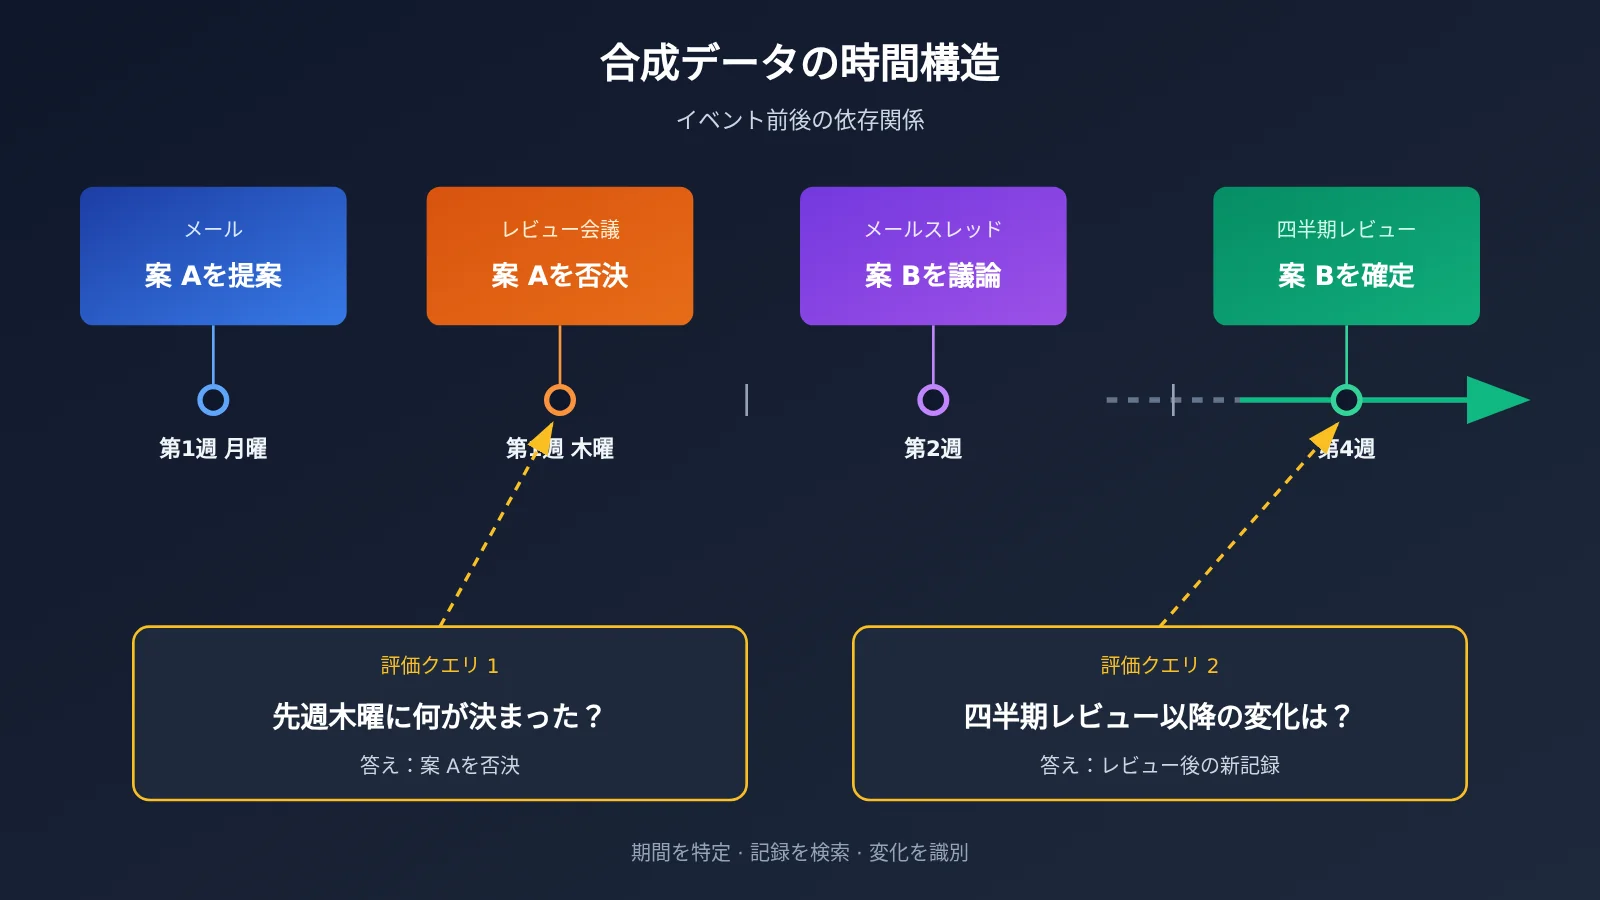
これは、元記事の中でも中小チームが特に注目したいポイントです。Microsoft の合成環境は、固定されたスナップショットではなく、時間とともに変化する組織です。会議の履歴やプロジェクトのタイムライン、数週間にわたるメールスレッドがあり、組織変更も自然に発生します。元記事では、「チームは先週の木曜日に何を決めたか」「前回の四半期レビュー以降、何が変わったか」のように、多くの Copilot への質問自体に時間の要素が含まれていると指摘しています。
時間に関する質問に答えるには、モデルは対象期間を特定し、その期間内の関連記録を探し、前後の変化を把握する必要があります。合成データが日付のつながりのない文書の集まりだったり、すべての会議が同じ日に集中していたりすると、この種の質問には正解を定められないか、答えが簡単すぎて評価の意味がなくなります。たとえば、月曜日に案を提案し、木曜日の会議で否決され、翌週のメールで代替案が登場する。このように合成データに時系列のつながりがあってこそ、「先週の木曜日に何が決まったか」という質問でモデルの実力を評価できます。
業界別の評価:同じモデルでも業界によって異なる問題が現れる
Microsoft は3つの業界向けに合成環境を構築し、それぞれ実際の業務フローに対応させました。
- 製薬:規制当局への申請フロー、臨床試験に関する議論、部門横断の安全性レビュー会議
- 資本市場:取引パイプライン、コンプライアンスに関するやり取り、顧客ポートフォリオの振り返り
- IT・ソフトウェア企業:イテレーション計画、コードレビューの議論、製品リリースの調整
原文では、業界に合わせることで、評価クエリをその分野のユーザーが実際に尋ねる質問に近づけ、汎用的なテストケースでは見つからない分野固有の失敗パターンを明らかにできるとしています。企業内のチームが対象とする業界は通常1~2つなので、かえって深く掘り下げやすいでしょう。
クエリの自動生成:6段階のパイプラインを解説
合成環境を用意したら、次は評価クエリが必要です。原文によると、データに即した業界固有のクエリを数千件手作業で作るには、コストも時間もかかりすぎるため、自動化パイプラインを構築しました。原文では各段階について簡潔に説明されているため、下表はその記述順に沿って6つの工程に整理したものです。具体的な区分は原文の図を参照してください。
| 段階 | 原文の説明のポイント | 中小チーム向けの簡易的な方法 |
|---|---|---|
| 1. タスクライブラリ | 多数の汎用的な職場タスクを出発点とする | 会議の要約、意思決定の確認、バージョンの比較など、社員によくあるタスクを50~100件挙げる |
| 2. 業界別の選別 | 特定の業界に関連するタスクを選ぶ | 業務担当者に自社の業界に関連するタスクを選んでもらう |
| 3. 分野に合わせた書き換え | 分野固有の言葉や文脈を使って書き換える | 業界用語や典型的な文書の種類を追加する |
| 4. 環境に基づく生成 | AIを使い、合成環境のデータに基づいたクエリを生成する | モデルに具体的な文書やスレッドを読ませてから問題を作らせ、模範回答と出典も同時に生成する |
| 5. 自然な表現への書き換え | 実際の人の質問に近い表現に書き換える | 「あの案はその後どうなった?」のように、話し言葉や省略、指示語を加える |
| 6. 検証 | 各クエリの正確性と一意性を確認する | 重複を除き、回答を裏付ける一意の根拠がデータ内にあるか抜き取り確認する |
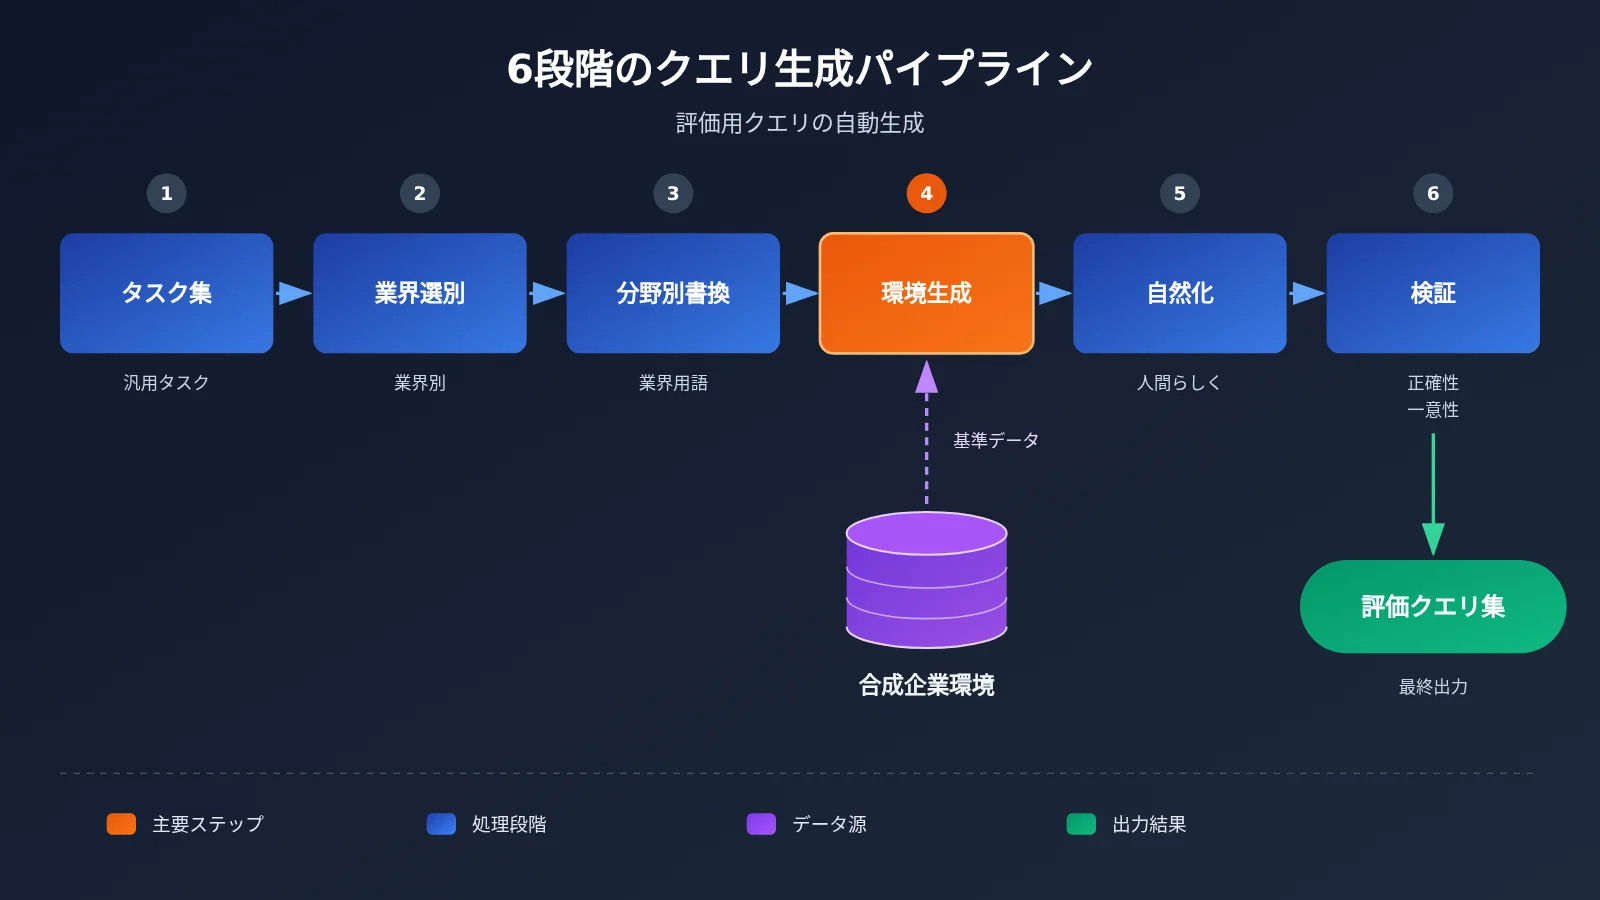
第4段階はパイプライン全体の要です。クエリは環境内の具体的なデータに基づいていなければ、回答の正誤を判断できません。また、第6段階の「一意性」も見落とされがちです。同じ質問に対してデータ内に複数の妥当な回答があると、採点をめぐって議論が生じます。
第4・第5段階では、あるモデルに問題を作らせ、別のモデルに自然な表現への書き換えや検証を任せることで、同じモデルが問題と回答の両方を作ることによる偏りを減らせます。APIYI apiyi.com の OpenAI 互換インターフェースを通じて複数のモデルを呼び出す場合は、モデル名を変更するだけで切り替えられるため、生成スクリプトをほとんど変更する必要はありません。
🎯 技術的なアドバイス:クエリ生成の段階では、プロンプトのテンプレート、モデル名、ランダムシードなどのパラメータを固定し、設定ファイルに記録しておくことをおすすめします。こうすれば、モデルを変更して比較実験を行う際に、変数をモデル自体だけに絞れます。APIYI の統一インターフェースを使えば、同じフロー内で異なるベンダーのモデルを切り替え、クエリの生成と検証を行えます。
合成データの品質検証:モデルの前にデータを評価する
合成データ自体も評価する必要があります。そうしなければ、モデルのスコアが高くても、単にデータが簡単すぎるだけかもしれません。原文では、内部の意味評価フレームワークを使って「3つの次元」から品質を測るとしていますが、実際には4項目が挙げられています。下表には原文どおり4項目を記載しています。引用する際は、この相違にご注意ください。
| 品質の次元 | 原文での確認事項 | 実践できる確認方法 |
|---|---|---|
| 構造の忠実度 | 組織構造に、現実的な報告階層、チーム規模、部門横断の関係が反映されているか | 階層の深さやチーム人数の分布を集計し、公開データと照合する |
| コンテキストの関連性 | クエリやワークフローが、企業の実際の利用パターンを表しているか | 業務担当者にサンプルのクエリをブラインド評価してもらい、「実際の質問らしいか」を採点する |
| 行動の現実性 | シミュレーションされたユーザーに、人間らしいコミュニケーションパターンや協働の動きが見られるか | メールに返信のやり取りがあるか、会議で意見の相違やその後の対応があるかを確認する |
| コンテンツの安全性 | 有害または不快な内容、個人を特定できる情報が含まれず、実在の人物をかたっていないか | 人名、電話番号、身分証番号の形式を自動スキャンし、人が再確認する |
原文によると、初期の生成方法を基準として、総合品質指標は39%向上し、一部の業界環境では品質スコアが満点の1.0に対して0.9を超えました。原文では、この向上を2つの要因によるものとしています。1つは実際の業界の情報を取り入れたこと、もう1つは総合品質指標を使って自動的に品質を改善したことです。なお、このスコアが測っているのは、合成データが実際の企業にどれだけ近いかであり、Copilot自体の性能ではありません。原文では、これらのデータセットにおけるCopilotの評価指標は公表されていません。
再現性:合成評価セットをバージョン間の回帰テストに使うための前提
原文では、自動化されていない場合の実際の課題として、次の4つを挙げています。
- 再現性:手作業では毎回結果に微妙な違いが生じ、バージョン間の比較が難しい
- 規模:業界や設定のバリエーションが多く、人手では対応しきれない
- 反復の速さ:手作業での作成に数日かかり、フィードバックが遅れる
- チーム間の一貫性:標準ツールがないと、チームごとにデータセットの形式や品質が異なり、互換性がなくなる
自動化により、データセットの作成は数日かかる手作業から自動実行へと変わりました。Microsoft の試算では、評価データセット1つあたり約100,000ドル、プロジェクト全体で約300,000ドルを節約できたとされています。これは同社の規模に基づく試算であり、他のチームにそのまま当てはめることはできません。原文では、より重要な成果として、どのチームが同じ設定で再生成しても、まったく同じデータセットを得られる点を挙げています。
この再現性は、回帰テストにとって重要です。検索戦略を変更したりモデルを切り替えたりしてスコアが下がった場合、その変化がデータではなくシステムに由来することを確認する必要があります。再生成するたびにテストセットが少しずつ変わってしまうと、バージョン間の比較は意味を失います。
APIYI で複数の候補モデルを比較する際も、同じ原則に従いましょう。同じバージョンの合成評価セットを固定し、異なるモデルをそれぞれ呼び出して評価します。そうすることで、比較結果にはモデルの違いだけが反映されます。
中小チーム向け:合成企業評価セットのクイックスタート
Microsoft の手法では、数百人のユーザーの完全なコミュニケーション履歴、3つの業界環境、法務レビュー、社内共有ディレクトリを扱っています。中小チームがすべてをそのまま取り入れる必要はありません。以下に、原文の方法を簡略化した手順を紹介します。
構築手順
- 範囲を決める:「議事録に関する質問応答」や「プロジェクト文書の検索」など、1つの業務シナリオを選び、対象業界も1つに絞ります。
- 組織を設計する:公開されている求人情報や業界資料を参考に、20~50人の架空の組織を設計します。部署、役職、レポートラインを明確にします。
- タイムラインを作る:まず4~8週間のプロジェクトのタイムラインを作り、主要なイベント、意思決定ポイント、変更を列挙します。それに基づいて議事録、メール、文書を生成し、前後のつながりを保ちます。
- コンテンツを生成する:大規模言語モデルを使い、タイムラインに沿って文書を1件ずつ生成します。各文書には日付、作成者、参加者などのメタデータを付けます。
- クエリを生成する:前述の6段階のフローに沿って問題を作成します。各問題に模範解答と出典文書の番号を付け、時間に関するクエリは別途マークします。
- データを検証する:4つの品質指標に沿ってサンプルをチェックします。PII(個人を特定できる情報)のスキャンは必ず全件に対して実行します。
- バージョン管理する:組織の設定、タイムライン、プロンプト、モデル名、パラメータを設定ファイルに記録し、バージョン番号を付けます。
- 評価を実行する:固定バージョンのデータセットで評価対象のシステムを実行し、クエリの種類ごとのスコアを記録します。
🚀 クイックスタート:ステップ4と5では、大規模言語モデルを繰り返し呼び出す必要があります。APIYI apiyi.com の OpenAI 互換インターフェースを使えば、同じ呼び出し方法で複数のモデルにアクセスできます。モデル名を変更するだけで、生成時と検証時に異なるモデルを使えます。
セルフチェックリスト
- [ ] 評価データに実在する顧客や従業員のデータが一切含まれていない
- [ ] 組織構造に階層と部門間の連携があり、単なるフラットな名簿になっていない
- [ ] データに現実的な時間構造があり、少なくとも数週間をカバーし、イベント間に因果関係がある
- [ ] 「先週」「前回の振り返り以降」など、時間に関するクエリが一定の割合で含まれている
- [ ] クエリに自社の業界で使われる用語や文書の種類が使われている
- [ ] すべてのクエリに、照合可能な一意の参照回答と出典がある
- [ ] 合成データをそのまま使うのではなく、品質チェックを行っている
- [ ] 同じ設定から同じデータセットを再生成できる
大規模な投資が必要な工程と簡略化できる工程
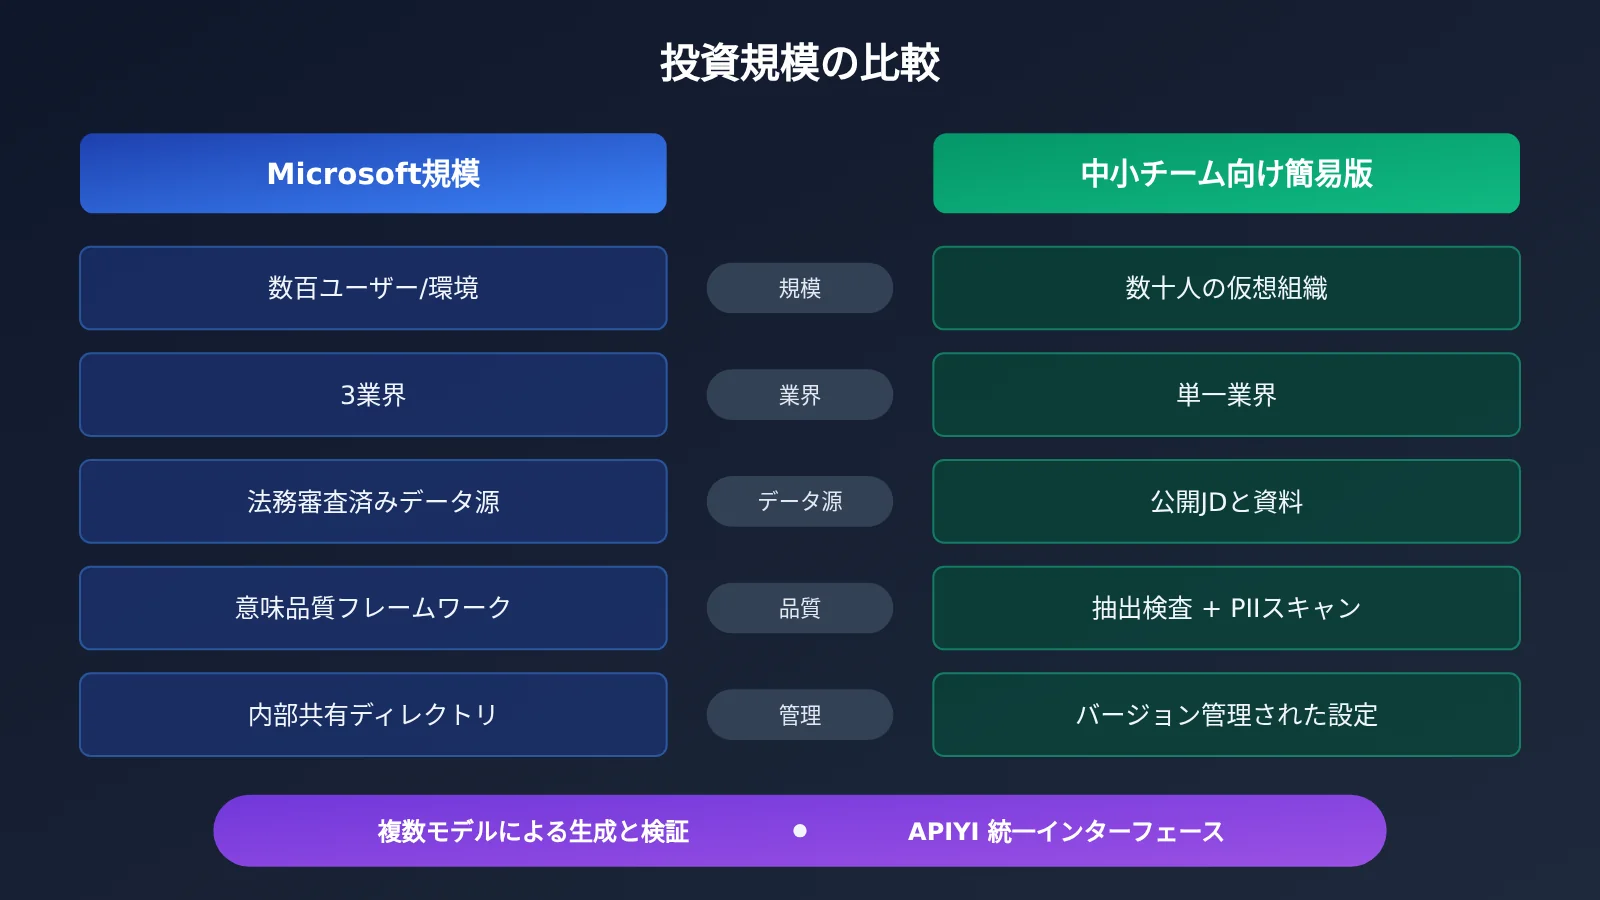
| 工程 | Microsoft の方法 | 投入規模 | 中小チームへの提案 |
|---|---|---|---|
| 公開データの取り込み | O*NET、求人情報、SEC 提出書類を法務審査のうえで利用 | 大 | 業界資料を手作業で整理するだけでもよいが、出典を利用できることは確認する |
| 環境の規模 | 環境ごとに数百ユーザーを用意し、完全なコミュニケーション履歴を含める | 大 | 主要な役割をカバーするには数十人で十分 |
| 業界のカバー範囲 | 3業界 | 中 | 自社がサービスを提供する1業界に絞る |
| 品質フレームワーク | 社内の意味的評価フレームワークと総合指標 | 大 | 人手によるサンプリング + 簡単な統計 + 自動 PII スキャン |
| 時間構造 | 時間とともに変化する組織 | 省略不可 | まずタイムラインを作成してからコンテンツを生成する |
| 再現性 | 同じ設定から同じ結果を生成 | 省略不可 | 設定をバージョン管理し、生成結果をキャッシュする |
縮小できるのは規模と自動化の程度です。一方、時間構造、クエリの根拠付け、再現性は省けません。この3つによって、評価結果を本番公開の判断に使えるかどうかが決まります。なお、中小チームがこの方法を実践した場合の実際のコストや効果については、現在参考にできる公開資料がありません。上記の提案は、原文の方法を基にした推論です。
よくある質問 FAQ
Q1:合成企業環境の評価セットとは何ですか?
プログラムで生成された架空の企業ワークスペースと、そのデータに基づく評価用の質問を組み合わせたものです。ワークスペースには、従業員、組織構造、会議、メール、文書などが含まれます。実際の顧客データに触れることなく、企業向けAIアプリケーションが正しい情報を見つけ、統合し、提示できるかをテストするために使います。
Q2:合成評価セットと汎用ベンチマークの違いは何ですか?
汎用ベンチマークは、一般的な能力を横断的に比較するうえで役立ちますが、報告系統やプロジェクトの履歴、業務固有のフローは含まれていません。合成企業環境ではこうした構造を再現できるため、部署の所属を取り違えたり、部門横断の会議で決まったことを見落としたりと、汎用的なテストケースでは見つけにくい業務固有の失敗を明らかにできます。
Q3:Microsoftのこの手法はいつ公開されましたか?
Microsoft Researchは2026年10月30日に関連するブログ記事を公開しました。原文によると、このプラットフォームは社内の共有ディレクトリで公開され、Microsoft Copilot初の標準化された評価ベースラインになったとのことです。
Q4:この手法はどのような場面に適していますか?
– **会議議事録に関する質問応答**:要約、アクションアイテムの抽出、引用が正確かをテスト
– **企業内のナレッジ検索**:大量の文書の中から、正しい根拠を一つに絞って見つけられるかをテスト
– **時間に関する質問**:「先週何が決まったか」「最近何が変わったか」といった質問をテスト
– **モデルやバージョンの回帰テスト**:固定されたデータセットで新旧の方式を比較
Q5:同じ合成評価セットで異なるモデルを比較するにはどうすればよいですか?
重要なのは、データセットのバージョンを固定し、評価対象のモデルだけを切り替えることです。APIYI apiyi.comはOpenAI互換の統一インターフェースを提供し、複数の主要モデルに対応しています。切り替え時はモデル名を変更するだけなので、同じ評価スクリプトを使って候補モデルを順番にテストできます。なお、採点ロジックと評価フレームワークは自分で実装する必要があります。
Q6:合成データによって評価結果がゆがむことはありませんか?
その可能性はあります。そのため、原文では専用の品質フレームワークを設け、モデルを評価する前にデータを評価しています。合成データが整いすぎていて、現実にある意見の食い違いやノイズが欠けていると、モデルのスコアが実力以上に高くなるおそれがあります。業務担当者にサンプルデータをブラインド評価してもらい、匿名化した実際のフィードバックを使って定期的に合成データを調整することをおすすめします。
Q7:この手法にはどのような既知の制限がありますか?
原文では、プロンプト、ツール、パイプラインの各段階における実装の詳細は公開されておらず、Copilotの評価指標も明かされていません。また、品質フレームワークは「3つの次元」と記しながら、4項目を挙げています。削減額はMicrosoft自身の推計です。さらに原文では、複数ターンにわたるエージェントとのやり取り、数か月から数年に及ぶ組織の変化、操作を実行するAIシステムを、今後取り組むべき評価上の課題として挙げています。
合成企業環境を使った評価セットの要点 Key Takeaways
- 3層の構造:合成環境の構築、クエリの自動生成、データ品質の検証のどれかが欠けると、評価の信頼性は損なわれます
- 公開データによる調整:職業データベース、求人情報、公開財務報告を活用し、組織構造を現実に近づけます
- 時間構造は不可欠:時間に関するクエリには、データ内に現実的なイベントの前後関係と因果関係が必要です
- 業界に特化して問題の発見率を高める:領域に即したクエリは、その領域特有の失敗を見つけやすくなります
- モデルより先にデータをテストする:構造、コンテキスト、動作、安全性の4つの観点から合成データを確認します
- 再現性は回帰テストの前提:同じ設定から同じデータを生成できてこそ、バージョン間の比較に意味が生まれます
- 複数モデルの比較:データセットを固定した後、APIYI の統一インターフェースでモデル名を切り替えて比較できます
まとめ
Microsoft Copilot における合成企業環境の手法を分解すると、次の3点にまとめられます。
- 合成データでプライバシーを守る:最初から顧客データを使わないことで、データセットをチーム間で自由に共有・再利用できます。
- 構造によって現実に近づける:組織階層、タイムライン、業界の業務フローが、評価で実際の問題を検出できるかどうかを左右します。
- 自動化によって再現性を確保する:同じ設定から同じデータセットが得られてこそ、評価結果をリリース判断に役立てられます。
中小規模のチームは、Microsoft と同じ規模を再現する必要はありません。ただし、時間構造、データに基づくクエリの生成、設定のバージョン管理の3つは取り入れる価値があります。まずは1つのシナリオ、1つの業界、数十人規模の仮想組織から始め、ひと通りの流れを実行してから徐々に拡大していくとよいでしょう。
データセットを固定した後は、APIYI apiyi.com を通じて、同じ OpenAI 互換の呼び出し方式で複数のモデルを利用し、同一の合成評価セット上で各モデルの性能を直接比較できます。
📚 参考資料
- Microsoft Research Blog – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence:この記事で解説した手法の原典
- リンク:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
内容: 合成環境、6段階のパイプライン、品質フレームワーク、プライバシー設計、結果データについての原文
-
O*NET 職業データベース:米国労働省の職業情報データベース
- リンク:
onetonline.org -
内容: 原文では、合成従業員の役割、職責、業務活動の分布を調整するために使用
-
SEC EDGAR 公開書類検索:米国証券取引委員会の公開書類
- リンク:
sec.gov/edgar - 内容: 原文では、合成組織の規模、事業部門の構成、財務状況を決定するために使用
著者: APIYI 技術チーム
技術交流: 複数モデルへの統一的なアクセスについては、APIYIのサイト apiyi.com からお気軽にご相談ください