Nota del autor: a partir del método de entornos empresariales sintéticos publicado por Microsoft Copilot, analizamos sus tres componentes —entorno sintético, generación automática de consultas y validación de calidad— y reunimos pasos y una lista de comprobación para que los equipos pequeños y medianos puedan crear sus propios conjuntos de evaluación.
Cuando un asistente de IA o una aplicación de conocimiento empresarial está a punto de salir a producción, quienes se encargan de evaluarlo suelen encontrarse con un problema: los correos, las actas de reuniones y los documentos de proyectos de la propia empresa son los que mejor reflejarían su rendimiento real, pero contienen información sensible que no se puede usar en las pruebas. Por otra parte, las puntuaciones en pruebas de referencia generales no permiten detectar los problemas que surgen en escenarios de negocio. En este artículo tomamos como ejemplo una entrada de blog publicada por Microsoft Research el 30 de octubre de 2026 para analizar este método de creación de conjuntos de evaluación: entorno empresarial sintético + generación automática de consultas + validación de calidad.
No se trata de repetir el discurso oficial. El contenido publicado por Microsoft se centra en el marco metodológico: no incluye indicaciones ni código de herramientas, y tampoco revela las métricas concretas de Copilot en estos conjuntos de datos. Aquí distinguiremos lo que dice explícitamente la publicación original de nuestras propias deducciones y, después, resumiremos el método en pasos que puedan servir de referencia a equipos pequeños y medianos.
Valor principal: al terminar de leer, entenderás qué problema resuelve cada una de las tres capas de un conjunto de evaluación empresarial sintético, por qué no se pueden dejar de lado la dimensión temporal y la adaptación al sector, y cómo detectar las lagunas de tu proceso de evaluación con ayuda de una lista de comprobación.
Puntos clave de los conjuntos de evaluación para entornos empresariales sintéticos
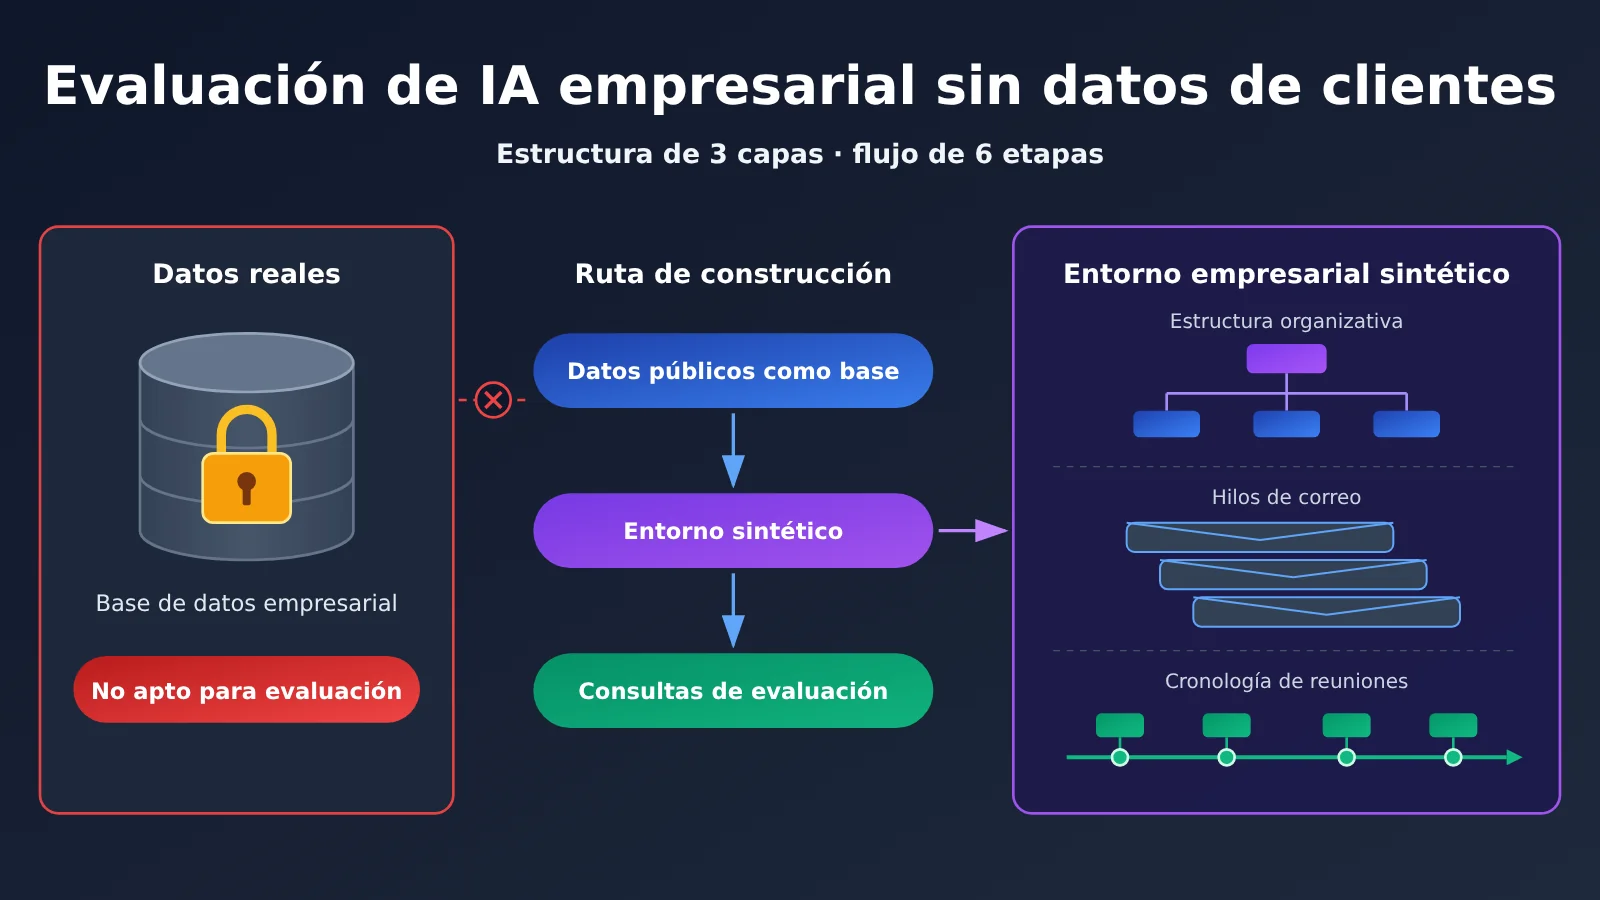
Microsoft llama a este sistema Industry Evaluation Data Generation Platform (plataforma de generación de datos para evaluaciones sectoriales). Según el artículo original, se apoya en tres pilares, unidos por una capa de automatización de extremo a extremo.
| Componente | Descripción original | Problema que resuelve |
|---|---|---|
| Entorno empresarial sintético | Un espacio de trabajo de Copilot simulado, con usuarios, reuniones, correos, documentos y estructura organizativa, sin usar datos de clientes | Ofrece una base para realizar pruebas sin comprometer la privacidad |
| Pipeline automatizado de generación de consultas | Convierte ideas genéricas para consultas en preguntas adaptadas al sector y coherentes con los datos del entorno | Reduce el alto costo de escribir a mano miles de consultas ajustadas a los datos |
| Marco estructurado de calidad | Evalúa desde varias dimensiones si los datos sintéticos cumplen los requisitos | Evita extraer conclusiones erróneas a partir de datos poco realistas |
| Automatización de extremo a extremo | Una misma configuración permite regenerar exactamente el mismo conjunto de datos | Facilita las comparaciones de regresión entre versiones y la coherencia entre equipos |
Por qué los benchmarks generales no detectan los problemas de las aplicaciones de IA empresariales
La dificultad en los entornos empresariales no está en responder preguntas aisladas, sino en entender el contexto de la organización. Si un usuario pide «organiza para cada equipo las tareas pendientes de esta reunión de revisión de seguridad», el modelo debe saber quién asistió, quién es responsable de cada módulo y qué puntos concretos se trataron. Además, debe citar el contenido original del acta en su respuesta. El ejemplo del artículo original plantea que una institución de salud le pide a Copilot resumir una reunión y extraer las tareas pendientes. Lo que se evalúa es si la respuesta es precisa, completa y está fundamentada.
Los benchmarks generales no incluyen relaciones jerárquicas, historial de proyectos, hábitos de comunicación ni procesos específicos de cada sector. Por eso no detectan fallos propios de las empresas, como «atribuir al departamento B una decisión del departamento A» u «omitir una conclusión clave de una reunión entre distintas áreas». La idea de Microsoft es que, si no se pueden usar datos reales, se puede crear un entorno cuya estructura y comportamiento se parezcan a los de una empresa real.
Crear una base para entornos empresariales sintéticos con datos públicos
Cuando se deja que un Modelo de Lenguaje Grande invente toda una estructura organizativa desde cero, el resultado suele tener roles poco variados, relaciones jerárquicas demasiado planas y tareas repetitivas. Microsoft utiliza tres tipos de datos públicos para ajustar sus entornos sintéticos. Todas estas fuentes fueron revisadas y aprobadas por sus departamentos legal y de políticas.
| Fuente de datos públicos | Uso en el artículo original | Alternativa para equipos pequeños y medianos |
|---|---|---|
| Base de datos ocupacional O*NET (Departamento de Trabajo de EE. UU.) | Dar más realismo a los roles y responsabilidades, ajustar la combinación y frecuencia de las actividades de cada rol y adaptar los procesos al sector | Elaborar una lista de roles a partir de descripciones de puestos y clasificaciones profesionales públicas del sector |
| Ofertas de empleo en línea | Obtener nombres de puestos, niveles jerárquicos y estructuras de departamentos reales | Recopilar descripciones de puestos de ofertas públicas del sector y extraer los niveles y la estructura de departamentos |
| Documentos públicos de la SEC | Determinar el tamaño de la organización, la estructura de sus unidades de negocio y su contexto financiero | Consultar las descripciones de segmentos de negocio y número de empleados en los informes anuales de empresas cotizadas |
En la terminología de Microsoft, cada espacio de trabajo simulado se denomina «tenant» (inquilino): un entorno organizativo aislado con sus propios usuarios, datos y configuración. El artículo original destaca que estos entornos son bases ampliables sobre las que cada equipo puede seguir construyendo.
La dimensión temporal: por qué «¿qué se decidió el jueves pasado?» necesita una estructura temporal realista
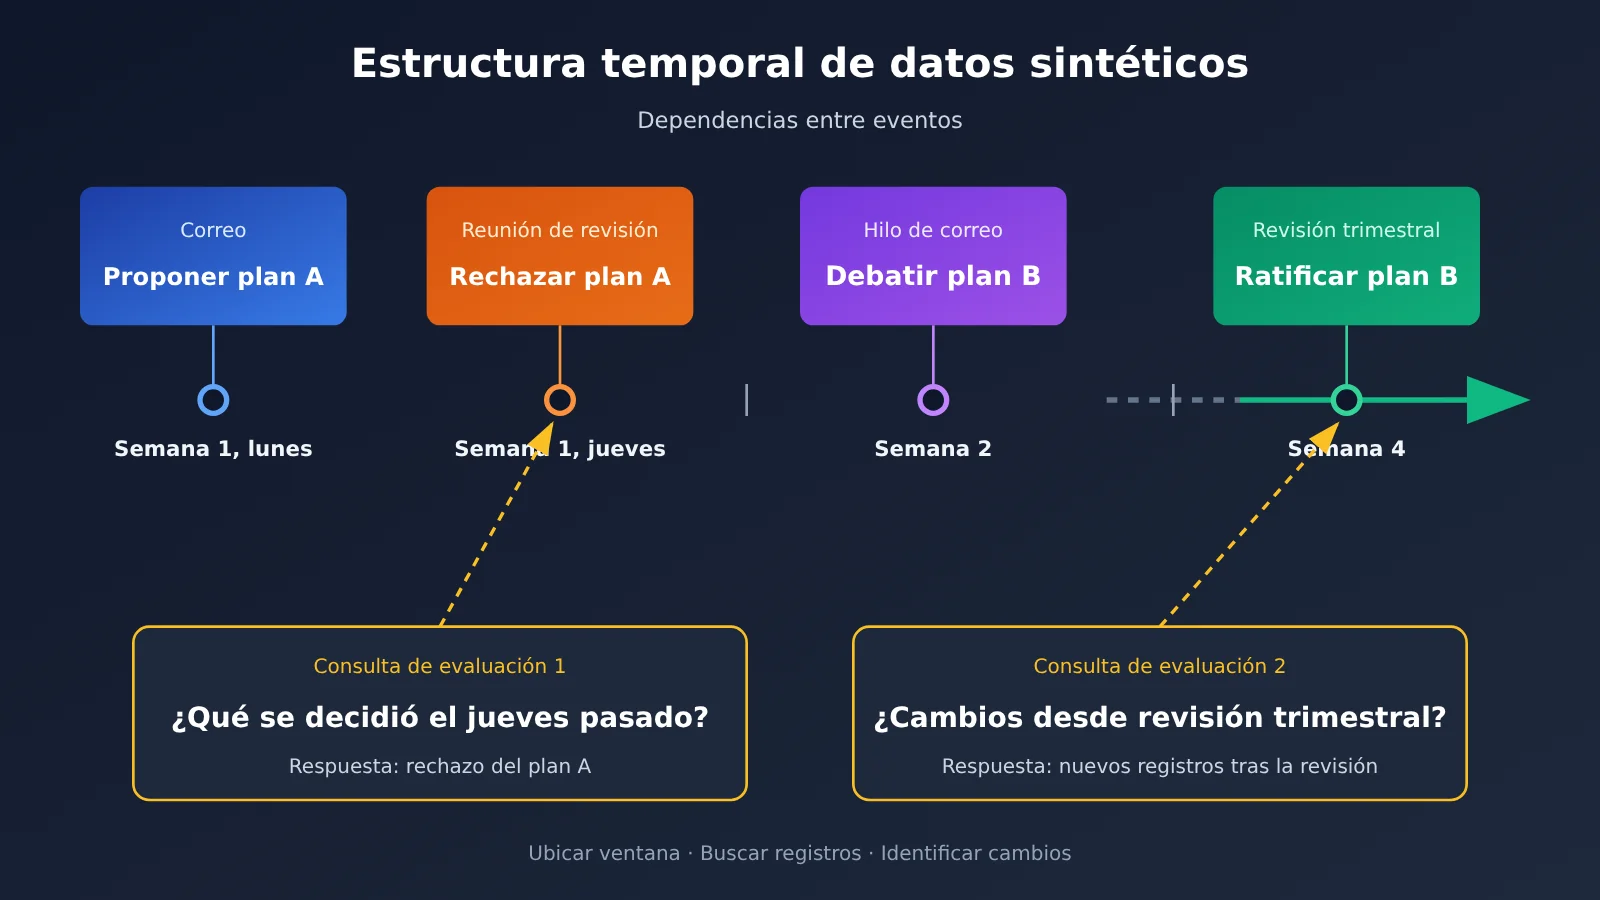
Este es el punto del artículo original que más merece la atención de los equipos pequeños y medianos. El entorno sintético de Microsoft no es una instantánea estática, sino una organización que evoluciona con el tiempo: tiene un historial de reuniones, cronologías de proyectos, hilos de correo que duran semanas y cambios organizativos que surgen de forma natural. El artículo señala que muchas consultas a Copilot incluyen una referencia temporal, como «¿qué decidió el equipo el jueves pasado?» o «¿qué ha cambiado desde la última revisión trimestral?».
Esto se debe a que las preguntas sobre el tiempo le exigen al modelo tres cosas: delimitar el período, encontrar los registros relevantes dentro de él e identificar los cambios ocurridos. Si los datos sintéticos son solo un conjunto de documentos sin relaciones entre sus fechas, o si todas las reuniones se concentran en un mismo día, estas preguntas no tendrán una respuesta de referencia o serán demasiado fáciles, y la evaluación no servirá de mucho. Los datos sintéticos necesitan relaciones de causa y efecto a lo largo del tiempo: por ejemplo, una propuesta se plantea el lunes, se rechaza en la reunión del jueves y la semana siguiente aparece una alternativa en un correo. Solo así una pregunta como «¿qué se decidió el jueves pasado?» puede poner realmente a prueba al modelo.
Especialización por industria: un mismo modelo revela problemas distintos según el sector
Microsoft construyó entornos sintéticos para tres industrias, cada uno basado en procesos de negocio reales:
- Farmacéutica: presentación de documentación regulatoria, discusiones sobre ensayos clínicos y reuniones de revisión de seguridad entre equipos
- Mercados de capitales: flujo de operaciones, comunicaciones de cumplimiento normativo y revisión de carteras de clientes
- Empresas de TI y software: planificación de iteraciones, discusiones de revisión de código y coordinación de lanzamientos de productos
Según el artículo original, adaptar la evaluación a cada industria permite formular consultas más cercanas a las preguntas reales de sus usuarios y detectar fallos específicos que las pruebas genéricas no revelan. Para un equipo interno, el hecho de trabajar normalmente con solo una o dos industrias facilita profundizar en ellas.
Generación automática de consultas: desglose del flujo en seis etapas
Una vez creado el entorno sintético, también hacen falta consultas de evaluación. El artículo original señala que escribir a mano miles de consultas ajustadas a los datos y con características propias de cada industria sería demasiado costoso y lento, por lo que se creó un flujo automatizado. El artículo solo resume cada etapa en un párrafo; la siguiente tabla organiza los seis pasos según el orden descrito, aunque la división concreta debe contrastarse con el diagrama original.
| Etapa | Puntos clave del artículo original | Versión simplificada para equipos pequeños y medianos |
|---|---|---|
| 1. Biblioteca de tareas | Partir de un amplio conjunto de tareas laborales genéricas | Enumerar entre 50 y 100 tareas habituales, como resumir reuniones, buscar decisiones y comparar versiones |
| 2. Filtrado por industria | Seleccionar las tareas relevantes para una industria concreta | Pedir al equipo de negocio que marque las tareas relevantes para su industria |
| 3. Reformulación para el dominio | Reformular las tareas con lenguaje y contexto propios del dominio | Añadir terminología de la industria y tipos de documentos habituales |
| 4. Generación basada en el entorno | Usar IA para generar consultas vinculadas a los datos del entorno sintético | Pedir al modelo que lea documentos o hilos concretos antes de generar las preguntas y que incluya respuestas de referencia y fuentes |
| 5. Reformulación natural | Reformular las consultas para que se parezcan más a preguntas reales | Añadir expresiones coloquiales, omisiones y referencias implícitas, como «¿Qué pasó al final con aquella propuesta?» |
| 6. Validación | Comprobar la exactitud y unicidad de cada consulta | Eliminar duplicados y comprobar por muestreo si cada respuesta tiene una única base en los datos |
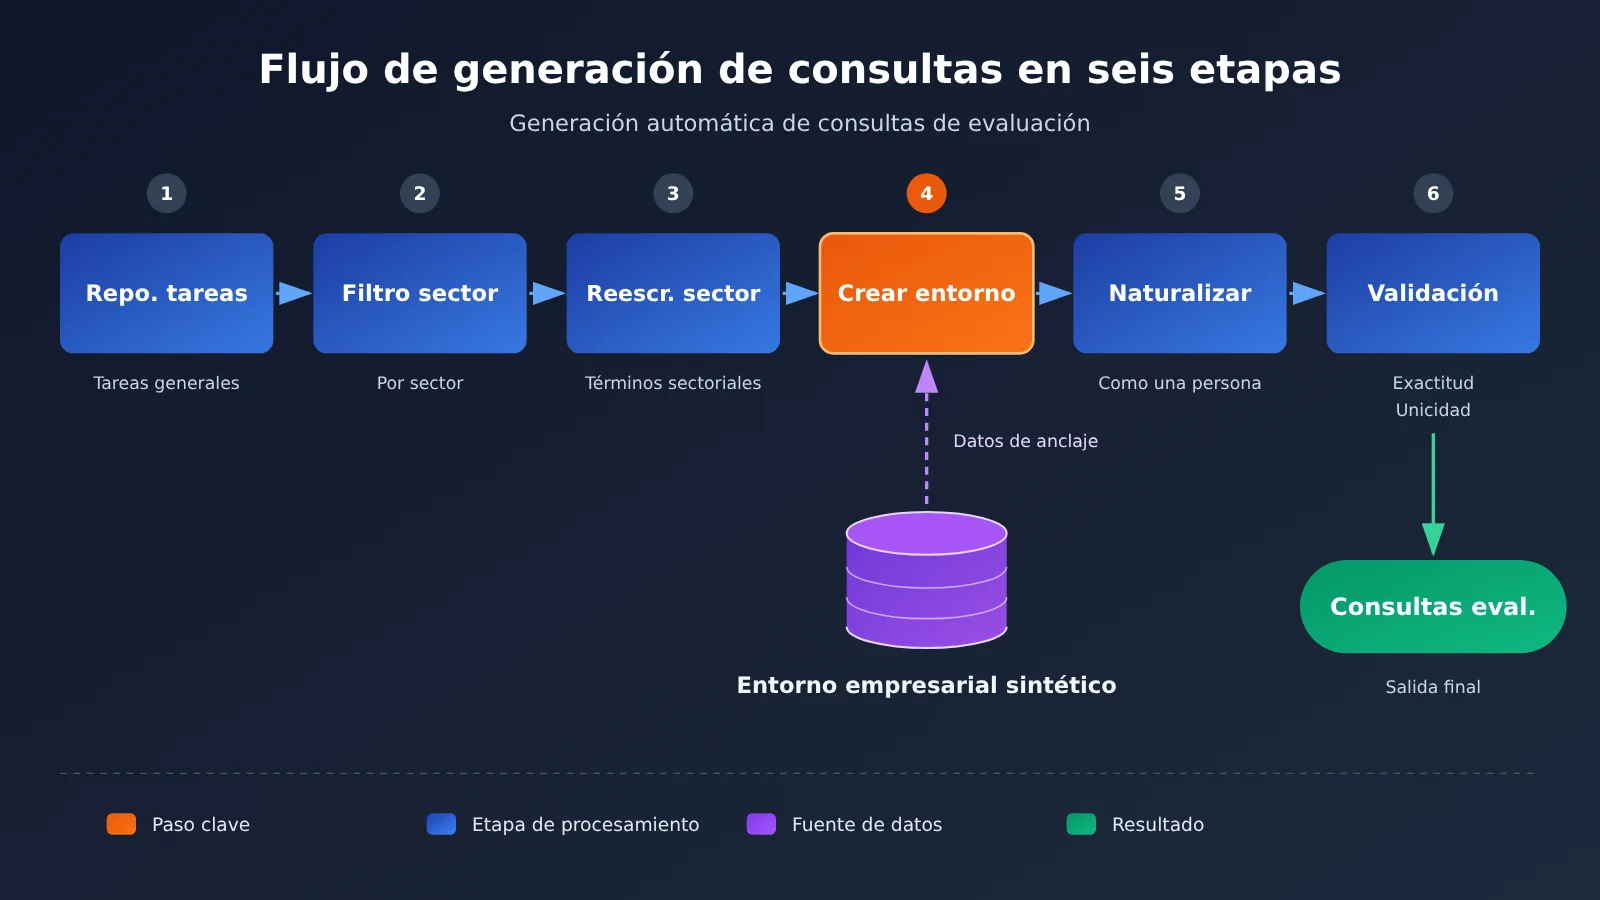
El paso 4 es la clave de todo el flujo: las consultas deben estar vinculadas a datos concretos del entorno; de lo contrario, no se puede determinar si una respuesta es correcta. La «unicidad» del paso 6 también se pasa por alto con facilidad. Si una misma pregunta tiene varias respuestas razonables en los datos, la puntuación puede resultar discutible.
En los pasos 4 y 5 se puede usar un modelo para generar las preguntas y otro para reformularlas de forma natural o validarlas. Así se reduce el sesgo que puede aparecer cuando un mismo modelo se pregunta y se responde a sí mismo. Al invocar varios modelos mediante la interfaz compatible con OpenAI de APIYI, apiyi.com, basta con cambiar el nombre del modelo; el script de generación prácticamente no necesita modificaciones.
🎯 Consejo técnico: durante la generación de consultas, conviene fijar la plantilla de indicaciones, el nombre del modelo y parámetros como la semilla aleatoria, y guardarlos en un archivo de configuración. Así, al comparar modelos, la única variable será el propio modelo. Con la interfaz unificada de APIYI, puedes alternar entre modelos de distintos proveedores para generar y validar consultas dentro del mismo flujo.
Validación de la calidad de los datos sintéticos: primero los datos, después el modelo
Los datos sintéticos también necesitan evaluarse. De lo contrario, una puntuación alta del modelo podría deberse simplemente a que los datos son demasiado fáciles. El texto original indica que se utilizó un marco interno de evaluación semántica para medir la calidad en «tres dimensiones», pero enumera cuatro. La tabla recoge las cuatro; ten en cuenta esta discrepancia al citarlas.
| Dimensión de calidad | Pregunta de evaluación original | Cómo comprobarla en la práctica |
|---|---|---|
| Fidelidad estructural | ¿La estructura organizativa refleja jerarquías reales, tamaños de equipo y relaciones entre áreas? | Analizar la profundidad de las jerarquías y la distribución del tamaño de los equipos, y compararlas con datos públicos |
| Relevancia contextual | ¿Las consultas y los flujos de trabajo representan patrones de uso reales en las empresas? | Pedir a personal del área de negocio que evalúe a ciegas una muestra de consultas y puntúe si parecen preguntas reales |
| Realismo del comportamiento | ¿Los usuarios simulados muestran patrones de comunicación y dinámicas de colaboración similares a los humanos? | Comprobar si los correos tienen cadenas de respuestas y si en las reuniones hay desacuerdos y seguimiento posterior |
| Seguridad del contenido | ¿El contenido está libre de material dañino, ofensivo o de información personal identificable, y evita hacerse pasar por personas reales? | Buscar automáticamente nombres, teléfonos y formatos de números de identificación, y revisarlos manualmente |
Según los resultados del texto original, el indicador global de calidad mejoró un 39% con respecto al método de generación inicial. En algunos entornos sectoriales, la puntuación de calidad superó 0.9 sobre un máximo de 1.0. El texto atribuye la mejora a dos factores: la incorporación de señales reales de la industria y el uso de un indicador global de calidad para impulsar mejoras automatizadas. Cabe aclarar que estas puntuaciones miden hasta qué punto los datos sintéticos se parecen a los de empresas reales, no el rendimiento de Copilot. El texto original no revela las métricas de Copilot en estos conjuntos de datos.
Reproducibilidad: la clave para usar conjuntos de evaluación sintéticos en pruebas de regresión entre versiones
El artículo original enumera cuatro problemas prácticos de trabajar sin automatización:
- Reproducibilidad: los procesos manuales producen pequeñas diferencias en cada ejecución, lo que dificulta comparar versiones.
- Escala: la cantidad de sectores y variantes de configuración supera la capacidad de trabajo manual.
- Velocidad de iteración: la creación manual tarda días y retrasa la retroalimentación.
- Consistencia entre equipos: sin herramientas estandarizadas, los formatos y la calidad de los conjuntos de datos no son compatibles entre equipos.
Con la automatización, la creación de conjuntos de datos pasó de requerir varios días de trabajo manual a ejecutarse automáticamente. Microsoft calcula un ahorro aproximado de 100.000 dólares por conjunto de evaluación y de 300.000 dólares en total para el proyecto. Es una estimación basada en su propia escala, por lo que no se puede extrapolar directamente a otros equipos. Según el artículo original, el resultado más importante es que cualquier equipo puede regenerar el mismo conjunto de datos con una configuración idéntica y obtener exactamente los mismos resultados.
Esto es clave para las pruebas de regresión. Si cambias la estrategia de recuperación o sustituyes el modelo y la puntuación baja, debes asegurarte de que el cambio se debe al sistema y no a los datos. Si el conjunto de prueba varía ligeramente cada vez que se regenera, la comparación entre versiones pierde sentido.
Al comparar varios modelos candidatos en APIYI, conviene seguir el mismo principio: fija una versión del conjunto de evaluación sintético y ejecútala por separado con cada modelo. Así, los resultados de la comparación solo reflejarán las diferencias entre modelos.
Guía rápida para crear un conjunto de evaluación empresarial sintético en equipos pequeños y medianos
El sistema de Microsoft abarca el historial completo de comunicaciones de cientos de usuarios, tres entornos sectoriales, revisión legal y un directorio interno compartido. Los equipos pequeños y medianos no necesitan reproducirlo al pie de la letra. Estos son los pasos simplificados a partir del método original.
Pasos para crear el conjunto
- Definir el alcance: elige un escenario de negocio, como «preguntas y respuestas sobre actas de reuniones» o «búsqueda de documentos de proyectos», y céntrate en un solo sector.
- Diseñar la organización: usa ofertas de empleo públicas y documentación del sector para crear una organización virtual de 20 a 50 personas. Define sus departamentos, niveles jerárquicos y relaciones de reporte.
- Preparar la cronología: redacta primero una cronología del proyecto de 4 a 8 semanas, con los eventos clave, los puntos de decisión y los cambios. Después, genera actas de reuniones, correos y documentos a partir de ella, respetando las dependencias entre eventos.
- Generar el contenido: usa un Modelo de Lenguaje Grande para generar los documentos uno a uno según la cronología. Cada documento debe incluir metadatos como fecha, autor y participantes.
- Generar las consultas: crea las preguntas siguiendo el proceso de seis etapas descrito arriba. Añade a cada una una respuesta de referencia y el número del documento de origen, y marca por separado las consultas temporales.
- Validar los datos: revisa una muestra según las cuatro dimensiones de calidad y ejecuta el análisis de información de identificación personal (PII) sobre todos los datos.
- Gestionar versiones: guarda en la configuración la definición de la organización, la cronología, las indicaciones, los nombres de los modelos y sus parámetros, y asígnale un número de versión.
- Ejecutar la evaluación: ejecuta el sistema que quieres evaluar sobre una versión fija del conjunto de datos y registra las puntuaciones de cada tipo de consulta.
🚀 Para empezar rápido: los pasos 4 y 5 requieren invocar repetidamente Modelos de Lenguaje Grande. Con la interfaz compatible con OpenAI de APIYI apiyi.com, puedes acceder a varios modelos de la misma forma: usa uno para generar y otro para validar, cambiando solo el nombre del modelo.
Lista de comprobación
- [ ] Los datos de evaluación no contienen ningún dato real de clientes o empleados
- [ ] La estructura organizativa tiene jerarquías y colaboración entre departamentos, no es una lista plana
- [ ] Los datos tienen una estructura temporal realista, abarcan al menos varias semanas y muestran relaciones de causa y efecto entre eventos
- [ ] Incluyen cierta proporción de consultas temporales, como «la semana pasada» o «desde la última revisión»
- [ ] Las consultas utilizan terminología y tipos de documentos propios del sector
- [ ] Cada consulta tiene una única respuesta de referencia verificable y su fuente
- [ ] Los datos sintéticos pasan por controles de calidad antes de utilizarse
- [ ] La misma configuración permite regenerar el mismo conjunto de datos
Qué etapas requieren una inversión a gran escala y cuáles se pueden simplificar
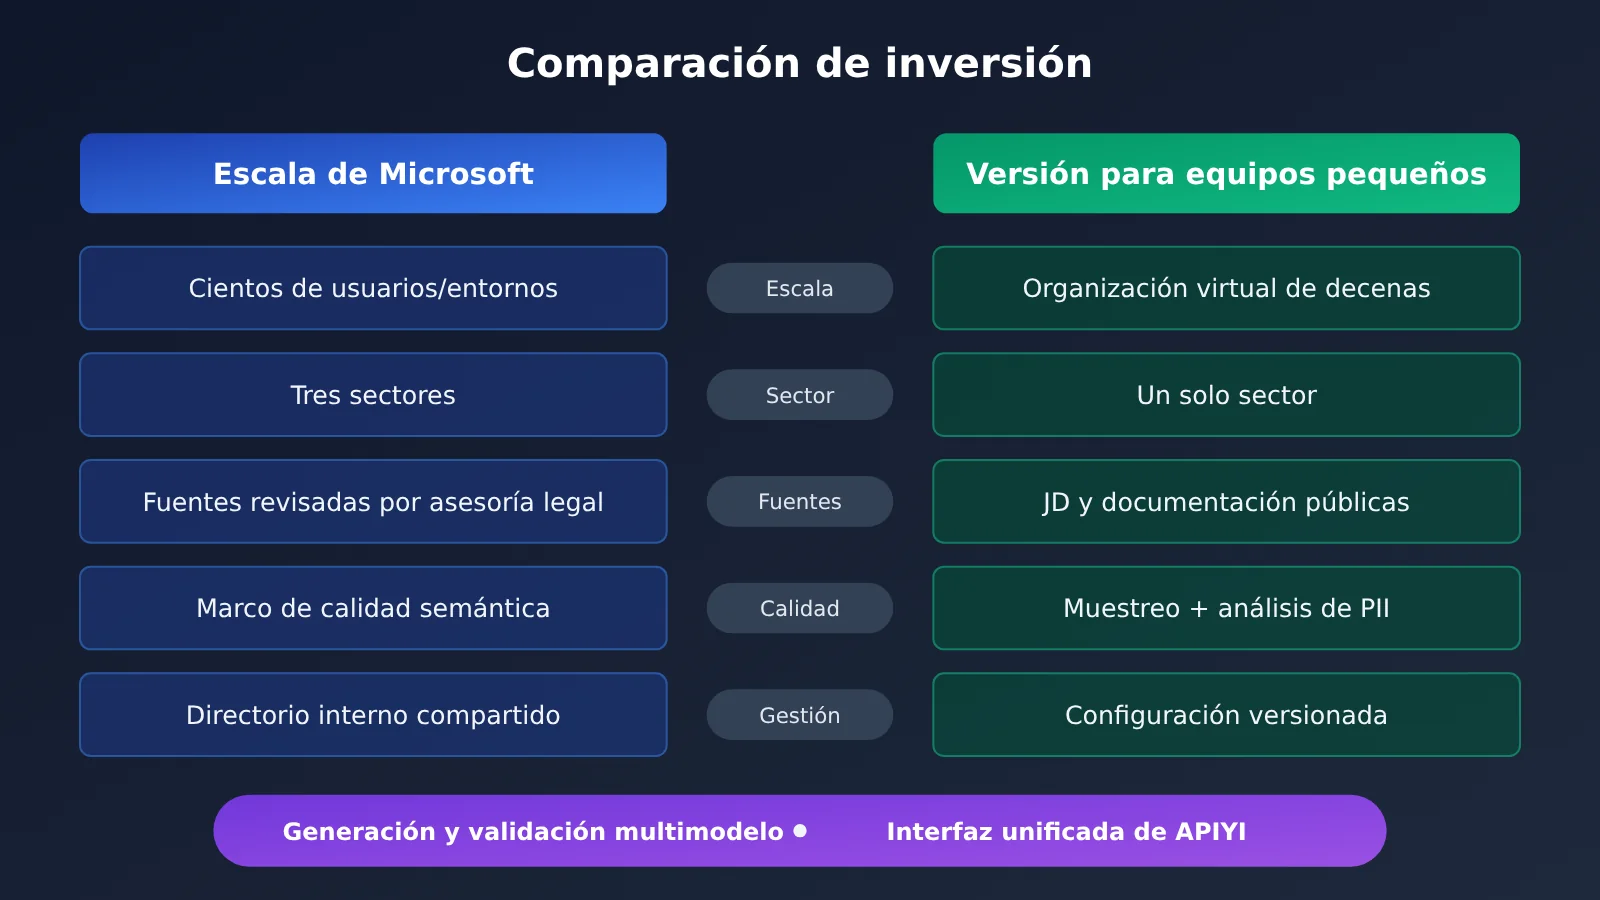
| Etapa | Enfoque de Microsoft | Nivel de inversión | Recomendación para equipos pequeños y medianos |
|---|---|---|---|
| Incorporación de datos públicos | O*NET, ofertas de empleo y documentos de la SEC, con revisión legal | Alto | Basta con recopilar manualmente documentación del sector, pero hay que confirmar que se pueden utilizar las fuentes |
| Escala del entorno | Cientos de usuarios por entorno, con historial completo de comunicaciones | Alto | Unas decenas de personas bastan para cubrir los roles principales |
| Cobertura sectorial | Tres sectores | Medio | Centrarse en el sector al que se presta servicio |
| Marco de calidad | Marco interno de evaluación semántica e indicadores integrales | Alto | Muestreo manual + estadísticas sencillas + análisis automático de PII |
| Estructura temporal | Organización que evoluciona con el tiempo | Imprescindible | Crear primero una línea temporal y después generar el contenido |
| Reproducibilidad | La misma configuración genera los mismos resultados | Imprescindible | Versionar la configuración y guardar en caché los resultados generados |
Se pueden reducir la escala y el grado de automatización, pero no conviene prescindir de la estructura temporal, el anclaje de las consultas y la reproducibilidad. Estos tres elementos determinan si los resultados de la evaluación sirven para tomar decisiones de puesta en producción. Cabe aclarar que actualmente no hay información pública sobre el costo y los resultados reales de aplicar este método en equipos pequeños y medianos; las recomendaciones anteriores son deducciones basadas en el método del artículo original.
Preguntas frecuentes FAQ
Q1: ¿Qué es un conjunto de evaluación de entorno empresarial sintético?
Es un espacio de trabajo empresarial simulado, generado íntegramente mediante software, que incluye empleados, estructuras organizativas, reuniones, correos y documentos, junto con un conjunto de consultas de evaluación basadas en esos datos. Sirve para comprobar si las aplicaciones de IA empresarial pueden encontrar, integrar y presentar la información correcta sin acceder a datos reales de clientes.
Q2: ¿En qué se diferencia un conjunto de evaluación sintético de una prueba de referencia general?
Las pruebas de referencia generales son valiosas para comparar capacidades de forma transversal, pero carecen de relaciones jerárquicas, historiales de proyectos y procesos específicos de cada ámbito. Un entorno empresarial sintético conserva esas estructuras y permite detectar fallos específicos que los casos de prueba generales no revelan, como confundir la pertenencia a un departamento o pasar por alto decisiones tomadas en reuniones entre equipos.
Q3: ¿Cuándo se hizo público este método de Microsoft?
Microsoft Research publicó una entrada de blog sobre el tema el 30 de octubre de 2026. Según el artículo original, la plataforma ya se había publicado en un directorio interno compartido y se había convertido en la primera referencia de evaluación estandarizada de Microsoft Copilot.
Q4: ¿Para qué escenarios es más adecuado este método?
– **Preguntas y respuestas sobre actas de reuniones**: comprobar la precisión de los resúmenes, la extracción de tareas y las citas
– **Búsqueda de conocimiento empresarial**: comprobar si se puede encontrar la única fuente correcta entre una gran cantidad de documentos
– **Consultas temporales**: probar preguntas como «¿qué se decidió la semana pasada?» o «¿qué ha cambiado recientemente?»
– **Pruebas de regresión de modelos o versiones**: comparar soluciones nuevas y anteriores con un conjunto de datos fijo
Q5: ¿Cómo se pueden comparar distintos modelos con el mismo conjunto de evaluación sintético?
La clave es mantener fija la versión del conjunto de datos y cambiar únicamente el modelo evaluado. APIYI apiyi.com ofrece una interfaz unificada compatible con OpenAI que admite varios modelos populares. Para cambiar entre ellos, basta con modificar el nombre del modelo, por lo que puedes evaluar todos los candidatos con el mismo script. Eso sí, tendrás que implementar por tu cuenta la lógica de puntuación y el marco de evaluación.
Q6: ¿Pueden los datos sintéticos distorsionar los resultados de la evaluación?
Es posible. Por eso, el artículo original establece un marco de calidad que evalúa primero los datos y después el modelo. Si los datos sintéticos son demasiado uniformes y carecen de desacuerdos y ruido propios de situaciones reales, las puntuaciones del modelo pueden ser artificialmente altas. Se recomienda pedir al personal del área de negocio que evalúe a ciegas una muestra de los datos y calibrar periódicamente los datos sintéticos con comentarios reales anonimizados.
Q7: ¿Cuáles son las limitaciones conocidas de este método?
El artículo original no publica las indicaciones, las herramientas ni los detalles de implementación de cada fase del proceso, y tampoco revela las métricas de evaluación de Copilot. El marco de calidad menciona «tres dimensiones», pero enumera cuatro. El ahorro económico es una estimación de la propia Microsoft. El artículo también señala que las interacciones de varias rondas entre agentes, la evolución de una organización a lo largo de meses o incluso años y los sistemas de IA que ejecutan acciones son problemas de evaluación que aún quedan por resolver.
Puntos clave sobre los conjuntos de evaluación de entornos empresariales sintéticos
- Estructura de tres capas: un entorno sintético como base, generación automática de consultas y validación de la calidad de los datos. Sin cualquiera de las tres, la evaluación no es fiable.
- Calibración con datos públicos: usa bases de datos de profesiones, ofertas de empleo e informes financieros públicos para que la estructura de la organización se acerque a la realidad.
- La estructura temporal es indispensable: las consultas sobre el tiempo requieren datos con una secuencia de eventos y relaciones causales realistas.
- La especialización sectorial mejora la detección: las consultas adaptadas al dominio tienen más probabilidades de revelar fallos específicos de ese ámbito.
- Evalúa primero los datos y después el modelo: comprueba los datos sintéticos desde cuatro perspectivas: estructura, contexto, comportamiento y seguridad.
- La reproducibilidad es esencial para las pruebas de regresión: generar los mismos datos con la misma configuración permite comparar versiones de forma significativa.
- Comparación entre modelos: una vez fijado el conjunto de datos, puedes cambiar el nombre del modelo mediante la interfaz unificada de APIYI para compararlos.
Resumen
El método de Microsoft Copilot para crear entornos empresariales sintéticos se puede resumir en tres puntos:
- Usar datos sintéticos para proteger la privacidad: al no utilizar datos de clientes desde el principio, el conjunto de datos se puede compartir y reutilizar libremente entre equipos.
- Aportar realismo mediante la estructura: la jerarquía organizativa, la cronología y los procesos del sector determinan si la evaluación puede detectar problemas reales.
- Garantizar la reproducibilidad mediante la automatización: si una misma configuración produce el mismo conjunto de datos, los resultados de la evaluación pueden respaldar las decisiones de lanzamiento.
Los equipos pequeños y medianos no necesitan replicar la escala de Microsoft, pero sí vale la pena adoptar tres prácticas: estructurar el tiempo, vincular las consultas a los datos y versionar las configuraciones. Lo recomendable es empezar con un escenario, un sector y una organización virtual de unas pocas decenas de personas, completar el proceso de principio a fin y ampliar el alcance gradualmente.
Una vez fijado el conjunto de datos, puedes acceder a varios modelos a través de APIYI apiyi.com con el mismo método de invocación compatible con OpenAI y comparar directamente su rendimiento sobre el mismo conjunto de evaluación sintético.
📚 Referencias
- Microsoft Research Blog – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence: fuente original del análisis del método
- Enlace:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
Descripción: incluye la descripción original del entorno sintético, la canalización de seis etapas, el marco de calidad, el diseño de privacidad y los resultados
-
Base de datos de ocupaciones O*NET: base de datos de información laboral del Departamento de Trabajo de Estados Unidos
- Enlace:
onetonline.org -
Descripción: se utilizó para calibrar la distribución de roles, responsabilidades y actividades laborales de los empleados sintéticos
-
Buscador de documentos públicos SEC EDGAR: documentos públicos de la Comisión de Bolsa y Valores de Estados Unidos
- Enlace:
sec.gov/edgar - Descripción: se utilizó para determinar el tamaño, la estructura de las unidades de negocio y el contexto financiero de la organización sintética
Autor: Equipo técnico de APIYI
Intercambio técnico: Si tienes preguntas sobre el acceso unificado a varios modelos, contáctanos a través del sitio web de APIYI apiyi.com