ملاحظة الكاتب: نستعرض منهج بيئة المؤسسة الاصطناعية الذي كشفته Microsoft Copilot، ونحلّل طبقاته الثلاث: البيئة الاصطناعية، والتوليد الآلي للاستعلامات، والتحقق من الجودة. كما نلخّص خطوات وقائمة تحقق يمكن للفرق الصغيرة والمتوسطة الاستعانة بها لبناء مجموعات تقييم.
عندما يستعد مساعد ذكاء اصطناعي أو تطبيق معرفي للإطلاق داخل مؤسسة، يواجه المسؤولون عن التقييم مشكلة شائعة: رسائل البريد الإلكتروني ومحاضر الاجتماعات ووثائق المشاريع الخاصة بالشركة هي الأقدر على عكس الأداء الحقيقي، لكنها تحتوي على معلومات حساسة لا يمكن استخدامها في الاختبار. وفي المقابل، لا تكشف نتائج المعايير العامة وحدها عن المشكلات التي تظهر في سياقات العمل الفعلية. نستعرض في هذا المقال منهج بناء مجموعات التقييم القائم على بيئة مؤسسة اصطناعية + توليد آلي للاستعلامات + التحقق من الجودة، استنادًا إلى تدوينة نشرتها Microsoft Research في 30 أكتوبر 2026.
هذا المقال ليس إعادة صياغة للدعاية الرسمية. فالمحتوى الذي نشرته Microsoft يركّز على إطار المنهج، ولا يتضمن الموجهات أو شيفرة الأدوات، كما لا يكشف عن مؤشرات أداء Copilot المحددة على مجموعات البيانات هذه. سنميّز بين ما ورد صراحةً في المصدر وما نستنتجه نحن، ثم نلخّص المنهج في خطوات يمكن للفرق الصغيرة والمتوسطة الاستفادة منها.
الفائدة الأساسية: بعد قراءة المقال، ستفهم المشكلة التي تعالجها كل طبقة من طبقات مجموعة التقييم الاصطناعية للمؤسسات، ولماذا لا يمكن إغفال البعد الزمني والتخصيص حسب القطاع، وستتمكن من استخدام قائمة التحقق لاكتشاف الثغرات في عملية التقييم لديك.
أبرز ركائز مجموعة تقييم بيئات المؤسسات الاصطناعية
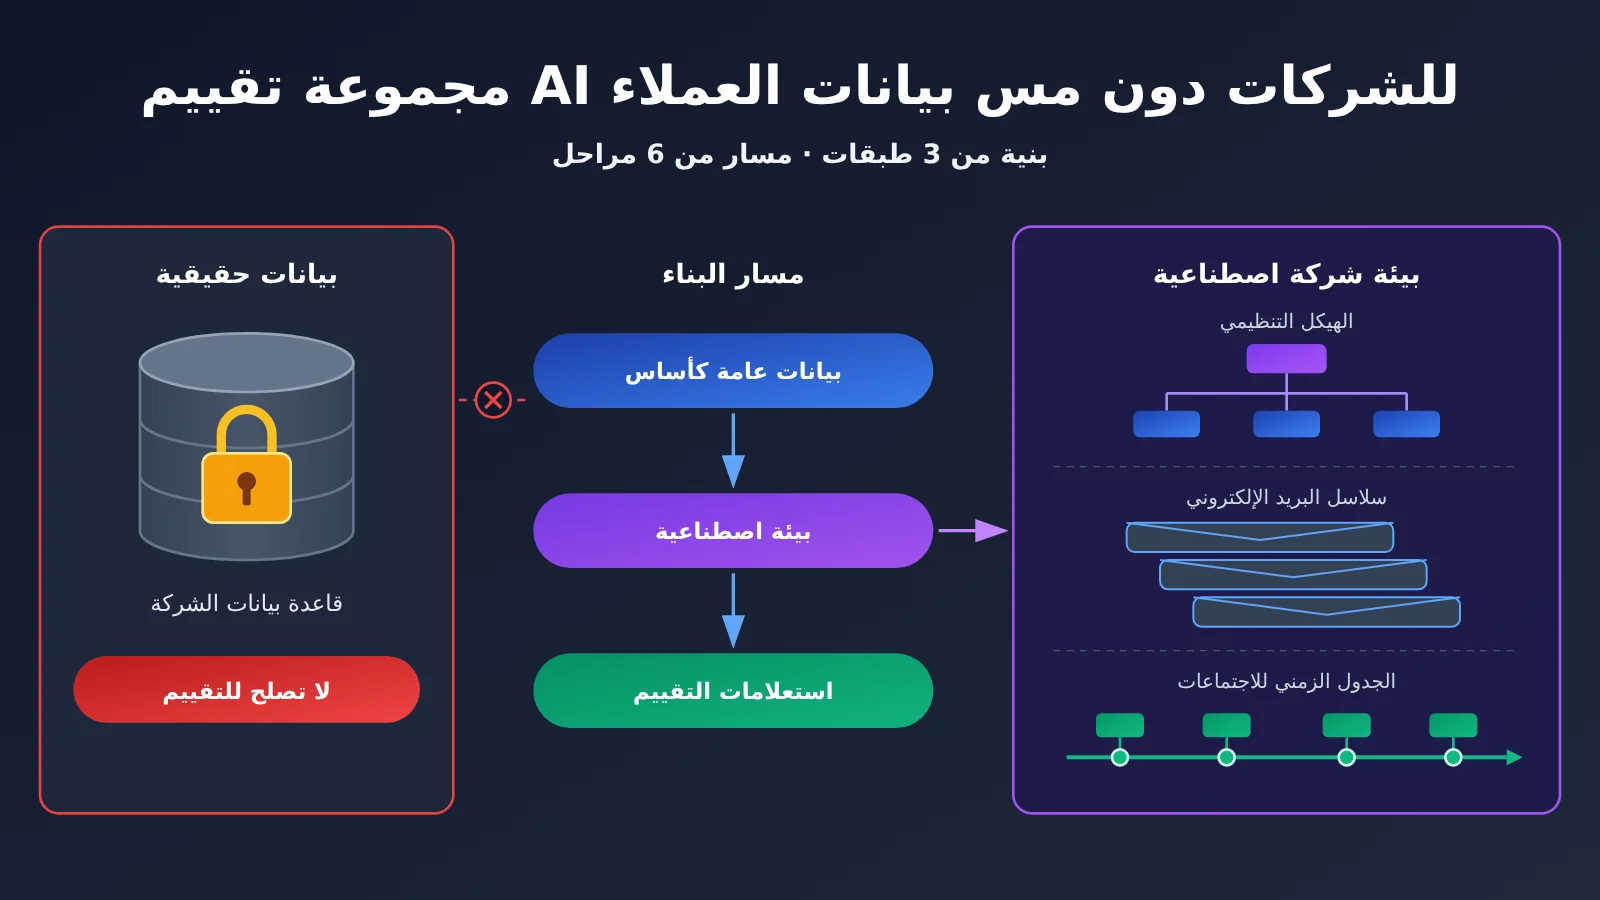
تطلق Microsoft على هذا النظام اسم Industry Evaluation Data Generation Platform، أو منصة توليد بيانات التقييم للقطاعات. وبحسب المصدر، يقوم النظام على ثلاث ركائز، تربط بينها طبقة من الأتمتة الشاملة.
| المكوّن | الوصف في المصدر | المشكلة التي يحلّها |
|---|---|---|
| بيئة مؤسسة اصطناعية | مساحة عمل Copilot محاكاة تضم مستخدمين واجتماعات ورسائل بريد إلكتروني ومستندات وهيكلًا تنظيميًا، دون استخدام أي بيانات للعملاء | توفير أساس قابل للاختبار دون المساس بالخصوصية |
| خط أنابيب آلي لتوليد الاستعلامات | يحوّل الأفكار العامة للاستعلامات إلى أسئلة متخصصة في القطاع ومتوافقة مع بيانات البيئة | ارتفاع تكلفة كتابة آلاف الاستعلامات المتوافقة مع البيانات يدويًا |
| إطار جودة منظّم | يقيس مدى صلاحية البيانات الاصطناعية وفق أبعاد متعددة | تجنّب استخلاص نتائج خاطئة من بيانات غير واقعية على نحو مبالغ فيه |
| أتمتة شاملة | تتيح إعادة توليد مجموعة البيانات نفسها تمامًا باستخدام الإعدادات ذاتها | مقارنة النتائج بين الإصدارات للكشف عن التراجع، وضمان الاتساق بين الفرق |
لماذا لا تكشف معايير التقييم العامة مشكلات تطبيقات الذكاء الاصطناعي في المؤسسات؟
لا تكمن صعوبة سيناريوهات المؤسسات في الأسئلة والأجوبة ذات الجولة الواحدة، بل في سياق المؤسسة. فعندما يطلب المستخدم «تنظيم بنود العمل الناتجة عن اجتماع المراجعة الأمنية وتوزيعها على الفرق»، يحتاج النموذج إلى معرفة المشاركين، والمسؤول عن كل جزء، والتفاصيل التي نوقشت، مع الاستشهاد بنص محضر الاجتماع في إجابته. والمثال الوارد في المصدر هو مؤسسة صحية تستخدم Copilot لتلخيص اجتماع واستخراج بنود العمل، والهدف هو التحقق من أن الإجابة دقيقة وكاملة ومدعومة بالأدلة.
تفتقر معايير التقييم العامة إلى معلومات مثل العلاقات الإدارية وتاريخ المشاريع وعادات التواصل وإجراءات العمل المتخصصة. لذلك لا تكشف إخفاقات خاصة بالمؤسسات، مثل «نسب قرار قسم A إلى قسم B» أو «إغفال نتيجة أساسية من اجتماع بين فرق متعددة». وفكرة Microsoft هي: إذا تعذّر استخدام البيانات الحقيقية، فلننشئ بيئة تشبه المؤسسة الحقيقية في بنيتها وطريقة عملها.
استخدام البيانات العامة كأساس لبيئة مؤسسية اصطناعية
عندما يُعتمد على نموذج لغة كبير وحده لاختلاق هيكل مؤسسة من الصفر، غالبًا ما تكون النتيجة أدوارًا محدودة، وتسلسلًا إداريًا مسطحًا، وطبيعة عمل متكررة. أما Microsoft فتستخدم ثلاثة أنواع من البيانات العامة لضبط البيئة الاصطناعية، وقد راجعت فرقها القانونية وفرق السياسات جميع مصادر البيانات هذه ووافقت عليها.
| مصدر البيانات العامة | استخدامه في المصدر | بديل للفرق الصغيرة والمتوسطة |
|---|---|---|
| قاعدة بيانات المهن O*NET (وزارة العمل الأمريكية) | جعل أدوار الموظفين ومسؤولياتهم أكثر واقعية، وضبط تنوع أنشطة العمل وتكرارها لكل دور، وتخصيص إجراءات العمل حسب القطاع | إعداد قائمة بالأدوار استنادًا إلى توصيفات الوظائف العامة ومعايير التصنيف المهني في القطاع |
| إعلانات الوظائف على الإنترنت | توفير مسميات وظيفية حقيقية ومستويات التسلسل الإداري وتكوين الأقسام | جمع توصيفات الوظائف المنشورة في القطاع المستهدف واستخراج المستويات الوظيفية وهيكل الأقسام |
| إيداعات SEC العامة | تحديد حجم المؤسسة وهيكل وحدات الأعمال والخلفية المالية | الاستعانة بأوصاف قطاعات الأعمال وأعداد الموظفين في التقارير السنوية للشركات المدرجة |
في مصطلحات Microsoft، تُسمّى كل مساحة عمل محاكاة «tenant» (مستأجر)، وهي بيئة مؤسسية معزولة لها مستخدموها وبياناتها وإعداداتها المستقلة. ويؤكد المصدر أن هذه البيئات تشكّل أساسًا قابلًا للتوسّع، يمكن للفرق البناء عليه.
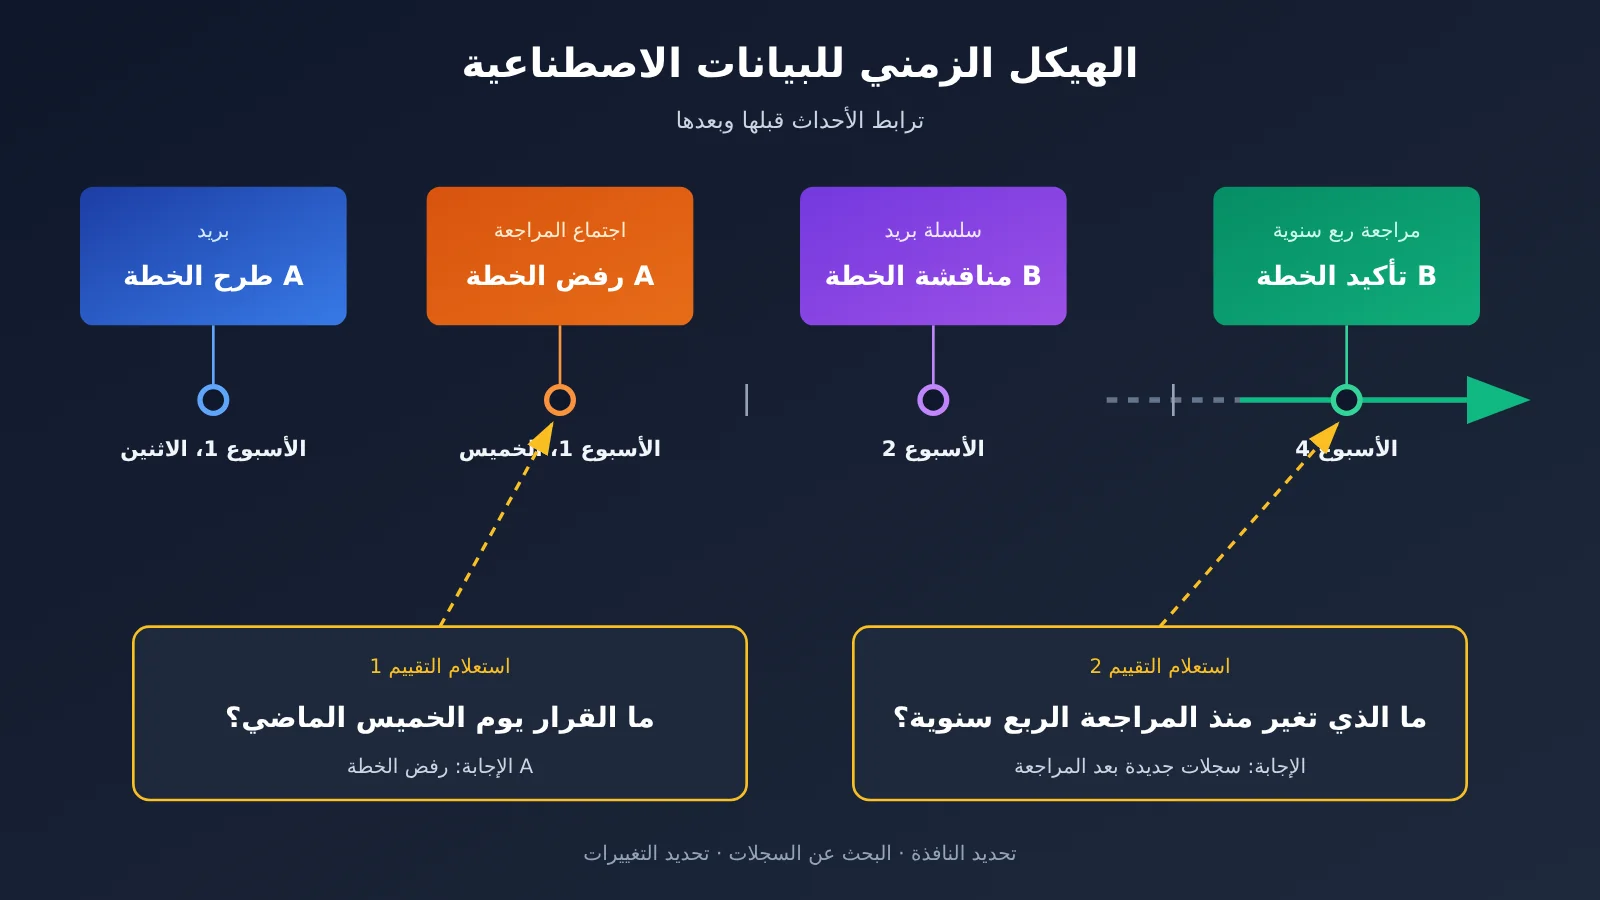
البعد الزمني: لماذا يتطلب سؤال «ما الذي تقرر الخميس الماضي؟» تسلسلاً زمنياً واقعياً
هذه من أهم النقاط التي ينبغي للفرق الصغيرة والمتوسطة الانتباه إليها في المقال الأصلي. فبيئة Microsoft الاصطناعية ليست لقطة ثابتة، بل هي مؤسسة تتطور بمرور الوقت: لها سجل اجتماعات، وجداول زمنية للمشاريع، وسلاسل رسائل بريد إلكتروني تمتد لأسابيع، وتغييرات تنظيمية تحدث بصورة طبيعية. ويشير المقال إلى أن كثيراً من استفسارات Copilot تتعلق بالزمن بطبيعتها، مثل «ما الذي قرره الفريق الخميس الماضي؟» و«ما الذي تغير منذ آخر مراجعة ربع سنوية؟».
والسبب أن الأسئلة الزمنية تتطلب من النموذج إنجاز ثلاث مهام: تحديد النافذة الزمنية، والعثور على السجلات ذات الصلة داخلها، ورصد التغييرات بين الفترتين. فإذا كانت البيانات الاصطناعية مجرد مجموعة وثائق لا تربط تواريخها علاقة، أو كانت الاجتماعات كلها في اليوم نفسه، فلن تكون لهذه الأسئلة إجابة معيارية، أو ستكون الإجابة سهلة جداً، ولن تكون لنتائج التقييم دلالة. لذلك يجب أن تتضمن البيانات الاصطناعية أحداثاً مترابطة زمنياً: يُطرح مقترح يوم الاثنين، ويُرفض في اجتماع الخميس، ثم يظهر مقترح بديل في رسالة بريد إلكتروني الأسبوع التالي. عندها فقط يمكن لسؤال «ما الذي تقرر الخميس الماضي؟» أن يختبر النموذج فعلاً.
التخصص القطاعي: النموذج نفسه يكشف مشكلات مختلفة في كل قطاع
أنشأت Microsoft بيئات اصطناعية لثلاثة قطاعات، تحاكي كل منها إجراءات عمل حقيقية:
- الأدوية: إجراءات الإيداع لدى الجهات التنظيمية، ومناقشات التجارب السريرية، واجتماعات مراجعة السلامة بين الفرق المختلفة
- أسواق رأس المال: مسارات الصفقات، واتصالات الامتثال، ومراجعة محافظ العملاء الاستثمارية
- شركات تقنية المعلومات والبرمجيات: تخطيط دورات التطوير، ومناقشات مراجعة الشفرة، والتنسيق لإطلاق المنتجات
يرى النص الأصلي أن التخصص القطاعي يجعل استعلامات التقييم أقرب إلى الأسئلة التي يطرحها المستخدمون فعلًا في هذه المجالات، ما يكشف أنماط الإخفاق المتخصصة التي لا ترصدها حالات الاختبار العامة. وبالنسبة للفرق الداخلية في الشركات، فإن التركيز عادةً على قطاع واحد أو اثنين يجعل التعمق فيهما أسهل.
التوليد التلقائي للاستعلامات: شرح المراحل الست
بعد إنشاء البيئة الاصطناعية، نحتاج أيضًا إلى استعلامات للتقييم. يوضح المقال الأصلي أن كتابة آلاف الاستعلامات يدويًا، بحيث تتوافق مع البيانات وتعكس طبيعة القطاع، عملية مكلفة وبطيئة للغاية. لذلك أُنشئ خط عمل آلي لهذا الغرض. يوجز المقال مراحل العملية في فقرة واحدة، وقد نظمناها في الجدول التالي إلى ست حلقات بحسب ترتيب وصفها، مع الرجوع إلى الرسم الأصلي لمعرفة التقسيم الدقيق.
| المرحلة | أبرز ما ورد في المقال الأصلي | طريقة مبسطة للفرق الصغيرة والمتوسطة |
|---|---|---|
| 1. مكتبة المهام | البدء بمجموعة كبيرة من مهام العمل العامة | إعداد قائمة تضم 50~100 مهمة شائعة للموظفين، مثل تلخيص الاجتماعات والبحث عن القرارات ومقارنة الإصدارات |
| 2. التصفية حسب القطاع | اختيار المهام المرتبطة بقطاع معين | يحدد فريق العمل المهام ذات الصلة بقطاعه |
| 3. إعادة الصياغة بلغة المجال | إعادة صياغة المهام باستخدام لغة المجال وسياقه | إضافة مصطلحات القطاع وأنواع المستندات المعتادة فيه |
| 4. التوليد استنادًا إلى البيئة | استخدام الذكاء الاصطناعي لتوليد استعلامات مرتبطة ببيانات البيئة الاصطناعية | جعل النموذج يقرأ مستندات أو سلاسل محادثات محددة قبل إنشاء الأسئلة، مع إنتاج الإجابات المرجعية ومصادرها |
| 5. إعادة الصياغة بأسلوب طبيعي | جعل الاستعلامات أقرب إلى أسئلة البشر | إضافة تعبيرات محادثة وحذف بعض الكلمات واستخدام الإحالات، مثل «ماذا حدث لاحقًا لتلك الخطة؟» |
| 6. التحقق | فحص دقة كل استعلام وتفرّده | إزالة التكرار والتحقق بعينات عشوائية من وجود أساس وحيد للإجابة في البيانات |
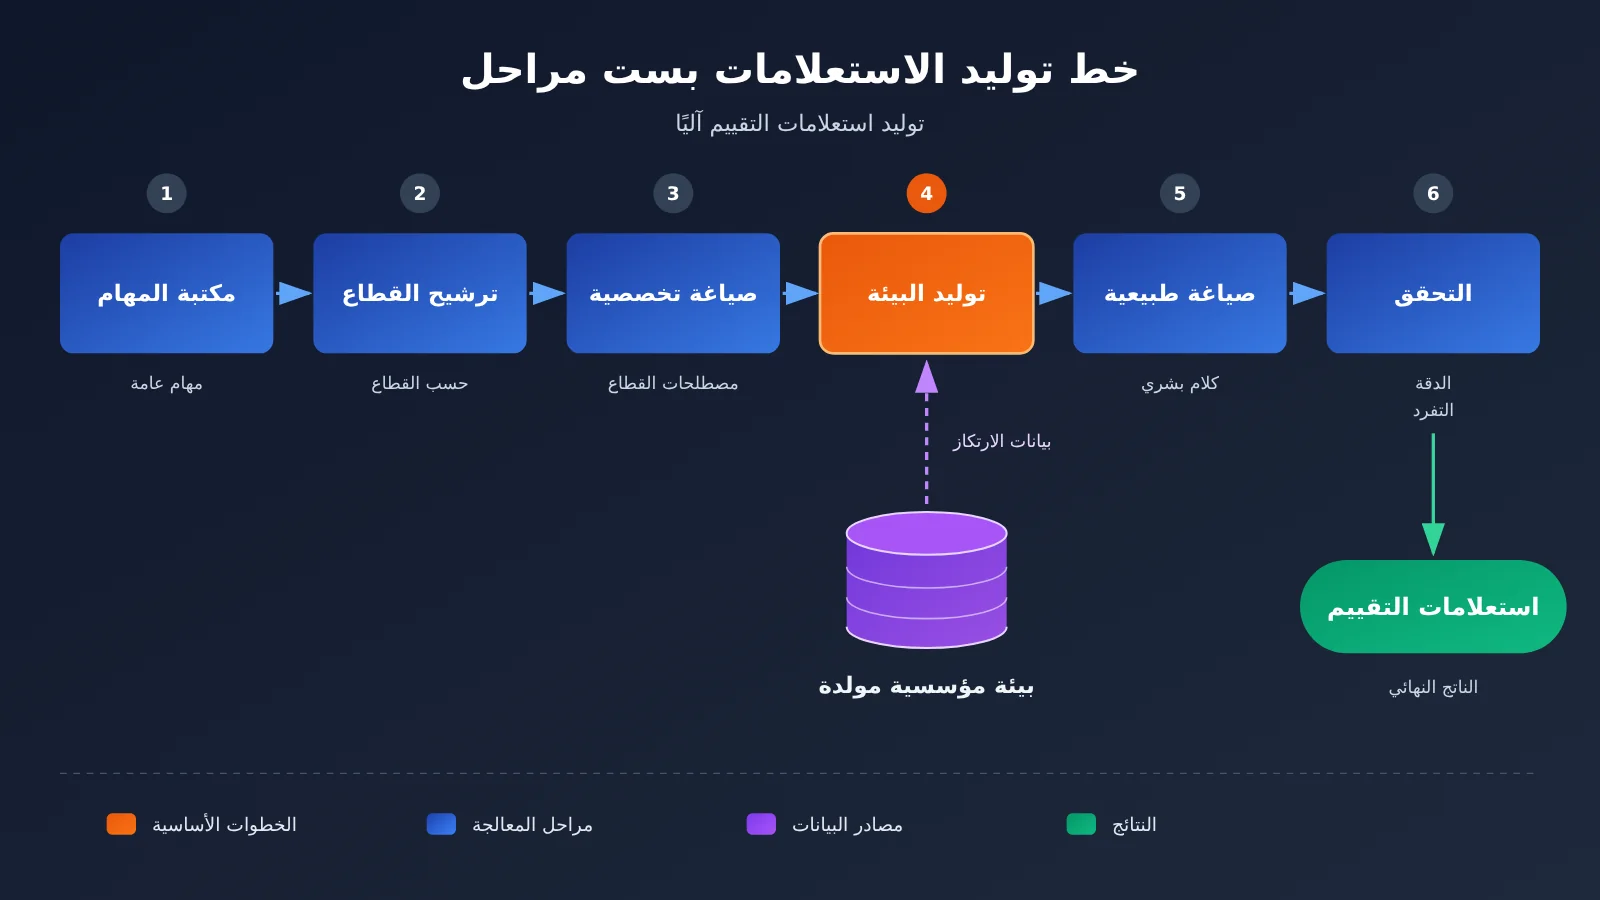
الخطوة الرابعة هي أساس خط العمل كله: يجب أن ترتبط الاستعلامات ببيانات محددة داخل البيئة، وإلا فلن يكون من الممكن تحديد صحة الإجابة. ومن السهل أيضًا إغفال «التفرّد» في الخطوة السادسة؛ فإذا كانت البيانات تحتمل عدة إجابات معقولة للسؤال نفسه، فقد يصبح التقييم محل خلاف.
في الخطوتين الرابعة والخامسة، يمكن استخدام نموذج لإنشاء الأسئلة وآخر لإعادة صياغتها بأسلوب طبيعي أو للتحقق منها، لتقليل التحيز الناتج عن قيام النموذج نفسه بطرح الأسئلة والإجابة عنها. وعند استدعاء نماذج متعددة عبر واجهة APIYI على apiyi.com المتوافقة مع OpenAI، يكفي تغيير اسم النموذج للتبديل بينها، دون الحاجة إلى تعديل يُذكر في سكربت التوليد.
🎯 نصيحة تقنية: يُنصح بتثبيت قالب الموجه واسم النموذج والمعلمات مثل البذرة العشوائية خلال مرحلة توليد الاستعلامات، وتسجيلها في ملف إعدادات. بهذه الطريقة، عند تبديل النموذج لإجراء تجربة مقارنة، يبقى النموذج نفسه المتغير الوحيد. وبفضل واجهة APIYI الموحدة، يمكن التبديل بين نماذج مزودين مختلفين لتوليد الاستعلامات والتحقق منها ضمن خط العمل نفسه.
التحقق من جودة البيانات الاصطناعية: اختبر البيانات قبل النموذج
تحتاج البيانات الاصطناعية نفسها إلى تقييم؛ فقد تكون الدرجة العالية للنموذج ناتجة عن سهولة البيانات فحسب. يذكر النص الأصلي أن الجودة قِيست باستخدام إطار داخلي للتقييم الدلالي وفق «ثلاثة أبعاد»، لكنه يسرد أربعة أبعاد فعليًا. يعرض الجدول التالي الأبعاد الأربعة كما وردت، مع ضرورة الانتباه إلى هذا التباين عند الاقتباس.
| بُعد الجودة | سؤال التحقق في النص الأصلي | طريقة عملية للتحقق |
|---|---|---|
| دقة البنية | هل تعكس البنية التنظيمية تسلسل التبعية الوظيفية الحقيقي، وأحجام الفرق، والعلاقات بين التخصصات؟ | حصر عدد المستويات الإدارية وتوزيع أعداد أعضاء الفرق، ومقارنتها بالبيانات المتاحة للعامة |
| ملاءمة السياق | هل تمثل الاستعلامات وسير العمل أنماط الاستخدام الفعلية في الشركات؟ | مطالبة مختصين من قطاع الأعمال بتقييم عينة من الاستعلامات دون معرفة مصدرها، وتقدير مدى شبهها بالأسئلة الحقيقية |
| واقعية السلوك | هل يتبع المستخدمون المُحاكون أنماط تواصل وديناميكيات تعاون شبيهة بالبشر؟ | التحقق من وجود سلاسل ردود في رسائل البريد، وخلافات ومتابعات في الاجتماعات |
| سلامة المحتوى | هل يخلو المحتوى من المعلومات الضارة أو المسيئة أو التي تحدد هوية الأفراد، ولا ينتحل شخصيات حقيقية؟ | إجراء مسح آلي لأسماء الأشخاص وأرقام الهواتف وصيغ أرقام وثائق الهوية، ثم مراجعة النتائج يدويًا |
وفقًا للنتائج الواردة في النص الأصلي، تحسن مقياس الجودة المركّب بنسبة 39% مقارنةً بطريقة التوليد الأولية، وتجاوزت درجة الجودة في بعض بيئات القطاعات 0.9 من أصل 1.0. ويعزو النص هذا التحسن إلى عاملين: إدخال مؤشرات من قطاعات حقيقية، واستخدام مقياس الجودة المركّب لتوجيه التحسين الآلي للجودة. ومن المهم توضيح أن هذه الدرجات تقيس مدى شبه البيانات الاصطناعية ببيانات الشركات الحقيقية، لا أداء Copilot نفسه. ولم يفصح النص الأصلي عن مؤشرات أداء Copilot على مجموعات البيانات هذه.
قابلية إعادة الإنتاج: شرط استخدام مجموعة تقييم اصطناعية لاختبارات الانحدار بين الإصدارات
عرض المقال الأصلي أربع مشكلات عملية تظهر عند غياب الأتمتة:
- قابلية إعادة الإنتاج: تختلف نتائج العمل اليدوي قليلًا في كل مرة، ما يصعّب المقارنة بين الإصدارات
- الحجم: يفوق عدد القطاعات واختلافات الإعدادات قدرة الفرق على التعامل معها يدويًا
- سرعة التكرار: يستغرق الإعداد اليدوي أيامًا، ما يؤخر الحصول على الملاحظات
- الاتساق بين الفرق: في غياب أدوات موحّدة، تختلف صيغ مجموعات البيانات وجودتها بين الفرق بحيث تصبح غير متوافقة
بعد الأتمتة، أصبح إنشاء مجموعات البيانات عملية تلقائية بدلًا من عمل يدوي يستغرق أيامًا. وتقدّر Microsoft أنها وفّرت نحو 100,000 دولار لكل مجموعة بيانات تقييم، ونحو 300,000 دولار للمشروع ككل. هذا تقدير مبني على حجم عملها، ولا يمكن تطبيقه مباشرةً على فرق أخرى. ويرى المقال الأصلي أن النتيجة الأهم هي أن أي فريق يستطيع إعادة توليد مجموعة البيانات نفسها تمامًا باستخدام ملف الإعدادات ذاته.
وهذا مهم لاختبارات الانحدار. فعندما تغيّر استراتيجية الاسترجاع أو تستبدل النموذج وتنخفض النتائج، عليك التأكد من أن التغيّر ناتج عن النظام لا عن البيانات. وإذا اختلفت مجموعة الاختبار قليلًا في كل مرة تعيد توليدها، تفقد المقارنة بين الإصدارات معناها.
وعند مقارنة عدة نماذج مرشّحة على APIYI، ينبغي اتباع المبدأ نفسه: ثبّت إصدارًا واحدًا من مجموعة التقييم الاصطناعية، ثم استدعِ كل نموذج على حدة واختبره باستخدام المجموعة نفسها. بهذه الطريقة، تعكس نتائج المقارنة الفروق بين النماذج فقط.
دليل سريع للفرق الصغيرة والمتوسطة لبناء مجموعة تقييم مؤسسية اصطناعية
يتضمن نظام Microsoft سجلات اتصال كاملة لمئات المستخدمين، وبيئات لثلاثة قطاعات، ومراجعات قانونية، وأدلة مشاركة داخلية. لا تحتاج الفرق الصغيرة والمتوسطة إلى نسخ هذا النظام بالكامل. فيما يلي خطوات مبسطة تستند إلى المنهج الوارد في المقال الأصلي.
خطوات البناء
- حدد النطاق: اختر سيناريو عمل واحدًا، مثل «الإجابة عن أسئلة حول محاضر الاجتماعات» أو «البحث في وثائق المشروع»، واقتصر على قطاع واحد.
- صمّم الهيكل التنظيمي: استعن بإعلانات الوظائف العامة ومعلومات القطاع لتصميم مؤسسة افتراضية تضم 20 إلى 50 شخصًا، مع تحديد الأقسام والمستويات الوظيفية وعلاقات الإشراف.
- ضع جدولًا زمنيًا: ابدأ بجدول للمشروع يمتد من 4 إلى 8 أسابيع، وسجّل الأحداث الرئيسية ونقاط اتخاذ القرار والتغييرات. ثم أنشئ محاضر الاجتماعات ورسائل البريد الإلكتروني والوثائق بناءً عليه، مع ضمان اتساق ترابطها.
- أنشئ المحتوى: استخدم نموذج لغة كبيرًا لإنشاء الوثائق تباعًا وفق الجدول الزمني، وأرفق بكل وثيقة بيانات وصفية مثل التاريخ والمؤلف والمشاركين.
- أنشئ الاستعلامات: صغ الأسئلة وفق العملية المكونة من ست مراحل المذكورة أعلاه، وأرفق بكل سؤال إجابة مرجعية ورقم الوثيقة المصدر، مع تمييز الاستعلامات المتعلقة بالزمن على حدة.
- تحقق من البيانات: افحص عينات وفق أبعاد الجودة الأربعة، مع ضرورة إجراء فحص المعلومات الشخصية القابلة للتعريف (PII) على جميع البيانات.
- أدر الإصدارات: أدرج إعدادات المؤسسة والجدول الزمني والموجهات وأسماء النماذج ومعلماتها في ملف إعدادات، ثم عيّن رقم إصدار.
- شغّل التقييم: شغّل النظام قيد الاختبار على إصدار ثابت من مجموعة البيانات، وسجّل درجات كل نوع من الاستعلامات.
🚀 للبدء سريعًا: تتطلب الخطوتان 4 و5 استدعاء نموذج اللغة الكبير مرارًا. عبر واجهة APIYI المتوافقة مع OpenAI على apiyi.com، يمكنك الوصول إلى نماذج متعددة بالطريقة نفسها: استخدم نموذجًا للتوليد وآخر للتحقق، مع تغيير اسم النموذج فقط.
قائمة التحقق الذاتي
- [ ] لا تحتوي بيانات التقييم على أي بيانات حقيقية للعملاء أو الموظفين
- [ ] للهيكل التنظيمي مستويات واضحة وتعاون بين الأقسام، وليس مجرد قائمة مسطحة
- [ ] تتبع البيانات تسلسلًا زمنيًا واقعيًا يغطي عدة أسابيع على الأقل، وتربط بين أحداثه علاقات سببية
- [ ] تتضمن نسبة من الاستعلامات أسئلة زمنية، مثل «الأسبوع الماضي» و«منذ آخر مراجعة»
- [ ] تستخدم الاستعلامات مصطلحات القطاع وأنواع مستنداته
- [ ] لكل استعلام إجابة مرجعية واحدة يمكن التحقق منها، مع مصدرها
- [ ] خضعت البيانات الاصطناعية لفحص الجودة قبل استخدامها
- [ ] يمكن إعادة توليد مجموعة البيانات نفسها باستخدام الإعدادات نفسها
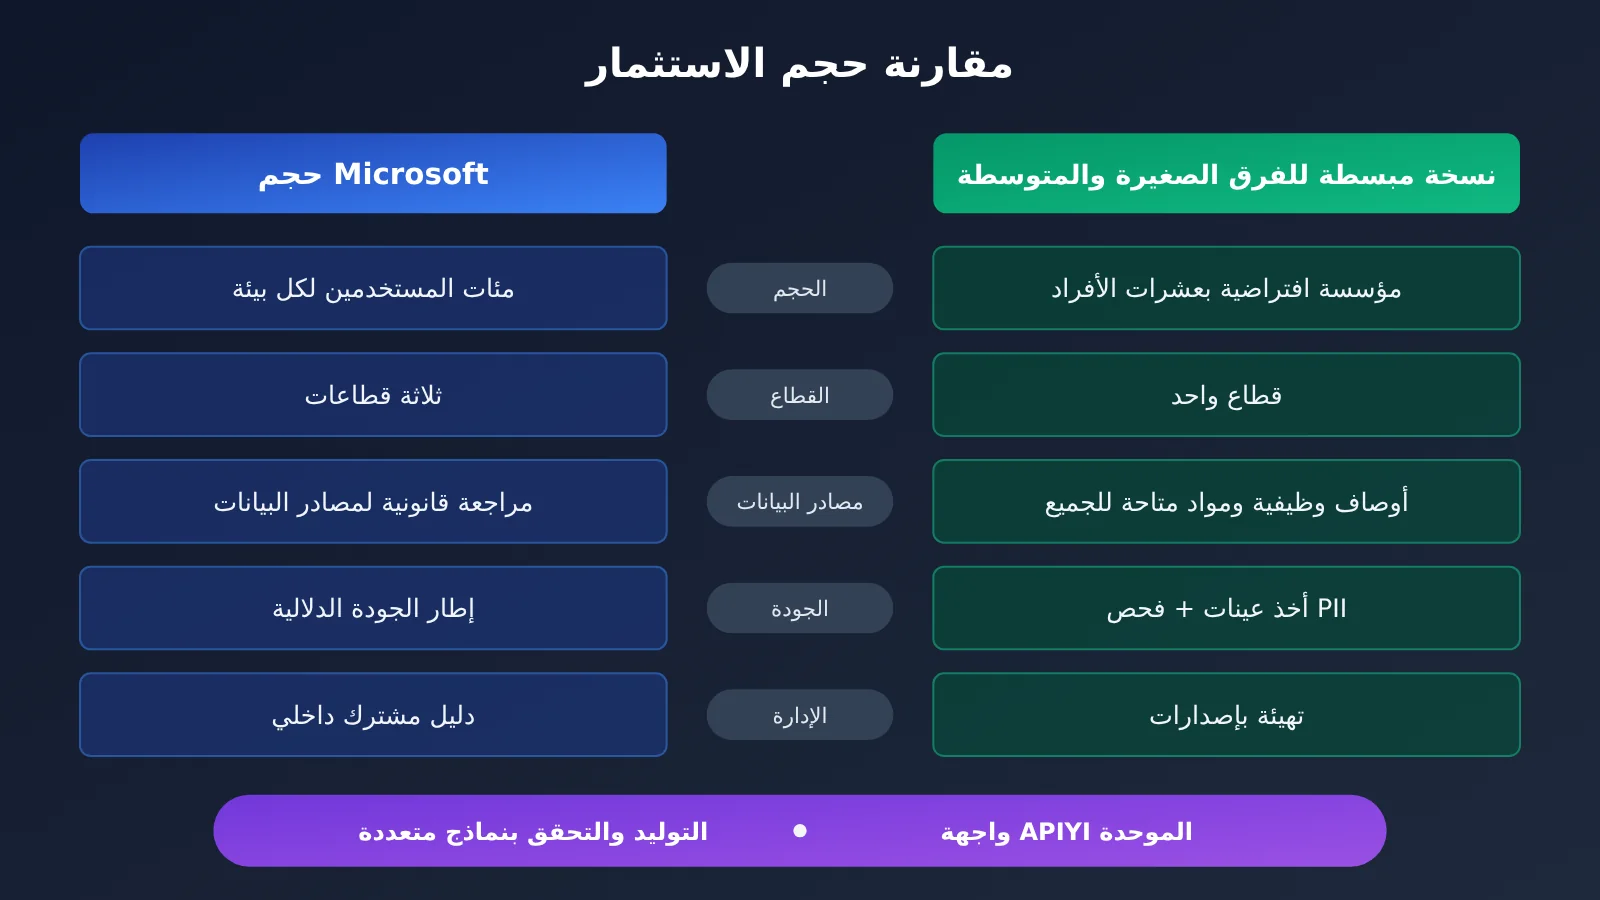
ما المراحل التي تتطلب استثمارًا كبيرًا، وما الذي يمكن تبسيطه؟
| المرحلة | نهج Microsoft | حجم الاستثمار | توصية للفرق الصغيرة والمتوسطة |
|---|---|---|---|
| استخدام البيانات العامة | O*NET، وإعلانات التوظيف، وملفات SEC، بعد مراجعتها قانونيًا | مرتفع | يكفي جمع مواد القطاع يدويًا، مع التأكد من إمكانية استخدام مصادرها |
| حجم البيئة | مئات المستخدمين في كل بيئة، مع سجل تواصل كامل | مرتفع | يكفي عشرات الأشخاص لتغطية الأدوار الرئيسية |
| تغطية القطاعات | ثلاثة قطاعات | متوسط | الاكتفاء بالقطاع الذي يخدمه الفريق |
| إطار الجودة | إطار داخلي للتقييم الدلالي ومقاييس شاملة | مرتفع | أخذ عينات يدويًا + إحصاءات بسيطة + فحص آلي للبيانات الشخصية |
| البنية الزمنية | مؤسسة تتطور بمرور الوقت | لا غنى عنها | إعداد تسلسل زمني أولًا، ثم توليد المحتوى |
| قابلية إعادة الإنتاج | توليد النتائج نفسها بالإعدادات نفسها | لا غنى عنها | تحديد إصدارات الإعدادات وتخزين نتائج التوليد مؤقتًا |
يمكن تقليص حجم العمل ومستوى الأتمتة، لكن لا يمكن الاستغناء عن البنية الزمنية، وربط الاستعلامات بإجابات مرجعية، وقابلية إعادة الإنتاج. فهذه العناصر الثلاثة تحدد ما إذا كانت نتائج التقييم صالحة لاتخاذ قرار الإطلاق. وتجدر الإشارة إلى عدم توفر مواد منشورة يمكن الرجوع إليها بشأن التكلفة والنتائج الفعلية لتطبيق هذه الطريقة لدى الفرق الصغيرة والمتوسطة؛ لذا فإن التوصيات أعلاه استنتاجات مبنية على منهج المقال الأصلي.
الأسئلة الشائعة FAQ
س1: ما مجموعة تقييم بيئة المؤسسات الاصطناعية؟
هي مساحة عمل مؤسسية افتراضية تُنشأ بالكامل برمجيًا، وتضم موظفين وهيكلًا تنظيميًا واجتماعات ورسائل بريد إلكتروني ومستندات، إلى جانب مجموعة من استعلامات التقييم المستندة إلى هذه البيانات. وتُستخدم لاختبار قدرة تطبيقات الذكاء الاصطناعي المؤسسية على العثور على المعلومات الصحيحة ودمجها وعرضها، دون الوصول إلى بيانات عملاء حقيقية.
س2: ما الفرق بين مجموعة التقييم الاصطناعية والاختبارات المعيارية العامة؟
تُعد الاختبارات المعيارية العامة مفيدة لمقارنة القدرات العامة، لكنها تفتقر إلى علاقات التبعية الإدارية وتاريخ المشاريع وإجراءات العمل المتخصصة. أما بيئة المؤسسات الاصطناعية فتحافظ على هذه البنى، وتكشف أنماط الإخفاق المرتبطة بمجال العمل التي قد لا ترصدها الاختبارات العامة، مثل الخلط بين الأقسام أو إغفال القرارات المتخذة في اجتماعات تضم فرقًا من تخصصات مختلفة.
س3: متى أعلنت Microsoft عن هذه المنهجية؟
نشرت Microsoft Research تدوينة حولها في 30 أكتوبر 2026. وبحسب المقال الأصلي، أُتيحت المنصة في دليل داخلي مشترك، وأصبحت أول خط أساس موحد للتقييم في Microsoft Copilot.
س4: ما السيناريوهات الأنسب لهذه المنهجية؟
– **الإجابة عن أسئلة محاضر الاجتماعات**: اختبار دقة الملخصات واستخراج بنود العمل والاستشهادات
– **البحث في المعرفة المؤسسية**: اختبار القدرة على العثور على الدليل الصحيح الوحيد بين عدد كبير من المستندات
– **الاستعلامات الزمنية**: اختبار أسئلة مثل «ما الذي تقرر الأسبوع الماضي؟» و«ما آخر التغييرات؟»
– **اختبار التراجع للنماذج أو الإصدارات**: مقارنة الحلول الجديدة والقديمة باستخدام مجموعة بيانات ثابتة
س5: كيف يمكن مقارنة نماذج مختلفة باستخدام مجموعة التقييم الاصطناعية نفسها؟
المفتاح هو تثبيت إصدار مجموعة البيانات وتغيير النموذج قيد الاختبار فقط. توفر APIYI عبر apiyi.com واجهة موحدة متوافقة مع OpenAI وتدعم عدة نماذج شائعة؛ ولا يتطلب التبديل بينها سوى تغيير اسم النموذج. وبذلك يمكنك تشغيل برنامج التقييم نفسه على النماذج المرشحة بالتتابع. مع ذلك، ستحتاج إلى تنفيذ منطق احتساب الدرجات وإطار التقييم بنفسك.
س6: هل يمكن أن تشوّه البيانات الاصطناعية نتائج التقييم؟
نعم، ولذلك وضع المقال الأصلي إطارًا للجودة يقضي بتقييم البيانات أولًا ثم تقييم النموذج. فإذا كانت البيانات الاصطناعية شديدة الانتظام وتفتقر إلى الاختلافات والتشويش الموجودَين في الواقع، فقد تحصل النماذج على درجات أعلى من مستواها الفعلي. يُنصح بأن يقيّم موظفو الأعمال عينات من البيانات دون معرفة مصدرها، وأن تُعايَر البيانات الاصطناعية دوريًا باستخدام ملاحظات حقيقية أُزيلت منها المعلومات الحساسة.
س7: ما القيود المعروفة لهذه المنهجية؟
لم تكشف المقالة الأصلية عن الموجهات أو الأدوات أو تفاصيل تنفيذ مراحل سير العمل، كما لم تفصح عن مقاييس تقييم Copilot. ويذكر إطار الجودة «ثلاثة أبعاد» لكنه يسرد أربعة. أما قيمة الوفورات فهي تقدير Microsoft الخاص. وتشير المقالة أيضًا إلى أن تفاعلات الوكلاء متعددة الجولات، وتطور المؤسسات على مدى أشهر أو حتى سنوات، وأنظمة الذكاء الاصطناعي التي تنفذ الإجراءات، كلها مسائل تقييم تعتزم الشركة معالجتها لاحقًا.
أبرز النقاط حول مجموعات تقييم بيئات المؤسسات الاصطناعية
- بنية من ثلاث طبقات: بناء بيئة اصطناعية، وتوليد الاستعلامات تلقائيًا، والتحقق من جودة البيانات؛ وغياب أي طبقة يجعل التقييم غير موثوق
- المعايرة باستخدام بيانات عامة: الاستعانة بقواعد بيانات المهن وإعلانات الوظائف والتقارير المالية المنشورة لجعل الهيكل التنظيمي أقرب إلى الواقع
- لا غنى عن البنية الزمنية: تتطلب الاستعلامات الزمنية بيانات تعكس ترتيب الأحداث وعلاقات السببية بصورة واقعية
- التخصص القطاعي يحسن اكتشاف الإخفاقات: الاستعلامات القريبة من المجال أكثر قدرة على كشف الإخفاقات الخاصة به
- اختبر البيانات قبل النموذج: افحص البيانات الاصطناعية من أربعة جوانب: البنية والسياق والسلوك والأمان
- قابلية إعادة الإنتاج شرط لاختبار التراجع: يجب أن يولّد الإعداد نفسه البيانات نفسها حتى تكون المقارنة بين الإصدارات ذات معنى
- المقارنة بين نماذج متعددة: بعد تثبيت مجموعة البيانات، يمكن تبديل اسم النموذج عبر الواجهة الموحدة لـ APIYI لإجراء المقارنة
الخلاصة
يمكن تلخيص منهج Microsoft Copilot في إنشاء بيئة مؤسسية اصطناعية في ثلاث نقاط:
- استخدام البيانات الاصطناعية لحماية الخصوصية: عدم استخدام بيانات العملاء من الأساس يتيح مشاركة مجموعة البيانات وإعادة استخدامها بحرية بين الفرق.
- استخدام البنية لتعزيز الواقعية: يحدد التسلسل الهرمي للمؤسسة والجداول الزمنية وإجراءات القطاع مدى قدرة التقييم على كشف المشكلات الواقعية.
- استخدام الأتمتة لضمان قابلية إعادة الإنتاج: الحصول على مجموعة البيانات نفسها من الإعدادات نفسها يجعل نتائج التقييم أساسًا موثوقًا لقرارات الإطلاق.
لا تحتاج الفرق الصغيرة والمتوسطة إلى محاكاة حجم عمل Microsoft، لكن من المفيد اتباع ثلاثة مبادئ: تنظيم البيانات زمنيًا، وربط الاستعلامات بالبيانات، وإدارة إصدارات الإعدادات. يُنصح بالبدء بسيناريو واحد وقطاع واحد ومؤسسة افتراضية تضم بضع عشرات من الأشخاص، ثم إكمال العملية مرة واحدة قبل التوسع تدريجيًا.
بعد تثبيت مجموعة البيانات، يمكن استخدام APIYI apiyi.com للوصول إلى عدة نماذج بالطريقة نفسها المتوافقة مع OpenAI، ومقارنة أدائها مباشرةً على مجموعة التقييم الاصطناعية نفسها.
📚 المراجع
- مدونة Microsoft Research – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence: المصدر الأصلي الذي يستند إليه تحليل المنهجية في هذا المقال
- الرابط:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
التوضيح: يتضمن وصفًا للبيئة الاصطناعية، وخط العمل ذي المراحل الست، وإطار الجودة، وتصميم الخصوصية، وبيانات النتائج.
-
قاعدة البيانات المهنية O*NET: قاعدة بيانات المعلومات المهنية التابعة لوزارة العمل الأمريكية
- الرابط:
onetonline.org -
التوضيح: استُخدمت في المصدر الأصلي لضبط توزيع أدوار الموظفين الاصطناعيين ومسؤولياتهم وأنشطة عملهم.
-
البحث في الملفات العامة عبر SEC EDGAR: ملفات الإفصاح العام الصادرة عن هيئة الأوراق المالية والبورصات الأمريكية
- الرابط:
sec.gov/edgar - التوضيح: استُخدمت في المصدر الأصلي لتحديد حجم المؤسسة الاصطناعية، وهيكل وحدات أعمالها، وخلفيتها المالية.
الكاتب: الفريق التقني في APIYI
للتواصل التقني: للاستفسار عن الوصول الموحد إلى نماذج متعددة، يُرجى التواصل معنا عبر موقع APIYI apiyi.com.