Anmerkung der Redaktion: Am Beispiel der von Microsoft Copilot veröffentlichten Methode für synthetische Unternehmensumgebungen beleuchten wir die drei Ebenen synthetische Umgebung, automatische Abfragegenerierung und Qualitätsprüfung. Außerdem stellen wir Schritte und eine Checkliste zusammen, mit denen kleine und mittlere Teams eigene Evaluierungsdatensätze aufbauen können.
Wenn ein KI-Assistent oder eine Wissensanwendung im Unternehmen kurz vor dem Start steht, stehen die Verantwortlichen für die Evaluierung oft vor einem Problem: Die tatsächliche Leistung ließe sich am besten anhand unternehmenseigener E-Mails, Besprechungsprotokolle und Projektdokumente beurteilen. Diese Daten enthalten aber sensible Informationen und können deshalb nicht für Tests verwendet werden. Allgemeine Benchmarks allein zeigen wiederum nicht, welche Probleme in konkreten Geschäftsszenarien auftreten. Anhand eines Blogbeitrags von Microsoft Research vom 30. Oktober 2026 beleuchten wir eine Methode zum Aufbau von Evaluierungsdatensätzen: synthetische Unternehmensumgebung + automatische Abfragegenerierung + Qualitätsprüfung.
Das ist keine Wiederholung der offiziellen Darstellung. Microsoft beschreibt vor allem das methodische Vorgehen, veröffentlicht aber weder Eingabeaufforderungen noch Tool-Code oder konkrete Kennzahlen zur Leistung von Copilot auf diesen Datensätzen. Wir unterscheiden daher zwischen dem, was im Original ausdrücklich steht, und unseren eigenen Ableitungen. Daraus entwickeln wir Schritte, an denen sich auch kleine und mittlere Teams orientieren können.
Das nehmen Sie mit: Sie verstehen, welches Problem jede der drei Ebenen eines synthetischen Evaluierungsdatensatzes für Unternehmen löst und warum die zeitliche Dimension und der Branchenbezug unverzichtbar sind. Anhand einer Checkliste können Sie außerdem Lücken in Ihrem eigenen Evaluierungsprozess erkennen.
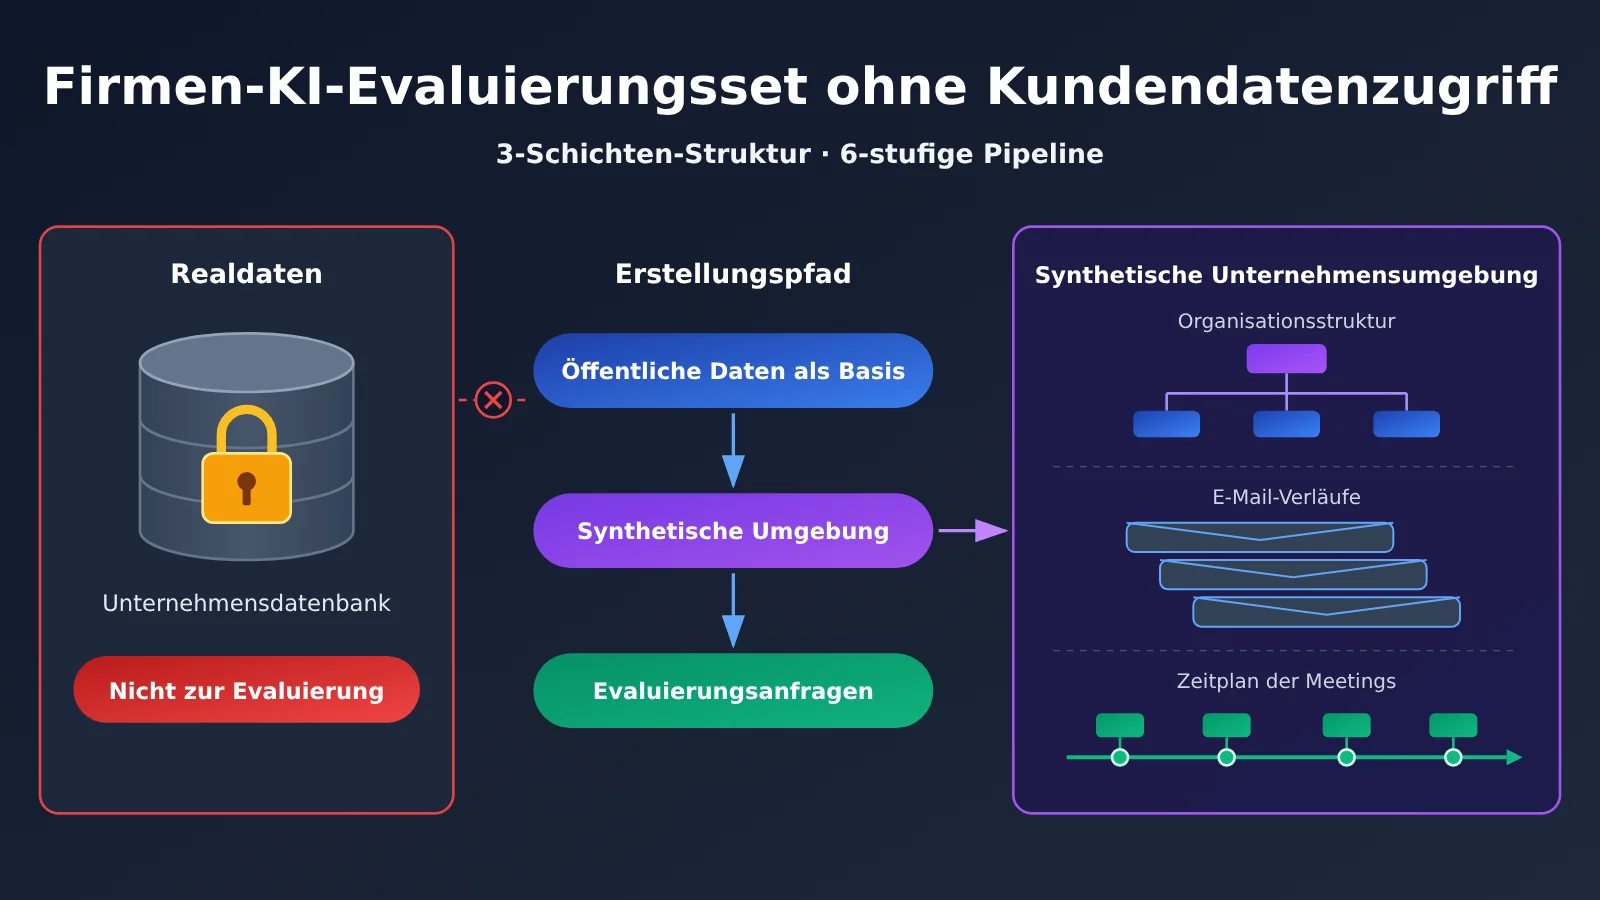
Die wichtigsten Punkte zu Evaluierungsdatensätzen für synthetische Unternehmensumgebungen
Microsoft nennt dieses System Industry Evaluation Data Generation Platform – eine Plattform zur Erzeugung branchenspezifischer Evaluierungsdaten. Laut Originalartikel basiert sie auf drei Säulen, die durch eine Ende-zu-Ende-Automatisierung miteinander verbunden werden.
| Bestandteil | Beschreibung im Original | Gelöstes Problem |
|---|---|---|
| Synthetische Unternehmensumgebung | Ein simulierter Copilot-Arbeitsbereich mit Nutzern, Meetings, E-Mails, Dokumenten und Organisationsstruktur, ohne Kundendaten | Eine Grundlage für Tests, ohne die Privatsphäre zu gefährden |
| Automatisierte Pipeline zur Abfragegenerierung | Wandelt allgemeine Abfrageideen in branchenspezifische Fragen um, die zu den Daten der Umgebung passen | Tausende passgenaue Abfragen von Hand zu erstellen, wäre zu aufwendig |
| Strukturiertes Qualitätsframework | Bewertet anhand mehrerer Dimensionen, ob die synthetischen Daten geeignet sind | Verhindert falsche Schlussfolgerungen durch unrealistische Daten |
| Ende-zu-Ende-Automatisierung | Mit derselben Konfiguration lässt sich exakt derselbe Datensatz erneut erzeugen | Ermöglicht Regressionsvergleiche zwischen Versionen und einheitliche Ergebnisse über Teams hinweg |
Warum allgemeine Benchmarks Probleme von KI-Anwendungen im Unternehmen nicht aufdecken
Die Herausforderung im Unternehmensalltag liegt nicht in einzelnen Fragen und Antworten, sondern im organisatorischen Kontext. Fragt ein Nutzer etwa: „Fasse die Aufgaben aus dieser Sicherheitsbesprechung für die einzelnen Teams zusammen“, muss das Modell wissen, wer teilgenommen hat, wer für welches Modul verantwortlich ist und welche konkreten Punkte besprochen wurden. Ausserdem muss es in seiner Antwort das Sitzungsprotokoll zitieren. Im Original geht es um eine Gesundheitseinrichtung, die Copilot Meetings zusammenfassen und Aufgaben extrahieren lässt. Geprüft wird, ob die Antwort korrekt, vollständig und belegt ist.
Allgemeinen Benchmarks fehlen Berichtswege, Projektverläufe, Kommunikationsgewohnheiten und fachspezifische Abläufe. Deshalb decken sie unternehmenstypische Fehler nicht auf – etwa wenn die Entscheidung von Abteilung A der Abteilung B zugeschrieben wird oder wichtige Ergebnisse aus einem funktionsübergreifenden Meeting fehlen. Microsofts Ansatz lautet: Wenn sich echte Daten nicht verwenden lassen, wird eine Umgebung geschaffen, deren Struktur und Abläufe einem realen Unternehmen ähneln.
Öffentliche Daten als Grundlage für synthetische Unternehmensumgebungen
Wenn ein Großes Sprachmodell eine Organisationsstruktur völlig frei erfindet, sind die Rollen oft eintönig, die Berichtslinien flach und die Aufgaben wenig abwechslungsreich. Microsoft nutzt deshalb drei Arten öffentlicher Daten, um die synthetischen Umgebungen an der Realität auszurichten. Alle Datenquellen wurden von Microsofts Rechts- und Policy-Abteilungen geprüft und freigegeben.
| Öffentliche Datenquelle | Verwendung im Original | Alternativen für kleine und mittlere Teams |
|---|---|---|
| O*NET-Berufsdatenbank (US-Arbeitsministerium) | Mitarbeiterrollen und Zuständigkeiten realistischer gestalten, Kombination und Häufigkeit von Tätigkeiten je Rolle abstimmen und branchenspezifische Prozesse anpassen | Eine Rollenliste aus öffentlich verfügbaren Stellenbeschreibungen und Berufsklassifikationen der eigenen Branche erstellen |
| Online-Stellenanzeigen | Reale Stellenbezeichnungen, Berichtsebenen und Abteilungsstrukturen liefern | Öffentliche Stellenanzeigen der Zielbranche sammeln und daraus Hierarchieebenen und Abteilungsstrukturen ableiten |
| Öffentliche SEC-Dokumente | Organisationsgröße, Struktur der Geschäftsbereiche und finanziellen Hintergrund bestimmen | Beschreibungen von Geschäftssegmenten und Mitarbeiterzahlen in Jahresberichten börsennotierter Unternehmen heranziehen |
Bei Microsoft heißt jeder simulierte Arbeitsbereich „tenant“ (Mandant): eine isolierte Organisationsumgebung mit eigenen Nutzern, Daten und Konfigurationen. Der Originaltext betont, dass diese Umgebungen eine erweiterbare Grundlage sind, auf der Teams weiter aufbauen können.
Zeitdimension: Warum „Was wurde letzten Donnerstag entschieden?“ eine echte Zeitstruktur braucht
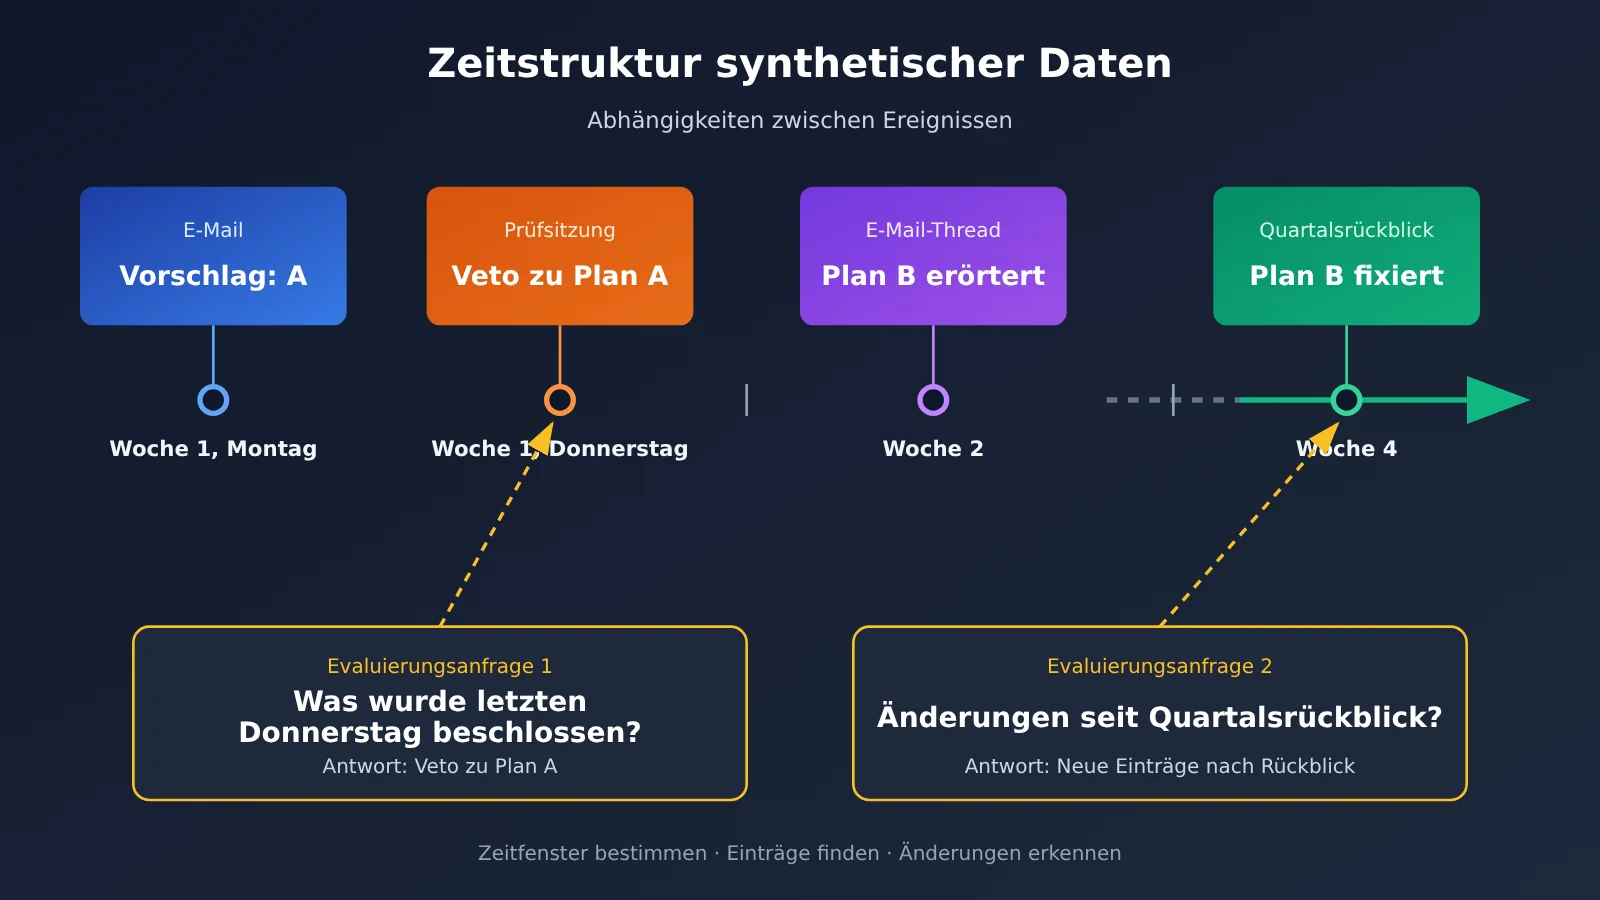
Das ist der Punkt aus dem Originalartikel, den kleine und mittlere Teams besonders beachten sollten. Microsofts synthetische Umgebung ist keine statische Momentaufnahme, sondern eine Organisation, die sich mit der Zeit verändert: mit vergangenen Meetings, Projektzeitplänen, E-Mail-Threads über mehrere Wochen und organisch entstehenden organisatorischen Veränderungen. Der Artikel weist darauf hin, dass viele Copilot-Anfragen selbst einen zeitlichen Bezug haben, etwa „Was hat das Team letzten Donnerstag entschieden?“ oder „Was hat sich seit dem letzten Quartalsrückblick geändert?“.
Bei zeitbezogenen Fragen muss das Modell drei Dinge leisten: den relevanten Zeitraum bestimmen, darin die passenden Aufzeichnungen finden und Veränderungen im Zeitverlauf erkennen. Bestehen die synthetischen Daten nur aus Dokumenten ohne zeitlichen Zusammenhang oder finden alle Meetings am selben Tag statt, haben solche Fragen entweder keine eindeutige Antwort oder sind zu leicht. Das macht die Evaluierungsergebnisse wenig aussagekräftig. Die synthetischen Daten brauchen zeitliche Abhängigkeiten: etwa einen Vorschlag am Montag, seine Ablehnung im Meeting am Donnerstag und eine Alternative, die in einer E-Mail der folgenden Woche auftaucht. Erst dann prüft die Frage „Was wurde letzten Donnerstag entschieden?“ das Modell wirklich.
Branchenspezifische Tests: Dasselbe Modell zeigt je nach Branche andere Probleme
Microsoft hat synthetische Testumgebungen für drei Branchen erstellt. Jede bildet reale Geschäftsabläufe ab:
- Pharma: Zulassungsverfahren, Diskussionen zu klinischen Studien und funktionsübergreifende Sicherheitsprüfungen
- Kapitalmärkte: Handelspipeline, Compliance-Kommunikation und Überprüfung von Kundenportfolios
- IT-/Softwareunternehmen: Iterationsplanung, Diskussionen zu Code-Reviews und Koordination von Produktveröffentlichungen
Laut Originaltext ermöglichen branchenspezifische Tests, die Bewertungsanfragen näher an den tatsächlichen Fragen der Nutzer in diesen Bereichen auszurichten. So werden branchenspezifische Fehlermuster sichtbar, die allgemeine Testfälle nicht aufdecken. Interne Unternehmensteams betreuen meist nur eine oder zwei Branchen – dadurch können sie diese umso gründlicher untersuchen.
Automatische Abfragegenerierung: Die Pipeline in sechs Phasen
Eine synthetische Umgebung allein reicht nicht aus – für die Evaluation werden auch Abfragen benötigt. Tausende datenbezogene, branchenspezifische Abfragen von Hand zu schreiben, wäre laut Originalartikel zu teuer und zu langsam. Deshalb wurde eine automatisierte Pipeline entwickelt. Der Originalartikel fasst die Phasen nur kurz zusammen. Die folgende Tabelle ordnet sie in sechs Schritte entsprechend der dort beschriebenen Reihenfolge; für die genaue Aufteilung ist die Abbildung im Original maßgeblich.
| Phase | Kernaussage im Original | Vereinfachtes Vorgehen für kleinere Teams |
|---|---|---|
| 1. Aufgabenpool | Ausgangspunkt ist eine große Sammlung allgemeiner Arbeitsaufgaben | 50 bis 100 typische Aufgaben von Mitarbeitenden auflisten, etwa Meetings zusammenfassen, Entscheidungen finden oder Versionen vergleichen |
| 2. Branchenauswahl | Aufgaben auswählen, die für eine bestimmte Branche relevant sind | Den Fachbereich die für seine Branche relevanten Aufgaben auswählen lassen |
| 3. Fachliche Überarbeitung | Aufgaben mit branchentypischer Sprache und Kontext umformulieren | Branchenbegriffe und typische Dokumentarten ergänzen |
| 4. Umgebungsbasierte Generierung | Mit KI Abfragen erzeugen, die auf Daten der synthetischen Umgebung basieren | Das Modell konkrete Dokumente oder Threads lesen lassen, bevor es Fragen samt Referenzantworten und Quellen erstellt |
| 5. Natürlichere Formulierung | Abfragen so umformulieren, dass sie eher wie Fragen echter Menschen klingen | Umgangssprache, Auslassungen und Verweise einbauen, etwa „Was ist eigentlich aus dem Vorschlag geworden?“ |
| 6. Prüfung | Jede Abfrage auf Korrektheit und Eindeutigkeit prüfen | Duplikate entfernen und stichprobenartig prüfen, ob sich für die Antwort eine eindeutige Grundlage in den Daten finden lässt |
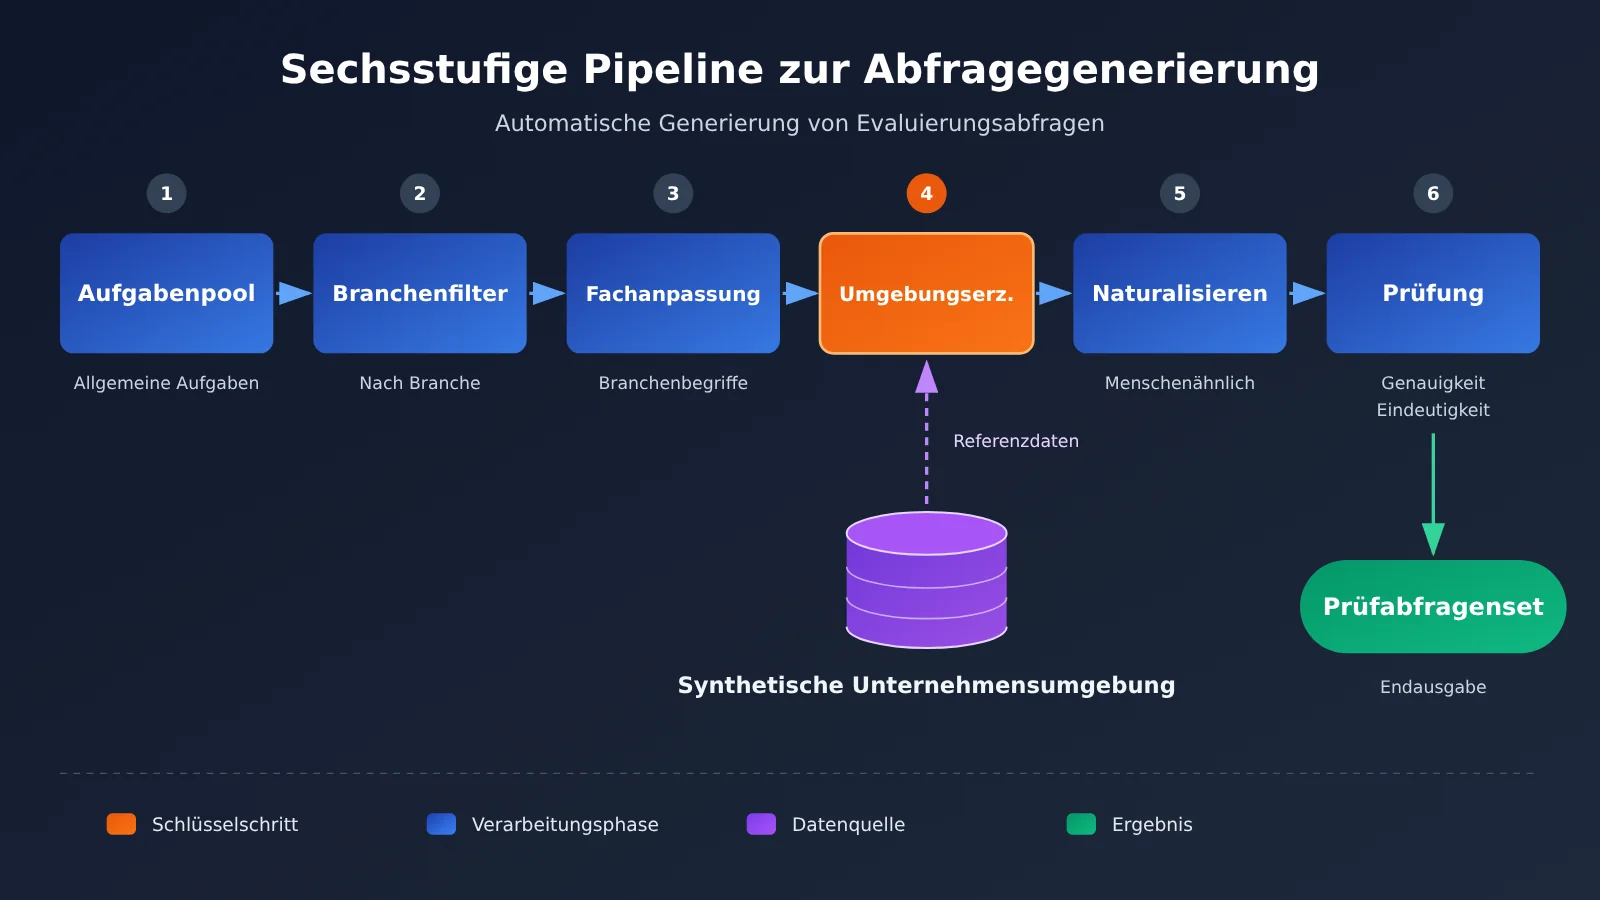
Schritt 4 ist der Schlüssel zur gesamten Pipeline: Die Abfragen müssen auf konkreten Daten der Umgebung basieren, sonst lässt sich nicht beurteilen, ob eine Antwort korrekt ist. Auch die „Eindeutigkeit“ in Schritt 6 wird leicht übersehen. Gibt es für dieselbe Frage mehrere plausible Antworten in den Daten, kann die Bewertung strittig werden.
In Schritt 4 und 5 kann ein Modell die Fragen erstellen und ein anderes sie natürlicher formulieren oder prüfen. Das reduziert mögliche Verzerrungen, die entstehen, wenn dasselbe Modell seine eigenen Fragen beantwortet. Beim Aufruf mehrerer Modelle über die OpenAI-kompatible Schnittstelle von APIYI auf apiyi.com genügt für den Wechsel eine Änderung des Modellnamens; das Generierungsskript muss kaum angepasst werden.
🎯 Technischer Tipp: Für die Abfragegenerierung empfiehlt es sich, die Vorlage für die Eingabeaufforderung, den Modellnamen und Parameter wie den Zufalls-Seed festzulegen und in einer Konfigurationsdatei zu speichern. So bleibt bei Vergleichstests mit einem anderen Modell nur das Modell selbst als Variable. Über die einheitliche Schnittstelle von APIYI lassen sich Modelle verschiedener Anbieter innerhalb desselben Ablaufs zur Generierung und Prüfung von Abfragen einsetzen.
Qualität synthetischer Daten prüfen: erst die Daten, dann das Modell
Auch synthetische Daten müssen bewertet werden. Andernfalls könnte ein Modell nur deshalb gut abschneiden, weil die Daten zu einfach sind. Der Originaltext spricht davon, die Qualität mit einem internen semantischen Bewertungsrahmen anhand von „drei Dimensionen“ zu messen, zählt aber tatsächlich vier auf. Die folgende Tabelle übernimmt alle vier Punkte. Beim Zitieren sollte dieser Unterschied beachtet werden.
| Qualitätsdimension | Prüffrage im Original | Praktische Prüfmethode |
|---|---|---|
| Strukturelle Genauigkeit | Spiegelt die Organisationsstruktur reale Berichtslinien, Teamgrößen und funktionsübergreifende Beziehungen wider? | Hierarchietiefe und Verteilung der Teamgrößen ermitteln und mit öffentlich verfügbaren Daten vergleichen |
| Kontextrelevanz | Entsprechen Abfragen und Workflows den tatsächlichen Nutzungsmustern in Unternehmen? | Fachleute stichprobenartig Abfragen blind bewerten lassen: Wie sehr ähneln sie echten Fragen? |
| Realitätsnähe des Verhaltens | Zeigen simulierte Nutzer menschenähnliche Kommunikationsmuster und Zusammenarbeitsdynamiken? | Prüfen, ob E-Mails Antwortketten enthalten und ob es in Meetings Meinungsverschiedenheiten und Folgeaktivitäten gibt |
| Inhaltssicherheit | Sind die Daten frei von schädlichen, beleidigenden oder personenbezogenen Informationen, und geben sie sich nicht als echte Personen aus? | Automatisch nach Formaten für Namen, Telefonnummern und Ausweisnummern suchen und die Treffer manuell prüfen |
Laut Originaltext verbesserte sich der Gesamtqualitätsindikator gegenüber der ursprünglichen Erzeugungsmethode um 39 %. In einigen Branchenumgebungen lag der Qualitätswert bei über 0.9 von maximal 1.0. Der Text führt die Verbesserung auf zwei Faktoren zurück: die Einbeziehung realer Branchensignale und automatisierte Qualitätsverbesserungen, die durch den Gesamtqualitätsindikator gesteuert wurden. Wichtig dabei: Der Wert misst, wie realitätsnah die synthetischen Daten ein Unternehmen abbilden – nicht die Leistung von Copilot selbst. Kennzahlen zu Copilot auf diesen Datensätzen nennt der Originaltext nicht.
Reproduzierbarkeit: Voraussetzung für versionsübergreifende Regressionstests mit synthetischen Evaluierungsdatensätzen
Der Originalartikel nennt vier praktische Probleme, die ohne Automatisierung auftreten:
- Reproduzierbarkeit: Manuelle Abläufe liefern jedes Mal leicht unterschiedliche Ergebnisse. Das erschwert Vergleiche zwischen Versionen.
- Umfang: Die Zahl der Branchen- und Konfigurationsvarianten übersteigt das, was sich manuell bewältigen lässt.
- Iterationsgeschwindigkeit: Die manuelle Erstellung dauert Tage und verzögert das Feedback.
- Konsistenz zwischen Teams: Ohne standardisierte Tools sind Format und Qualität der Datensätze verschiedener Teams nicht miteinander kompatibel.
Nach der Automatisierung erfolgt die Erstellung der Datensätze automatisch statt in mehrtägiger Handarbeit. Microsoft schätzt die Einsparung auf rund 100.000 US-Dollar pro Evaluierungsdatensatz und insgesamt rund 300.000 US-Dollar für das Projekt. Diese Schätzung basiert auf den eigenen Größenordnungen und lässt sich nicht direkt auf andere Teams übertragen. Als wichtigeres Ergebnis hebt der Originalartikel hervor: Jedes Team kann mit derselben Konfiguration exakt denselben Datensatz erneut erzeugen.
Das ist für Regressionstests entscheidend. Wenn du die Suchstrategie änderst oder das Modell wechselst und die Bewertung schlechter ausfällt, musst du sicher sein, dass die Veränderung vom System und nicht von den Daten stammt. Unterscheidet sich der Testdatensatz bei jeder Neuerstellung leicht, verliert der Vergleich zwischen Versionen seine Aussagekraft.
Auch beim Vergleich mehrerer Modellkandidaten auf APIYI solltest du diesem Prinzip folgen: Fixiere eine Version des synthetischen Evaluierungsdatensatzes und teste damit nacheinander die verschiedenen Modelle. So spiegeln die Vergleichsergebnisse nur die Unterschiede zwischen den Modellen wider.
Schnelleinstieg: Synthetisches Evaluierungsdataset für kleine und mittlere Teams erstellen
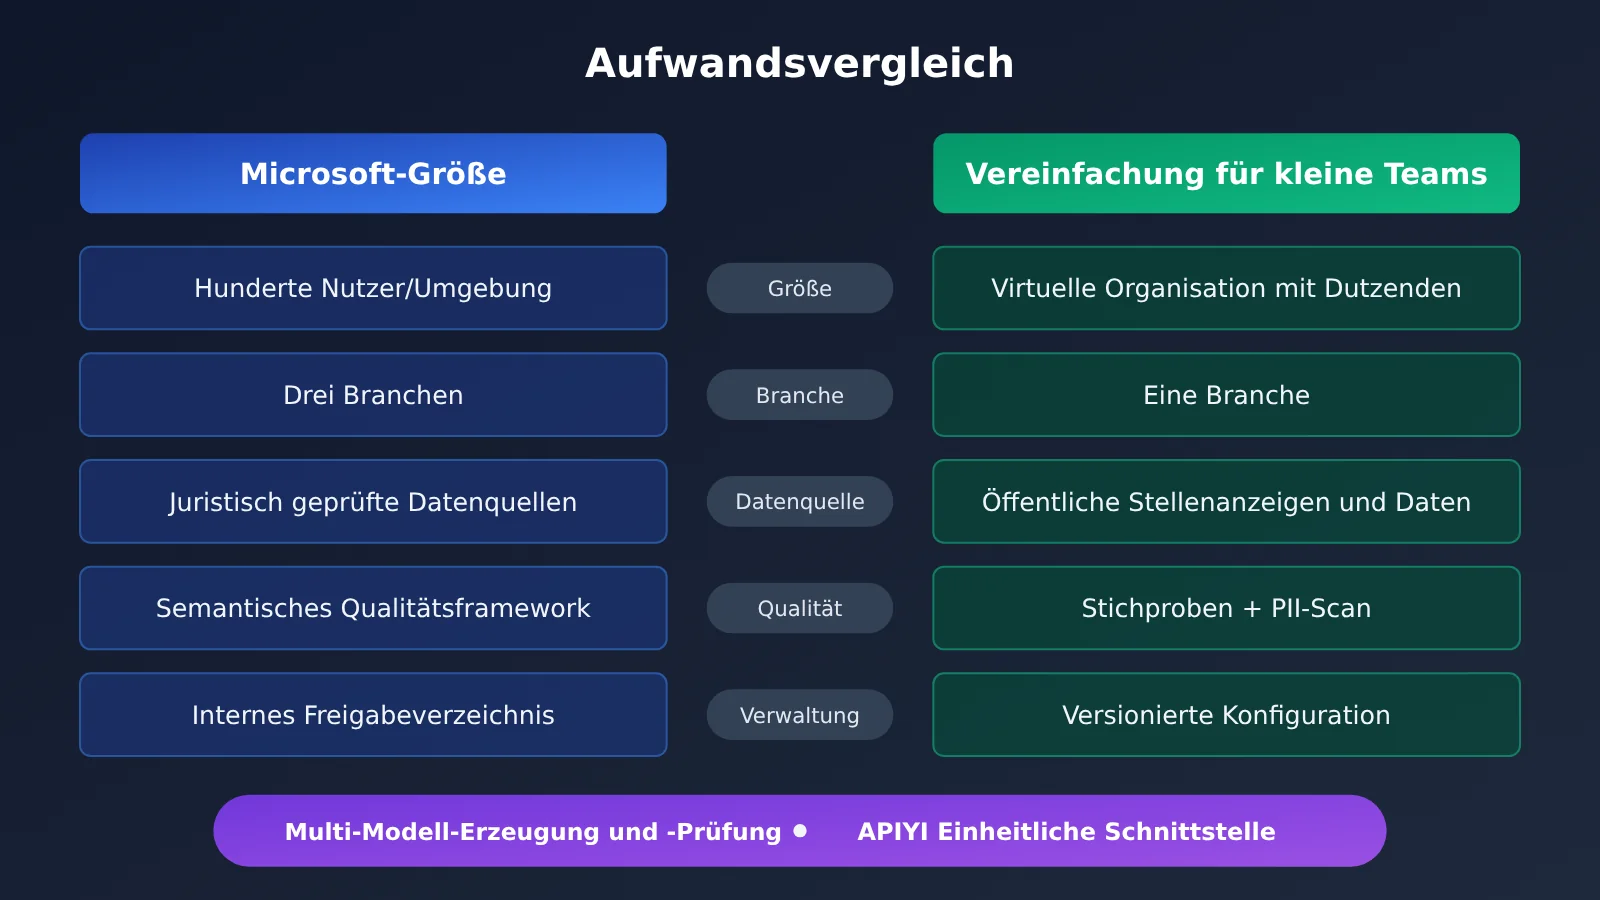
Microsofts Ansatz umfasst die vollständige Kommunikationshistorie von Hunderten Nutzern, drei Branchenumgebungen, eine rechtliche Prüfung und ein intern freigegebenes Verzeichnis. Kleine und mittlere Teams müssen das nicht eins zu eins übernehmen. Die folgenden Schritte vereinfachen die Methode aus dem Originalartikel.
Vorgehen
- Umfang festlegen: Wählen Sie einen Geschäftsfall, etwa „Fragen und Antworten zu Besprechungsprotokollen“ oder „Suche in Projektdokumenten“, und beschränken Sie sich auf eine Branche.
- Organisation entwerfen: Entwickeln Sie anhand öffentlicher Stellenanzeigen und Brancheninformationen eine virtuelle Organisation mit 20 bis 50 Personen. Halten Sie Abteilungen, Hierarchieebenen und Berichtslinien fest.
- Zeitplan erstellen: Schreiben Sie zunächst einen Projektzeitplan über 4 bis 8 Wochen mit wichtigen Ereignissen, Entscheidungspunkten und Änderungen. Erstellen Sie darauf aufbauend Besprechungsprotokolle, E-Mails und Dokumente, deren Zusammenhänge und Abhängigkeiten stimmen.
- Inhalte erzeugen: Lassen Sie ein Großes Sprachmodell die Dokumente einzeln anhand des Zeitplans erstellen. Jedes Dokument erhält Metadaten wie Datum, Autor und Beteiligte.
- Abfragen erstellen: Erstellen Sie die Fragen nach dem oben beschriebenen sechsstufigen Verfahren. Ergänzen Sie zu jeder Frage eine Referenzantwort und die Nummer des Quelldokuments. Markieren Sie zeitbezogene Abfragen gesondert.
- Daten prüfen: Prüfen Sie Stichproben anhand der vier Qualitätsdimensionen. Der Scan auf personenbezogene Daten (PII) muss für den gesamten Datensatz durchgeführt werden.
- Versionieren: Halten Sie Organisationsstruktur, Zeitplan, Eingabeaufforderungen, Modellnamen und Parameter in einer Konfiguration fest und vergeben Sie eine Versionsnummer.
- Evaluierung durchführen: Führen Sie das zu testende System mit einer festen Version des Datensatzes aus und erfassen Sie die Ergebnisse für die verschiedenen Abfragetypen.
🚀 Schnellstart: Für Schritt 4 und 5 sind wiederholte Aufrufe eines Großen Sprachmodells nötig. Über die OpenAI-kompatible Schnittstelle von APIYI auf apiyi.com können Sie mehrere Modelle auf dieselbe Weise ansprechen: Nutzen Sie ein Modell zur Erzeugung und ein anderes zur Prüfung – dafür müssen Sie nur den Modellnamen ändern.
Checkliste zur Selbstkontrolle
- [ ] Die Evaluierungsdaten enthalten keinerlei echte Kunden- oder Mitarbeiterdaten
- [ ] Die Organisationsstruktur hat Hierarchien und abteilungsübergreifende Zusammenarbeit, statt nur eine flache Namensliste zu sein
- [ ] Die Daten haben eine realistische zeitliche Struktur, decken mindestens mehrere Wochen ab und enthalten kausale Zusammenhänge zwischen Ereignissen
- [ ] Ein Teil der Abfragen enthält zeitliche Bezüge wie „letzte Woche“ oder „seit der letzten Retrospektive“
- [ ] Die Abfragen verwenden Fachbegriffe und Dokumenttypen der eigenen Branche
- [ ] Jede Abfrage hat eine eindeutig überprüfbare Referenzantwort mit Quellenangabe
- [ ] Die synthetischen Daten wurden vor der Verwendung auf ihre Qualität geprüft
- [ ] Mit derselben Konfiguration lässt sich derselbe Datensatz erneut erzeugen
Wo ist hoher Aufwand nötig, und was lässt sich vereinfachen?
| Bereich | Vorgehen von Microsoft | Aufwand | Empfehlung für kleine und mittlere Teams |
|---|---|---|---|
| Einbindung öffentlicher Daten | O*NET, Stellenanzeigen und SEC-Dokumente nach rechtlicher Prüfung | Hoch | Branchenmaterialien manuell zusammenstellen, aber weiterhin die Nutzbarkeit der Quellen prüfen |
| Größe der Umgebung | Hunderte Nutzer pro Umgebung, einschliesslich vollständiger Kommunikationshistorie | Hoch | Einige Dutzend Personen reichen aus, um die wichtigsten Rollen abzudecken |
| Branchenabdeckung | Drei Branchen | Mittel | Nur die eigene Zielbranche abdecken |
| Qualitätsframework | Internes Framework zur semantischen Bewertung und umfassende Kennzahlen | Hoch | Manuelle Stichproben + einfache Statistiken + automatischer PII-Scan |
| Zeitliche Struktur | Eine Organisation, die sich im Laufe der Zeit entwickelt | Unverzichtbar | Erst einen Zeitplan erstellen, dann Inhalte generieren |
| Reproduzierbarkeit | Dieselbe Konfiguration erzeugt dieselben Ergebnisse | Unverzichtbar | Konfiguration versionieren und generierte Ergebnisse zwischenspeichern |
Reduzieren lassen sich der Umfang und der Automatisierungsgrad. Auf die zeitliche Struktur, die Verankerung der Abfragen und die Reproduzierbarkeit sollte man dagegen nicht verzichten. Diese drei Punkte entscheiden darüber, ob sich die Evaluierungsergebnisse für eine Entscheidung über den Produktivstart nutzen lassen. Zu beachten ist: Zu den tatsächlichen Kosten und Ergebnissen einer solchen Umsetzung in kleinen und mittleren Teams liegen derzeit keine öffentlich zugänglichen Informationen vor. Die Empfehlungen oben sind aus der Methode des Originalartikels abgeleitet.
Häufige Fragen (FAQ)
Q1: Was ist ein synthetischer Evaluierungsdatensatz für Unternehmensumgebungen?
Es handelt sich um einen vollständig programmgenerierten, simulierten Unternehmensarbeitsbereich mit Mitarbeitenden, Organisationsstrukturen, Meetings, E-Mails und Dokumenten. Dazu gehört eine Reihe von Evaluierungsfragen auf Grundlage dieser Daten. Damit lässt sich testen, ob KI-Anwendungen für Unternehmen die richtigen Informationen finden, zusammenführen und präsentieren können – ohne auf echte Kundendaten zuzugreifen.
Q2: Wie unterscheidet sich ein synthetischer Evaluierungsdatensatz von allgemeinen Benchmarks?
Allgemeine Benchmarks sind wertvoll, um allgemeine Fähigkeiten zu vergleichen. Ihnen fehlen jedoch Berichtswege, Projekthistorien und fachspezifische Abläufe. Synthetische Unternehmensumgebungen bilden diese Strukturen ab und können dadurch fachspezifische Fehler aufdecken, die allgemeine Testfälle übersehen – etwa verwechselte Abteilungszugehörigkeiten oder übersehene Entscheidungen aus abteilungsübergreifenden Meetings.
Q3: Wann wurde dieser Ansatz von Microsoft veröffentlicht?
Microsoft Research veröffentlichte den zugehörigen Blogbeitrag am 30. Oktober 2026. Laut Originalartikel wurde die Plattform in einem internen gemeinsamen Verzeichnis bereitgestellt und zur ersten standardisierten Evaluierungsgrundlage für Microsoft Copilot.
Q4: Für welche Szenarien eignet sich der Ansatz besonders?
– **Fragen und Antworten zu Meeting-Protokollen**: Testen, ob Zusammenfassungen, extrahierte Aufgaben und Quellenangaben korrekt sind
– **Suche nach Unternehmenswissen**: Testen, ob sich unter vielen Dokumenten der eindeutig richtige Beleg finden lässt
– **Zeitbezogene Fragen**: Fragen wie „Was wurde letzte Woche entschieden?“ oder „Was hat sich zuletzt geändert?“ testen
– **Regressionstests für Modelle oder Versionen**: Alte und neue Lösungen anhand eines festen Datensatzes vergleichen
Q5: Wie lassen sich verschiedene Modelle mit demselben synthetischen Evaluierungsdatensatz vergleichen?
Entscheidend ist, die Datensatzversion unverändert zu lassen und nur das getestete Modell auszutauschen. APIYI apiyi.com bietet eine einheitliche, OpenAI-kompatible Schnittstelle, die mehrere gängige Modelle unterstützt. Zum Wechseln muss nur der Modellname geändert werden. So lassen sich die Kandidaten nacheinander mit demselben Evaluierungsskript testen. Die Bewertungslogik und das Evaluierungsframework müssen Sie allerdings selbst implementieren.
Q6: Können synthetische Daten die Evaluierungsergebnisse verzerren?
Ja. Deshalb sieht der Originalartikel ein eigenes Qualitätsframework vor: Zuerst werden die Daten bewertet, dann das Modell. Sind die synthetischen Daten zu gleichförmig und fehlen realistische Meinungsverschiedenheiten und Störfaktoren, fallen die Modellbewertungen zu hoch aus. Lassen Sie deshalb Stichproben von Fachleuten aus dem Unternehmen blind bewerten und kalibrieren Sie die synthetischen Daten regelmässig anhand anonymisierten echten Feedbacks.
Q7: Welche bekannten Einschränkungen hat der Ansatz?
Der Originalartikel legt weder die Eingabeaufforderungen, Werkzeuge oder Implementierungsdetails der einzelnen Pipeline-Phasen noch die Evaluierungsmetriken für Copilot offen. Das Qualitätsframework spricht von „drei Dimensionen“, führt aber vier Punkte auf. Die Einsparungen beruhen auf einer eigenen Schätzung von Microsoft. Als weitere Evaluierungsprobleme nennt der Artikel mehrstufige Interaktionen mit Agenten, die Entwicklung von Organisationen über Monate oder sogar Jahre hinweg sowie KI-Systeme, die Aktionen ausführen.
Die wichtigsten Erkenntnisse zu synthetischen Evaluierungsdatensätzen für Unternehmensumgebungen
- Drei Ebenen: Eine synthetische Umgebung als Grundlage, automatisch generierte Abfragen und eine Prüfung der Datenqualität – fehlt eine Ebene, ist die Evaluierung nicht zuverlässig.
- Abgleich mit öffentlichen Daten: Berufsdatenbanken, Stellenanzeigen und öffentliche Geschäftsberichte helfen, realitätsnahe Organisationsstrukturen zu erstellen.
- Zeitliche Strukturen sind unverzichtbar: Zeitbezogene Abfragen setzen Daten mit realistischer Ereignisabfolge und Kausalität voraus.
- Branchenspezifische Tests decken mehr auf: Fachlich passende Abfragen bringen branchentypische Fehler leichter ans Licht.
- Erst die Daten, dann das Modell testen: Synthetische Daten sollten hinsichtlich Struktur, Kontext, Verhalten und Sicherheit geprüft werden.
- Reproduzierbarkeit ist die Voraussetzung für Regressionstests: Nur wenn dieselbe Konfiguration dieselben Daten erzeugt, sind Vergleiche zwischen Versionen aussagekräftig.
- Mehrere Modelle vergleichen: Steht der Datensatz fest, lassen sich über die einheitliche Schnittstelle von APIYI durch Wechsel des Modellnamens verschiedene Modelle gegenüberstellen.
Fazit
Der Ansatz von Microsoft Copilot für synthetische Unternehmensumgebungen lässt sich in drei Punkten zusammenfassen:
- Datenschutz durch synthetische Daten: Werden von Anfang an keine Kundendaten verwendet, lässt sich der Datensatz frei zwischen Teams teilen und wiederverwenden.
- Realitätsnähe durch Struktur: Organisationshierarchien, Zeitverläufe und branchenspezifische Prozesse entscheiden darüber, ob die Evaluierung reale Probleme aufdeckt.
- Reproduzierbarkeit durch Automatisierung: Nur wenn dieselbe Konfiguration denselben Datensatz liefert, können die Evaluierungsergebnisse Entscheidungen über die Produktivsetzung unterstützen.
Kleine und mittelgrosse Teams müssen nicht den Umfang von Microsoft nachbilden. Zeitliche Strukturen, die Verankerung von Abfragen in den Daten und die Versionierung der Konfiguration sollten sie aber übernehmen. Am besten starten sie mit einem Szenario, einer Branche und einer virtuellen Organisation mit einigen Dutzend Personen. Ist der gesamte Ablauf einmal erfolgreich durchlaufen, lässt er sich schrittweise erweitern.
Sobald der Datensatz feststeht, können über APIYI auf apiyi.com mehrere Modelle mit derselben OpenAI-kompatiblen Aufrufmethode angebunden werden. So lässt sich ihre Leistung auf demselben synthetischen Evaluierungsdatensatz direkt vergleichen.
📚 Quellen
- Microsoft Research Blog – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence: Originalquelle für die Analyse der Methode
- Link:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
Inhalt: Beschreibt die synthetische Umgebung, die sechsstufige Pipeline, das Qualitätsframework, das Datenschutzkonzept und die Ergebnisdaten
-
O*NET-Berufsdatenbank: Datenbank des US-Arbeitsministeriums mit Berufsinformationen
- Link:
onetonline.org -
Inhalt: Diente im Original zur Kalibrierung der Rollen, Verantwortlichkeiten und Arbeitsaktivitäten synthetischer Mitarbeitender
-
SEC EDGAR-Suche für öffentliche Dokumente: Öffentlich zugängliche Dokumente der US-Börsenaufsicht
- Link:
sec.gov/edgar - Inhalt: Diente im Original dazu, Größe, Geschäftsbereichsstruktur und finanziellen Hintergrund der synthetischen Organisation festzulegen
Autor: APIYI-Technikteam
Technischer Austausch: Fragen zum einheitlichen Zugriff auf mehrere Modelle? Kontaktieren Sie uns über die APIYI-Website apiyi.com.