Nota do autor: usamos o método de ambiente empresarial sintético divulgado pela Microsoft Copilot como exemplo para analisar suas três camadas — ambiente sintético, geração automática de consultas e validação de qualidade — e reunir etapas e uma lista de verificação para equipes pequenas e médias criarem seus próprios conjuntos de avaliação.
Quando um assistente de IA ou uma aplicação de conhecimento corporativo está prestes a entrar em produção, quem cuida da avaliação costuma enfrentar um problema: os dados que melhor refletem os resultados reais são os próprios e-mails, atas de reuniões e documentos de projetos da empresa, mas eles contêm informações sensíveis e não podem ser usados em testes. Por outro lado, avaliar apenas com benchmarks genéricos não revela os problemas que surgem nos cenários de negócio. Neste artigo, usamos como exemplo uma publicação do Microsoft Research de 30 de outubro de 2026 para analisar o método de construção de conjuntos de avaliação baseado em ambiente empresarial sintético + geração automática de consultas + validação de qualidade.
Este artigo não é uma reprodução do material promocional oficial. O conteúdo divulgado pela Microsoft se concentra na estrutura do método: não inclui comandos nem código das ferramentas e também não revela os indicadores específicos do Copilot nesses conjuntos de dados. Vamos separar o que está explícito no texto original do que é dedução nossa e transformar o método em etapas que equipes pequenas e médias possam usar como referência.
O que você vai aprender: ao final da leitura, você entenderá o problema que cada uma das três camadas do conjunto de avaliação empresarial sintético resolve, por que não dá para deixar de lado a dimensão temporal e a adaptação ao setor e como usar a lista de verificação para identificar lacunas no seu processo de avaliação.
Pontos principais da avaliação em ambientes empresariais sintéticos
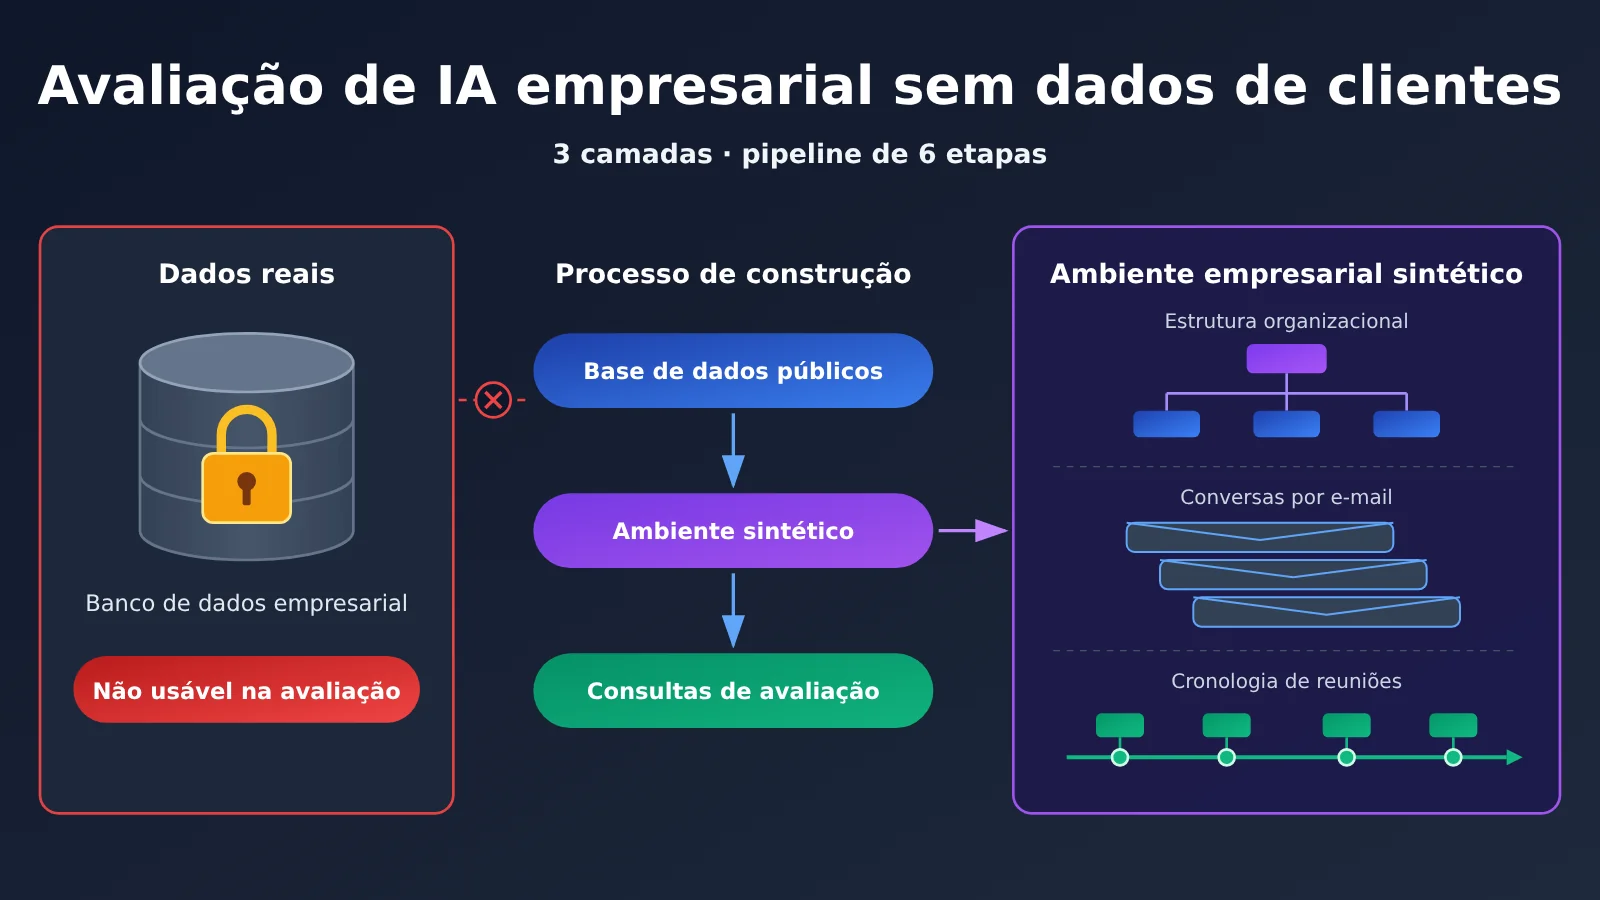
A Microsoft chama essa abordagem de Industry Evaluation Data Generation Platform (plataforma de geração de dados para avaliação setorial). Segundo o artigo original, ela se apoia em três pilares, conectados por uma camada de automação de ponta a ponta.
| Componente | Descrição no original | Problema que resolve |
|---|---|---|
| Ambiente empresarial sintético | Espaço de trabalho simulado do Copilot, com usuários, reuniões, e-mails, documentos e estrutura organizacional, sem usar dados de clientes | Cria uma “base” para testes sem comprometer a privacidade |
| Pipeline automatizado de geração de consultas | Transforma ideias genéricas de consulta em perguntas específicas do setor e alinhadas aos dados do ambiente | Evita o alto custo de escrever manualmente milhares de consultas alinhadas aos dados |
| Estrutura de qualidade | Avalia a qualidade dos dados sintéticos por várias dimensões | Evita conclusões equivocadas baseadas em dados pouco realistas |
| Automação de ponta a ponta | Permite gerar novamente o mesmo conjunto de dados com a mesma configuração | Viabiliza comparações de regressão entre versões e consistência entre equipes |
Por que benchmarks genéricos não detectam problemas de IA em empresas
A dificuldade no ambiente empresarial não está em perguntas e respostas isoladas, mas no contexto da organização. Quando alguém pede “organize os itens de ação desta reunião de revisão de segurança para cada equipe”, o modelo precisa saber quem participou, quem é responsável por cada módulo e quais pontos foram discutidos. Também precisa citar trechos da ata na resposta. O exemplo do artigo original envolve uma instituição de saúde que usa o Copilot para resumir uma reunião e extrair itens de ação. O objetivo é verificar se a resposta é precisa, completa e fundamentada.
Benchmarks genéricos não incluem relações hierárquicas, histórico de projetos, hábitos de comunicação e processos específicos de cada área. Por isso, não detectam falhas típicas do ambiente empresarial, como atribuir uma decisão do departamento A ao departamento B ou omitir uma conclusão importante de uma reunião entre áreas. A proposta da Microsoft é: se não dá para usar dados reais, crie um ambiente cuja estrutura e comportamento se pareçam com os de uma empresa real.
Usando dados públicos como base para ambientes empresariais sintéticos
Quando se pede a um Modelo de Linguagem Grande que invente uma estrutura organizacional do zero, o resultado costuma ter pouca variedade de funções, uma hierarquia rasa e atividades repetitivas. A Microsoft usa três tipos de dados públicos para calibrar o ambiente sintético, todos revisados e aprovados por suas equipes jurídicas e de políticas.
| Fonte de dados públicos | Uso no artigo original | Alternativa para equipes pequenas e médias |
|---|---|---|
| Banco de dados ocupacional O*NET (Departamento do Trabalho dos EUA) | Tornar os cargos e as responsabilidades mais realistas, calibrar a combinação e a frequência das atividades de cada função e adaptar processos ao setor | Montar uma lista de funções com base em descrições públicas de vagas e padrões de classificação ocupacional do setor |
| Anúncios de vagas online | Fornecer nomes reais de cargos, níveis hierárquicos e composição de departamentos | Reunir descrições públicas de vagas do setor e extrair níveis de cargo e estruturas departamentais |
| Documentos públicos da SEC | Definir o tamanho da organização, a estrutura das unidades de negócio e o contexto financeiro | Consultar as descrições de segmentos de negócio e número de funcionários nos relatórios anuais de empresas de capital aberto |
Na terminologia da Microsoft, cada espaço de trabalho simulado é chamado de “tenant” (locatário): um ambiente organizacional isolado, com usuários, dados e configurações próprios. O artigo destaca que esses ambientes são bases expansíveis, sobre as quais cada equipe pode continuar construindo.
A dimensão temporal: por que “o que foi decidido na última quinta-feira?” exige uma estrutura temporal realista
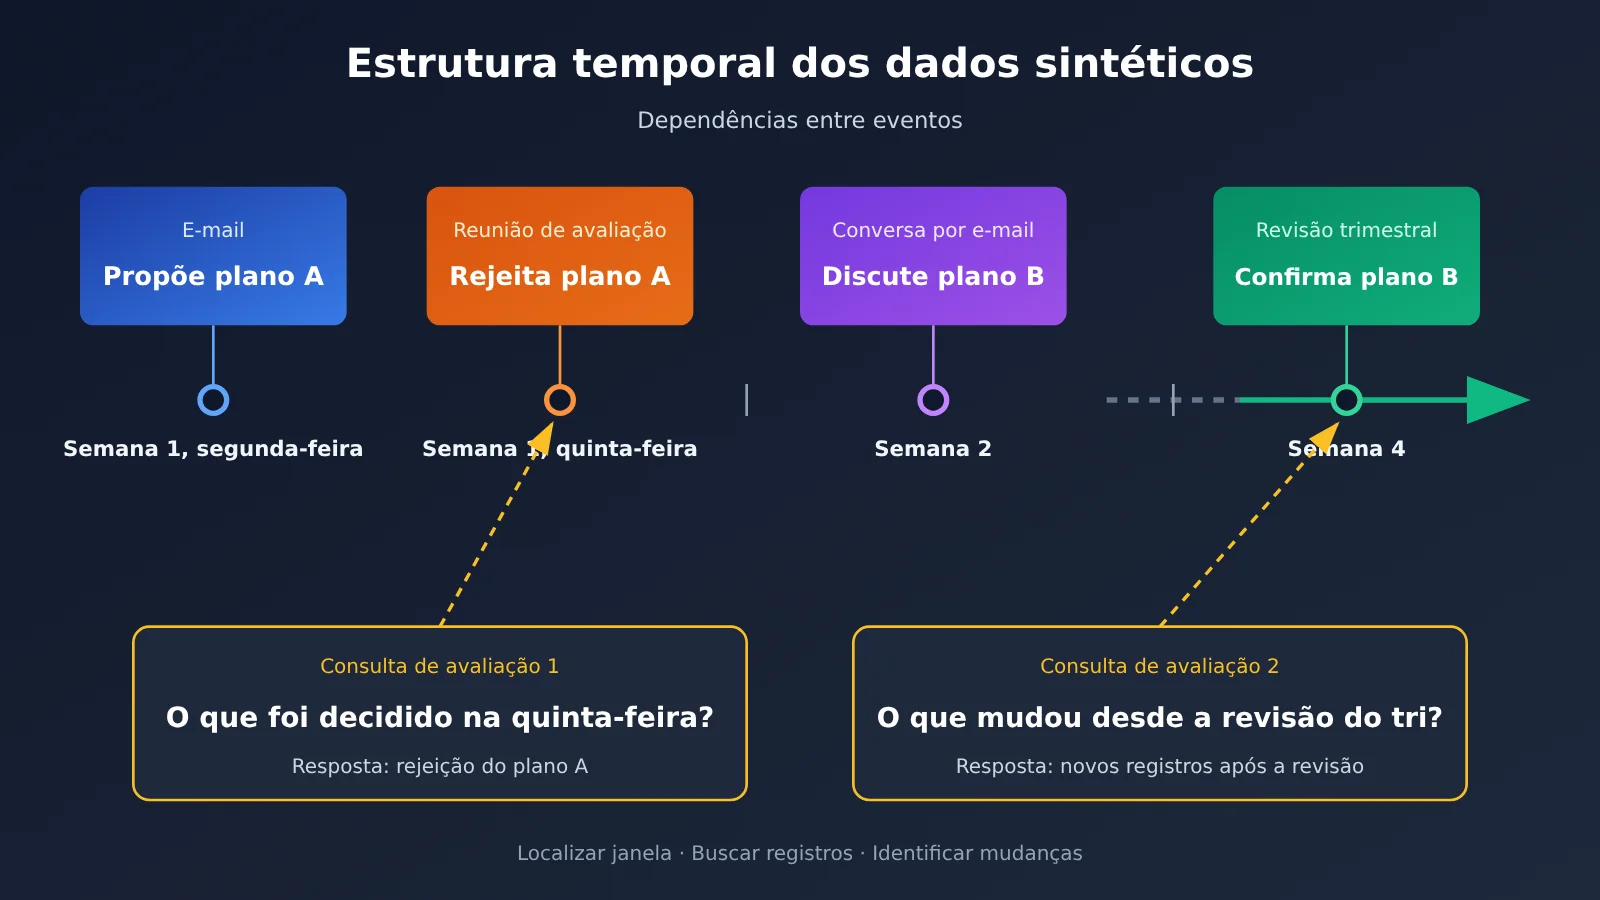
Este é o ponto do texto original que mais merece atenção das equipes pequenas e médias. O ambiente sintético da Microsoft não é um retrato estático, mas uma organização que evolui com o tempo: há históricos de reuniões, cronogramas de projetos, conversas por e-mail que se estendem por semanas e mudanças organizacionais que acontecem naturalmente. O texto original destaca que muitas consultas ao Copilot já têm uma dimensão temporal, como “o que a equipe decidiu na última quinta-feira?” ou “o que mudou desde a última revisão trimestral?”.
Isso acontece porque perguntas sobre tempo exigem que o modelo faça três coisas: delimitar o período, encontrar os registros relevantes dentro dele e identificar o que mudou. Se os dados sintéticos forem apenas um monte de documentos sem relação entre suas datas, ou se todas as reuniões acontecerem no mesmo dia, essas perguntas não terão uma resposta de referência ou serão fáceis demais, tornando a avaliação pouco significativa. Os dados sintéticos precisam ter relações de causa e efeito ao longo do tempo: por exemplo, uma proposta apresentada na segunda-feira, rejeitada na reunião de quinta e substituída por uma alternativa em um e-mail na semana seguinte. Só assim “o que foi decidido na última quinta-feira?” pode realmente testar o modelo.
Especialização por setor: o mesmo modelo revela problemas diferentes em cada área
A Microsoft criou ambientes sintéticos para três setores, cada um baseado em processos reais de negócio:
- Indústria farmacêutica: processos de submissão regulatória, discussões sobre ensaios clínicos e reuniões de avaliação de segurança entre equipes
- Mercado de capitais: pipeline de negociações, comunicação sobre conformidade e revisão de carteiras de clientes
- Empresas de TI e software: planejamento de iterações, discussões de revisão de código e coordenação de lançamentos de produtos
Segundo o artigo original, a especialização por setor aproxima as consultas de avaliação das perguntas que os usuários dessas áreas realmente fariam. Com isso, fica mais fácil identificar falhas específicas que testes genéricos não detectariam. Para equipes internas de empresas, que geralmente atendem a apenas um ou dois setores, isso torna mais viável aprofundar a avaliação.
Geração automática de consultas: as seis etapas do pipeline
Com o ambiente sintético pronto, ainda é preciso criar as consultas de avaliação. Segundo o artigo original, escrever manualmente milhares de consultas alinhadas aos dados e às características de cada setor seria caro e demorado. Por isso, foi criado um pipeline automatizado. O artigo apresenta apenas um resumo das etapas; a tabela abaixo organiza seis delas na ordem descrita, mas a divisão exata deve ser conferida no diagrama original.
| Etapa | Pontos principais do artigo original | Abordagem simplificada para equipes pequenas e médias |
|---|---|---|
| 1. Biblioteca de tarefas | Partir de uma grande variedade de tarefas comuns no ambiente de trabalho | Listar de 50 a 100 tarefas frequentes, como resumir reuniões, localizar decisões e comparar versões |
| 2. Seleção por setor | Selecionar as tarefas relevantes para um setor específico | Pedir à equipe de negócios que selecione as tarefas relevantes para seu setor |
| 3. Adaptação ao domínio | Reescrever as tarefas usando linguagem e contexto específicos do domínio | Adicionar termos do setor e tipos de documentos comuns |
| 4. Geração baseada no ambiente | Usar IA para gerar consultas ancoradas nos dados do ambiente sintético | Pedir ao modelo que leia documentos ou discussões específicos antes de criar as perguntas e que também produza respostas de referência e suas fontes |
| 5. Reescrita natural | Reescrever as consultas para que pareçam perguntas feitas por pessoas | Incluir linguagem coloquial, omissões e referências indiretas, como “o que aconteceu depois com aquele plano?” |
| 6. Validação | Verificar a precisão e a unicidade de cada consulta | Remover duplicatas e verificar por amostragem se cada resposta tem um único fundamento nos dados |
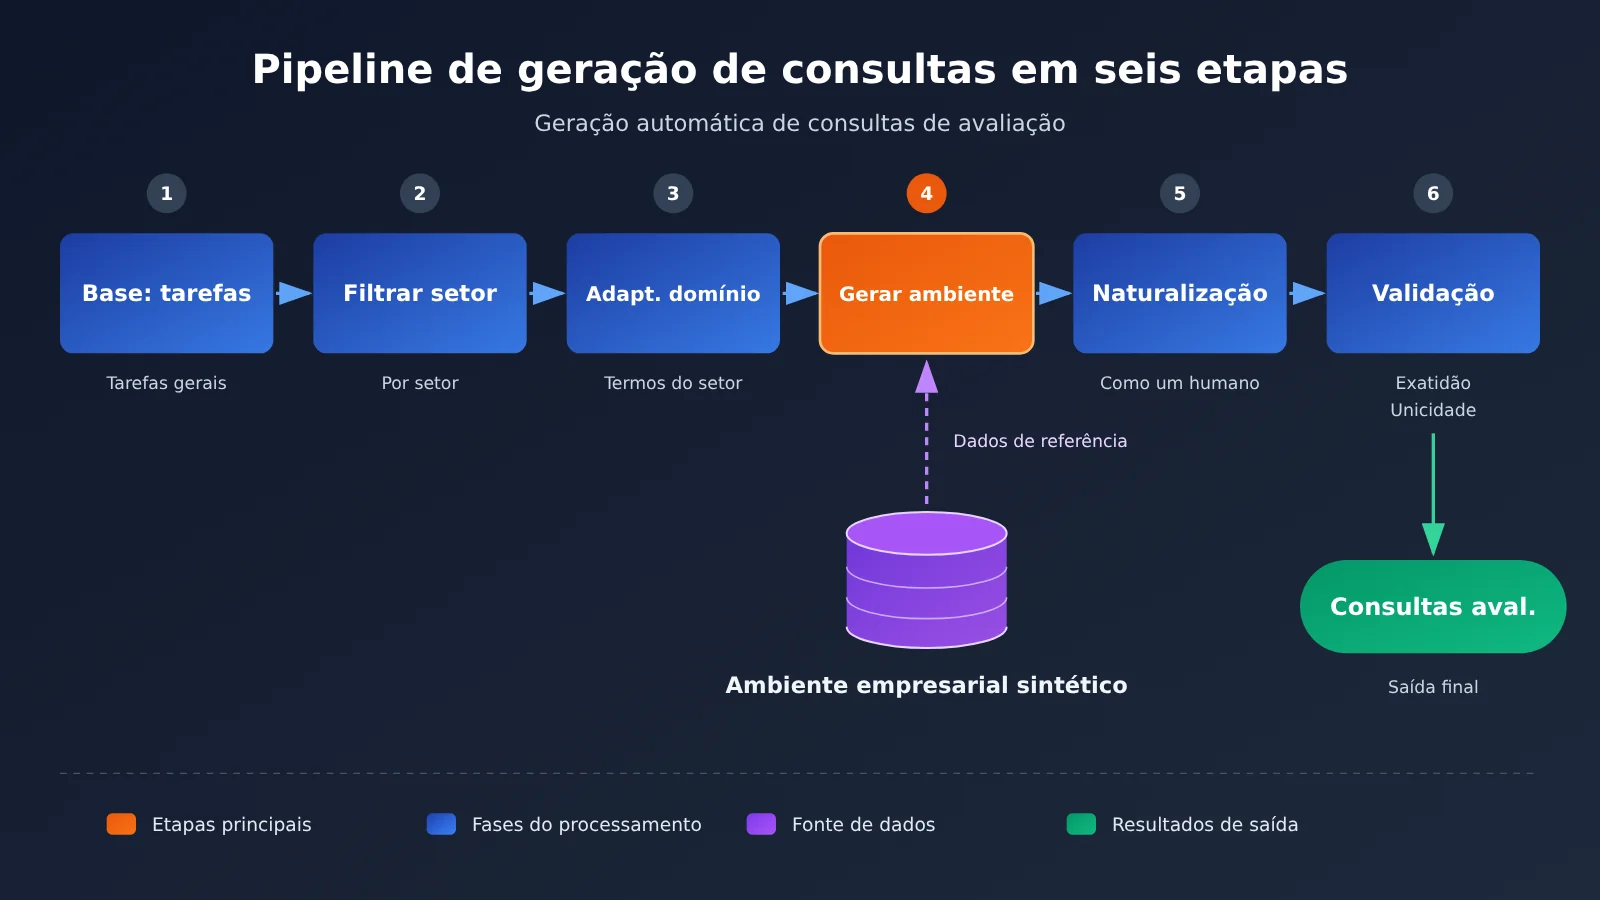
A etapa 4 é o ponto-chave de todo o pipeline: as consultas precisam estar ancoradas em dados específicos do ambiente. Caso contrário, não é possível determinar se as respostas estão corretas. A “unicidade” da etapa 6 também passa facilmente despercebida. Se uma mesma pergunta tiver várias respostas razoáveis nos dados, a pontuação poderá gerar controvérsia.
Nas etapas 4 e 5, é possível usar um modelo para criar as perguntas e outro para fazer a reescrita natural ou a validação. Isso ajuda a reduzir o viés de usar o mesmo modelo para criar e responder às próprias perguntas. Ao invocar vários modelos pela interface compatível com OpenAI da APIYI apiyi.com, basta alterar o nome do modelo para trocar entre eles, praticamente sem mudar o script de geração.
🎯 Sugestão técnica: na etapa de geração de consultas, defina um template de comando, o nome do modelo e parâmetros como a semente aleatória, e registre tudo em um arquivo de configuração. Assim, ao trocar de modelo para um experimento comparativo, a única variável será o próprio modelo. Com a interface unificada da APIYI, é possível alternar entre modelos de diferentes fornecedores no mesmo fluxo para gerar e validar consultas.
Validação da qualidade dos dados sintéticos: primeiro os dados, depois o modelo
Os próprios dados sintéticos também precisam ser avaliados. Caso contrário, uma pontuação alta do modelo pode indicar apenas que os dados são simples demais. O texto original afirma que a qualidade é medida em “três dimensões” por meio de um framework interno de avaliação semântica, mas lista quatro itens. A tabela abaixo apresenta os quatro; leve essa divergência em conta ao citar a fonte.
| Dimensão de qualidade | Pergunta de verificação no original | Como verificar na prática |
|---|---|---|
| Fidelidade estrutural | A estrutura organizacional reflete hierarquias de subordinação, tamanhos de equipe e relações entre áreas reais? | Medir a profundidade da hierarquia e a distribuição do número de pessoas por equipe e comparar com dados públicos |
| Relevância contextual | As consultas e os fluxos de trabalho representam padrões reais de uso em empresas? | Pedir a profissionais da área que avaliem amostras de consultas sem conhecer sua origem e pontuem se parecem perguntas reais |
| Realismo comportamental | Os usuários simulados apresentam padrões de comunicação e dinâmicas de colaboração semelhantes aos humanos? | Verificar se os e-mails têm sequências de respostas e se as reuniões incluem divergências e ações posteriores |
| Segurança do conteúdo | O conteúdo está livre de informações prejudiciais, ofensivas ou de identificação pessoal e não se passa por pessoas reais? | Buscar automaticamente padrões de nomes, telefones e números de documentos e fazer uma revisão manual |
Segundo o texto original, em comparação com o método inicial de geração, o indicador geral de qualidade melhorou 39%, e alguns ambientes setoriais atingiram pontuações acima de 0,9 em uma escala cujo máximo é 1,0. O texto atribui a melhora a dois fatores: a introdução de sinais reais do setor e o uso do indicador geral de qualidade para orientar melhorias automatizadas. Vale destacar que essas pontuações medem o quanto os dados sintéticos se parecem com dados de empresas reais, não o desempenho do Copilot em si. O texto original não divulga métricas do Copilot nesses conjuntos de dados.
Reprodutibilidade: a base para usar conjuntos de avaliação sintéticos em testes de regressão entre versões
O artigo original lista quatro problemas práticos enfrentados sem automação:
- Reprodutibilidade: processos manuais geram pequenas diferenças a cada execução, dificultando a comparação entre versões
- Escala: a quantidade de setores e variações de configuração supera a capacidade humana
- Velocidade de iteração: a criação manual leva dias, atrasando o feedback
- Consistência entre equipes: sem ferramentas padronizadas, os formatos e a qualidade dos conjuntos de dados são incompatíveis entre equipes
Com a automação, a criação de conjuntos de dados deixou de ser um trabalho manual de vários dias e passou a ser executada automaticamente. A Microsoft estima uma economia de cerca de 100.000 dólares por conjunto de avaliação e de aproximadamente 300.000 dólares no projeto todo. Essa estimativa se baseia na escala da própria empresa e não pode ser aplicada diretamente a outras equipes. Para o artigo original, o resultado mais importante é que qualquer equipe pode gerar exatamente o mesmo conjunto de dados usando a mesma configuração.
Isso é fundamental para testes de regressão. Se você altera a estratégia de recuperação ou troca de modelo e a pontuação cai, precisa ter certeza de que a mudança veio do sistema, não dos dados. Se o conjunto de teste for ligeiramente diferente a cada geração, a comparação entre versões perde o sentido.
Ao comparar vários modelos candidatos na APIYI, vale seguir o mesmo princípio: mantenha fixo o conjunto de avaliação sintético de uma determinada versão e execute-o com cada modelo separadamente. Assim, os resultados da comparação refletem apenas as diferenças entre os modelos.
Guia rápido para criar um conjunto de avaliação empresarial sintético em equipes pequenas e médias
A abordagem da Microsoft envolve o histórico completo de comunicação de centenas de usuários, três ambientes setoriais, revisão jurídica e diretórios internos compartilhados. Equipes pequenas e médias não precisam copiar tudo isso. Os passos abaixo simplificam o método do artigo original.
Etapas de implementação
- Defina o escopo: escolha um cenário de negócios, como “perguntas e respostas sobre atas de reunião” ou “busca em documentos de projetos”, e trabalhe com apenas um setor.
- Desenhe a organização: use vagas públicas e materiais do setor como referência para criar uma organização virtual de 20 a 50 pessoas. Defina departamentos, cargos e relações de subordinação.
- Monte a linha do tempo: crie primeiro uma linha do tempo do projeto de 4 a 8 semanas, com eventos importantes, decisões e mudanças. Depois, gere atas, e-mails e documentos com base nela, mantendo a coerência entre os acontecimentos.
- Gere o conteúdo: use um Modelo de Linguagem Grande para gerar os documentos conforme a linha do tempo, incluindo metadados como data, autor e participantes em cada arquivo.
- Gere as consultas: crie as perguntas seguindo o processo de seis etapas descrito acima. Inclua uma resposta de referência e o número do documento de origem para cada pergunta, identificando separadamente as consultas temporais.
- Valide os dados: faça verificações por amostragem nas quatro dimensões de qualidade. A varredura de informações de identificação pessoal (PII) deve cobrir todos os dados.
- Controle as versões: registre a configuração da organização, a linha do tempo, os comandos, os nomes e os parâmetros dos modelos em um arquivo de configuração e atribua um número de versão.
- Execute a avaliação: rode o sistema em teste sobre uma versão fixa do conjunto de dados e registre as pontuações por tipo de consulta.
🚀 Comece rapidamente: as etapas 4 e 5 exigem invocações repetidas de Modelos de Linguagem Grande. Com a interface compatível com OpenAI da APIYI em apiyi.com, você pode acessar vários modelos usando o mesmo formato de chamada: use um modelo para gerar e outro para validar, alterando apenas o nome do modelo.
Checklist de verificação
- [ ] Os dados de avaliação não contêm nenhum dado real de clientes ou funcionários
- [ ] A estrutura organizacional tem hierarquia e colaboração entre departamentos, em vez de ser uma lista sem hierarquia
- [ ] Os dados seguem uma estrutura temporal realista, abrangem pelo menos algumas semanas e apresentam relações de causa e efeito entre os eventos
- [ ] Há uma proporção de consultas temporais, como “na semana passada” e “desde a última retrospectiva”
- [ ] As consultas usam termos e tipos de documentos do setor em questão
- [ ] Cada consulta tem uma única resposta de referência verificável e uma fonte identificada
- [ ] Os próprios dados sintéticos passaram por uma verificação de qualidade antes de serem usados
- [ ] A mesma configuração permite gerar novamente o mesmo conjunto de dados
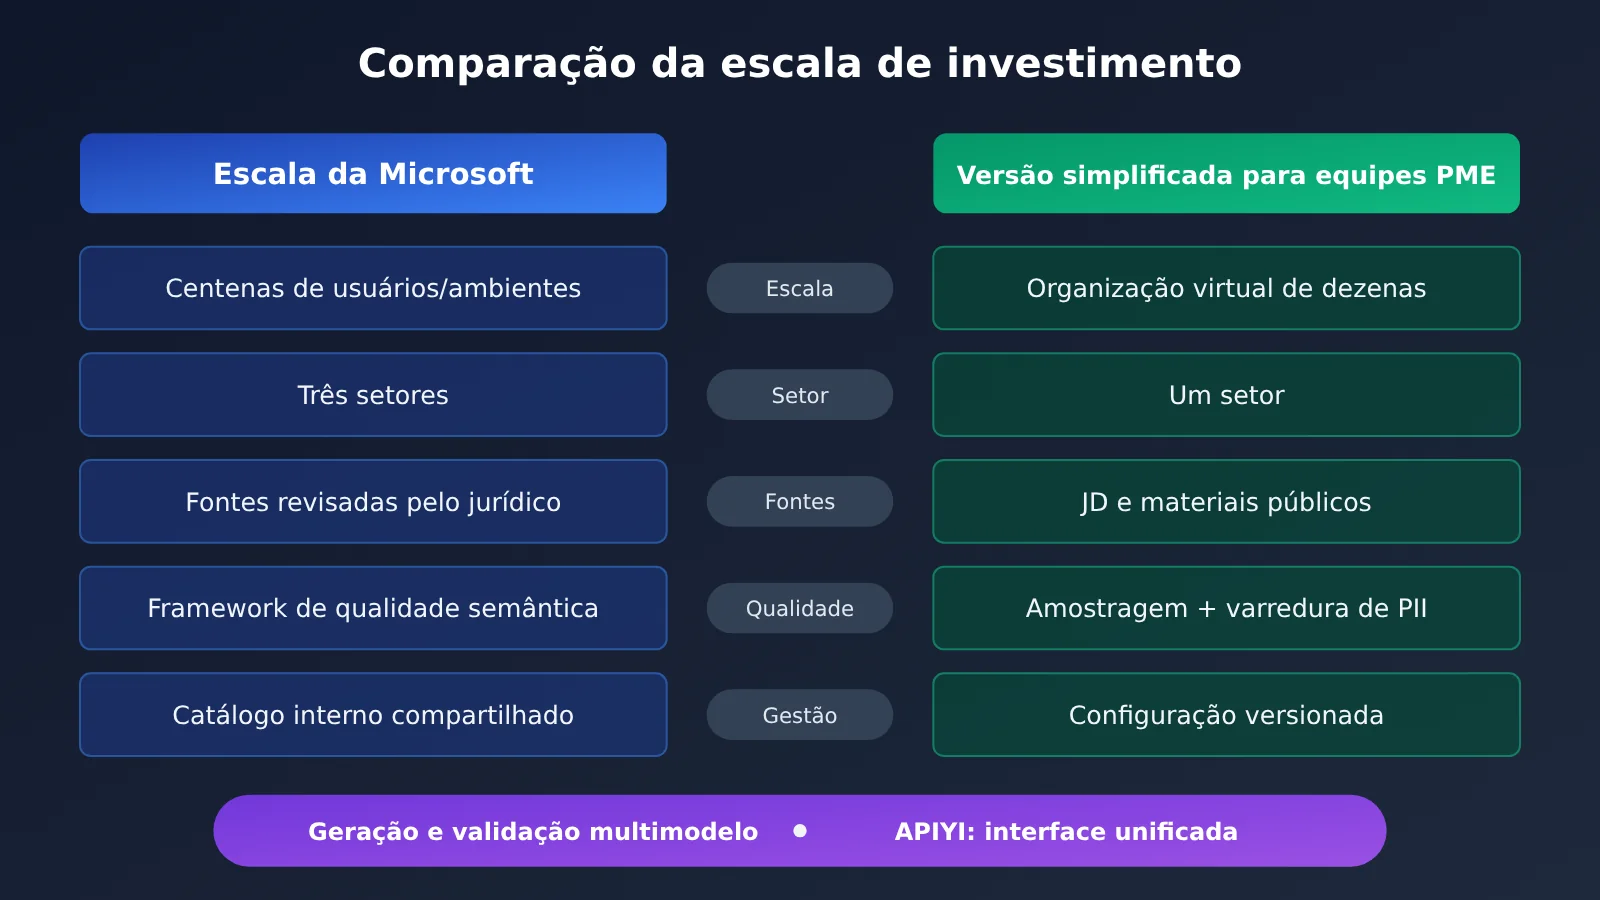
Quais etapas exigem grandes investimentos e quais podem ser simplificadas
| Etapa | Abordagem da Microsoft | Investimento necessário | Sugestão para equipes pequenas e médias |
|---|---|---|---|
| Uso de dados públicos | O*NET, anúncios de vagas e documentos da SEC, revisados pelo departamento jurídico | Alto | Basta reunir manualmente materiais do setor, mas ainda é necessário confirmar se as fontes podem ser usadas |
| Escala do ambiente | Centenas de usuários por ambiente, com histórico completo de comunicação | Alto | Dezenas de pessoas bastam para cobrir os principais papéis |
| Cobertura de setores | Três setores | Médio | Trabalhar apenas com o setor atendido pela equipe |
| Framework de qualidade | Framework interno de avaliação semântica e métricas integradas | Alto | Amostragem manual + estatísticas simples + varredura automática de PII |
| Estrutura temporal | Organização que evolui com o tempo | Indispensável | Criar primeiro uma linha do tempo e depois gerar o conteúdo |
| Reprodutibilidade | A mesma configuração gera os mesmos resultados | Indispensável | Versionar a configuração e armazenar os resultados gerados em cache |
É possível reduzir a escala e o nível de automação, mas não abrir mão da estrutura temporal, da ancoragem das consultas e da reprodutibilidade. Esses três elementos determinam se os resultados da avaliação podem embasar a decisão de colocar o sistema em produção. Vale destacar que ainda não há materiais públicos sobre os custos e resultados reais da aplicação desse método por equipes pequenas e médias. As sugestões acima são extrapolações baseadas no método do artigo original.
Perguntas frequentes (FAQ)
Q1: O que é um conjunto de avaliação de ambiente empresarial sintético?
É um espaço de trabalho empresarial simulado, gerado inteiramente por programa, que contém funcionários, estrutura organizacional, reuniões, e-mails e documentos, acompanhado de um conjunto de consultas de avaliação baseadas nesses dados. Ele serve para testar se aplicações de IA empresarial conseguem encontrar, integrar e apresentar as informações corretas sem acessar dados reais de clientes.
Q2: Qual é a diferença entre um conjunto de avaliação sintético e um benchmark genérico?
Benchmarks genéricos são úteis para comparar capacidades gerais, mas não incluem relações de subordinação, histórico de projetos e fluxos de trabalho específicos de um domínio. Um ambiente empresarial sintético preserva essas estruturas e pode revelar falhas específicas que testes genéricos não detectam, como confundir a qual departamento alguém pertence ou deixar passar decisões tomadas em reuniões entre equipes.
Q3: Quando a Microsoft divulgou essa abordagem?
A Microsoft Research publicou um artigo sobre o assunto em 30 de outubro de 2026. Segundo o texto, a plataforma foi disponibilizada em um diretório interno compartilhado e se tornou a primeira base padronizada de avaliação do Microsoft Copilot.
Q4: Para quais cenários essa abordagem é mais indicada?
– **Perguntas e respostas sobre atas de reunião**: testar a precisão de resumos, extração de ações e citações
– **Busca em bases de conhecimento empresarial**: testar se é possível encontrar a única fonte correta em meio a muitos documentos
– **Consultas temporais**: testar perguntas como “o que foi decidido na semana passada?” e “o que mudou recentemente?”
– **Testes de regressão de modelos ou versões**: comparar soluções novas e antigas em um conjunto de dados fixo
Q5: Como comparar diferentes modelos com o mesmo conjunto de avaliação sintético?
O essencial é manter fixa a versão do conjunto de dados e trocar apenas o modelo avaliado. A APIYI apiyi.com oferece uma interface unificada compatível com a OpenAI, com suporte a vários modelos populares. Para alternar entre eles, basta mudar o nome do modelo, permitindo executar o mesmo script de avaliação para cada candidato. Vale lembrar que você ainda precisa implementar a lógica de pontuação e a estrutura de avaliação.
Q6: Dados sintéticos podem distorcer os resultados da avaliação?
Sim. Por isso, o artigo original apresenta uma estrutura de qualidade que avalia primeiro os dados e depois o modelo. Se os dados sintéticos forem organizados demais e não tiverem divergências e ruídos realistas, as pontuações dos modelos podem ficar artificialmente altas. A recomendação é pedir que profissionais da área de negócio avaliem amostras dos dados às cegas e usar regularmente feedback real anonimizado para calibrar os dados sintéticos.
Q7: Quais são as limitações conhecidas dessa abordagem?
O artigo original não divulga os comandos, as ferramentas ou os detalhes de implementação de cada etapa do pipeline, nem as métricas de avaliação do Copilot. A estrutura de qualidade menciona “três dimensões”, mas lista quatro itens. O valor economizado é uma estimativa da própria Microsoft. O texto também aponta como próximos desafios de avaliação as interações com agentes em múltiplas rodadas, a evolução organizacional ao longo de meses ou até anos e os sistemas de IA que executam ações.
Principais pontos sobre conjuntos de avaliação de ambientes empresariais sintéticos
- Estrutura em três camadas: criar o ambiente sintético, gerar consultas automaticamente e validar a qualidade dos dados. Sem qualquer uma delas, a avaliação não é confiável.
- Calibração com dados públicos: use bases de dados ocupacionais, anúncios de vagas e relatórios financeiros públicos para aproximar a estrutura organizacional da realidade.
- A estrutura temporal é indispensável: consultas sobre tempo exigem que os dados tenham uma sequência realista de eventos e relações de causa e efeito.
- A especialização por setor aumenta a detecção: consultas próximas ao domínio têm mais chances de revelar falhas específicas daquela área.
- Teste os dados antes do modelo: verifique os dados sintéticos em quatro dimensões: estrutura, contexto, comportamento e segurança.
- A reprodutibilidade é essencial para testes de regressão: a mesma configuração precisa gerar os mesmos dados para que a comparação entre versões faça sentido.
- Comparação entre modelos: depois de fixar o conjunto de dados, é possível trocar o nome do modelo pela interface unificada da APIYI e comparar os resultados.
Resumo
Ao analisar o método da Microsoft para criar ambientes empresariais sintéticos para o Copilot, podemos destacar três pontos:
- Dados sintéticos para proteger a privacidade: sem usar dados de clientes desde o início, o conjunto de dados pode ser compartilhado e reutilizado livremente entre equipes.
- Estrutura para ganhar realismo: hierarquia organizacional, cronologia e processos do setor determinam se a avaliação consegue identificar problemas reais.
- Automação para garantir reprodutibilidade: a mesma configuração deve produzir o mesmo conjunto de dados para que os resultados da avaliação apoiem decisões de lançamento.
Equipes pequenas e médias não precisam reproduzir a escala da Microsoft, mas vale adotar três práticas: estruturar o tempo, ancorar as consultas e versionar as configurações. Comece com um cenário, um setor e uma organização virtual de algumas dezenas de pessoas. Execute o processo completo uma vez e, depois, amplie aos poucos.
Depois de fixar o conjunto de dados, você pode usar a APIYI apiyi.com para acessar vários modelos com o mesmo formato de chamada compatível com OpenAI e comparar diretamente seu desempenho no mesmo conjunto de avaliação sintético.
📚 Referências
- Microsoft Research Blog – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence: fonte original da análise apresentada neste artigo
- Link:
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
Descrição: apresenta o ambiente sintético, o pipeline de seis etapas, o framework de qualidade, o design de privacidade e os dados dos resultados
-
Base de dados ocupacionais O*NET: base de informações sobre ocupações do Departamento do Trabalho dos EUA
- Link:
onetonline.org -
Descrição: usada no artigo original para calibrar a distribuição de cargos, responsabilidades e atividades de trabalho dos funcionários sintéticos
-
Pesquisa de documentos públicos SEC EDGAR: documentos divulgados publicamente pela Comissão de Valores Mobiliários dos EUA
- Link:
sec.gov/edgar - Descrição: usada no artigo original para definir o porte, a estrutura das unidades de negócio e o contexto financeiro da organização sintética
Autor: Equipe técnica da APIYI
Troca de ideias técnicas: Para conversar sobre acesso unificado a vários modelos, entre em contato conosco pelo site da APIYI, apiyi.com