著者注:Gemini 4 Neon には4段階の思考レベルがあり、デフォルトは HIGH です。思考トークンは出力トークンとして課金されます。本記事では、各レベルがどのようなタスクに適しているかを説明し、Carbon のレベル設定をそのまま Neon に適用できない理由も整理します。
Gemini 4 Neon を導入してから、多くの開発者が最初にぶつかる問題は成果ではなく請求額です。思考トークンは出力価格で課金され、レベルを上げるほどモデルは回答を出す前に多く考え、出力トークンも増えます。本記事の提案は タスクに応じてレベルを選び、必要十分で止める こと。効果とコストの間で適切なレベルを見つける助けになります。
これは「高いほど良い」というパラメータ解説ではありません。 Google Cloud のドキュメントでは、Neon の各レベルの適用シナリオが具体的に示されています。本記事は公式ドキュメントを根拠に、そのまま設定に使える対照表として整理し、よくあるエラーや混同しやすい点を補足します。
本記事の価値:読み終えると、Gemini 4 Neon のデフォルトが HIGH であること、分類やルーティング系のタスクなら LOW で十分であること、XHIGH は最も重い作業にだけ使うこと、そして Carbon や Antigravity の設定を API 呼び出しに誤って流用しないことが分かります。
Gemini 4 Neon 思考レベルの核心ポイント
まず、最も重要な結論から確認します。これらはすべて Google Cloud の Gemini 4 Neon ドキュメント(2026-11-19 版)と AI Studio の最新モデルページに基づいています。
| ポイント | 説明 | 実務での価値 |
|---|---|---|
| 4段階の思考レベル | LOW、MEDIUM、HIGH、XHIGH。デフォルトは HIGH | パラメータを渡さない場合すでに高めのレベルになり、能動的に下げる必要があります |
| 旧パラメータはエラーになる | thinking_budget と MINIMAL は HTTP 400 を返します |
既存コードを移行する際はパラメータ変更が必須です |
| 思考トークンの課金 | 思考トークンは出力単価で課金されます | レベルが出力側コストに直接影響します |
| レベルはモデル間で共通ではない | Carbon は3段階のみでデフォルトは medium。Hydrogen は Neon と同じく4段階です | あるモデルの設定を別モデルにコピーすることはできません |
| UI と API は異なる | Antigravity の UI では Extra が xhigh に相当し、コンテキスト上限も異なります | IDE の体験から API の挙動を推測するのは避けましょう |
Gemini 4 Neon の4段階思考レベルとタスクの対応
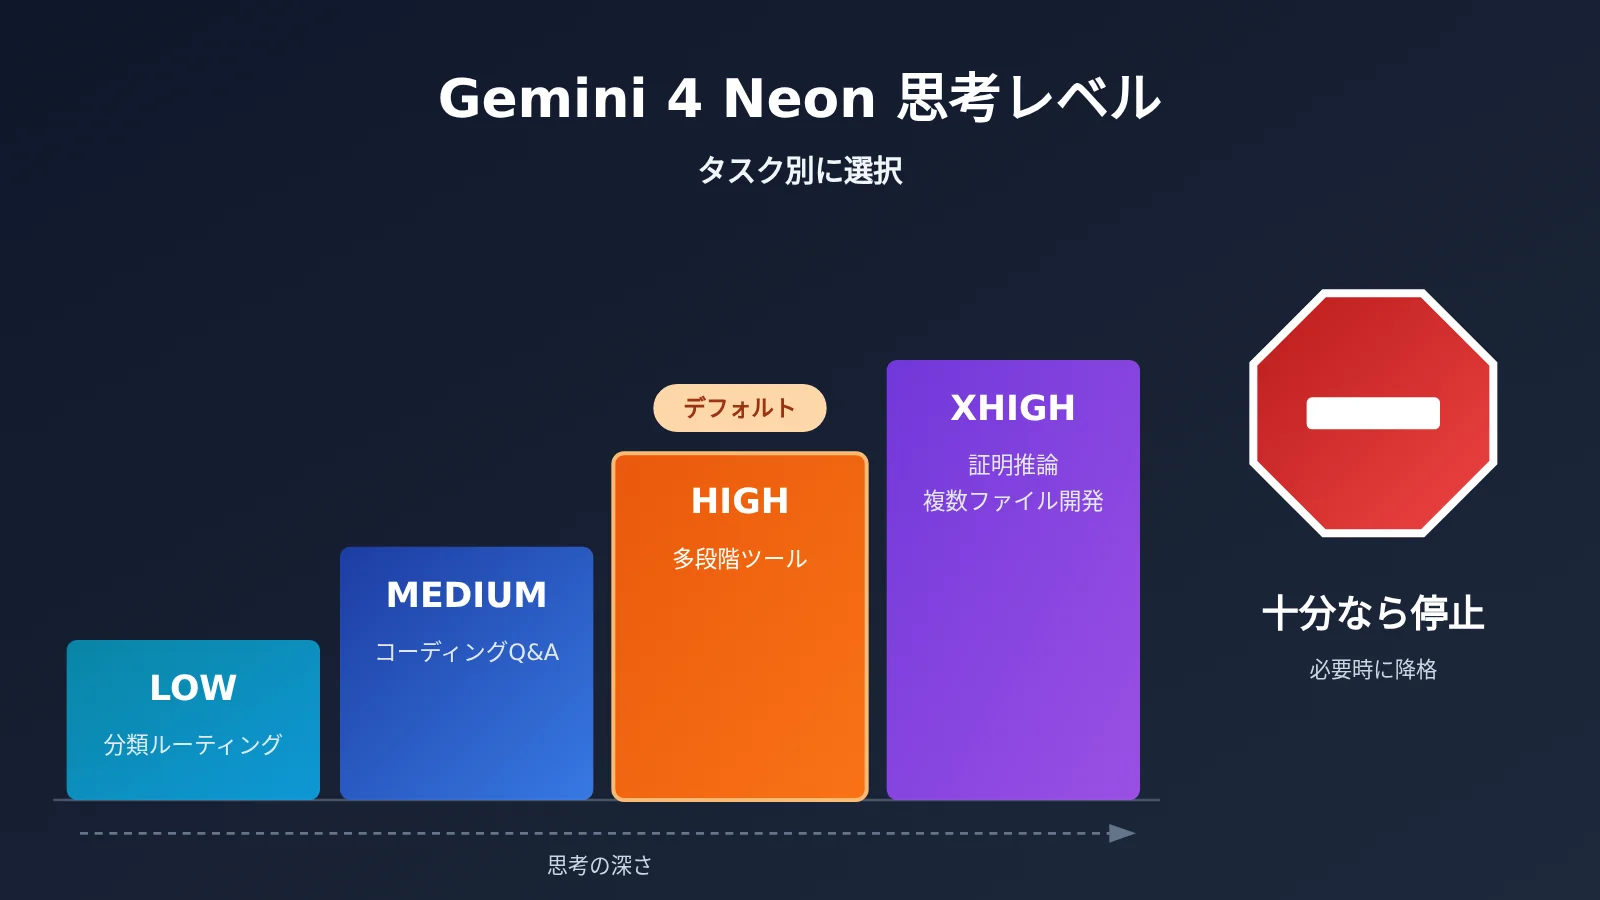
公式ドキュメントでは各レベルごとに推奨シナリオが明記されています。設定時の参照用に、以下にまとめます。
| 思考レベル | 公式推奨シナリオ | 典型的な業務例 | 選択のヒント |
|---|---|---|---|
LOW |
高スループットの分類、ルーティング、要約 | チケットへのタグ付け、意図認識、長文の要点抽出 | バッチ処理ではこのレベルを優先 |
MEDIUM |
一般的なコーディング、ドキュメントQ&A | 関数の作成、バグ修正、ナレッジベースに基づく回答 | 日常的な開発リクエストの大半にはこれで十分 |
HIGH(デフォルト) |
多段階のツール呼び出し、複雑なマルチモーダル | Agent による連続的なツール呼び出し、画像とテキストの混合分析 | パラメータを渡さない場合のデフォルト |
XHIGH |
証明、科学分析、最も負荷の高い複数ファイルエンジニアリング | 数学的導出、実験データ分析、複数モジュールにまたがるリファクタリング | 最も重いタスクにのみ使用 |
この表で注意すべき点は2つあります。第一に、デフォルト値は HIGH であり、MEDIUM ではありません。つまり、コードで何も指定しなければ、分類リクエストごとに「多段階ツール呼び出し」相当の強度で思考します。高スループットのシナリオでは、これは通常無駄です。第二に、XHIGH は Neon の上限レベルであり、用途は証明や最も重いエンジニアリングタスクです。日常的なコーディングリクエストで XHIGH を有効にすると、多くの場合、より長い待ち時間とより多くの出力トークンしか得られません。
なぜ Gemini 4 Neon は「十分なら止める」べきなのか
コストの鍵は課金方式にあります。思考トークンは出力単価で課金され、Gemini 4 Neon の出力単価は入力単価の5倍です(Google の公告価格は入力 $3、キャッシュ $0.15、出力 $15、単位はいずれも100万トークンあたり)。思考が増えるほど、最も高価な部分のトークンが増えます。
各レベルでどれだけ思考トークンを余分に消費するかは、タスク自体の複雑さに依存します。公式は固定比率を示しておらず、本記事でも「1レベル下げるとどれだけコストを削減できるか」といった数値は提供しません。より確実な方法は、自社の業務サンプルで LOW とデフォルトの HIGH をそれぞれ実行し、返却結果の出力トークン使用量と回答品質を比較したうえで、レベルを下げるかどうかを判断することです。
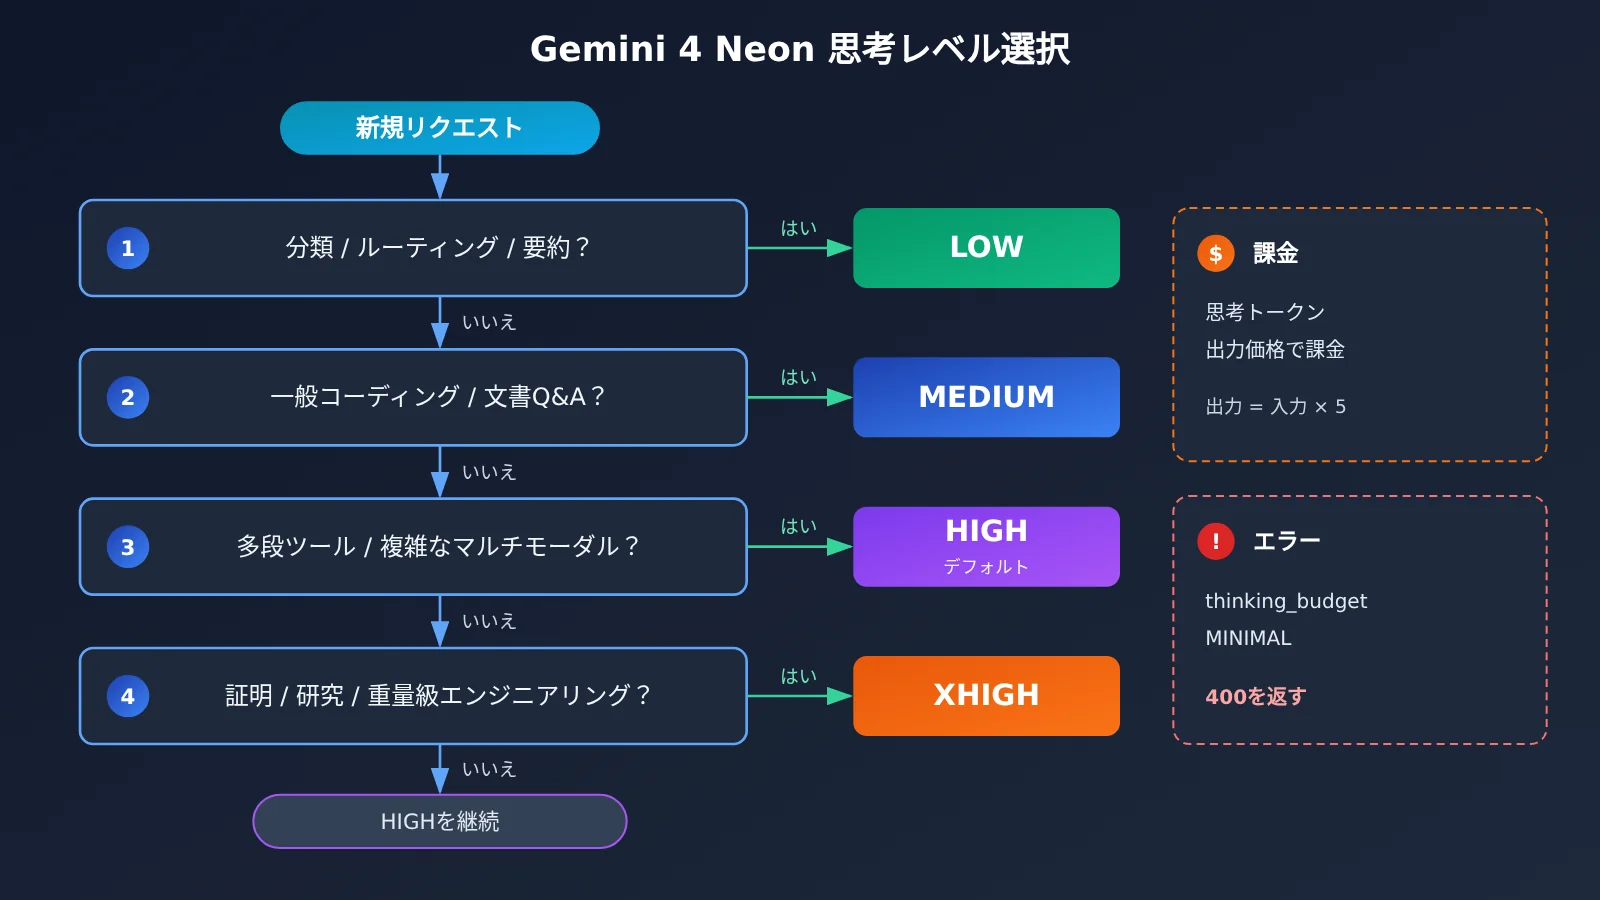
Gemini 4 Neon 思考レベル クイックスタート
最小サンプル:LOW レベルで分類を行う
APIYI は OpenAI 互換インターフェースを提供しています。公式の openai Python SDK で base_url を少し変更するだけで、Gemini 4 Neon を呼び出せます。以下、重要なコードをステップごとに示します。どれもそのままコピーして使えます:
- SDK をインストール:
pip install openai - クライアントを作成:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - モデルを指定:
model="gemini-4-neon" - 思考レベルを設定:
reasoning_effort="low" - リクエストを送信:
client.chat.completions.create(model="gemini-4-neon", reasoning_effort="low", messages=[{"role": "user", "content": "判断这条工单属于:账单 / 技术 / 其他。工单内容:……"}]) - 結果を取得:
resp.choices[0].message.content
分類タスクではラベルが 1 つあれば十分なので、LOW レベルで要件を満たせます。コードを書くタスクや、ドキュメントに基づく質問応答に切り替える場合は、ステップ 4 を reasoning_effort="medium" に変更するだけです。
ここで補足しておきたいのは、パラメータ名は使用するインターフェース形式によって異なるという点です。Gemini ネイティブインターフェースでは、思考レベルは thinking_config の thinking_level フィールドに記述し、値は LOW / MEDIUM / HIGH / XHIGH を取ります。OpenAI 互換形式では、思考の強度は通常 reasoning_effort で渡します。具体的なフィールドマッピングはプラットフォームのドキュメントに従ってください。リリース前に、まず 1 回のリクエストでレベルが確実に反映されることを確認することをお勧めします。
完全な実装方針を見る:タスク種別に応じて自動でレベルを選択
本番環境では、グローバルに 1 つの値をハードコードするのではなく、業務コードがタスク種別に応じてレベルを選択するようにするのが望ましい方法です。実装は次のステップに分けられます:
1. マッピング表を定義:`LEVEL_MAP = {“classify”: “low”, “route”: “low”, “summary”: “low”, “code”: “medium”, “doc_qa”: “medium”, “agent”: “high”, “multimodal”: “high”, “proof”: “xhigh”, “multi_file”: “xhigh”}`
2. フォールバック値を設定:`level = LEVEL_MAP.get(task_type, “high”)`。未知のタスクは公式デフォルトの HIGH をそのまま使うので、予期せず品質が下がることはありません
3. クライアントを統一:`client = OpenAI(api_key=os.getenv(“APIYI_KEY”), base_url=”https://api.apiyi.com/v1″)`
4. 呼び出しを実行:`client.chat.completions.create(model=”gemini-4-neon”, reasoning_effort=level, messages=messages)`
5. 使用量を記録:`resp.usage` の出力トークン数と `task_type`、`level` を一緒にログに書き込み、タスク種別ごとに思考コストを集計できるようにします
6. 400 エラーを処理:例外をキャッチしたら、リクエストにまだ `thinking_budget` や `MINIMAL` が含まれていないか確認します。これら 2 つの値は Neon ではいずれも HTTP 400 を返します
ステップ 2 のフォールバック値は重要です。マッピング表で特定のタスクが漏れていた場合、デフォルトの HIGH でトークンを多く消費するほうが、黙って LOW に下げて回答が誤るより良いです。ログがある程度蓄積されたら、データに基づいて種別ごとにレベルを段階的に下げていきます。
推奨:まず少量の実際の業務サンプルで LOW、MEDIUM、デフォルトの HIGH をそれぞれ実行し、それから本番のレベルを決めましょう。APIYI apiyi.com で登録すると無料のテスト枠がもらえます。1 つの API キーで Neon、Hydrogen、Carbon を切り替えて比較できます。
Gemini 4 Neon と Carbon、Hydrogen の思考レベル比較
多くの人がつまずく原因は、Gemini 4 シリーズが同じティア構成を共有していると思い込んでいることです。AI Studio の最新モデルページを見ると、実際はそうではありません:
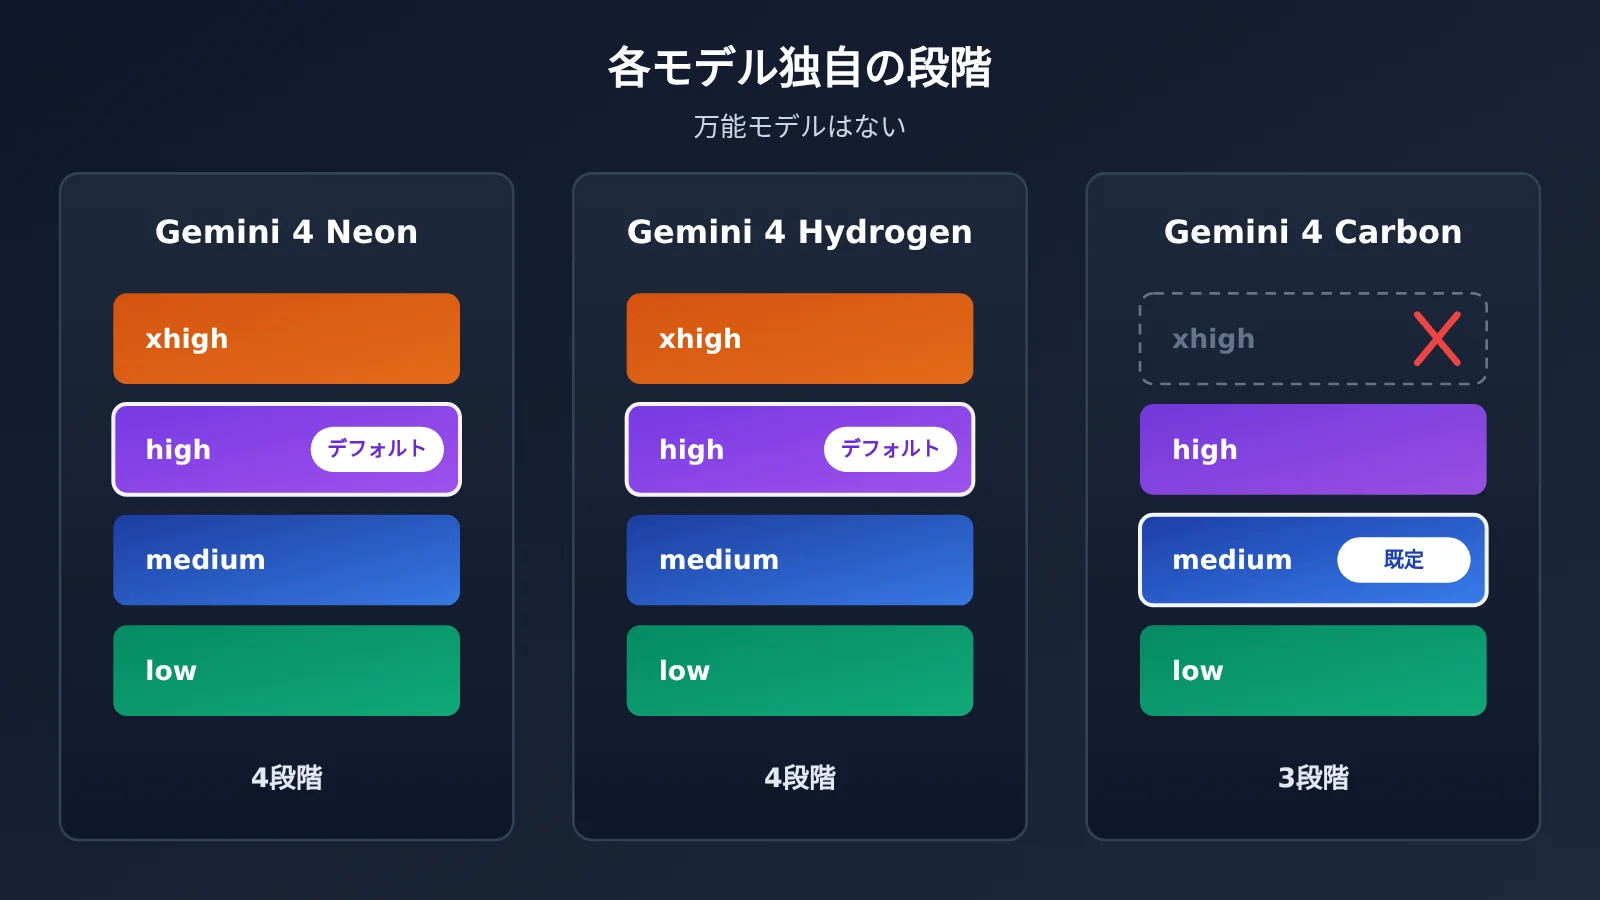
| モデル | 思考レベル | デフォルトティア | xhigh の有無 | 利用可能なプラットフォーム |
|---|---|---|---|---|
| gemini-4-neon | low / medium / high / xhigh | high | あり | APIYI、Google 公式 |
| gemini-4-hydrogen | low / medium / high / xhigh | high | あり | APIYI、Google 公式 |
| gemini-4-carbon | low / medium / high | medium | なし | APIYI、Google 公式 |
ティアの違いを読み解く
Carbon の比較分析:Carbon のデフォルトティアは medium で、最高ティアは high、xhigh はありません。Carbon 向けに書かれた設定(たとえば「デフォルトは medium、重い処理では high を有効にする」)をそのまま Neon に適用すると、Neon の「重い処理」は中間ティアしか使われず、本当に XHIGH が必要な証明系タスクでは最高強度に達しません。逆に、Neon の xhigh を Carbon に渡しても、Carbon がサポートする値の範囲外です。
Hydrogen の比較分析:Hydrogen は Neon と同じく4段階で、デフォルトも high なので、両者のティア設定は互いに参考にできます。ただしティア名が同じでも、同じティアの思考深度やコストが同じというわけではありません。モデルを切り替えた後は、改めて評価し直す必要があります。
Antigravity の場合:Antigravity のインターフェースでは xhigh は Extra と表示されますが、CLI では依然として xhigh と書かれます。コンテキスト上限は 512K で、API のコンテキストウィンドウは 1,048,576 token であり、両者は同じウィンドウではありません。そのため IDE で得られる体験を、そのまま API 呼び出しの長コンテキスト性能の推定に使うことはできません。
比較のポイント:3モデルはいずれも同じエンドポイント
https://api.apiyi.com/v1から呼び出せ、modelフィールドを変えるだけです。それぞれがサポートするティアの範囲内で個別にテストすることを推奨します。モデルをまたいでティア設定をそのまま流用しないでください。
Gemini 4 Neon の価格とエンドポイント確認
モデルティアを選ぶとき、単価はどうしても気になるポイントです。以下の表は、2026-11-20 に確認した APIYI の価格で、単位はすべて米ドル / 100万トークンです。データソースは2つあります。APIYI(apiyi.com)のモデル一覧表 docs.apiyi.com/models.md(2026-11-19 10:59、UTC+8 更新)と、料金API https://api.apiyi.com/api/pricing(バージョン shell-api-modelmak-v1。ここで model_ratio が 1 のとき、入力 $2 / 100万トークンに対応します)です。
| モデル ID | 入力 | キャッシュ読み取り | 出力 | 備考 |
|---|---|---|---|---|
gemini-4-neon |
$3 |
$0.15 |
$15 |
料金API の model_ratio 1.5、completion_ratio 5、cache_ratio 0.05 は Google の表示価格と一致 |
gemini-4-hydrogen |
$1.5 |
$0.075 |
$7.5 |
同じく4ティア構成で、デフォルトは high |
gemini-4-carbon |
$2 |
$0.1 |
$10 |
Google の 2026-11-30 時点の導入価格と一致。12月1日以降の Google 標準価格は入力 $4、出力 $20 |
注意点として、gemini-4-neon はこのバージョンのモデル一覧表にはまだ掲載されていませんが、料金API にはすでに対応する項目があり、換算後の価格は Google の公表価格と一致します。価格を確認する際は、料金API を基準にすることをおすすめします。Neon では、出力単価 $15 が思考トークンにも適用されるため、ティアが高いほどこの列の影響が大きくなります。
よくある質問(FAQ)
Q1: Gemini 4 Neon の思考レベルとは何ですか?
思考レベルは、モデルが最終回答を出す前にどれだけ内部推論を行うかを決めるものです。Neon は LOW、MEDIUM、HIGH、XHIGH の4段階を提供し、デフォルトは HIGH です。思考によって生成されるトークンは出力価格で課金されるため、このレベル設定は回答の品質とコストの両方に影響します。
Q2: Gemini 4 Neon と Carbon の思考レベルにはどんな違いがありますか?
Carbon は low、medium、high の3段階のみで、デフォルトは medium、xhigh はありません。Neon は4段階で、デフォルトは high です。両者のレベル体系は異なり、設定をそのまま流用することはできません。Hydrogen のレベルは Neon と同じで、4段階、デフォルトは high です。
Q3: なぜ Gemini 4 Neon のリクエストが HTTP 400 を返すのですか?
最も一般的な原因は、リクエストでまだ古い `thinking_budget` パラメータを使用しているか、レベルを `MINIMAL` に設定していることです。公式ドキュメントには、Neon ではこの2つの記述方法がいずれも HTTP 400 を返すと明記されています。LOW から XHIGH のいずれかのレベルに変更すれば解決します。
Q4: Gemini 4 Neon の各思考レベルは、それぞれどのようなタスクに適していますか?
– **LOW**:チケット分類、リクエストルーティング、バッチ要約など、高スループットのタスク
– **MEDIUM**:日常的なコーディング、ドキュメントに基づくQ&A
– **HIGH**:Agent の多段階ツール呼び出し、複雑な画像テキストのマルチモーダル分析
– **XHIGH**:数学的証明、科学データ分析、最も重い複数ファイルのエンジニアリング
Q5: API 経由で Gemini 4 Neon を素早く呼び出し、思考レベルを設定するには?
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーと無料テスト枠を取得
2. SDK の `base_url` を `https://api.apiyi.com/v1` に、`model` を `gemini-4-neon` に設定
3. タスクの種類に応じて思考レベルを渡す。例えば分類タスクでは `low` を使用
同じキーで Hydrogen や Carbon も呼び出せるため、それぞれのレベル範囲で効果を比較できます。
Q6: Gemini 4 Neon の思考レベル設定にはどのような制限がありますか?
– **コスト**:思考トークンは出力単価 `$15` / 100万トークンで課金され、高いレベルは出力使用量を大幅に増やします
– **パラメータ**:`thinking_budget` と `MINIMAL` はサポートされていません
– **コンテキスト**:Antigravity の 512K 上限と API の 1,048,576 は同じウィンドウではありません
– **節約幅**:公式には各レベルのトークン消費の固定比率は示されておらず、自社の業務サンプルで測定する必要があります
Q7: タスクの複雑さが不明な場合、どのレベルを選ぶべきですか?
デフォルトの HIGH を維持し、出力トークンの使用量を記録します。データが、ある種のタスクが MEDIUM や LOW でも品質が低下しないことを示したら、そのタスクに対してレベルを下げます。XHIGH をデフォルトに設定する必要は通常ありません。
Gemini 4 Neon 思考レベルの重要ポイント
- デフォルトは HIGH:パラメータを渡さない場合、Neon は多段階ツール呼び出し相当の強度で思考します
- 分類・ルーティングには LOW:高スループットのラベリング、ルーティング、要約タスクには、公式が LOW を推奨
- XHIGH は最も重いタスクに:証明、科学分析、マルチファイルにわたるエンジニアリングにのみ使用
- Carbon の設定をそのまま流用しない:Carbon は3段階のみで、デフォルトは medium、xhigh は存在しません
- 旧パラメータはエラーになる:
thinking_budgetとMINIMALは HTTP 400 を返します - 思考は出力で課金:段階が高いほど、最も高価な出力トークンが増えます
- まずテストしてから決定:APIYI apiyi.com で同じキーを使い、異なる段階の効果と使用量を比較しましょう
まとめ
Gemini 4 Neon 思考レベルの核心ポイント:
- タスクに応じて段階を選ぶ:LOW は分類、ルーティング、要約に、MEDIUM はコーディングと質疑応答に、HIGH は多段階ツールとマルチモーダルに、XHIGH は最も重いタスクだけに
- デフォルト値に注意:デフォルトが HIGH なので、高スループットタスクでは能動的に段階を下げる必要があります
- 段階はモデル間で共通ではない:Neon と Hydrogen は4段階、Carbon は3段階で、それぞれ個別に設定します
「十分なら止める」というのは、まずデフォルト段階で業務を通し、出力トークンのログを見ながらカテゴリごとに段階を下げていくという意味であり、最初からすべてのリクエストを最高段階に設定することではありません。APIYI apiyi.com の無料枠で LOW、MEDIUM、HIGH を一通り比較してから、本番環境の設定を決めることをおすすめします。
📚 参考資料
-
Google Cloud – Gemini 4 Neon モデルガイド:思考レベル、デフォルト段階、エラー説明、適用シーン
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 説明:本稿の4段階の対応関係と HTTP 400 の説明に関する主な根拠(2026-11-19)
- リンク:
-
Google AI Studio 最新モデルページ:Carbon、Hydrogen のグレードとデフォルト値
- リンク:
aistudio.google.com - 説明:異なる Gemini 4 モデルのグレード差異を確認するために使用
- リンク:
作者:APIYI 技術チーム
技術交流:Gemini 4 Neon の思考レベル設定で問題が発生した場合は、APIYI 公式サイトのトップページからお気軽にお問い合わせください。