著者注:Gemini 4 Neon の公開スコアをプログラミング・知識作業・科学の3分野に分け、項目ごとに出典を明記します。どの種類の仕事を任せるべきか、判断の材料になる内容です。
2026-11-18、Google は Gemini 4 Neon を発表しました。Sundar Pichai は発表投稿の中で、その位置づけを「複雑なソフトウェアエンジニアリング、知識作業、科学プロセスをより速く終えられる」と要約しています。同じ日に DeepMind がモデルカードを公開し、Artificial Analysis も第三者測定の記事とモデルページを公開しました。公開データが一度にいくつも出てきた形です。
問題は、これらの数値の測定基準がそれぞれ違う点です。Google のブログは公式の自己申告、モデルカードの比較表には Claude Opus 5.5 と GPT-6.2 Sol が並んでいますが、評価の注記には「Gemini 以外の結果は既定で各社の自己申告によるもの」と書かれています。第三者測定なのは Artificial Analysis だけです。本記事では 2026-11-19 をデータ確認日とし、項目ごとに出典ラベルを残し、食い違う数値は両方並記して平均は取りません。
核心的な価値:この記事を読み終えると、タスクの種類ごとに見られる表が手に入ります。Gemini 4 Neon がプログラミング・資料読解・科学の3分野のうち、どの項目で公式が1位と主張しているのか、どの項目でモデルカード上は競合のほうが上なのか、どの項目で第三者がわずか1点のリードしか示していないのか、が分かります。
Gemini 4 Neon の核心ポイント:まず入口を見て、それから3つのブロックに分解
総合スコアは、多くの人が最初に目にする数字です。Artificial Analysis の記事によると、Gemini 4 Neon は xhigh 思考レベルの知能スコアが61で、総合3位。上位は GPT-6.2 Astra(max)と Claude Fable 5.2(max)です。Google ブログ(公式の自己申告)も61と3位を示しており、「より大きく、より遅いモデルに後れを取っている」と一言添えています。モデルカードの AA Index v5.0.1 の欄も同じく61で、比較対象の Opus 5.5 は59、Sol は57です。
この61は3つのソースで一致していますが、それはあくまで入口にすぎません。総合スコアはコーディング、資料読解、科学をまとめたもので、実際に納品する仕事は通常そのうちの1つにしか属しません。下表ではまず3種類の性質ごとにソースを整理し、以降の各節でブロックごとに詳しく見ていきます。
| ソース | 性質 | 本記事で何を見るか |
|---|---|---|
| Google ブログ | 公式の自己申告 | Google が1位と自称する項目と各スコア |
| DeepMind モデルカード | 公式の集約。Gemini 以外の結果は多くが各社の自己申告 | Neon、Opus 5.5、Sol の3列を項目ごとに比較 |
| Artificial Analysis の記事 | 第三者による測定 | Coding Agent Index、GDP.pdf、MKA など |
| Artificial Analysis のモデルページ | 第三者による測定、思考レベル別に記載 | 4段階の思考レベルにおける知能スコアの違い |
Gemini 4 Neon のファミリー内での位置づけ
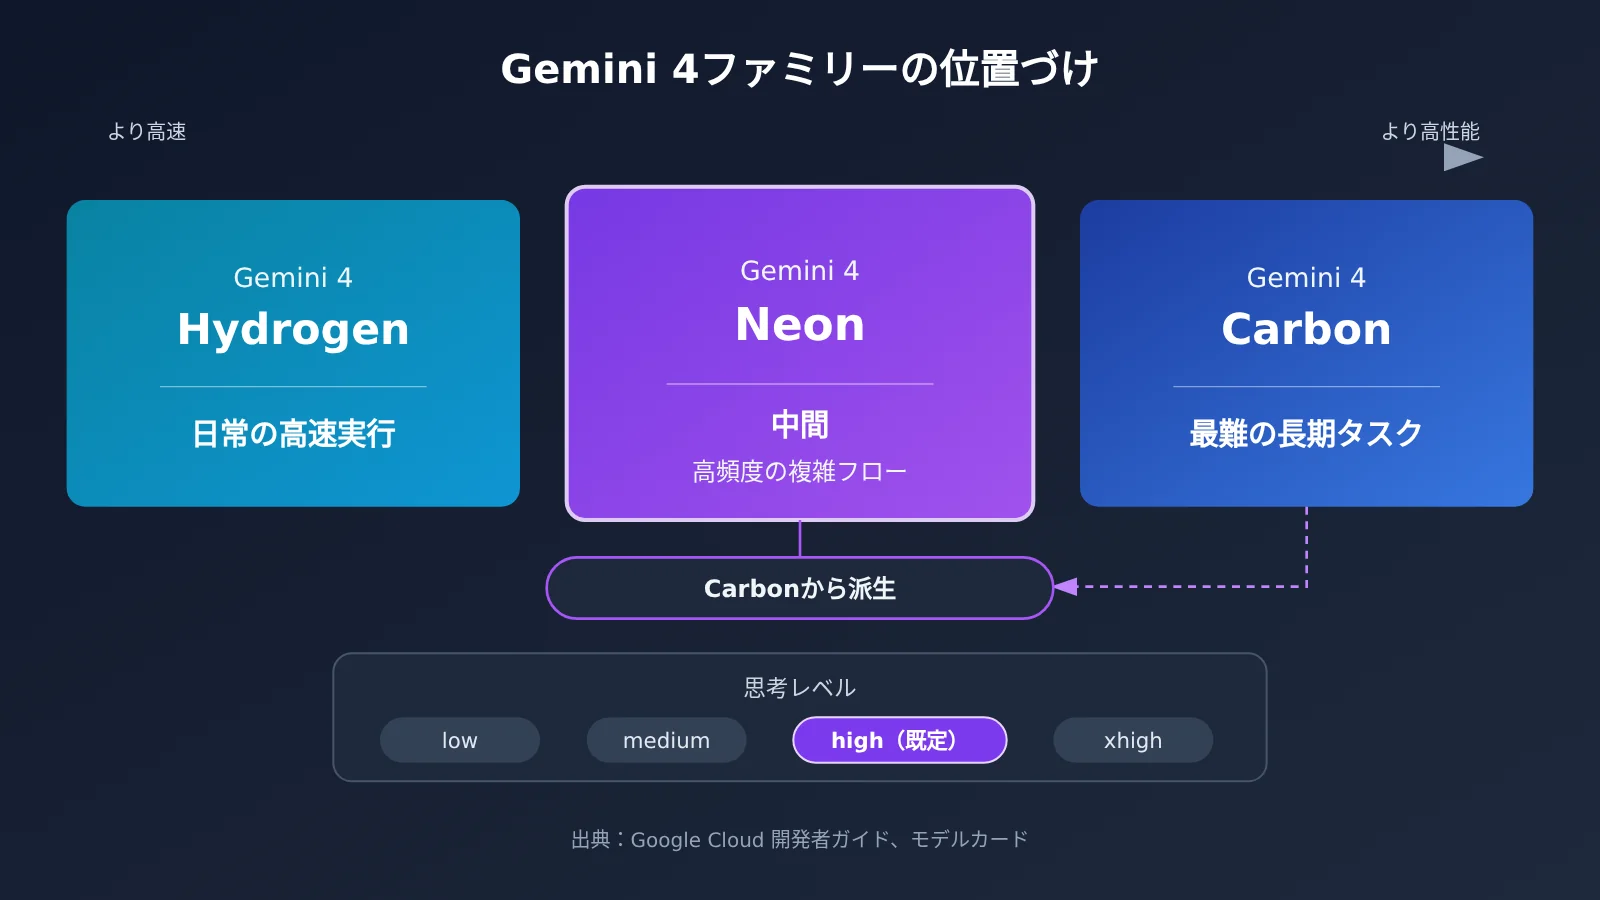
モデルカードには、Gemini 4 Neon が Gemini 4 Carbon をベースに改変されたもので、知識カットオフは2026年3月、入力はテキスト・画像・音声・動画に対応し、統合ウィンドウは最大100万トークンと記載されています。Google Cloud の開発者ガイドでは、Hydrogen(日常的な高速ループ)と Carbon(複雑で長距離の処理)の間に位置づけられており、公式ブログでも高頻度の複雑なフロー向けだと説明されています。
この位置づけを理解しておくと、後のスコアを読みやすくなります。Neon の比較対象はソースによって異なります。モデルカードには Opus 5.5 と Sol の2列しかなく、Fable 5.2、Astra、Carbon はありません。一方、Artificial Analysis は主に Carbon、Fable、Opus と比較しています。項目別の比較では、本記事は他のセルを借りて穴埋めすることはしません。
プログラミングは Google のブログで最も多くの紙幅を割いている分野です。公式の自己申告によれば、Gemini 4 Neon は Artificial Analysis Coding Agent Index で 58.6 を記録し、総合 1 位となっています。Artificial Analysis の記事が示す数値は 59 で、測定条件は Antigravity CLI 上の Neon xhigh です。58.6 と 59 は 2 つの情報源に由来するため、本記事では両方を掲載します。
サードパーティ側のリード幅は別途見る必要があります。Artificial Analysis の記事では、Claude Code 上の Fable xhigh と Opus 5.5 max はいずれも 58、Carbon high は 55 です。つまり、Neon はこれら 2 つの Claude モデルに対して 1 ポイントのリードとなります。
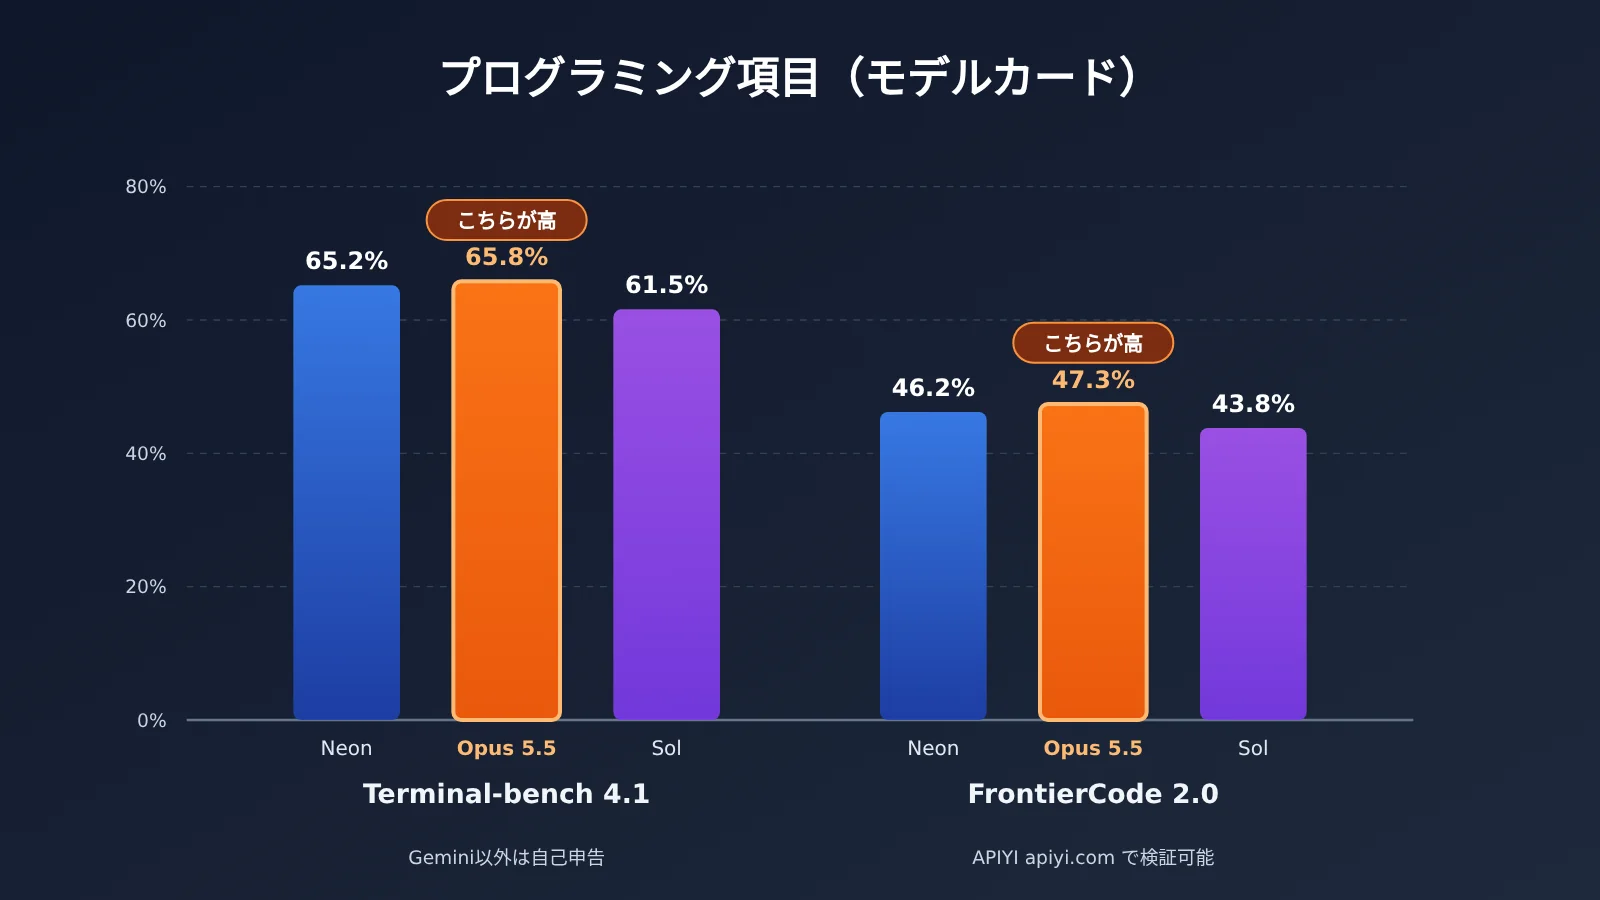
モデルカードの内訳はさらに細かく、そのうち 2 項目で Opus 5.5 の方が高くなっています。
| プログラミング項目(モデルカード) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | なし |
| Terminal-bench 4.1(チート調整後) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep ベンダー harness | 39.0% | 10.1% | 8.3% |
| SWE-sweep mini-SWE harness | 12.8% | 3.6% | 11.6% |
Gemini 4 Neon のプログラミングスコアの読み方
Terminal-bench 4.1 では Opus 5.5 が 65.8%、Neon が 65.2% です。FrontierCode 2.0 では Opus 5.5 が 47.3%、Neon が 46.2% です。どちらも差は 1 パーセントポイント前後ですが、方向としては Opus がわずかに上です。公式ブログでは FrontierCode 2.0 の 46.2% はデフォルトの high 設定と注記されています。
SWE-sweep の 2 つの数字は最も誤読されやすい部分です。12.8% は mini-SWE harness での結果、39.0% は Google Antigravity(ベンダー harness)での結果です。公式ブログは両者の差を harness によるアンロックと表現しており、これはツールチェーンの効果を反映したもので、モデル自体が 3 倍差あると読むべきではありません。また、mini-SWE harness では Sol が 11.6% で、Neon の 12.8% にかなり近い点にも注意が必要です。
Gemini 4 Neon のナレッジワーク:多くで首位、Chartography では Sol が上回る
ナレッジワークの領域では、公式ブログに「第1位」が数多く並んでいます。Legal Research Bench と Tax Agent Bench はいずれも第1位とされていますが、ブログにはこの2項目のパーセンテージが示されていません。Surge における金融、会計、スプレッドシートモデリング、複雑な制約タスクも大半で第1位とされていますが、こちらも項目別のスコアは示されていません。これらは公式の自己申告による順位として扱い、本記事では数値を補いません。
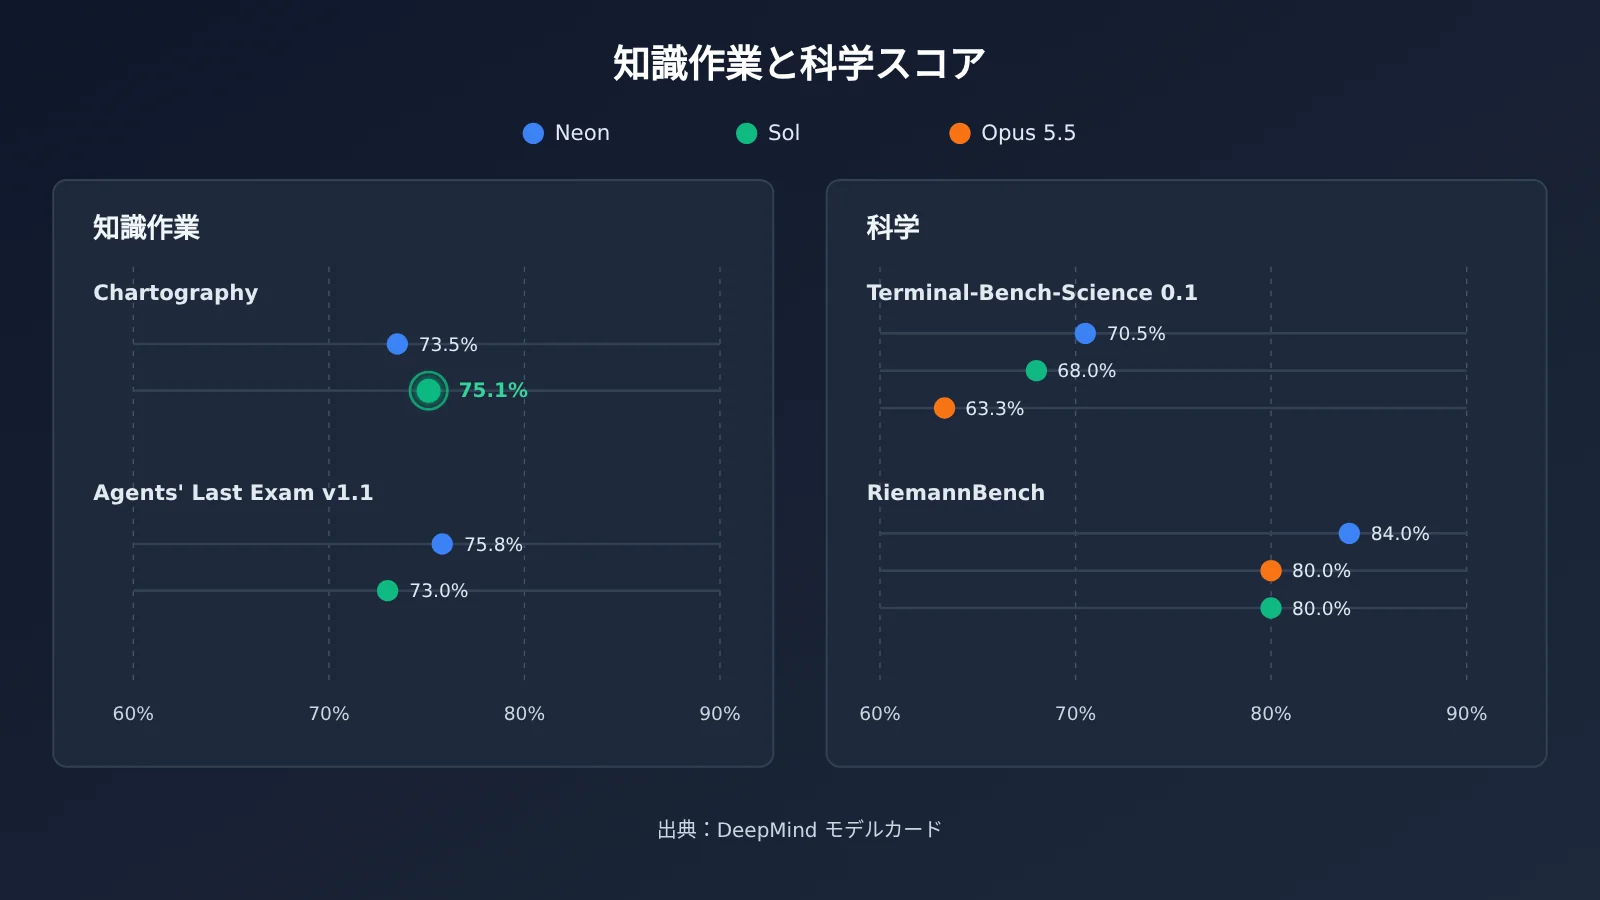
スコアが示されている項目はモデルカードと照合できます。Zapier AutomationBench は公式ブログで第1位、56.3%、Andon Labs Vending-Bench 2 は第1位、16843ドルです。Chartography はこの領域で唯一 Sol が上回る項目です。Sol 75.1%、Neon 73.5% です。
第三者による測定はさらに詳細を示しています。Artificial Analysis の記事によると、GDP.pdf では Neon high が 33.4%、Neon xhigh は逆に 28.0%、Carbon high が 28.4% で、思考レベルを上げても必ずしも高いスコアになるわけではないことを示しています。AA-Briefcase では Neon xhigh の総合スコアが 1700 Elo、プレゼンテーション品質が 1771 Elo で、Claude Sonnet 5.5 max の 1726 を上回っています。MKA については、Artificial Analysis の記事では Neon 56% と書かれており、Fable max の 57% に近く、Carbon より 2ポイント高くなっています。モデルカードには 56.5% と記載されており、2つの数値はそれぞれそのまま残します。
Gemini 4 Neon の科学能力:3項目で公式に best in class と主張
科学は3つの領域のうち、公式の表現が最も強い領域です。Google のブログは Terminal-Bench Science 70.5%、RiemannBench 84.0%、HLE-Diamond 71.3% の3項目を best in class としていますが、これは公式の自己申告です。モデルカードの比較表もこれと一致し、3項目とも Neon は Opus 5.5 と Sol を上回っています。ただし、比較列も各社の自己申告をまとめたものです。
| 知識・科学項目(モデルカード) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks(256k–1M、BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
GraphWalks は 256k から 1M の長コンテキスト区間で 95.2% を記録し、Opus 5.5 の 66.8% と大きく差を開いています。超長文の資料を読み込むシーンでは特に注目すべきでしょう。Terminal-Bench-Science では Sol が 68.0% で、Neon の 70.5% とは 2.5 ポイント差です。科学3項目のうち、最も差が小さい項目です。
Gemini 4 Neon をタスク別に見る:全体像を一枚の表で
三つの証拠をまとめ、「公式が第1位と主張」「モデルカードでは競合が上」「サードパーティの差はわずか1点」という三つの状況別に整理すると、下のタスク別の表が得られます。これは誰が総合的に最強かを答えるものではなく、各タスク類型のスコアがどの証拠に立っているかを示すものです。
| タスク類型 | 公式の自己申告で第1位 | モデルカードで競合が上 | サードパーティの差は1点 |
|---|---|---|---|
| プログラミング | Coding Agent Index 58.6 で総合第1位 | Terminal-bench 4.1、FrontierCode 2.0:Opus 5.5 が上 | Coding Agent Index 59 対 Fable xhigh、Opus 5.5 max の 58 |
| ナレッジワーク | Legal Research Bench、Tax Agent Bench、AutomationBench、Vending-Bench 2 | Chartography:Sol が上 | MKA 56% 対 Fable max 57%(Neon は1点低い) |
| 科学 | Terminal-Bench Science、RiemannBench、HLE-Diamond | なし | サードパーティの科学スコアを単独で示す項目はなし |
| 総合エントリー | Vals Index 第2位(70.9%) | なし | AA 知能スコア 61、Carbon high より1点高い |
Gemini 4 Neon の長所と短所の分析
強み
- 科学の3項目で一貫してリード:公式の自己申告とモデルカードの双方で、Terminal-Bench Science、RiemannBench、HLE-Diamond が2つの比較モデルを上回っていることを示しています。
- 長文コンテキストの読み取りが強力:モデルカードの GraphWalks では 256k〜1M 区間の BFS F1 が 95.2% で、100万トークンの統一ウィンドウに対応しています。
- ツールチェーンの増幅効果が顕著:SWE-sweep はベンダーのハーネス下で 39.0% を記録し、Antigravity のようなエージェント環境と組み合わせると効果が大きいことを示しています。
- マルチモーダル入力が揃っている:モデルカードにはテキスト、画像、音声、動画入力のサポートが明記されています。一方、Artificial Analysis のモデルページでは、Opus 5.5 の入力はテキストと画像のみです。
制約
- プログラミングは項目ごとに第1位ではない:Terminal-bench 4.1 と FrontierCode 2.0 では Opus 5.5 がわずかに上で、純粋なターミナルや先端コードのタスクでは両方をテストすることをおすすめします。
- チャート理解では上回る競合がいる:Chartography では Sol が上で、チャートが密集するレポートタスクでは Sol を比較対象に含められます。
- 高い設定が必ずしも高スコアを保証しない:Artificial Analysis の記事では GDP.pdf の xhigh が high より低く、思考設定はタスクに応じて調整する必要があります。
- パラメータ制約が比較的厳しい:開発者ガイドには、
thinking_budgetまたはMINIMALを渡すとHTTP 400が返され、明示的なコンテキストキャッシュはサポートされず、4096 トークン以上の共有プレフィックスによる暗黙的キャッシュのみが使われると書かれています。
価格と速度については、本文では一文だけ触れておきます。単一タスクのコストと Carbon の比較には、Google の自己申告で32%低い、Artificial Analysis の記事で約17%少ないなど、異なる基準が存在します。詳しくは価格の専用記事に譲ります。各思考設定の所要時間と出力速度については、速度の専用記事に譲ります。
Gemini 4 Neon クイックスタート:まずタスクを決め、次に思考レベルを決める
導入の順序は、次の3ステップがおすすめです。まず上記の一覧表でタスク種別を選び、次に思考レベルを決め、最後に APIYI のモデル一覧表で、提供開始済みの Gemini 4 ファミリーモデルが十分かどうかを確認します。
- タスク種別を選ぶ:科学推論や長文資料の読解では、Neon の強みを優先的に検討します。ターミナルプログラミングや図表理解では、Opus 5.5 や Sol も候補に加えます。
- 思考レベルを選ぶ:開発者ガイドには、Neon の思考レベルが
low、medium、high、xhighの4段階のみで、デフォルトはhighと記載されています。Artificial Analysis のモデルページでは、4段階の知能スコアがそれぞれ 44、55、60、61 となっており、highからxhighまではわずか1点差です。GDP.pdf ではhighのほうがむしろ高くなっているため、多くのタスクはデフォルトのレベルから始めれば十分です。 - 利用可能なモデルを確認する:オーケストレーション系のタスクでは、開発者ガイドの方法を参考に、メイン制御を強力なモデルに任せ、高速なサブタスクを
gemini-4-hydrogenに担当させます。最も難しい長期的なタスクにはgemini-4-carbonを検討します。
呼び出し先については、OpenAI 互換インターフェースでは base_url を https://api.apiyi.com/v1 に設定します。Gemini ネイティブインターフェースでは https://api.apiyi.com を使用し、v1beta バージョンを選択します。APIキーは環境変数から読み取ります(例:APIYI_API_KEY)。APIキーを平文でコードに書き込まないでください。呼び出し時は model に gemini-4-carbon または gemini-4-hydrogen を指定すればOKです。両者は APIYI のモデル一覧表では、エンドポイントがいずれも chat と gemini です。
下表は、2026-11-16 更新の APIYI モデル一覧表(docs.apiyi.com/models.md)と、2026-11-19 時点で照会した価格API(api.apiyi.com/api/pricing、全285モデル)から对照できるモデルです。単位は100万 token あたりの米ドルです。
| モデル ID | 入力 | キャッシュ読み取り | 出力 | 利用可能なプラットフォーム |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | APIYI モデル一覧、価格API |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | APIYI モデル一覧、価格API |
claude-opus-5-5 |
4 | 0.2 | 20 | APIYI モデル一覧、価格API |
gpt-6.2-sol |
2(272000 token を超える入力は 3) | 0.1 | 10(価格APIの上位料金は約 11.25) | APIYI モデル一覧、価格API |
gemini-4-carbon の 2/10 は APIYI の現在の販売価格で、Google の 2026-11-30 までの導入価格に対応しています。Gemini 4 Neon の Google AI Studio 価格ページでの表示価格は、100万 token あたり入力 3.00 米ドル、出力 15.00 米ドルで、無料枠はありません。APIYI のモデル一覧表と価格APIのどちらにもまだ掲載されていません。現在はまだ提供開始していませんが、このモデルはできるだけ早く提供開始する予定です。モデル名と価格はプラットフォームのモデル一覧を基準とします。
🚀 導入のヒント:Neon の提供開始前に、APIYI(apiyi.com)経由で同じ APIキーを使い、
gemini-4-carbon、claude-opus-5-5、gpt-6.2-solをそれぞれ呼び出してみましょう。自分のプログラミングやレポート作成タスクを一通り実行して、どの種類のタスクに Neon 級の能力が必要かを先に把握してください。
よくある質問(FAQ)
Q1:Gemini 4 Neon はどのような位置づけのモデル?
Google が 2026-11-18 にリリースした Gemini 4 ファミリーの中間モデルで、Carbon をベースにしています。開発者ガイドでは Hydrogen と Carbon の間に位置づけられ、公式ブログでは高頻度な複雑フロー向けと説明されています。モデル ID は `gemini-4-neon` です。
Q2:総合スコア 61 は何位?
Artificial Analysis の記事では xhigh で 61 点、総合 3 位で、上位は GPT-6.2 Astra(max)と Claude Fable 5.2(max)です。Google のブログとモデルカードの 61 もこれと一致しますが、総合スコアはあくまで入口として見るもので、項目別の評価はタスクに応じて確認する必要があります。
Q3:Coding Agent Index は 58.6 なのか 59 なのか?
どちらも正しく、出典が異なります。58.6 は Google ブログ(公式の自己申告)の数値、59 は Artificial Analysis の記事が Antigravity CLI 上で Neon の xhigh を測定した数値です。両者を合成したり平均したりするべきではありません。
Q4:SWE-sweep の 12.8% と 39.0% がこれほど違うのは何を意味する?
これは 2 つの harness の結果です。12.8% は mini-SWE harness、39.0% は Google Antigravity によるものです。公式ブログはこの差を harness による性能の引き出し方の違いと説明しており、モデル選定では実際に使う agent 環境に注目すべきです。
Q5:どの項目で競合モデルが Gemini 4 Neon を上回っている?
モデルカードでは Terminal-bench 4.1 と FrontierCode 2.0 は Claude Opus 5.5 がわずかに上、Chartography は GPT-6.2 Sol がわずかに上です。Artificial Analysis の記事では MKA は Fable max の 57% が Neon の 56% を上回っています。
Q6:現時点で API から Gemini 4 Neon を呼び出せる?
Google 側では AI Studio の Gemini API などのチャネルで提供が始まっています。APIYI(apiyi.com)の一覧表と価格インターフェースには現時点で `gemini-4-neon` がなく、まだ上架していません。このモデルはできるだけ早く上架いたします。モデル名と価格はプラットフォームのモデル一覧を基準にしてください。
Q7:上架前に代替となるモデルでテストするには?
APIYI(apiyi.com)では OpenAI 互換のエンドポイント `https://api.apiyi.com/v1` を使って `gemini-4-carbon` または `gemini-4-hydrogen` を呼び出せます。同じ APIキーのまま `claude-opus-5-5`、`gpt-6.2-sol` に切り替えて横断比較も可能です。新規ユーザーには無料のテスト枠があります。
Q8:Gemini 4 Neon にはどのような呼び出し制限がある?
開発者ガイドには次のように記載されています。思考レベルは `low` から `xhigh` までの 4 段階のみで、`thinking_budget` や `MINIMAL` を渡すと `HTTP 400` が返ります。明示的なコンテキストキャッシュはサポートされません。上限は入出力を合わせて 1048576 token で、1 回あたりのデフォルト最大出力は 65536 です。
Gemini 4 Neon の主なポイント
- 総合スコアはあくまで入口:AA 知能スコアは61で3位、この結果は3つの情報源で一致しています。それでもモデル選定はタスクごとに分けて考えるべきです。
- コーディングでは2項目で追い抜かれ:モデルカードでは Terminal-bench 4.1 と FrontierCode 2.0 で Opus 5.5 がわずかに上回っています。
- コーディングは第三者指標で1点リード:Coding Agent Index は59で、Fable xhigh と Opus 5.5 max の58を上回っています。
- ナレッジワークでは多くでリード:Chartography は Sol の方が高く、GraphWalks では長文コンテキストの優位性が最も顕著です。
- 科学分野の3項目は公式に best in class:モデルカードとの比較でも同様にリードしていますが、競合のデータは各社の自己申告です。
- 思考レベルは high から:high と xhigh の知能スコア差はわずか1で、GDP.pdf では high の方が高くなっています。
- まずは提供済みモデルで試す:Neon の提供開始前は、APIYI apiyi.com で Carbon や Hydrogen を使って先にタスクを実行できます。
まとめ
Gemini 4 Neon の強さは、3つの領域に分けて見るとずっと分かりやすくなります。
- コーディング:公式の自己申告では Coding Agent Index が1位、第三者指標では1点だけリード、モデルカードでは Opus 5.5 が2項目でわずかに上回っています。
- ナレッジワーク:AutomationBench や長文コンテキストの GraphWalks など多くでリードし、Chartography では Sol の方が高いです。
- 科学:3項目で公式に best in class とされ、モデルカードとの比較でも一貫してリード。3領域の中では証拠が最も揃っている領域です。
まず自分のタスクをこのうちのどれか1つに分類し、本記事の総合表と照らして Neon が必要か判断するのがおすすめです。提供開始前は APIYI apiyi.com の統一インターフェースから Gemini 4 Carbon、Hydrogen、Opus、Sol を呼び出して比較し、gemini-4-neon が公開されたらモデル ID を置き換えるだけで再テストできます。
📚 参考資料
-
Google ブログ – Introducing Gemini 4 Neon:公式発表記事と自己申告スコア
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 説明: 公式が自己申告したランキング、コーディングとサイエンスのスコア
- リンク:
-
DeepMind モデルカード – Gemini 4 Neon:3列の比較表とモデル仕様
- リンク:
deepmind.google/models/model-cards/gemini-4-neon/ - 説明: Neon、Opus 5.5、Sol の項目別スコア。Gemini 以外の結果は各社の自己申告によるもの
- リンク:
-
Google Cloud 開発者ガイド – Gemini 4 Neon:パラメータと呼び出し制約
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 説明: 思考レベル、トークン上限、キャッシュ、エラーコード
- リンク:
-
Artificial Analysis の記事 – Gemini 4 Neon intelligence gain:サードパーティによる測定
- リンク:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 説明: Coding Agent Index 59、GDP.pdf、MKA など
- リンク:
-
Artificial Analysis モデルページ – Gemini 4 Neon:思考レベル別の指数
- リンク:
artificialanalysis.ai/models/gemini-4-neon - 説明: 4段階の知能スコア比較
- リンク:
-
APIYI モデル一覧:提供中のモデルと価格
- リンク:
docs.apiyi.com/models.md - 説明: モデルと価格はプラットフォームのモデル一覧を基準とします
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI サイトのトップページからお気軽にお問い合わせください。その他の資料は docs.apiyi.com のドキュメントセンターをご覧ください。