Catatan penulis: Skor publik Gemini 4 Neon saya pecah menjadi tiga bagian—pemrograman, pekerjaan pengetahuan, dan sains—dengan sumber yang ditandai per item, supaya Anda bisa menilai jenis pekerjaan apa yang cocok diserahkan ke model ini.
Pada 2026-11-18, Google merilis Gemini 4 Neon. Dalam postingan peluncurannya, Sundar Pichai merangkum posisi model ini sebagai “menyelesaikan lebih cepat” untuk rekayasa perangkat lunak kompleks, pekerjaan pengetahuan, dan proses sains. Di hari yang sama, DeepMind merilis kartu model, dan Artificial Analysis juga menerbitkan artikel pengukuran pihak ketiga serta halaman model. Data publik pun langsung bertambah jadi beberapa set.
Masalahnya, set-set angka itu punya standar pengukuran yang berbeda. Blog Google adalah laporan sendiri resmi; tabel perbandingan di kartu model memang mencantumkan Claude Opus 5.5 dan GPT-6.2 Sol, tapi catatan evaluasinya menyebut bahwa hasil non-Gemini secara default berasal dari laporan sendiri masing-masing vendor. Hanya Artificial Analysis yang merupakan pengukuran pihak ketiga. Artikel ini memakai 2026-11-19 sebagai tanggal verifikasi data, mempertahankan label sumber di setiap item, dan menuliskan angka dari dua set yang tidak konsisten secara berdampingan—tanpa dirata-ratakan.
Nilai inti: Setelah membaca artikel ini, Anda akan mendapatkan tabel berdasarkan jenis tugas: di tiga bidang pemrograman, membaca dokumen, dan sains, Anda bisa melihat item mana yang menurut pihak resmi berada di peringkat pertama, item mana yang pesaingnya lebih tinggi di kartu model, dan item mana yang menurut pihak ketiga hanya unggul 1 poin.
Poin inti Gemini 4 Neon: mulai dari pintu masuk, lalu bedah tiga bagian
Skor keseluruhan adalah angka yang pertama kali dilihat kebanyakan orang. Artikel Artificial Analysis menunjukkan bahwa Gemini 4 Neon pada tingkat penalaran xhigh memiliki skor kecerdasan 61, peringkat keseluruhan ke-3, di atasnya ada GPT-6.2 Astra (max) dan Claude Fable 5.2 (max). Blog Google (klaim resmi sendiri) juga memberikan 61 dan peringkat ke-3, serta menambahkan kalimat “tertinggal dari model yang lebih besar dan lebih lambat”. Kolom AA Index v5.0.1 di kartu model juga 61; sebagai pembanding, Opus 5.5 bernilai 59 dan Sol 57.
Angka 61 ini konsisten di tiga sumber, tetapi itu hanyalah pintu masuk. Skor keseluruhan mencampur pemrograman, membaca materi, dan sains, sedangkan hasil kerja yang harus Anda serahkan biasanya hanya termasuk salah satu bagian. Tabel berikut menjelaskan sifat ketiga jenis sumber, lalu bagian-bagian selanjutnya akan membedahnya satu per satu.
| Sumber | Sifat | Yang dilihat artikel ini |
|---|---|---|
| Blog Google | Klaim resmi sendiri | Item mana yang Google klaim sebagai peringkat pertama, dan skor tiap item |
| Kartu model DeepMind | Ringkasan resmi; hasil non-Gemini sebagian besar merupakan klaim masing-masing penyedia | Perbandingan baris per baris tiga kolom Neon, Opus 5.5, dan Sol |
| Artikel Artificial Analysis | Pengukuran pihak ketiga | Coding Agent Index, GDP.pdf, MKA, dll. |
| Halaman model Artificial Analysis | Pengukuran pihak ketiga, dipecah menurut tingkat penalaran | Perbedaan skor kecerdasan pada empat tingkat penalaran |
Posisi Gemini 4 Neon dalam keluarga
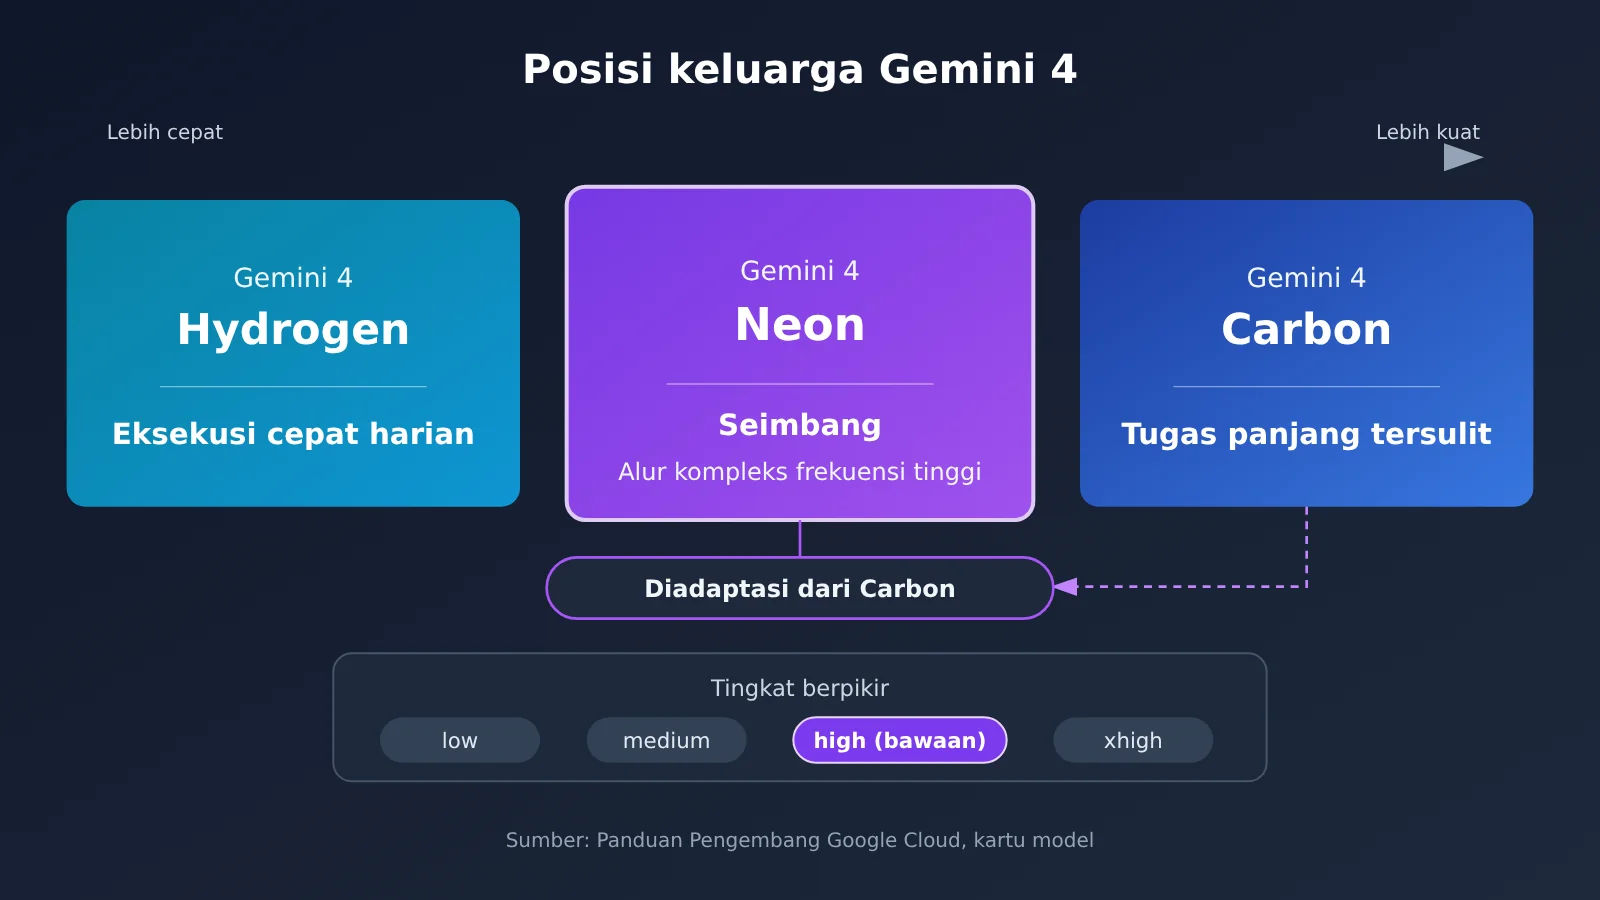
Kartu model menyatakan bahwa Gemini 4 Neon diadaptasi dari Gemini 4 Carbon, batas pengetahuan Maret 2026, input mendukung teks, gambar, audio, dan video, dengan jendela konteks terpadu maksimum 1 juta token. Panduan developer Google Cloud menempatkannya di antara Hydrogen (siklus cepat harian) dan Carbon (tugas panjang kompleks); blog resmi juga menyebutnya menyasar alur kompleks berfrekuensi tinggi.
Memahami posisi ini membantu membaca skor di bagian berikutnya. Objek pembanding Neon berbeda di tiap sumber: kartu model hanya memiliki dua kolom Opus 5.5 dan Sol, tanpa Fable 5.2, Astra, dan Carbon; Artificial Analysis terutama membandingkannya dengan Carbon, Fable, dan Opus. Saat membandingkan per item, artikel ini tidak akan meminjam sel lain untuk mengisi kekosongan.
Kemampuan Pemrograman Gemini 4 Neon: Unggul di Dua Hal, Dua Hal Lain Sedikit Disalip Opus
Pemrograman adalah bagian yang paling banyak dibahas dalam blog Google. Menurut laporan resmi Google sendiri, Gemini 4 Neon memperoleh 58.6 di Artificial Analysis Coding Agent Index, peringkat 1 secara keseluruhan. Artikel Artificial Analysis memberikan angka 59, dengan kondisi pengukuran Neon xhigh di Antigravity CLI. Angka 58.6 dan 59 berasal dari dua sumber; artikel ini mempertahankan keduanya.
Besaran keunggulan menurut pihak ketiga perlu dilihat secara terpisah. Dalam artikel Artificial Analysis, Fable xhigh di Claude Code dan Opus 5.5 max keduanya memperoleh 58, sedangkan Carbon high 55. Artinya, keunggulan Neon atas kedua model Claude tersebut adalah 1 poin.
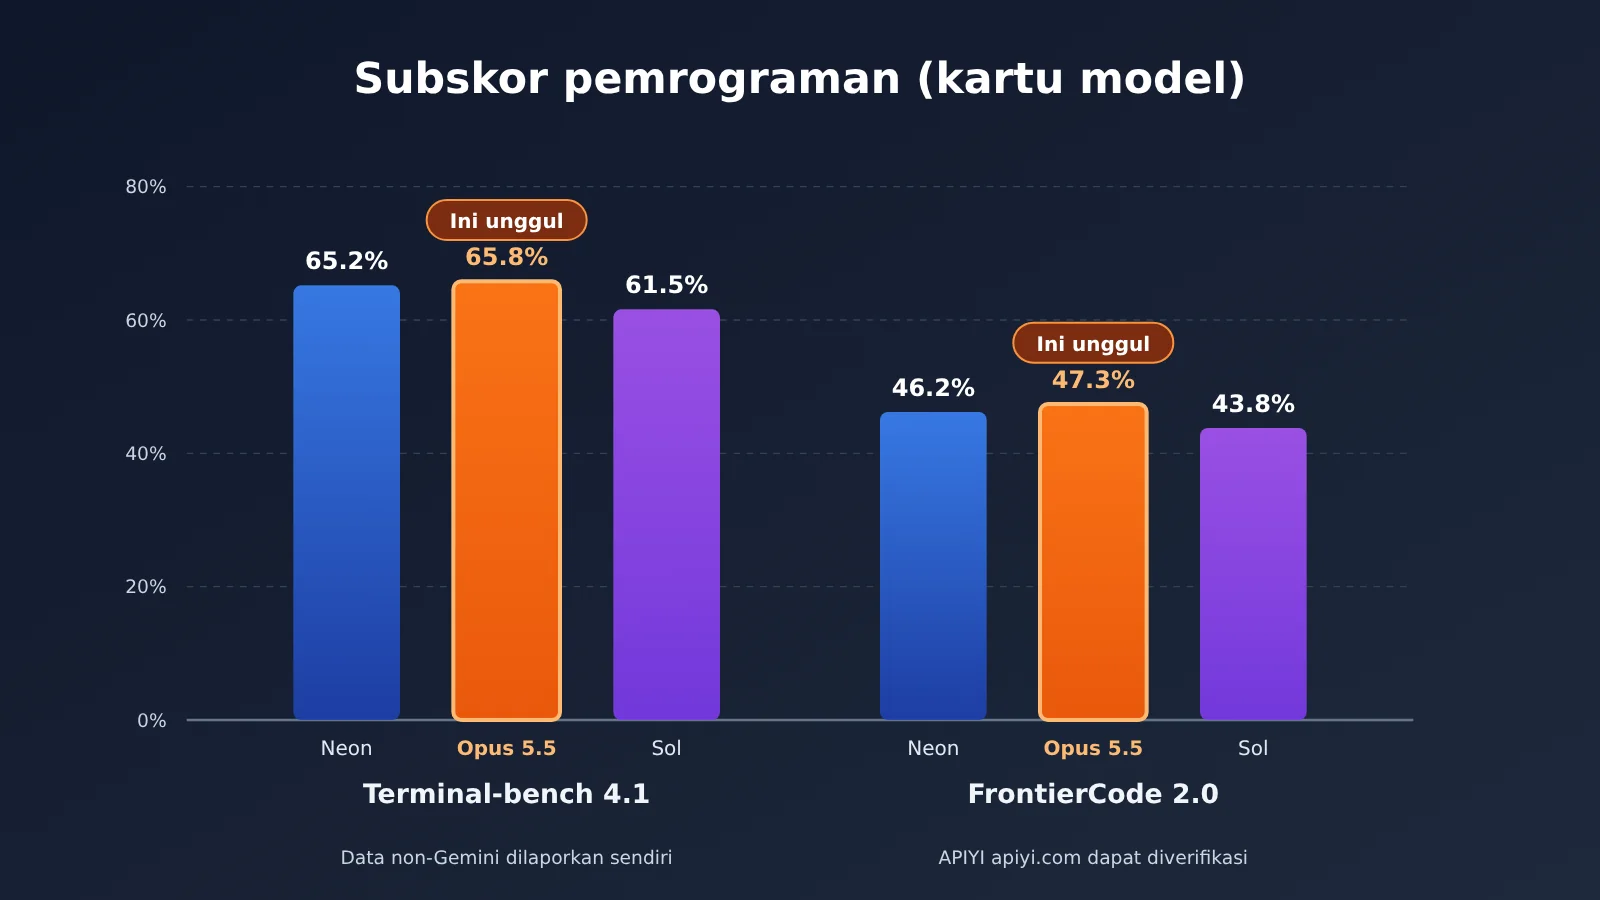
Rincian per item di kartu model lebih terperinci; dua di antaranya justru lebih tinggi pada Opus 5.5.
| Item pemrograman (kartu model) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Tidak ada |
| Terminal-bench 4.1 (setelah koreksi kecurangan) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep harness vendor | 39.0% | 10.1% | 8.3% |
| SWE-sweep harness mini-SWE | 12.8% | 3.6% | 11.6% |
Cara Membaca Skor Pemrograman Gemini 4 Neon
Pada Terminal-bench 4.1, Opus 5.5 memperoleh 65.8% dan Neon 65.2%; pada FrontierCode 2.0, Opus 5.5 memperoleh 47.3% dan Neon 46.2%. Selisih kedua item sekitar satu poin persentase, tetapi arahnya Opus sedikit lebih tinggi. Di blog resmi, angka 46.2% untuk FrontierCode 2.0 ditandai sebagai pengaturan high default.
Dua angka SWE-sweep paling mudah salah dibaca. Angka 12.8% adalah hasil dengan harness mini-SWE, sedangkan 39.0% adalah hasil di Google Antigravity (harness vendor). Blog resmi menggambarkan selisih keduanya sebagai unlock yang diberikan oleh harness; ini mencerminkan peran toolchain, bukan berarti kemampuan model itu sendiri berbeda tiga kali lipat. Perlu diperhatikan juga bahwa dengan harness mini-SWE, Sol memperoleh 11.6%, cukup dekat dengan 12.8% milik Neon.
Gemini 4 Neon untuk pekerjaan pengetahuan: unggul di sebagian besar item, Chartography justru lebih tinggi pada Sol
Di bagian pekerjaan pengetahuan, blog resmi mencantumkan banyak “juara 1”. Legal Research Bench dan Tax Agent Bench keduanya disebut juara 1, tetapi blog tidak memberikan persentase untuk kedua item ini; tugas keuangan, akuntansi, pemodelan spreadsheet, dan batasan kompleks di Surge juga disebut mayoritas juara 1, dan juga tidak memberikan skor per item. Ini hanya bisa dicatat sebagai peringkat yang dilaporkan sendiri oleh pihak resmi; artikel ini tidak menambahkan angka.
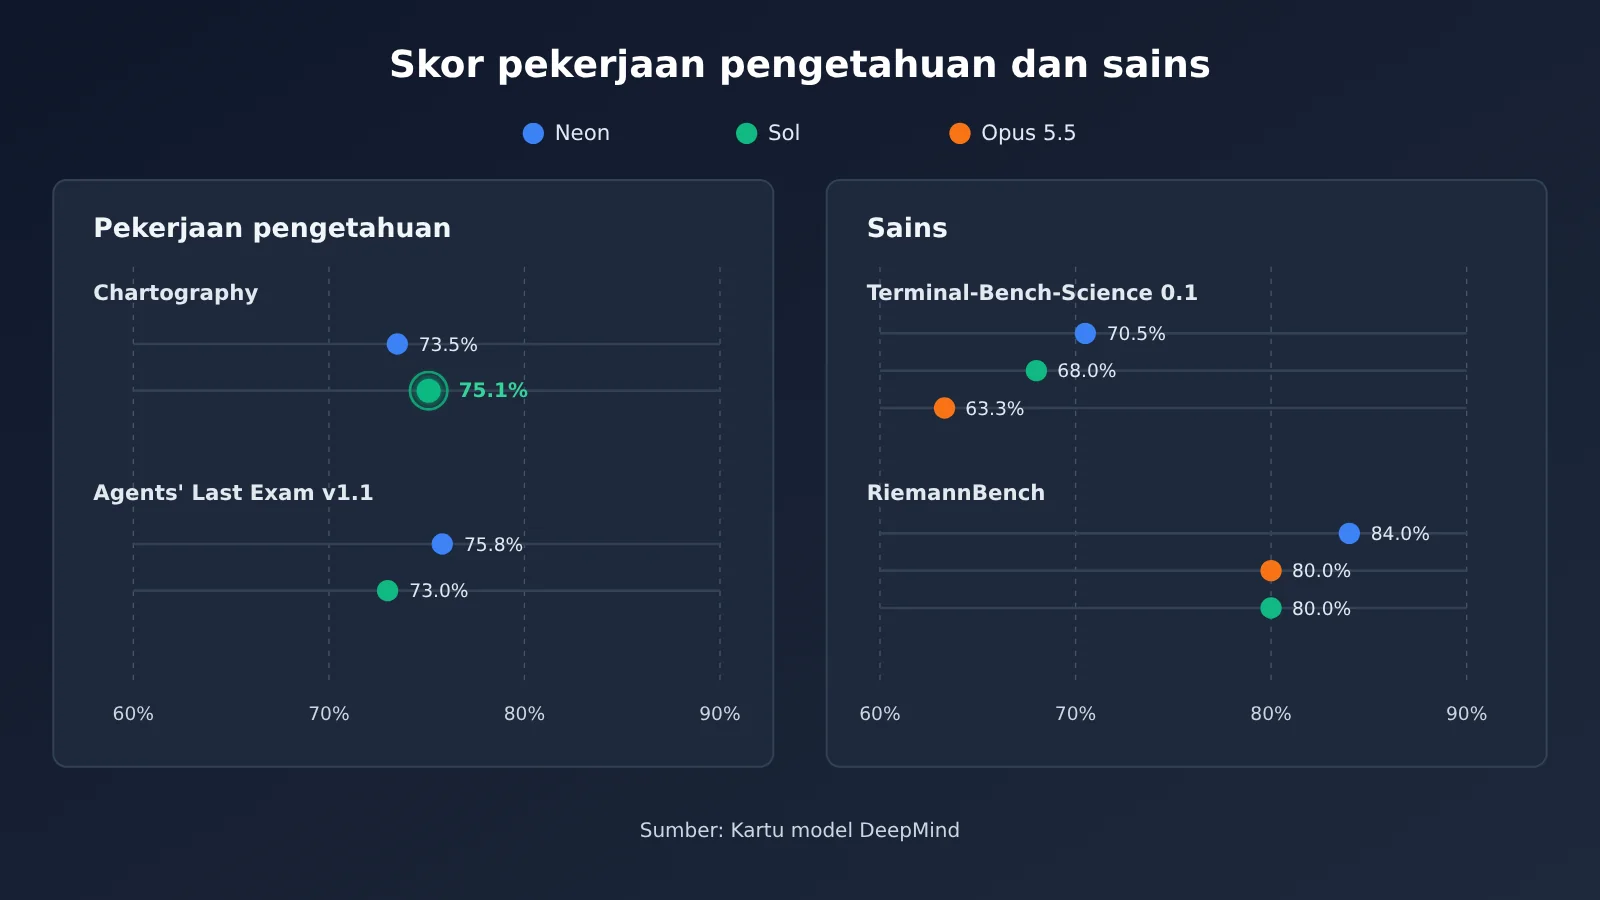
Item yang memiliki skor dapat dibandingkan dengan kartu model. Zapier AutomationBench di blog resmi adalah juara 1 dengan 56.3%, Andon Labs Vending-Bench 2 juara 1 dengan 16843 dolar. Chartography adalah satu-satunya sub-item di bagian ini yang lebih tinggi pada Sol: Sol 75.1%, Neon 73.5%.
Pengukuran pihak ketiga memberikan lebih banyak detail. Artikel Artificial Analysis menunjukkan bahwa pada GDP.pdf, Neon high adalah 33.4%, Neon xhigh justru 28.0%, Carbon high 28.4%, yang menunjukkan bahwa menaikkan tingkat pemikiran tidak selalu menghasilkan skor lebih tinggi. Pada AA-Briefcase, skor total Neon xhigh adalah 1700 Elo, kualitas penyajian 1771 Elo, lebih tinggi dari 1726 milik Claude Sonnet 5.5 max. Untuk item MKA, artikel Artificial Analysis menulis Neon 56%, mendekati 57% milik Fable max, 2 poin lebih tinggi dari Carbon; kartu model menulis 56.5%, kedua angka dipertahankan masing-masing.
Kemampuan sains Gemini 4 Neon: tiga item resmi disebut best in class
Sains adalah bagian dengan pernyataan resmi paling kuat di antara ketiga bagian. Blog Google menyebut Terminal-Bench Science 70.5%, RiemannBench 84.0%, dan HLE-Diamond 71.3% sebagai best in class untuk tiga item; ini merupakan laporan sendiri pihak resmi. Tabel perbandingan di kartu model konsisten dengan itu, ketiga item Neon lebih tinggi dari Opus 5.5 dan Sol, tetapi kolom pembanding juga merupakan rangkuman laporan sendiri dari masing-masing pihak.
| Item pengetahuan dan sains (kartu model) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M, BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
GraphWalks pada rentang konteks panjang 256k hingga 1M mencatat 95.2%, terpaut cukup jauh dari 66.8% milik Opus 5.5, cocok untuk menjadi perhatian utama pada skenario membaca materi yang sangat panjang. Pada Terminal-Bench-Science, Sol mencatat 68.0%, selisih 2.5 poin persentase dari 70.5% milik Neon, menjadi selisih terkecil di antara tiga item sains.
Gemini 4 Neon berdasarkan tugas: satu tabel keseluruhan
Setelah menggabungkan ketiga bagian, disusun berdasarkan tiga kondisi “klaim resmi peringkat pertama”, “model card pesaing lebih tinggi”, dan “pihak ketiga hanya unggul 1 poin”, maka diperoleh tabel berdasarkan tugas di bawah ini. Tabel ini tidak menjawab siapa yang paling kuat secara keseluruhan, hanya memberi tahu Anda skor setiap jenis tugas didasarkan pada bukti yang mana.
| Jenis tugas | Klaim resmi peringkat 1 | Model card pesaing lebih tinggi | Selisih pihak ketiga 1 poin |
|---|---|---|---|
| Pemrograman | Coding Agent Index 58.6 peringkat 1 keseluruhan | Terminal-bench 4.1, FrontierCode 2.0: Opus 5.5 lebih tinggi | Coding Agent Index 59 vs Fable xhigh, Opus 5.5 max 58 |
| Pekerjaan pengetahuan | Legal Research Bench, Tax Agent Bench, AutomationBench, Vending-Bench 2 | Chartography: Sol lebih tinggi | MKA 56% vs Fable max 57% (Neon lebih rendah 1 poin) |
| Sains | Terminal-Bench Science, RiemannBench, HLE-Diamond | Tidak ada | Tidak ada skor sains pihak ketiga terpisah |
| Pintu masuk komprehensif | Vals Index peringkat 2 (70.9%) | Tidak ada | Skor kecerdasan AA 61, 1 poin lebih tinggi dari Carbon high |
Analisis kelebihan dan kekurangan Gemini 4 Neon
Kelebihan
- Tiga bidang sains konsisten unggul: Klaim resmi dan model card keduanya menunjukkan Terminal-Bench Science, RiemannBench, HLE-Diamond lebih tinggi dari dua model pembanding.
- Pembacaan konteks panjang kuat: Model card GraphWalks pada interval 256k–1M BFS F1 sebesar 95.2%, sesuai dengan jendela terpadu 1 juta token.
- Peningkatan rantai alat terlihat jelas: SWE-sweep di bawah harness vendor 39.0%, menunjukkan manfaat lebih besar saat dipadukan dengan lingkungan agent seperti Antigravity.
- Input multimodal lengkap: Model card menyatakan dukungan input teks, gambar, audio, video; halaman model Artificial Analysis menunjukkan input Opus 5.5 hanya teks dan gambar.
Keterbatasan
- Pemrograman bukan peringkat pertama di setiap item: Pada Terminal-bench 4.1 dan FrontierCode 2.0, Opus 5.5 sedikit lebih tinggi, untuk tugas terminal murni atau kode frontier disarankan menguji keduanya.
- Pemahaman grafik ada pesaing lebih tinggi: Pada Chartography, Sol lebih tinggi, untuk tugas laporan padat grafik dapat memasukkan Sol dalam perbandingan.
- Tingkat tinggi tidak menjamin skor lebih tinggi: Pada artikel Artificial Analysis, GDP.pdf xhigh lebih rendah dari high, tingkat pemikiran perlu disesuaikan per tugas.
- Batasan parameter cukup ketat: Panduan pengembang menyatakan mengirim
thinking_budgetatauMINIMALakan mengembalikanHTTP 400, cache konteks eksplisit tidak didukung, hanya menggunakan cache implisit dengan prefiks bersama di atas 4096 token.
Harga dan kecepatan artikel ini hanya menyisakan satu kalimat: perbandingan biaya per tugas dengan Carbon memiliki kaliber berbeda seperti klaim Google 32% lebih rendah, artikel Artificial Analysis sekitar 17% lebih sedikit, diserahkan ke artikel khusus penetapan harga untuk diuraikan; waktu dan kecepatan output setiap tingkat pemikiran diserahkan ke artikel khusus kecepatan.
Panduan Cepat Gemini 4 Neon: Tentukan Tugas Dulu, Baru Tentukan Tingkat Pemikiran
Urutan memulai sebaiknya dibagi menjadi tiga langkah: pertama pilih jenis tugas berdasarkan tabel ringkasan di atas, lalu tentukan tingkat pemikiran, terakhir cek tabel utama APIYI untuk memastikan model keluarga Gemini 4 yang sudah tersedia sudah memadai.
- Pilih jenis tugas: Untuk penalaran ilmiah dan membaca materi panjang, utamakan keunggulan Neon; untuk pemrograman terminal dan pemahaman grafik, sertakan Opus 5.5 atau Sol sebagai kandidat.
- Pilih tingkat pemikiran: Panduan pengembang menyatakan bahwa Neon hanya memiliki empat tingkat, yaitu
low,medium,high, danxhigh, dengan defaulthigh. Halaman model Artificial Analysis menunjukkan skor kecerdasan keempat tingkat masing-masing 44, 55, 60, dan 61; darihighkexhighhanya selisih 1 poin, sedangkan pada GDP.pdfhighjustru lebih tinggi. Jadi, untuk sebagian besar tugas, memulai dari tingkat default sudah cukup. - Cek model yang tersedia: Untuk tugas orkestrasi, Anda dapat mengikuti pendekatan di panduan pengembang: serahkan kendali utama kepada model yang kuat, dan serahkan subtugas cepat kepada
gemini-4-hydrogen; untuk tugas jangka panjang yang paling sulit, lihatgemini-4-carbon.
Untuk alamat pemanggilan, pada antarmuka yang kompatibel dengan OpenAI, setel base_url ke https://api.apiyi.com/v1; antarmuka native Gemini menggunakan https://api.apiyi.com dan pilih versi v1beta. Kunci API dibaca dari variabel lingkungan, misalnya APIYI_API_KEY; jangan menulis kunci teks polos ke dalam kode. Saat memanggil, isi model dengan gemini-4-carbon atau gemini-4-hydrogen; di tabel utama APIYI, endpoint keduanya adalah chat dan gemini.
Tabel di bawah ini berisi model-model pembanding dari tabel utama APIYI yang diperbarui pada 2026-11-16 (docs.apiyi.com/models.md) dan antarmuka harga yang dikueri pada 2026-11-19 (api.apiyi.com/api/pricing, total 285 model), dengan satuan dolar AS per juta token.
| ID Model | Input | Baca cache | Output | Platform yang Tersedia |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | Tabel utama APIYI, antarmuka harga |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | Tabel utama APIYI, antarmuka harga |
claude-opus-5-5 |
4 | 0.2 | 20 | Tabel utama APIYI, antarmuka harga |
gpt-6.2-sol |
2 (input di atas 272000 token: 3) | 0.1 | 10 (tier tinggi antarmuka harga sekitar 11.25) | Tabel utama APIYI, antarmuka harga |
2/10 untuk gemini-4-carbon adalah harga katalog APIYI saat ini, yang sesuai dengan harga perkenalan Google hingga 2026-11-30. Harga yang tertera untuk Gemini 4 Neon di halaman harga Google AI Studio adalah input 3.00 dan output 15.00 dolar AS per juta token, tanpa paket gratis; model ini belum muncul baik di tabel utama APIYI maupun di antarmuka harga. Model ini belum tersedia; kami akan segera menyediakannya. Model dan harga mengacu pada daftar model platform.
🚀 Saran memulai: Sebelum Neon tersedia, Anda bisa lebih dulu menggunakan APIYI apiyi.com dengan kunci API yang sama untuk memanggil
gemini-4-carbon,claude-opus-5-5, dangpt-6.2-solsecara terpisah, lalu menjalankan tugas pemrograman atau pembuatan laporan Anda masing-masing satu kali untuk lebih dulu menentukan jenis tugas mana yang memerlukan kemampuan setara Neon.
Pertanyaan Umum (FAQ)
Q1: Model Gemini 4 Neon ditujukan untuk segmen apa?
Model kelas menengah keluarga Gemini 4 yang dirilis Google pada 2026-11-18, diadaptasi dari Carbon. Panduan pengembang menempatkannya di antara Hydrogen dan Carbon, sedangkan blog resmi menyebutnya ditujukan untuk alur kerja kompleks yang berjalan dengan frekuensi tinggi. ID modelnya adalah `gemini-4-neon`.
Q2: Skor keseluruhan 61 menempatkan Gemini 4 Neon di peringkat berapa?
Artikel Artificial Analysis menunjukkan skor 61 pada tingkat xhigh dan peringkat 3 keseluruhan; di atasnya ada GPT-6.2 Astra (max) dan Claude Fable 5.2 (max). Blog Google dan kartu model mencantumkan angka 61 yang sama, tetapi skor keseluruhan hanya cocok sebagai pintu masuk; subskor harus dilihat berdasarkan tugas.
Q3: Coding Agent Index sebenarnya 58.6 atau 59?
Keduanya benar, tetapi sumbernya berbeda. 58.6 adalah angka dari blog Google (dilaporkan sendiri secara resmi), sedangkan 59 adalah angka dari artikel Artificial Analysis saat menguji Neon xhigh di Antigravity CLI. Keduanya tidak boleh digabungkan atau dirata-ratakan.
Q4: Selisih 12.8% dan 39.0% pada SWE-sweep sangat besar, apa artinya?
Mereka adalah hasil dari dua harness: 12.8% berasal dari mini-SWE harness, sedangkan 39.0% berasal dari Google Antigravity. Blog resmi mengaitkan selisih tersebut dengan efek harness yang membuka kemampuan; saat memilih model, perhatikan lingkungan agent yang benar-benar Anda gunakan.
Q5: Pada tolok ukur mana pesaing lebih tinggi daripada Gemini 4 Neon?
Pada kartu model, Terminal-bench 4.1 dan FrontierCode 2.0 menunjukkan Claude Opus 5.5 sedikit lebih tinggi, sedangkan Chartography menunjukkan GPT-6.2 Sol sedikit lebih tinggi. Dalam artikel Artificial Analysis, MKA Fable max sebesar 57% lebih tinggi daripada Neon 56%.
Q6: Apakah Gemini 4 Neon sudah bisa dipanggil melalui API sekarang?
Di sisi Google, model ini telah diluncurkan melalui kanal seperti Gemini API di AI Studio. Tabel utama dan antarmuka harga APIYI apiyi.com saat ini belum memiliki `gemini-4-neon`, jadi belum tersedia di platform; kami akan segera menyediakan model ini. Jenis model dan harga mengacu pada daftar model platform.
Q7: Model apa yang bisa dipakai sebagai alternatif untuk pengujian sebelum tersedia?
Di APIYI apiyi.com, Anda dapat memanggil `gemini-4-carbon` atau `gemini-4-hydrogen` melalui alamat kompatibel OpenAI `https://api.apiyi.com/v1`; kunci API yang sama juga dapat dipindahkan ke `claude-opus-5-5` dan `gpt-6.2-sol` untuk perbandingan silang. Pengguna baru mendapatkan kuota uji coba gratis.
Q8: Apa saja batasan pemanggilan Gemini 4 Neon?
Panduan pengembang menyatakan: tingkat pemikiran hanya tersedia empat pilihan, dari `low` hingga `xhigh`; mengirimkan `thinking_budget` atau `MINIMAL` akan mengembalikan `HTTP 400`; cache konteks eksplisit tidak didukung; batas seragam 1048576 token mencakup input dan output, dengan output default maksimum 65536 per segmen.
Poin-Poin Utama Gemini 4 Neon (Key Takeaways)
- Skor komposit hanyalah pintu masuk: skor kecerdasan AA 61 dan peringkat ke-3 konsisten di tiga sumber; pemilihan model tetap harus dipecah per tugas.
- Dua benchmark pemrograman disalip: di kartu model, Opus 5.5 sedikit lebih tinggi pada Terminal-bench 4.1 dan FrontierCode 2.0.
- Pemrograman unggul 1 poin menurut pihak ketiga: Coding Agent Index 59 berbanding 58 untuk Fable xhigh dan Opus 5.5 max.
- Sebagian besar pekerjaan pengetahuan unggul: pada Chartography, Sol lebih tinggi; keunggulan konteks panjang GraphWalks paling jelas.
- Tiga item sains diklaim resmi best in class: dalam perbandingan kartu model juga unggul, tetapi data pesaing berasal dari klaim masing-masing vendor.
- Tingkat berpikir dimulai dari high: skor kecerdasan high dan xhigh hanya berbeda 1; pada GDP.pdf, high lebih tinggi.
- Untuk memulai, uji dulu model yang sudah tersedia: sebelum Neon tersedia, Anda dapat menjalankan tugas lebih dulu dengan Carbon dan Hydrogen di APIYI apiyi.com.
Ringkasan
Seberapa kuat Gemini 4 Neon akan jauh lebih jelas jika dilihat dari tiga bagian:
- Pemrograman: secara resmi diklaim peringkat pertama Coding Agent Index; dari pihak ketiga hanya unggul 1 poin; di kartu model, Opus 5.5 sedikit lebih tinggi pada dua item.
- Pekerjaan pengetahuan: sebagian besar unggul pada AutomationBench, GraphWalks dengan konteks panjang, dan lain-lain; pada Chartography, Sol lebih tinggi.
- Sains: tiga item diklaim resmi best in class; perbandingan kartu model konsisten unggul; ini bagian dengan bukti paling rapi di antara ketiganya.
Saran: kelompokkan dulu tugas Anda ke salah satu kategori, lalu bandingkan dengan tabel ringkasan di artikel ini untuk memutuskan apakah perlu Neon. Sebelum tersedia, Anda dapat membandingkan Gemini 4 Carbon, Hydrogen, serta Opus dan Sol melalui antarmuka terpadu di APIYI apiyi.com; setelah gemini-4-neon dirilis, cukup ganti ID model dan uji ulang.
📚 Referensi
-
Blog Google – Introducing Gemini 4 Neon: artikel rilis resmi dan skor yang dilaporkan sendiri
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Keterangan: peringkat, skor pemrograman, dan sains yang dilaporkan sendiri oleh pihak resmi
- Tautan:
-
Kartu Model DeepMind – Gemini 4 Neon: tabel perbandingan tiga kolom dan spesifikasi model
- Tautan:
deepmind.google/models/model-cards/gemini-4-neon/ - Keterangan: skor per item Neon, Opus 5.5, Sol; hasil non-Gemini secara default berasal dari laporan masing-masing pihak
- Tautan:
-
Panduan Developer Google Cloud – Gemini 4 Neon: parameter dan batasan pemanggilan
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Keterangan: tingkat pemikiran, batas token, caching, dan kode error
- Tautan:
-
Artikel Artificial Analysis – Gemini 4 Neon intelligence gain: pengukuran pihak ketiga
- Tautan:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Keterangan: Coding Agent Index 59, GDP.pdf, MKA, dan lainnya
- Tautan:
-
Halaman model Artificial Analysis – Gemini 4 Neon: indeks yang dipisahkan berdasarkan tingkat pemikiran
- Tautan:
artificialanalysis.ai/models/gemini-4-neon - Keterangan: perbandingan skor kecerdasan empat tingkat
- Tautan:
-
Daftar lengkap model APIYI: model yang sudah tersedia dan harganya
- Tautan:
docs.apiyi.com/models.md - Keterangan: model dan harga mengacu pada daftar model platform
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami di halaman utama situs web APIYI; materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com