著者注:GPT-6.2 Sol と Claude Fable 5.2 について、サードパーティの総合スコア、公式価格、キャッシュ読み取り、そして単項目の比較を、それぞれ分けて整理しました。どの数字が直接比較できて、どれが「どちらが強い」という一言では括れないのかを解説します。
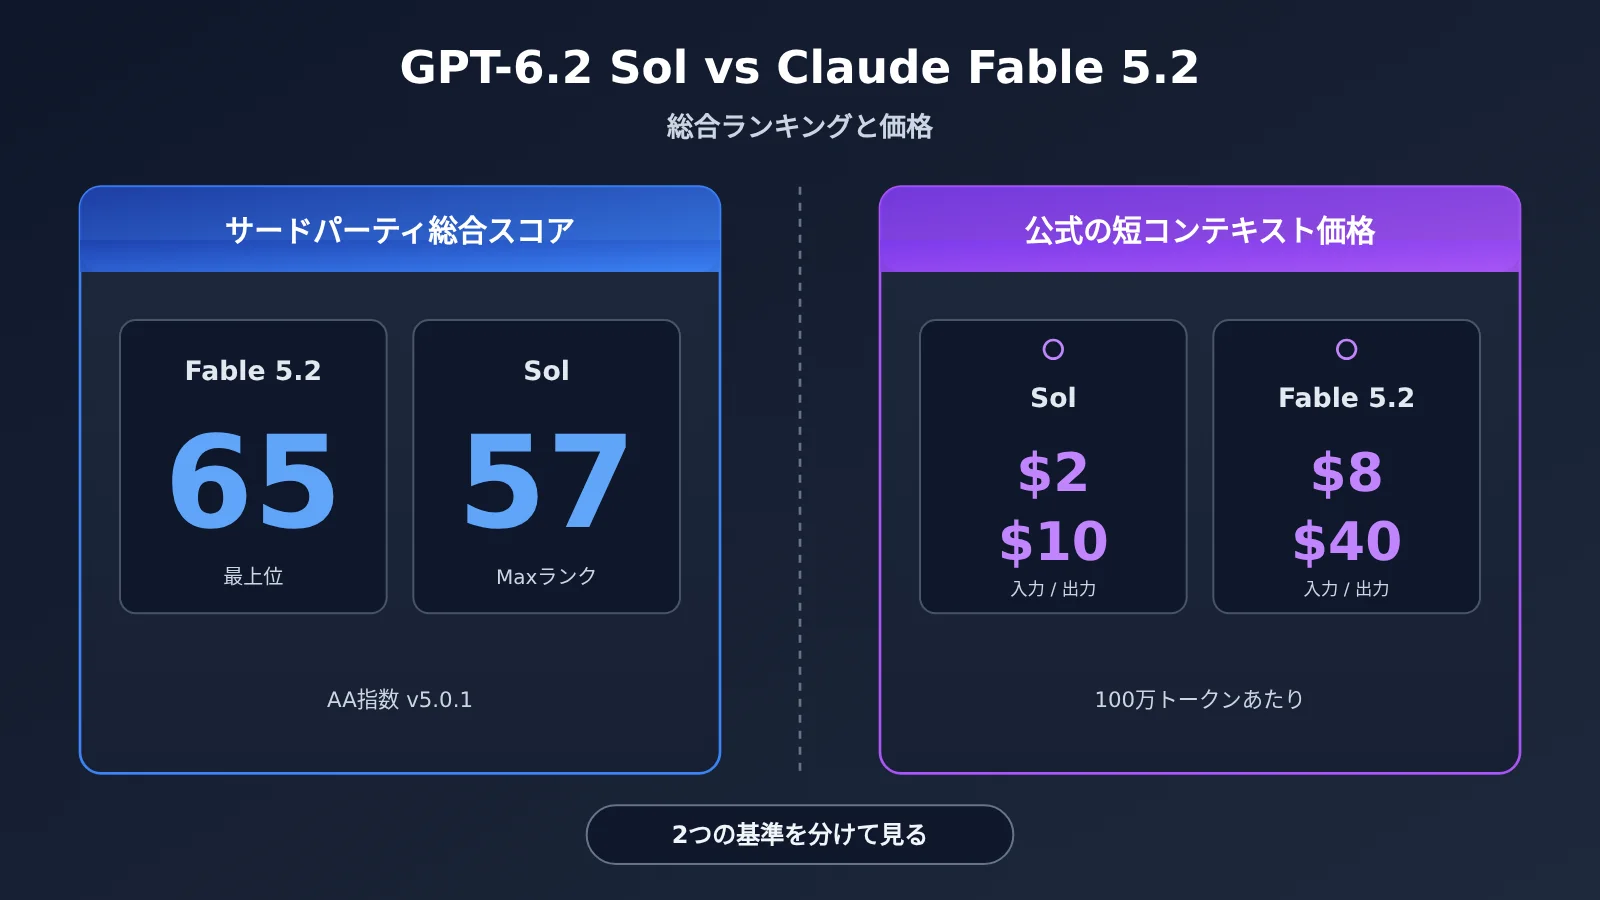
GPT-6.2 Sol と Claude Fable 5.2 を並べて比較するとき、一番起こりやすいミスは、すべての数字を「どちらが強いか」という一言で片付けてしまうことです。2026年11月17日、OpenAI が GPT-6.2 Astra と GPT-6.2 Sol を発表すると、サードパーティ機関の Artificial Analysis はその日のうちに総合ランキングを更新しました:Claude Fable 5.2 の最高推論ティアは65点、GPT-6.2 Sol の Max ティアは57点。一方、両社が公式に定めている短いコンテキスト向けの価格では、Sol の入力・出力どちらの単価も Fable の4分の1です。
スコアの差も大きければ、価格の差も大きい。どちらも事実ですが、互いに相殺できるわけでも、一つの結論にまとめられるわけでもありません。本記事は、あなたに代わってどちらかを選ぶ記事ではありません。メーカーの自己申告、サードパーティのランキング、ベンダーの公式価格は、3つの別々の基準です。本記事ではこれらを層ごとに切り分けて解説し、さらにどの単項目には Sol 対 Fable の直接的な公式比較データが実際には存在しないのかを、別途リストアップします。
核心ポイント:本記事を読み終える頃には、総合スコア・公式価格・キャッシュ読み取りという3組の検証可能な数字が手に入り、どの単項目が Sol 対 Fable の比較には使えないのかがわかります。さらに、自分のタスクに合わせてどちらのデータを先に確認すべきかも判断できるようになります。
GPT-6.2 Sol と Claude Fable 5.2 の核心ポイント
まず、下の表で結論レベルの数字をお伝えします。各行には測定条件を明記してあります。続く章では、一行ずつ詳しく見ていきます。
| 要点 | 数字 | 根拠と読み方 |
|---|---|---|
| 総合スコア | Fable 5.2 が 65、Sol(Max)が 57 | 第三者機関 Artificial Analysis Intelligence Index v5.0.1、それぞれの最高推論レベル |
| 短いコンテキストの入力/出力価格 | Sol $2 / $10、Fable $8 / $40(100万トークンあたり) | 両社の公式価格。Sol は Fable の4分の1。ただしこの2項目に限る |
| キャッシュ読み取り価格 | Sol $0.10、Fable $0.20 | 公式価格。Sol は Fable の半分であり、4分の1ではない |
| 公式資料での直接比較 | AA-3D 人工ブラインド評価 Elo:Sol 1259、Fable 1271 | 公式の転述によるもの。その他の公式個別項目は、多くが Astra 対 Fable、または Sol 対 自社旧モデル |
| APIYI での取扱状況 | claude-fable-5-2 は取扱あり、gpt-6.2-sol は未取扱 |
プラットフォームのモデル一覧を正とする |
表中の GPT-6.2 Sol の価格について:上記は OpenAI の公式価格です。現在はまだ取扱がなく、できるだけ早くこのモデルを取り扱う予定です。モデル名と価格は、プラットフォームのモデル一覧をご確認ください。
GPT-6.2 Sol と Claude Fable 5.2 の比較を、なぜ層に分けて考えるのか
総合指数は数十項目のタスクを1つのスコアに圧縮したものです。そのため「全体の水準はどのあたりか」という問いには答えられますが、「自分のこのタスクにはどちらが向いているか」という問いには答えられません。一方、価格が示しているのは100万トークンあたりの単価であり、1つのタスクを完了するまでにいくらかかるかとは別物です。両者の推論レベル、思考トークンの量、キャッシュヒット率によって、実際の請求額は変わってくるからです。
さらに、個別タスクの比較は第三の層にあたります。OpenAI の発表文で Fable の個別成績に触れるとき、比較対象の多くは Sol ではなく GPT-6.2 Astra です。Astra の成績をそのまま Sol のものとして扱ってしまうのが、この種の比較で最もよくある誤読です。本記事では両者をきちんと区別して扱います。
GPT-6.2 Sol と Claude Fable 5.2 の比較:核心的な違い
GPT-6.2 Sol と Claude Fable 5.2 のサードパーティ総合スコア
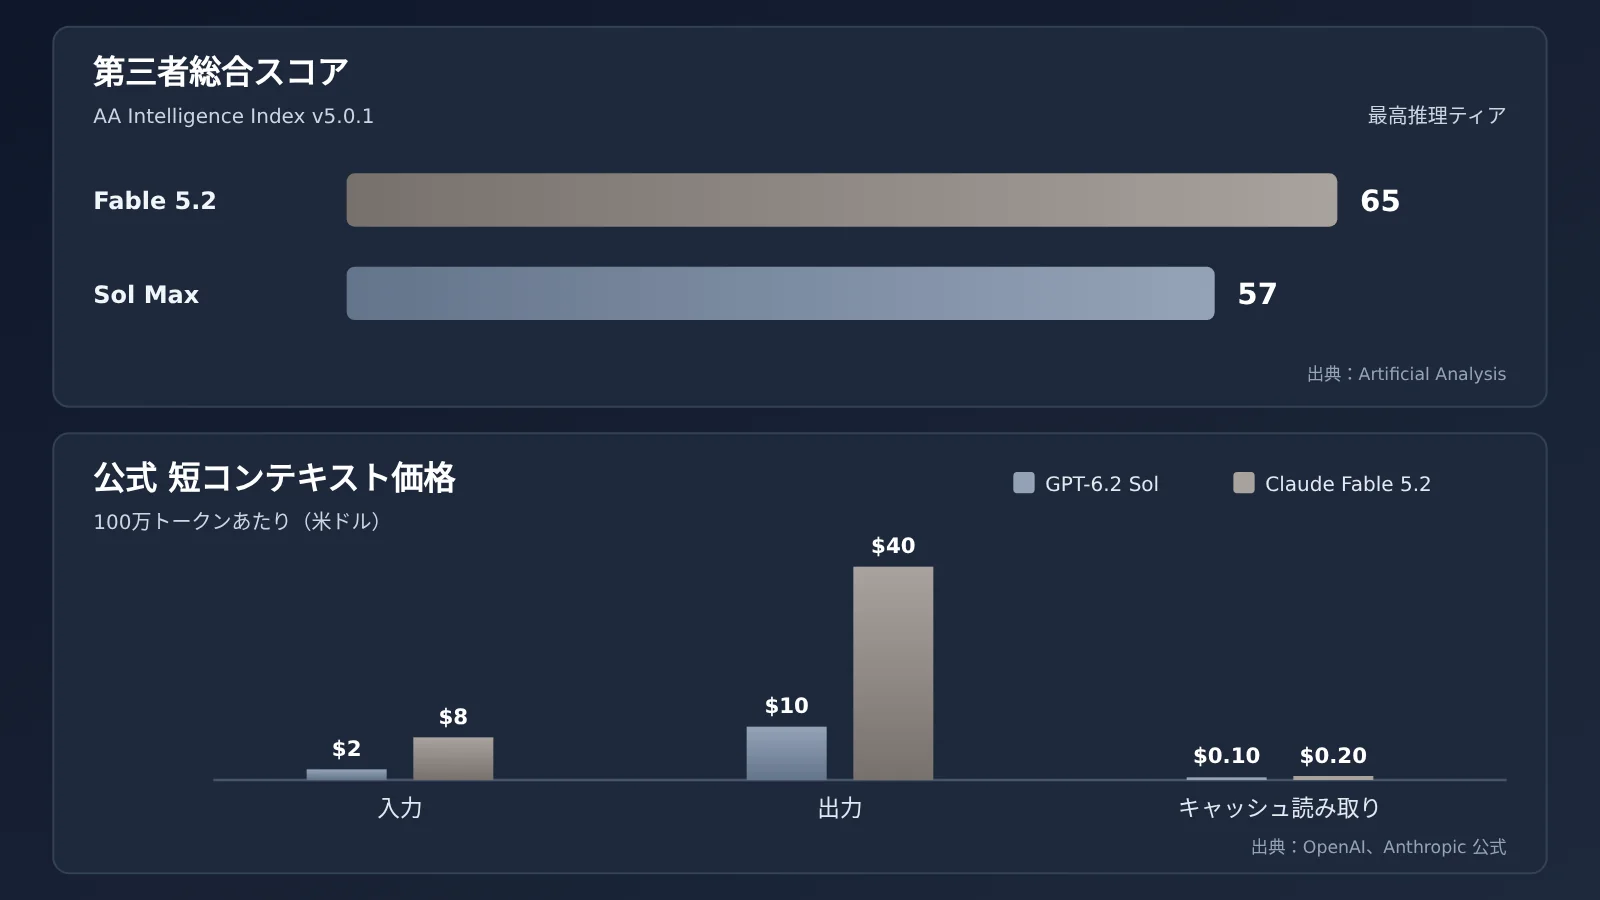
Artificial Analysis はサードパーティの評価機関であり、以下の数字は OpenAI や Anthropic の自己申告ではありません。同機関は Intelligence Index v5.0.1 において、各モデルを推論レベルごとに採点しています。比較する際は、どの推論レベルのスコアかを明確にしておく必要があります。
| モデル | 推論レベル | Intelligence Index v5.0.1 | 総合指数の1タスクあたりコスト(各モデルページより) |
|---|---|---|---|
| Claude Fable 5.2 | 最高推論レベル | 65(ランキング1位) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00(Max) |
| Gemini 4 Carbon | 最高レベル | 60 | — |
| Claude Opus 5.5 | 最高レベル | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
Artificial Analysis によれば、Sol は GPT-6.1 Sol より 2 ポイント高い 57 に達し、GPT-6 Astra と同水準となりました。1タスクあたりのコストは後者の約 15% です。表の「1タスクあたりコスト」は、サードパーティがこの指数を実行した際に実際にかかった費用で、推論レベル・思考の長さ・表示価格を総合した結果を反映したものです。API の表示価格そのものではありません。
なお注意したいのは、OpenAI 公式によると Astra の Agents’ Last Exam におけるコストは Fable の約 5% とされていますが、これは別のタスクセットでの話だという点です。$26.54 と公式の「5%」を相互に換算することはできませんし、この数字を Sol に当てはめることもできません。
GPT-6.2 Sol と Claude Fable 5.2 の公式価格とキャッシュ
まずは GPT-6.2 Sol から。OpenAI のモデルページに掲載されている標準ティア・短いコンテキスト向けの価格は、入力 $2、キャッシュ読み取り $0.10、キャッシュ書き込み(30分間保持)$2.50、12時間キャッシュ書き込み $5、出力 $10 です。このモデルはまだ提供を開始していませんが、できるだけ早く提供開始を進めています。モデル名と価格は、プラットフォームのモデル一覧を基準としてください。なお、リリース記事では、Sol は GPT-6.1 Sol と同じ API トークン価格を引き継ぐと説明されています。
Claude Fable 5.2 については、Anthropic のドキュメントで入力 $8、出力 $40、5分キャッシュ書き込み $10、1時間キャッシュ書き込み $16、キャッシュ読み取り $0.20 と記載されています。APIYI(apiyi.com)のモデル一覧では、claude-fable-5-2 と claude-fable-5-2-thinking の入力・出力・キャッシュ読み取りが $8 / $40 / $0.2 と掲載されており、公式価格と一致しています。ただし、両モデルの詳細ページは現在 404 エラーを返しているため、価格はモデル一覧を基準にしてください。
| 課金項目(100万トークンあたり) | GPT-6.2 Sol(OpenAI 公式) | Claude Fable 5.2(Anthropic 公式) | 両者の関係 |
|---|---|---|---|
| 入力(短いコンテキスト) | $2 | $8 | 1/4 |
| 出力(短いコンテキスト) | $10 | $40 | 1/4 |
| キャッシュ読み取り | $0.10 | $0.20 | 1/2 |
| キャッシュ書き込み | 30分 $2.50、12時間 $5 | 5分 $10、1時間 $16 | 保持時間が異なるため単純比較は不可 |
| Batch | 標準価格の50% | 入力・出力とも半額 | ルールはほぼ同じ |
| 高速オプション | Fast は標準価格の2倍。Ultrafast は 2027-02-28 まで3倍、2027-03-01 からは6倍 | Fast mode は入力 $16・出力 $80、速度は最大約2.5倍 | 仕組みが異なる |
表中の GPT-6.2 Sol の各項目は OpenAI 公式の価格です。このモデルはまだ提供を開始していませんが、できるだけ早く提供開始を進めています。モデル名と価格は、プラットフォームのモデル一覧を基準としてください。
「Sol は Fable の1/4」という関係が成り立つのは、短いコンテキストの入力と出力だけです。OpenAI のモデルページにはもう一つルールがあります。1回のリクエストで入力が 272K トークンを超えると、入力とキャッシュの単価が2倍になり、出力は短いコンテキストの1.5倍で計算されます。しかも、このレートはリクエスト全体に一括適用されます。この場合、Sol の出力単価は $10 ではなくなるため、1/4 で概算すると誤った結果になります。Fable 側の長いコンテキストの課金については、Anthropic のドキュメントを基準にしてください。
GPT-6.2 Sol と Claude Fable 5.2 のスペックとインターフェース
両モデルともコンテキストは百万クラス、最大出力も 128K で共通しています。違いは入力モダリティ、推論のオン/オフ設定、そしてインターフェースにあり、ここが統合方式の設計に影響するポイントです。
| 項目 | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| コンテキスト / 最大出力 | 1,050,000(最大入力 922,000)/ 128,000 | 1M / 128K |
| 入力 / 出力 | テキスト、画像 / テキスト | Anthropic のドキュメントを参照 |
| 知識のカットオフ | 2026-06-01 | 2026-06 |
| 推論設定 | API では reasoning effort を none に設定不可 | デフォルトの effort は high、思考モードは常時有効でオフにできない |
| 公式エンドポイント | Chat Completions、Responses、Batch | Anthropic API |
| APIYI | 未掲載 | claude-fable-5-2、claude-fable-5-2-thinking(エンドポイントは chat、messages) |
APIYI で掲載済みの Fable を呼び出す場合、OpenAI 互換方式の base URL は https://api.apiyi.com/v1 で、モデル名には claude-fable-5-2 を指定します。プロジェクトがもともと Anthropic Messages プロトコルで動いている場合は、プラットフォームの messages エンドポイントを利用することもできます。グループについては、一覧表に ClaudeCode、Claude_Reverse、Claude_Enterprise、Default、SVIP の記載があります。
GPT-6.2 Sol と Claude Fable 5.2 の個別タスクを分けて見る
ここが本記事で最も重要なセクションです。OpenAI の発表文には個別のスコアが数多く載っていますが、その中で「Sol 対 Fable」の直接比較はごくわずかです。以下の表では、出典と比較相手の組み合わせごとに項目を一つずつ整理しました。
| 個別項目 | 出典 | 比較対象と結果 | Sol 対 Fable の直接比較か |
|---|---|---|---|
| Intelligence Index v5.0.1 | サードパーティ AA、最高推論レベル | Fable 65、Sol(Max)57 | はい(サードパーティの総合スコア) |
| AA-3D 人間ブラインド評価 Elo | 公式の転述 | Sol 1259、Fable 1271 | はい(公式資料の中で唯一の項目) |
| AA-Robotics v0.1 | サードパーティ AA、研究プレビュー | Sol 78、Fable 75 | はい(サードパーティのプレビュー、推論レベルは AA のページを参照) |
| Agents’ Last Exam | 公式自己申告 | Astra は Fable より 5.5 点高く、コストは約 5% | いいえ、Astra 対 Fable |
| Harvey LAB-AA v1.1 | 公式自己申告 | Astra の合格率は Fable の2倍超、コストは約6分の1 | いいえ、Astra 対 Fable |
| FrontierCode 2.0 | 公式自己申告 | Sol と Astra の差は 0.5 点未満、コストは約5分の1、双方とも Max | いいえ、Sol 対 Astra |
| LifeVal | 公式自己申告 | Sol は GPT-6 Astra を上回る、コストは約7分の1 | いいえ |
| GDPval v2 | 公式自己申告 | Sol は GPT-6.1 Sol より 5.3 点高い | いいえ |
| Coding Agent Index | サードパーティ AA、max レベル | Sol は GPT-6.1 Sol より 3 点低い | いいえ |
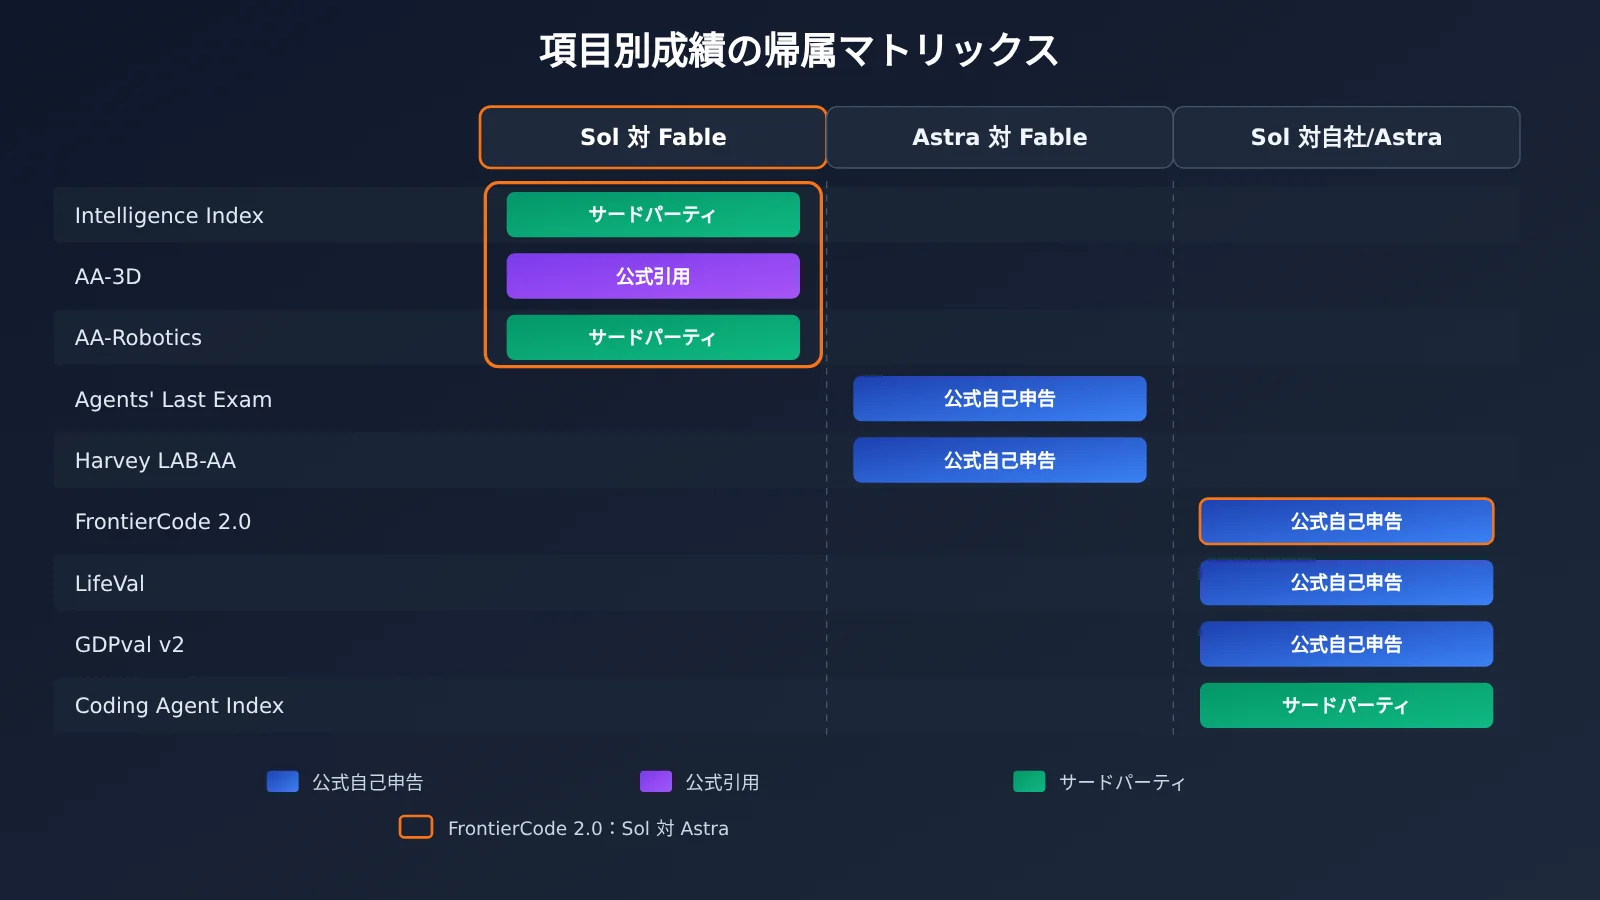
GPT-6.2 Sol の FrontierCode 2.0 スコアを Fable との比較に流用してはいけない
FrontierCode 2.0 は Cognition が設計したベンチマークで、実際のコードベースへの変更がメンテナーにマージされるかどうかを試すものです。公式自己申告の結果では、Sol と Astra の差は 0.5 点未満、コストは Astra の約5分の1で、双方とも Max レベルです。ここには Fable が関与していないため、「Sol は FrontierCode で Fable と 0.5 点未満の差」と書くことはできません。
同様に、Agents’ Last Exam と Harvey LAB-AA で Fable をリードしているのは Astra です。Sol がこの 2 項目で Fable と比べてどうなのかは、発表文には示されておらず、推測すべきではありません。
GPT-6.2 Sol と Claude Fable 5.2 の科学・コード系項目
Terminal-Bench-Science 0.1 にも注意が必要です。公式自己申告では、Astra は GPT-6 Astra より 9 ポイント高くなっています。脚注では、Fable 5.2 に 2 つの数値が記載されています。1 つは Artificial Analysis が mini-swe-agent を使って実施したテストの値、もう 1 つは Anthropic が報告した Claude Code・Max 推論強度での 74.6% です。この 2 つの Fable の数値は異なるテストに由来するため、同じ比較として扱うことはできず、どちらも Sol のスコアではありません。
サードパーティについては、Artificial Analysis が、Sol は Coding Agent Index(Codex harness、max)で GPT-6.1 Sol より 3 点低く、その主な原因は SWE-Atlas-QnA-AA が 14 点低く、重要な事実を見落としやすい点にあると述べています。同社が測定した AA-Omniscience のハルシネーション率(Max)は、Sol で 55% でした。これらの数値に対応する Fable の値はないため、Sol 自身の弱点を把握する材料としてしか使えません。
GPT-6.2 Sol と Claude Fable 5.2 のシーン別おすすめ
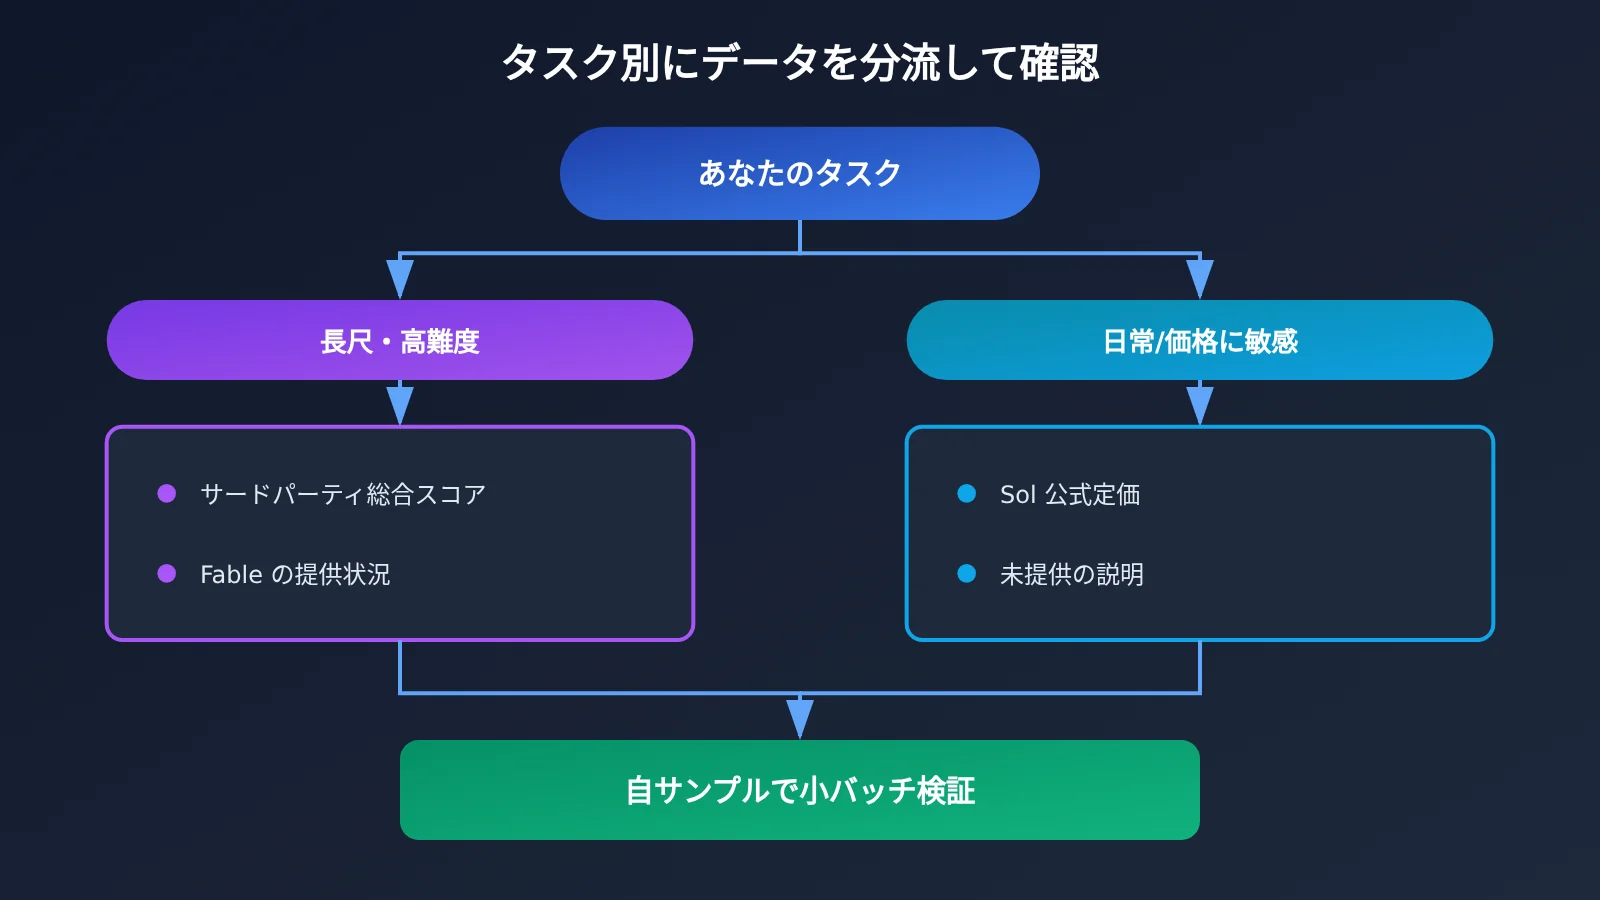
このセクションでは、どちらを使うべきかを決める代わりに、タスクの種類ごとに最初に見るべきデータを説明します。
まず Claude Fable 5.2 のデータを確認すべきタスク
- 長時間・高難度・多ステップの複合タスク:まずサードパーティの総合スコアを確認しましょう。Fable は Intelligence Index v5.0.1 の最高推論ティアで 65 を記録し、首位に立っています。これが現時点で Sol と直接比較できる総合データです。
- すぐに導入したいプロジェクト:
claude-fable-5-2はすでに APIYI で取り扱いがあるので、すぐに自分のサンプルでテストできます。 - 思考のオーバーヘッドを考慮したいプロジェクト:Fable の思考はデフォルトで有効かつオフにできず、デフォルトの effort は high です。予算を組む際は思考トークンも計上しておきましょう。
まず GPT-6.2 Sol のデータを確認すべきタスク
- 日常タスクや価格に敏感なバッチタスク:まず公式の短コンテキスト表示価格と Batch のルールを確認し、その上で LifeVal や GDPval v2 といった公式自身が公表する日常タスクの成績を見ましょう。
- 主に 272K 以内に収まるリクエスト:Sol の入力・出力が 4 分の 1 になるという価格差は、主にこの区間で現れます。
- すでに ChatGPT Work や Codex を利用しているチーム:公式によると、Plus、Pro、Enterprise、Edu で即日から利用可能になり、Pro 200 は初めて Ultrafast を利用できるようになります。Ultrafast は Sol から提供が始まります。
GPT-6.2 Sol と Claude Fable 5.2 クイックスタート
このセクションでは、タスクの種類ごとに操作の手順を紹介します。コードは一切使わず、モデル名とアドレスはすべて文中に記載しています。
長時間に及ぶ高難度タスク:まず Fable の総合スコアと提供状況を確認しましょう。 APIYI のコンソールで APIキー を作成し、OpenAI 互換 SDK の base URL を https://api.apiyi.com/v1 に変更して、model に claude-fable-5-2 を指定します。モデル名に思考モードを明示したい場合は、claude-fable-5-2-thinking を使うこともできます。料金一覧表の定価は入力 $8、出力 $40、キャッシュ読み取り $0.2 で、Anthropic 公式と一致しています。まずは自分の実際のタスクを 20〜50 件実行して完了率とトークン使用量を記録し、65 点というスコアがあなたのシナリオで実際に活きるかどうかを見極めてから導入を判断するのがおすすめです。
日常的で定価が気になるタスク:次に Sol の公式定価と、まだ提供されていない点を確認しましょう。 GPT-6.2 Sol の OpenAI 公式定価は、入力 $2、キャッシュ読み取り $0.10、出力 $10 です。現在はまだ提供されていませんが、できるだけ早くこのモデルを提供する予定です。モデル名と価格はプラットフォームのモデル一覧を基準としてください。提供開始前は、apiyi.com のモデル一覧を定期的にチェックしましょう。テストにプラットフォーム上の gpt-6.1-sol や gpt-6-sol を代用しないでください。これらは 6.2 ではなく、gpt-6-sol はキャッシュ読み取り価格も異なります。
Sol の提供開始後は、注意すべき点が 3 つあります。まず reasoning effort は none に設定できません。次に、入力が 272K を超えるとリクエスト全体に追加料金がかかります。そして、公式エンドポイントは Chat Completions と Responses に対応していますが、プラットフォームのエンドポイントはモデル一覧を基準にしてください。
🚀 すぐに試すなら:同じ APIキー でプラットフォーム上の複数のモデルを呼び出せます。まずは APIYI(apiyi.com)の無料テストクレジットで Fable を実際に動かして動作を確認し、評価スクリプトとサンプルを準備しておきましょう。Sol の提供開始後は、モデル名を差し替えるだけで同じサンプルでの比較ができます。
GPT-6.2 Sol と Claude Fable 5.2 の選定アドバイス
以下は、数字を自分のタスクに当てはめる際に役立つチェックリストです。
- まず集計基準を確認:引用しているのがサードパーティの総合スコアなのか、公式が自己申告している個別スコアなのか、それとも公式の価格表なのかを見極めましょう。3つを合算したり、相互に換算したりしてはいけません。
- 推論レベルを確認:Sol の 57 点は Max レベルの数値で、High レベルは 55、Low レベルに至っては 41 しかありません。実際に使うレベルのスコアをチェックするようにしましょう。
- リクエスト長別にコスト計算:272K 以内であれば、入力と出力を4分の1として概算できます。272K を超えると、OpenAI の一括計算ルールに従って再計算が必要になります。
- キャッシュは別途計算:キャッシュ読み取りは $0.10 対 $0.20 と、両者で2倍の差があります。キャッシュ書き込みの保持期間も異なるため、自分のキャッシュ戦略に合わせて別々に見積もりましょう。
- 個別比較データの有無を確認:注目している個別項目について、Astra 対 Fable や Sol 対 Astra のデータしかない場合は、それを Sol 対 Fable の結論として扱うことはできません。
- 安全ポリシーへの配慮:公式によると、両 6.2 モデルとも Preparedness Framework のサイバーセキュリティで「クリティカル」レベルに達しており、防御がより厳格になっています。一部の正当な脆弱性研究リクエストは拒否される可能性があります。
💡 選定のアドバイス:どのモデルを使うかは、タスクの長さ、推論レベル、キャッシュヒット率によって決まります。同じサンプル群を APIYI プラットフォームでそれぞれモデル呼び出しを行い、請求額と完了率で判断すれば、単一のランキングに頼る必要はありません。
よくある質問 FAQ
Q1:GPT-6.2 Sol と Claude Fable 5.2 とは何ですか?
GPT-6.2 Sol は、OpenAI が 2026-11-17 に GPT-6.2 Astra とともにリリースしたモデルです。モデル ID は `gpt-6.2-sol`、テキストと画像を入力してテキストを出力し、コンテキストは 1,050,000 です。Claude Fable 5.2 は、Anthropic が 2026-11-09 にリリースしたモデルで、コンテキストは 1M、最大出力は 128K。思考はデフォルトで有効になっており、オフにすることはできません。
Q2:総合ランキングが 65 対 57 なら、Claude Fable 5.2 が GPT-6.2 Sol に全面的に先行していると言えますか?
いいえ、そうとは言えません。65 対 57 はサードパーティの Artificial Analysis Intelligence Index v5.0.1 における結果で、Fable は最高推論レベル、Sol は Max レベルを使用したものです。これはあくまでこの指数の全体水準を反映したもので、すべての個別項目で同じ差があるわけではありません。公式が引用している AA-3D の人間によるブラインド評価 Elo では、Sol が 1259、Fable が 1271 と差は明らかに小さくなっています。また、サードパーティの AA-Robotics v0.1 研究プレビューでは、Sol が 78、Fable が 75 です。
Q3:GPT-6.2 Sol の価格は本当に Claude Fable 5.2 の 4 分の 1 なのですか?
短いコンテキストの入力と出力に限れば成立します。公式価格では、Sol は入力 $2・出力 $10、Fable は入力 $8・出力 $40 です。なお、このモデルはまだ提供が始まっておらず、できるだけ早く取り扱いを開始する予定です。モデル名と価格はプラットフォームのモデルリストを参照してください。キャッシュ読み取りは $0.10 対 $0.20 で半分です。272K を超える入力の場合、Sol には全体に割増料金がかかり、出力は短いコンテキスト時の 1.5 倍になるため、この場合は 4 分の 1 として見積もることはできません。
Q4:FrontierCode 2.0 で GPT-6.2 Sol と Claude Fable 5.2 はどれくらい差がありますか?
公式資料にはこの比較は含まれていません。FrontierCode 2.0 における「差が 0.5 点未満」というのは GPT-6.2 Sol と GPT-6.2 Astra の比較で、どちらも Max レベル、Sol のコストは約 5 分の 1 です。Fable はこの比較に参加していません。
Q5:API 経由で GPT-6.2 Sol と Claude Fable 5.2 を呼び出すにはどうすればいいですか?
手順は以下のとおりです。
1. APIYI apiyi.com に登録して、APIキーと無料テストクレジットを取得します。
2. OpenAI 互換 SDK の base URL をプラットフォームのアドレスに設定し、model に `claude-fable-5-2` を指定すれば、Fable を呼び出せます。
3. `gpt-6.2-sol` は現在まだ取り扱いがありません。取り扱い開始後は、モデル名と価格はプラットフォームのモデルリストに準じますので、同じサンプルセットでテストしてください。
Q6:GPT-6.2 Sol と Claude Fable 5.2 には、それぞれどのような既知の制限がありますか?
Sol について:サードパーティの AA の測定では、Max レベルでのハルシネーション率は 55%、Coding Agent Index は GPT-6.1 Sol より 3 点低くなっています。これは主に、重要な事実を見落としやすいためです。また、reasoning effort は none に設定できず、サイバーセキュリティ関連の対策がより厳格で、合法的な脆弱性研究の一部が拒否される場合があります。Fable について:思考はオフにできず、デフォルトの effort は high、思考トークンはコストに計上されます。Fast mode の単価は入力 $16・出力 $80 です。
Q7:公式では Astra のコストは Fable の 5% だと言われていますが、これはサードパーティの $26.54 と突き合わせて計算できますか?
いいえ、できません。「約 5%」は公式が自己申告した Agents’ Last Exam のコストで、比較対象は Astra と Fable です。一方の $26.54 は、Artificial Analysis が総合指数を実施した際の Fable の1タスクあたりコストです。両者はタスクも出所も異なるため、割り算して比較することも、そこから Sol のコストを推算することもできません。おおよその規模感だけ知りたい場合は、APIYI プラットフォームで自分のサンプルを使って実際の請求額を記録する方が確実です。
GPT-6.2 Sol と Claude Fable 5.2 の核心ポイント Key Takeaways
- 総合スコア:サードパーティの AA 指数では、Fable が最高推論ティアで 65、Sol は Max ティアで 57 となっており、同じランキング上に並ぶ直接の比較対象です。
- 定価:短いコンテキストの入力・出力は、Sol が Fable の4分の1($2 対 $8、$10 対 $40)です。
- キャッシュ読み取り:$0.10 対 $0.20 で差は半分にとどまり、4分の1という比率はそのまま使えません。
- ロングコンテキスト:Sol は入力が 272K を超えるとリクエスト全体に上乗せ料金が発生し、元の比率は適用できなくなります。
- 直接比較は少ない:公式資料で Sol 対 Fable の直接比較があるのは AA-3D の1項目のみで、1259 対 1271 です。
- スコアの流用に注意:FrontierCode 2.0 は Sol 対 Astra、ALE と Harvey は Astra 対 Fable の結果です。
- 提供状況:Fable は APIYI(apiyi.com)から直接モデル呼び出しが可能ですが、Sol は現時点でまだ取り扱いがないため、正確な情報はモデル一覧をご確認ください。
まとめ
GPT-6.2 Sol と Claude Fable 5.2 を比較するときは、数字を3つの層に分けて考えることがポイントです:
- サードパーティ総合スコア:Fable 65、Sol(Max)57。全体としてどのランクに位置するかを判断するための数字です。
- 公式価格:短いコンテキストの入力・出力には4分の1の差、キャッシュ読み取りには半分の差があり、長いコンテキストはそれぞれのルールに従って別途計算されます。
- 個別タスク:公式の個別スコアの大半は Sol 対 Fable の直接比較ではないため、引用する前に誰と誰の比較なのかを必ず確認しましょう。
スコアの差と価格の差を「どちらがお得か」という一言にまとめることはできません。より確実なのは、自分のサンプルと固定した推論設定を使い、タスク完了率と請求額をそれぞれ記録する方法です。Fable は今すぐ APIYI(apiyi.com)で試せます。GPT-6.2 Sol はまだ掲載されていませんが、できるだけ早くこのモデルを追加する予定です。モデル名と価格はプラットフォームのモデルリストをご確認ください。
📚 参考資料
-
OpenAI 発表記事:GPT-6.2 Astra と Sol のリリースノートおよび公式自己申告の個別スコア
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明:公式自己申告の個別スコア、利用可能範囲、価格の概要
- リンク:
-
OpenAI モデルページ – GPT-6.2 Sol:仕様、価格、272K の課金ルール
- リンク:
platform.openai.com/docs/models/gpt-6.2-sol - 説明:キャッシュ書き込み価格、長いコンテキストの追加料金、加速モードの倍率はこちらに準拠します
- リンク:
-
OpenAI システムカード:GPT-6.2 Astra と Sol の安全性評価
- リンク:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 説明:準備フレームワークのレベル分けとアライメント評価
- リンク:
-
Artificial Analysis の記事とモデルページ:サードパーティの Intelligence Index v5.0.1
- リンク:
artificialanalysis.ai/models/claude-fable-5-2 - 説明:ランク別の総合スコア、タスク別コスト、Coding Agent Index
- リンク:
-
Anthropic ドキュメント – Claude Fable 5.2:公式価格と仕様
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明:キャッシュ書き込み、キャッシュ読み取り、Fast mode、effort 設定
- リンク:
-
APIYI モデル一覧表:プラットフォームで提供中のモデルと価格
- リンク:
docs.apiyi.com/models.md - 説明:データ取得日時 2026-11-17 15:54(UTC+8)。モデル名と価格はプラットフォームのモデルリストをご確認ください
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にご連絡ください。より多くのモデルや API 仕様については、docs.apiyi.com のドキュメントセンターをご覧ください