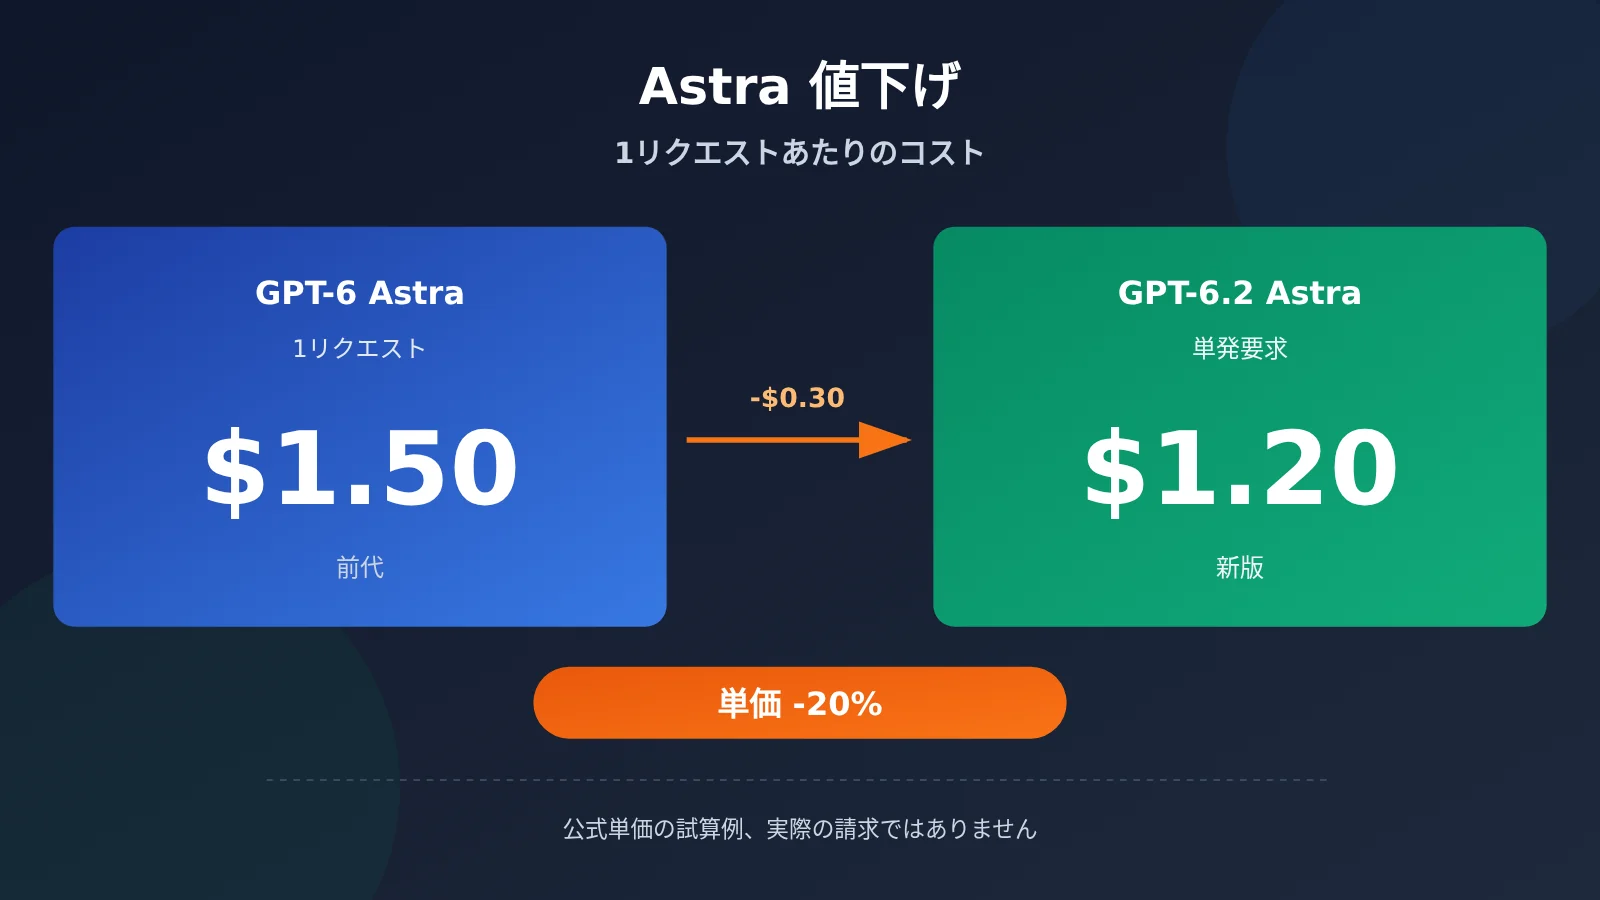
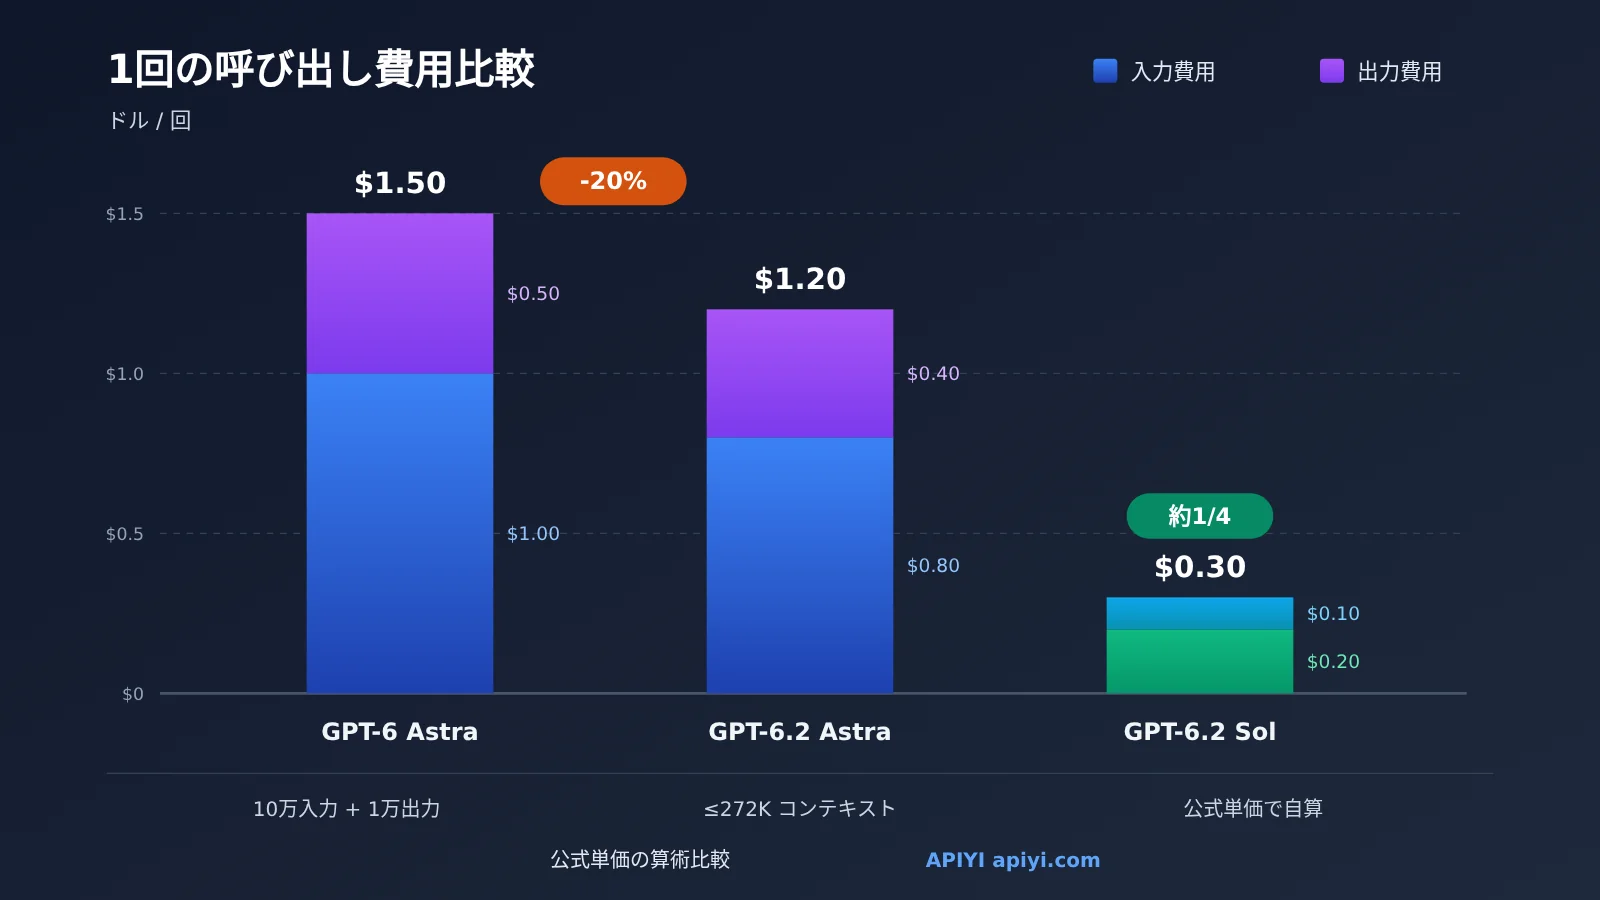
「非キャッシュで入力10万トークン+出力1万トークン、入力が272Kを超えない」という標準的なリクエストを例に挙げます。公式の標準単価で計算すると、GPT-6 Astra は約 $1.50、GPT-6.2 Astra は約 $1.20 となり、1回あたり $0.30 の節約、つまりちょうど 20% です。同じトークン量を GPT-6.2 Sol に置き換えると、約 $0.30 で済みます。ここで注意したいのは、これが「単価が 20% 下がる」という話だという点です。キャッシュ、長コンテキストの段階制、推論出力量、ツール呼び出しなどの要因が最終費用に影響するため、実際の請求額が必ずしも 20% と同じ割合で下がるわけではありません。
この記事を読むとわかること
- OpenAI が 2026年11月17日に発表した GPT-6.2 Astra と Sol について、公式標準価格はそれぞれいくらなのか。
- API リクエスト1回分の費用をどう計算するのか:各ステップの乗算、単位換算、前提条件。
- キャッシュ読み取り、272Kを超える長コンテキスト、出力トークンの変化によって、実際のコストが「20% 値下げ」からどれだけずれるのか。
- 開発者や予算担当者は、自社の呼び出しコストをどのように再估算すべきか。
目次:本文ではまず、概念表と影響の概観で背景を説明します。第1部「客観的事実」では公式発表情報、価格表、公式評価を整理し、公式単価に基づく3つの試算例を示します。第2部「分析と判断」では、単価の下落と請求額の下落の間にある差を説明し、立場別の対応提案を示したうえで、そのまま実行できるコスト試算コードを添えます。
GPT-6.2 Astra の値下げに関連する基礎知識
| 概念 | 簡単な説明 |
|---|---|
| トークン | モデルの課金とテキスト処理の基本単位です。API は「100万トークンあたり」で価格設定されます |
| 非キャッシュ入力 | 本記事では、キャッシュ読み取りとしてもキャッシュ書き込みとしても課金されない、通常の入力部分を指します |
| キャッシュ読み取り | リクエストのうちプロンプトキャッシュにヒットした部分です。単価は非キャッシュ入力よりはるかに低くなります |
| キャッシュ書き込み | 書き込みトークンには独立した合計単価が適用され、同じトークンに通常の入力料金は重ねてかかりません |
| 長コンテキスト段階 | 入力が272Kトークンを超えると、リクエスト全体の入力料金とキャッシュ料金が2倍、出力料金が1.5倍になります |
| 推論レベル | モデルが回答前に投入する推論の強さです。レベルが高いほど、通常は消費するトークンが増えます |
| GDPval v2 / ALE / FrontierCode 2.0 | OpenAI が発表時に引用した3つの評価です。評価対象と基準がそれぞれ異なり、結果を相互に換算することはできません |
GPT-6.2 Astra 20%値下げの影響早見表
| 対象 | 主な影響 |
|---|---|
| API開発者 | 通常の長さのリクエストでは、Astra の入力・出力単価がともに20%下がり、同じ呼び出し量なら費用もそれに応じて減少します。超長コンテキストのリクエストは別途計算が必要です |
| 予算責任者 | Astra の単価予算を20%前提で再評価できますが、実際の削減幅はキャッシュヒット率・コンテキスト長・出力量を踏まえ、請求データで確認する必要があります |
| 選定中のチーム | Sol の標準単価は Astra の約1/4で、コスト重視のタスクには評価する価値のある選択肢が増えました |
| ChatGPT一般ユーザー | 今回は主に ChatGPT Work、Codex、API 向けに段階的に開放され、通常の Chat は今回の提供対象外です |
1. GPT-6.2 Astra の20%値下げに関する客観的事実
以下の内容は、OpenAI の公式リリースページ、モデルドキュメント、価格ページから取得したもので、確認日は 2026 年 11 月 18 日です。すべての評価データは公式レポートによるものであり、本チームの実測結果ではありません。
1.1 GPT-6.2 Astra と Sol のリリース基本情報
OpenAI は 2026 年 11 月 17 日に GPT-6.2 Astra と GPT-6.2 Sol をリリースしました。両モデルは入力でテキストと画像に対応し、出力はテキストです。動画をネイティブに生成することはできません。
提供範囲について、公式は新モデルを ChatGPT Work、Codex、API の各ユーザーへ段階的に開放すると説明しており、通常の Chat は今回の提供範囲には含まれていません。具体的な開放スケジュールは OpenAI のヘルプドキュメントに準拠します。
1.2 GPT-6.2 Astra 公式 API の標準価格
以下の表は、OpenAI 公式の Standard プランにおいて、入力が 272K トークン以下の場合の価格です。単位は米ドル/100万トークンで、APIYI の料金ではありません。出力量は usage の課金対象出力トークン合計で計算され、推論トークンを含みます。そのため、実際に表示される本文の長さとは一致しません。
| モデル | 非キャッシュ入力 | キャッシュ読み取り | 出力 | データソース |
|---|---|---|---|---|
| GPT-6 Astra(前世代) | $10 | $1.00 | $50 | OpenAI モデルページ |
| GPT-6.2 Astra | $8 | $0.4 | $40 | OpenAI モデルページ / 料金ページ |
| GPT-6.2 Sol | $2 | $0.1 | $10 | OpenAI モデルページ / 料金ページ |
公式の課金ルールとして、次の2点に注意が必要です。
- キャッシュ書き込みは独立した合計レートで課金されます:Standard かつ短いコンテキストの場合、Astra の書き込み料金は30分で $10/100万トークン、12時間で $20/100万トークンです。通常入力の $8 にこの費用を上乗せするのではありません。同じ入力トークンは、通常入力・キャッシュ読み取り・該当する寿命のキャッシュ書き込みのいずれか1つに分類されるべきで、二重に課金されることはありません。
- 入力が 272K トークンを超える場合、リクエスト全体の入力料率とキャッシュ料率は2倍、出力料率は1.5倍で計算されます。
前世代と比べると、Astra の非キャッシュ入力は $10 から $8 に、出力は $50 から $40 に下がり、どちらも20%の値下げとなっています。これが「20%の値下げ」の正確な意味です。標準単価が20%下がったということです。
1.3 GPT-6.2 Astra の公式評価データ(当チームによる実測ではありません)
OpenAI はリリース時にいくつかの評価結果を公開しています。評価ごとに基準が異なるため、混同して解釈することはできません。
- GDPval v2:GPT-6.2 Astra は GPT-6 Astra より 6.2 ポイント高く、出力 token は 22% 少なくなっています。GPT-6.2 Sol は GPT-6.1 Sol より 5.3 ポイント高いスコアです。
- ALE:GPT-6.2 Astra はスコアが 5.2 ポイント向上しています。これは別の評価であり、GDPval のポイントと足し合わせたり比較したりすることはできません。
- FrontierCode 2.0:max 推論モードでは、Sol のスコアは Astra より 0.5 ポイント低く、タスクコストは Astra の約 1/5 です。これはこのテストとこのモードにのみ当てはまる内容であり、汎用的なコスト結論として扱うことはできません。
1.4 GPT-6.2 Astra の単一リクエスト費用を自分で計算する例
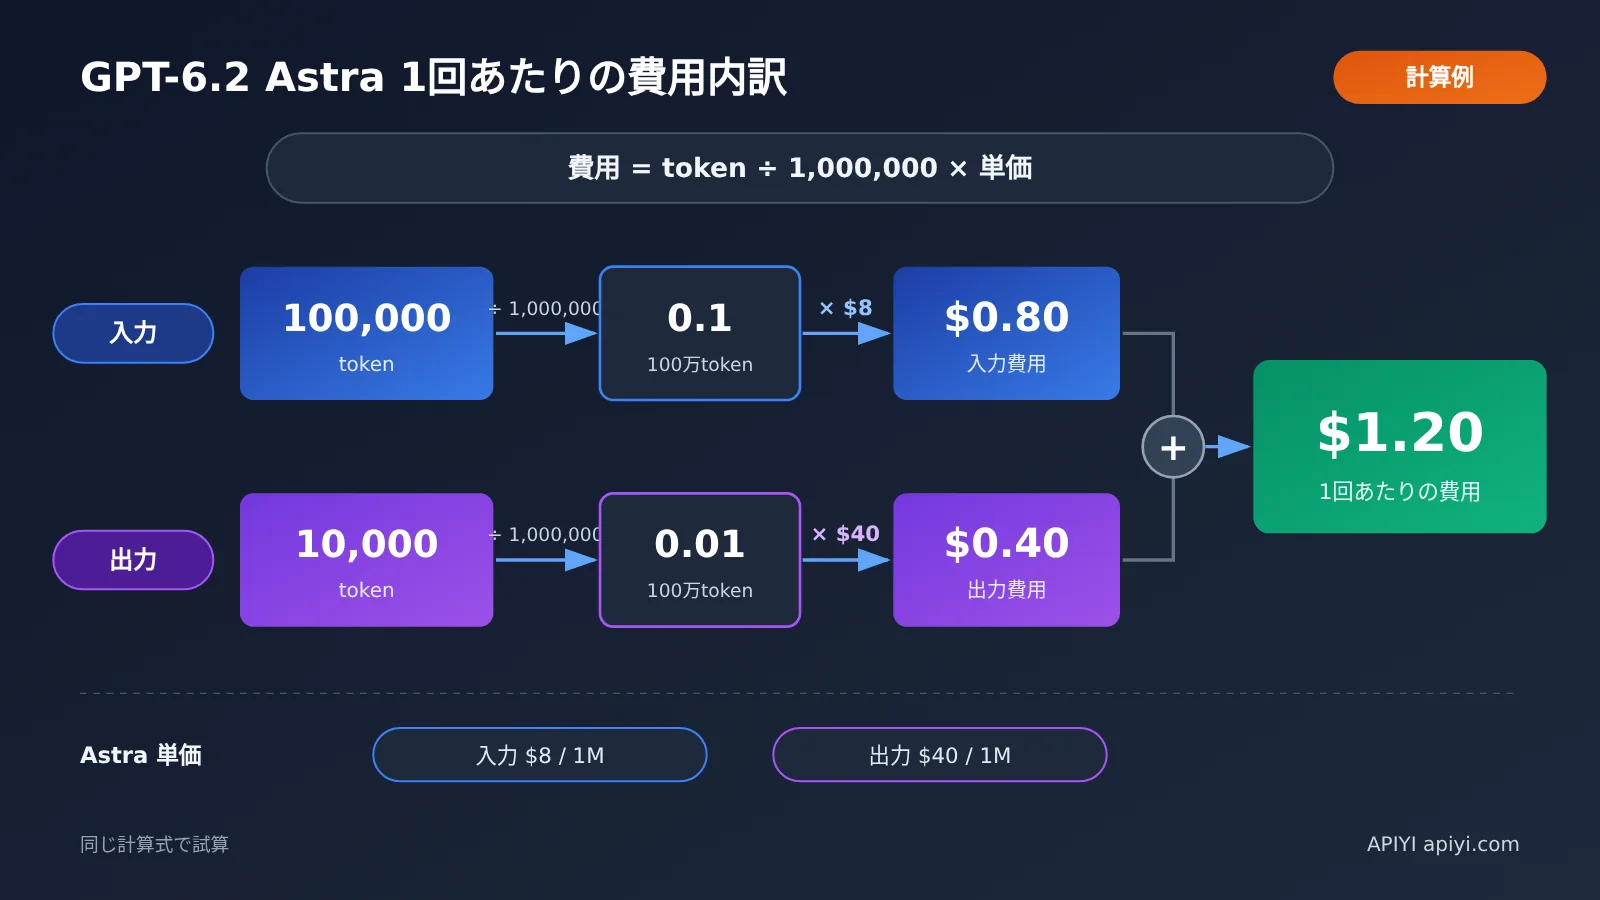
以下の3つの計算例は、公式サイトの標準単価に基づいて私たちが行った算術計算です。APIの実測値ではなく、どのアカウントの実際の請求額を表すものでもありません。計算式は次のとおりです。
費用 = token 数 ÷ 1,000,000 × 100万tokenあたりの単価
計算例1:標準的なリクエスト、新旧AstraとSolの比較
前提条件:非キャッシュ入力100,000 token、出力10,000 token、入力は272K以下、キャッシュの読み書きなし、ツール呼び出しなし、標準価格で課金。
| 項目 | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| 入力費用 | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| 出力費用 | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| 1回あたり合計 | $1.50 | $1.20 | $0.30 |
| GPT-6 Astra との比較 | 基準 | $0.30少ない(-20%) | $1.20少ない(-80%) |
表中の「0.1」は 100,000 ÷ 1,000,000、「0.01」は 10,000 ÷ 1,000,000 を指します。同じリクエストを毎月10,000回送信すると仮定すると、この前提ではGPT-6 Astraが約$15,000、GPT-6.2 Astraが約$12,000となります。この結果はあくまで線形の外挿であり、費用を保証するものではありません。
計算例2:キャッシュにヒットした GPT-6.2 Astra のリクエスト
前提条件:総入力100,000 tokenのうち、80,000 tokenがキャッシュ読み取りにヒット、20,000 tokenがキャッシュに書き込まない通常入力、出力は10,000 token。今回のキャッシュ書き込み量はゼロとし、過去のキャッシュ構築コストは今回の計算例には含めません。
- 非キャッシュ入力:0.02 × $8 = $0.16
- キャッシュ読み取り:0.08 × $0.4 = $0.032
- 出力:0.01 × $40 = $0.40
- 合計:約 $0.592
前世代のGPT-6 Astraのキャッシュ読み取り価格は$1.00/100万token、新版は$0.40で、60%の値下げとなります。同じtoken数で計算すると、前世代の費用は$0.20 + $0.08 + $0.50 = $0.78、新版は$0.592で、$0.188少なく、約24.1%の低下です。いずれもキャッシュ書き込み、ツール、その他の費用は含まれておらず、完全な請求額とは見なせません。
計算例3:272Kを超える GPT-6.2 Astra の長文コンテキストリクエスト
前提条件:通常入力300,000 token(272K超)、出力10,000 token、キャッシュの読み取りと書き込みはいずれもゼロ。
- 入力:0.3 × ($8 × 2) = $4.80
- 出力:0.01 × ($40 × 1.5) = $0.60
- 合計:$5.40
段階的な料金はリクエスト全体に対して計算される点にご注意ください。入力が272Kを超えると、そのリクエストの入力全体が2倍の料率で課金され、超過分だけが割増になるわけではありません。
キャッシュ寿命の設定には Responses API の prompt_cache_options.ttl を使用します。デフォルトは "30m" で、"12h" も選択できます。個別の明示的なブレークポイントでは prompt_cache_breakpoint.ttl で上書き可能です。これは最低キャッシュ寿命を示すものであって、データ削除の期限ではありません。旧モデルの prompt_cache_retention パラメータと混同しないようにしてください。
入力が 272K を超える場合、Standard ティアの Astra では、通常入力、キャッシュ読み取り、30 分の書き込み、12 時間の書き込み、出力がそれぞれ $16、$0.80、$20、$40、$60/100 万トークンとなります。倍率はリクエスト全体に適用され、超過部分だけにかかるわけではありません。
1.5 GPT-6.2 Astra の公式ソース
-
OpenAI 発表のお知らせ: openai.com/index/introducing-gpt-6-2-astra-sol/
- GPT-6 Astra モデルドキュメント:公式の旧モデル価格
- GPT-6.2 Astra モデルドキュメント:公式の新モデル価格と料率条件
- GPT-6.2 Sol モデルドキュメント: developers.openai.com/api/docs/models/gpt-6.2-sol
- OpenAI API 料金ページ: developers.openai.com/api/docs/pricing
- ChatGPT Work と Codex ヘルプドキュメント: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
2. GPT-6.2 Astra の 20% 値下げに関する分析と判断
以下は、上記の事実に基づいて編集部が行った解釈であり、分析と判断に属するものであって、公式の結論ではありません。
2.1 単価が 20% 下がっても、請求額が 20% 下がるとは限らない理由
計算例1で厳密に 20% という結果が得られるのは、非キャッシュ入力と標準出力という2項目だけを含んでおり、しかもこの2項目がちょうど 20% 下がったからです。実際の業務の請求額は通常、複数の費用で構成されており、どれか1項目の比率が変われば、全体の下落率は 20% からずれてしまいます。
| コスト要因 | 実際の請求額への影響の可能性 | 判断の根拠 |
|---|---|---|
| キャッシュ読み取りと書き込み | キャッシュ読み取りの単価は 60% 下落し、非キャッシュ入力の 20% とは異なる。それぞれの token 数で計算する必要があり、全体の下落率をあらかじめ想定することはできない。キャッシュ書き込みは独立した総合レートを使用し、通常の入力費用とは重複しない | 公式価格表 |
| 長コンテキストの段階制 | 272K を超えるとリクエスト全体のレートが上昇し、長文ドキュメントのシナリオでは1回あたりの費用が計算例1より明らかに高くなる可能性がある | 公式課金ルール |
| 出力 / 推論 token 数 | 公式は GDPval v2 で出力 token が 22% 少ないと報告している。あなたのタスクでも同様の変化があれば、節約額は 20% を超える可能性がある。推論のティアがより高ければ、逆に高くつくこともある | 公式評価(特定タスク) |
| ツール呼び出しと速度ティア | GPT-6.2 Astra の Fast は同一コンテキストの Standard レートの2倍、Batch は 50%。ツール費用は使用したツールに応じて別途計算する | 公式モデルページと価格ページ |
| 呼び出しチャネル | APIYI apiyi.com などのサードパーティプラットフォーム経由で呼び出す場合、プラットフォームが公表する実際の課金に従う必要があり、公式価格をそのまま適用することはできない | チャネルの違い |
見落とされやすいポイントは「出力が 22% 少ない」という点です。この数字は GDPval v2 という1つの評価から来ています。これをそのまま全ての業務に当てはめて「実際に 30% 以上節約できる」という結論を出すのは、公式の特定の評価における結果を普遍的な法則とみなすことになります。より慎重な方法は、自分の実際のリクエストで小規模なサンプルテストを行い、usage フィールドの token 数を記録してから判断することです。
2.2 GPT-6.2 Astra と Sol の選定判断
標準単価を見ると、Sol の各項目の価格はすべて Astra の約 1/4 です。計算例1では、Sol の1回あたりの費用は Astra の4分の1にすぎません。FrontierCode 2.0 の結果では、Sol は max 推論モードで Astra との差が小さいものの、この結論が他のタスクにも当てはまるかどうかは公式には示されていません。
したがって私たちの判断は、コストに敏感でタスク難度が中程度の場面では、Sol を優先的に評価する価値がある、というものです。品質要求が高い場合やタスクが複雑な場合でも、Astra の値下げによって導入のハードルは下がりました。最終的にどちらを選ぶかは、自分のタスクセットで A/B 比較を行って決めるべきです。
💡 選定のヒント:同一のコード内で複数モデルの token 消費量と出力品質を比較する必要がある場合は、APIYI apiyi.com のような OpenAI 互換のアグリゲーションインターフェース経由でモデルを切り替えることを検討できます。GPT-6.2 シリーズがプラットフォーム上で公開済みかどうか、価格がいくらかは、プラットフォームのモデル一覧と課金ページを基準にしてください。
2.3 GPT-6.2 Astra のコスト見積もりコード
以下のスクリプトはローカルでの算術計算のみを行い、API は呼び出しません。入力を互いに重複しない4種類(通常入力、キャッシュ読み取り、30分書き込み、12時間書き込み)に分けます。総入力量は 272K の段階判定に用います。書き込み料率は総料率であり、書き込み token に通常入力料金を重ねて加算することはありません。
# OpenAI Standard の料率(米ドル/100万 token)。ツール、税、その他の段階の費用は含まない
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# 同じ10万入力でもすべて30分書き込みで課金:1.2 にさらに 1.0 を加えるわけではない
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Responses の usage については、まずキャッシュ読み取り量と書き込み量を識別し、次に総入力からその2つを引いて通常入力を得るべきです。30分と12時間の寿命が混在する場合は、実際の課金明細に従って書き込み量を配分する必要があり、すべての書き込みに1種類の料率を適用することはできません。チャネルに書き込み明細がない場合や課金の基準が異なる場合は、そのチャネルの請求書で照合してください。書き込み量がゼロであると勝手にみなしてはいけません。課金出力に推論 token が含まれる場合は、推論量を再度加算しないでください。本記事では実際に API を呼び出していません。サードパーティのプラットフォームがこうした設定をサポートするかどうか、どのように課金するかは、そのドキュメントを基準にしてください。
2.4 GPT-6.2 Astra 値下げ後の対応提案
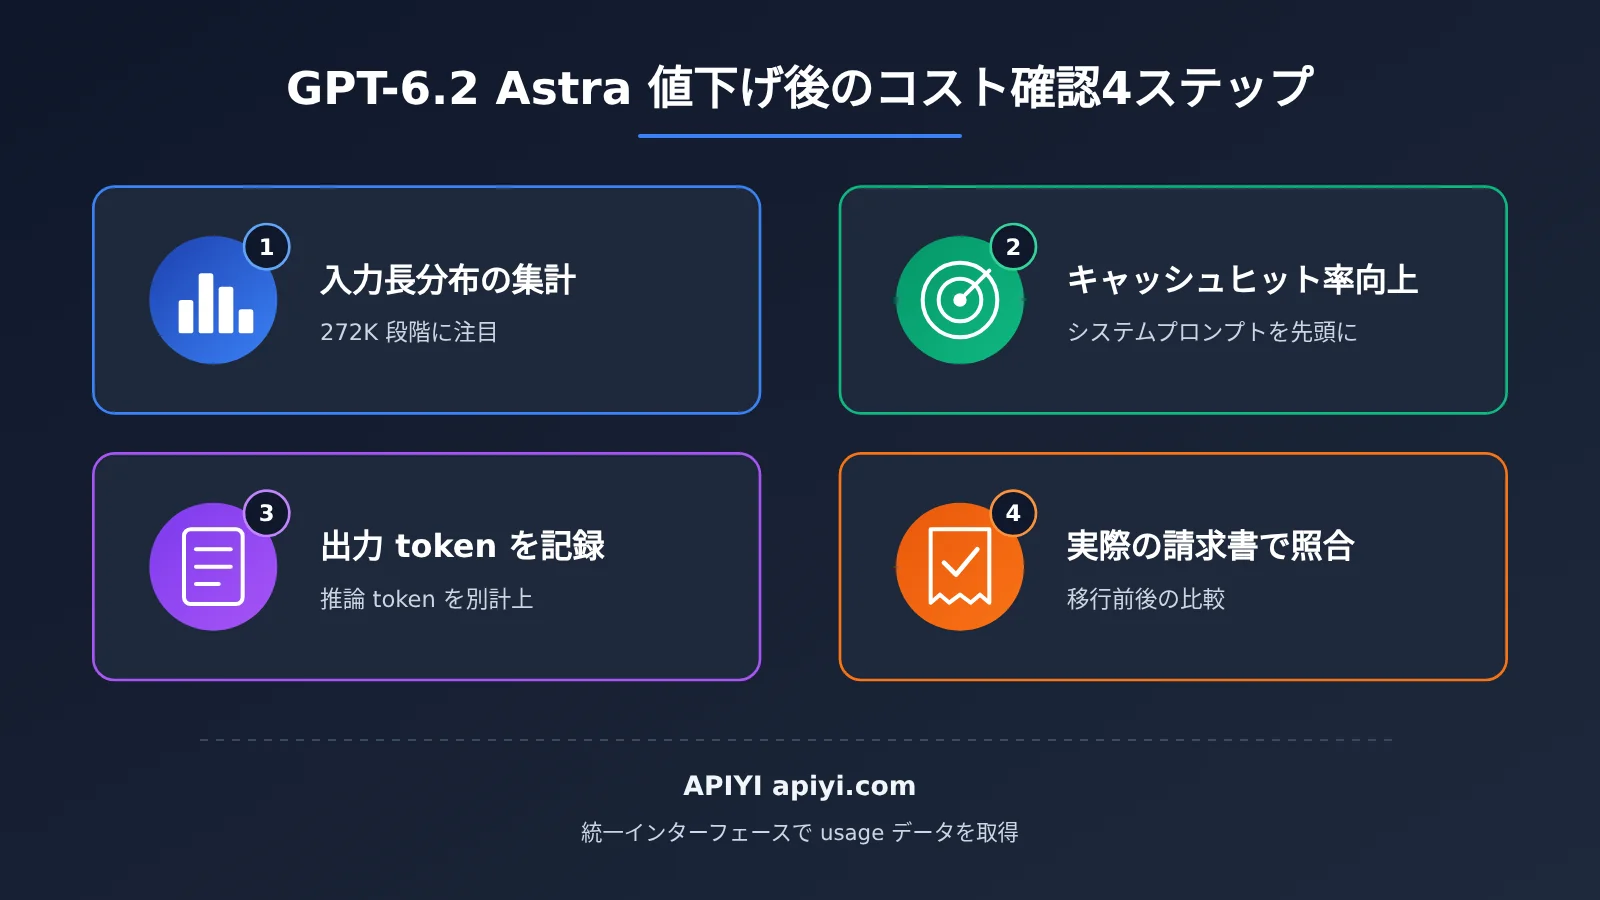
開発者向け:まず既存リクエストの入力長の分布を集計し、どれくらいのリクエストが 272K に近いか、あるいは超えているかを確認しましょう。長コンテキストのリクエスト比率が高い場合は、検索スライシングや要約圧縮などで入力を料金段階内に収めることで、20% の値下げ分よりも多くのコストを削減できる可能性があります。同時に、固定のシステムプロンプトをリクエストの前部に置くことで、キャッシュヒット率を高めましょう。
予算責任者向け:「Astra の標準単価が 20% 下落」は、同等の非キャッシュ入力・出力量における予算基準の参考として扱うのが適切で、実際の削減率の上限や確定した節約額とみなすべきではありません。移行前後の一定期間の実際の請求額を比較し、キャッシュ、長コンテキスト、出力トークンの変化をそれぞれ分けて示すことをおすすめします。APIYI apiyi.com などのプラットフォーム経由で呼び出すチームは、プラットフォームの請求書の課金基準に従う必要もあります。
引き続き注目すべき今後の変化:公式の価格更新、チャネル開放の進捗、そして第三者の独立評価が公式データを再現できるかどうかです。公式はキャッシュ書き込みと速度ティアの料率をすでに明示しているため、試算の際は選択したティアを確認すべきで、未公表と扱うべきではありません。新しい Astra では、Standard の短コンテキストにおいて、30 分保持のキャッシュ書き込みが $10/100万トークン、12 時間が $20/100万トークンです。本文の3つの主な試算例はいずれも今回のキャッシュ書き込み量をゼロと仮定しており、デフォルトの API リクエストに必ず書き込みがないという意味ではありません。
まず課金照合の流れを一通り動かしたい場合は、APIYI apiyi.com で同じコードを使い、異なるモデルの usage データを比較できます。GPT-6.2 シリーズが利用中のチャネルで公開されたら、実際のトークン数を上の試算関数にそのまま代入できます。
20% の値下げは明確なシグナルですが、請求書の数字はリクエストごとに入力がどれだけ長いか、キャッシュがどれだけヒットするか、出力がどれだけあるかで決まります。一つ一つの掛け算を正確に計算するほうが、ある割合を覚えておくより役に立ちます。
“Beware of little expenses; a small leak will sink a great ship.”
——ベンジャミン・フランクリン『Poor Richard’s Almanack』
(小さな出費に気をつけよ。小さな漏れが大きな船を沈める。)