Catatan penulis: Menguji GPT-6 Luna Decisions API dari empat sudut pandang—prinsip, metode pengujian, metrik latensi, dan skenario bisnis—untuk membantu Anda menentukan apakah “pemanggilan berbasis keputusan” lebih cepat dan lebih cocok untuk bisnis Anda dibandingkan pemanggilan model biasa.
Setelah Decisions API dari GPT-6 Luna resmi dirilis, pertanyaan yang paling banyak dibahas pengembang adalah: seberapa cepat sebenarnya ia dibandingkan pemanggilan model biasa, dan bisnis mana yang layak beralih. Artikel ini menguji kemampuan inti, prinsip percepatan, metode pengujian, dan skenario penerapan GPT-6 Luna Decisions API dari sudut pandang integrasi nyata.
Ini bukan sekadar mengulang promosi resmi. Di bawah akun, wilayah, konkurensi, dan petunjuk yang berbeda, perbedaan latensi bisa sangat besar. Karena itu, artikel ini tidak memberikan “pengali tetap” yang berpotensi menyesatkan, melainkan menyediakan seperangkat skrip pengujian yang dapat direproduksi beserta kriteria penilaiannya, agar Anda bisa menarik kesimpulan nyata dari data bisnis Anda sendiri.
Nilai inti: Setelah membaca artikel ini, Anda bisa menggunakan satu skrip Python untuk mengukur perbedaan latensi antara GPT-6 Luna Decisions API dan pemanggilan biasa, serta menilai apakah ia cocok untuk bisnis berbasis keputusan seperti klasifikasi, perutean, peninjauan, dan kontrol risiko.
🎯 Catatan pengujian: Semua kode dalam artikel ini ditulis berdasarkan antarmuka yang kompatibel dengan OpenAI, dan dapat langsung dijalankan melalui APIYI apiyi.com. ID model spesifik, parameter antarmuka, dan penagihan mengikuti dokumentasi resmi serta konsol platform.
Fitur Inti GPT-6 Luna Decisions API
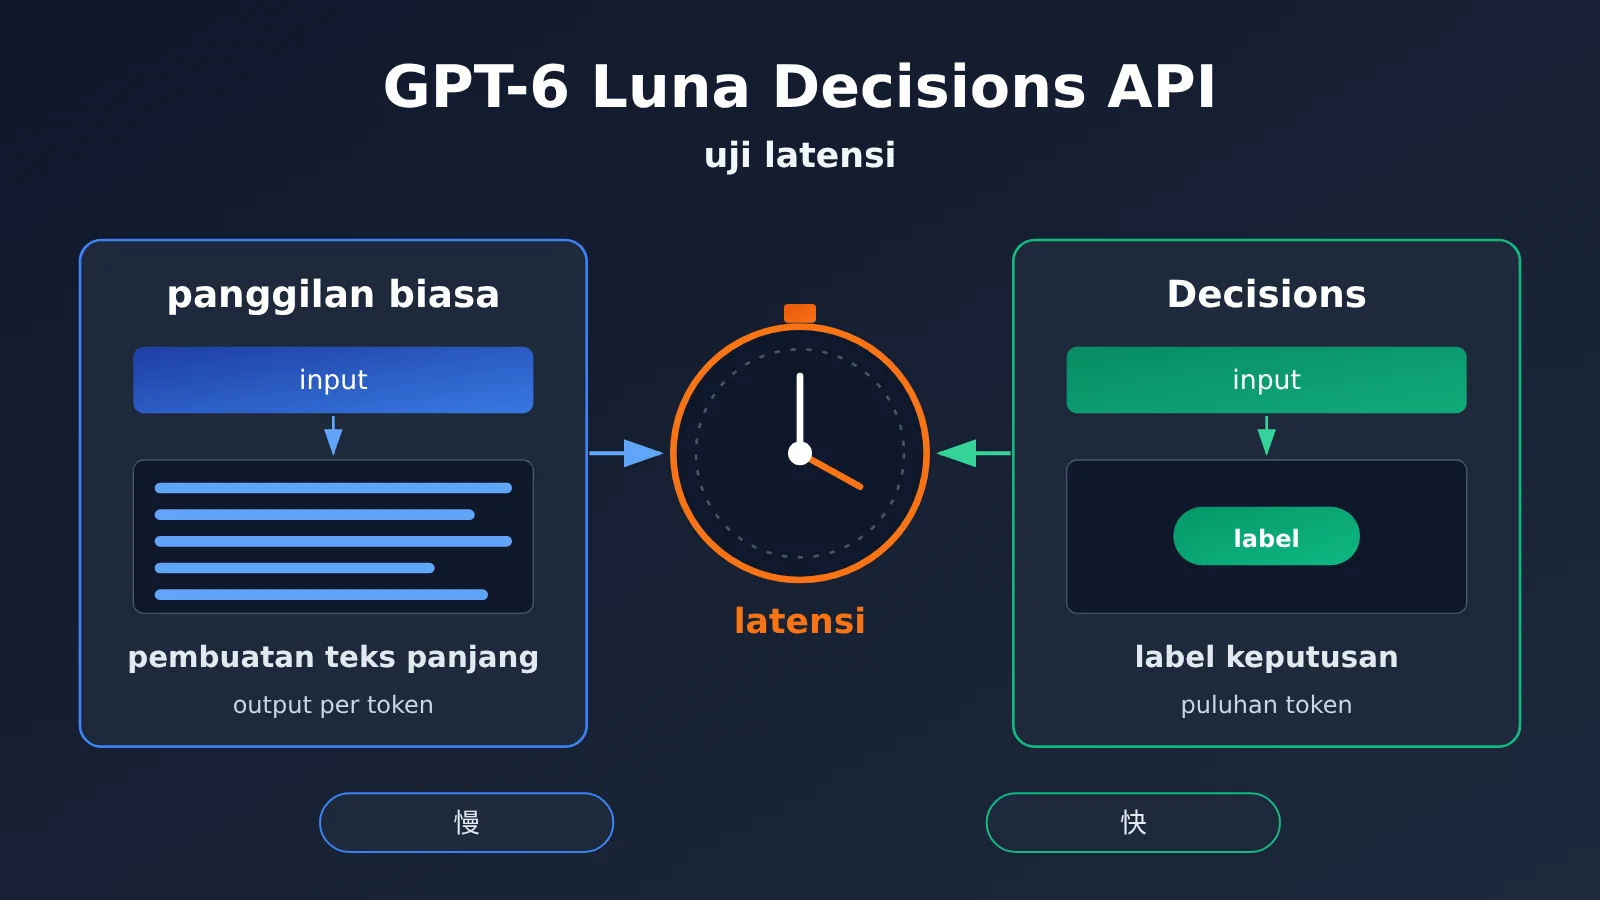
Sebelum memahami Decisions API, pahami dulu perbedaan posisinya dengan pemanggilan percakapan biasa. Tujuan pemanggilan biasa adalah “menghasilkan konten”, sedangkan pemanggilan keputusan bertujuan “memberikan penilaian di antara opsi terbatas”. Panjang output, batasan format, dan komposisi latensi kedua jenis tugas ini sangat berbeda.
| Poin | Penjelasan | Nilai bagi pengembang |
|---|---|---|
| Output keputusan | Output berfokus pada hasil terstruktur seperti label, opsi, skor, bukan teks panjang | Hasil dapat langsung dikonsumsi program, tanpa parsing ulang |
| Output pendek | Hasil keputusan tipikal hanya puluhan token, jauh lebih sedikit daripada tugas generasi biasa | Total waktu respons terutama bergantung pada token pertama dan pemrosesan input |
| Format dapat dibatasi | Dapat dipadukan dengan batasan output terstruktur seperti JSON Schema | Menurunkan tingkat kesalahan format, mengurangi percobaan ulang |
| Cocok untuk pemanggilan frekuensi tinggi | Permintaan seperti perutean, klasifikasi, dan moderasi biasanya berjumlah besar dan sederhana per panggilan | Optimasi latensi dan biaya akan terasa lebih besar |
Perbedaan Decisions API dengan pemanggilan biasa
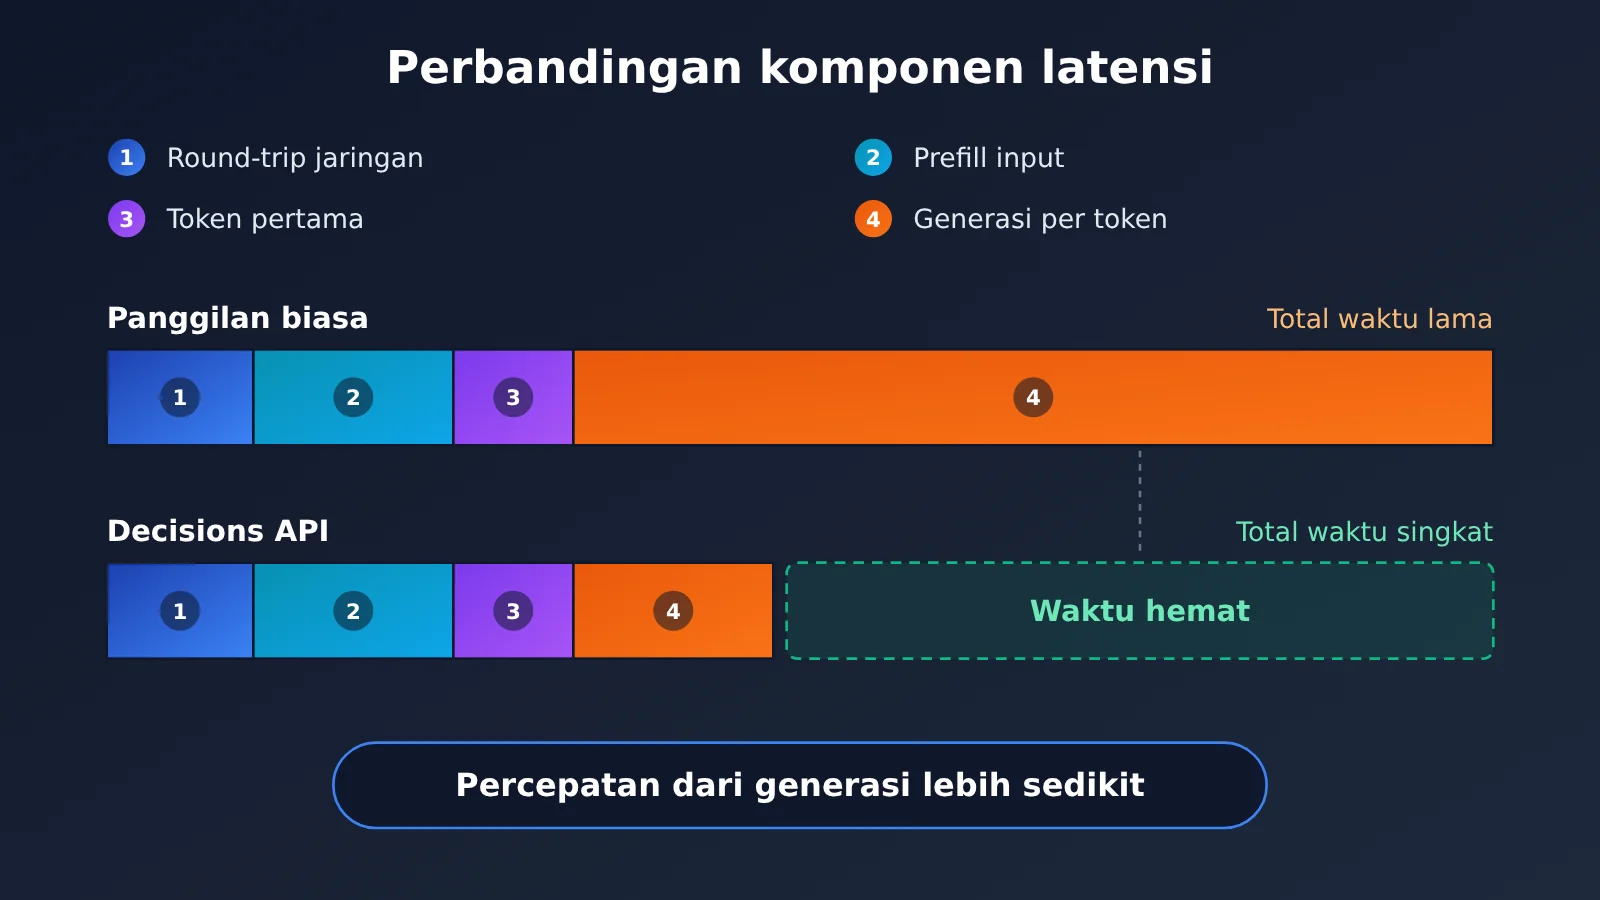
Dari perspektif rekayasa, total waktu pemanggilan model biasa kira-kira terdiri dari tiga bagian: perjalanan bolak-balik jaringan, pemrosesan input (prefill), dan generasi token per token. Pada tugas generatif, bagian ketiga sering mendominasi; semakin panjang output, semakin lambat.
Pemanggilan keputusan memampatkan output menjadi satu hasil terstruktur, sehingga waktu tahap generasi berkurang drastis. Artinya, percepatan GPT-6 Luna Decisions API terutama berasal dari “lebih sedikit menghasilkan”, bukan “menghasilkan lebih cepat”. Jika bisnis Anda memang membutuhkan teks panjang, antarmuka ini bukan untuk Anda.
Sumber percepatan Decisions API
Antarmuka keputusan biasanya juga memberikan keuntungan tambahan di dua aspek. Pertama, format sudah pasti, program tidak perlu memakai regex untuk mengambil jawaban dari bahasa alami, sehingga kemungkinan gagal dan mencoba ulang lebih rendah. Kedua, proses penalaran dapat dikendalikan; jika model mendukung penyesuaian intensitas penalaran, skenario keputusan biasanya tidak memerlukan rantai pemikiran yang panjang, sehingga waktu tunggu berkurang lebih jauh.
Perlu ditekankan bahwa ini semua adalah analisis pada level mekanisme. Besar percepatan aktual bergantung pada panjang output Anda sebelumnya: jika sebelumnya model hanya diminta membalas satu kata, manfaat setelah beralih akan sangat terbatas; jika sebelumnya model diminta “menjelaskan dulu baru memberi kesimpulan”, manfaatnya akan sangat jelas.
Mulai Cepat API GPT-6 Luna Decisions
Contoh Sederhana
Berikut adalah contoh minimal untuk menyelesaikan satu pemanggilan keputusan menggunakan output terstruktur. Ganti nama model dengan ID model GPT-6 Luna sebenarnya yang kamu lihat di konsol platform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI dari APIYI
)

resp = client.chat.completions.create(
    model="gpt-6-luna",  # Sesuaikan dengan nama aktual di daftar model konsol
    messages=[{"role": "user", "content": "Isi tiket: Faktur saya salah. Tolong tentukan departemen penanggung jawabnya."}],
    response_format={"type": "json_object"},
    max_tokens=50
)
print(resp.choices[0].message.content)
Kunci dari kode ini ada pada max_tokens dan response_format: yang pertama membatasi batas atas output, sedangkan yang kedua memastikan hasil bisa diurai oleh program. Kedua parameter inilah yang menjadi inti percepatan pemanggilan tipe keputusan.
Lihat skrip pengujian lengkap (membandingkan latensi pemanggilan biasa dan pemanggilan keputusan)
import time
import json
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Dipanggil melalui antarmuka terpadu APIYI
)

MODEL = "gpt-6-luna"  # Sesuaikan dengan ID model aktual di konsol; jika ada model/antarmuka Decisions terpisah, ganti di sini

SAMPLES = [
    "Faktur saya salah, bisakah dibuat ulang?",
    "Login aplikasi terus menampilkan error kode verifikasi",
    "Ingin mengubah paket dari bulanan ke tahunan",
    "Pesanan menunjukkan sudah diterima tetapi saya belum menerimanya",
]

DECISION_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "route",
        "schema": {
            "type": "object",
            "properties": {
                "department": {"type": "string", "enum": ["finance", "tech", "sales", "logistics"]},
                "confidence": {"type": "number"}
            },
            "required": ["department", "confidence"]
        }
    }
}

def timed_call(prompt: str, mode: str) -> dict:
    """Mengembalikan waktu token pertama, total waktu, dan panjang output"""
    kwargs = dict(model=MODEL, stream=True)
    if mode == "generate":
        kwargs["messages"] = [{"role": "user", "content": f"Tolong analisis tiket berikut dan jelaskan departemen mana yang harus menanganinya beserta alasannya: {prompt}"}]
    else:
        kwargs["messages"] = [{"role": "user", "content": f"Tiket: {prompt}. Hanya keluarkan penilaian departemen."}]
        kwargs["response_format"] = DECISION_SCHEMA
        kwargs["max_tokens"] = 60

    start = time.perf_counter()
    ttft, chunks = None, []
    for event in client.chat.completions.create(**kwargs):
        delta = event.choices[0].delta.content if event.choices else None
        if delta:
            if ttft is None:
                ttft = time.perf_counter() - start
            chunks.append(delta)
    total = time.perf_counter() - start
    return {"ttft": ttft or total, "total": total, "chars": len("".join(chunks))}

def bench(mode: str, rounds: int = 5) -> dict:
    results = [timed_call(p, mode) for _ in range(rounds) for p in SAMPLES]
    totals = sorted(r["total"] for r in results)
    return {
        "mode": mode,
        "ttft_avg": round(statistics.mean(r["ttft"] for r in results), 3),
        "total_p50": round(totals[len(totals) // 2], 3),
        "total_p95": round(totals[int(len(totals) * 0.95) - 1], 3),
        "avg_chars": round(statistics.mean(r["chars"] for r in results), 1),
    }

if __name__ == "__main__":
    for m in ("generate", "decision"):
        print(json.dumps(bench(m), ensure_ascii=False))
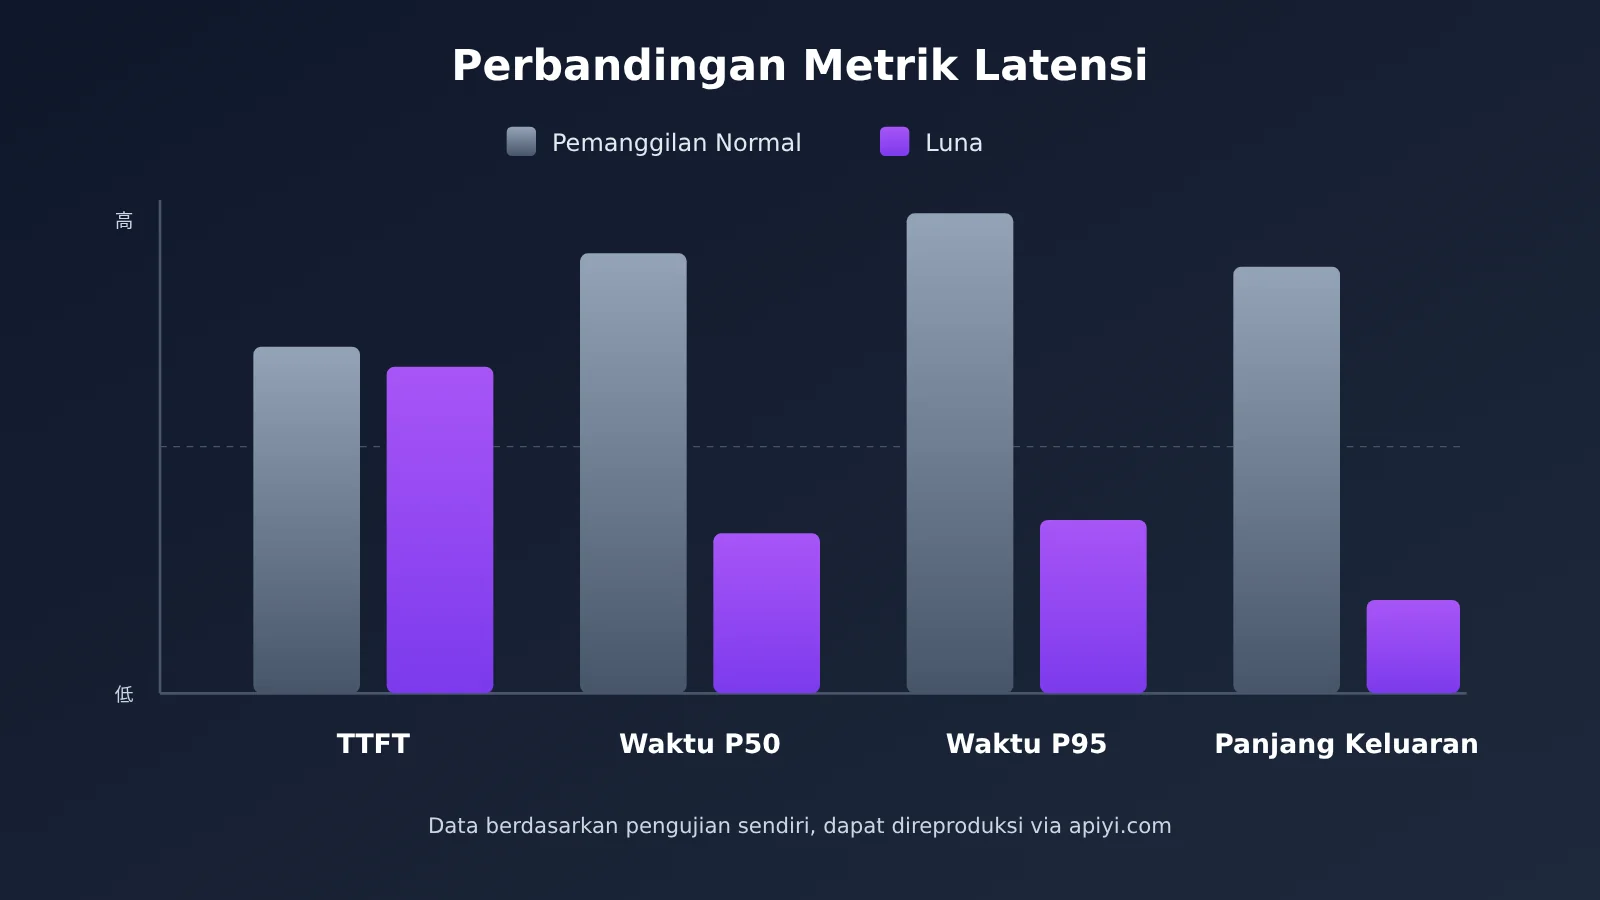
Skrip ini menggunakan output streaming, sehingga bisa mendapatkan waktu token pertama (TTFT) sekaligus total waktu. Disarankan menjalankan setiap mode minimal 20 kali, dan menjalankannya secara bergantian dalam rentang waktu yang sama, untuk menghindari bias akibat fluktuasi jaringan.
🚀 Mulai cepat: Praktik yang direkomendasikan pihak resmi adalah terlebih dahulu mengambil kuota uji coba gratis untuk pengguna baru di APIYI apiyi.com, menjalankan skrip di atas dengan sampel tiket nyata milikmu, lalu baru memutuskan apakah akan memasukkan GPT-6 Luna Decisions API ke lingkungan produksi.
Data pengukuran sebenarnya GPT-6 Luna Decisions API
“Seberapa cepat dibandingkan pemanggilan biasa” tidak memiliki jawaban tunggal, jadi bagian ini menyajikan kerangka evaluasi yang dapat direproduksi. Ikuti lingkungan dan metrik di bawah ini agar angka yang Anda dapatkan benar-benar dapat memandu keputusan bisnis.
Konfigurasi lingkungan pengujian
| Item konfigurasi | Pengaturan yang disarankan | Keterangan |
|---|---|---|
| Titik akses pemanggilan | Antarmuka kompatibel OpenAI (base_url mengarah ke gateway terpadu) | Memastikan kedua mode melewati jalur jaringan yang sama |
| Data sampel | 20-100 permintaan bisnis nyata | Latensi yang diukur dengan data sintetis cenderung terlalu optimis |
| Metode pemanggilan | stream=True |
Hanya dengan ini waktu token pertama dapat diukur |
| Konkurensi | Mulai dari konkurensi tunggal, lalu tingkatkan bertahap hingga puncak bisnis | Amati fluktuasi latensi pada konkurensi tinggi |
| Waktu pengujian | Satu putaran pada jam sibuk dan satu putaran pada jam sepi di hari kerja | Menghilangkan perbedaan beban berdasarkan waktu |
Metrik latensi inti
| Metrik | Arti | Standar penilaian |
|---|---|---|
| TTFT waktu token pertama | Dari permintaan dikirim hingga karakter pertama diterima | Kedua mode biasanya berdekatan, terutama dipengaruhi panjang input |
| P50 total waktu | Berapa lama separuh permintaan dapat diselesaikan | Metrik keunggulan inti mode keputusan, semakin besar selisihnya semakin layak beralih |
| P95 total waktu | Waktu permintaan ekor panjang | Menentukan batas bawah pengalaman pengguna, wajib dilihat untuk bisnis online |
| Rata-rata panjang output | Jumlah karakter atau token yang dikembalikan setiap kali | Menjelaskan alasan percepatan, juga berkaitan langsung dengan biaya |
| Tingkat keberhasilan format | Proporsi hasil yang dapat langsung diurai | Percobaan ulang akibat kegagalan akan memakan waktu yang dihemat |
Cara menafsirkan hasil evaluasi Decisions API
Jika Anda menemukan TTFT kedua mode hampir sama, tetapi selisih P50 total waktu jelas, itu berarti percepatan memang berasal dari “lebih sedikit menghasilkan”, dan ini adalah hasil yang paling sesuai harapan. Pada titik ini Anda dapat membandingkan lebih lanjut rata-rata panjang output; semakin besar selisih keduanya, semakin signifikan waktu dan biaya output yang dihemat.
Jika selisih P50 tidak besar tetapi selisih P95 jelas, itu berarti ekor panjang pemanggilan biasa terutama disebabkan oleh output panjang yang muncul sesekali. Dalam kasus ini, meskipun nilai rata-rata tidak menunjukkan peningkatan mencolok, beralih ke GPT-6 Luna Decisions API tetap dapat secara signifikan meningkatkan stabilitas bisnis online.
Ada juga kasus di mana kedua mode hampir tidak memiliki perbedaan, yang biasanya berarti petunjuk Anda sudah cukup ringkas. Pada titik ini nilai utama peralihan terletak pada keandalan format, bukan kecepatan.
💡 Saran verifikasi: Untuk batch sampel yang sama, disarankan menguji secara bergantian di gateway yang sama. Kami menyarankan langsung menjalankan perbandingan melalui antarmuka terpadu APIYI apiyi.com, untuk menghindari distorsi hasil akibat jalur keluar jaringan yang berbeda.
GPT-6 Luna Decisions API cocok untuk bisnis apa
Nilai antarmuka keputusan (decisions API) bukan terletak pada penghematan beberapa ratus milidetik per panggilan, melainkan pada skenario berfrekuensi tinggi, sederhana, dan hasilnya perlu dikonsumsi oleh program — di sana milidetik tersebut diperbesar oleh ribuan hingga puluhan ribu permintaan. Tabel berikut merangkum tingkat kesesuaian untuk lima kategori bisnis tipikal.
| Skenario bisnis | Output tipikal | Tingkat kesesuaian | Keterangan |
|---|---|---|---|
| Routing tiket layanan pelanggan | Label departemen + skor keyakinan | Tinggi | Volume permintaan besar, pilihan tetap, keuntungan kecepatan dan format sama-sama jelas |
| Moderasi keamanan konten | Lolos / Tolak / Tinjau manual | Tinggi | Sensitif terhadap latensi P95, hasil harus langsung menggerakkan alur |
| Pemilihan alat Agent | Alat mana yang dipanggil beserta parameternya | Tinggi | Setiap langkah dalam Agent multi-langkah menghemat waktu, manfaat keseluruhan terakumulasi |
| Penyaringan awal risiko dan anti-fraud | Tingkat risiko | Sedang | Cocok sebagai penyaring pertama, keputusan kunci tetap butuh aturan atau tinjauan manusia sebagai jaring pengaman |
| Penulisan panjang / pembuatan laporan | Paragraf panjang bahasa natural | Rendah | Memang membutuhkan output panjang, bukan skenario sasaran antarmuka keputusan |
Perbandingan solusi: Decisions API vs solusi keputusan lain
Untuk tugas berbasis keputusan, Model Bahasa Besar bukan satu-satunya pilihan. Tabel berikut membandingkan GPT-6 Luna Decisions API dengan beberapa pendekatan umum.
| Solusi | Karakteristik inti | Skenario cocok | Tingkat latensi | Platform tersedia |
|---|---|---|---|---|
| GPT-6 Luna Decisions API | Pemahaman Model Bahasa Besar + output pendek terstruktur | Keputusan dengan semantik kompleks namun opsi jelas | Rendah (bergantung pada pengujian sendiri) | APIYI apiyi.com, API resmi |
| Panggilan generatif biasa | Fleksibel, bisa menyertakan penjelasan | Keputusan frekuensi rendah yang butuh alasan | Sedang hingga tinggi, meningkat seiring panjang output | Platform Model Bahasa Besar mainstream |
| Klasifikasi model kecil ringan | Murah dan cepat, tetapi pemahaman terbatas | Klasifikasi dengan semantik sederhana dan anotasi memadai | Rendah | Platform Model Bahasa Besar mainstream atau deployment mandiri |
| Rule engine | Tingkat milidetik, sepenuhnya terkendali | Aturan dengan kondisi jelas dan hampir tidak berubah | Sangat rendah | Dibangun sendiri |
Analisis pembanding: Rule engine tetap unggul dalam kecepatan dan kendali, tetapi saat menghadapi input lisan yang beragam, biaya pemeliharaan aturan akan melonjak tajam. Model kecil ringan punya keunggulan biaya yang jelas, namun pemahamannya kurang terhadap semantik ambigu dan konteks panjang. Sebagai pembanding, GPT-6 Luna Decisions API lebih cocok untuk skenario “semantik kompleks tetapi ruang jawaban terbatas”, menjadi pilihan tengah antara aturan dan panggilan Model Bahasa Besar biasa.
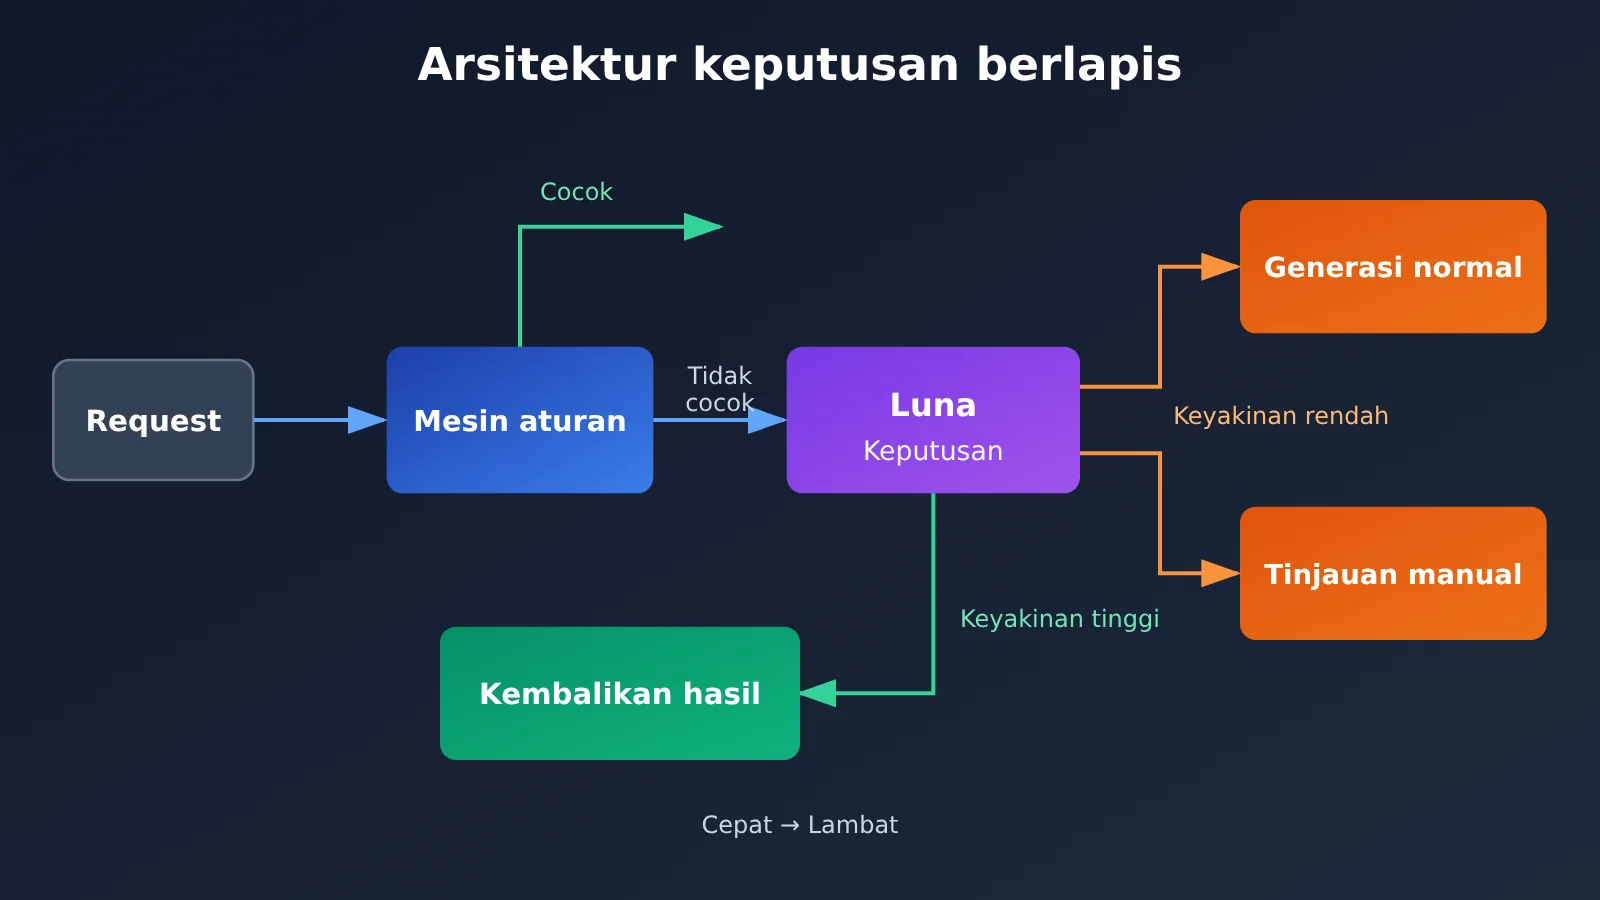
Dalam praktik, pendekatan yang lebih umum adalah arsitektur berlapis: rule engine menangani kondisi yang jelas, GPT-6 Luna Decisions API menangani permintaan ambigu, dan hanya saat penjelasan dibutuhkan barulah beralih ke panggilan generatif biasa.
Analisis Kelebihan dan Kekurangan API GPT-6 Luna Decisions
Kelebihan
- Total waktu proses lebih terkendali: output dipadatkan menjadi hasil terstruktur, sehingga waktu di tahap generasi berkurang signifikan dan latensi ekor panjang jadi lebih stabil.
- Hasil bisa langsung dipakai: berkat JSON Schema, nilai kembalian dapat langsung masuk ke alur bisnis, mengurangi kode parsing dan percobaan ulang yang gagal.
- Struktur biaya lebih ramah: berkurangnya token output berarti biaya output ikut turun, dan ini terasa jelas terutama pada skenario dengan frekuensi tinggi.
- Ambang integrasi rendah: berbasis protokol yang kompatibel dengan OpenAI, kode yang sudah ada biasanya cukup menyesuaikan nama model dan batasan output untuk beralih.
Keterbatasan
- Tidak jago menjelaskan: hasil keputusan tidak disertai alasannya. Saat perlu audit, Anda bisa mengirim satu panggilan biasa tambahan untuk sampel dengan tingkat keyakinan rendah agar penjelasannya lengkap.
- Besaran percepatan berbeda-beda per skenario: kalau panggilan lama sudah hanya mengeluarkan satu label, manfaat beralih jadi terbatas. Sebaiknya kuantifikasi dulu dengan skrip evaluasi sebelum migrasi.
- Panjang input masih jadi hambatan: API tipe keputusan mengoptimalkan sisi output, sementara waktu prefill untuk konteks super panjang tidak otomatis hilang. Bila perlu, lakukan pemangkasan input atau kompresi hasil retrieval lebih dulu.
- Bergantung pada kualitas desain opsi: definisi nilai enum yang tidak jelas membuat model goyah di antara opsi yang mirip, jadi berikan opsi yang jelas dan saling eksklusif di dalam Schema.
FAQ Pertanyaan Umum
Q1: Apa itu GPT-6 Luna Decisions API?
Ini adalah cara pemanggilan yang dirancang untuk tugas-tugas pengambilan keputusan. Inti utamanya adalah membuat model mengeluarkan hasil penilaian yang singkat dan terstruktur dari pilihan yang diberikan, bukan menghasilkan teks panjang. Cocok untuk skenario seperti klasifikasi, routing, moderasi, dan pemilihan tool. Untuk parameter spesifik, silakan mengacu pada dokumentasi resmi.
Q2: Seberapa cepat Decisions API dibandingkan pemanggilan model biasa?
Tidak ada angka pengali yang seragam. Peningkatan kecepatan terutama berasal dari pemendekan panjang output—semakin panjang output sebelumnya, semakin besar manfaat yang didapat setelah beralih. Sebaiknya gunakan skrip pengujian di artikel ini untuk membandingkan total waktu P50 dan P95 pada sampel nyata Anda, sehingga Anda bisa menarik kesimpulan yang sesuai dengan bisnis Anda.
Q3: Apa perbedaan antara GPT-6 Luna Decisions API dan pemanggilan biasa ditambah output JSON?
Pemanggilan biasa dengan batasan JSON juga bisa mencapai efek serupa. Selisih antara keduanya bergantung pada apakah pihak resmi melakukan optimasi khusus untuk skenario pengambilan keputusan, misalnya pada intensitas penalaran, batasan output, dan penjadwalan layanan. Cara paling andal untuk menilai tetap melalui perbandingan pengujian langsung pada kondisi yang sama.
Q4: Bisnis mana yang paling cocok untuk beralih lebih dulu?
Prioritaskan bisnis dengan volume permintaan besar, ruang jawaban yang tetap, dan sensitif terhadap latensi, seperti routing tiket layanan pelanggan, moderasi konten, dan pemilihan tool pada Agent. Bisnis yang memang membutuhkan output panjang seperti penulisan artikel panjang atau pembuatan laporan tidak disarankan untuk beralih.
Q5: Bagaimana cara memanggil GPT-6 Luna Decisions API dengan cepat melalui API?
Disarankan mengikuti langkah-langkah berikut:
1. Kunjungi APIYI apiyi.com untuk mendaftar akun dan mendapatkan kunci API
2. Konfirmasi ID model GPT-6 Luna yang sebenarnya pada daftar model di konsol
3. Atur `base_url` pada kode di artikel ini menjadi `https://api.apiyi.com/v1` dan ganti nama model lalu jalankan
Platform ini menggunakan antarmuka yang kompatibel dengan OpenAI, sehingga satu kunci API bisa sekaligus dipakai untuk memanggil model-model utama lainnya sebagai pembanding.
Q6: Bagaimana cara mengendalikan biaya pemanggilan Decisions API?
Output bertipe keputusan memang sudah menghemat token output. Optimasi lebih lanjut bisa dilakukan dari tiga sisi: memangkas konteks yang tidak perlu, menggunakan mesin aturan untuk menyaring permintaan yang jelas, dan hanya melakukan pemanggilan ulang untuk sampel dengan tingkat keyakinan rendah. Di konsol APIYI apiyi.com Anda dapat melihat rincian penggunaan per model, sehingga memudahkan untuk melacak sumber biaya terbesar.
Q7: Apa saja keterbatasan yang diketahui dari GPT-6 Luna Decisions API?
Keterbatasan utamanya adalah tidak disediakannya alasan keputusan, peningkatan kecepatan bergantung pada panjang output sebelumnya, dan waktu prefill untuk input yang sangat panjang tidak dapat dihilangkan. Untuk keputusan berisiko tinggi seperti di bidang keuangan dan medis, disarankan untuk menjadikannya sebagai penilaian pendukung dan tetap menyertakan tahap tinjauan manusia.
Poin Penting GPT-6 Luna Decisions API (Key Takeaways)
- Posisi yang jelas: Decisions API menyelesaikan masalah “penilaian cepat di antara opsi terbatas”, bukan pembuatan teks panjang.
- Sumber percepatan: terutama berasal dari output yang lebih pendek. Semakin panjang output aslinya, semakin terasa manfaat beralih ke API ini.
- Metrik kunci: fokus pada total waktu P50 dan P95. TTFT pada kedua mode biasanya berdekatan.
- Skenario terbaik: tugas keputusan berfrekuensi tinggi seperti perutean tiket, moderasi konten, dan pemilihan tool oleh Agent.
- Arsitektur yang disarankan: skema fallback berlapis yang menggabungkan rule engine + Decisions API + pemanggilan biasa.
- Cara memulai: jalankan skrip perbandingan melalui antarmuka kompatibel OpenAI yang seragam, lalu migrasi berdasarkan data pengujian Anda sendiri.
Ringkasan
Poin inti GPT-6 Luna Decisions API:
- Cepat karena sedikit menghasilkan: keunggulan kecepatannya terutama datang dari output terstruktur yang pendek, bukan dari peningkatan kecepatan generasi per token.
- Nilainya tergantung skenario: bisnis dengan frekuensi tinggi, pilihan opsi tetap, dan sensitif terhadap latensi akan mendapat manfaat terbesar. Skenario teks panjang tidak cocok.
- Kesimpulan harus dari pengukuran nyata: besaran percepatan sangat bervariasi tergantung petunjuk dan sampel, jadi pastikan mengukur P50 dan P95 dengan data asli Anda.
Jika Anda sedang mengerjakan perutean layanan pelanggan, moderasi konten, atau orkestrasi Agent, GPT-6 Luna Decisions API layak dievaluasi dengan serius. Sebaiknya pertahankan pemanggilan lama sebagai kelompok pembanding, alihkan sebagian trafik secara bertahap (canary), lalu putuskan migrasi penuh berdasarkan latensi dan tingkat keberhasilan format.
Disarankan mengambil kuota gratis melalui APIYI apiyi.com, lalu menggunakan skrip di artikel ini untuk memverifikasi dengan cepat percepatan nyata pada skenario bisnis Anda.
📚 Referensi
- Dokumentasi Resmi OpenAI API: Penjelasan tentang pemanggilan model, output streaming, dan output terstruktur
- Tautan:
platform.openai.com/docs -
Keterangan: Sumber otoritatif untuk mengonfirmasi parameter terkait GPT-6 Luna dan Decisions
-
OpenAI Python SDK: Klien Python resmi
- Tautan:
github.com/openai/openai-python -
Keterangan: SDK yang digunakan oleh skrip pengujian dalam artikel ini, termasuk contoh pemanggilan streaming
-
Spesifikasi JSON Schema: Standar definisi untuk batasan output terstruktur
- Tautan:
json-schema.org - Keterangan: Referensi spesifikasi saat merancang opsi keputusan dan nilai enumerasi
Penulis: Tim Teknis APIYI
Diskusi Teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Informasi integrasi lebih lanjut dapat diakses di pusat dokumentasi docs.apiyi.com