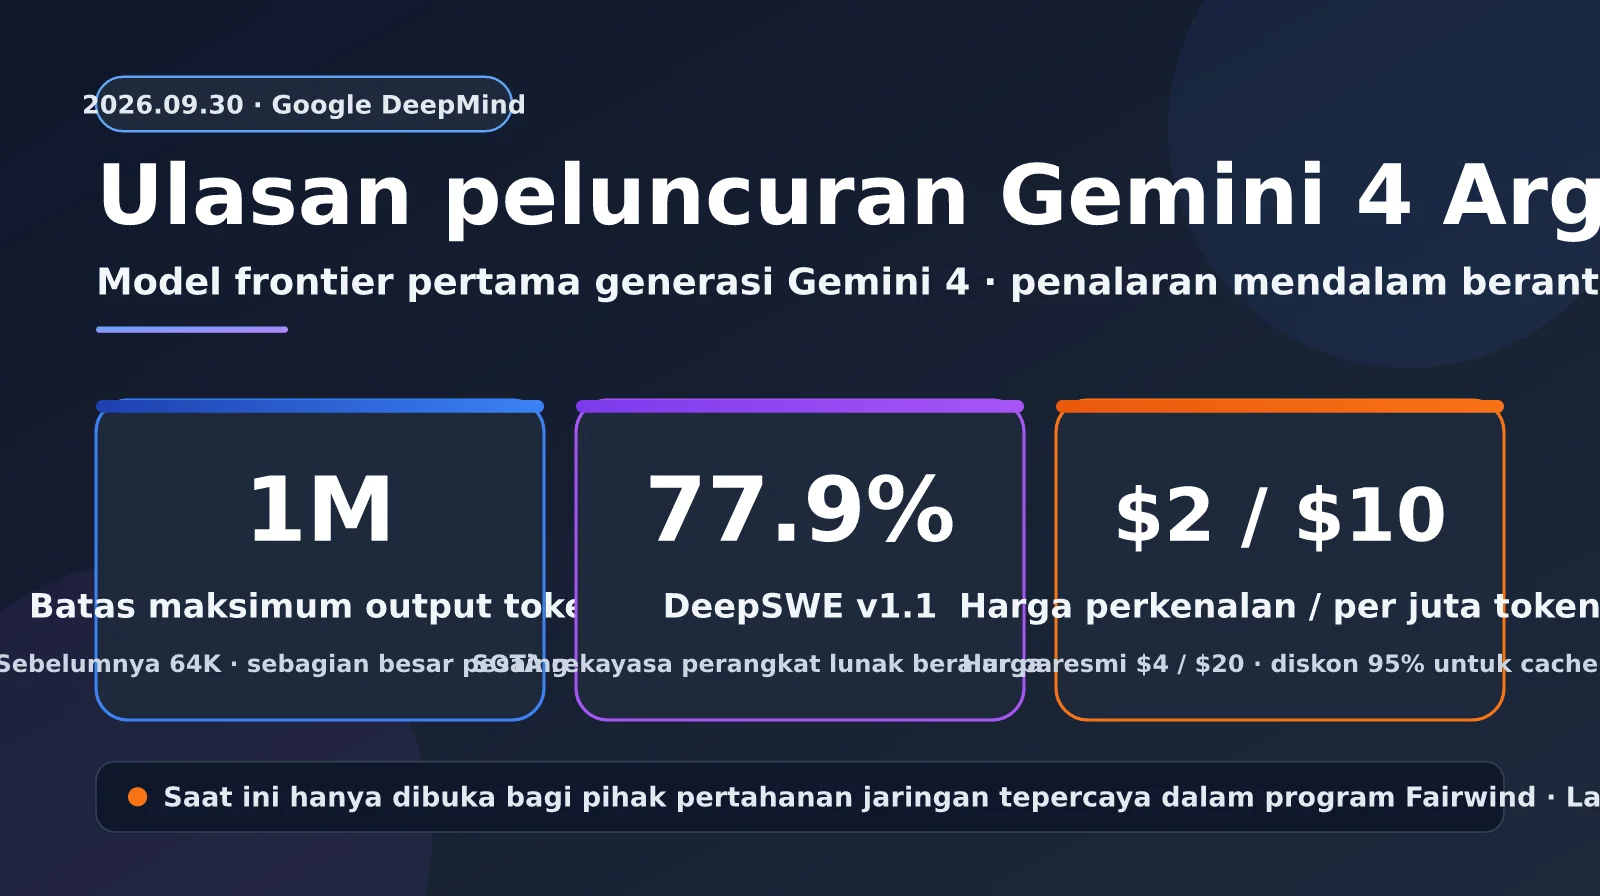
Setelah beralih dari gemini-3.1-pro-preview ke Gemini 4 Argon, banyak developer menemukan masalah: dengan petunjuk yang sama, jawaban Argon terkadang justru terasa “kurang mendalam”. Penyebabnya kemungkinan besar adalah nilai default tingkat penalaran Gemini 4 Argon. Menurut dokumentasi resmi Google, nilai default thinking_level Gemini 4 Argon adalah medium, bukan high. Sementara itu, nilai default gemini-3.1-pro-preview adalah level tertinggi, yaitu high. Jika kode atau klien yang Anda gunakan tidak pernah mengatur tingkat penalaran secara eksplisit, kedalaman penalaran model bisa diam-diam turun satu level setelah migrasi.
Yang lebih merepotkan, klien percakapan yang umum digunakan seperti Cherry Studio sering terlambat mendukung parameter penalaran model baru. Opsi tingkat penalaran mungkin bahkan tidak muncul di kolom input. Artikel ini akan menjelaskan nilai dan default tingkat penalaran Gemini 4 Argon serta dampaknya terhadap biaya, lalu menunjukkan tiga cara untuk mengaturnya: melalui API native, antarmuka yang kompatibel dengan OpenAI, dan parameter khusus di Cherry Studio.
Manfaat utama: Setelah membaca artikel ini, Anda bisa mengatur tingkat penalaran Gemini 4 Argon ke level yang diinginkan melalui cara pemanggilan apa pun, sekaligus menghindari masalah migrasi seperti pemotongan max_tokens dan error parameter 400.
Poin Penting tentang Tingkat Penalaran Gemini 4 Argon
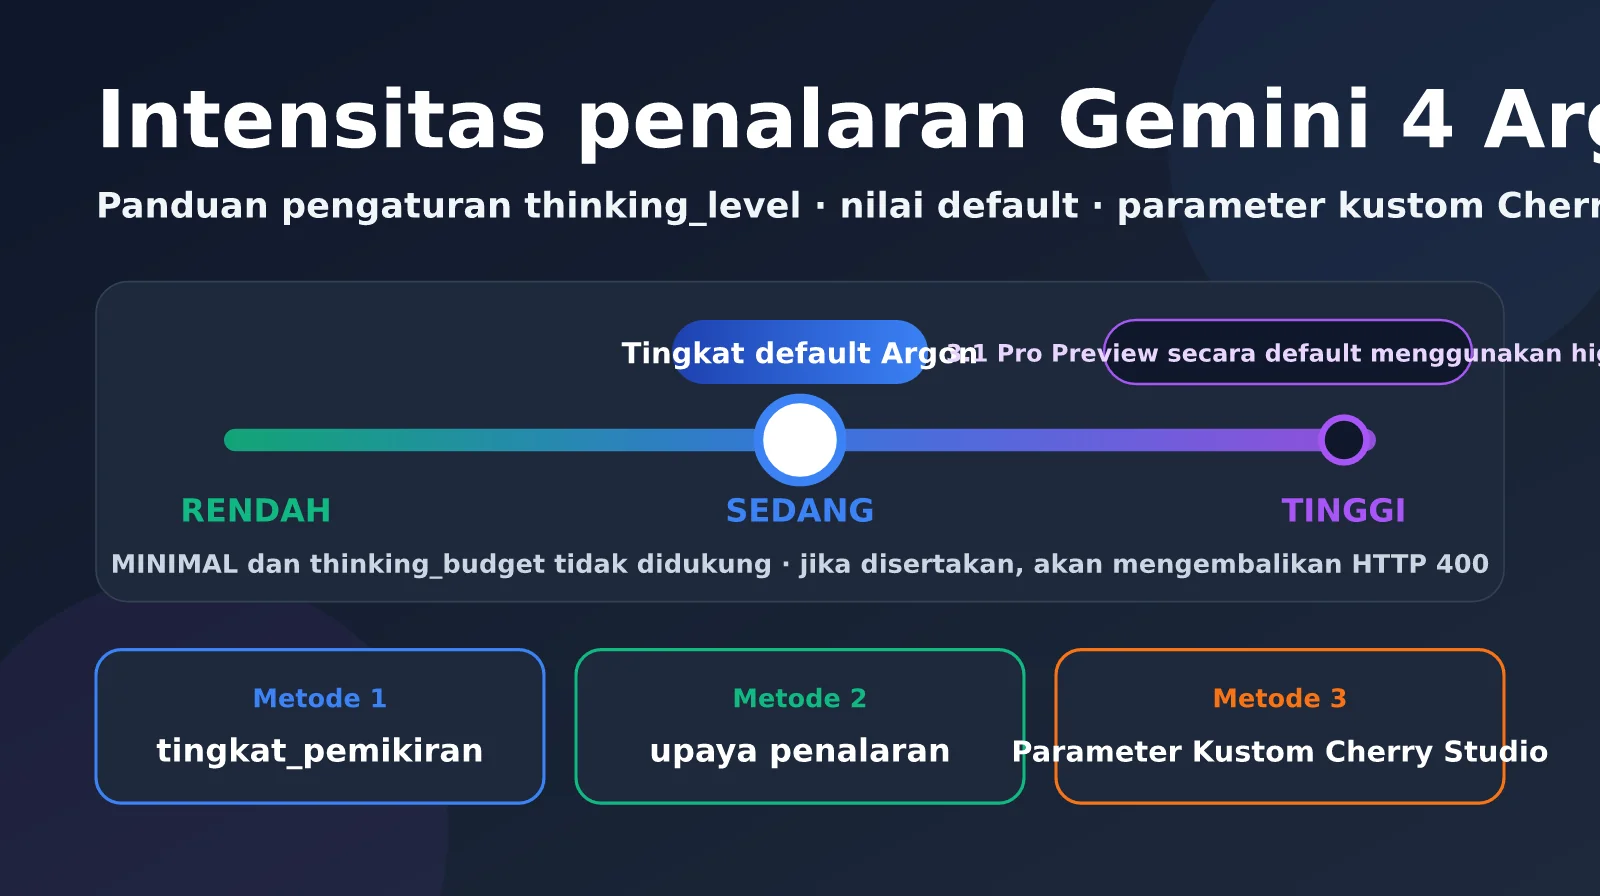
Gemini 4 Argon menggunakan parameter thinking_level untuk mengatur tingkat penalaran, dengan tiga pilihan: low, medium, dan high. Dibandingkan model generasi sebelumnya, Argon tidak lagi mendukung thinking_budget yang ditentukan berdasarkan jumlah token dan juga tidak mendukung level minimal. Mengatur salah satu dari keduanya akan langsung menghasilkan error HTTP 400. Tabel berikut merangkum penjelasan resmi untuk ketiga level dalam panduan developer Google Cloud.
| Tingkat penalaran | Default? | Skenario yang direkomendasikan secara resmi | Karakteristik |
|---|---|---|---|
| LOW | Tidak | Klasifikasi, ringkasan, ekstraksi metadata | Latensi paling rendah, hampir tidak menghasilkan token penalaran |
| MEDIUM | ✅ Default gemini-4-argon | Pemrograman umum, pemanggilan alat, tanya jawab dokumen, pemahaman video | Keseimbangan antara kecepatan, biaya, dan akurasi |
| HIGH | ✅ Default versi cyber-permissive | Rekayasa perangkat lunak multi-file, pembuktian formal, desain arsitektur, pencarian kerentanan | Penalaran paling mendalam, latensi token pertama dan biaya meningkat signifikan |
| MINIMAL | Tidak didukung | — | Menghasilkan error HTTP 400 jika diatur |
| thinking_budget | Tidak didukung | — | Model generasi sebelumnya akan memetakannya secara diam-diam, tetapi Argon langsung menghasilkan error 400 |
Perlu diperhatikan bahwa versi gemini-4-argon-cyber-permissive, yang ditujukan bagi pihak pertahanan siber dalam program Fairwind, menggunakan HIGH sebagai nilai default. Hanya versi standar gemini-4-argon yang menggunakan MEDIUM sebagai default. Selain itu, semua hasil evaluasi Argon yang tercantum dalam tabel Google diperoleh pada tingkat penalaran tertinggi. Jika Anda menggunakan nilai default medium, performa yang didapat mungkin tidak setara dengan yang ditampilkan dalam promosi resmi.
Perbandingan Nilai Default Tingkat Penalaran Gemini 4 Argon dan Model Sebelumnya
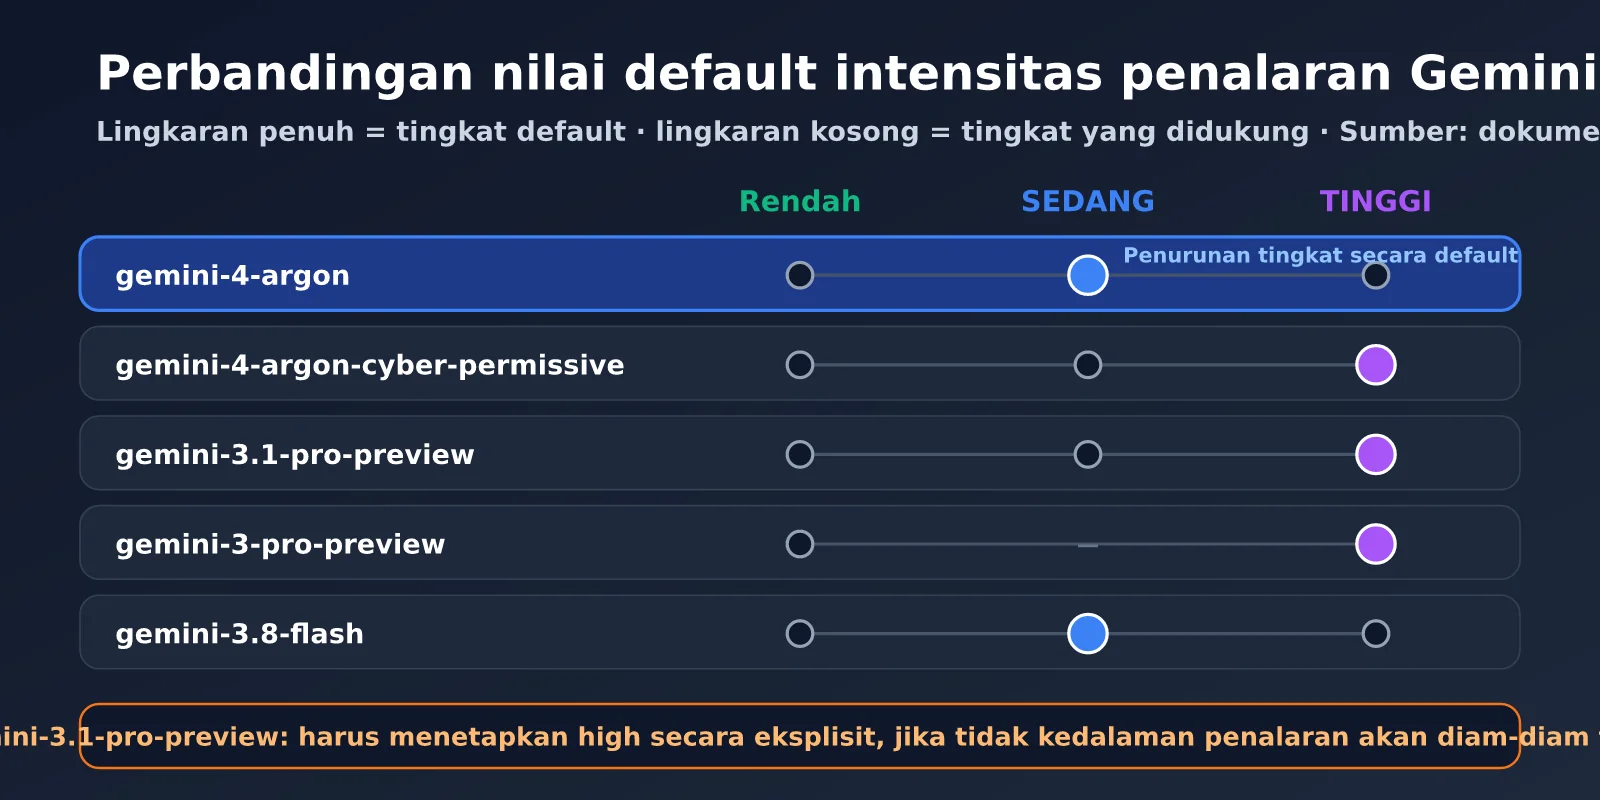
Dengan membandingkan nilai default penalaran Gemini 4 Argon dengan beberapa model Gemini terbaru, kita bisa melihat risiko yang perlu diperhatikan saat migrasi. Data berikut berasal dari dokumentasi resmi Gemini API Google tentang thinking.
| Model | Tingkat penalaran default | Tingkat yang didukung |
|---|---|---|
| gemini-4-argon | medium | low, medium, high |
| gemini-4-argon-cyber-permissive | high | low, medium, high |
| gemini-3.1-pro-preview | high | low, medium, high |
| gemini-3-pro-preview | high | low, high |
| gemini-3.8-flash | medium | low, medium, high |
| gemini-3-flash-preview | high | minimal, low, medium, high |
Terlihat bahwa Google mulai menurunkan tingkat penalaran default model generasi baru dari high ke medium. Gemini 3.8 Flash dan Gemini 4 Argon sama-sama menggunakan nilai default medium. Langkah ini dapat mengurangi latensi dan biaya default, tetapi bagi pengguna yang terbiasa dengan “penalaran maksimal secara default” pada 3.1 Pro, Anda perlu mengatur high secara eksplisit saat beralih ke Argon agar kedalaman penalarannya tetap sama.
🎯 Saran migrasi: Saat beralih dari gemini-3.1-pro-preview ke Gemini 4 Argon, sebaiknya atur tingkat penalaran secara eksplisit di kode, lalu bandingkan kualitas output kedua model. Melalui antarmuka terpadu platform APIYI apiyi.com, Anda bisa memanggil kedua model Gemini—yang baru maupun sebelumnya—untuk melakukan perbandingan A/B. Anda hanya perlu mengubah parameter
model.
Hubungan Tingkat Penalaran Gemini 4 Argon dengan Biaya
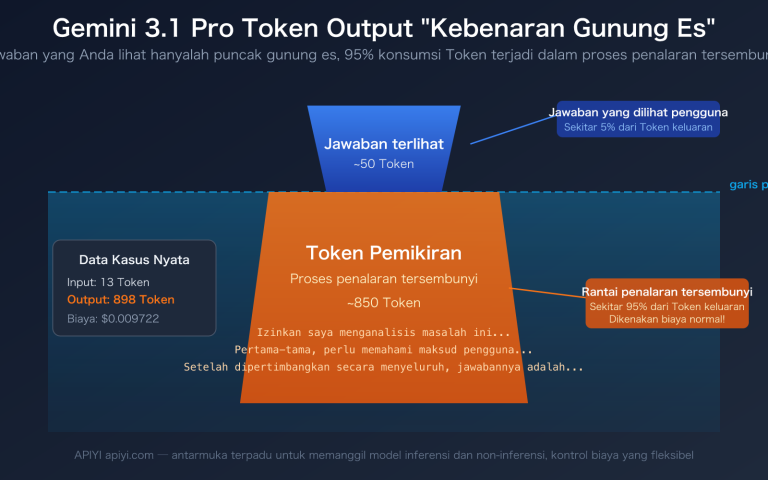
Tingkat penalaran tidak hanya memengaruhi kualitas jawaban, tetapi juga menentukan biaya secara langsung. Token penalaran Argon dikenai biaya dengan tarif output, yaitu $10 per juta token selama periode perkenalan dan $20 setelah harga resmi berlaku. Sementara itu, proses penalaran biasanya tidak ditampilkan secara lengkap kepada pengguna. Artinya, semakin tinggi level yang digunakan, semakin besar biaya yang Anda keluarkan untuk “penalaran yang tak terlihat”.
Sebagai perkiraan kasar berdasarkan harga perkenalan, satu permintaan dengan level high yang menghasilkan 1.500 token penalaran akan menambah biaya sekitar $0,015 hanya untuk proses penalaran. Jika Anda melakukan 10.000 pemanggilan per hari, dalam sebulan biaya tambahannya bisa mencapai sekitar $4.500. Ini juga menjadi salah satu pertimbangan Google saat menurunkan level default Argon ke medium: sebagian besar permintaan sehari-hari tidak membutuhkan penalaran paling mendalam, dan level high sebagai default akan membuat banyak pengguna membayar untuk proses penalaran yang tidak mereka perlukan. Karena itu, cara yang lebih masuk akal adalah memilih level berdasarkan jenis tugas, bukan menetapkan high untuk semua permintaan.
3 Cara Mengatur Tingkat Penalaran Gemini 4 Argon
Tergantung cara pemanggilannya, ada tiga cara untuk mengatur tingkat penalaran Gemini 4 Argon: thinking_level di Google SDK native, reasoning_effort di antarmuka yang kompatibel dengan OpenAI, dan meneruskan parameter native Google melalui extra_body. Ketiganya tidak boleh digunakan sekaligus karena akan menyebabkan error.
| Cara pengaturan | Lokasi parameter | Nilai yang tersedia | Skenario penggunaan |
|---|---|---|---|
| thinking_level native | thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK, Vertex AI |
| reasoning_effort yang kompatibel dengan OpenAI | reasoning_effort di tingkat teratas isi permintaan |
minimal / low / medium / high | OpenAI SDK dan berbagai klien kompatibel |
| Meneruskan melalui extra_body | extra_body.google.thinking_config |
low / medium / high | Saat perlu mengaktifkan opsi native lain, seperti ringkasan pemikiran |
reasoning_effort pada antarmuka yang kompatibel dengan OpenAI akan dipetakan ke thinking_level Argon. Menurut tabel pemetaan resmi Google, minimal dan low sama-sama dipetakan ke low, medium dipetakan ke medium, dan high dipetakan ke high. Namun, Argon tidak mengenali tingkat yang lebih tinggi seperti xhigh dan max yang digunakan OpenAI dan Anthropic. Jika dikirim, permintaan akan langsung mengembalikan error 400.
Cara 1: Mengatur thinking_level melalui SDK native
Saat menggunakan Google GenAI SDK, cukup tentukan tingkatnya langsung di ThinkingConfig. Endpoint Vertex AI mendukung tiga region: global, us, dan eu.
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
Cara 2: Mengatur reasoning_effort melalui antarmuka yang kompatibel dengan OpenAI
Jika proyek Anda menggunakan OpenAI SDK, memanggil Argon melalui antarmuka kompatibel adalah cara yang paling minim perubahan. Anda hanya perlu menambahkan parameter reasoning_effort.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
Lihat kode lengkap: meneruskan extra_body dan membandingkan tiga tingkat
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 Tips pemanggilan: Antarmuka yang kompatibel dengan OpenAI adalah cara termudah untuk menggunakan Gemini 4 Argon. Kode yang sudah menggunakan OpenAI SDK umumnya tidak perlu banyak diubah. Anda bisa mendapatkan kuota pengujian melalui APIYI apiyi.com, lalu mencoba skrip perbandingan tiga tingkat di atas untuk melihat perbedaan hasil pada tugas yang biasa Anda kerjakan.
Mengatur Tingkat Penalaran Gemini 4 Argon di Cherry Studio
Di pojok kanan bawah kolom input Cherry Studio terdapat menu tarik-turun tingkat penalaran. Namun, opsi ini hanya ditampilkan untuk model penalaran yang dikenali oleh klien. Berdasarkan issue komunitas, Cherry Studio menentukan apakah model mendukung tingkat penalaran menggunakan katalog model bawaan yang dibuat saat build dari models.dev dan OpenRouter. Cherry Studio tidak membaca informasi kemampuan yang dikembalikan oleh antarmuka saat dijalankan. Untuk model baru seperti Gemini 4 Argon, menu tarik-turun mungkin tidak muncul sebelum katalog diperbarui. Bahkan, opsi bisa saja terlihat dan dapat dipilih, tetapi tidak berfungsi.
Dalam situasi seperti ini, cara yang paling andal adalah menggunakan fitur parameter kustom Cherry Studio. Menurut dokumentasi resminya, parameter kustom akan langsung ditambahkan ke isi permintaan dan memiliki prioritas lebih tinggi daripada parameter bawaan.
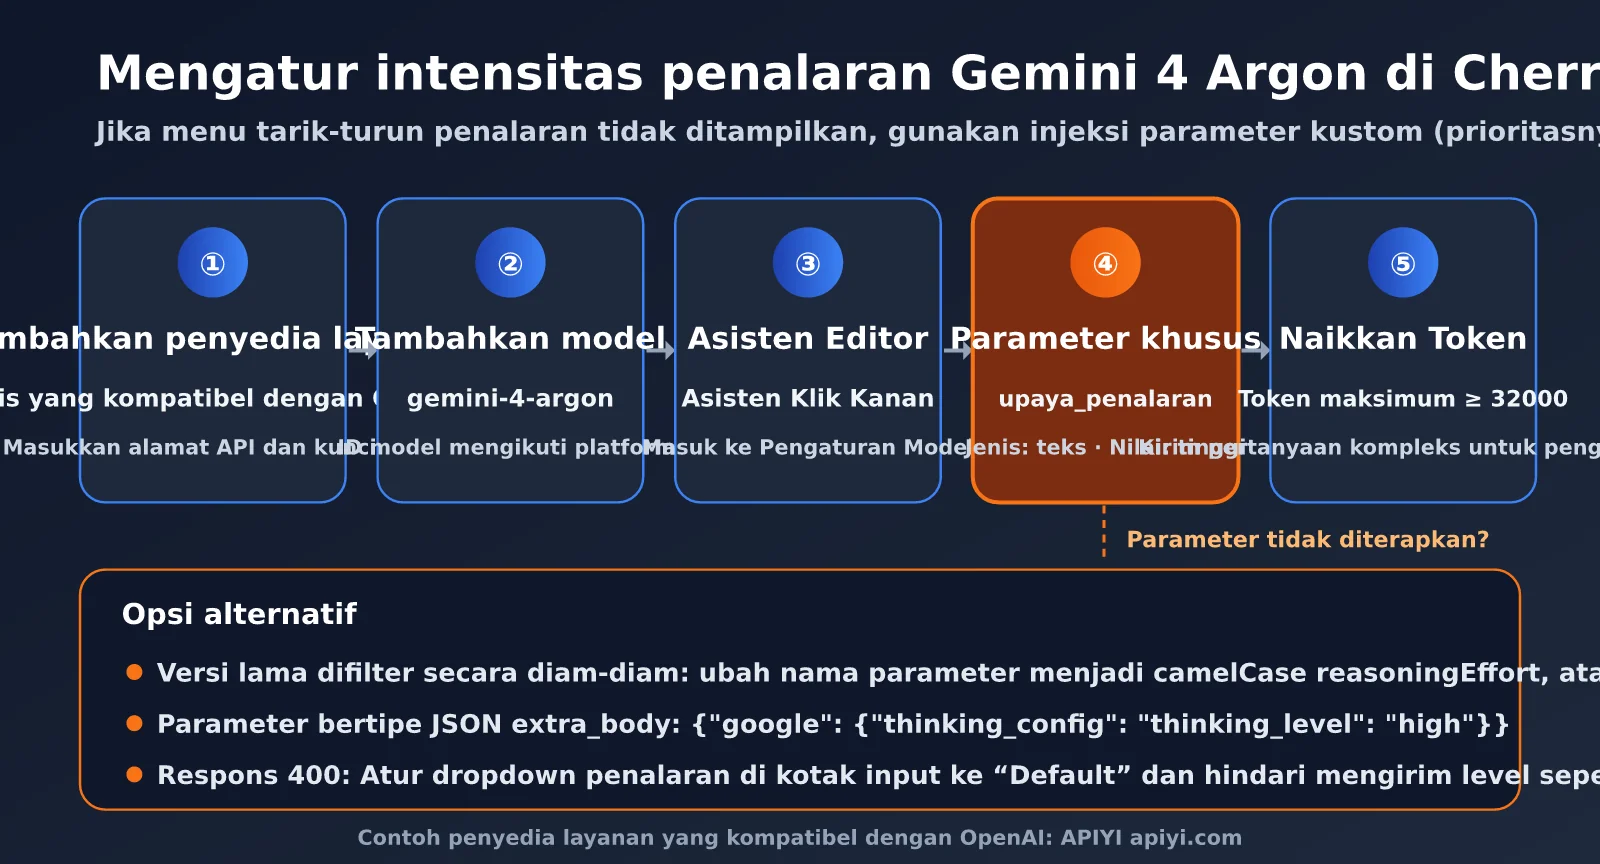
Langkah Mengatur Parameter Kustom di Cherry Studio
Berikut langkah konfigurasi lengkap menggunakan penyedia layanan yang kompatibel dengan OpenAI sebagai contoh:
- Tambahkan penyedia layanan: Tambahkan penyedia layanan yang kompatibel dengan OpenAI di pengaturan, lalu masukkan alamat API dan kunci API, misalnya
https://api.apiyi.commilik APIYI. - Tambahkan model: Tambahkan ID model
gemini-4-argondi bawah penyedia layanan tersebut. - Buka pengaturan asisten: Klik kanan asisten yang dituju di daftar asisten, pilih “Edit Asisten”, lalu buka tab “Pengaturan Model”.
- Tambahkan parameter kustom: Isi nama parameter dengan
reasoning_effort, pilih tipe “Teks”, lalu masukkan nilaihigh(ataulow,medium). - Naikkan batas output: Aktifkan dan naikkan “Jumlah Token Maksimum”. Disarankan minimal 32000 agar tersedia ruang untuk proses berpikir.
- Kirim permintaan uji: Coba pertanyaan yang memerlukan penalaran bertahap, lalu bandingkan waktu respons dan isi pemikiran sebelum dan sesudah pengaturan.
Jika tingkat penalaran masih belum berfungsi setelah mengikuti langkah-langkah di atas, periksa beberapa kemungkinan berikut:
| Gejala masalah | Kemungkinan penyebab | Solusi |
|---|---|---|
| Tidak ada perubahan setelah mengatur reasoning_effort | Versi lama diam-diam menyaring parameter ini dalam mode kompatibel dengan OpenAI | Perbarui ke versi terbaru atau ganti nama parameter menjadi reasoningEffort |
| Menu tarik-turun tingkat penalaran tidak muncul di kolom input | Argon belum tercantum di katalog model bawaan | Gunakan parameter kustom; pengguna tingkat lanjut dapat menambahkan informasi kemampuan penalaran di konfigurasi model |
| Permintaan mengembalikan error 400 | Klien mengirim tingkat seperti max atau xhigh yang tidak didukung Argon |
Biarkan menu tarik-turun pada “Default” dan tentukan hanya low/medium/high melalui parameter kustom |
| Parameter tertimpa pengaturan bawaan | Opsi penalaran di kolom input bertentangan dengan parameter kustom | Biarkan opsi di kolom input pada “Default” agar tidak diatur di dua tempat sekaligus |
| Perlu meneruskan parameter native | Ingin mengaktifkan ringkasan pemikiran sekaligus | Tambahkan parameter bertipe JSON extra_body dengan nilai {"google": {"thinking_config": {"thinking_level": "high"}}} |
Masalah reasoning_effort yang diam-diam disaring telah diperbaiki Cherry Studio melalui PR pada Maret 2026. Versi terbaru akan otomatis mengubahnya menjadi reasoningEffort yang digunakan secara internal. Jika Anda memakai versi yang lebih lama, tulis nama parameter dalam format camelCase sebagai reasoningEffort untuk menghindari penyaringan.
Prinsip yang sama juga berlaku untuk klien percakapan lain selain Cherry Studio: cari opsi seperti “Parameter Kustom”, “Isi Permintaan Tambahan”, atau “Parameter Lanjutan”, lalu tambahkan reasoning_effort sebagai kolom di tingkat teratas isi permintaan. Jika klien hanya mendukung format JSON, gunakan extra_body untuk meneruskan thinking_config native. Setelah selesai mengatur, uji dengan pertanyaan kompleks yang sama dan bandingkan waktu respons serta penggunaan token untuk memastikan parameter benar-benar berfungsi.
🚀 Saran penggunaan klien: Saat menghubungkan Gemini 4 Argon di Cherry Studio, sebaiknya pilih penyedia layanan yang kompatibel dengan OpenAI karena penerusan parameternya paling stabil. APIYI apiyi.com menyediakan antarmuka terpadu yang kompatibel dengan OpenAI. Setelah dikonfigurasi sekali di Cherry Studio, Anda bisa menggunakan model dari Gemini, Claude, GPT, dan lainnya.
Uji Langsung Tingkat Penalaran Gemini 4 Argon dan Panduan Menghindari Kesalahan
Tingkat penalaran berpengaruh langsung terhadap latensi, biaya, dan kualitas output. Blog teknologi pihak ketiga ComputingForGeeks membandingkan Argon dalam serangkaian tugas operasional. Hasilnya cukup menarik untuk dijadikan acuan.
| Metrik pengujian | Default (medium) | high | Perbedaan |
|---|---|---|---|
| Rata-rata token output | 463 | 1.836 | Sekitar 4 kali |
| Rata-rata latensi | 5,5 detik | 15,3 detik | Sekitar 2,8 kali |
| Token pertama yang terlihat | Sekitar 4,3 detik | 12–13 detik | Mengeluarkan sekitar 1.400 token penalaran terlebih dahulu |
| Biaya untuk 9 kali pemanggilan (harga perkenalan) | $0.045 | $0.169 | Sekitar 3,8 kali |
| Perbandingan low / medium dengan default | Hampir sama | — | Tidak menghasilkan token penalaran pada tugas singkat |
Data ini menunjukkan dua hal. Pertama, untuk tugas sederhana dan singkat, pengaturan low, medium, dan default hampir tidak berbeda. Semuanya tidak menghasilkan token penalaran; hanya tingkat high yang benar-benar melakukan “penalaran mendalam”. Kedua, biaya tingkat high cukup jelas: biayanya hampir 4 kali lipat dan latensi token pertama bertambah sekitar 8 detik. Perlu diperhatikan bahwa pengujian ini hanya mencakup petunjuk singkat. Pada tugas kompleks dan panjang, tingkat medium juga mungkin menghasilkan proses penalaran.
4 Kesalahan Umum saat Mengatur Tingkat Penalaran Gemini 4 Argon
Berdasarkan panduan migrasi Google dan pengujian komunitas, berikut beberapa kesalahan yang paling sering terjadi saat mengatur tingkat penalaran Gemini 4 Argon:
max_tokensterlalu kecil sehingga menghasilkan balasan kosong:max_output_tokensmencakup token penalaran sekaligus token isi jawaban. Dalam sebuah pengujian, Argon pada tingkat high denganmax_tokenssebesar 1024 menggunakan seluruh 1021 token untuk penalaran, lalu mengembalikan string kosong dengan alasan penghentianMAX_TOKENS. Saat menggunakan tingkat high, sisakan setidaknya 16K–32K token.- Tetap menggunakan
thinking_budgetsehingga langsung terjadi error:gemini-3.1-pro-previewsecara diam-diam memetakanthinking_budgetke tingkat tertentu, sedangkan Argon langsung mengembalikan error 400. Pastikan parameter ini dihapus saat migrasi. - Parameter sampling seperti
temperaturediabaikan: Dokumentasi Google menjelaskan bahwa backend Argon mengabaikantemperaturekustom. Parameterfrequency_penalty,presence_penalty, dancandidate_countjuga akan menghasilkan error 400. Sebaiknya atur kedalaman penalaran dengan tingkat penalaran, lalu gunakanresponse_schemauntuk mengatur format output. - Menekan biaya dengan mengurangi
max_tokensjustru berdampak buruk: Google menyarankan untuk menurunkan tingkat penalaran, bukan memperkecilmax_tokens, jika ingin mengurangi biaya dan latensi. Jikamax_tokensterlalu kecil, output lebih mudah terpotong.
📊 Saran memilih tingkat: Untuk tanya jawab sehari-hari dan pemrograman sederhana, tingkat default medium sudah cukup. Beralihlah ke high untuk desain arsitektur yang kompleks, refaktorisasi beberapa file, atau pembuktian matematika. Anda bisa membandingkan penggunaan token pada berbagai tingkat melalui log pemanggilan di platform APIYI apiyi.com untuk menemukan keseimbangan terbaik antara kualitas dan biaya.
Pertanyaan Umum
Q1: Apakah tingkat penalaran Gemini 4 Argon secara default adalah high?
Tidak. Versi standar `gemini-4-argon` secara default menggunakan medium. Hanya `gemini-4-argon-cyber-permissive`, yang ditujukan bagi pihak pertahanan siber, yang secara default menggunakan high. Ini berbeda dengan `gemini-3.1-pro-preview`, yang secara default menggunakan tingkat tertinggi, yaitu high. Jika membutuhkan kemampuan penalaran maksimal, Anda harus mengatur `thinking_level=”high”` atau `reasoning_effort=”high”` secara eksplisit.
Q2: Bisakah penalaran Gemini 4 Argon dinonaktifkan atau diatur ke minimal?
Tidak. Argon hanya mendukung tiga tingkat: low, medium, dan high. Pengaturan minimal atau `thinking_budget` akan menghasilkan HTTP 400. Jika `reasoning_effort=”minimal”` dikirim melalui antarmuka yang kompatibel dengan OpenAI, nilainya akan dipetakan ke low. Jika membutuhkan latensi yang sangat rendah, pertimbangkan model seperti seri Gemini 3.x Flash yang mendukung tingkat minimal.
Q3: Bagaimana jika opsi tingkat penalaran tidak terlihat di Cherry Studio?
Ini terjadi karena katalog model bawaan Cherry Studio belum mencakup Argon. Anda bisa menambahkan parameter kustom `reasoning_effort` di “Edit Asisten → Pengaturan Model”, dengan tipe teks dan nilai `high`. Parameter kustom memiliki prioritas lebih tinggi daripada parameter bawaan. Layanan yang kompatibel dengan OpenAI seperti APIYI apiyi.com direkomendasikan karena penerusan parameternya paling stabil.
Q4: Bagaimana cara memastikan tingkat penalaran benar-benar diterapkan?
Cara paling mudah adalah memeriksa jumlah token output pada usage dan durasi respons: pada tingkat high, jumlah token output dan latensi token pertama akan jauh lebih tinggi daripada tingkat default. Di Cherry Studio, Anda juga bisa melihat apakah konten penalaran muncul. Coba ajukan pertanyaan kompleks yang sama dengan tingkat default dan high, lalu bandingkan hasilnya.
Kesimpulan
Kesimpulan utama tentang tingkat penalaran Gemini 4 Argon: default-nya medium, bukan high. Ini berbeda dengan gemini-3.1-pro-preview yang default-nya berada di tingkat tertinggi. Saat melakukan migrasi, jika tingkatnya tidak diatur secara eksplisit, kedalaman pemikiran model akan diam-diam turun satu tingkat. Argon hanya mendukung tiga tingkat: low, medium, dan high. thinking_budget dan minimal akan memicu error 400. Saat menggunakan tingkat high, pastikan max_tokens menyediakan ruang yang cukup untuk token pemikiran.
Untuk cara pemanggilan, SDK native menggunakan thinking_level, sedangkan antarmuka yang kompatibel dengan OpenAI menggunakan reasoning_effort. Pada klien seperti Cherry Studio yang belum mendukung opsi penalaran Argon, Anda bisa menyisipkannya melalui parameter khusus. Untuk tugas sehari-hari, sebaiknya gunakan default medium. Beralihlah ke high untuk tugas yang kompleks sesuai kebutuhan, lalu tentukan tingkat yang tepat berdasarkan hasil pengujian.
Kami menyarankan penggunaan platform APIYI apiyi.com untuk mengakses Gemini 4 Argon secara terpadu melalui cara yang kompatibel dengan OpenAI. Dengan begitu, Anda bisa menggunakan satu parameter, reasoning_effort, untuk mengatur tingkat penalaran di kode maupun klien seperti Cherry Studio.
Referensi:
- Dokumentasi Google Gemini API tentang Thinking: ai.google.dev/gemini-api/docs/thinking
- Dokumentasi Google Gemini API tentang kompatibilitas OpenAI: ai.google.dev/gemini-api/docs/openai
- Panduan developer Google Cloud untuk Gemini 4 Argon: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Dokumentasi pengaturan asisten Cherry Studio: docs.cherryai.com.cn
- GitHub Issues Cherry Studio #11987 dan #19761: github.com/CherryHQ/cherry-studio
Penulis: APIYI Team | Berbagi praktik integrasi Model Bahasa Besar dan penyetelan parameter secara berkala. Kunjungi APIYI apiyi.com untuk tutorial integrasi model AI lainnya.