Gemini 4 Argon mengalami perkembangan baru. Setelah diumumkan pada 30 September dan awalnya hanya tersedia bagi pihak pertahanan siber dalam program Fairwind, model Gemini 4 Argon kini sudah bisa diakses di Vertex AI. Google Cloud pun resmi mulai memperluas ketersediaannya. Bagi kebanyakan developer, pertanyaan paling penting sekarang adalah: bagaimana cara menghitung harga Gemini 4 Argon, dan berapa biaya yang harus disiapkan setiap bulan setelah mengintegrasikannya?
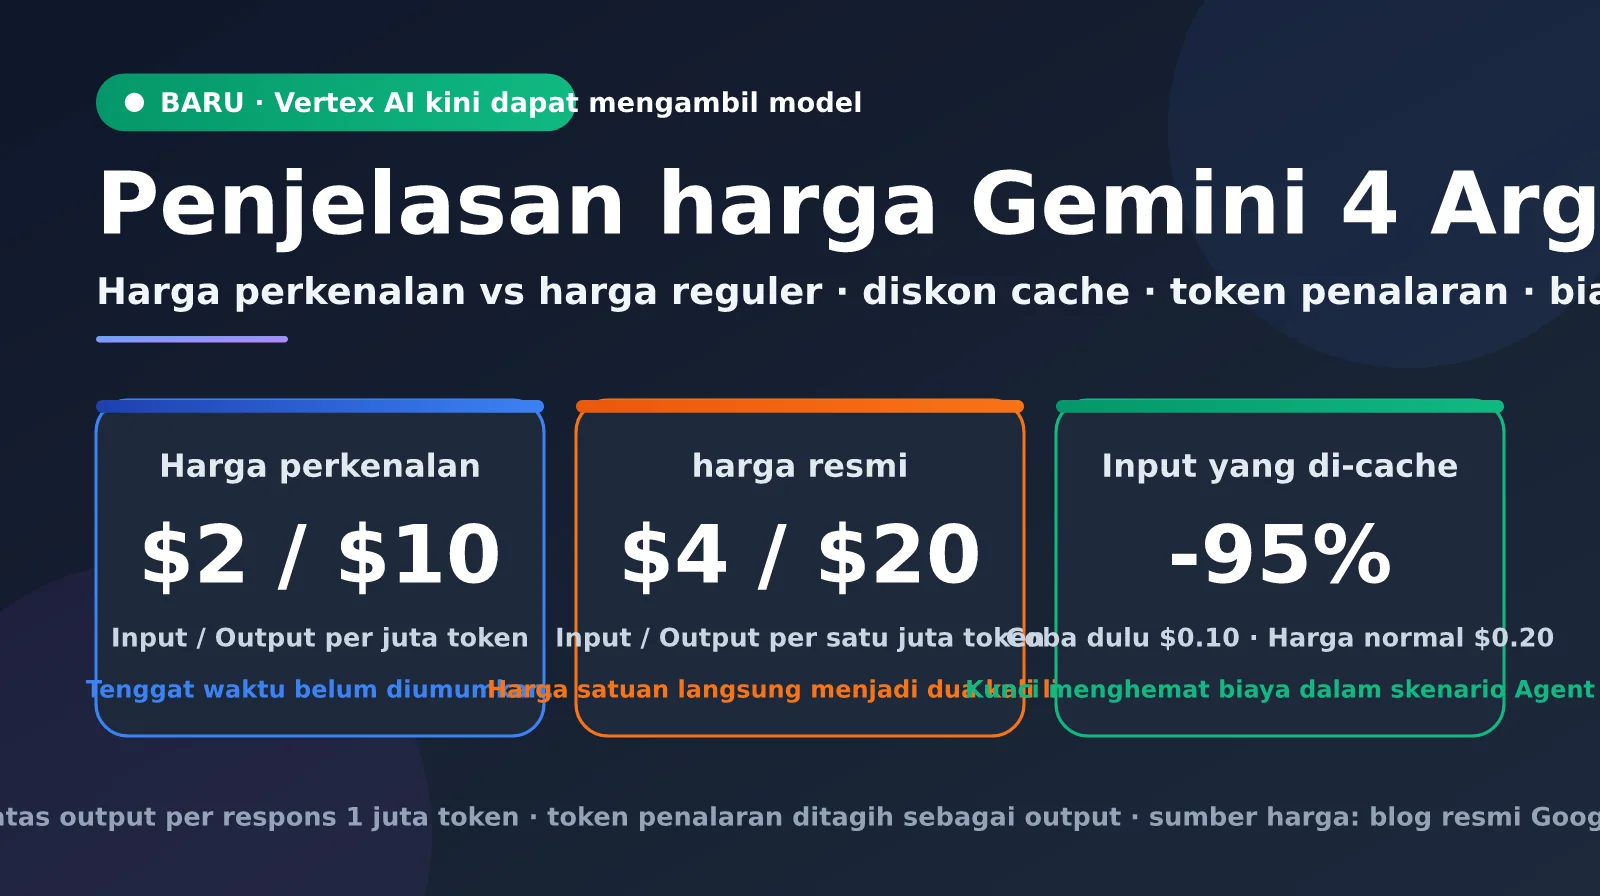
Sekilas, harga Argon terlihat sederhana: harga perkenalan sebesar $2 untuk input dan $10 untuk output per satu juta token, lalu naik dua kali lipat menjadi $4/$20 setelah harga reguler berlaku. Input yang di-cache mendapat diskon 95%. Namun, ada beberapa variabel lain di balik daftar harga ini: bagaimana token penalaran dikenai biaya, apakah batas output 1 juta token bisa membuat biaya satu permintaan membengkak, dan seberapa besar konsumsi token Argon dibandingkan pesaingnya. Artikel ini menguraikan harga Gemini 4 Argon satu per satu berdasarkan blog resmi Google, sejumlah media berbahasa Inggris, dan data publik dari lembaga evaluasi pihak ketiga. Kami juga menghitung biaya untuk lima skenario umum.
Manfaat utama: Setelah membaca artikel ini, Anda bisa menghitung biaya nyata per tugas Gemini 4 Argon untuk bisnis Anda, memahami perubahan tagihan setelah periode perkenalan berakhir, serta menekan biaya dengan caching dan pembatasan output.
Ringkasan harga Gemini 4 Argon
Pertama, mari rangkum harga yang diumumkan Google secara resmi dalam sebuah tabel. Perlu diperhatikan bahwa Google hanya mengumumkan dua skema harga—harga perkenalan dan harga reguler—tanpa menjelaskan berapa lama periode perkenalan berlangsung. Google juga belum mengumumkan rincian biaya untuk Batch, Flex, tingkatan konteks panjang, maupun penyimpanan cache.
| Komponen biaya | Harga perkenalan (per satu juta token) | Harga reguler (per satu juta token) | Keterangan |
|---|---|---|---|
| Input | $2.00 | $4.00 | Durasi periode perkenalan belum diumumkan |
| Output | $10.00 | $20.00 | Google belum menjelaskan secara terpisah cara penghitungan biaya token penalaran |
| Input yang di-cache | $0.10 | $0.20 | Diskon 95% dari harga input; harga reguler dihitung dengan diskon yang sama |
| Batas output per permintaan | 1 juta token | 1 juta token | Batas model Gemini sebelumnya adalah 64 ribu |
| Batch / Flex | Belum diumumkan | Belum diumumkan | Model Gemini yang tersedia saat ini biasanya menawarkan diskon untuk Batch |
| Tingkatan konteks panjang | Belum diumumkan | Belum diumumkan | Google juga belum mengumumkan jendela konteks input |
Tiga hal penting tentang harga Gemini 4 Argon
Hal pertama adalah token penalaran. Google belum menjelaskan secara terpisah cara menghitung biaya token pemikiran Argon. Namun, praktik umum pada seri Gemini saat ini adalah mengenakan biaya token pemikiran dengan tarif output. Untuk membuat anggaran, cara paling aman adalah mengasumsikan Argon mengikuti aturan ini. Artinya, semua proses pemikiran dihitung dalam tagihan dengan tarif $10 (harga perkenalan) atau $20 (harga reguler) per satu juta token.
Hal kedua adalah diskon cache. Diskon cache sebesar 95% berarti input yang di-cache hanya dikenai biaya $0.10 per satu juta token selama periode perkenalan. Dalam alur kerja berbasis agen, petunjuk sistem, definisi alat, dan konteks basis kode dikirim ulang di setiap putaran percakapan. Tingkat cache hit sering kali bisa mencapai lebih dari 70%, sehingga diskon ini mungkin berdampak lebih besar pada total tagihan dibandingkan harga dasar $2.
Hal ketiga adalah ketidakpastian periode perkenalan. Setelah periode perkenalan berakhir, semua harga satuan langsung naik dua kali lipat, sementara Google belum menyebutkan batas waktunya. Jadi, jika Anda menghitung ROI berdasarkan harga perkenalan, sebaiknya siapkan juga perhitungan berdasarkan harga reguler agar tagihan tidak tiba-tiba berlipat ganda.
🎯 Saran anggaran: Harga Gemini 4 Argon dipengaruhi beberapa variabel. Sebaiknya mulai dengan trafik kecil untuk melihat pola konsumsi token yang sebenarnya sebelum memutuskan untuk beralih secara besar-besaran. Melalui platform APIYI apiyi.com, Anda bisa memanggil berbagai seri model seperti Gemini, GPT, dan Claude melalui satu antarmuka, sehingga biaya nyata untuk tugas yang sama lebih mudah dibandingkan.
Update terbaru peluncuran Gemini 4 Argon di Vertex AI
Jadwal ketersediaan Argon selalu menjadi salah satu hal yang paling ditunggu developer. Menurut rencana dalam blog Google, Argon pertama kali tersedia bagi pihak tepercaya yang menangani pertahanan jaringan dalam program Fairwind dan tim internal Google. Setelah itu, model akan tersedia bagi pelanggan API berbayar dan pelanggan Google AI Ultra, sebelum dibuka untuk developer, perusahaan, dan konsumen secara lebih luas. Tabel berikut merangkum linimasa sejak pengumuman hingga model dapat diakses melalui Vertex AI.
| Waktu | Peristiwa | Sumber informasi |
|---|---|---|
| 3 September | Program Fairwind diluncurkan, dengan Gemini 3.8 Flash Cyber sebagai model perdana | Blog resmi Google |
| 30 September | Gemini 4 Argon diumumkan dan diluncurkan untuk anggota Fairwind | Blog resmi Google |
| 30 September | Pemeriksaan DataCamp: Vertex AI, Gemini CLI, dan layanan lainnya belum menyediakan model ini | DataCamp |
| 7–8 Oktober | Komunitas menemukan entri gemini-4-argon-cyber-permissive di Vertex AI |
Komunitas dan media teknologi |
| Pertengahan Oktober | Model Gemini 4 Argon sudah dapat diakses melalui Vertex AI | Update terbaru |
ID gemini-4-argon-cyber-permissive yang pertama kali ditemukan komunitas cukup menarik. Istilah “cyber-permissive” mengisyaratkan bahwa ini adalah versi untuk pihak yang menangani pertahanan jaringan, dengan pembatasan keamanan siber yang lebih longgar. Ini selaras dengan keterangan di blog Google bahwa model tersebut tidak menerapkan pembatasan keamanan siber bagi pihak tepercaya yang menangani pertahanan. Versi untuk pelanggan berbayar umum kemungkinan besar akan menggunakan ID berbeda dan tetap dilengkapi perlindungan keamanan secara penuh. Jadi, saat mengintegrasikan model, pastikan untuk menggunakan ID yang benar-benar tercantum di Model Garden pada konsol Google Cloud Anda. Jangan langsung menyalin nama yang beredar di internet.
Harga Gemini 4 Argon di Vertex AI dan perubahan platform
Menurut informasi dari komunitas, harga global Argon yang ditampilkan di Vertex AI adalah $4 untuk input dan $20 untuk output per satu juta token—sesuai dengan tarif resmi yang dicantumkan di blog Google. Hal ini perlu diperhatikan: jika perusahaan menggunakan Argon melalui Vertex AI dan langsung dikenai tarif resmi, semua estimasi yang dibuat berdasarkan harga perkenalan $2/$10 harus dikalikan dua. Google belum menjelaskan secara pasti kanal mana saja yang mendapatkan harga perkenalan. Sebelum mengintegrasikannya, pastikan untuk memeriksa harga aktual di halaman penagihan konsol.
Perubahan lain yang mudah terlewat adalah platformnya sendiri. Dalam konferensi Cloud Next pada April 2026, Google mengintegrasikan layanan Vertex AI ke Gemini Enterprise Agent Platform. Dokumentasi Vertex AI versi lama kini mencantumkan bahwa dokumentasinya tidak akan diperbarui lagi. Endpoint yang sudah ada tetap dapat digunakan, tetapi dokumentasi dan fitur baru untuk model seperti Argon akan lebih dulu tersedia di Agent Platform. Selain itu, Gemini 2.5 Pro, 2.5 Flash, dan 2.5 Flash-Lite akan dihentikan pada 16 Oktober. Tim yang masih menggunakan model-model tersebut bisa memanfaatkan kesempatan ini untuk menyelesaikan migrasi sekaligus.
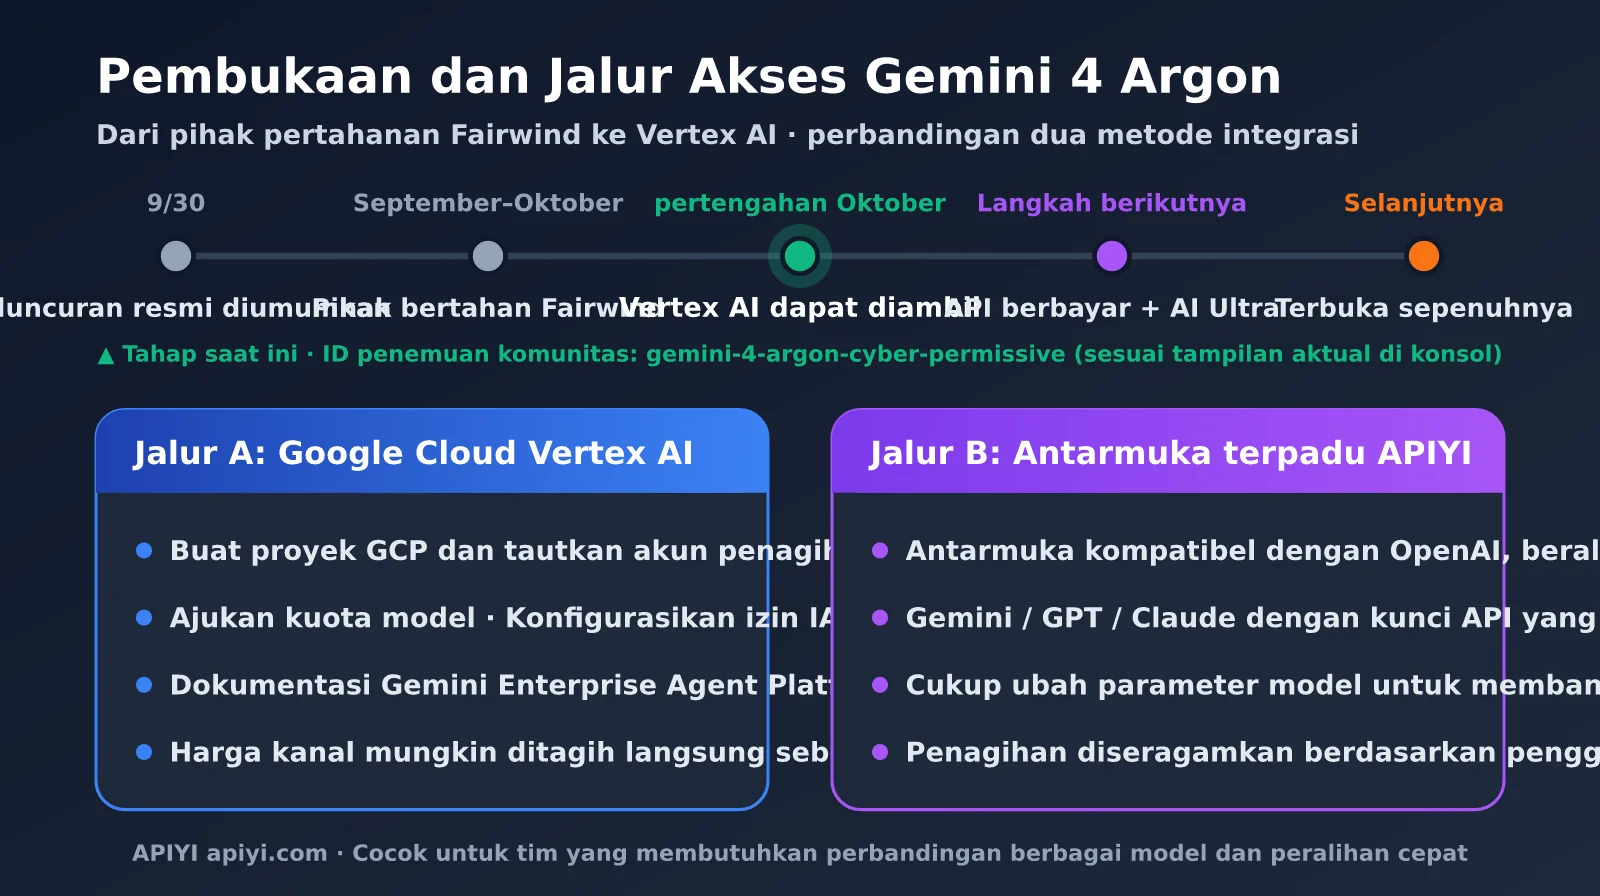
🚀 Saran integrasi: Mengakses Vertex AI secara langsung membutuhkan project GCP, akun penagihan, pengajuan kuota, dan konfigurasi IAM. Persyaratan ini bisa cukup berat bagi tim kecil dan menengah. Kami menyarankan penggunaan antarmuka yang kompatibel dengan OpenAI dari platform APIYI apiyi.com untuk mengakses model Gemini secara terpadu. Anda hanya perlu mengubah parameter
modeluntuk beralih antara Argon dan model lainnya.
Perbandingan Harga Gemini 4 Argon: Model Satu Keluarga dan Pesaing
Melihat harga satuan saja belum cukup untuk menilai apakah Argon mahal. Kita perlu membandingkannya dengan Gemini 3.8 Flash dari keluarga yang sama dan model unggulan pesaing. Tabel berikut menampilkan harga yang tercantum. Harga model pesaing dihimpun oleh pihak ketiga; silakan merujuk ke halaman resmi masing-masing penyedia untuk harga terbaru.
| Model | Input / juta token | Output / juta token | Batas output per permintaan | Posisi |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | Andalan untuk penggunaan sehari-hari, hemat biaya |
| Gemini 4 Argon (harga perkenalan) | $2.00 | $10.00 | 1M | Model unggulan untuk penalaran berantai panjang |
| Gemini 4 Argon (harga reguler) | $4.00 | $20.00 | 1M | Model unggulan untuk penalaran berantai panjang |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | Model unggulan pesaing |
| GPT-6 Astra | $10.00 | $50.00 | 128K | Model unggulan pesaing |
Dari sisi harga satuan, harga perkenalan Argon sekitar 2,7 kali harga Gemini 3.8 Flash. Harga regulernya setara dengan Claude Opus 5.5, dan hanya 40% dari harga GPT-6 Astra. Namun, harga satuan baru menjelaskan separuh cerita. Separuh lainnya adalah jumlah token yang dibutuhkan untuk menyelesaikan tugas yang sama—dan inilah hal utama yang perlu diperhatikan saat menilai harga Argon.
Biaya Gemini 4 Argon per Tugas: Konsumsi Token adalah Kuncinya
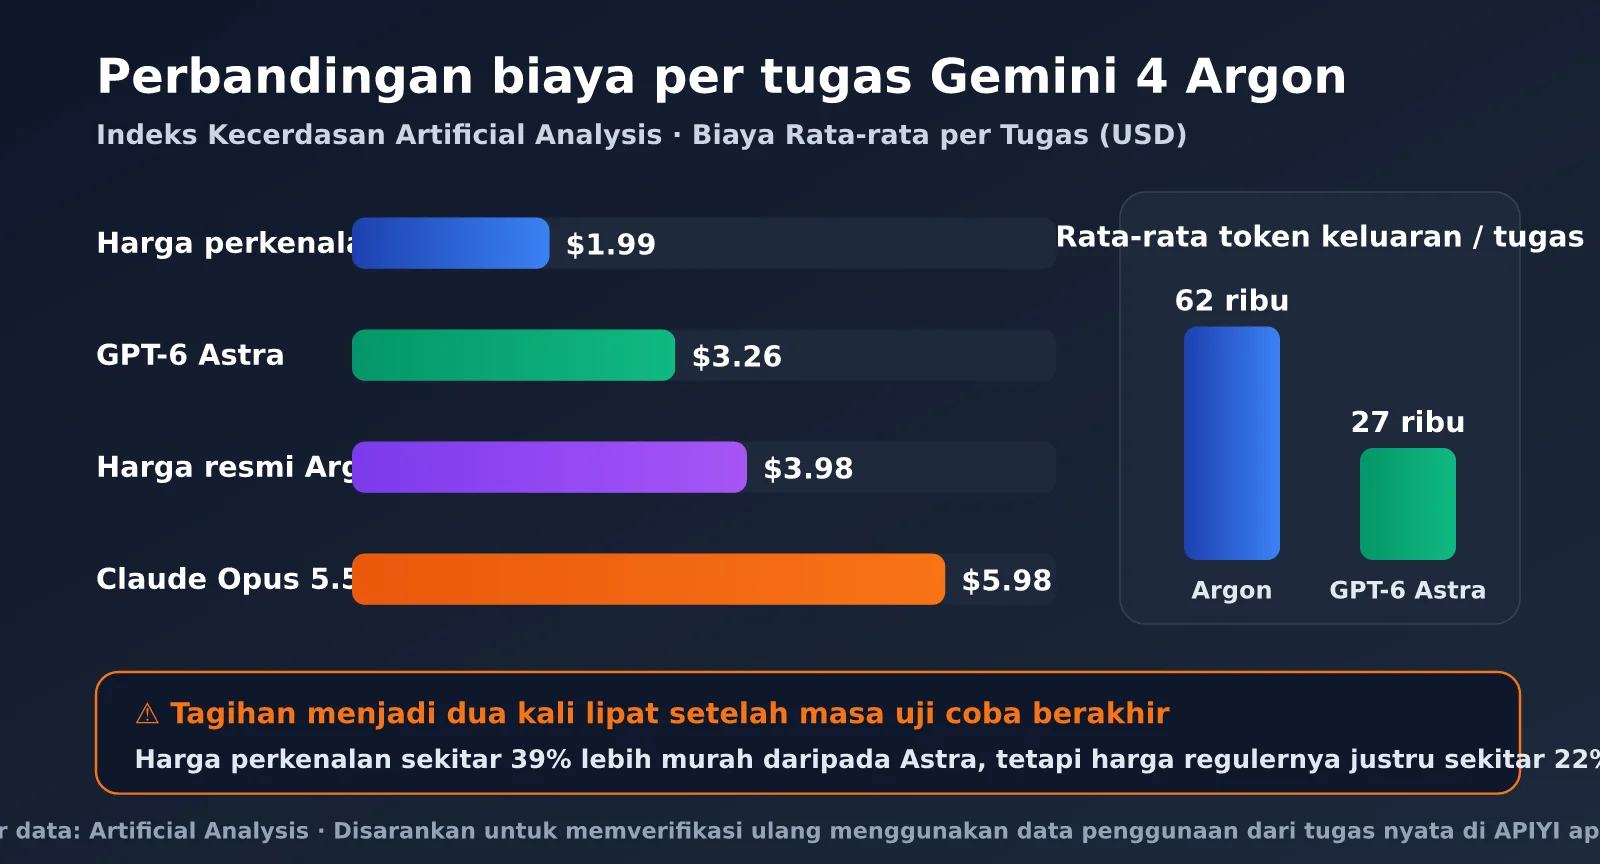
Biaya per tugas dari lembaga evaluasi pihak ketiga lebih menggambarkan biaya sebenarnya daripada harga satuan. Data Artificial Analysis menunjukkan bahwa Argon menghasilkan rata-rata sekitar 62 ribu token output per tugas dalam pengujian Intelligence Index, sedangkan GPT-6 Astra, yang meraih skor sama, hanya menggunakan sekitar 27 ribu token. Artinya, Argon menghasilkan lebih dari dua kali lipat token dibanding pesaingnya.
| Metode evaluasi | Gemini 4 Argon | Model pembanding | Kesimpulan |
|---|---|---|---|
| Biaya per tugas AA (harga perkenalan) | $1.99 | GPT-6 Astra $3.26 | Selama masa perkenalan, sekitar 39% lebih murah daripada Astra |
| Biaya per tugas AA (harga reguler) | $3.98 | GPT-6 Astra $3.26 | Pada harga reguler, justru sekitar 22% lebih mahal daripada Astra |
| Biaya per tugas AA | $1.99 | Claude Opus 5.5 $5.98 | Sekitar sepertiga biaya Opus 5.5 |
| Biaya per pengujian Vals | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | Biaya terendah untuk beban kerja ini |
| Rata-rata token output per tugas | Sekitar 62 ribu | GPT-6 Astra sekitar 27 ribu | Proses penalaran Argon jauh lebih panjang |
Tabel ini menunjukkan hal paling penting terkait harga Gemini 4 Argon: selama masa perkenalan, Argon menawarkan nilai yang sangat baik. Namun, setelah masa perkenalan berakhir, biaya Argon bisa lebih tinggi daripada GPT-6 Astra yang harga satuannya lebih mahal, untuk beberapa jenis beban kerja. Penyebabnya adalah konsumsi token output. Namun, pengujian Vals menunjukkan bahwa Argon justru paling murah untuk jenis beban kerja lain. Jadi, hasilnya sangat bergantung pada tugas yang dikerjakan; Anda perlu mengujinya dengan data sendiri.
💡 Tips memilih model: Harga satuan yang rendah bukan berarti tagihannya juga rendah. Di platform APIYI apiyi.com, coba jalankan kumpulan tugas nyata yang sama dengan Argon dan model unggulan lainnya. Catat kolom
usagepada setiap permintaan, lalu tentukan strategi perutean berdasarkan konsumsi token aktual, bukan harga yang tercantum.
Menghitung Biaya Gemini 4 Argon dalam Penggunaan Nyata: 5 Skenario Umum
Berikut perhitungan biaya untuk satu permintaan dalam lima skenario umum, berdasarkan harga satuan yang dipublikasikan Google. Perhitungan dibuat untuk harga perkenalan dan harga reguler. Token penalaran dihitung sebagai token output.
| Skenario | Token input | Token output | Biaya harga perkenalan | Biaya harga reguler |
|---|---|---|---|---|
| Tanya jawab sehari-hari | 20 ribu | 5000 | $0.09 | $0.18 |
| Analisis dokumen panjang | 200 ribu | 50 ribu | $0.90 | $1.80 |
| Pemrograman Agent (cache hit 80%) | 600 ribu | 62 ribu | $0.91 | $1.82 |
| Migrasi kode skala besar | 300 ribu | 400 ribu | $4.60 | $9.20 |
| Output penuh 1M | Diabaikan | 1 juta | $10.00 | $20.00 |
Sebagai contoh, untuk skenario pemrograman Agent: dari 600 ribu token input, 480 ribu masuk cache dan hanya dikenai biaya $0.10, sehingga biayanya $0.048. Sisa 120 ribu token dikenai biaya $2, sehingga biayanya $0.24. Lalu, 62 ribu token output dikenai biaya $10, sehingga biayanya $0.62. Totalnya sekitar $0.91. Dalam kondisi cache yang optimal, token output menyumbang hampir 70% dari total biaya. Karena itu, membatasi panjang output lebih penting daripada menekan jumlah input.
Migrasi kode skala besar dan output penuh 1M adalah dua skenario yang paling perlu diwaspadai. Batas output 1M merupakan salah satu keunggulan utama Argon, tetapi satu permintaan dengan output penuh akan dikenai biaya $20 pada harga reguler. Jika pengaturan waktu tunggu klien tidak tepat dan permintaan gagal lalu dicoba ulang secara otomatis, biaya bisa langsung berlipat ganda. Bagi tim yang menjalankan ratusan tugas panjang setiap hari, biaya tersembunyi seperti ini bisa membuat tagihan bulanan membengkak.
Daftar Biaya Tersembunyi Gemini 4 Argon
Berdasarkan perhitungan di atas, berikut beberapa jenis biaya tersembunyi yang perlu diantisipasi saat menggunakan Argon:
- Lonjakan token penalaran: Rata-rata token output Argon lebih dari dua kali lipat GPT-6 Astra. Proses penalaran yang dikenai biaya berdasarkan tarif output dapat meningkatkan biaya per tugas secara signifikan.
- Output yang sangat panjang dan percobaan ulang: Dengan batas output 1M, pengaturan waktu tunggu yang tidak tepat pada klien atau load balancer dapat menyebabkan permintaan panjang gagal lalu dicoba ulang, sehingga biaya berlipat ganda.
- Cache tidak terkena: Struktur petunjuk yang kurang tepat dapat membuat tingkat cache hit rendah, sehingga potongan harga 95% terbuang percuma.
- Masa perkenalan berakhir: Semua harga satuan menjadi dua kali lipat, tanpa tanggal berakhir yang jelas.
- Perbedaan harga antarplatform: Harga yang ditampilkan di Vertex AI mungkin langsung mengikuti harga reguler, sehingga biayanya dua kali lipat dibandingkan perhitungan dengan harga perkenalan.
Praktik Integrasi Gemini 4 Argon yang Lebih Hemat
Untuk mengatasi biaya tersembunyi di atas, ada tiga cara paling efektif: tetapkan batas output yang jelas untuk setiap permintaan, letakkan konten yang stabil di bagian awal petunjuk agar cache lebih sering digunakan, dan pilih model berdasarkan tingkat kesulitan tugas. Contoh berikut menggunakan antarmuka yang kompatibel dengan OpenAI, dengan ID model yang dikonfigurasi melalui variabel lingkungan.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
Lihat kode lengkap: perutean berdasarkan tingkat kesulitan + pencatatan biaya
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
Kode ini menerapkan tiga prinsip penghematan. Pertama, tetapkan max_tokens secara eksplisit dan jangan mengandalkan batas output default model yang sangat besar. Kedua, letakkan petunjuk sistem sebagai awalan yang stabil agar cache lebih sering digunakan pada permintaan berulang. Ketiga, lakukan perutean berdasarkan tingkat kesulitan: serahkan tugas sederhana kepada Gemini 3.8 Flash, yang tarifnya hanya sekitar sepertiga Argon, dan gunakan Argon hanya untuk tugas yang panjang dan sulit.
Saran: Anda bisa mendapatkan kuota uji coba di APIYI apiyi.com, lalu menjalankan skrip perutean di atas dengan lalu lintas nyata selama seminggu. Setelah itu, sesuaikan ambang perutean dan batas output berdasarkan log
usage.
Pertanyaan Umum
Q1: Berapa harga Gemini 4 Argon saat ini, $2/$10 atau $4/$20?
Harga uji coba yang diumumkan Google adalah $2/$10, sedangkan harga resminya $4/$20. Namun, Google tidak menyebutkan berapa lama periode uji coba berlangsung atau apakah harga uji coba berlaku sama di semua kanal. Ada kabar dari komunitas bahwa Vertex AI menampilkan harga resmi $4/$20. Sebaiknya gunakan tarif yang tercantum di tagihan kanal yang Anda pakai, dan buat anggaran dengan mempertimbangkan kedua tingkat harga tersebut.
Q2: Apakah gemini-4-argon-cyber-permissive di Vertex AI bisa langsung digunakan?
Dari namanya, ID ini tampaknya ditujukan bagi pihak yang menangani pertahanan siber, dengan pembatasan keamanan siber yang lebih longgar. Model ini memerlukan akses melalui program Fairwind, sehingga biasanya tidak bisa dipanggil oleh proyek biasa. Pelanggan berbayar reguler sebaiknya menggunakan ID model yang ditampilkan di Model Garden pada konsol mereka. Jika tidak ingin mengurus konfigurasi proyek GCP, kuota, dan izin, Anda juga bisa memanggil model Gemini melalui platform agregator seperti APIYI apiyi.com.
Q3: Apakah token penalaran Argon dikenai biaya tambahan?
Google belum memberikan penjelasan khusus. Namun, pada model Gemini yang sudah ada, token penalaran ditagihkan dengan tarif output. Sebaiknya gunakan aturan yang sama untuk membuat anggaran. Karena jumlah token output Argon cenderung lebih banyak, token penalaran sering menjadi sumber biaya utama. Anda bisa mengendalikannya dengan membatasi `max_tokens` dan menyesuaikan tingkat penalaran.
Q4: Dalam situasi apa Gemini 4 Argon layak digunakan meski berbayar?
Argon paling unggul untuk tugas berantai panjang, seperti migrasi kode berskala besar, analisis profesional atas dokumen panjang, agen untuk bidang hukum dan keuangan, serta audit keamanan. Untuk tugas-tugas ini, biaya Argon bisa sepadan dengan kemampuannya. Untuk tanya jawab sehari-hari, pelengkapan kode sederhana, dan tugas ringan dengan konkurensi tinggi, model berbiaya rendah seperti Gemini 3.8 Flash biasanya lebih hemat. Cara paling aman adalah membandingkan kinerja menggunakan tugas nyata melalui platform APIYI apiyi.com, lalu menentukan proporsi perutean yang sesuai.
Kesimpulan
Harga Gemini 4 Argon bisa dirangkum sebagai “harga awalnya menarik, tetapi banyak variabel yang perlu diperhatikan”. Harga perkenalan $2/$10 sangat kompetitif untuk model flagship, dan diskon cache 95% sangat menguntungkan untuk skenario Agent. Namun, konsumsi token penalarannya cukup tinggi, harga per token akan naik dua kali lipat setelah periode perkenalan berakhir, dan kanal Vertex AI mungkin langsung menerapkan harga normal. Ketiga hal ini bisa membuat tagihan aktual jauh berbeda dari perkiraan berdasarkan harga yang tercantum.
Gemini 4 Argon kini sudah tersedia di Vertex AI. Langkah penting berikutnya bukan buru-buru beralih sepenuhnya, melainkan menguji distribusi konsumsi token menggunakan lalu lintas nyata, lalu mengendalikan biaya dengan membatasi keluaran, memanfaatkan prefix cache, dan mengarahkan permintaan berdasarkan tingkat kesulitan. Kami menyarankan Argon digunakan sebagai model flagship khusus untuk “soal-soal sulit”, berdampingan dengan model kelas Flash.
Kami menyarankan penggunaan platform APIYI apiyi.com untuk mengakses berbagai model Gemini secara terpadu. Dengan satu antarmuka, Anda dapat membandingkan biaya dan hasil Argon dengan model lain, lalu menentukan strategi model berdasarkan data, bukan sekadar harga yang tercantum.
Referensi:
- Artikel pengumuman Gemini 4 Argon di blog resmi Google: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Halaman pengenalan Google Fairwind Program: deepmind.google/fairwind-program
- Rangkuman benchmark dan harga Gemini 4 Argon oleh DataCamp: datacamp.com/blog/gemini-4-argon
- Data biaya model dan indeks kecerdasan dari Artificial Analysis: artificialanalysis.ai
- Evaluasi model dan data biaya dari Vals AI: vals.ai
Penulis: APIYI Team | Terus mengikuti perkembangan harga Model Bahasa Besar dan aksesnya. Kunjungi APIYI apiyi.com untuk mendapatkan informasi lebih lanjut tentang akses ke model AI.