Baru-baru ini ada pelanggan yang bertanya di grup dengan pertanyaan yang cukup tipikal: “Sistem images2 kami ini bisa dipakai untuk bikin set gambar e-commerce, kan?” Jawabannya bisa, tapi bukan berarti sekali panggil langsung keluar satu set gambar utuh. Antarmuka gpt-image-2 itu prinsipnya “satu petunjuk untuk satu kali generate”. Kalau Anda ingin satu set gambar yang isinya berbeda-beda — gambar utama, gambar selling point, gambar scene, sampai halaman detail — cara pemanggilannya perlu sedikit dirancang.
Artikel ini membagi gpt-image-2 untuk set gambar e-commerce jadi dua jalur: satu jalur memakai satu gambar untuk membawa informasi multidimensi, cocok untuk gambar panjang halaman detail; jalur lainnya memakai model teks dulu untuk memecah kebutuhan lalu menghasilkan petunjuk tiap gambar, baru kemudian memanggil gpt-image-2 secara paralel, cocok untuk set gambar multi-gambar dalam arti sesungguhnya. Setelah selesai membaca, Anda akan mendapatkan desain alur lengkap, kode yang bisa langsung dijalankan, plus beberapa trik kunci untuk menjaga gaya seluruh set gambar tetap konsisten.
Batasan inti gpt-image-2 untuk set gambar e-commerce: satu pemanggilan = satu petunjuk
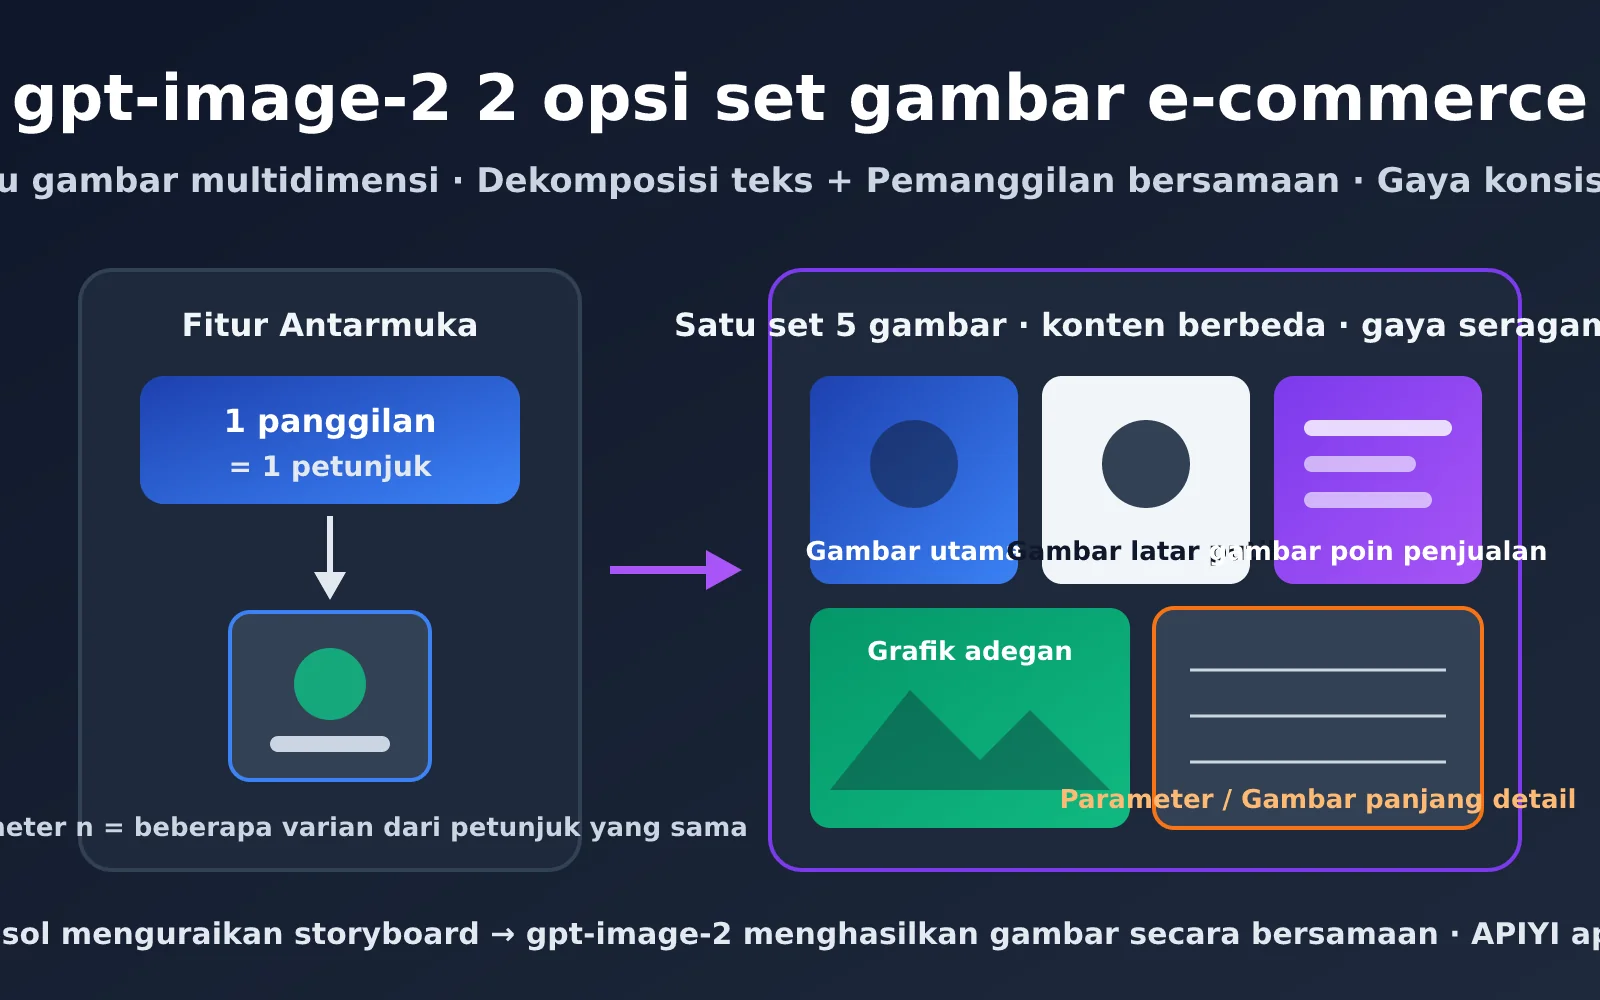
Mari kita perjelas dulu perilaku antarmukanya, karena seluruh desain solusi setelah ini berdiri di atas premis tersebut. Endpoint /v1/images/generations dan /v1/images/edits milik gpt-image-2 hanya menerima satu petunjuk per request. Baik gpt-image-2 maupun seri 2.5 resmi sama-sama mendukung parameter n, dan APIYI juga mendukungnya secara penuh. Tapi arti n di sini adalah “menghasilkan n varian dari petunjuk yang sama“, bukan “n petunjuk masing-masing menghasilkan 1 gambar”.
Jadi n=5 berarti Anda mendapat 5 versi dari satu gambar yang sama — cocok untuk “generate beberapa lalu pilih yang paling bagus”, tapi tidak cocok untuk set gambar. Esensi set gambar e-commerce adalah beberapa gambar dengan konten berbeda namun gaya seragam: gambar utama harus menonjolkan produk, gambar selling point harus ditemani teks promosi, gambar scene butuh lingkungan pemakaian, gambar parameter butuh anotasi ukuran. Petunjuk tiap gambar berbeda, jadi otomatis perlu banyak pemanggilan.
3 kesulitan nyata dalam set gambar e-commerce gpt-image-2
Setelah batasannya jelas, Anda akan sadar bahwa kesulitan sebenarnya bukan di “menghasilkan banyak gambar”, melainkan di tiga hal berikut:
- Subjek konsisten: produk di kelima gambar harus produk yang sama — warna, logo, dan strukturnya tidak boleh berubah di tiap gambar.
- Gaya konsisten: tone warna, pencahayaan, tekstur latar, dan gaya font harus terasa seperti buatan desainer yang sama.
- Pembagian informasi: tiap gambar memikul tugas marketing berbeda, tidak boleh kelimanya membahas selling point yang sama.
Ketiga hal inilah yang membuat set gambar tidak bisa diselesaikan dengan “melempar satu kalimat ke model”. Perlu perencanaan sebelum pemanggilan. Tabel berikut adalah komposisi standar set gambar di platform e-commerce umum, bisa jadi titik awal perencanaan Anda.
| Posisi dalam set | Fungsi utama | Rasio disarankan | Kepadatan informasi | Perlu teks? |
|---|---|---|---|---|
| Gambar utama (gambar pertama) | Click-through rate di hasil pencarian | 1:1 | Rendah, produk ditonjolkan | Opsional, sedikit |
| Gambar latar putih | Kepatuhan platform, iklan berbayar | 1:1 | Sangat rendah | Tidak perlu |
| Gambar selling point | Menyampaikan 2-3 selling point inti | 1:1 atau 3:4 | Sedang | Perlu |
| Gambar scene | Membangun suasana pemakaian | 1:1 atau 4:5 | Sedang | Opsional |
| Gambar ukuran/parameter | Menekan pertanyaan CS dan retur | 1:1 | Tinggi | Perlu |
| Gambar panjang halaman detail | Menjelaskan produk secara utuh | 9:16 atau lebih panjang | Sangat tinggi | Perlu |
🎯 Saran perencanaan: sebelum menulis kode, tentukan dulu berdasarkan tabel di atas berapa gambar yang dibutuhkan platform Anda dan tugas apa yang dipikul masing-masing gambar. Kami sarankan Anda mencoba dulu 2-3 gambar tunggal secara manual dengan gpt-image-2 di APIYI apiyi.com, pastikan tingkat kemiripan produk dan hasil render teksnya sesuai ekspektasi, baru masuk ke alur set gambar batch.
Pendekatan 1: gpt-image-2 satu gambar memuat informasi multidimensi (gambar panjang halaman detail)
Jalur pertama adalah “satu gambar menyampaikan satu set pesan”. Kemampuan rendering teks Tionghoa dan pemahaman tata letak gpt-image-2 sangat kuat — menata visual utama, poin jual, dan tabel spesifikasi secara terpisah dalam satu gambar vertikal besar sepenuhnya bisa dilakukan. Untuk kebutuhan seperti gambar panjang halaman detail, gambar kumpulan poin jual, dan infografis, satu kali pemanggilan sudah cukup menghasilkan produk jadi dengan kepadatan informasi yang tinggi.
Keuntungan terbesar jalur ini adalah secara alami tidak ada masalah konsistensi. Semua konten berada dalam satu gambar yang dihasilkan model sekaligus, nada warna dan gaya otomatis seragam, dan tidak perlu kode orkestrasi tambahan. Kekurangannya, ruang satu gambar terbatas: kalau kontennya terlalu banyak, teks akan mengecil dan berdesakan, dan hasilnya tidak bisa dipecah menjadi gambar utama independen untuk diiklankan.
Cara menulis petunjuk per area untuk gambar panjang detail gpt-image-2
Kunci satu gambar multidimensi adalah deskripsi per area. Jangan menulis satu paragraf panjang yang tercampur, tapi ikuti urutan tata letak dari atas ke bawah dan beri tahu model apa yang diletakkan di setiap area. Berikut contoh struktur petunjuk untuk gambar panjang halaman detail tumbler:
Gambar panjang halaman detail e-commerce vertikal 9:16, gaya keseluruhan: minimalis Nordik, latar krem, cahaya alami lembut.
【Area atas】Visual utama produk: satu tumbler hijau tua matte diletakkan miring 45 derajat, teks judul "Tahan panas 24 jam".
【Area tengah】Tiga kolom poin jual, tiap kolom satu ikon linear plus teks singkat: "Lapisan dalam stainless 316", "Tutup pop-up sekali tekan buka satu tangan", "Kapasitas besar 500ml".
【Area bawah】Tabel spesifikasi: kapasitas 500ml, berat 320g, tinggi 22cm, bahan stainless 316.
Semua teks menggunakan font Tionghoa sans-serif yang jelas, jangan munculkan teks berlebih.
Soal ukuran, gambar panjang sebaiknya pakai rasio vertikal 9:16, misalnya 1152x2048 di kelas 2K. Kalau butuh materi final yang lebih tajam, bisa pakai 2160x3840 di kelas 4K.
Pendekatan satu gambar hanya butuh 1 kali pemanggilan, biayanya paling rendah, dan gayanya otomatis seragam; harganya adalah kapasitas informasi yang terbatas — lewat dari 5 blok, teks mudah berdesakan, dan gambar tidak bisa dipotong untuk dipakai mandiri sebagai gambar utama pencarian. Pendekatan ini paling cocok untuk halaman detail dan kumpulan poin jual produk bertipe spesifikasi seperti peralatan rumah tangga, aksesori digital, dan kebutuhan sehari-hari.
💡 Tips praktik: begitu area melebihi 5 blok, tingkat kesalahan rendering teks naik cukup signifikan. Sebaiknya pecah gambar panjang menjadi 2-3 “gambar setengah layar” yang dihasilkan terpisah, lalu sambung vertikal di halaman detail. Gambar setengah layar itu sendiri sudah menjadi satu set kecil, jadi secara alami kita beralih ke pendekatan 2.
Pendekatan 2: dekomposisi dengan model teks + pemanggilan gpt-image-2 berulang untuk set gambar e-commerce
Kalau yang Anda butuhkan adalah set gambar multi-gambar sungguhan (gambar utama, gambar poin jual, dan gambar suasana masing-masing berdiri sendiri), Anda perlu jalur produksi kecil. Idenya: serahkan “memahami kebutuhan dan merencanakan storyboard” ke model teks, serahkan “menghasilkan gambar” ke gpt-image-2, dan hubungkan keduanya dengan JSON terstruktur.
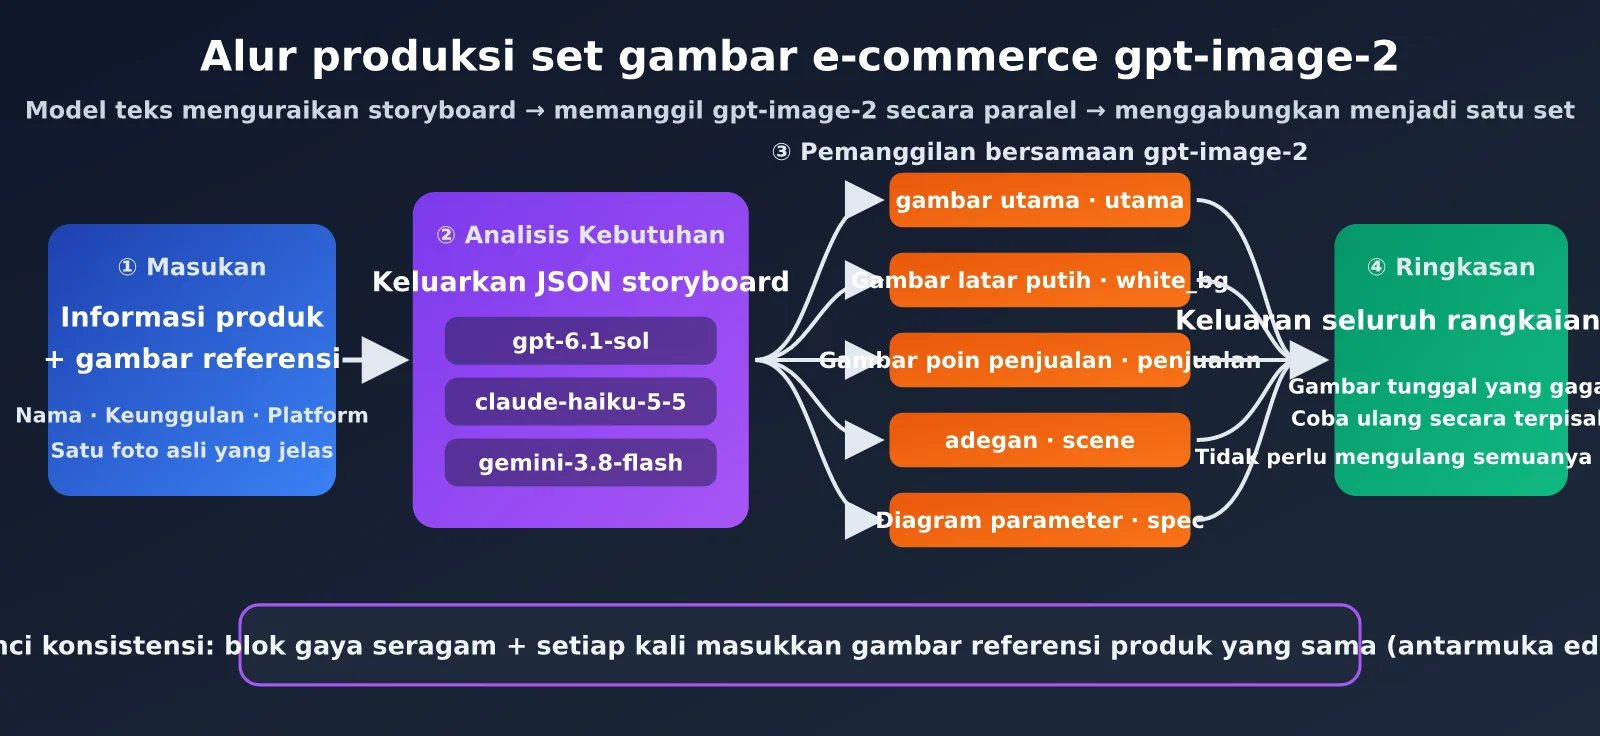
Alur lengkapnya terbagi dalam 4 langkah:
- Input: penjual menyediakan nama produk, poin jual, platform target, dan minimal satu foto produk asli yang jelas.
- Analisis kebutuhan: model teks mengeluarkan array JSON berdasarkan input; setiap elemen adalah storyboard satu gambar, mencakup tujuan pemakaian, prompt, ukuran, dan teks.
- Pembuatan gambar paralel: program menelusuri array storyboard, setiap storyboard memanggil gpt-image-2 sekali dengan gambar referensi produk yang sama.
- Agregasi dan validasi: kumpulkan semua hasil, gambar yang gagal diulang satu per satu, lalu keluarkan seluruh set sesuai urutan.
Cara memilih model teks: “otak” di balik set gambar gpt-image-2
Langkah analisis kebutuhan menuntut model teks untuk: memahami logika pemasaran e-commerce, mengeluarkan JSON secara konsisten, dan menulis petunjuk yang kuat secara visual. Beberapa model terbaru di APIYI saat ini semuanya sanggup:
| Model | Posisi | Skenario yang cocok | Alasan memilih |
|---|---|---|---|
| gpt-6.1-sol | Rekomendasi unggulan | Produk bernilai tinggi, ekstraksi poin jual rumit | Kualitas copywriting pemasaran dan perencanaan storyboard paling baik |
| claude-haiku-5-5 | Murah dan cepat | SKU massal, kategori terstandardisasi | Instruksi dipatuhi secara stabil, output JSON rapi |
| gemini-3.8-flash | Murah dan cepat | Volume besar, produk lintas negara multibahasa | Cepat, biaya rendah, copywriting multibahasa natural |
Analisis kebutuhan hanya dipanggil sekali per set gambar, konsumsi token sangat sedikit, dan biaya utama tetap ada di pembuatan gambar. Kami sarankan menyetel template petunjuk dulu dengan gpt-6.1-sol sampai puas, baru beralih ke claude-haiku-5-5 atau gemini-3.8-flash untuk menekan biaya saat menjalankan produksi massal. Ketiga model di APIYI apiyi.com sama-sama memakai antarmuka yang kompatibel dengan OpenAI, jadi untuk beralih cukup mengubah parameter model.
Desain JSON storyboard untuk set gambar e-commerce gpt-image-2
Membuat model teks mengeluarkan JSON dengan struktur tetap adalah kunci agar seluruh jalur produksi berjalan stabil. Berikut desain field yang direkomendasikan:
| Field | Tipe | Keterangan | Contoh |
|---|---|---|---|
scene |
string | Penanda posisi dalam set gambar | main / white_bg / selling |
purpose |
string | Tugas pemasaran gambar ini | Menonjolkan tampilan produk, meningkatkan klik |
prompt |
string | Petunjuk lengkap untuk gpt-image-2 | Tumbler hijau tua matte di atas meja kayu… |
size |
string | Ukuran keluaran | 2048x2048 |
text_overlay |
string | Teks yang perlu dirender di gambar | Tahan panas 24 jam |
Kode minimal set gambar gpt-image-2
Berikut versi paling ringkas yang bisa langsung dijalankan: minta model teks menyusun storyboard, lalu panggil endpoint edits gpt-image-2 satu per satu (dengan gambar referensi produk).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "Rencanakan 5 gambar set Taobao untuk tumbler stainless 316 hijau tua, keluarkan {\"shots\": [...]}, "
               "tiap item berisi scene/purpose/prompt/size/text_overlay, gaya seragam: minimalis Nordik, latar krem, cahaya alami lembut"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
Kode ini berjalan serial, jadi 5 gambar harus menunggu bergantian; bagian berikutnya akan diubah ke versi konkuren.
Cara menjaga konsistensi gaya set gambar e-commerce gpt-image-2
Masalah yang paling sering muncul dari pemanggilan berulang adalah 5 gambar terlihat seperti berasal dari 5 toko berbeda. Gabungkan beberapa teknik berikut untuk mendongkrak konsistensi ke level yang layak komersial:
- Style block seragam: tulis nada warna, pencahayaan, latar, dan bahasa kamera sebagai satu paragraf teks tetap, lalu tempelkan di akhir setiap petunjuk storyboard. Jangan biarkan model teks mendeskripsikan gaya dengan bebas setiap kali.
- Gambar referensi produk tetap: setiap pemanggilan selalu kirimkan foto produk asli yang sama lewat endpoint edits, dan nyatakan jelas dalam petunjuk “pertahankan warna, logo, dan struktur produk pada gambar referensi”. Ini cara paling efektif untuk menjaga konsistensi subjek.
- Parameter tetap: satu set gambar memakai tingkat
qualityyang sama, ukuran hanya berubah bila perlu (misalnya gambar panjang memakai versi vertikal). - Pakai parameter n untuk memilih: untuk posisi paling krusial seperti gambar utama, set
n=2ataun=3untuk menghasilkan beberapa varian, lalu pilih manual yang terbaik. Inilah penggunaan parameter n yang tepat.
🎯 Saran konsistensi: style block adalah “standar merek” untuk seluruh set gambar, sebaiknya simpan satu template tetap untuk setiap toko. Saat memanggil gpt-image-2 lewat APIYI apiyi.com, style block bisa disimpan di file konfigurasi dan dipakai bersama oleh semua SKU, sehingga saat pergantian musim cukup diperbarui sekali.
Pemanggilan paralel untuk set gambar e-commerce gpt-image-2: strategi percepatan dan perluasan skala
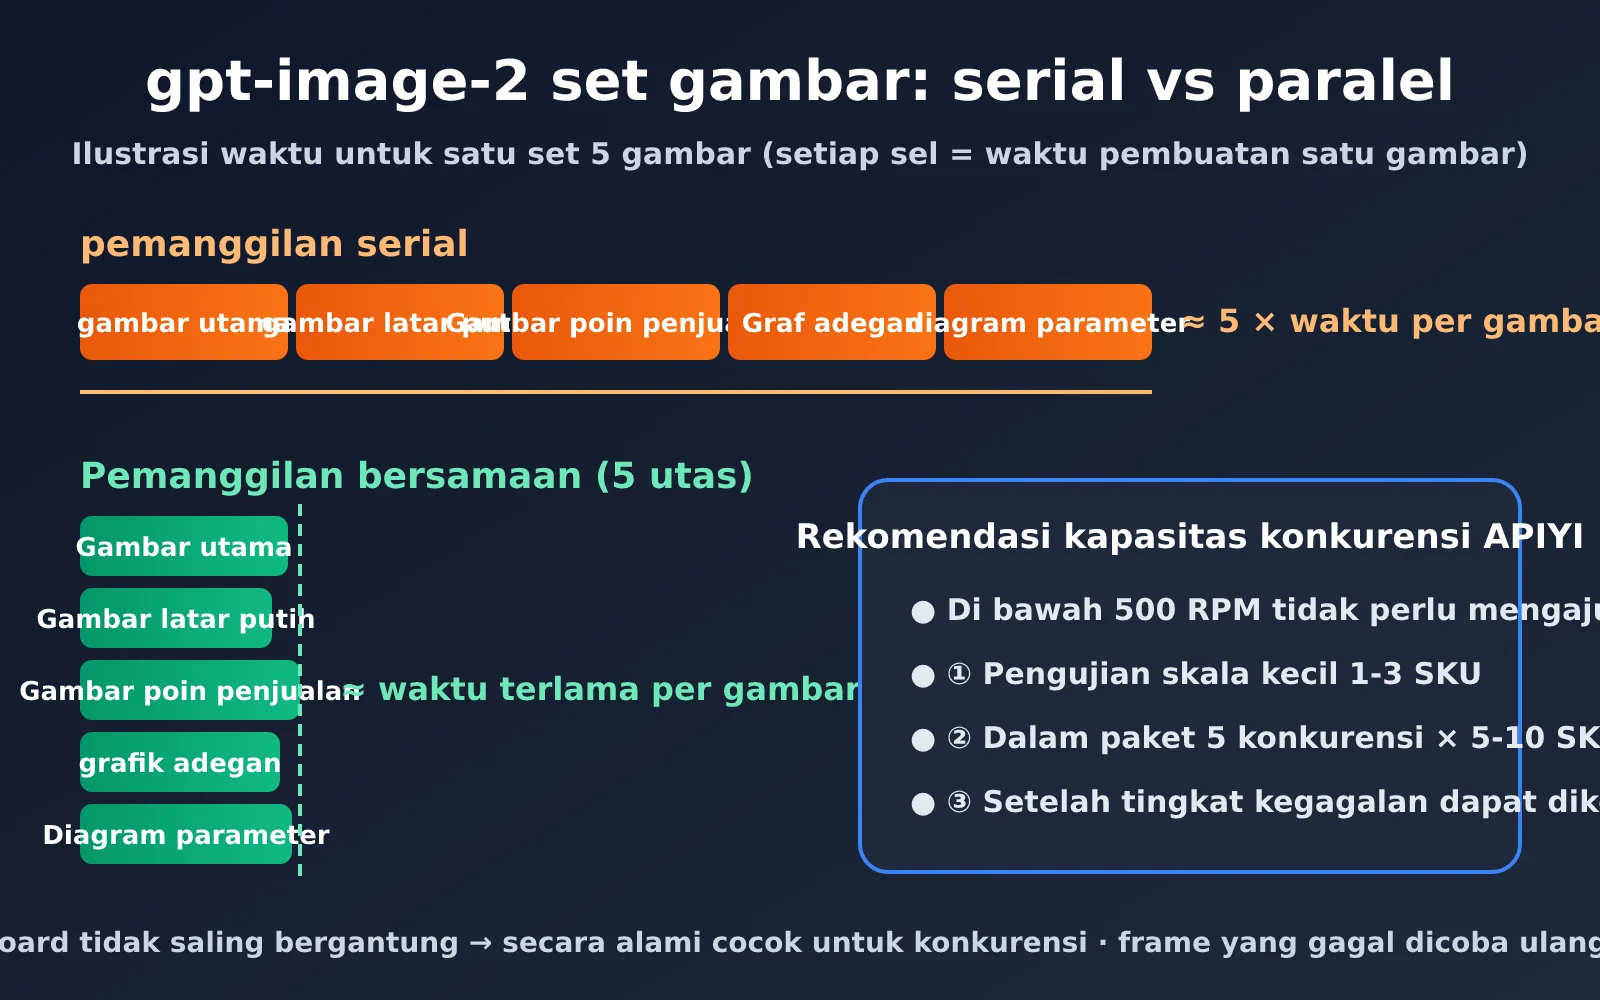
Membuat satu set 5 gambar secara serial berarti waktu tunggunya adalah jumlah waktu tiap gambar — semakin banyak gambar, semakin lambat. Karena setiap shot tidak saling bergantung, kita bisa memanggilnya secara paralel, sehingga total waktu satu set mendekati waktu “gambar paling lambat”.
APIYI tidak menerapkan batas konkurensi pada pemanggilan gpt-image-2. Di bawah 500 RPM bisa langsung dipakai, tanpa perlu pengajuan tambahan. Untuk sebagian besar pedagang, bahkan menjalankan puluhan SKU set gambar sekaligus pun masih jauh dari ambang tersebut.
Kode paralel untuk set gambar gpt-image-2
Cukup ganti loop serial di atas dengan thread pool, dan pembuatan gambar paralel pun terwujud. Tambahkan juga retry saat gagal, supaya satu gambar yang error tidak membuat seluruh set harus diulang:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
Lihat kode versi lengkap (termasuk style block, batch multi-SKU, pembuatan ulang gambar gagal, dan penyimpanan hasil)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """Pecah shot dengan model teks; untuk batch bisa ganti ke claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """Buat satu gambar, retry dengan exponential backoff saat gagal"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] percobaan ke-{attempt + 1} gagal: {e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # Buat ulang satu putaran untuk gambar yang gagal
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: berhasil {sum(1 for v in results.values() if v)}/{len(shots)} gambar")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
3 tahap perluasan konkurensi
Meskipun tidak ada batas konkurensi, kami tetap menyarankan perluasan bertahap: validasi hasilnya dulu, baru perbesar skala. Ini menghindari menghasilkan ratusan gambar tidak layak dalam sekali jalan:
- Uji skala kecil: pilih 1-3 SKU, jalankan secara serial atau dengan konkurensi rendah, lalu periksa manual tingkat kemiripan produk, akurasi teks, dan konsistensi gaya.
- Konkurensi sedang: setelah hasil stabil, naikkan ke 5 konkurensi per set gambar dan 5-10 SKU sekaligus, sambil memantau tingkat kegagalan dan rata-rata waktu proses.
- Perluasan batch: setelah tingkat kegagalan terkendali, tingkatkan konkurensi sesuai volume bisnis. Selama di bawah 500 RPM, semuanya bisa dijalankan langsung.
| Cara pemanggilan | Waktu satu set 5 gambar | Stabilitas | Tahap yang cocok |
|---|---|---|---|
| Pemanggilan serial | Sekitar 5x waktu satu gambar | Paling stabil, mudah di-debug | Masa penyetelan petunjuk |
| Paralel dalam set (5 thread) | Kira-kira sama dengan gambar paling lambat | Stabil | Update produk harian |
| Multi-SKU + paralel dalam set | Mendekati satu set tunggal | Perlu disertai retry | Update massal jelang promo besar |
🚀 Saran perluasan skala: untuk kebutuhan update produk yang menumpuk sebelum promo besar, kami merekomendasikan pola “multi-SKU + paralel dalam set” lewat APIYI apiyi.com. Platform tidak memerlukan pengajuan apa pun di bawah 500 RPM, dan dengan mekanisme pembuatan ulang gambar yang gagal, seluruh set gambar untuk puluhan SKU bisa selesai dalam waktu singkat.
Bagaimana memilih skema set gambar e-commerce gpt-image-2
Kedua skema tidak saling eksklusif dan sering dikombinasikan dalam praktik bisnis. Berikut rekomendasi berdasarkan platform dan skenario umum:
| Platform/Skenario | Skema yang disarankan | Jumlah gambar yang disarankan | Keterangan |
|---|---|---|---|
| Gambar utama Taobao/Tmall | Skema 2 | 5 gambar | Satu gambar masing-masing untuk gambar utama, latar putih, nilai jual, suasana, dan parameter |
| Halaman detail Taobao/Pinduoduo | Skema 1 + Skema 2 | 3-6 gambar setengah layar | Hasilkan per bagian lalu gabungkan secara vertikal |
| Listing Amazon | Skema 2 | 7 gambar | Gambar pertama berlatar putih harus sepenuhnya patuh aturan; sisanya untuk nilai jual dan suasana |
| Halaman produk situs mandiri | Skema 2 | 4-6 gambar | Gambar suasana lebih diprioritaskan, tonjolkan karakter merek |
| Rekomendasi produk di Xiaohongshu | Skema 2 | 3-6 gambar | Format vertikal 3:4, utamakan suasana sehari-hari |
| Poster kampanye/kumpulan nilai jual | Skema 1 | 1 gambar | Informasi terkonsentrasi dalam satu gambar, efisiensi penyebaran tinggi |
Prinsip inti pemilihannya sederhana: gambar yang perlu ditayangkan dan ditampilkan secara terpisah gunakan Skema 2; konten yang dibaca berurutan dalam satu halaman gunakan Skema 1. Jika ragu, buat dulu gambar utama dan gambar suasana dengan Skema 2, lalu buat satu gambar panjang kumpulan nilai jual dengan Skema 1, cakupannya paling luas.
💡 Saran kombinasi: kedua skema menggunakan model gpt-image-2 dan kunci API yang sama. Sebaiknya bungkus kedua alur kerja menjadi satu layanan, pilih skema otomatis berdasarkan jenis produk, sehingga penjual hanya perlu mengunggah satu foto produk dan beberapa baris teks nilai jual.
Pertanyaan umum
Apakah parameter n gpt-image-2 bisa langsung menghasilkan set gambar e-commerce?
Tidak bisa. gpt-image-2 resmi dan seri 2.5 sama-sama mendukung parameter n; APIYI juga mendukungnya, tetapi parameter ini menghasilkan n variasi dari petunjuk yang sama. Setiap gambar dalam set memiliki konten berbeda dan memerlukan petunjuk berbeda, jadi harus memanggil API beberapa kali. n lebih cocok dipakai untuk memilih yang terbaik di posisi kunci seperti gambar utama.
Bagaimana jika produk terlihat berbeda di beberapa gambar yang dihasilkan?
Ini masalah paling umum dalam set gambar. Cara paling efektif adalah setiap pemanggilan menggunakan antarmuka edits dan mengirimkan foto produk asli yang sama, lalu tuliskan dalam petunjuk: “Pertahankan warna, Logo, dan struktur produk dalam gambar referensi tanpa perubahan.” Pada saat yang sama, tetap kan deskripsi gaya sebagai style block; jangan biarkan model teks berkreasi bebas. Untuk gambar referensi, sebaiknya gunakan foto asli dengan latar bersih dan pencahayaan merata agar hasil rekonstruksinya paling baik.
Bagaimana menangani kesalahan rendering teks Mandarin dalam gambar?
Kemampuan rendering teks Mandarin gpt-image-2 sudah cukup kuat, tetapi semakin banyak teks, semakin tinggi kemungkinan salah. Sebaiknya batasi teks di setiap gambar dalam 2-3 kalimat pendek, dan tandai teks asli dengan tanda kutip di dalam petunjuk. Jika teks pada salah satu gambar salah, cukup hasilkan ulang gambar itu saja; tidak perlu mengulang seluruh set.
Model mana yang paling hemat untuk memecah teks?
Saat men-debug templat petunjuk, gunakan gpt-6.1-sol karena kualitas perencanaannya paling baik; setelah templat stabil dan ingin menjalankan produksi massal, beralihlah ke claude-haiku-5-5 atau gemini-3.8-flash yang lebih murah dan cepat. Langkah ini hanya dipanggil sekali per set gambar, biayanya jauh lebih rendah daripada pembuatan gambar itu sendiri. Ketiga model dapat dipanggil di APIYI apiyi.com menggunakan kunci API yang sama.
Apakah pemanggilan bersamaan perlu mengajukan kuota?
Tidak perlu. APIYI tidak menetapkan batas atas konkurensi untuk gpt-image-2; di bawah 500 RPM bisa langsung digunakan. Sebaiknya mulai dengan 1-3 SKU untuk pengujian skala kecil, lalu tingkatkan konkurensi secara bertahap setelah hasilnya terkonfirmasi.
Ringkasan
Dalam menghasilkan set gambar e-commerce dengan gpt-image-2, kuncinya adalah memahami karakteristik antarmuka yang “satu panggilan untuk satu petunjuk”. Parameter n menyelesaikan soal memilih yang terbaik, sementara set gambar justru membutuhkan banyak panggilan dengan petunjuk yang berbeda-beda. Dengan premis itu, konten yang dibaca berurutan seperti halaman detail dan kumpulan selling point bisa dibuat sekaligus dengan solusi multi-dimensi satu gambar; sementara set gambar yang perlu ditampilkan sendiri-sendiri seperti gambar utama dan gambar skenario, diselesaikan secara batch lewat pipeline dekomposisi model teks + pemanggilan paralel.
Inti bersama dari kedua jalur ini adalah kontrol konsistensi: blok gaya (style block) yang tetap ditambah gambar referensi produk yang sama, itulah kunci agar beberapa gambar terlihat berasal dari tim desain yang sama. Untuk konkurensi, di bawah 500 RPM bisa langsung dilepas, dengan tiga langkah “tes skala kecil → konkurensi sedang → pelepasan batch” yang paling aman.
Kami menyarankan menyelesaikan seluruh pipeline secara terpadu lewat APIYI apiyi.com: gpt-6.1-sol, claude-haiku-5-5, dan gemini-3.8-flash menangani dekomposisi kebutuhan, gpt-image-2 menangani pembuatan gambar, dan satu kunci API menghubungkan semua tahap, sehingga Anda bisa dengan cepat membangun layanan pembuatan set gambar e-commerce sendiri.
Penulis: Tim APIYI | Fokus berbagi teknologi API Model Bahasa Besar AI, untuk tutorial integrasi model lainnya silakan kunjungi APIYI apiyi.com