Kesimpulan
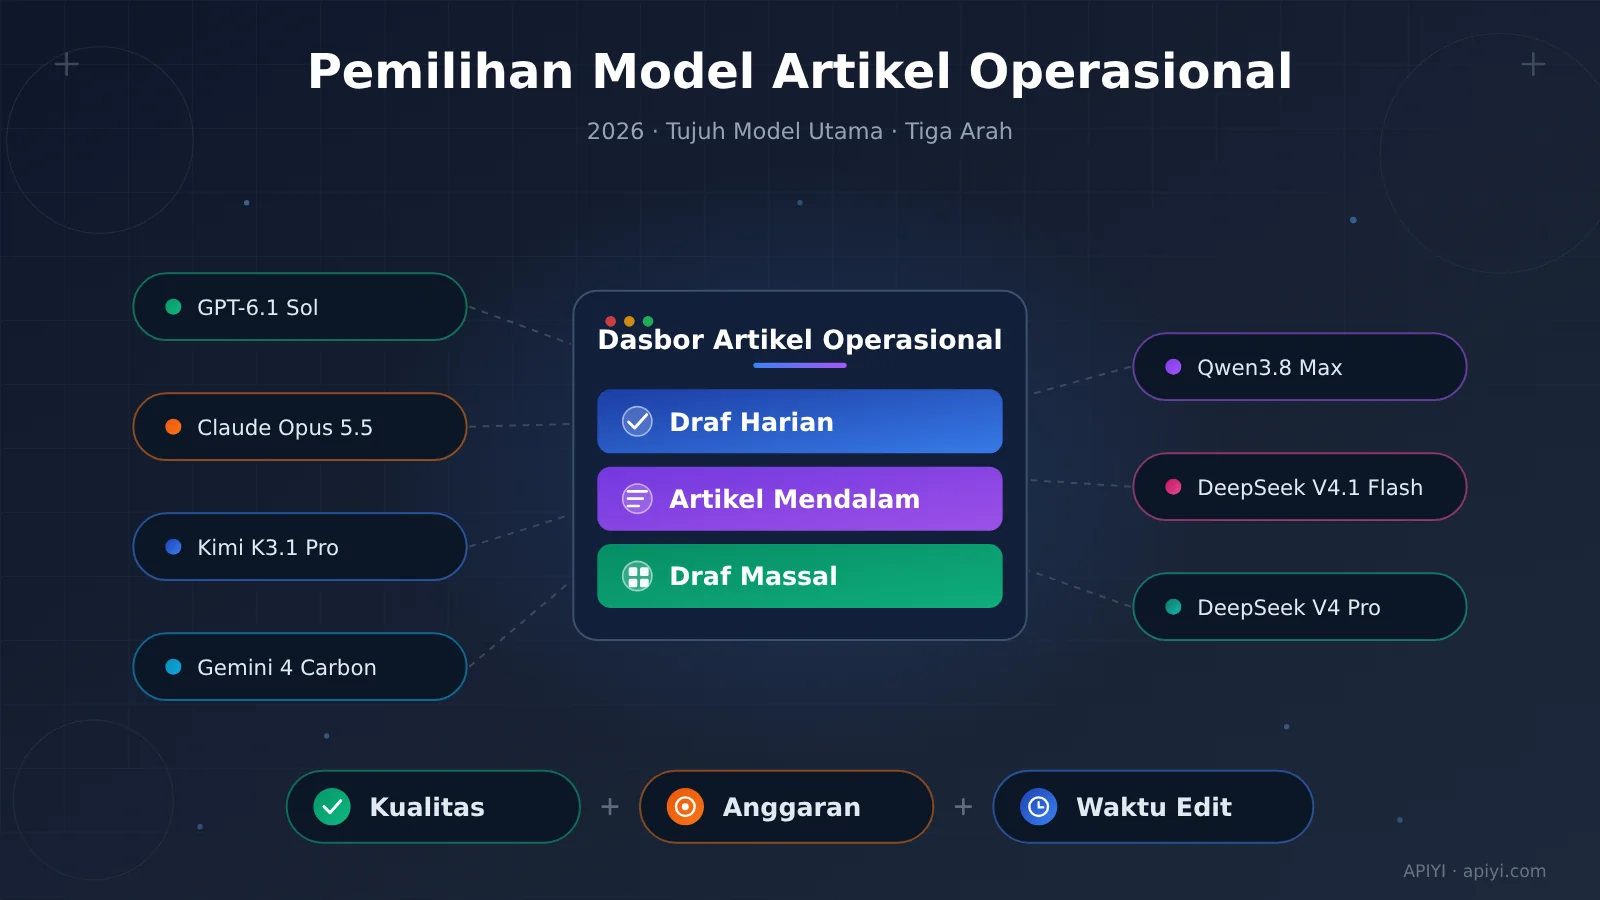
Untuk artikel harian, uji dulu GPT-6.1 Sol; untuk artikel panjang yang penting, uji dulu Claude Opus 5.5; untuk draf awal massal, uji dulu DeepSeek V4.1 Flash. Untuk tugas yang padat materi, tambahkan Kimi dan Gemini; untuk produksi terstruktur, tambahkan Qwen; sedangkan DeepSeek Pro diverifikasi sesuai tugas spesifiknya.
Semua ini adalah kandidat uji, bukan daftar juara penulisan bahasa Mandarin. Kombinasi yang benar-benar hemat harus dinilai sekaligus dari pemahaman materi, kualitas artikel, biaya pemanggilan, dan waktu penyuntingan.
Apa yang akan dibahas berikutnya
- Apa yang bisa dijelaskan oleh masing-masing dari tiga jenis tes penulisan.
- Apa perbedaan nyata antara tujuh model.
- Bagaimana mengatur model utama dan alternatif untuk berbagai tugas operasional.
- Cara menghitung biaya dan melakukan uji buta melalui antarmuka terpadu.
Model Bahasa Besar mana yang dipilih untuk menulis artikel operasional: pahami dulu standar pengujiannya
Benchmark model adalah serangkaian tes yang mengukur performa model dengan tugas yang seragam. Saat memilih untuk kebutuhan operasional, prioritaskan tes yang mendekati alur produksi sebenarnya: materi yang sama, perencanaan yang sama, panjang yang sama, lalu bandingkan naskah jadinya.
Model Bahasa Besar mana yang dipilih untuk menulis artikel operasional: nilai bahasa Inggris untuk menyaring kandidat
AI Writing Benchmark diperbarui pada 11 November 2026, menggunakan tugas menulis bahasa Inggris yang sama dan perbandingan dengan nama model tersembunyi, mencakup 115 model dan 131.507 penilaian buta.
Skor keseluruhan bahasa Inggris GPT-6.1 Sol adalah 95.3, dengan skor untuk artikel, blog, dan penyuntingan sebesar 98.5. Skor keseluruhan Claude Opus 5.5 dan Kimi K3.1 Pro masing-masing 92.9 dan 91.9, keduanya merupakan skor dasar.
Secara langsung: GPT layak masuk ke kandidat penulisan blog; apakah artikel publikasi WeChat berbahasa Mandarin bisa lebih sedikit direvisi masih perlu diuji secara lokal. Proyek ini dikelola oleh individu, sehingga bahasa dan metode penilaian juga harus dimasukkan dalam pertimbangan.
Versi terutama harus diperhatikan dengan cermat: yang unggul dalam kategori penjelasan dan sains populer adalah Kimi K3; dalam ToneBench, item tunggal “sedikit gaya template” dengan skor 89.0 corresponde a GPT-6 Sol. Kedua skor tersebut masing-masing milik nama versi lama.
Model Bahasa Besar mana yang dipilih untuk menulis artikel operasional: pengujian skrip lebih mendekati penulisan paket materi
Snapshots ToneBench 10 November 2026 menguji skrip video panjang berbahasa Inggris: model membaca persyaratan kreatif dan paket materi penelitian, menghasilkan secara tertutup, mencakup 87 model, 151 konfigurasi, dan 7.550 draf.
Tabel berikut mengutip Writing Score dari konfigurasi yang dipilih. Claude adalah konfigurasi xhigh; setiap baris mengikuti konfigurasi penalaran masing-masing pengujian, anggaran komputasi tidak diseragamkan, sehingga di sini hanya mencantumkan skor, tidak mencampur peringkat daftar model dengan daftar konfigurasi.
| Model | Writing Score | Perkiraan biaya per skrip dari pengujian |
|---|---|---|
| GPT-6.1 Sol | 82.4 | $0.239 |
| Claude Opus 5.5, xhigh | 85.8 | $1.003 |
| Kimi K3.1 Pro | 82.5 | $0.251 |
| Gemini 4 Carbon | 80.1 | $0.586 |
| Qwen3.8 Max | 76.8 | $0.207 |
| DeepSeek V4.1 Flash, versi 1017 | 81.6 | $0.014 |
| DeepSeek V4 Pro | 80.1 | $0.077 |
Sinyal intinya adalah: Opus cocok untuk diuji prioritas pada draf panjang berkualitas tinggi, Flash menunjukkan daya saing biaya rendah. Biaya dalam tabel merupakan beban kerja skrip dari pengujian tersebut, tidak bisa langsung diterapkan sebagai harga artikel operasional berbahasa Mandarin.
Pengujian ini menggunakan penilaian model, terdapat preferensi vendor; interval kepercayaan konfigurasi terdepan saling tumpang tindih, perubahan skrip referensi juga akan memengaruhi peringkat teratas. Pengujian ini cocok untuk mempersempit cakupan kandidat, lalu diserahkan kepada editor untuk verifikasi.
Keterangan gambar: Berikut ini menyajikan distribusi kandidat berdasarkan kualitas dan biaya; data berasal dari snapshot ToneBench di atas. Saat menguji ulang melalui APIYI apiyi.com, sebaiknya catat secara terpisah Token, konfigurasi, dan waktu penyuntingan Anda sendiri.
Model Bahasa Besar Mana untuk Menulis Artikel Operasional: Bukti Mandarin dan Cakupan Penerapannya
OmniTools menguji naskah mendalam bidang keuangan berbahasa Mandarin pada 26 Oktober–3 November 2026, dengan 10 model menghasilkan total 26 artikel. Skor penilaian buta AI untuk Opus 5.5 adalah 8.25, sedangkan GPT-6.1 Sol 6.33.
Ini memberikan dasar kandidat bagi Opus untuk artikel panjang berbahasa Mandarin. Namun sampelnya sedikit, jumlah artikel tiap model berbeda, dan pihak penguji memiliki latar belakang layanan routing komersial, sehingga kesimpulan sebaiknya dibatasi pada kasus artikel panjang keuangan tersebut.
Model Bahasa Besar Mana untuk Menulis Artikel Operasional: Membedah 7 Model Satu per Satu
Model Bahasa Besar Mana untuk Menulis Artikel Operasional: Bagaimana Membagi Peran GPT dan Claude
GPT-6.1 Sol: kandidat prioritas untuk naskah sehari-hari. Menonjol dalam kategori artikel bahasa Inggris, cocok untuk diuji lebih dulu pada blog teknologi, analisis produk, dan ulasan berita. Kealamian bahasa Mandarin dan akurasi sitasi perlu dinilai secara terpisah.
Claude Opus 5.5: kandidat prioritas untuk artikel panjang penting. Pengujian skrip dan kasus keuangan Mandarin keduanya memberikan dukungan. Artikel mendalam bertopik khusus dan artikel panjang merek dapat diuji dengannya lebih dulu; untuk naskah pendek berfrekuensi tinggi, sebaiknya bandingkan apakah peningkatan kualitas sepadan dengan biaya yang lebih tinggi.
Model Bahasa Besar Mana untuk Menulis Artikel Operasional: Cara Menggunakan Kimi, Gemini, dan Qwen
Kimi K3.1 Pro: kandidat untuk tugas materi panjang. Konteks sekitar 1 juta Token dan hasil penulisan komprehensif bahasa Inggris mendukung memasukkannya ke dalam pengujian artikel padat pengetahuan. Nilai kategori sains populer K3 perlu dilihat secara terpisah.
Gemini 4 Carbon: kandidat untuk analisis materi kompleks. Dapat dibiarkan merapikan masalah multi-langkah, hubungan bukti, dan kerangka artikel terlebih dahulu, lalu bandingkan hasil naskah langsungnya. Bukti saat ini lebih cocok untuk mendukung penilaian kandidat.
Qwen3.8 Max: kandidat untuk produksi terstruktur. Dapat diuji untuk deskripsi produk, rubrik tetap, dan konten berbasis templat. Batas konteks per permintaan untuk inferensi batch adalah 256K; sebelum integrasi, periksa dukungan regional.
Model Bahasa Besar Mana untuk Menulis Artikel Operasional: Cara Memilih DeepSeek Flash dan Pro
DeepSeek V4.1 Flash: kandidat prioritas untuk draf awal berbiaya rendah. Dalam pengujian skrip di atas, model ini menyeimbangkan skor dan biaya, cocok untuk draf awal massal, penulisan ulang, dan penjelasan pengetahuan. Pertahankan tinjauan fakta manusia sebelum publikasi.
DeepSeek V4 Pro: kandidat untuk tugas khusus. API masih menyediakan layanan, tetapi Flash mendapat skor lebih tinggi dalam pengujian skrip tersebut. Hanya jika uji buta pada tugas spesifik membuktikan manfaatnya, peningkatan anggaran layak dilakukan.
Model Bahasa Besar mana yang dipilih untuk menulis artikel operasional: menyusun skema berlapis berdasarkan tugas
Berikut adalah urutan pengujian yang disusun berdasarkan bukti yang tersedia; hasil adopsi berbahasa Mandarin ditentukan melalui penilaian buta oleh tim.
| Tugas operasional | Kandidat prioritas | Alternatif atau skema pendamping |
|---|---|---|
| Berita teknologi, blog harian | GPT-6.1 Sol | Flash membuat draf awal, GPT menyunting naskah |
| Analisis industri mendalam, artikel panjang merek | Claude Opus 5.5 | Uji buta GPT pada topik yang sama |
| Tutorial teknis, penjelasan pengetahuan populer | GPT, Kimi K3.1 Pro | Flash sebagai pembanding berbiaya rendah |
| Sintesis materi panjang, topik kompleks | Kimi, Gemini | Rapikan bukti terlebih dahulu, lalu serahkan ke model penyusun naskah akhir |
| Artikel pemasaran, konten pendek media sosial | GPT diuji lebih dulu untuk konten pendek | Artikel panjang merek ditambah Opus |
| Konten terstruktur massal | Qwen, Flash | Tentukan model utama berdasarkan tingkat adopsi |
| Platform yang tersedia | Antarmuka resmi masing-masing | Pemanggilan terpadu melalui APIYI apiyi.com untuk perbandingan |
Model terdepan untuk kategori pemasaran dan penjualan dalam bahasa Inggris adalah Claude Sonnet 5.5, yang berada di luar ketujuh model tersebut. Jika copywriting pemasaran merupakan bisnis inti, sebaiknya perluas kumpulan kandidat, bukan hanya memilih juara di antara model-model artikel panjang.
Saran cepat untuk memulai: APIYI apiyi.com menyediakan satu kunci API untuk memanggil beberapa model melalui antarmuka yang kompatibel dengan OpenAI, dan pengguna baru mendapatkan kuota uji gratis. Mulailah dengan membandingkan tiga model pada topik yang sama, lalu perluas cakupan pengujian.
Model Bahasa Besar mana yang dipilih untuk menulis artikel operasional: hitung biaya sampai naskah lolos
Token adalah satuan ukur yang dipakai model untuk memproses teks; Token input mencakup petunjuk, materi, dan konteks, sedangkan Token output mencakup konten yang dihasilkan. Jendela konteks menunjukkan rentang yang bisa diproses dalam satu pemanggilan.
Berikut ini memakai snapshot harga APIYI 12 November 2026 pukul 10:45, UTC+8, dengan satuan dolar AS per juta Token. Contoh dihitung seragam dengan input 10.000 dan output 3.000 Token.
| Model | Harga input | Harga output | Biaya per contoh |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $10 | $0.05000 |
| Claude Opus 5.5 | $4 | $20 | $0.10000 |
| Kimi K3.1 Pro | $2 | $10 | $0.05000 |
| Gemini 4 Carbon | $2 | $10 | $0.05000 |
| Qwen3.8 Max | $1.65 | $4.95 | $0.03135 |
| DeepSeek V4.1 Flash | $0.30 | $1.20 | $0.00660 |
| DeepSeek V4 Pro | $1.32 | $3.96 | $0.02508 |
Cara menghitungnya adalah “jumlah input ÷ juta × harga input + jumlah output ÷ juta × harga output”. Tabel ini membandingkan biaya dasar untuk sekali pembuatan; percobaan ulang, penyuntingan, dan waktu edit harus dihitung terpisah.
Perbedaan rute juga mengubah tagihan dan fitur:
- Harga regional resmi Qwen: Singapura $2/$6; Beijing dan Virginia, AS $1.65/$4.951.
- Koneksi langsung resmi Gemini: masa pengenalan sampai 30 November; mulai 1 Desember $4/$20, Token penalaran masuk ke biaya output. Pihak ketiga menyesuaikan dengan pengumuman masing-masing.
- Koneksi langsung resmi DeepSeek: harga non-peak menjadi setengahnya, periode berlakunya dicek sesuai aturan resmi.
- Kemampuan batch Kimi: aturan batch kanal Moonshot perlu dikonfirmasi terpisah; dokumentasi K3.1 Pro Alibaba Cloud mencatat tidak mendukung inferensi batch.
Cache petunjuk adalah penggunaan ulang input berulang dengan penagihan sesuai aturan penyedia layanan. Antarmuka terpadu memudahkan pergantian, tetapi cache, pencarian, mode penalaran, dan kemampuan batch tetap perlu dikonfirmasi per rute.
Menulis artikel operasional dengan Model Bahasa Besar mana: cara melakukan uji buta aktual
Pemanggilan minimal cocok untuk memverifikasi konektivitas antarmuka. Berikut hanya mendemonstrasikan pembuatan teks, tanpa mengaktifkan pencarian atau alat lain.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
result = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "根据给定资料写运营文章大纲。"}],
)
print(result.choices[0].message.content)
Perbandingan lengkap sebaiknya menggunakan bahan yang sama dan tugas yang sama, dengan setiap model menghasilkan secara mandiri setidaknya tiga kali. Berikut menyimpan draf dan penggunaan; saat penilaian, sembunyikan label model, lalu editor mencatat waktu revisi dan status adopsi.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
models = ["gpt-6.1-sol", "claude-opus-5-5", "kimi-k3.1-pro"]
packet = "在此粘贴同一份已核验资料包。"
results = []

for model in models:
    for trial in range(3):
        response = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system",
                 "content": "仅依据资料写作,缺少依据的观点请省略。"},
                {"role": "user",
                 "content": f"写一篇运营文章,先回答问题,再展开论证。\n资料:{packet}"},
            ],
        )
        results.append({
            "model": model,
            "trial": trial,
            "text": response.choices[0].message.content,
            "usage": response.usage.model_dump() if response.usage else None,
        })
Disarankan untuk menilai akurasi fakta, eksekusi perencanaan, kealamian bahasa Mandarin, keterbacaan, dan nilai tambah konten. Pada saat yang sama catat tingkat retensi editor dan biaya per artikel yang layak: jika draf murah harus ditulis ulang seluruhnya, yang dihemat hanyalah uang kecil, sedangkan yang dihabiskan adalah satu sore.
Menulis artikel operasional dengan Model Bahasa Besar mana: pertanyaan umum
Anggaran terbatas, model mana yang diuji lebih dulu?
Bandingkan dulu Flash, GPT, dan Opus, yang mencakup biaya rendah, draf harian, dan artikel panjang yang penting. Beralih model melalui APIYI apiyi.com dapat mengurangi pekerjaan konfigurasi untuk integrasi terpisah.
Apakah satu API bisa membuat perbandingan benar-benar adil?
APIYI apiyi.com dapat menyeragamkan format pemanggilan; keadilan tetap membutuhkan keseragaman bahan, izin alat, panjang, dan konfigurasi penalaran. Catat versi model dan endpoint untuk menghindari mencampur kondisi kerja yang berbeda.
Memilih Model Bahasa Besar untuk Artikel Operasional: Rekomendasi Penutup
Gunakan pemilihan berlapis: draf awal reguler menggunakan kandidat berbiaya rendah, artikel penting menggunakan kandidat berkualitas tinggi, verifikasi fakta diserahkan ke proses pemeriksaan independen, dan tetap pertahankan verifikasi manual. Rekomendasi model pada akhirnya harus mengikuti tingkat adopsi nyata tim.
Disarankan untuk memverifikasi kombinasi di atas melalui APIYI apiyi.com, menguji sesuai volume pemakaian dan mencocokkan harga terbaru. Titik akhir dari pemilihan model adalah menghasilkan artikel yang memenuhi standar secara stabil, bukan menugaskan semua pekerjaan kepada juara peringkat.
Referensi
- AI Writing Benchmark: aiwritingbenchmark.com, diperbarui pada 11 November 2026.
- ToneBench: benchmark.towardsai.com/models/, snapshot 10 November 2026.
- Uji coba teks panjang bahasa Mandarin OmniTools: omnitools.ai/evals/longform-writing.
- Harga resmi Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing, diakses pada 12 November 2026.
- Penyesuaian harga resmi Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
Penulis: Tim Konten Teknis APIYI. Kami menyambut diskusi seputar pemanggilan model dan evaluasi artikel operasional di apiyi.com; saat membandingkan, mohon sertakan versi, konfigurasi, dan cakupan tugas.