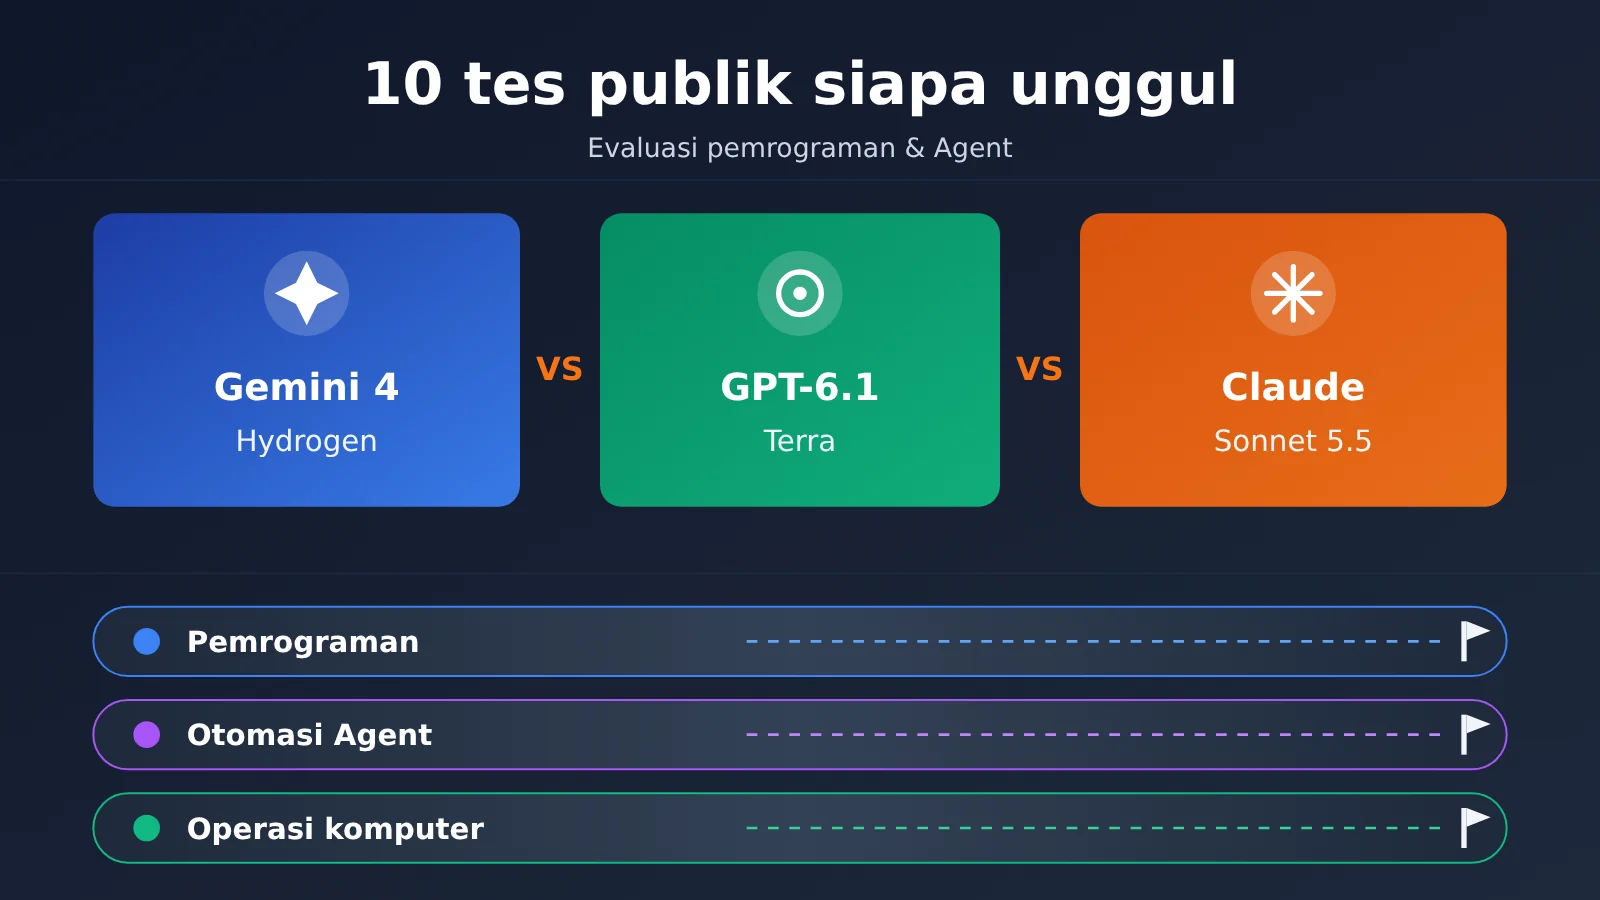
Catatan penulis: Berdasarkan 10 evaluasi lintas model yang diumumkan Google DeepMind, artikel ini mengulas kekuatan dan kelemahan Gemini 4 Hydrogen, GPT-6.1 Terra, dan Claude Sonnet 5.5 dalam pemrograman, otomasi Agent, serta pengoperasian komputer—sekaligus memberikan saran pemilihan model berdasarkan jenis tugas.
Ringkasan satu kalimat: Evaluasi lintas model yang dipublikasikan Google menunjukkan bahwa Gemini 4 Hydrogen dan Claude Sonnet 5.5 memiliki keunggulan masing-masing pada tugas pemrograman dan Agent yang berbeda, sementara GPT-6.1 Terra unggul dalam hal biaya dan posisinya untuk operasi visual. Pemilihan model sebaiknya mempertimbangkan kondisi pengujian, jenis tugas, dan biaya.
Perlu diketahui: 5 istilah yang perlu dipahami sebelum membaca artikel ini
- Harness: Kerangka pengujian yang mengatur input model, eksekusi alat, dan penilaian tugas. Model yang sama dapat menghasilkan skor yang sangat berbeda jika dijalankan dengan Harness lain.
- Versi benchmark: Versi data, tugas, dan aturan untuk suatu evaluasi. Misalnya, Terminal-Bench 4.0 dan 4.1 adalah versi yang berbeda, sehingga skornya perlu ditafsirkan secara terpisah.
- Agent: Sistem yang menyelesaikan tugas multi-langkah melalui kerja sama antara model dan lingkungan eksekusi alat. Skornya mencerminkan performa keseluruhan “model + toolchain”.
- Token: Satuan ukuran yang digunakan model untuk memproses teks dan informasi lain. Harga API biasanya dihitung per juta Token.
- API: Antarmuka yang memungkinkan program memanggil layanan. Melalui API, pengembang dapat menghubungkan model ke aplikasi atau Agent mereka sendiri.
Pada 12 November 2026, Google resmi merilis Gemini 4 Hydrogen dan, dalam model card resminya, menempatkannya bersama GPT-6.1 Terra serta Claude Sonnet 5.5 dalam satu tabel evaluasi yang sama. Tabel ini mencakup pemrograman, otomasi Agent, pengoperasian komputer, dan pekerjaan pengetahuan multimodal; saat ini, inilah data perbandingan publik paling lengkap untuk ketiga model tersebut.
Ini bukan analisis kompromi yang sekadar “masing-masing punya kelebihan”. Kami akan mengurai satu per satu apa yang diukur setiap pengujian dan dalam kondisi apa pengujian itu dijalankan, lalu menarik kesimpulan untuk tiga bidang—pemrograman, Agent, dan pengoperasian komputer—dan pada akhirnya menyajikan matriks pemilihan model yang bisa langsung diterapkan.
Nilai utama: Setelah membaca artikel ini, Anda akan memahami pada tugas apa Gemini 4 Hydrogen unggul, pada tugas apa ia kalah dari Sonnet 5.5, serta di posisi mana Terra cocok ditempatkan dalam alur kerja tim.
Mengapa membandingkan Gemini 4 Hydrogen dengan Terra dan Sonnet 5.5
Ketiga model ini diluncurkan dalam rentang waktu kurang dari dua bulan, dan posisi mereka juga sangat tumpang tindih: semuanya bukan model penalaran andalan paling berat dari masing-masing perusahaan, melainkan “model pekerja utama” yang ditujukan untuk pengembang, eksekusi Agent, dan tugas-tugas profesional berfrekuensi tinggi. Bagi tim yang perlu melakukan pemanggilan dalam jumlah besar setiap hari, merekalah lapisan yang benar-benar menentukan biaya dan efisiensi.
Gemini 4 Hydrogen adalah model efisiensi tinggi generasi baru dari Google DeepMind, diposisikan secara resmi untuk pemrograman sehari-hari dan eksekusi AI Agent, dapat berjalan secara mandiri, juga dapat berperan sebagai pelaksana atau verifikator dalam sistem multi-model. GPT-6.1 Terra dirilis oleh OpenAI pada 26 Oktober 2026, menekankan penalaran visual, operasi komputer, dan pekerjaan sehari-hari berfrekuensi tinggi. Claude Sonnet 5.5 dirilis oleh Anthropic pada 28 September 2026, dengan penekanan resmi pada pemrograman sehari-hari, perbaikan Bug, pembuatan dokumen profesional, dan desain antarmuka yang kompleks.
| Model | Produsen | Tanggal rilis | Posisi resmi | Harga API standar (per juta token, input/output) | Sumber harga |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | Pemrograman sehari-hari, pemanggilan multi-alat, eksekusi Agent | $1.50 / $7.50 | Halaman harga Google AI Studio, diverifikasi pada 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | Penalaran visual, operasi komputer, pekerjaan sehari-hari | $1 / $5 | Materi rilis OpenAI, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | Pemrograman sehari-hari, perbaikan Bug, dokumen profesional, desain antarmuka | Materi referensi belum mencakup, mengacu pada halaman harga resmi | Situs resmi Anthropic |
Perlu dijelaskan bahwa token pemikiran Hydrogen dihitung ke dalam harga output, sehingga biaya sebenarnya tidak dapat diperkirakan hanya berdasarkan teks akhir yang terlihat. Selain itu, harga mode Batch dan Flex Hydrogen adalah $0.75 / $3.75, cocok untuk tugas batch offline.
Perbandingan kuantitatif dalam artikel ini terutama didasarkan pada kartu model versi November 2026 Google DeepMind beserta dokumen metodologi evaluasi pendukungnya. Ini berarti data diagregasi oleh Google, dan sebagian skor pesaing diambil dari laporan publik produsen atau papan peringkat; kami akan membahas dampaknya terhadap kesimpulan secara khusus di bagian kelima.
Perbandingan Kemampuan Pemrograman Gemini 4 Hydrogen: Siapa yang Lebih Andal Memperbaiki Masalah Nyata
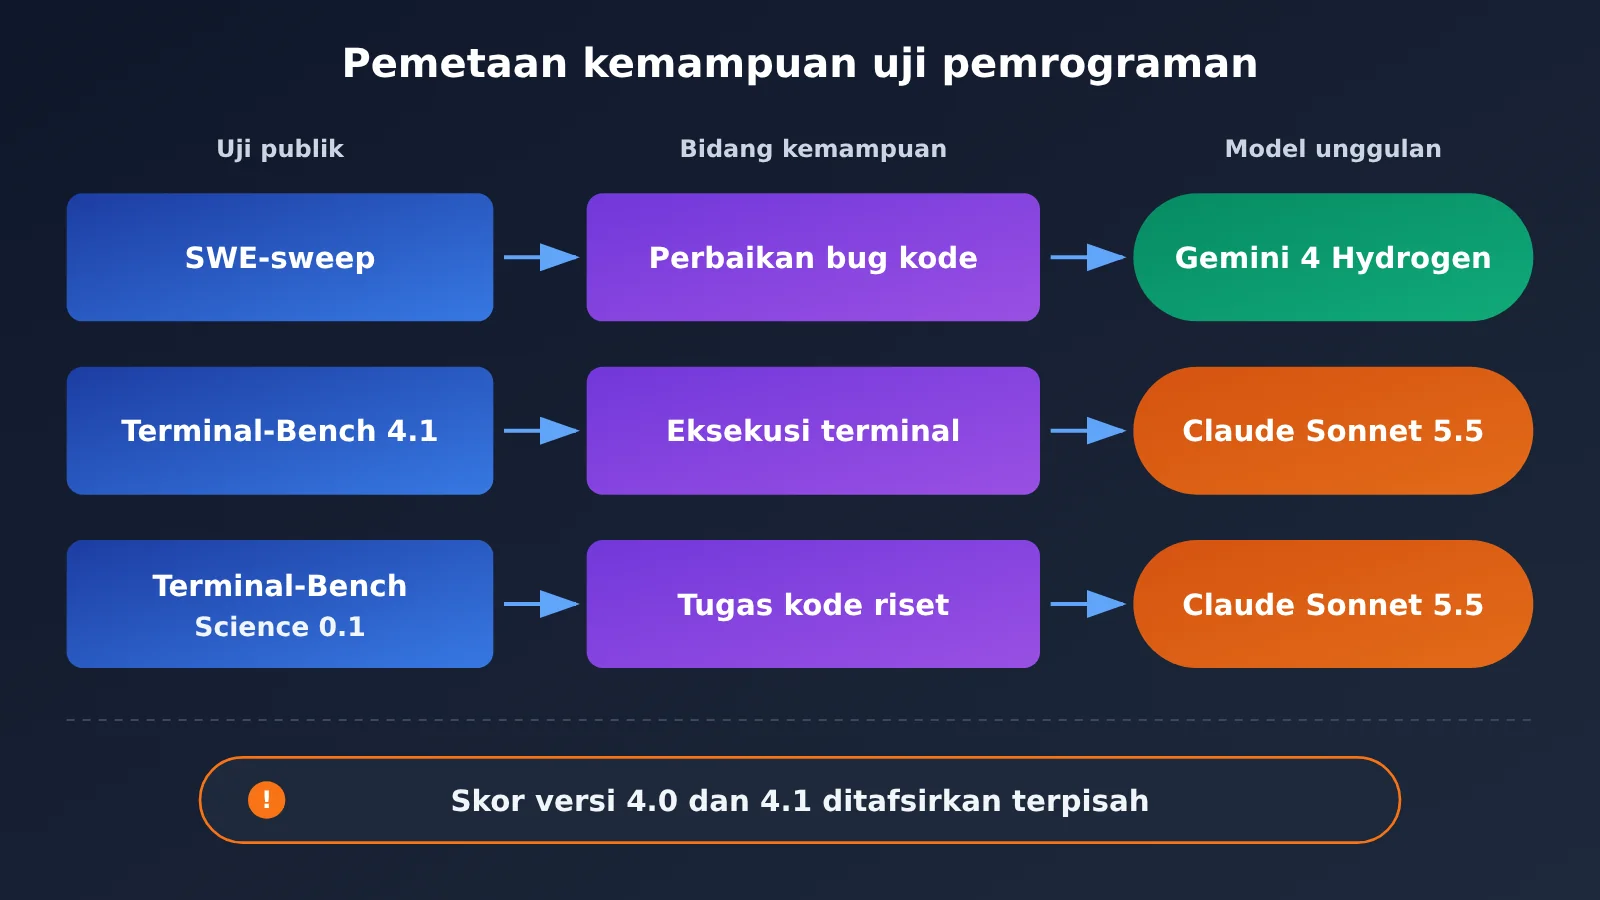
Pengujian di bidang pemrograman bisa dibagi menjadi dua kemampuan: pertama, menemukan dan memperbaiki masalah di dalam basis kode nyata; kedua, menjalankan perintah secara berurutan di lingkungan terminal untuk menyelesaikan tugas rekayasa. SWE-sweep condong ke kemampuan pertama, rangkaian Terminal-Bench condong ke kemampuan kedua, sedangkan Terminal-Bench-Science menguji kemampuan menyelesaikan tugas penelitian dengan kode.
| Evaluasi (versi) | Metrik | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Yang unggul |
|---|---|---|---|---|---|
| SWE-sweep | Reward tertimbang subtugas | 13,5% | 3,1% | 5,8% | Hydrogen |
| Terminal-Bench 4.1 | Reward rata-rata | 57,0% | 63,9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | Skor tugas | 51,4% | 59,9% | 58,3% | Sonnet |
Sumber: Google DeepMind《Gemini 4 Hydrogen Model Evaluation》dan kartu model, November 2026.
Membaca hasil pengujian pemrograman
Skor absolut SWE-sweep secara keseluruhan tergolong rendah, yang menunjukkan bahwa tes ini memang sangat sulit. Hydrogen mencatat 13,5%, sekitar dua kali lipat Terra dan lebih dari empat kali Sonnet — di sinilah selisihnya paling mencolok. Namun pada tes ini Hydrogen dijalankan menggunakan Antigravity-CLI 1.4.8 milik Google sendiri, sementara kondisi eksekusi para pesaing belum tentu setara, sehingga sebagian selisih bisa berasal dari penyesuaian Harness.
Pada Terminal-Bench 4.1, Sonnet 5.5 memimpin dengan 63,9% dibanding Hydrogen 57,0%; Terra tidak memiliki skor untuk tes ini di tabel Google. Hydrogen di sini menggunakan mini-swe-agent vision Harness dengan tingkat pemikiran High, dan setiap tugas dijalankan 5 kali lalu diambil reward rata-ratanya. Pada Terminal-Bench-Science 0.1, Sonnet tetap memimpin, Terra menyusul di 58,3%, sementara Hydrogen justru turun ke posisi ketiga.
Kesimpulan bidang pemrograman: Hydrogen punya keunggulan jelas pada tes perbaikan masalah basis kode seperti SWE-sweep; Sonnet 5.5 lebih stabil pada tugas eksekusi di terminal; Terra tampil mendekati Sonnet pada tugas kode ilmiah. Tidak ada satu model pun yang memimpin secara menyeluruh di semua tes pemrograman.
Data latar Terminal-Bench 4.0 yang dilaporkan vendor
OpenAI dan Anthropic masing-masing pernah merilis skor Terminal-Bench 4.0. Karena 4.0 dan 4.1 adalah versi benchmark yang berbeda, tabel berikut disajikan terpisah dan tidak boleh dibandingkan bersilang dengan skor 4.1 di tabel sebelumnya.
| Evaluasi (versi) | Model | Skor | Kondisi pengujian | Sumber |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70,6% | Uji mandiri vendor | Materi rilis Anthropic, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50,3% | Pengaturan penalaran tertinggi | Materi rilis OpenAI, 2026-10-26 |
Nilai data ini terletak pada acuan yang diberikannya: di bawah kondisi pengujian masing-masing vendor, kemampuan tugas terminal Sonnet 5.5 jelas lebih tinggi daripada Terra, sejalan dengan arah tabel Google yang menempatkan Sonnet unggul pada tes kelas terminal.
Apakah Gemini 4 Hydrogen Mampu Menyelesaikan Pekerjaan Secara Penuh dalam Pengujian Agent dan Otomasi
Perbedaan terbesar antara pengujian Agent dan tanya-jawab satu putaran adalah: model harus merencanakan langkahnya sendiri, memanggil alat secara berurutan, menyesuaikan strategi setelah gagal, dan akhirnya memverifikasi hasil. Pengujian semacam ini lebih mendekati alur kerja otomasi nyata, dan lebih menguji “disiplin eksekusi” model.
Tabel di bawah merangkum seluruh skor lintas model dari evaluasi Google untuk otomasi Agent, operasi komputer, dan pekerjaan pengetahuan multimodal. Tabel ini dipakai bersama oleh bagian ketiga dan keempat.
| Evaluasi (versi) | Bidang kemampuan | Metrik | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | Agent multi-langkah profesional | Skor tugas | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | Otomasi alur kerja | Skor tugas | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | Simulasi bisnis jangka panjang | Saldo dana akhir | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | Operasi komputer/antarmuka grafis | Tingkat keberhasilan tugas | 77.6% | 83.9% | 74.2% |
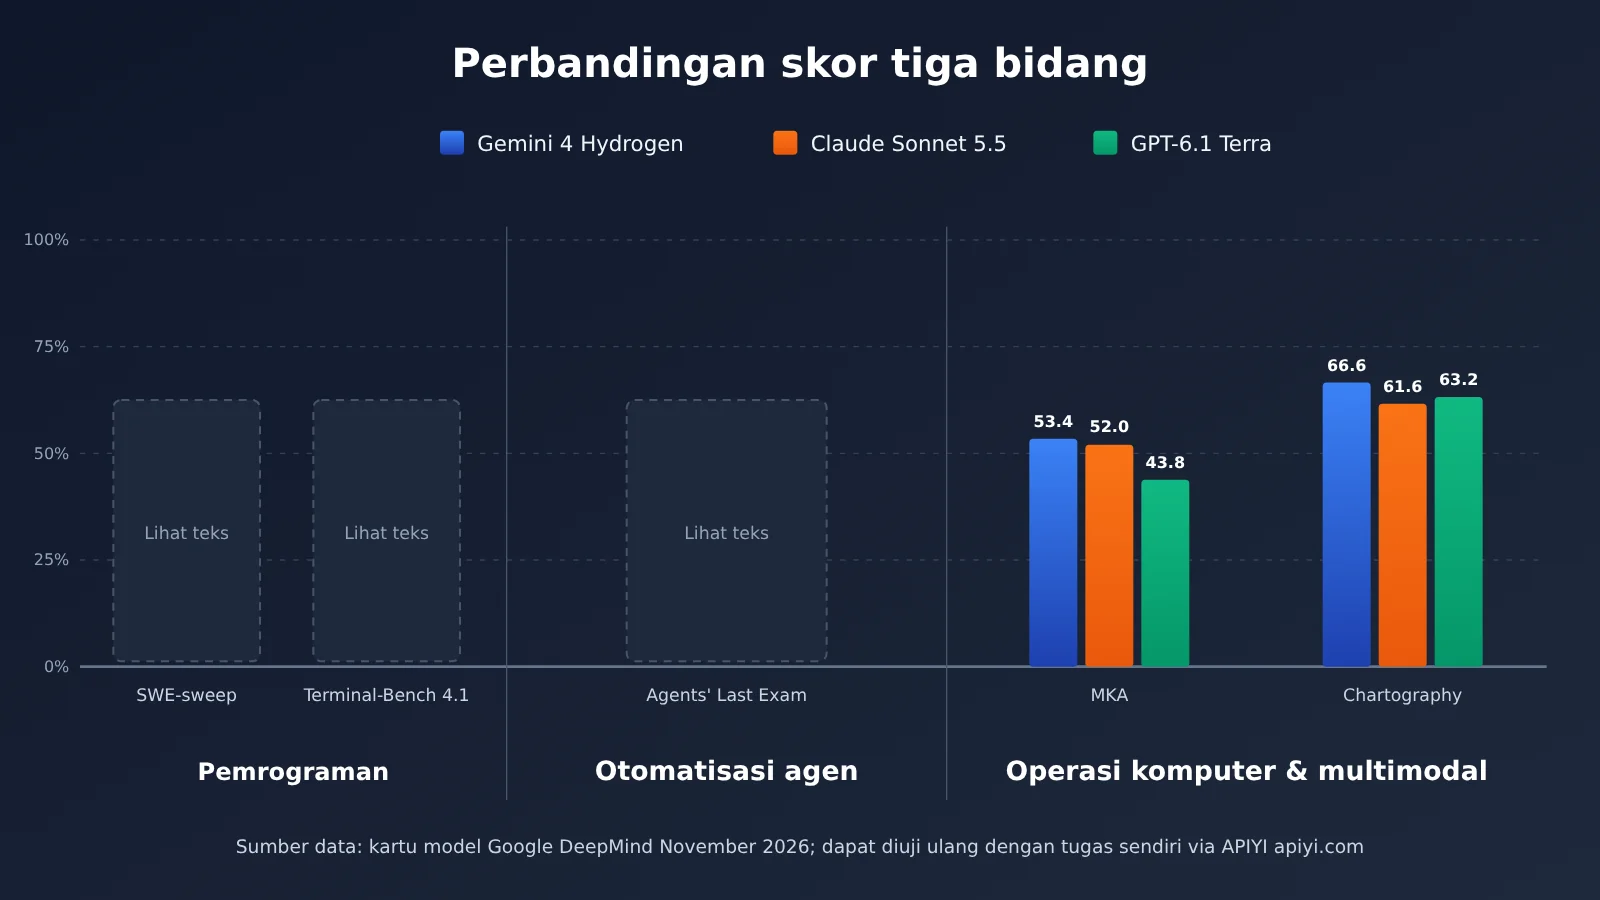
| MKA | Pekerjaan pengetahuan multimodal | Skor tugas | 53.4% | 52.0% | 43.8% |
| Chartography | Pemahaman grafik (tanpa alat) | Akurasi | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | Penalaran pengetahuan tingkat tinggi | Akurasi | 58.8% | 53.3% | 47.3% |
Sumber: kartu model Google DeepMind dan 《Gemini 4 Hydrogen Model Evaluation》, November 2026.
Membaca Hasil Agent dan Otomasi
Agents’ Last Exam v1.1 mencakup 122 tugas dengan jendela waktu 5 jam, dan Hydrogen juga dieksekusi menggunakan Antigravity-CLI 1.4.8. Hydrogen memimpin dengan 71.6%, tetapi yang perlu dicatat adalah Terra mengikuti dekat di belakang dengan 69.8%, bahkan hampir 10 poin persentase lebih tinggi daripada Sonnet. Ini menunjukkan bahwa pada tugas multi-langkah profesional, Terra tidak lemah.
Pola AutomationBench-AA sedikit berbeda: Hydrogen 76.1%, Sonnet 71.8%, sementara Terra tertinggal jelas di 60.2%. Jika bisnis Anda banyak melakukan otomasi proses lintas sistem, selisih pada metrik ini layak diperhatikan.
Vending-Bench 2 adalah tugas simulasi bisnis jangka panjang, dan metriknya adalah saldo dana akhir, bukan akurasi. $14,549 milik Hydrogen memimpin cukup jauh, dan bisa dijadikan pengamatan tambahan untuk “stabilitas keputusan dalam siklus panjang”, tetapi karena ini hanya satu lingkungan simulasi, hasilnya tidak cocok digeneralisasi langsung ke semua tugas panjang.
Kesimpulan bidang Agent: dalam pengujian Agent dan otomasi yang dicantumkan Google, Hydrogen memimpin di semua metrik; Terra mendekati Hydrogen pada tugas multi-langkah profesional tetapi tertinggal dalam otomasi alur kerja; Sonnet berada di posisi tengah.
🚀 Mulai cepat: Skor Agent sangat bergantung pada Harness dan definisi alat, sehingga skor publik hanya bisa dijadikan titik awal. Sebaiknya jalankan ketiga model melalui APIYI apiyi.com dengan rantai alat yang sama dan kumpulan tugas nyata yang sama; satu kunci API sudah cukup untuk berganti model, sehingga Anda mudah mendapatkan data perbandingan yang sesuai skenario Anda sendiri.
Gemini 4 Hydrogen vs Sonnet 5.5: Siapa yang Lebih Unggul dalam Operasi Komputer dan Pekerjaan Pengetahuan Multimodal
Pengujian jenis operasi komputer menuntut model untuk “melihat layar, mengklik mouse, mengetik keyboard”, yang secara langsung berkaitan dengan skenario seperti pengoperasian browser dan otomatisasi perangkat lunak perkantoran. Pekerjaan pengetahuan multimodal menguji kemampuan membaca file kompleks dan memahami grafik, yang berkaitan dengan pekerjaan seperti analisis laporan keuangan dan penyusunan laporan riset.
OSWorld-2.1: Sonnet 5.5 Memimpin dalam Operasi Antarmuka Grafis
OSWorld 2.1 dalam evaluasi Google menggunakan 82 tugas offline, resolusi 1080p, maksimal 500 langkah, model mengamati melalui tangkapan layar dan menjalankan operasi melalui PyAutoGUI. Sonnet 5.5 memimpin dengan 83.9%, Hydrogen 77.6%, Terra 74.2%.
Ada satu persoalan metode yang harus disebutkan: skor sebagian tes OSWorld 2.1 untuk Sonnet 5.5 yang diumumkan Anthropic sendiri adalah 80.1%, sedangkan tabel perbandingan Google memakai 83.9%, di mana angka tersebut diuji oleh Google dalam kondisi yang telah ditentukan dan diambil dari hasil tertinggi beberapa kali pengujian. Artinya, tes dengan nama sama bisa menghasilkan skor berbeda di tangan vendor yang berbeda, sehingga saat membandingkan harus dipatok pada satu sumber yang sama.
MKA dan Chartography: Hydrogen Sedikit Unggul
Dalam MKA pekerjaan pengetahuan multimodal, Hydrogen 53.4% dan Sonnet 52.0% sangat berdekatan, Terra 43.8% tertinggal sekitar 10 poin persentase. Chartography menguji pemahaman grafik tanpa menggunakan alat, Hydrogen 66.6% memimpin; yang menarik, Terra menempati posisi kedua dengan 63.2%, lebih tinggi daripada Sonnet 61.6%, hal ini sejalan dengan posisi Terra sebagai “penalaran visual” menurut OpenAI.
Kesimpulan operasi komputer dan multimodal: untuk operasi antarmuka grafis, utamakan Sonnet 5.5; untuk pembacaan file kompleks dan integrasi pengetahuan multimodal, Hydrogen dan Sonnet berdekatan dengan Hydrogen sedikit lebih unggul; untuk pemahaman grafik murni, Hydrogen memimpin, dan Terra juga kompetitif.
Cara Membaca Data Evaluasi Publik Gemini 4 Hydrogen dengan Benar
Hal yang paling mudah disalahpahami saat membaca evaluasi publik adalah menganggap satu tabel sebagai rapor “ruang ujian yang sama, aturan yang sama”. Kenyataannya, dokumen metodologi evaluasi Google menjelaskan beberapa prasyarat penting:
- Tingkat pemikiran (thinking): Hydrogen biasanya diuji dengan pengaturan thinking tertinggi, tetapi sebagian proyek punya ketentuan lain, misalnya Terminal-Bench 4.1 yang menggunakan level High.
- Harness eksekusi: SWE-sweep dan Agents’ Last Exam menggunakan Antigravity-CLI 1.4.8, Terminal-Bench 4.1 menggunakan mini-swe-agent vision Harness, sedangkan OSWorld 2.1 menggunakan tangkapan layar plus PyAutoGUI.
- Jumlah pengujian: Terminal-Bench 4.1 menjalankan setiap tugas 5 kali lalu mengambil rata-rata reward, sementara skor pesaing OSWorld memakai hasil tertinggi dari beberapa kali eksekusi — dua cara statistik ini memang sudah berbeda sejak awal.
- Sumber skor: Hasil pesaing terutama berasal dari laporan publik dan papan peringkat masing-masing vendor, dan tidak semua model dijalankan oleh tim yang sama.
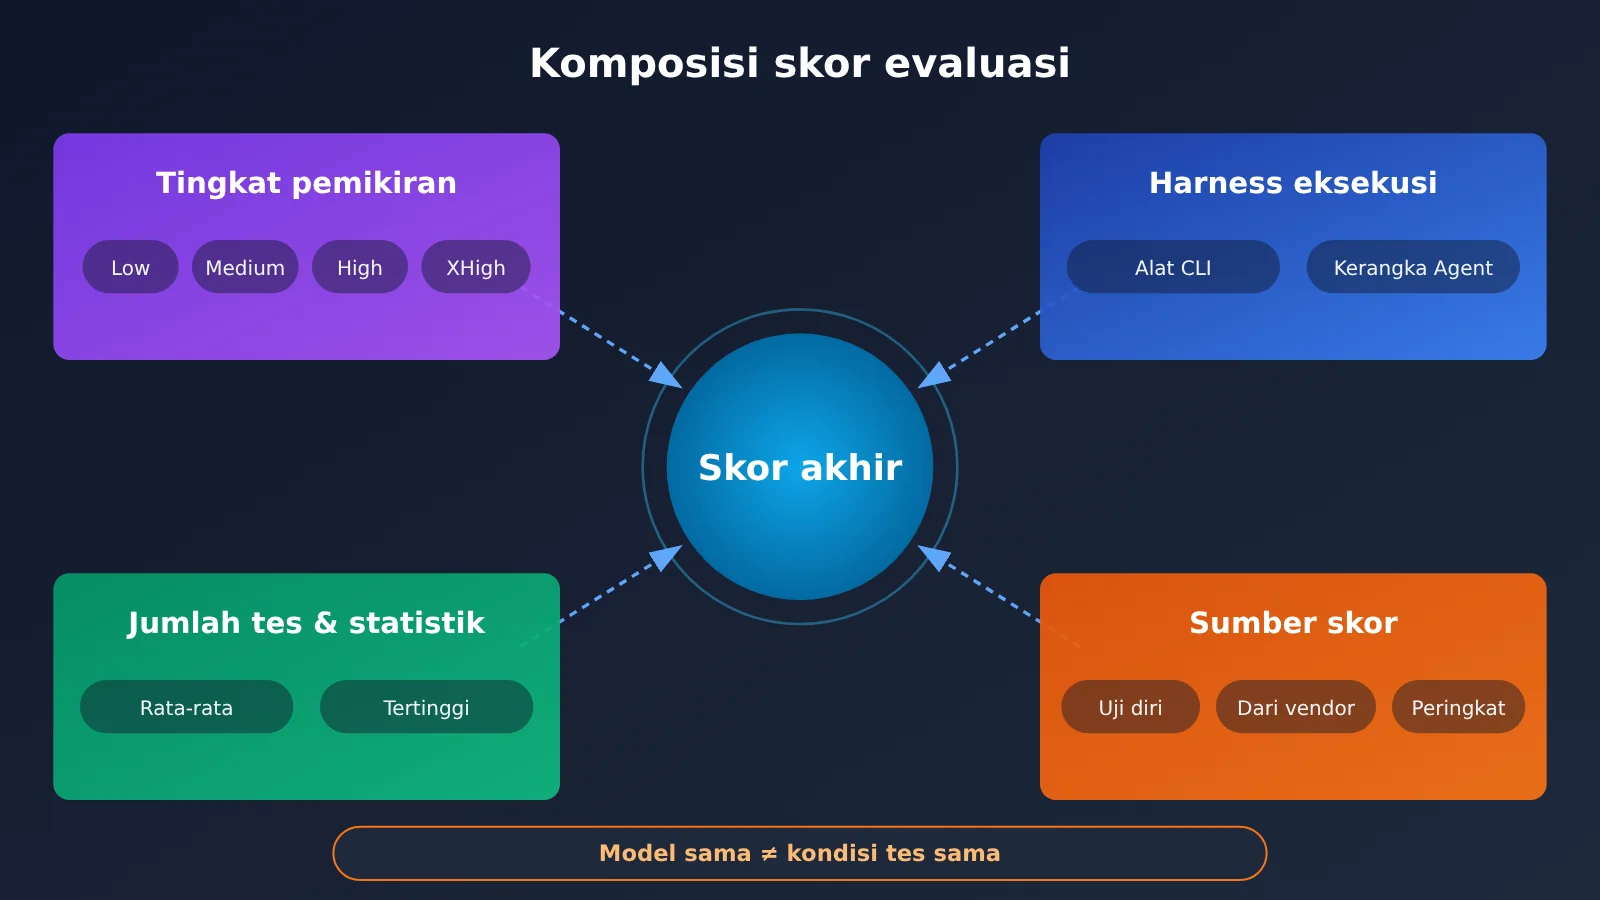
Pengaruh tingkat thinking sangat besar. Artificial Analysis pada 12 November melakukan evaluasi independen terhadap empat tingkat Hydrogen: indeks kecerdasan Low 27, Medium 41, High (default) 51, XHigh 54; biaya rata-rata tugas evaluasi terstandarnya berkisar dari $0.29 hingga $3.16. Ini adalah hasil tugas benchmark mereka, bukan biaya aktual setiap pemanggilan oleh pengguna biasa, tetapi sudah cukup menunjukkan bahwa model yang sama bisa berbeda jauh di tingkat yang berbeda — XHigh hanya unggul 3 poin dibanding High, namun biayanya naik cukup jelas.
Jadi, saat membaca skor di artikel ini, ingat dua hal: pertama, kesimpulan hanya berlaku untuk pengujian publik yang tercantum; kedua, jangan menyambung data paling menguntungkan dari tabel Google, laporan sendiri OpenAI, dan laporan sendiri Anthropic menjadi satu “peringkat keseluruhan”.
Gemini 4 Hydrogen: Mulai Cepat — Bandingkan Tiga Model dengan Satu Kode yang Sama
Cara paling andal untuk memilih model adalah menjalankan ketiga model tersebut dengan tugas Anda sendiri. Contoh di bawah ini menggunakan antarmuka yang kompatibel dengan OpenAI, cukup ubah parameter model untuk beralih.
Contoh Sederhana
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI dari APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Lihat kode implementasi lengkap: skrip perbandingan tiga model pada soal yang sama
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# ID model mengacu pada daftar model platform; gemini-4-hydrogen adalah ID resmi Google
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # ID contoh, harap konfirmasi di konsol
    "claude-sonnet-5.5",   # ID contoh, harap konfirmasi di konsol
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Ada beberapa hal yang perlu diperhatikan saat bermigrasi ke Hydrogen: temperature, top_p, dan top_k kustom akan diabaikan; thinking_budget dan MINIMAL tidak didukung; tingkat berpikir default adalah High; pemanggilan alat multi-putaran perlu mengembalikan thought signature dengan benar. Jika Agent Anda sebelumnya mengandalkan temperature rendah untuk mengendalikan output, Anda perlu beralih ke output terstruktur atau instruksi yang lebih eksplisit untuk membatasinya.
Saran: Gunakan 10-20 tiket atau tugas nyata sebagai set evaluasi terlebih dahulu, lalu panggil ketiga model secara terpisah di APIYI apiyi.com, sekaligus catat tingkat keberhasilan, waktu yang dibutuhkan, dan jumlah Token output. Pengguna baru mendapat kuota uji gratis, sehingga Anda dapat menyelesaikan verifikasi skala kecil sebelum pembelian resmi.
Rekomendasi Skenario dan Matriks Pemilihan Gemini 4 Hydrogen, Terra, dan Sonnet 5.5
Skenario yang Cocok untuk Gemini 4 Hydrogen
- Perbaikan masalah basis kode dan peningkatan dependensi: SWE-sweep unggul paling besar, dan pihak pengembang secara khusus meningkatkan kemampuan pengeditan presisi.
- Agent multi-langkah dan otomatisasi alur kerja: Agents’ Last Exam, AutomationBench-AA, dan Vending-Bench 2 semuanya unggul.
- Analisis dokumen dan grafik yang kompleks: MKA dan Chartography unggul, serta mendukung input berbagai format seperti PDF dan dokumen Office.
Skenario yang Cocok untuk Claude Sonnet 5.5
- Tugas rekayasa yang padat terminal: Terminal-Bench 4.1 dan Terminal-Bench-Science 0.1 keduanya unggul.
- Operasi desktop dan antarmuka grafis: OSWorld-2.1 tertinggi di Google Sheets.
- Dokumen profesional dan desain antarmuka: arah yang secara resmi ditekankan oleh Anthropic.
Skenario yang Cocok untuk GPT-6.1 Terra
- Tugas batch besar yang sensitif terhadap biaya: harga standar $1 / $5, terendah di antara ketiga model dengan harga yang diketahui.
- Penalaran visual dan otomatisasi harian: Chartography berada di peringkat kedua, Agents’ Last Exam mendekati Hydrogen.
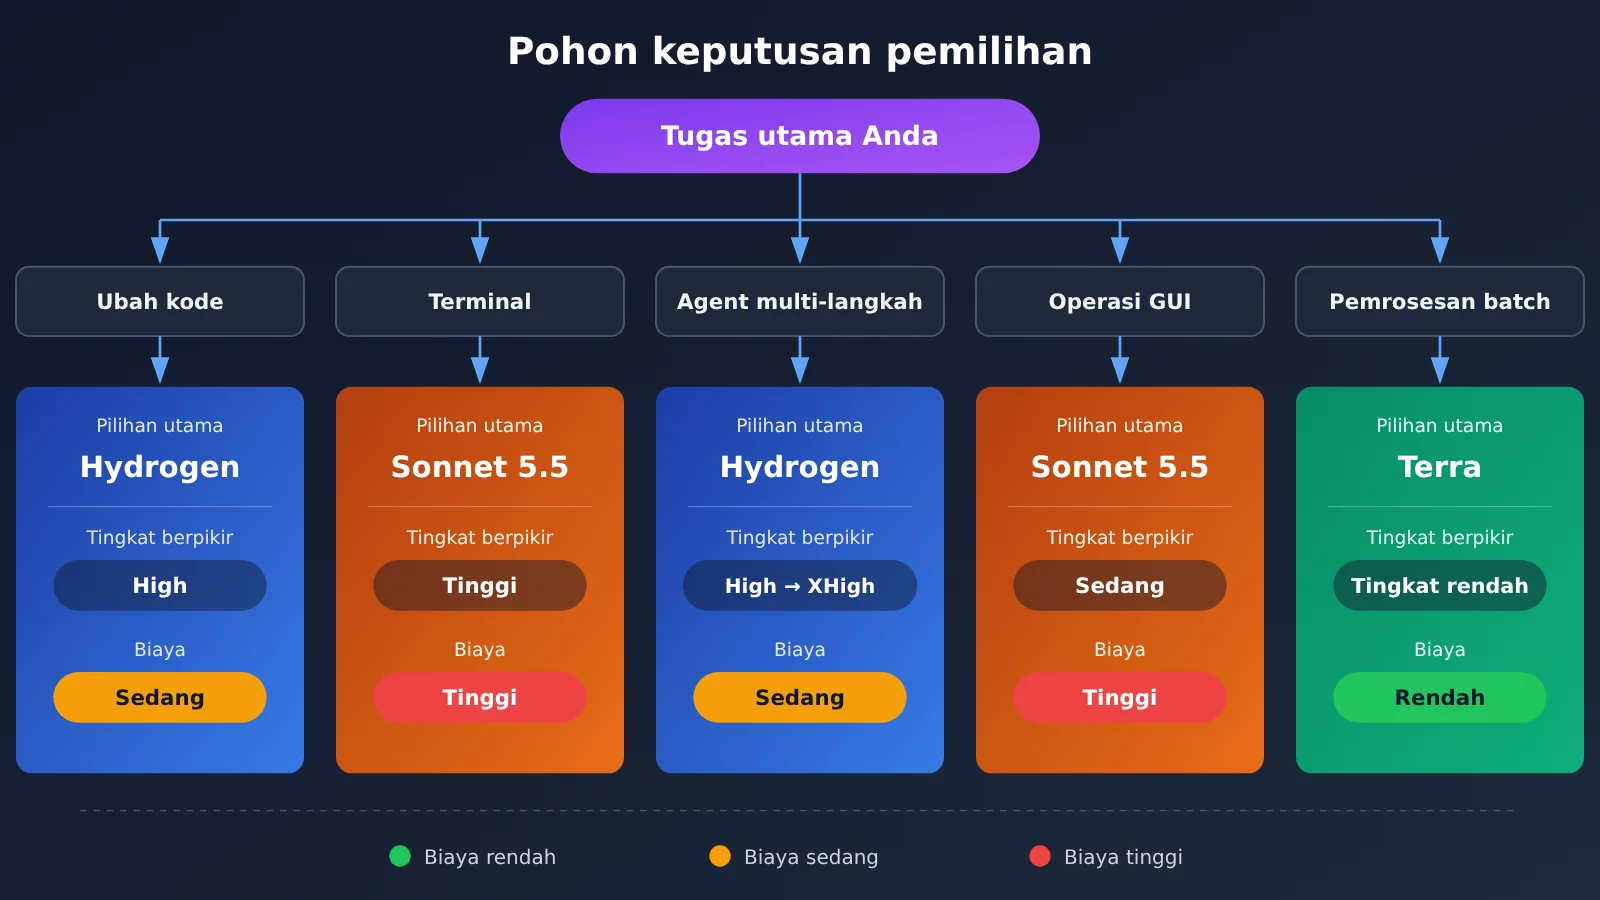
| Jenis Tugas | Pilihan Utama | Alternatif | Sensitivitas Biaya | Saran Metode Eksekusi | Saluran Akses |
|---|---|---|---|---|---|
| Pemeliharaan basis kode, perbaikan Bug | Hydrogen | Sonnet 5.5 | Sedang | Hydrogen mengubah kode, Sonnet melakukan verifikasi terminal | Antarmuka terpadu APIYI apiyi.com |
| Operasional terminal, kode penelitian | Sonnet 5.5 | Terra | Sedang | Sesi panjang satu model | Sama seperti di atas |
| Alur kerja Agent multi-langkah | Hydrogen | Terra | Sedang | Mulai dari tingkat High, jika gagal naikkan ke XHigh | Sama seperti di atas |
| Operasi GUI desktop/browser | Sonnet 5.5 | Hydrogen | Rendah | Observasi tangkapan layar + alat operasi | Sama seperti di atas |
| Membaca grafik dan dokumen | Hydrogen | Terra | Sedang | Tanpa alat atau penguatan retrieval | Sama seperti di atas |
| Otomatisasi harian dalam jumlah besar | Terra | Hydrogen (Batch) | Tinggi | Pemrosesan asinkron batch | Sama seperti di atas |
💡 Saran pemilihan: Jika tim memiliki kebutuhan pemrograman dan otomatisasi GUI sekaligus, tidak perlu hanya bergantung pada satu model. Anda dapat merujuk pada pendekatan Google Antigravity Orchestrator untuk membagi tugas berdasarkan tahap. Dengan APIYI apiyi.com, gunakan kunci yang sama untuk memanggil beberapa model; peralihan rute hanya perlu mengubah satu parameter.
Pertanyaan Umum (FAQ)
Q1: Apa itu Gemini 4 Hydrogen?
Gemini 4 Hydrogen adalah model efisiensi tinggi yang dirilis Google DeepMind pada 12 November 2026. ID model API-nya adalah `gemini-4-hydrogen`, dan model ini diposisikan untuk pemrograman sehari-hari serta eksekusi Agent. Model ini mendukung kuota jendela konteks terpadu sebesar 1,048,576 Token, menyediakan empat tingkat penalaran: Low, Medium, High, dan XHigh, dengan default High.
Q2: Gemini 4 Hydrogen dan Claude Sonnet 5.5, mana yang lebih kuat dalam pemrograman?
Tergantung jenis tugasnya. Hydrogen unggul cukup jauh dalam uji perbaikan basis kode SWE-sweep; Sonnet 5.5 unggul dalam uji eksekusi terminal seperti Terminal-Bench 4.1 dan Terminal-Bench-Science 0.1. Untuk modifikasi kode sehari-hari, cenderung ke Hydrogen; untuk pekerjaan rekayasa yang intensif terminal, cenderung ke Sonnet.
Q3: GPT-6.1 Terra tidak meraih satu pun posisi pertama, masih layak digunakan?
Layak dipertimbangkan. Dalam hasil tiga pihak yang disusun Google dalam satu tabel, Terra memang tidak memiliki skor tertinggi pada satu pun kategori, tetapi di Agents’ Last Exam hampir mendekati Hydrogen, berada di peringkat kedua di Chartography, dan harga API standarnya paling rendah. Untuk skenario yang sensitif biaya dan berfokus pada operasi visual serta otomatisasi rutin, Terra adalah kandidat penting.
Q4: Mengapa skor OSWorld Sonnet 5.5 memiliki dua versi, 80.1% dan 83.9%?
80.1% adalah skor sebagian pengujian yang diumumkan sendiri oleh Anthropic, sedangkan 83.9% adalah hasil pengujian Google dalam kondisi tertentu dengan mengambil hasil tertinggi dari beberapa kali eksekusi. Kondisi pengujian keduanya berbeda; saat membandingkan, gunakan satu sumber secara konsisten dan jangan mencampurnya.
Q5: Bagaimana cara membandingkan ketiga model ini dengan cepat melalui API?
Disarankan menggunakan platform agregasi API yang mendukung banyak model:
1. Kunjungi APIYI di apiyi.com, daftarkan akun, dan dapatkan kunci API;
2. Pastikan ID ketiga model yang tersedia di daftar model pada konsol;
3. Atur base_url pada kode di artikel ini ke `https://api.apiyi.com/v1`, lalu panggil masing-masing model dengan kumpulan tugas yang sama.
APIYI menyediakan antarmuka yang kompatibel dengan OpenAI dan penagihan sesuai pemakaian, sehingga memudahkan perbandingan langsung dalam satu skrip.
Q6: Apa saja keterbatasan Gemini 4 Hydrogen yang diketahui?
Kartu model resmi menyebutkan: model masih mungkin menghasilkan halusinasi; tingkat penalaran tinggi membuat waktu dan biaya meningkat signifikan; pengetahuan berhenti pada Maret 2026; metrik penolakan yang tidak semestinya memburuk 5.57 poin persentase dibandingkan 3.8 Flash; laporan keamanan lengkap belum diterbitkan saat verifikasi. Beberapa pengembang juga melaporkan adanya eksekusi berlebihan pada sebagian tugas Agent. Selain itu, harga standar per Token-nya dua kali lipat harga 3.8 Flash saat ini, sehingga tugas batch dapat mempertimbangkan mode Batch.
Gemini 4 Hydrogen: Poin-Poin Utama Perbandingan (Key Takeaways)
- Tidak ada juara universal di bidang pemrograman: Hydrogen unggul dalam perbaikan basis kode, Sonnet 5.5 unggul dalam tugas eksekusi terminal.
- Hydrogen memimpin dalam otomatisasi Agent: Pada pengujian Agent dan otomatisasi yang dicantumkan Google, Hydrogen selalu berada di posisi tertinggi.
- Untuk operasi GUI, lihat Sonnet 5.5: Pada OSWorld-2.1, Sonnet memimpin dengan 83.9%—perhatikan perbedaan metodologi pengukuran.
- Terra menang pada biaya dan visual: Harga standarnya paling rendah, sementara pemahaman grafik dan tugas Agent profesionalnya tidak lemah.
- Versi dan sumber tidak boleh dicampur: Terminal-Bench 4.0 dan 4.1, serta laporan mandiri vendor dan pengujian internal Google, harus dipisahkan.
- Tingkat thinking berpengaruh besar: Indeks kecerdasan Hydrogen High dan XHigh hanya berbeda 3 poin, tetapi biayanya naik cukup signifikan.
- Patokan utamanya adalah pengujian ulang dengan tugas Anda sendiri: Anda bisa menguji ketiga model secara berdampingan lewat APIYI apiyi.com dengan satu Key.
Ringkasan
Poin-poin utama perbandingan Gemini 4 Hydrogen, GPT-6.1 Terra, dan Claude Sonnet 5.5:
- Bidang pemrograman: Hydrogen memimpin di SWE-sweep, Sonnet 5.5 memimpin di dua pengujian kelas terminal, dan Terra mendekati Sonnet pada tugas kode riset.
- Bidang Agent: Hydrogen memimpin di semua kategori—Agent multi-langkah, otomatisasi alur kerja, dan simulasi manajemen jangka panjang—dengan Terra menyusul ketat pada tugas profesional.
- Operasi komputer dan multimodal: Sonnet 5.5 mendominasi operasi antarmuka grafis, sementara Hydrogen sedikit unggul dalam kerja pengetahuan multimodal dan pemahaman grafik.
Evaluasi publik memberi tahu Anda “siapa yang lebih kuat dalam kondisi tertentu”, bukan “siapa yang lebih cocok untuk bisnis Anda”. Pendekatan yang lebih praktis adalah memilih satu atau dua kandidat berdasarkan matriks pemilihan di atas, lalu melakukan pengujian ulang skala kecil dengan tugas nyata Anda, tingkat thinking yang tetap, dan toolchain yang Anda gunakan.
Sebaiknya verifikasi hasilnya dengan cepat melalui APIYI apiyi.com—platform ini menyediakan kuota uji gratis dan antarmuka terpadu untuk berbagai model, cocok bagi tim yang ingin menyelesaikan evaluasi berdampingan sebelum peluncuran resmi.
📚 Referensi
- Blog Resmi Google – Introducing Gemini 4 Hydrogen: Pengumuman peluncuran dan studi kasus mitra
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Keterangan: Posisi resmi, cakupan kemampuan, dan data pengujian awal
-
Kartu Model Google DeepMind: Tabel perbandingan evaluasi lintas model
- Tautan:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Keterangan: Sumber data kuantitatif utama artikel ini
-
PDF Evaluasi Model Google DeepMind: Penjelasan rinci kondisi eksekusi pengujian
- Tautan:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
Keterangan: Harness, tingkat pemikiran, jumlah run, dan skor tambahan seperti Vending-Bench 2
-
Dokumentasi Teknis Google Cloud: Spesifikasi Hydrogen dan panduan migrasi
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Keterangan: Batas jendela konteks, perilaku parameter, dan catatan kompatibilitas
-
Halaman Harga Google AI Studio: Harga API resmi
- Tautan:
aistudio.google.com/docs/pricing -
Keterangan: Harga untuk mode Standard, Batch, Flex, dan Priority
-
OpenAI – Introducing GPT-6.1 Terra: Materi peluncuran Terra
- Tautan:
openai.com/index/introducing-gpt-6-1-terra/ -
Keterangan: Skor Terminal-Bench 4.0 yang dilaporkan sendiri dan harga API
-
Anthropic – Introducing Claude Sonnet 5.5: Materi peluncuran Sonnet 5.5
- Tautan:
anthropic.com/claude-sonnet-5-5 -
Keterangan: Skor Terminal-Bench 4.0 dan OSWorld 2.1 yang dilaporkan sendiri
-
Artificial Analysis – Gemini 4 Hydrogen: Evaluasi independen empat tingkat pemikiran
- Tautan:
artificialanalysis.ai/models/gemini-4-hydrogen - Keterangan: Indeks, waktu, dan biaya tiap tingkat pada Intelligence Index v5.0.1
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs APIYI; untuk materi integrasi model lainnya, kunjungi pusat dokumentasi docs.apiyi.com