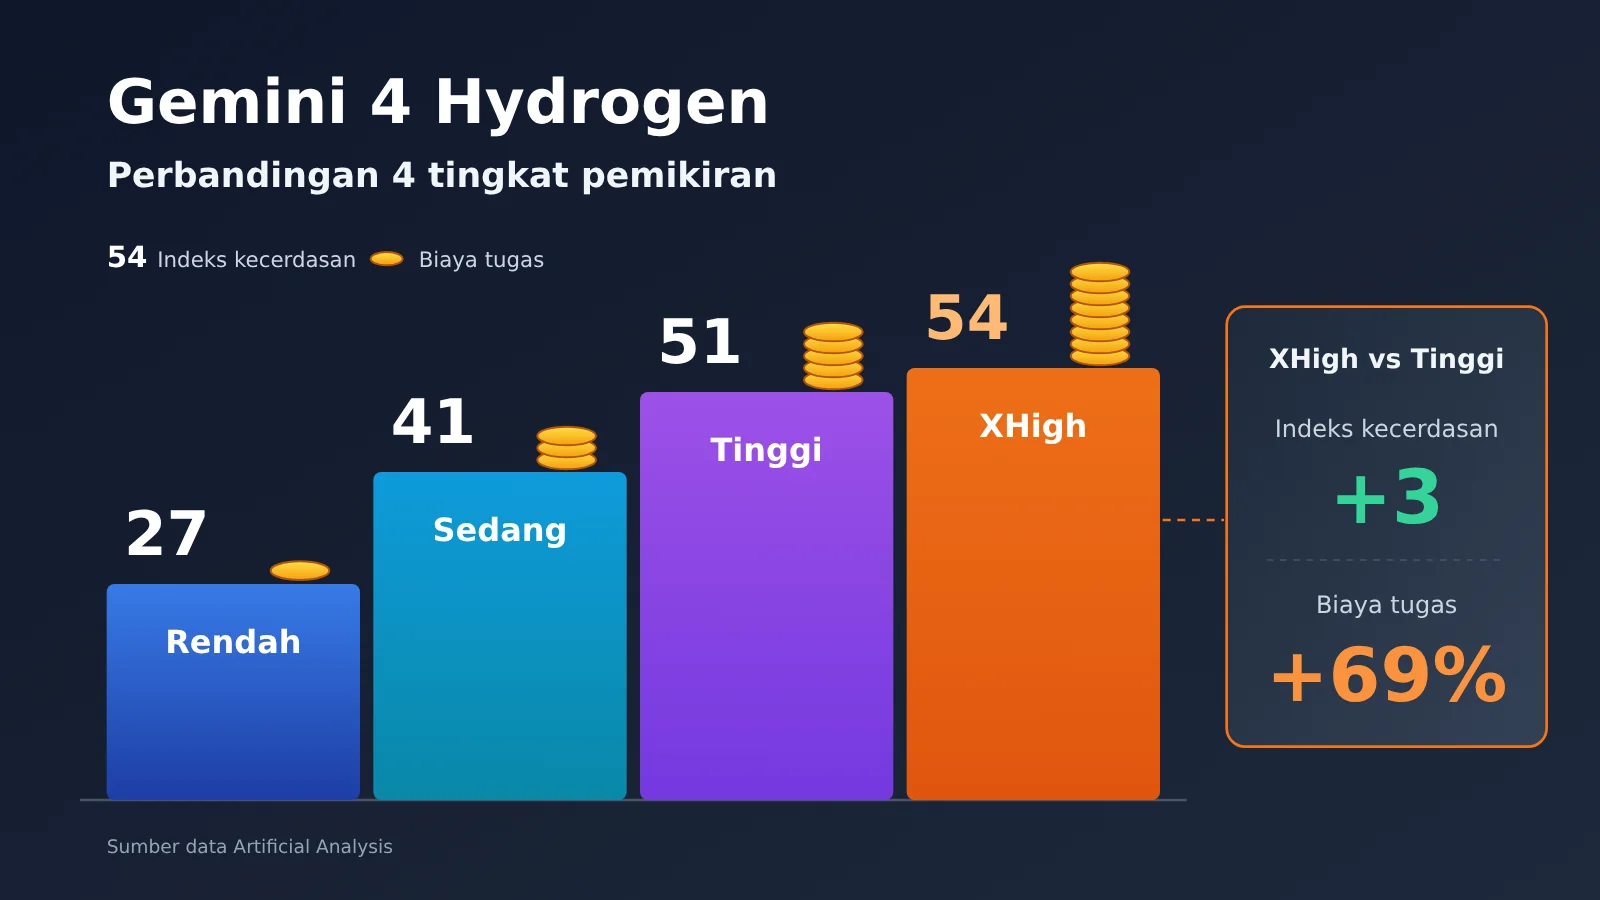
Ringkasan satu kalimat: Evaluasi empat tingkat dari Artificial Analysis menunjukkan bahwa saat Gemini 4 Hydrogen naik dari High ke XHigh, indeks kecerdasannya hanya bertambah 3 poin, tetapi biaya tugas evaluasi meningkat sekitar 69%. Karena itu, model ini lebih cocok digunakan dengan mengonfigurasi tingkat pemikiran sesuai kesulitan tugas.
Google secara resmi merilis Gemini 4 Hydrogen pada 12 November 2026, sekaligus menyediakan empat tingkat pemikiran: Low, Medium, High, dan XHigh. Keempat tingkat menggunakan ID model yang sama dan tarif Token yang sama, tetapi skor, biaya, dan waktu tunggu dalam evaluasi pihak ketiga berbeda jauh.
Ini bukan rekomendasi bahwa “semakin tinggi tingkatnya, semakin baik”. Artikel ini menggunakan data evaluasi terstandardisasi dari Artificial Analysis untuk menghitung manfaat marginal setiap tingkat, lalu memberikan rekomendasi tingkat yang jelas berdasarkan jenis tugas.
Nilai utama: Setelah membaca artikel ini, Anda dapat menentukan tingkat mana yang sebaiknya digunakan bisnis Anda, serta bagaimana menggunakan parameter thinking_level untuk mengendalikan biaya pemikiran.
Istilah yang perlu diketahui sebelum membandingkan empat tingkat pemikiran Gemini 4 Hydrogen
- thinking_level: parameter tingkat pemikiran yang mengontrol kedalaman penalaran model. Hydrogen mendukung empat nilai: Low, Medium, High, XHigh.
- Token pemikiran: Token yang dipakai model untuk bernalar sebelum memberikan jawaban akhir. Menurut penjelasan di halaman harga resmi Google, bagian ini ikut dihitung dalam harga output.
- Token: satuan ukur saat model memproses teks, gambar, dan informasi lain. API menagih berdasarkan juta Token.
- Harness: kerangka pengujian yang menyusun input model, menjalankan pemanggilan tool, dan memberi skor pada tugas. Skor yang dihasilkan harness berbeda tidak bisa dibandingkan secara langsung.
- API: antarmuka yang dipanggil program untuk mengakses layanan. Contoh kode di artikel ini memakai format yang kompatibel dengan OpenAI.
Gemini 4 Hydrogen yang sama, kenapa performa empat tingkatnya bisa berbeda jauh?
Gemini 4 Hydrogen adalah model efisiensi tinggi rilisan Google DeepMind, terutama dipakai untuk pemrograman sehari-hari dan eksekusi tugas AI Agent, dengan ID model API gemini-4-hydrogen. Empat tingkat pemikiran bukan empat model berbeda, melainkan empat kedalaman penalaran dari model yang sama. Dokumentasi Google Cloud mencantumkan rekomendasi penggunaan untuk tiap tingkat:
| Tingkat pemikiran | Penggunaan yang direkomendasikan resmi | Kedalaman penalaran | Default |
|---|---|---|---|
| Low | Tugas sederhana seperti klasifikasi | Dangkal | Tidak |
| Medium | Pemrograman umum | Sedang | Tidak (tingkat default 3.8 Flash) |
| High | Agent multi-langkah | Dalam | ✅ Default Hydrogen |
| XHigh | Penalaran mendalam yang kompleks | Paling dalam | Tidak |
Harga satuan keempat tingkat pemikiran Hydrogen sama, tapi kenapa tagihannya beda
Per 13 November 2026, harga panggilan Standard resmi Google adalah input $1.50 / juta Token dan output $7.50 / juta Token, tanpa perbedaan antartingkat. Yang membedakan adalah pemakaian Token: semakin tinggi tingkatnya, semakin banyak Token pemikiran yang dihasilkan model sebelum menjawab, dan Token itu ditagih dengan harga output.
Jadi “harga satuan sama” bukan berarti “biaya tiap tugas sama”. Pertanyaan yang sama di XHigh bisa menghasilkan konten pemikiran berkali-kali lipat dibanding High, dan tagihannya ikut naik. Saat memperkirakan biaya, jangan cuma melihat panjang jawaban akhir, tapi hitung juga bagian pemikiran yang tidak terlihat.
Data pengujian empat tingkat Gemini 4 Hydrogen: perbandingan skor, biaya, dan kecepatan
Data berikut berasal dari lembaga pihak ketiga Artificial Analysis, dan pengujian diselesaikan pada hari peluncuran. Indeks Kecerdasan, biaya tugas evaluasi, dan durasi rata-rata berasal dari Intelligence Index v5.0.1 milik mereka; latensi token jawaban pertama dan total token keluaran diambil dari snapshot halaman pada 13 November 2026. Semua hasil di bawah ini adalah hasil evaluasi terstandar pihak ketiga, bukan pengujian langsung situs ini.
| Tingkat penalaran | Indeks Kecerdasan | Biaya rata-rata per tugas | Durasi rata-rata per tugas | Latensi token jawaban pertama | Total token keluaran seluruh evaluasi |
|---|---|---|---|---|---|
| Low | 27 | $0,29 | 1,3 menit | sekitar 5,7 detik | 20,3 juta |
| Medium | 41 | $0,80 | 3,7 menit | sekitar 11,8 detik | 54,4 juta |
| High (default) | 51 | $1,87 | 8,3 menit | sekitar 18,9 detik | 110 juta |
| XHigh | 54 | $3,16 | 13,5 menit | sekitar 37,8 detik | 304 juta |
Jangan mencampuradukkan tiga metrik waktu
Tabel ini memuat tiga jenis metrik dengan makna yang berbeda:
- Indeks Kecerdasan: skor kemampuan yang menggabungkan beberapa benchmark, hanya menunjukkan tingkat relatif dalam rangkaian evaluasi ini.
- Durasi rata-rata per tugas: metrik berbobot yang dihitung dari jumlah token keluaran tugas dan kecepatan keluaran end-to-end, mewakili beban kerja evaluasi terstandar. Pengguna yang mengajukan pertanyaan sederhana tidak harus menunggu 8,3 menit.
- Latensi token jawaban pertama: waktu tunggu dari pengiriman permintaan hingga melihat token jawaban pertama, termasuk fase berpikir model penalaran; ini adalah metrik yang paling terasa bagi pengguna dalam skenario percakapan.
Dari tabel terlihat bahwa selisih skor dari Medium ke High (10 poin) jauh lebih besar daripada High ke XHigh. Dengan nama model yang sama, perbedaan kemampuan aktual antar tingkat bisa lebih dari 20 poin; saat membandingkan Hydrogen dengan model lain, Anda harus lebih dulu memastikan tingkat mana yang digunakan model pembanding.
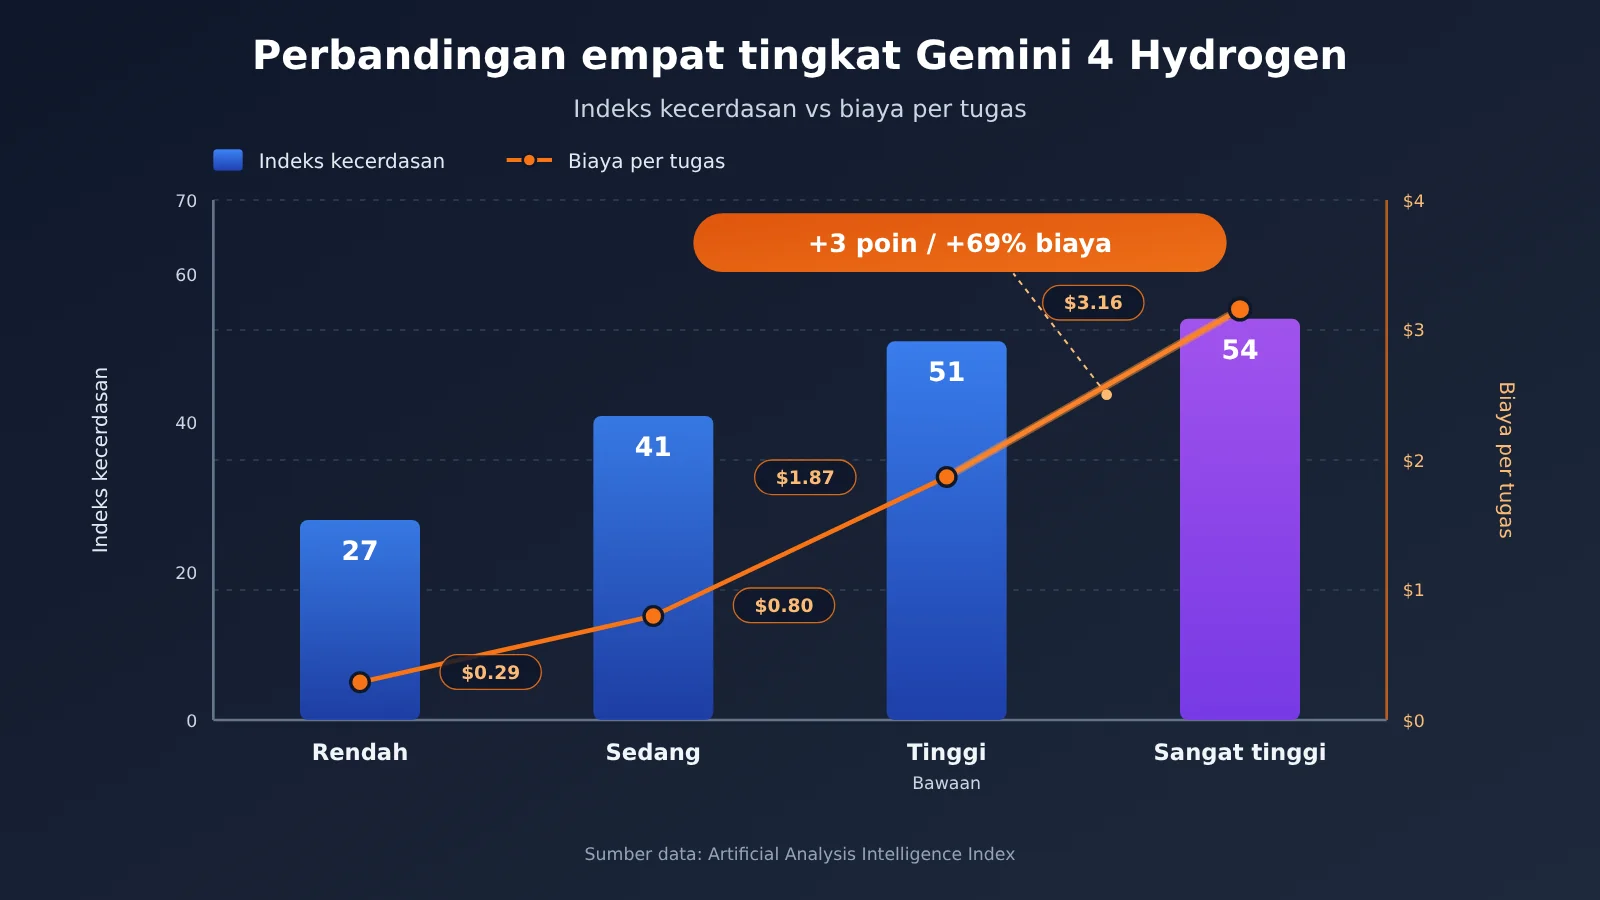
Gemini 4 Hydrogen XHigh menghabiskan 69% lebih banyak daripada High, apa sebenarnya yang didapat?
Dengan membandingkan keempat tingkat data secara berpasangan, kita bisa melihat keuntungan dan biaya dari setiap kenaikan tingkat. Rasio kenaikan pada tabel berikut dihitung oleh editor berdasarkan data yang dipublikasikan Artificial Analysis.
| Jalur peningkatan | Perubahan indeks kecerdasan | Perubahan biaya tugas | Perubahan waktu rata-rata | Biaya tambahan per 1 poin |
|---|---|---|---|---|
| Low → Medium | +14 poin | +176% | +185% | sekitar $0.036 |
| Medium → High | +10 poin | +134% | +124% | sekitar $0.107 |
| High → XHigh | +3 poin | +69% | +63% | sekitar $0.43 |
Hasil yang menurun: biaya marginal empat tingkat pemikiran Hydrogen
Dari High naik ke XHigh, indeks kecerdasan naik dari 51 ke 54, sekitar 5,9%; biaya per tugas naik dari $1.87 ke $3.16, waktu dari 8,3 menit menjadi 13,5 menit, dan latensi jawaban pertama berlipat dari sekitar 18,9 detik menjadi sekitar 37,8 detik. Jika dihitung “per tambahan 1 poin”, biaya marginal XHigh sekitar 12 kali biaya Low → Medium.
Penyebab utamanya adalah penggunaan token. Untuk seluruh evaluasi, High mengeluarkan sekitar 110 juta token, sedangkan XHigh sekitar 304 juta token, atau sekitar 2,76 kali lipat. Namun tagihan tidak naik 2,76 kali, karena total biaya juga mencakup token input, kondisi cache hit, dan cara pembobotan tugas evaluasi; Anda tidak bisa langsung memperkirakan biaya dari kelipatan token output.
Skor rata-rata rendah bukan berarti manfaat pada tugas kompleks juga rendah
Indeks kecerdasan adalah hasil rata-rata dari banyak tugas. Selisih 3 poin bisa berasal dari dua situasi: sebagian besar tugas menunjukkan performa yang sama di kedua tingkat, sementara pada sedikit tugas yang sangat sulit, XHigh jelas lebih baik. Untuk tugas seperti penalaran ilmiah, pembuktian matematika, dan refaktorisasi besar lintas file yang “salah satu langkah maka semuanya salah”, pemikiran ekstra dari XHigh bisa menentukan apakah tugas berhasil atau tidak.
Jadi, pernyataan yang lebih tepat adalah: XHigh sangat tidak efisien untuk tugas biasa, tetapi bisa jadi penting untuk sedikit tugas yang sangat sulit. Apakah layak mengeluarkan 69% lebih banyak harus diverifikasi dengan sampel tugas Anda sendiri, bukan hanya melihat skor rata-rata.
🎯 Saran teknis: Sebaiknya pilih dulu 20~50 sampel tugas nyata, lalu jalankan masing-masing dengan High dan XHigh, dan bandingkan tingkat keberhasilan serta biaya per tugas. Melalui APIYI apiyi.com dengan kunci API yang sama, Anda cukup mengganti parameter untuk melakukan pengujian A/B, tanpa perlu mengubah struktur kode bisnis.
Untuk tugas apa saja keempat tingkat pemikiran Gemini 4 Hydrogen cocok digunakan?
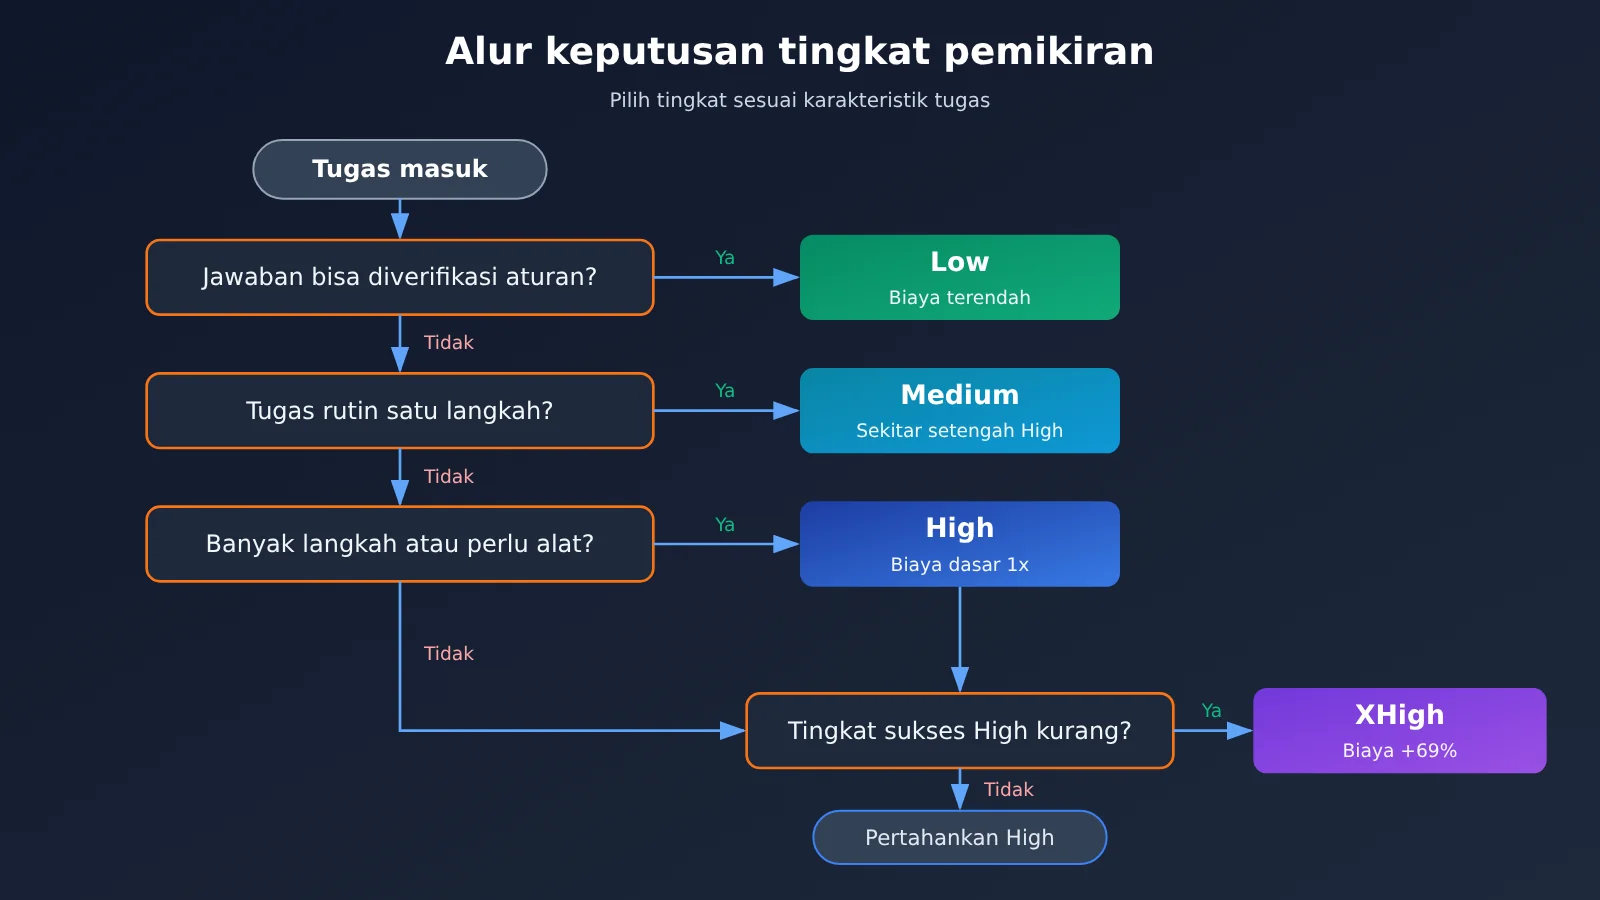
Dengan menggabungkan rekomendasi resmi Google dan data biaya di atas, berikut saran berdasarkan tingkat kesulitan tugas:
| Jenis Tugas | Tingkat yang Disarankan | Contoh Umum | Alasan Pemilihan |
|---|---|---|---|
| Klasifikasi, ekstraksi, perapian format | Low | Klasifikasi tiket, ekstraksi field, format JSON, tanya jawab sederhana | Biaya paling rendah, latensi token pertama sekitar 5,7 detik, cocok untuk konkurensi tinggi |
| Pemrosesan kode dan konten rutin | Medium | Menulis fungsi satu berkas, menulis ulang teks, ringkasan dokumen, otomatisasi bisnis umum | 14 poin lebih tinggi dari Low, biaya masih kurang dari separuh High |
| Agent multi-langkah dan pemanggilan tool | High | Memperbaiki bug lintas berkas, pemanggilan tool berurutan, analisis komprehensif setelah retrieval | Tingkat default resmi, kemampuan dan biaya cukup seimbang |
| Penalaran sangat kompleks | XHigh | Penalaran ilmiah, pembuktian matematis, refaktorisasi rekayasa perangkat lunak berskala besar | Hanya dipakai ketika tingkat keberhasilan High jelas tidak memadai |
Skenario yang cocok untuk tingkat rendah Hydrogen
Low dan Medium cocok untuk skenario yang tujuan tugasnya jelas dan jawabannya mudah diverifikasi. Misalnya mengekstrak nominal dan tanggal dari kontrak, atau mengelompokkan umpan balik pengguna ke dalam sepuluh kategori. Untuk tugas seperti ini, berpikir lebih lama pun sulit meningkatkan akurasi, dan hanya menambah latensi serta biaya. Untuk skenario yang sensitif terhadap latensi token pertama seperti chat real-time dan penyelesaian pencarian, Low dengan sekitar 5,7 detik juga jelas lebih unggul dibanding XHigh yang sekitar 37,8 detik.
Skenario yang cocok untuk tingkat tinggi Hydrogen
High adalah tingkat default yang ditetapkan Google dan cocok untuk sebagian besar alur kerja Agent. Hanya ketika tugas menunjukkan kondisi “High gagal berulang kali dan biaya percobaan ulang sudah melebihi biaya menaikkan tingkat”, barulah perlu naik ke XHigh. Perlu diperhatikan, kartu model resmi Google juga menyebutkan bahwa tingkat pemikiran tinggi dapat meningkatkan waktu proses dan biaya secara signifikan, kadang terjadi latensi atau timeout, sehingga untuk tugas dengan rantai panjang perlu mengatur strategi timeout dan percobaan ulang dengan baik.
Cara Pengembang Mengontrol Biaya Berpikir Gemini 4 Hydrogen
Parameter thinking_level dan Nilai Default
Hydrogen memilih tingkat pemikiran melalui parameter thinking_level, jika tidak diisi maka default-nya adalah High. Ada beberapa hal yang perlu diperhatikan saat migrasi dari Gemini 3.8 Flash:
- Default 3.8 Flash adalah Medium; setelah migrasi, jika parameter tidak diisi, nilainya akan otomatis berubah menjadi High dan tagihan berpotensi naik.
thinking_budgetdanMINIMALsudah tidak didukung lagi; jika dipakai akan mengembalikan HTTP 400.- Nilai kustom untuk temperature, top_p, dan top_k akan diabaikan.
- Pemanggilan alat dalam beberapa putaran mengharuskan thought signatures disimpan dan dikirim balik dengan benar.
Contoh Minimal: Memanggil Hydrogen Berdasarkan Tingkat
Berikut cara memanggilnya dengan format kompatibel OpenAI, meneruskan tingkatan thinking melalui extra_body. Field parameter yang diteruskan oleh platform berbeda mungkin berbeda-beda, nama field spesifiknya mengacu pada dokumentasi platform masing-masing.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Klasifikasikan umpan balik ini: pengembalian dana terlalu lambat"}],
    extra_body={"thinking_level": "low"}  # Klasifikasi sederhana gunakan Low
)
print(resp.choices[0].message.content)
Lihat kode implementasi lengkap: klasifikasi berdasarkan tingkat kesulitan tugas dan naikkan tingkat secara otomatis
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Pemetaan jenis tugas dan tingkat default
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """Gunakan tingkat rendah terlebih dahulu, jika validasi gagal naikkan tingkat secara bertahap, max_level membatasi tingkat tertinggi"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # Catat Token, untuk menghitung biaya tugas yang berhasil
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="Ekstrak nomor pesanan, hanya kembalikan angka: pesanan A-20261113-889 sudah dikirim",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 Mulai cepat: APIYI apiyi.com menyediakan antarmuka kompatibel OpenAI, satu kunci API saja sudah bisa memanggil model-model mainstream seperti Gemini, Claude, OpenAI. Pengguna baru mendapatkan kuota uji gratis, cocok untuk menjalankan strategi bertingkat di atas terlebih dahulu sebelum diluncurkan.
Strategi Bertingkat: Mulai dari Tingkat Rendah, Naikkan Jika Gagal
Pendekatan yang direkomendasikan adalah “default ke tingkat rendah, naikkan sesuai kebutuhan”: tugas sederhana selalu pakai Low atau Medium; tugas kompleks mulai dari High, dan hanya naik ke XHigh ketika validasi gagal; serta tetapkan batas tingkat maksimum untuk setiap jenis tugas agar lonjakan biaya tak terduga bisa dihindari. Ini sejalan dengan pendekatan Google di Antigravity Orchestrator yang membagi tugas ke model-model berbeda, hanya saja di sini yang disesuaikan adalah kedalaman berpikir dari model yang sama.
Mengukur Efektivitas Optimasi Tingkat Hydrogen dengan Empat Metrik
| Metrik Optimasi | Cara Perhitungan | Alasan Diperhatikan |
|---|---|---|
| Akurasi / Tingkat Keberhasilan | Jumlah tugas yang lolos validasi ÷ total tugas | Kualitas tidak boleh turun signifikan setelah tingkat diturunkan |
| Waktu end-to-end | Total durasi dari permintaan hingga mendapatkan hasil yang bisa dipakai, termasuk retry | Latensi token pertama hanyalah sebagian dari keseluruhan |
| Penggunaan Token | Token input + output (termasuk thinking) | Token thinking ditagih dengan harga output |
| Biaya tugas berhasil | Total pengeluaran ÷ jumlah tugas berhasil | Tingkat rendah yang sering gagal dan retry bisa jadi lebih mahal daripada tingkat tinggi |
“Biaya tugas berhasil” paling mencerminkan pengeluaran sebenarnya. Jika Medium membuat 30% tugas perlu dijalankan ulang, sementara High berhasil dalam sekali jalan, maka biaya tugas berhasil dengan High justru bisa lebih rendah.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apakah empat tingkat pemikiran Gemini 4 Hydrogen berarti empat model berbeda?
Bukan. Keempat tingkat tersebut adalah kedalaman penalaran yang berbeda dari model yang sama, yaitu `gemini-4-hydrogen`, yang diubah melalui parameter thinking_level. Harga per Token sama, yang membedakan hanyalah jumlah Token pemikiran yang dihasilkan.
Q2: XHigh hanya 3 poin lebih tinggi dari High, apakah benar-benar tidak perlu digunakan?
Tidak bisa dipahami seperti itu. Selisih 3 poin adalah perbedaan rata-rata dari berbagai tugas. Dalam penalaran ilmiah, pembuktian matematika, dan tugas rekayasa berskala besar, XHigh bisa menentukan apakah suatu tugas dapat diselesaikan atau tidak. Untuk tugas biasa, rasio harga-kinerja XHigh memang lebih rendah, tetapi untuk sebagian kecil tugas yang sangat sulit, XHigh bisa jadi diperlukan.
Q3: Rata-rata waktu High adalah 8,3 menit, apakah berarti setiap kali bertanya harus menunggu selama itu?
Tidak. 8,3 menit adalah waktu rata-rata tertimbang dari tugas evaluasi standar Artificial Analysis. Untuk percakapan biasa, sebaiknya merujuk pada latensi Token jawaban pertama, yaitu sekitar 18,9 detik untuk High dan sekitar 5,7 detik untuk Low. Durasi aktual juga bergantung pada panjang tugas.
Q4: Apa yang terjadi jika tidak mengirimkan thinking_level?
Secara default akan menggunakan High. Proyek yang dimigrasi dari Gemini 3.8 Flash (default Medium), jika tetap menggunakan kode lama tanpa mengirim parameter, tingkat pemikirannya akan otomatis naik, dan biaya juga bisa ikut meningkat. Sebaiknya atur tingkat secara eksplisit.
Q5: Bagaimana cara cepat membandingkan efek berbagai tingkat pada bisnis sendiri?
Disarankan menyiapkan sekumpulan sampel tugas nyata, jalankan dengan tingkat yang berbeda-beda, lalu hitung tingkat keberhasilan dan penggunaan Token:
1. Daftar di APIYI apiyi.com dan dapatkan API Key serta kuota uji gratis
2. Gunakan kode dalam artikel ini, ubah nilai `thinking_level`
3. Pilih tingkat yang paling sesuai berdasarkan “biaya tugas yang berhasil”
Q6: Apa saja masalah yang diketahui pada tingkat pemikiran tinggi Hydrogen?
Kartu model Google menyebutkan bahwa tingkat pemikiran tinggi dapat secara signifikan meningkatkan waktu dan biaya, serta kadang-kadang terjadi penundaan atau timeout. Selain itu, ada pengguna di Hacker News yang melaporkan bahwa pada sebagian tugas Agent terjadi eksekusi berlebihan. Disarankan untuk mengatur timeout, tingkat maksimum, dan kondisi berhenti untuk tugas-tugas panjang.
Q7: Saat memperkirakan biaya berdasarkan Token, kesalahpahaman yang paling umum apa?
Hanya memperkirakan berdasarkan jumlah kata dari jawaban akhir. Token pemikiran dihitung dalam harga output, sehingga Token output untuk seluruh evaluasi XHigh sekitar 2,76 kali lipat dari High. Melihat detail penggunaan aktual di konsol APIYI apiyi.com lebih andal daripada estimasi manual.
Gemini 4 Hydrogen: Poin Penting Empat Tingkat Pemikiran
- Model sama, tingkat berbeda: Harga satuan keempat tingkat sama; biaya tugas sebenarnya ditentukan oleh jumlah Token pemikiran yang terpakai.
- Hasil menurun jelas: High → XHigh menambah 3 poin, biaya tugas evaluasi meningkat sekitar 69%.
- Latensi berlipat ganda: Latensi jawaban pertama XHigh sekitar 37,8 detik, dua kali lipat High.
- Default adalah High: Saat migrasi dari 3.8 Flash, tingkat perlu diatur secara eksplisit.
- Pilih tingkat sesuai kesulitan: Klasifikasi pakai Low, rutin pakai Medium, Agent pakai High, tugas sulit baru pakai XHigh.
- Lihat biaya tugas yang berhasil: Hitung juga percobaan ulang, baru bisa membandingkan biaya nyata tiap tingkat.
- Verifikasi dengan sampel: Bisa membandingkan efek empat tingkat lewat satu Key di APIYI apiyi.com.
Ringkasan
Kesimpulan inti dari perbandingan empat tingkat pemikiran Gemini 4 Hydrogen:
- Kesenjangan kemampuan besar: Low 27 poin hingga XHigh 54 poin, di bawah nama model yang sama kemampuannya berbeda dua kali lipat.
- Biaya marginal meningkat: Biaya tambahan per 1 poin naik dari sekitar $0,036 pada Low → Medium menjadi sekitar $0,43 pada High → XHigh.
- XHigh gunakan sesuai kebutuhan: Selisih skor rata-rata kecil, tetapi untuk sebagian kecil tugas berkesulitan tinggi tetap bisa menjadi kunci.
Saran untuk bisnis sehari-hari: atur thinking_level secara eksplisit, gunakan tingkat rendah untuk tugas sederhana, naikkan tingkat untuk langkah kompleks, dan jadikan biaya tugas yang berhasil sebagai tolok ukur akhir.
Disarankan memverifikasi efek tiap tingkat dengan sampel tugas nyata lewat APIYI apiyi.com; platform menyediakan antarmuka kompatibel OpenAI dan kuota uji gratis.
📚 Referensi
- Artificial Analysis – Halaman Evaluasi Empat Tingkat Gemini 4 Hydrogen: Indeks kecerdasan, biaya tugas, durasi, dan data latensi
- Tautan:
artificialanalysis.ai/models/gemini-4-hydrogen-low - Tautan:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - Tautan:
artificialanalysis.ai/models/gemini-4-hydrogen-high - Tautan:
artificialanalysis.ai/models/gemini-4-hydrogen -
Keterangan: Sumber semua data perbandingan empat tingkat dalam artikel ini; latensi adalah metrik dinamis
-
Blog Resmi Google – Introducing Gemini 4 Hydrogen: Pengumuman rilis
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Keterangan: Posisi model, cakupan kemampuan, dan studi kasus mitra
-
Panduan Pengembang Google Cloud – Gemini 4 Hydrogen: thinking_level dan catatan migrasi
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Keterangan: Rekomendasi penggunaan empat tingkat, tingkat default, parameter yang tidak kompatibel
-
Halaman Harga Google AI Studio: Harga API resmi Hydrogen
- Tautan:
aistudio.google.com/docs/pricing -
Keterangan: Harga untuk mode Standard, Batch, Flex, dan Priority, serta aturan penagihan Token pemikiran
-
Kartu Model Google DeepMind: Keterbatasan dan evaluasi keamanan
- Tautan:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Keterangan: Risiko durasi pada tingkat pemikiran tinggi, penolakan menjawab, halusinasi, dan masalah umum lainnya
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs resmi APIYI untuk mendapatkan lebih banyak materi integrasi model seri Gemini