Catatan penulis: Setelah ponsel dan browser bisa mensintesis suara secara lokal, apakah API suara di cloud masih perlu dipertahankan? Artikel ini memberi penilaian dari 4 sisi: offline, privasi, kualitas suara dan audio panjang, serta model yang bisa ditentukan dan tagihan terpadu.
Makin banyak sistem ponsel dan browser yang bisa langsung membacakan teks secara lokal. Kalau suara di sisi perangkat sudah tersedia, apakah API suara di cloud masih perlu dipertahankan? Pertanyaan ini sekarang sulit dihindari oleh tim yang membangun produk suara. Ada yang berpendapat semuanya sebaiknya dipindah ke lokal supaya biaya pemanggilan hilang, ada juga yang khawatir kualitas suara lokal belum cukup untuk produk resmi.
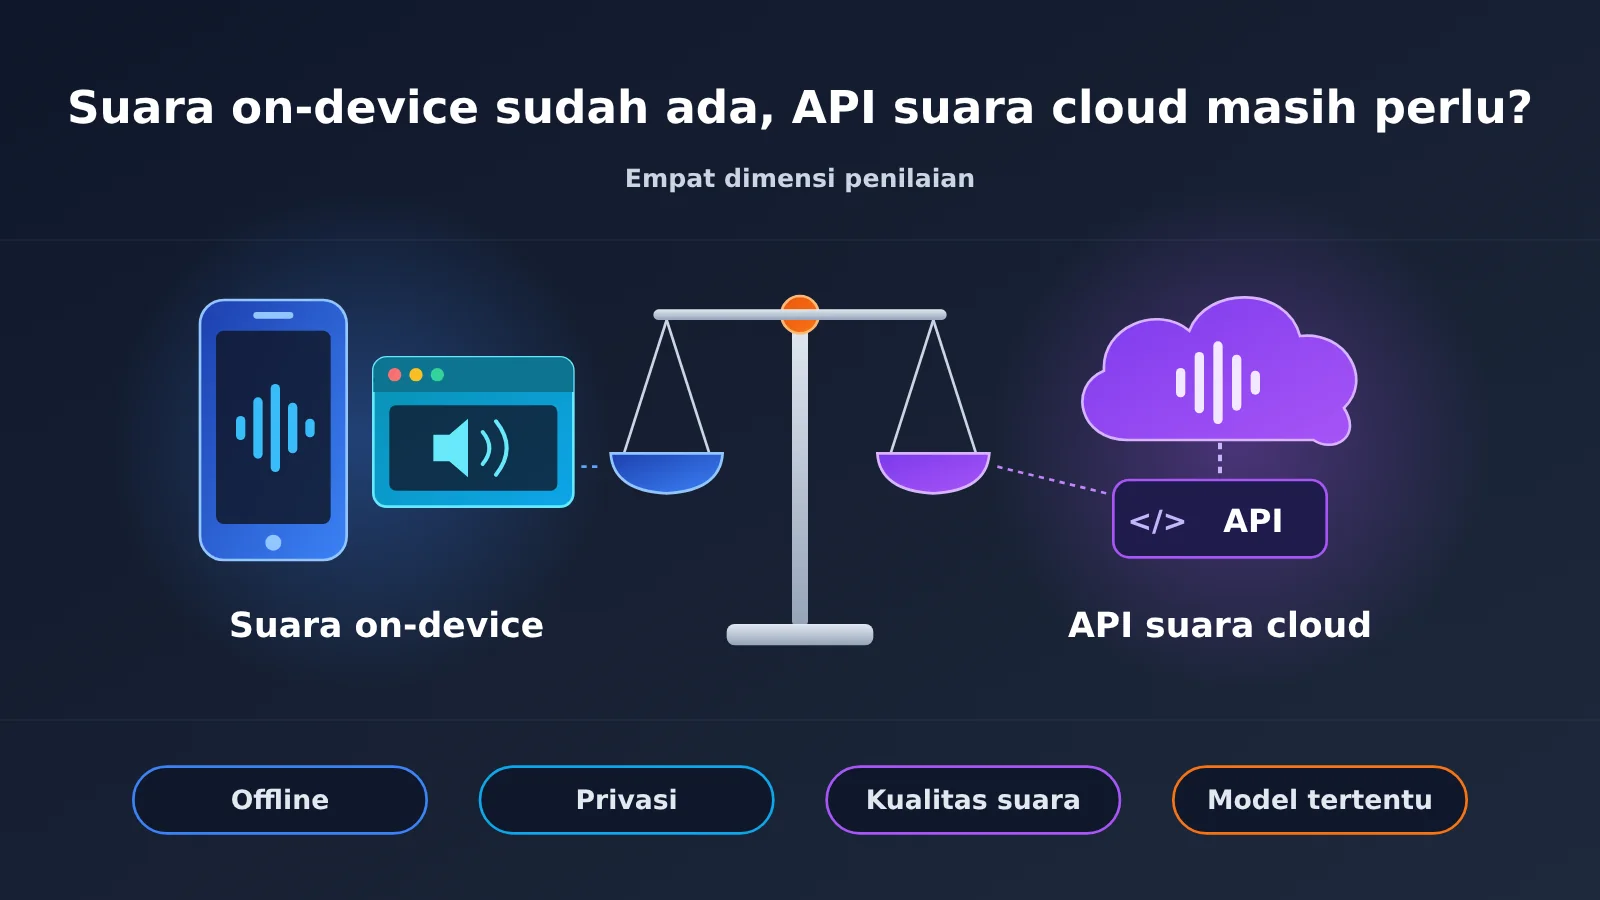
Ini bukan pilihan satu atau yang lain. Sisi perangkat dan cloud sama-sama punya batas. Keputusannya bergantung pada apakah produkmu harus bisa offline, seberapa sensitif soal privasi, seberapa tinggi tuntutan kualitas suara dan audio panjang, serta apakah kamu wajib memakai model tertentu.
Nilai utama: Setelah membaca artikel ini, kamu bisa menilai satu per satu dari 4 sisi tadi bagaimana membagi peran antara sisi perangkat dan cloud untuk produkmu, tanpa perlu memukul rata.
Suara di Perangkat Sudah Hadir: Ringkasan Informasi Inti
Mari kita pisahkan dulu mana informasi yang sudah bisa dipastikan dan mana yang belum jelas. Arah besar suara di perangkat (on-device) sudah jelas, tetapi untuk latensi dan kualitas suara model lokal tertentu, belum ada angka publik yang cukup dan bisa dibandingkan. Artikel ini tidak menebak-nebak, semuanya ditandai sebagai tidak diketahui.
| Butir informasi | Rincian |
|---|---|
| Perubahan | Sistem ponsel dan browser kini bisa mengubah teks menjadi suara secara lokal, tanpa perlu internet |
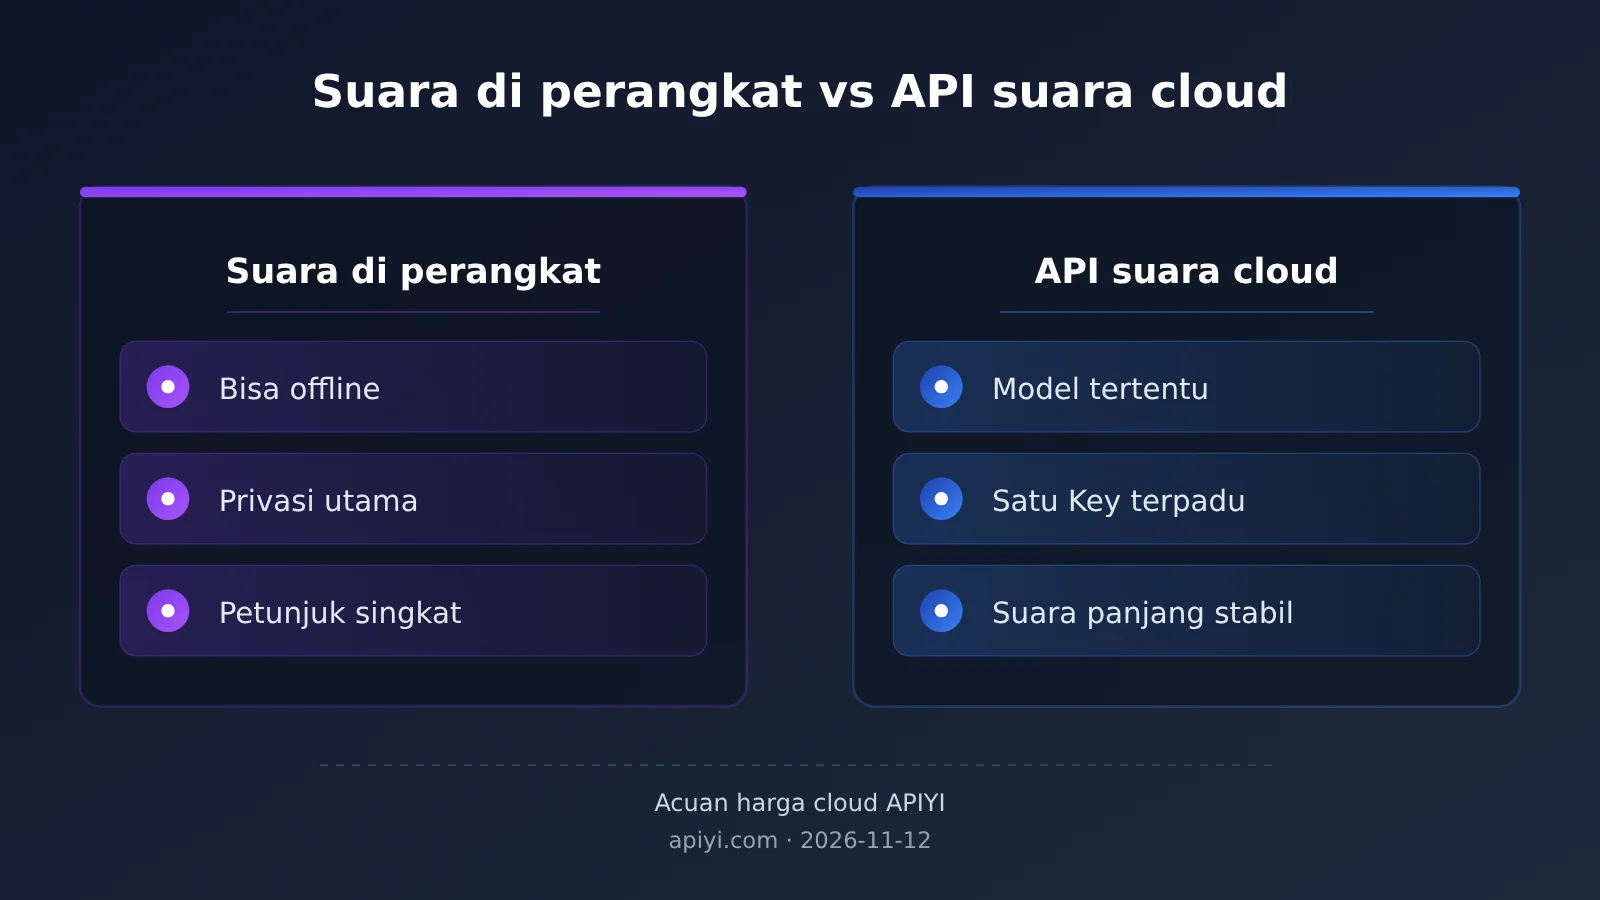
| Keunggulan di perangkat | Bisa dipakai offline, data tidak keluar dari perangkat, cocok untuk pengumuman kalimat pendek |
| Hal yang belum diketahui di perangkat | Latensi dan skor kualitas suara tiap solusi di perangkat belum punya data publik yang seragam, jadi dianggap tidak diketahui |
| Keunggulan cloud | Bisa menentukan model tertentu, berbagi satu kunci API dengan model teks, lebih stabil untuk suara yang panjang |
| Model cloud yang tersedia | Per 2026-11-12, daftar harga APIYI masih memuat tts-1, tts-1-hd, gpt-realtime-2.1, gpt-realtime-2.1-mini |
| Pihak yang terdampak | Tim produk yang membuat pengumuman suara, asisten suara, dan percakapan suara real-time |
Apa yang Bisa Dilakukan Suara di Perangkat, dan Apa yang Tidak Bisa Dijamin
Manfaat paling langsung dari suara di perangkat adalah “tanpa jaringan pun tetap bersuara”. Untuk skenario seperti petunjuk navigasi, bantuan membaca, dan nada pemberitahuan singkat di dalam aplikasi, kalimatnya pendek dan frekuensinya tinggi, sehingga sintesis lokal sudah cukup, sekaligus menghemat satu kali bolak-balik jaringan. Data tetap berada di perangkat, jadi untuk produk yang menangani teks sensitif seperti kesehatan atau keuangan, tekanan kepatuhan juga jauh lebih ringan.
Namun, warna suara dan hasil akhir yang bisa disediakan suara di perangkat bergantung pada perangkat pengguna itu sendiri. Untuk produk yang sama, di ponsel dengan merek dan versi sistem berbeda, suara yang dibacakan bisa sama sekali berbeda, dan pengembang sulit menjamin pengalaman yang konsisten. Soal seberapa jauh model di perangkat lebih lambat atau lebih rendah kualitas suaranya dibandingkan cloud, saat ini belum ada angka publik yang bisa diandalkan. Sebaiknya penilaian didasarkan pada sampel perangkat nyata dari produk Anda sendiri.
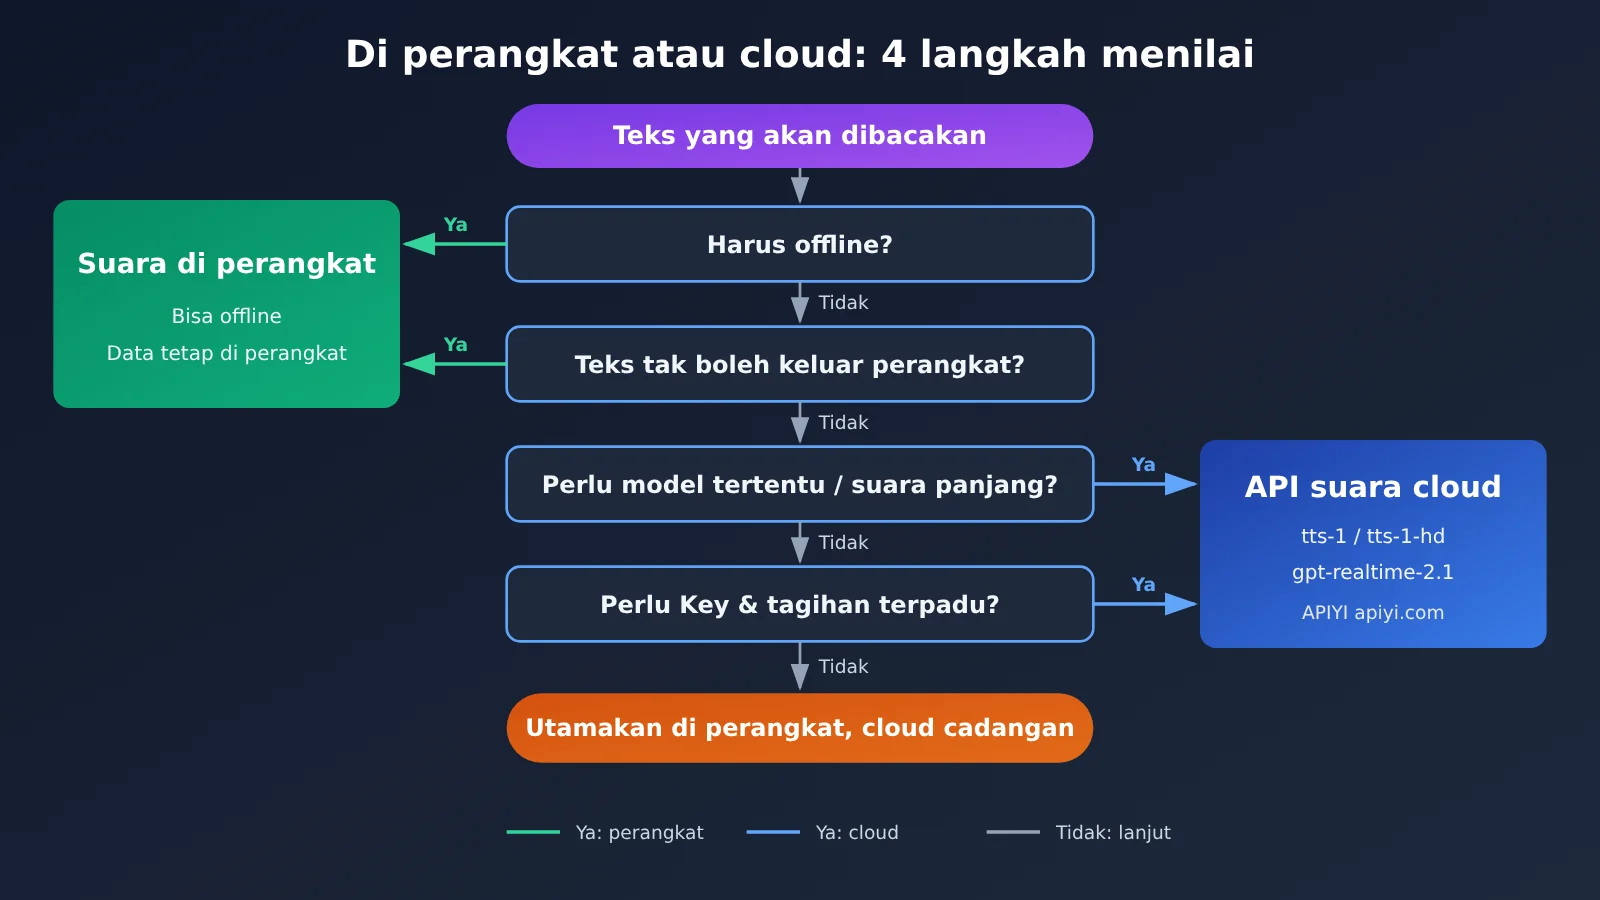
Pembagian Peran antara Suara di Perangkat dan API Suara Cloud
Memecah masalah ini ke dalam 4 dimensi jauh lebih efektif daripada memperdebatkan “perlu tidaknya mempertahankan cloud”. Tabel di bawah menunjukkan sisi mana yang lebih cocok untuk tiap dimensi, beserta pertanyaan yang perlu Anda ajukan saat menilainya.
| Dimensi Penilaian | Lebih cocok untuk suara di perangkat | Lebih cocok untuk API suara cloud | Pertanyaan yang perlu diajukan |
|---|---|---|---|
| Offline | Harus tetap bersuara di lingkungan tanpa jaringan atau jaringan lemah | Pengguna umumnya selalu online | Saat koneksi putus, apakah produk tetap harus membacakan suara? |
| Privasi | Teks sensitif, tidak boleh keluar dari perangkat | Teks boleh diunggah untuk diproses | Apakah persyaratan kepatuhan melarang data keluar dari perangkat pengguna? |
| Kualitas suara dan suara panjang | Kalimat pendek, nada notifikasi, tuntutan timbre suara tidak tinggi | Pembacaan teks panjang, tuntutan konsistensi timbre suara tinggi | Apakah dapat diterima jika tiap perangkat membacakan dengan suara yang berbeda? |
| Model tertentu dan tagihan terpadu | Tidak ada kebutuhan ini | Harus mengunci model tertentu, dengan satu kunci API yang sama dengan model teks | Apakah Anda perlu model spesifik yang tetap seperti tts-1-hd atau gpt-realtime-2.1? |
Offline dan Privasi: Wilayah Unggulan Suara di Perangkat
Kalau produk Anda sering dipakai di kereta bawah tanah, daerah pegunungan, atau di pesawat, kemampuan offline adalah kebutuhan wajib, dan suara di perangkat sebaiknya menjadi pemegang peran utama dalam pembacaan suara. Begitu pula jika aturan bisnis melarang teks input pengguna diunggah, suara di perangkat hampir menjadi satu-satunya pilihan. Pada kedua dimensi ini, API suara cloud lebih berperan sebagai “penambah kualitas saat ada jaringan”, bukan andalan utama.
Kualitas Suara, Suara Panjang, dan Model Tertentu: Wilayah Unggulan API Suara Cloud
Begitu produk membutuhkan timbre suara merek yang seragam, pembacaan artikel panjang yang stabil, atau percakapan suara real-time, cloud sulit tergantikan. Di cloud, Anda bisa menentukan model secara eksplisit, misalnya tts-1 untuk pembacaan reguler, tts-1-hd untuk kualitas suara lebih tinggi, serta gpt-realtime-2.1 atau gpt-realtime-2.1-mini untuk percakapan real-time, sehingga semua pengguna mendengar output dari model yang sama.
Satu hal lagi yang sering terlupakan adalah pengelolaan tagihan dan kunci. Selain suara, sebagian besar produk juga memanggil Model Bahasa Besar untuk pemahaman, ringkasan, atau pembuatan percakapan. Kalau suara dan teks memakai satu kunci API dan satu tagihan yang sama, urusan operasional dan rekonsiliasi akan jauh lebih sederhana.
Cara Mengintegrasikan API Suara Cloud: Sisakan Satu Jalur yang Stabil
Meski Anda memutuskan untuk mengutamakan pemrosesan di sisi perangkat, sebaiknya tetap sisakan satu jalur cloud sebagai cadangan sekaligus penguat. APIYI memakai antarmuka yang kompatibel dengan OpenAI, sehingga cara integrasinya hampir sama dengan memanggil SDK resmi. Anda cukup mengganti base_url.
Langkah integrasinya secara ringkas:
- Inisialisasi klien:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Panggil sintesis suara:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - Kalau butuh kualitas suara yang lebih tinggi, ganti model menjadi
tts-1-hd, parameter lainnya tidak perlu diubah - Model teks juga diarahkan ke
https://api.apiyi.com/v1, jadi suara dan teks bisa memakai satu kunci API yang sama
Koneksi untuk percakapan suara real-time (seri gpt-realtime-2.1) berbeda dari permintaan HTTP biasa. Untuk parameter integrasinya, ikuti penjelasan di pusat dokumentasi APIYI.
| Model | Jenis | Kegunaan Umum | Platform Tersedia |
|---|---|---|---|
| tts-1 | Teks ke suara | Pengumuman rutin, pembacaan notifikasi | APIYI apiyi.com |
| tts-1-hd | Teks ke suara (kualitas tinggi) | Pembacaan teks panjang, suara khas merek | APIYI |
| gpt-realtime-2.1 | Percakapan suara real-time | Asisten suara, interaksi real-time | APIYI |
| gpt-realtime-2.1-mini | Percakapan suara real-time (ringan) | Skenario real-time yang lebih sensitif terhadap biaya | APIYI |
🚀 Mulai Cepat: Kalau Anda sedang menimbang apakah suara cloud perlu dipertahankan, daftar dulu di APIYI apiyi.com, lalu manfaatkan kuota uji coba gratis untuk pengguna baru. Kirim satu teks yang sama ke tts-1 dan tts-1-hd, lalu bandingkan hasilnya dengan pembacaan lokal di perangkat. Dari situ Anda bisa menilai apakah selisih kualitasnya sepadan dengan biayanya.
Analisis Dampak Setelah Suara On-Device Hadir
Dampak bagi Developer
- Arsitektur berubah dari satu pilihan menjadi hibrida: modul suara perlu satu lapisan routing yang menentukan apakah proses berjalan di perangkat (on-device) atau di cloud, berdasarkan kondisi jaringan, sensitivitas teks, dan panjang teks
- Biaya pengujian naik: hasil on-device bergantung pada perangkat pengguna, sehingga perlu mengambil sampel dari berbagai tipe perangkat dan browser, sedangkan output cloud relatif konsisten
- Logika cadangan jadi wajib: kalau cloud gagal, turun ke on-device; kalau on-device tidak tersedia, kembali ke cloud. Kedua jalur saling menjadi cadangan
Dampak pada Arsitektur Produk
Cara penerapan arsitektur hibrida yang paling umum adalah menetapkan satu jalur default dan satu jalur cadangan (fallback) untuk setiap jenis tugas suara. Tabel di bawah ini bisa langsung dipakai sebagai titik awal desain.
| Tugas Suara | Jalur Default | Jalur Cadangan | Alasan |
|---|---|---|---|
| Petunjuk kalimat pendek, pengumuman navigasi | Suara on-device | tts-1 di cloud | Kalimat pendek cukup diproses lokal, dan harus tetap berfungsi saat offline |
| Pembacaan teks sensitif | Suara on-device | Tidak turun ke cloud | Data tidak boleh keluar dari perangkat |
| Artikel panjang, konten audio | tts-1-hd di cloud | Suara on-device | Warna suara konsisten, suara panjang lebih stabil |
| Percakapan suara real-time | gpt-realtime-2.1 di cloud | gpt-realtime-2.1-mini | Model harus ditentukan, interaksi real-time bergantung pada cloud |
Dampak pada Perhitungan Biaya
Suara on-device tidak ditagih per pemanggilan, dan inilah alasan banyak tim ingin memindahkan seluruh fitur suara ke lokal. Tapi perlu diingat, biaya pemanggilan yang dihemat bisa berubah menjadi biaya adaptasi dan pengujian, serta pengguna yang pergi karena pengalaman menurun di perangkat kelas bawah. Pendekatan yang lebih masuk akal adalah memindahkan hanya kalimat pendek berfrekuensi tinggi ke on-device, dan menyisakan tugas yang sensitif terhadap kualitas di cloud. Dengan begitu, volume pemanggilan cloud turun dengan sendirinya, sementara pengalaman yang krusial tetap terjaga.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Kalau suara on-device sudah dipakai, apakah API suara di cloud bisa langsung dimatikan?
Untuk sebagian besar produk, sebaiknya jangan langsung dimatikan. Suara on-device memang menyelesaikan kebutuhan offline dan privasi, tetapi pemilihan model tertentu, stabilitas untuk audio panjang, dan konsistensi karakter suara masih bergantung pada cloud. Pendekatan yang lebih aman: jadikan on-device sebagai jalur utama, lalu pakai cloud sebagai cadangan sekaligus penguat.
Q2: Seberapa besar selisih kualitas suara dan latensi antara suara on-device dan API suara di cloud?
Saat ini belum ada angka evaluasi publik yang seragam dan bisa dijadikan acuan. Performa tiap solusi on-device juga bergantung pada perangkat yang dipakai, jadi di sini kami anggap hasilnya belum diketahui. Sebaiknya lakukan uji dengar secara sampling pada beberapa perangkat yang umum dipakai target pengguna Anda, lalu bandingkan dengan keluaran tts-1 dan tts-1-hd di cloud.
Q3: Sampai sekarang, model suara apa saja di cloud yang masih bisa dipanggil?
Per 2026-11-12, daftar harga APIYI masih menyediakan tts-1, tts-1-hd, serta gpt-realtime-2.1 dan gpt-realtime-2.1-mini untuk suara real-time. Daftar model bisa berubah sewaktu-waktu, jadi selalu rujuk daftar harga terbaru di platform.
Q4: Bagaimana cara memanggil model suara dan model teks sekaligus dengan satu Key?
Buat satu API Key lewat APIYI apiyi.com, lalu atur base_url ke `https://api.apiyi.com/v1`. Sintesis suara, suara real-time, dan model teks seperti GPT, Claude, dan Gemini semuanya lewat satu pintu yang sama. Tagihannya pun digabung, sehingga rekonsiliasi berdasarkan pemakaian jadi lebih mudah.
Q5: Pada arsitektur hibrida, apa yang harus dilakukan kalau pemanggilan ke cloud gagal?
Tambahkan satu lapisan fallback di lapisan routing suara. Saat permintaan ke cloud timeout atau error, kalimat pendek yang tidak sensitif bisa dialihkan ke pembacaan on-device, sedangkan untuk audio panjang pengguna bisa diminta mencoba lagi nanti. Pada skenario percakapan real-time, Anda bisa berpindah antara gpt-realtime-2.1 dan gpt-realtime-2.1-mini.
Poin Utama: Suara On-Device vs API Suara Cloud (Key Takeaways)
- Bukan pilih salah satu: suara on-device dan API suara cloud punya pembagian peran, jadi tugas dialokasikan sesuai jalurnya
- On-device untuk offline dan privasi: tetap jalan tanpa internet, data tidak keluar dari perangkat, cocok untuk kalimat pendek dan suara notifikasi
- Cloud untuk kualitas dan konsistensi: suara panjang, suara khas brand, dan percakapan real-time tetap butuh model cloud
- Model tertentu hanya bisa lewat cloud: kalau ingin mengunci tts-1-hd atau gpt-realtime-2.1, Anda harus memakai API
- Data performa on-device belum diketahui: untuk bagian yang tidak ada angka publiknya, pakai hasil sampling dari perangkat Anda sendiri
- Satu kunci API, operasional lebih ringan: lewat APIYI (apiyi.com), model suara dan model teks bisa berbagi satu kunci API dan satu tagihan
Kesimpulan
Kalau suara on-device sudah dipakai, apakah API suara cloud masih perlu dipertahankan? Jawabannya tergantung pada 4 dimensi berikut:
- Offline: tugas yang harus tetap jalan tanpa jaringan diserahkan ke suara on-device
- Privasi: tugas yang teksnya tidak boleh keluar dari perangkat hanya berjalan di on-device
- Kualitas suara dan suara panjang: tugas yang menuntut konsistensi dan stabilitas tetap di cloud
- Model tertentu dan tagihan terpadu: tugas yang perlu mengunci model tertentu dan berbagi satu kunci API dengan model teks tetap memakai API cloud
Kesimpulannya jelas: on-device menyelesaikan masalah offline dan privasi, sedangkan model tertentu dan tagihan terpadu tetap diserahkan ke cloud. Sebaiknya pindahkan dulu kalimat pendek yang sering dipakai ke on-device, lalu pertahankan suara panjang dan percakapan real-time di cloud. Lewat APIYI (apiyi.com), Anda bisa memanggil tts-1, tts-1-hd, dan seri gpt-realtime-2.1 secara terpadu. Uji dulu hasilnya dengan kuota uji coba gratis, baru tentukan porsi masing-masing jalur.
📚 Referensi
- Pusat Dokumentasi APIYI: Panduan sintesis suara dan akses suara real-time
- Tautan:
docs.apiyi.com -
Keterangan: Lihat parameter pemanggilan dan cara akses model seperti tts-1, gpt-realtime-2.1, dan lainnya
-
Pusat Bantuan APIYI: Tutorial penggunaan platform dan pertanyaan umum
- Tautan:
help.apiyi.com - Keterangan: Cocok dibaca saat pertama kali mengakses, mulai dari pengajuan Key, penagihan, hingga daftar model
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda situs APIYI apiyi.com. Materi lainnya bisa dilihat di pusat dokumentasi docs.apiyi.com