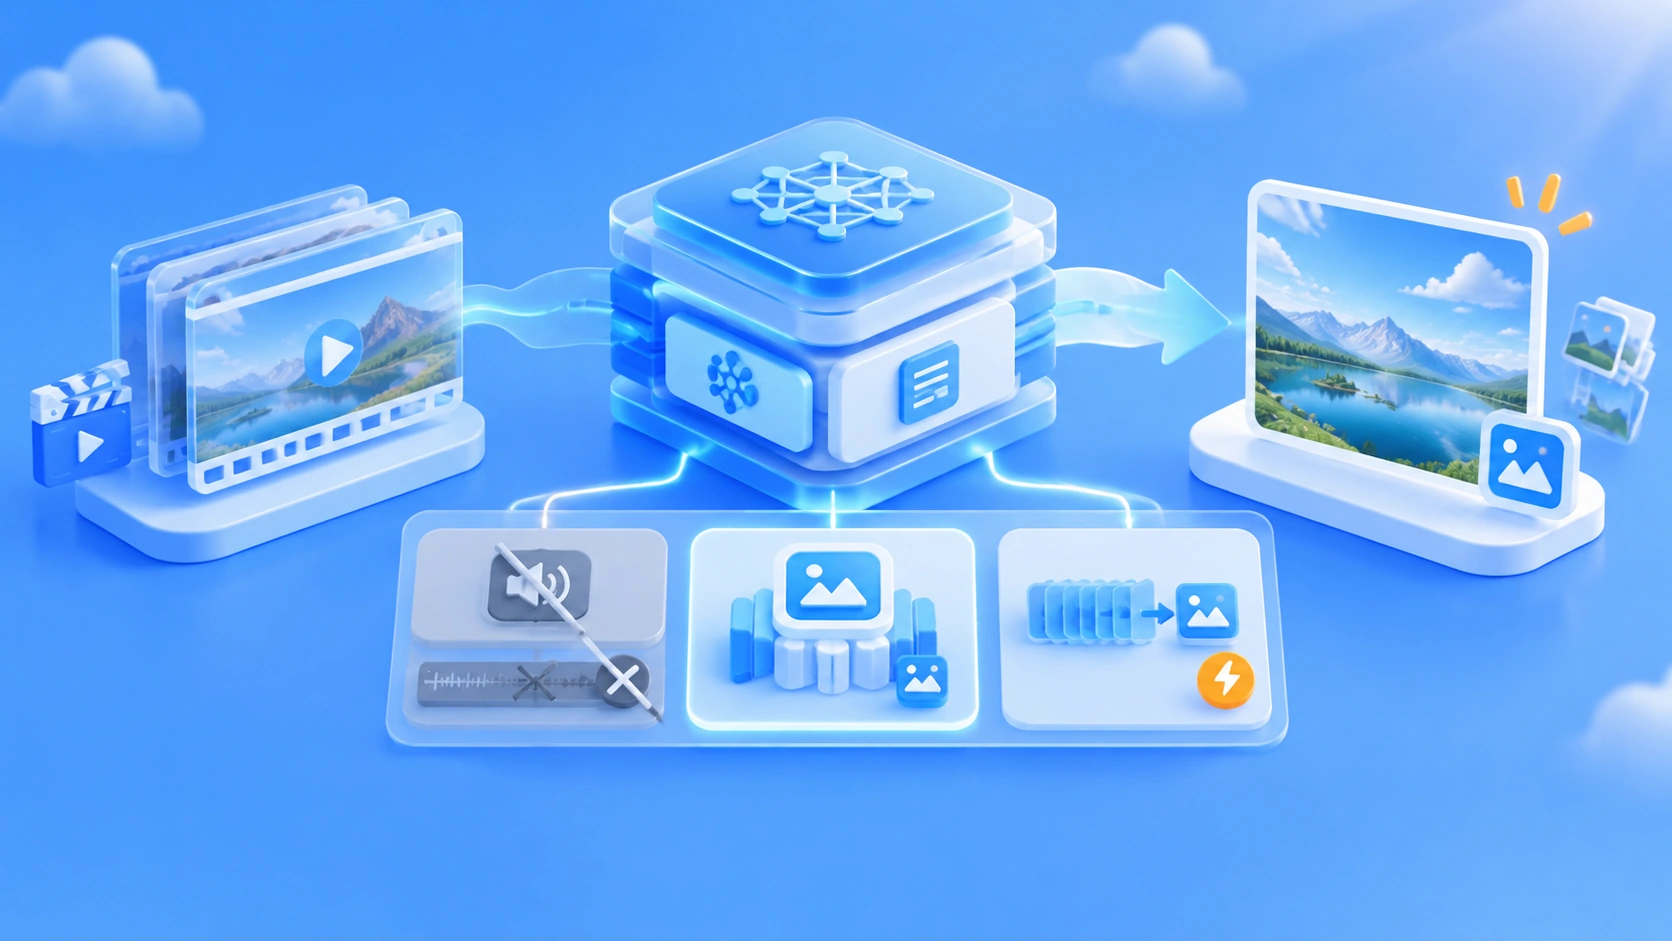
Catatan penulis: H3-Image memakai ulang fondasi multimodal H3, lalu menambahkan komponen khusus gambar dan mengoptimalkan ulang alur pelatihan serta inferensinya, sehingga menjadi model pembuatan gambar yang berdiri sendiri. Artikel ini membedah apa saja yang diwarisi, apa yang dibuang, dan apa yang ditambahkan.
6 istilah yang perlu dipahami sebelum membahas arsitektur MiniMax H3
Beberapa konsep di bawah ini akan sering muncul di bagian berikutnya, jadi kita jelaskan dulu masing-masing dalam satu kalimat.
| Istilah | Penjelasan sederhana | Peran dalam MiniMax H3 |
|---|---|---|
| Transformer | Jaringan saraf untuk memproses data berurutan, jago menangkap hubungan antar elemen dalam sebuah urutan | H3-Omni-Transformer adalah inti dari seluruh keluarga model ini |
| DiT | Model difusi yang dibangun dengan Transformer, menghasilkan konten lewat proses pembersihan derau (denoising) bertahap | Bagian utama H3-Image adalah DiT aliran tunggal (single-stream) dengan 33,1B parameter |
| VAE | Model yang meng-encode dan men-decode antara piksel dan representasi terkompresi, ibarat “kompresor + dekompresor” | H3 memakai VAE visual dan VAE audio, sedangkan H3-Image diganti dengan VAE khusus gambar |
| Variabel laten | Representasi ringkas dari data asli setelah dikompresi. Menghitung di ruang ini jauh lebih hemat daripada memproses piksel secara langsung | Yang diprediksi Transformer adalah variabel laten, bukan piksel |
| RoPE | Rotary Position Embedding, memberi tahu model posisi tiap token dalam urutan | H3 memakai 3D Multimodal RoPE untuk menyatakan posisi dalam waktu dan ruang |
| Distilasi | Melatih proses kompleks yang semula butuh banyak langkah agar cukup diselesaikan dalam beberapa langkah saja | H3-Image didistilasi sehingga hanya perlu 6 langkah sampling |
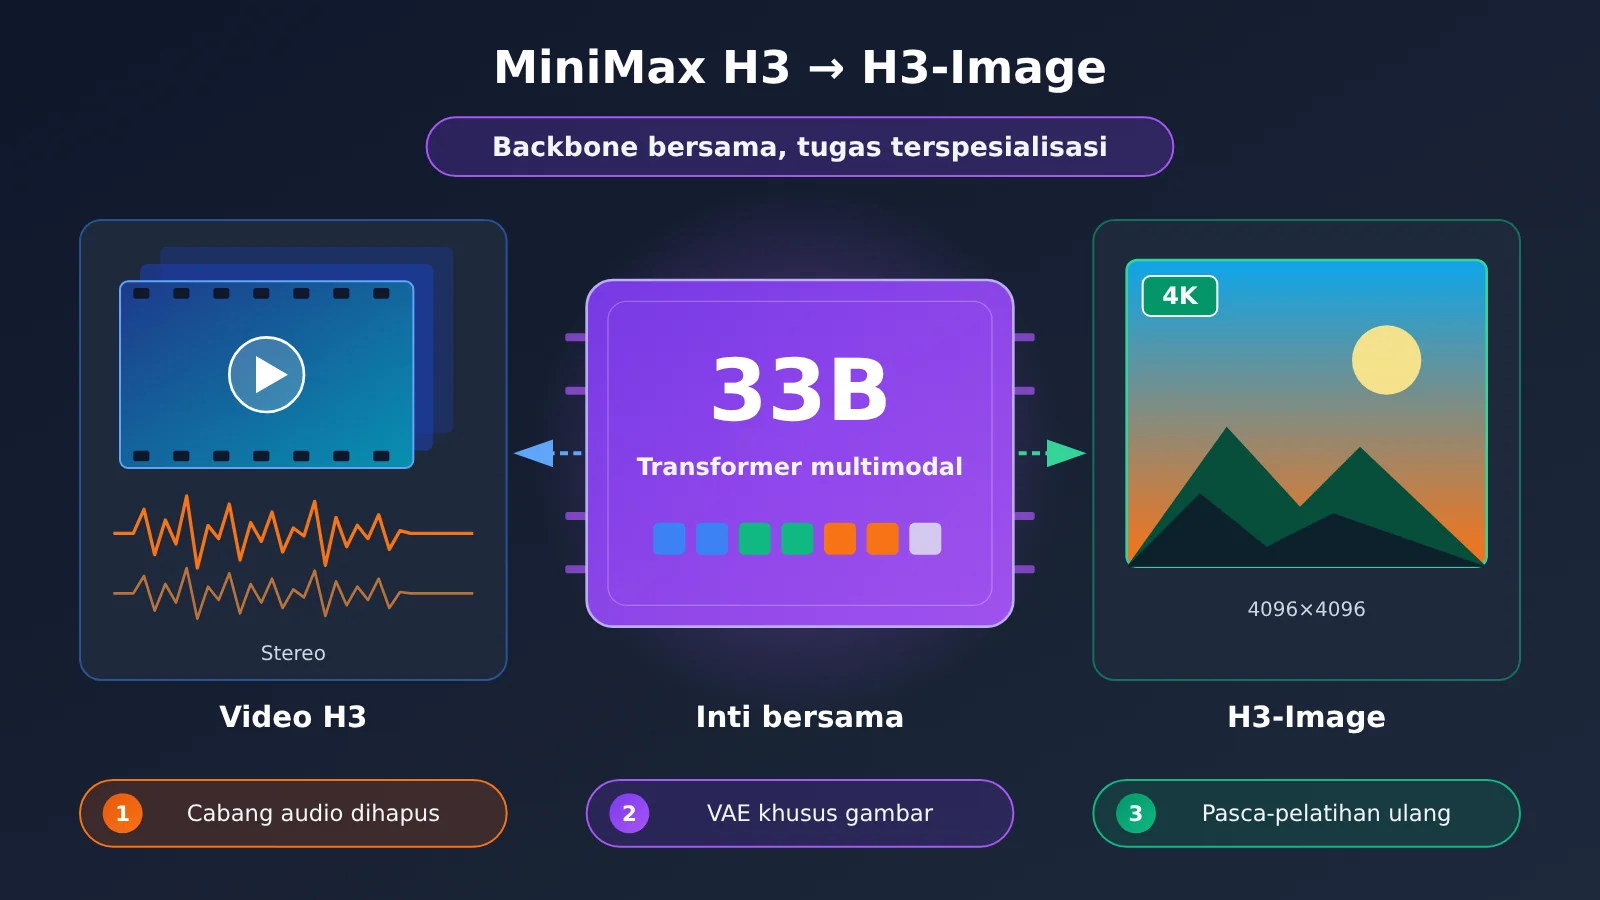
Pada November 2026, MiniMax membuka bobot model pembuatan gambar H3-Image. H3 yang dirilis sebagai open source tiga bulan sebelumnya adalah model yang bisa menghasilkan video lengkap dengan audio stereo. Model baru ini punya skala parameter yang sama, sekitar 33B, dan arsitektur intinya juga berasal dari H3.
Ini bukan sekadar “mengubah keluaran model video menjadi satu frame”. Model card resmi dan blog rilis H3-Image sudah menjelaskan bahwa model ini tetap memakai Transformer multimodal inti dan text encoder dari H3, membuang cabang pembuatan audio, memasang VAE khusus gambar, dan membuat ulang pasca-pelatihan serta alur inferensi untuk tugas gambar.
Nilai utama: setelah membaca artikel ini, kamu akan tahu bagian mana saja yang diubah ketika arsitektur 33B yang sama berpindah dari video ke gambar, mengapa tiap bagian itu perlu diubah, dan mana yang merupakan fakta yang dikonfirmasi resmi dibandingkan sekadar dugaan dari kalangan industri.
MiniMax H3 dari Video ke Gambar: Apa yang Dirilis MiniMax
Mari kita luruskan dulu garis waktunya. Banyak orang yang membaca berita “MiniMax H3 open source” mudah mencampuradukkan dua rilis berbeda. Padahal H3 dan H3-Image adalah dua hal yang terpisah, dengan jarak sekitar tiga bulan.
| Waktu | Peristiwa | Keterangan |
|---|---|---|
| 2026-07-31 | MiniMax merilis pengantar model H3 | Blog teknis resmi pertama kali membuka arsitektur H3 ke publik |
| 2026-08-03 | MiniMax H3 resmi membuka bobot model | Model pembuatan video omnimodal; yang dirilis sebagai open source adalah H3-Base |
| 2026-11-10 | Tanggal yang tercantum pada H3-Image Community License | Bobot model pembuatan gambar dibuka |
| 2026-11-11 | Blog resmi MiniMax berbahasa Inggris merilis pengantar H3-Image | Mengumumkan detail pasca-pelatihan dan optimasi inferensi |
Posisi Tugas MiniMax H3 dan H3-Image
Tugas keduanya berbeda sama sekali. H3 adalah sistem pembuatan video omnimodal yang dapat memahami input teks, gambar, video, dan audio sekaligus. Outputnya berupa video berdurasi 4–15 detik, 24 FPS, dengan suara stereo native 32kHz. Sisi pendek output default-nya 768px, dan untuk alur kerja lengkap resolusinya bisa mencapai 2K. Sementara itu, H3-Image berfokus pada pembuatan dan penyuntingan gambar beresolusi tinggi. Spesifikasi resminya mencapai sekitar 16MP (misalnya 4096×4096), dan MiniMax menyebut gambar 4K bisa dibuat dalam waktu kurang dari 10 detik.
Dari sini muncul pertanyaan inti artikel ini: satu model mengerjakan “video dengan suara”, yang lain mengerjakan “gambar statis beresolusi tinggi”. Lalu kenapa keduanya bisa berada dalam satu keluarga teknologi? Jawabannya ada di desain dasar H3.
Arsitektur Dasar MiniMax H3: Transformer Multimodal Terpadu
Inti dari H3 disebut H3-Omni-Transformer. Menurut pengenalan teknis resmi, ini adalah Transformer single-stream dan dense dengan sekitar 33B parameter. “Single-stream” artinya informasi dari berbagai modalitas tidak melewati jaringan yang terpisah. Semuanya digabung ke dalam satu urutan yang sama dan diproses oleh satu set parameter. Sementara “dense” berarti setiap token dihitung melalui seluruh parameter, bukan hanya sebagian pakar (expert) yang diaktifkan seperti pada MoE.
Cara MiniMax H3 Mengenkode Berbagai Modalitas
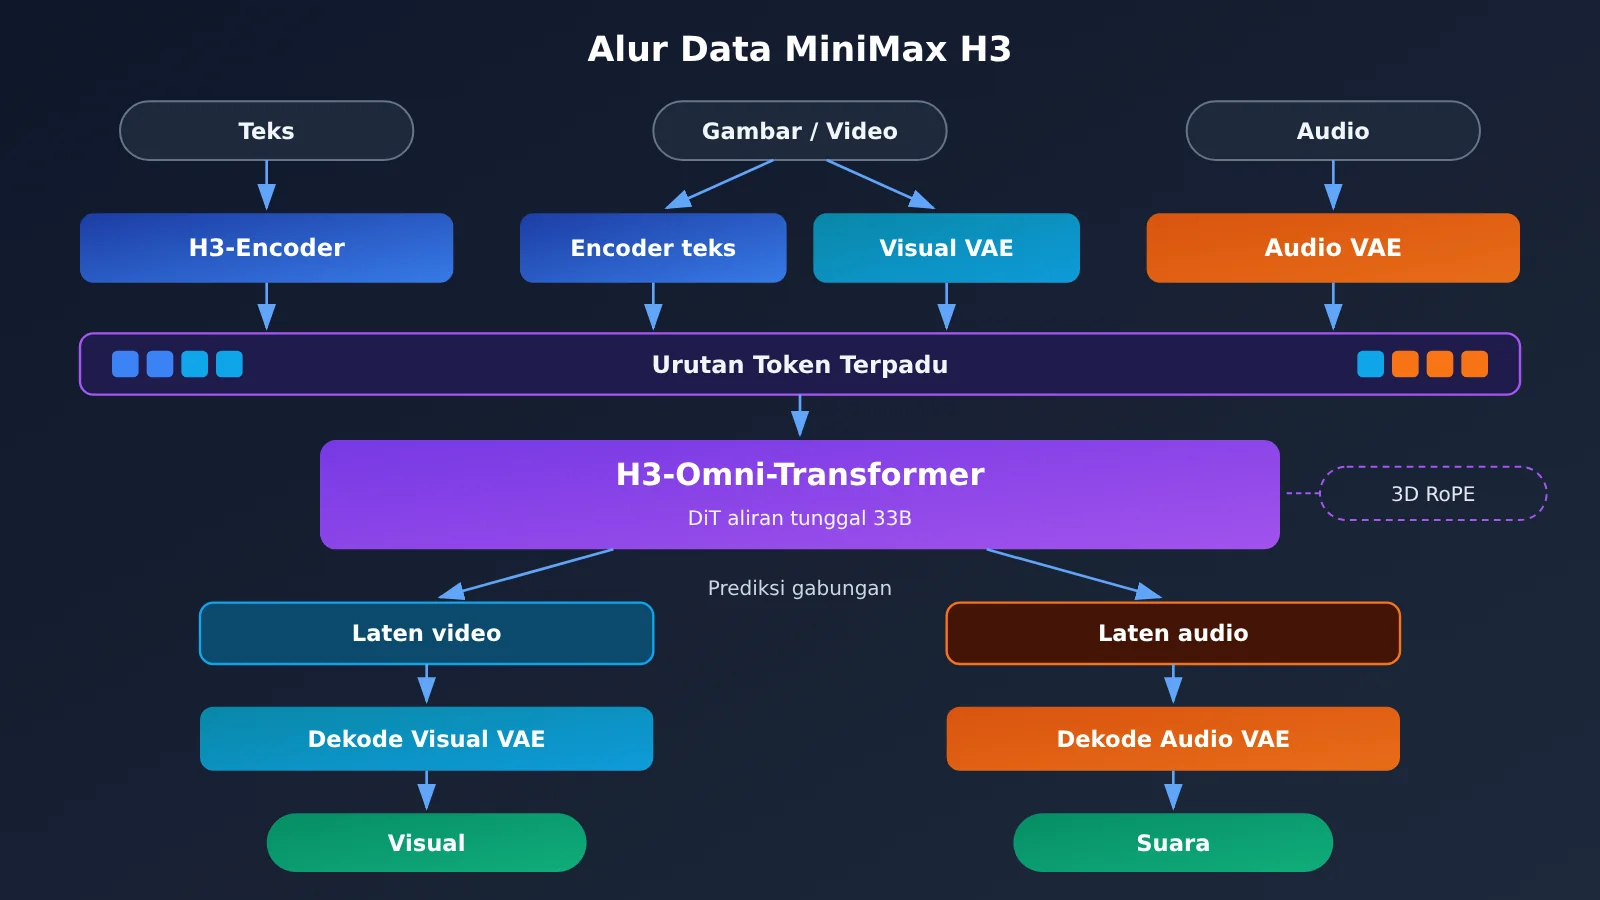
Alur pemrosesan yang diumumkan secara resmi kurang lebih seperti ini:
- Teks: dienkode oleh H3-Encoder menjadi representasi semantik, yang memberi tahu model “apa yang ingin kamu lihat terjadi di dalam gambar”.
- Gambar dan video: diproses sekaligus oleh encoder teks dan Visual VAE. Encoder teks bertugas memahami semantik isi gambar, sedangkan Visual VAE memampatkan piksel menjadi laten.
- Audio: dimampatkan oleh Audio VAE menjadi laten audio.
- Urutan terpadu: representasi dari semua modalitas di atas digabung menjadi satu urutan, lalu dimasukkan ke Transformer.
- Prediksi gabungan: Transformer memprediksi laten video dan audio secara bersamaan, lalu masing-masing diserahkan ke VAE yang sesuai untuk didekode menjadi gambar dan suara.
Bisa dibayangkan seperti “semua orang berbicara dalam bahasa yang sama”. Apa pun input aslinya, entah sebaris kalimat, sebuah gambar, atau sepotong musik, semuanya diterjemahkan dulu menjadi urutan token sebelum masuk ke Transformer. Model tidak peduli token itu berasal dari modalitas mana. Tugasnya hanya mencari hubungan antar token dan menghasilkan token target.
Fungsi 3D Multimodal RoPE
Video punya sumbu waktu sekaligus ruang dua dimensi, jadi H3 memakai 3D Multimodal RoPE untuk mengenkode posisi. Sebuah token tidak hanya perlu tahu koordinat horizontal dan vertikalnya di dalam gambar, tetapi juga frame ke berapa ia berada. Desain ini sudah dikonfirmasi secara resmi. Hal ini penting untuk memahami H3-Image nanti, karena sebuah gambar bisa dianggap sebagai kasus khusus dengan “dimensi waktu yang hanya satu frame”.
【Kesimpulan kami】 Justru karena H3 sejak awal dirancang dengan “urutan terpadu + Transformer terpadu”, bukan sebagai pipeline satu tugas “teks masuk, video keluar”, jaringan utamanya punya fondasi untuk dipindahkan ke tugas pembuatan lainnya. Pernyataan ini tidak disampaikan secara langsung oleh pihak resmi. Ini adalah penilaian kami berdasarkan desain arsitekturnya.
Apa yang Diwarisi, Dihapus, dan Ditambahkan oleh MiniMax H3-Image
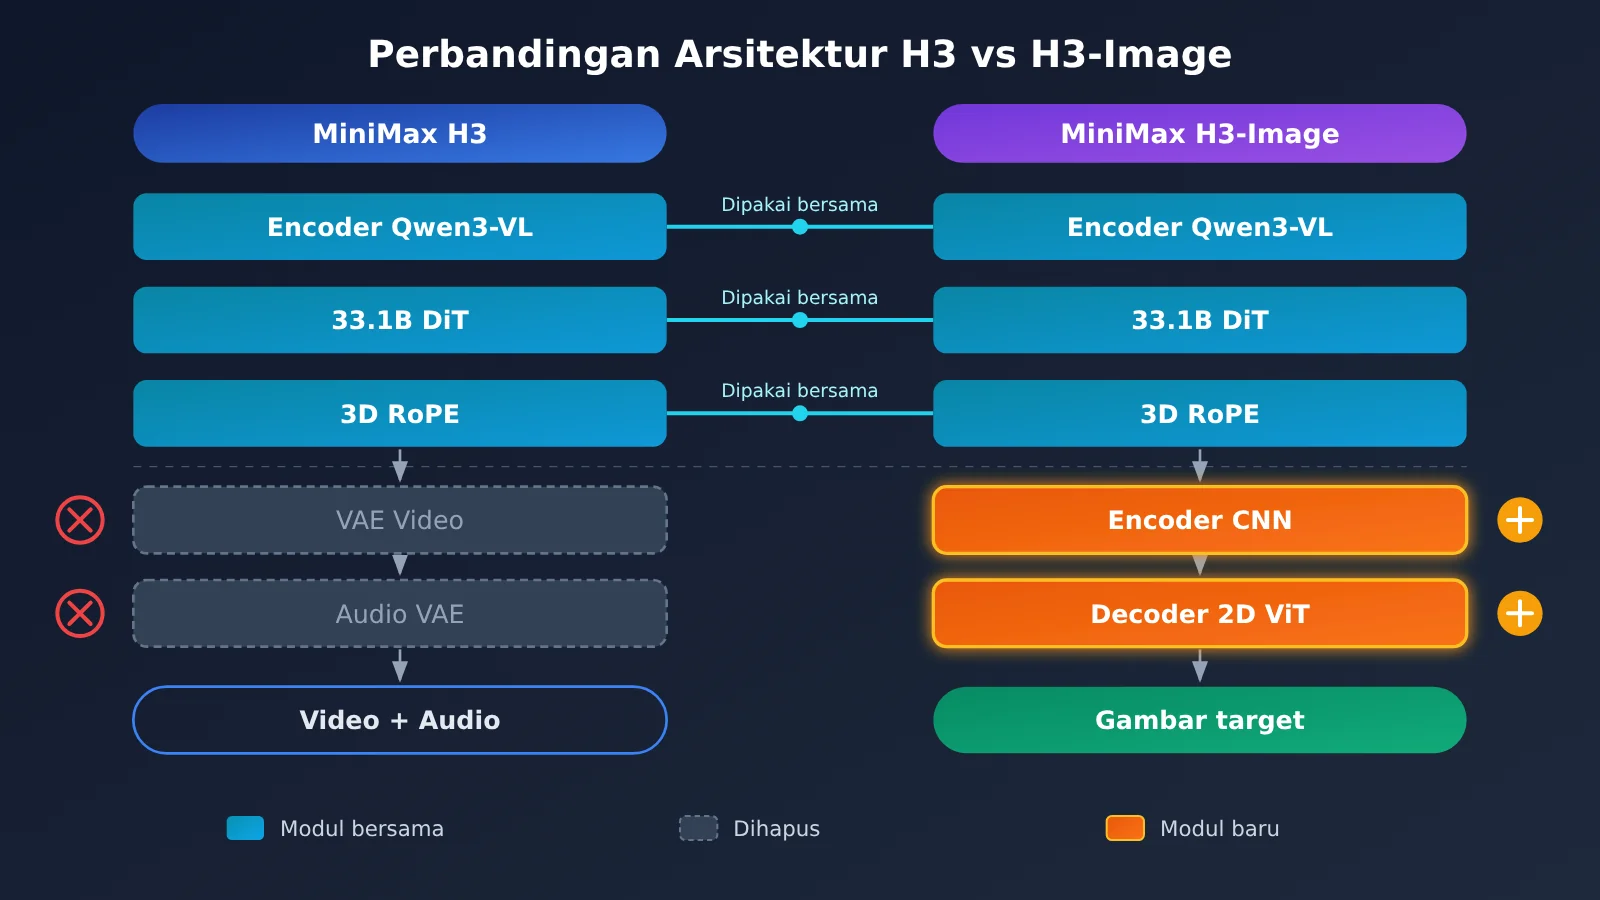
Bagian ini paling layak dicermati dalam keseluruhan evolusi teknologinya. Tabel berikut disusun berdasarkan model card resmi H3-Image:
| Kategori | Komponen | Pendekatan |
|---|---|---|
| Diwarisi | Text encoder Qwen3-VL | Memakai text encoder lengkap dari H3, dengan mengambil hidden state dari layer ke-50 |
| Diwarisi | DiT single-stream 33,1B | Mempertahankan arsitektur inti H3-Omni-Transformer |
| Diwarisi | 3D Multimodal RoPE | Tetap dipakai untuk mengodekan hubungan posisi |
| Dihapus | Cabang audio | Tidak lagi melakukan pembuatan video dan audio secara gabungan |
| Diganti | VAE khusus gambar | Encoder CNN + decoder ViT 2D 24 layer |
| Diubah | Target generasi | Teks dan gambar referensi dikodekan menjadi satu sekuens terpadu, lalu model memprediksi latent gambar target |
Warisan Pertama: Text Encoder Qwen3-VL dan Hidden State Layer ke-50
Model card H3-Image menyebutkan bahwa model ini tetap memakai text encoder berbasis Qwen3-VL dari H3, dan menggunakan hidden state dari layer ke-50 sebagai masukan kondisi. Qwen3-VL sendiri adalah model vision-language, jadi ia tidak hanya memahami teks, tetapi juga isi gambar referensi. Kemampuan inilah yang dibutuhkan untuk penyuntingan dengan banyak gambar referensi.
【Praktik umum di industri】 Soal mengapa yang diambil adalah layer tengah dan bukan layer terakhir, pihak resmi tidak menjelaskannya lebih jauh. Secara umum, layer-layer terakhir pada model bahasa cenderung lebih condong ke tugas “memprediksi kata berikutnya”, sedangkan layer tengah menyimpan fitur semantik yang lebih kaya dan lebih umum. Banyak model difusi memakai pendekatan serupa.
Warisan Kedua: DiT 33,1B dan 3D RoPE
Spesifikasi utama DiT pada H3-Image adalah sebagai berikut:
| Parameter | Nilai | Penjelasan sederhana |
|---|---|---|
| Jumlah parameter | 33,1B | Selevel dengan tulang punggung H3 yang sekitar 33B |
| Jumlah lapisan | 50 lapisan | Informasi melewati 50 kali transformasi |
| Hidden Size | 5376 | Dimensi representasi setiap token |
| Attention Heads | 56 | Memperhatikan hubungan antartoken dari 56 sudut pandang sekaligus |
| FFN Size | 14336 | Lebar tengah jaringan feed-forward di setiap lapisan |
| Downsampling spasial VAE | 16 kali | Sisi 4096 piksel dimampatkan menjadi 256 |
| Kanal laten | 24 | Setiap posisi laten membawa 24 nilai |
| Cakupan per token | sekitar 32×32 piksel | Menentukan panjang urutan dan beban komputasi |
Dengan asumsi setiap token kira-kira mencakup 32×32 piksel, satu gambar 4096×4096 setara dengan sekitar 128×128 = 16384 token (ini estimasi kami berdasarkan parameter resmi). Kalau ditambah beberapa gambar referensi, urutannya jadi makin panjang. Inilah sebabnya optimasi kecepatan inferensi sangat penting untuk model ini.
【Kesimpulan kami】 3D RoPE tetap berguna dalam tugas gambar. Gambar target hanya satu frame, tetapi beberapa gambar referensi dan gambar target perlu dibedakan dalam urutan, yaitu mana yang mana. Dimensi tambahan itu bisa dipakai untuk membedakannya. Skema alokasi posisi yang spesifik belum diumumkan secara resmi, jadi ini hanya salah satu pemahaman yang masuk akal.
Dihapus: Cabang Audio
Gambar tidak punya durasi dan tidak punya suara, jadi mempertahankan cabang audio hanya membuang sumber daya untuk pelatihan dan inferensi. Setelah cabang ini dibuang, target belajar model menyempit dari “distribusi gabungan video + audio” menjadi “distribusi gambar” saja, sehingga sinyal pelatihannya juga lebih terfokus.
Diganti: VAE Khusus Gambar
Visual VAE pada H3 harus memperhatikan kesinambungan waktu pada video. Sementara itu, H3-Image memakai VAE yang dirancang khusus untuk gambar statis. Encoder-nya berbasis CNN, yang pandai mengekstrak tekstur lokal secara efisien. Decoder-nya adalah ViT 2D 24 lapisan, yang bisa menjaga struktur global saat merekonstruksi piksel. Downsampling 16 kali yang dipadukan dengan 24 kanal berarti informasi disimpan dalam posisi spasial yang lebih sedikit tetapi kanal yang lebih banyak. Hal ini penting untuk keluaran beresolusi tinggi setingkat 16MP. Pihak pengembang juga menegaskan bahwa hasil beresolusi tinggi H3-Image dihasilkan secara langsung, bukan mengandalkan super-resolution (upscaler) konvensional.
Perubahan: dari “memprediksi video + audio” ke “memprediksi gambar target”
Alur pembuatan gambar akhirnya seperti ini: petunjuk teks dan gambar referensi dienkode bersama menjadi satu urutan terpadu. DiT lalu melakukan denoising bertahap di ruang laten untuk memprediksi laten gambar target, kemudian VAE gambar mendekodenya menjadi gambar final. Soal jumlah gambar referensi, model card menyebut batas atas 16 gambar, sedangkan resep deployment vLLM menuliskan maksimal 9 gambar. Kedua angka ini memakai acuan yang berbeda, jadi jumlah yang benar-benar bisa dipakai tergantung pada framework inferensi yang Anda gunakan.
Optimasi apa saja di MiniMax H3-Image agar lebih cepat dan mudah dipakai
Mengubah arsitektur saja belum cukup. Dalam blog peluncuran H3-Image, MiniMax menyebutkan bahwa dengan tetap mewarisi kemampuan pra-pelatihan H3, mereka memperbaiki alur pasca-pelatihan di lima sisi: data pelatihan, reinforcement learning, pemadatan jumlah langkah sampling, peningkatan petunjuk (Prompt Enhancement), dan optimasi deployment. Detail soal data dan reinforcement learning tidak dibuka ke publik, jadi kita fokus ke bagian yang informasinya lebih banyak.
Distilasi Sampling 6 Langkah dan Penghapusan CFG
Proses diffusion model membuat gambar itu “mulai dari noise, lalu dibersihkan sedikit demi sedikit”. Cara yang lazim biasanya butuh puluhan langkah. Selain itu, diffusion model tradisional umumnya juga memakai CFG (Classifier-Free Guidance): di setiap langkah, model harus dijalankan dua kali, sekali dengan petunjuk dan sekali tanpa petunjuk, lalu hasilnya dicampur dengan rasio tertentu supaya gambar lebih patuh pada petunjuk.
H3-Image memadatkan sampling menjadi 6 langkah lewat distilasi, dan tidak lagi membutuhkan CFG. Yang pertama memangkas jumlah langkah secara drastis, sedangkan yang kedua membuat setiap langkah cukup menjalankan satu kali forward pass. Untuk model dengan 33,1B parameter dan puluhan ribu token per gambar, gabungan keduanya inilah fondasi teknis di balik klaim resmi “4K dalam 10 detik”. Perlu diingat, 10 detik itu klaim dari pihak vendor. Kecepatan sebenarnya bergantung pada perangkat keras dan konfigurasi deployment.
Peningkatan Petunjuk: Mengubah Deskripsi Singkat Jadi Instruksi yang Siap Dieksekusi
H3-Image menyediakan model PE (Prompt Enhancement) opsional dengan bobot sekitar 17,9GB. Fungsinya mengembangkan deskripsi singkat dari pengguna menjadi petunjuk yang lebih rinci dan lebih mudah dipahami model. Kalau belum mau men-deploy model tambahan ini, kamu bisa memakai Model Bahasa Besar umum untuk pra-pemrosesan dengan ide yang serupa. Berikut contoh paling sederhana:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Menggunakan antarmuka terpadu APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "把这句扩写成详细的图像生成提示词:雨夜的赛博朋克街头"}]
)
print(resp.choices[0].message.content)
Lihat implementasi lengkap peningkatan petunjuk
import openai
from typing import List, Optional

SYSTEM_PROMPT = (
    "你是图像生成提示词工程师。请把用户的简短描述扩写为结构化提示词,"
    "依次包含:主体、构图、光线、材质细节、色彩、镜头与画幅。"
    "如果用户提供了参考图说明,请明确每张参考图在画面中的作用。"
    "只输出提示词正文,不要解释。"
)

def enhance_prompt(
    user_prompt: str,
    reference_notes: Optional[List[str]] = None,
    model: str = "gpt-4o-mini",
) -> str:
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    content = user_prompt
    if reference_notes:
        refs = "\n".join(f"参考图{i+1}:{n}" for i, n in enumerate(reference_notes))
        content = f"{user_prompt}\n\n{refs}"

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            max_tokens=600,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Contoh: komposisi ruang tamu dari ruangan kosong + gambar referensi furnitur
print(enhance_prompt(
    "把这些家具摆进空客厅,北欧风,午后自然光",
    ["空房间照片", "灰色布艺沙发", "橡木茶几", "落地灯"],
))
Saran: Saat menyusun alur kerja pembuatan gambar, untuk tahap pra-pemrosesan petunjuk kamu bisa mulai dengan menghubungkan beberapa Model Bahasa Besar populer lewat APIYI (apiyi.com), bandingkan hasil pengembangan petunjuk dari tiap model, baru putuskan apakah perlu men-deploy model PE khusus. Nama model mengikuti daftar model di platform.
Optimasi Deployment dan Dukungan Resolusi Tinggi
Framework deployment yang direkomendasikan secara resmi mencakup SGLang, vLLM-Omni, Diffusers, dan ComfyUI. Perangkat keras yang didukung antara lain NVIDIA H200, RTX PRO 6000 Blackwell, dan AMD Instinct MI350X, lengkap dengan solusi paralel multi-GPU. Rasio kompresi VAE gambar yang tinggi, sampling 6 langkah tanpa CFG, dan optimasi inferensi di level framework bekerja bersama-sama untuk mendukung keluaran langsung pada resolusi tinggi, seperti 16:9 (5472×3072), 9:16 (3072×5472), dan 21:9 (6272×2688).
Dampak Penggunaan Ulang Arsitektur MiniMax H3
Dampak bagi Developer
- Fondasi bersama, tetapi tidak bisa saling menggantikan: H3 dan H3-Image berbagi text encoder. Model card menyebutnya “shared H3 text encoder” (sekitar 66,7GB). Namun, bobot DiT dan VAE-nya terpisah, sehingga bobot video H3 tidak bisa langsung dipakai untuk menghasilkan gambar.
- Syarat deployment tetap tinggi: Model utama gambar berukuran sekitar 68,65GB. Ditambah text encoder, total unduhan lengkapnya sekitar 135,35GB. Angka ini baru kebutuhan penyimpanan, bukan kebutuhan VRAM.
- Lisensi harus dibaca terpisah: H3 dan H3-Image punya dua Community License yang berbeda, dengan kondisi pemicu yang cukup berbeda. Lihat tabel berikut.
| Aspek | MiniMax H3 | MiniMax H3-Image |
|---|---|---|
| Cakupan open source | Hanya H3-Base; Context-IR dan Regenerate-2K harus memakai API resmi | Bobot model gambar, text encoder bersama, dan model PE opsional |
| Hasil yang bisa didapat secara lokal | Pembuatan audio-video 768p; alur kerja 2K penuh bergantung pada API resmi | Menurut pihak resmi, bisa langsung menghasilkan gambar hingga sekitar 16MP |
| Pemicu lisensi komersial | Pendapatan tahunan produk dan layanan komersial di atas 20 juta dolar AS | Pendapatan tahunan Anda dan/atau afiliasi di atas 1 juta dolar AS, atau menyediakan layanan hosting kepada pihak ketiga mana pun |
| Kewajiban lainnya | Pembatasan wilayah dan lainnya, cek teks asli lisensi | Pembatasan wilayah, penggunaan output, penandaan produk, dan lainnya, cek teks asli lisensi |
Catatan perbandingan: Tabel di atas disusun dari teks asli kedua lisensi dan model card resmi, hanya sebagai referensi pemilihan teknologi dan bukan nasihat hukum. Kalau Anda belum punya kondisi untuk deployment mandiri atau belum memenuhi syarat lisensi, Anda bisa lebih dulu memanggil model gambar dan multimodal arus utama lainnya lewat APIYI (apiyi.com) untuk membuat prototipe alur kerja.
Dampak bagi Industri
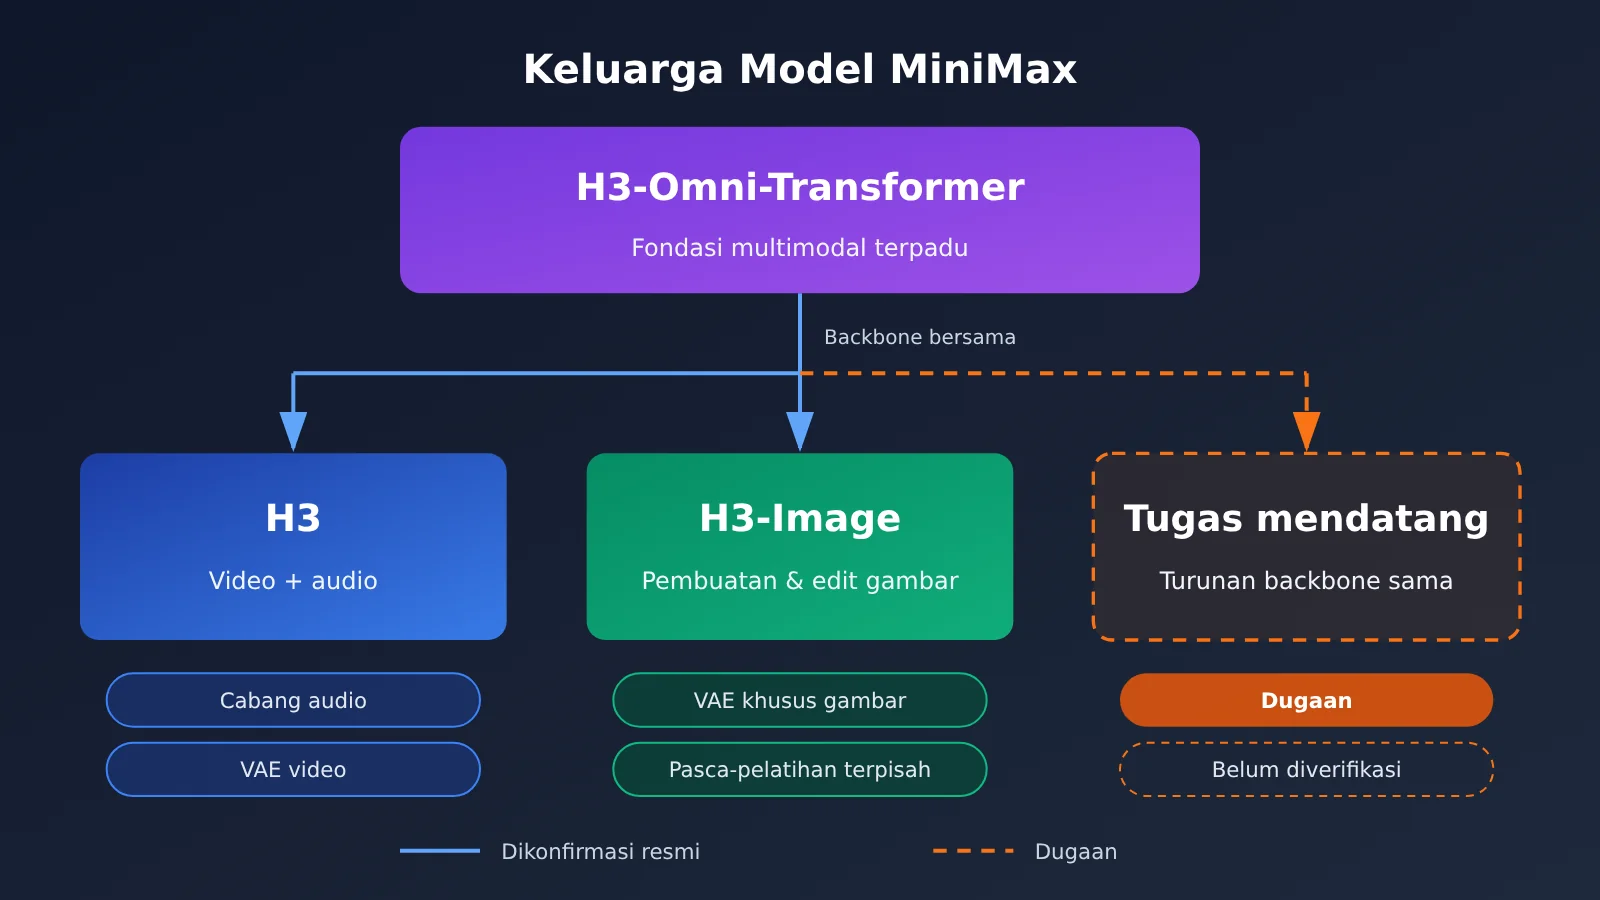
【Dikonfirmasi pihak resmi】 H3-Image memakai ulang Transformer inti dan text encoder dari H3, tetapi menggunakan VAE khusus dan proses post-training tersendiri.
【Inferensi kami】 Ini menunjukkan bahwa pembuatan video dan gambar bisa berbagi banyak kemampuan dasar, misalnya pemahaman semantik, penyelarasan multimodal, dan pemodelan posisi spasial. Meski begitu, setiap tugas tetap membutuhkan komponen encoder-decoder khusus serta pelatihan yang terarah. Jalur MiniMax tampaknya lebih mirip “membangun satu fondasi multimodal terpadu dulu, lalu mengkhususkannya sesuai tugas”, bukan melatih model dari nol untuk tiap jenis pembuatan. Kalau jalur ini berhasil, kemungkinan besar akan muncul lebih banyak model turunan yang memakai backbone yang sama. Tapi untuk saat ini, itu baru spekulasi industri.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apakah H3-Image hanya model video H3 yang dialihkan ke output gambar?
Bukan. H3-Image memang mewarisi enkoder teks Qwen3-VL, arsitektur DiT single-stream 33,1B, dan 3D RoPE dari H3. Namun cabang audionya dihapus, lalu VAE-nya diganti dengan VAE khusus gambar yang memakai enkoder CNN dan dekoder 2D ViT. Data, reinforcement learning, dan distilasi pada tahap pasca-pelatihan juga dilakukan secara terpisah.
Q2: Mengapa jumlah parameter MiniMax H3 dan H3-Image hampir sama?
Karena inti Transformer keduanya berasal dari arsitektur yang sama. H3 sekitar 33B, sedangkan DiT milik H3-Image 33,1B. Jumlah parameter yang berdekatan menunjukkan bahwa jaringan utamanya dipertahankan secara utuh. Perbedaannya terutama ada pada komponen encoder/decoder dan tujuan pelatihan.
Q3: Sebenarnya berapa banyak gambar referensi yang didukung H3-Image?
Model card resmi menyebut batas atas 16 gambar, sementara resep deployment vLLM menuliskan maksimal 9 gambar. Angka pertama adalah klaim dari vendor, sedangkan angka kedua adalah konfigurasi uji untuk framework tertentu. Dalam pemakaian nyata, ikuti batas dari framework inferensi yang Anda pilih.
Q4: Apakah sampling 6 langkah dan penghapusan CFG memengaruhi kualitas gambar?
Menurut pihak resmi, kualitas output tetap tinggi setelah distilasi. Namun yang tersedia untuk publik saat ini sebagian besar masih berupa demo dari vendor sendiri. Sebaiknya lakukan uji perbandingan pada skenario Anda sendiri, terutama untuk kepatuhan terhadap instruksi yang kompleks dan kombinasi beberapa gambar referensi.
Q5: Bagaimana cara memvalidasi alur kerja pembuatan gambar kalau tidak punya GPU kelas H200?
Anda bisa menjalankan alur kerjanya lebih dulu lewat API cloud:
1. Daftar di APIYI (apiyi.com), lalu dapatkan kunci API beserta kuota uji coba gratis
2. Gunakan kode peningkatan petunjuk dari artikel ini (base_url-nya `https://api.apiyi.com/v1`) untuk menyiapkan tahap prapemrosesan
3. Sambungkan ke model gambar populer yang sudah tersedia di platform, lalu pastikan seluruh alurnya berjalan sebelum menimbang apakah perlu deployment mandiri
Q6: Bolehkah H3-Image di-deploy lalu dijadikan layanan API untuk pihak luar?
Perlu sangat berhati-hati. Berdasarkan lisensi H3-Image, menyediakan layanan hosting kepada pihak ketiga mana pun memerlukan izin tertulis dari MiniMax terlebih dahulu, terlepas dari besar pendapatan. Untuk ketentuan lengkapnya, rujuklah teks asli lisensi, dan bila perlu konsultasikan dengan penasihat hukum.
Poin Penting Evolusi Arsitektur MiniMax H3 (Key Takeaways)
- Satu fondasi, fungsi berbeda: H3-Image memakai ulang Transformer inti dan encoder teks dari H3, jadi bukan sekadar berpindah mode keluaran.
- Tiga perubahan kunci: cabang audio dibuang, VAE diganti dengan yang khusus gambar, dan target pembuatan diubah menjadi memprediksi laten gambar.
- Pemahaman semantik berasal dari Qwen3-VL: mengambil hidden state lapisan ke-50, sehingga model bisa memahami teks sekaligus gambar referensi.
- Kecepatan berasal dari distilasi: sampling 6 langkah tanpa CFG menjadi dasar teknis klaim resmi “4K dalam 10 detik”.
- Lisensi perlu dilihat terpisah: layanan hosting H3-Image dan ambang pendapatan 1 juta dolar AS sama-sama dapat memicu kewajiban otorisasi.
- Validasi dulu sebelum deploy: Anda bisa membuat prototipe dengan banyak model lewat APIYI (apiyi.com), lalu menghitung biaya hosting mandiri.
Kesimpulan
Evolusi MiniMax H3 dari video ke gambar pada intinya bisa diringkas menjadi tiga hal:
- Fondasi bersama: Transformer multimodal single-stream kelas 33B, encoder teks Qwen3-VL, dan 3D RoPE dipertahankan sepenuhnya.
- Spesialisasi tugas: Cabang audio dihapus dan diganti dengan VAE gambar berbasis CNN + 2D ViT. Target pembuatan berubah dari laten video+audio menjadi laten gambar.
- Pelatihan dan inferensi dibuat ulang: Data, reinforcement learning, distilasi 6 langkah tanpa CFG, penyempurnaan petunjuk, dan optimasi deployment bersama-sama mendukung keluaran kelas 16MP.
Bagi developer, yang paling layak dipelajari adalah “kemampuan mana yang bisa dibagi dan mana yang harus dilatih khusus”, serta biaya perangkat keras dan kewajiban lisensi di balik bobot modelnya. Sebelum memutuskan untuk hosting mandiri, sebaiknya bandingkan beberapa model lewat satu antarmuka terpadu di APIYI (apiyi.com) agar alur kerja gambar Anda bisa cepat berjalan.
📚 Referensi
- Pengantar Teknis Resmi MiniMax H3: Penjelasan arsitektur H3-Omni-Transformer
- Tautan:
minimax.io/blog/minimax-h3 -
Keterangan: Deskripsi resmi tentang jalur encoding multimodal dan 3D Multimodal RoPE
-
Blog Rilis Resmi MiniMax H3-Image: Pasca-pelatihan dan optimasi inferensi
- Tautan:
minimax.io/blog/minimax-h3-image -
Keterangan: Peningkatan pada data, reinforcement learning, distilasi 6 langkah, penyempurnaan petunjuk, dan lainnya
-
Model Card H3-Image di Hugging Face: Parameter arsitektur lengkap
- Tautan:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Keterangan: Spesifikasi detail DiT, VAE, dan text encoder
-
Model Card Asli dan Lisensi H3: Spesifikasi model video dan ketentuan lisensi
- Tautan:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Keterangan: Spesifikasi H3 serta teks asli lisensi di
blob/main/LICENSE -
Teks Asli Lisensi H3-Image: Syarat lisensi komersial
- Tautan:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Keterangan: Ketentuan seperti layanan hosting dan ambang batas pendapatan
-
Resep Deployment vLLM: Konfigurasi pengujian framework
- Tautan:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image - Keterangan: Acuan dari sisi framework, seperti jumlah gambar referensi
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami di beranda APIYI apiyi.com, dan kunjungi pusat dokumentasi docs.apiyi.com untuk materi lebih lengkap