Catatan penulis: Berangkat dari tinjauan ulang eksperimen Astra yang mengubah bobot Qwen3.5-0.8B, artikel ini menjelaskan perbedaan antara “jawaban salah” dan “jawaban belum selesai” dalam evaluasi model penalaran, serta cara memisahkan hasil berdasarkan status pemotongan.
Pada 2 November, empat peneliti MIT CSAIL menerbitkan artikel blog berjudul Sparks of Weight-Space Programming. Artikel itu menyebutkan bahwa GPT-6 Astra hanya mengubah sekitar 0.016% parameter Qwen3.5-0.8B, tetapi skor MATH-500 naik dari 7.9% menjadi 48.1%. Skor GSM8K dan IFEval juga meningkat tajam. Kabar ini pun banyak dibagikan sebagai peristiwa penting ketika “AI mengubah otak AI”.
Ini bukan upaya untuk menolak penelitian tersebut. Repositori publik penelitian itu memuat log per putaran dari 1,125 pemanggilan. Setelah menghitung ulang berdasarkan catatan tiap soal, tinjauan media menghasilkan kesimpulan yang lebih sederhana: kenaikan skor hampir seluruhnya berasal dari “model akhirnya bisa menyelesaikan jawabannya”, bukan karena “model menjadi lebih mahir mengerjakan soal matematika”.
Nilai utama: Artikel ini tidak mengulang perdebatan tentang apakah RSI benar-benar terjadi. Kami merangkum tinjauan tersebut menjadi metode evaluasi model penalaran yang bisa digunakan kembali, untuk membantu Anda menilai saat memilih model, menyetel parameter, atau sebelum peluncuran: apakah perubahan skor berasal dari perbedaan kemampuan atau dari pemotongan akibat pengulangan.
Ringkasan fakta utama evaluasi model penalaran
Berikut fakta-fakta penting terkait evaluasi dalam kasus ini. Semua data berasal dari blog asli dan ulasan media terhadap repositori publik.
| Informasi | Detail |
|---|---|
| Waktu publikasi | 2 November 2026, blog peneliti MIT CSAIL |
| Model yang dimodifikasi | Qwen3.5-0.8B, dengan 131.072 bobot yang diubah, sekitar 0,016% |
| Hasil yang diklaim | MATH-500 7,9%→48,1%; GSM8K 13,8%→67,1%; IFEval 21,0%→62,3% |
| Pengaturan evaluasi | Mode penalaran aktif, batas keluaran 32.768 token, temperatur 0,6 |
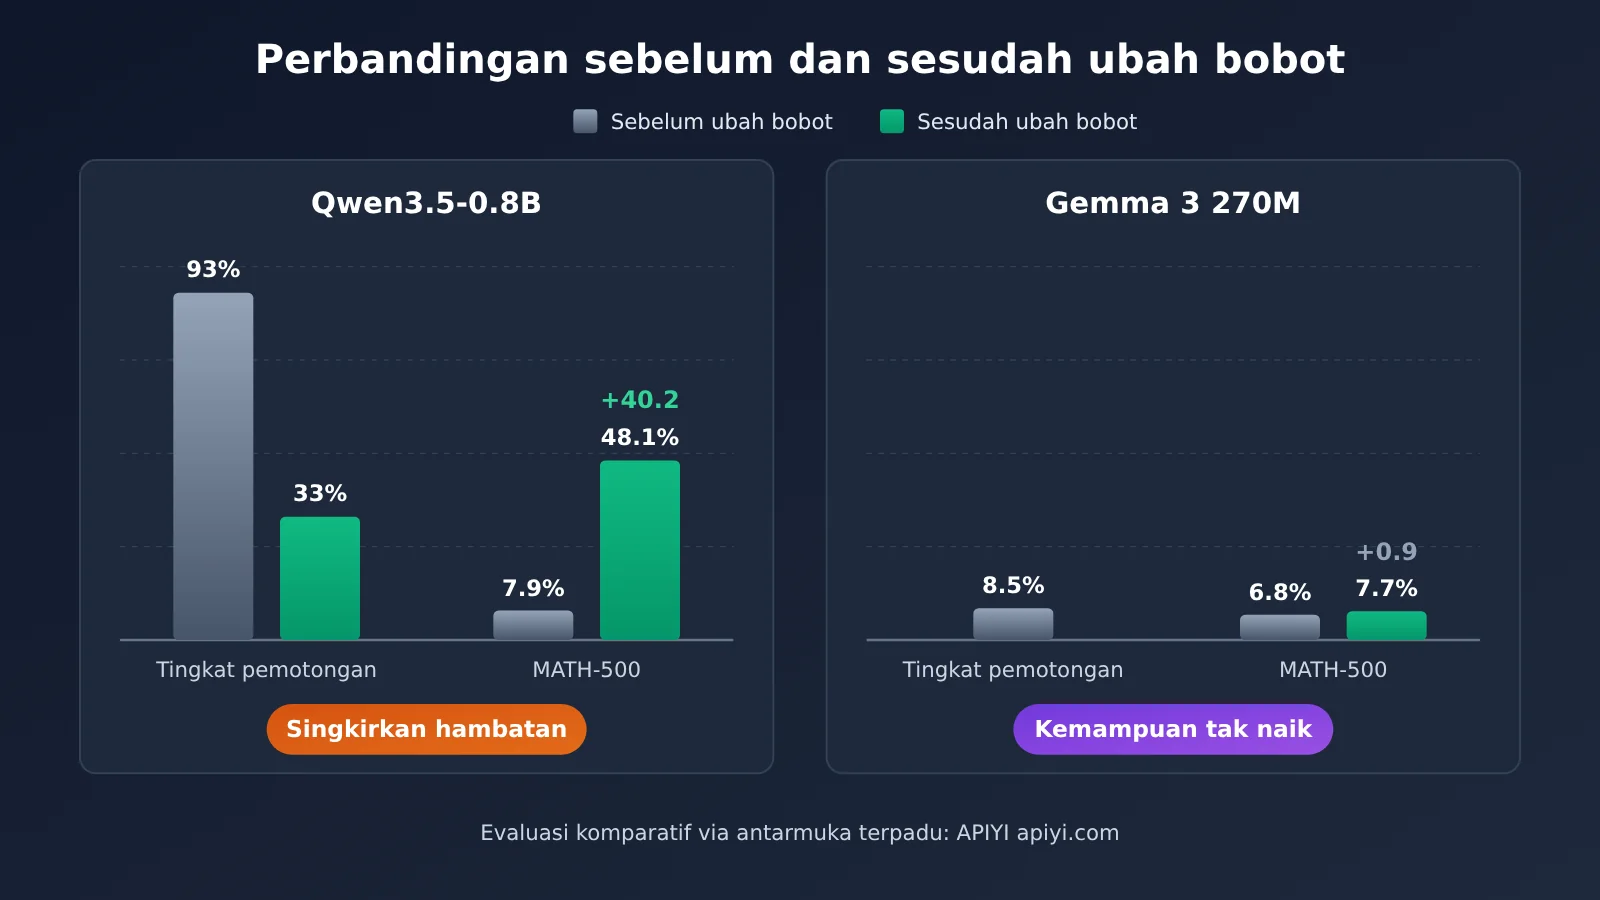
| Kondisi baseline | Sekitar 93% jawaban mencapai batas tanpa berhenti |
| Kondisi setelah modifikasi | Persentase jawaban yang mencapai batas turun dari 93% menjadi 33% |
| Kesimpulan ulasan | Patch terutama memperbaiki loop pengulangan, bukan meningkatkan kemampuan matematika |
Dari mana asal “pemotongan” dalam evaluasi model penalaran?
Saat pertama kali diminta mengerjakan 96 soal latihan dengan Qwen, Astra hanya menjawab benar 11 soal. Sebanyak 85 soal sisanya bukan salah hitung, melainkan semuanya mencapai batas panjang keluaran tanpa berhenti. Jika bagian akhir teks yang terpotong dihitung dalam potongan delapan kata, sekitar 95% isinya merupakan pengulangan. Sementara itu, 11 soal yang selesai secara normal semuanya dijawab dengan benar.
Ini menunjukkan bahwa penyebab utama rendahnya skor baseline adalah model “tidak bisa menyerahkan jawaban”, bukan “tidak bisa mengerjakan soal”. Menariknya, petunjuk putaran pertama yang diberikan peneliti kepada Astra sudah menyebut “terpotong oleh batas token, sering kali karena mengulang pemikirannya sendiri” sebagai salah satu jenis kegagalan. Petunjuk itu juga memberikan contoh perbaikan yang efektif: “memperbaiki hal yang memicu pengulangan”. Laporan akhir Astra pun menyatakan bahwa sasarannya adalah pengulangan, bukan pengetahuan matematika.
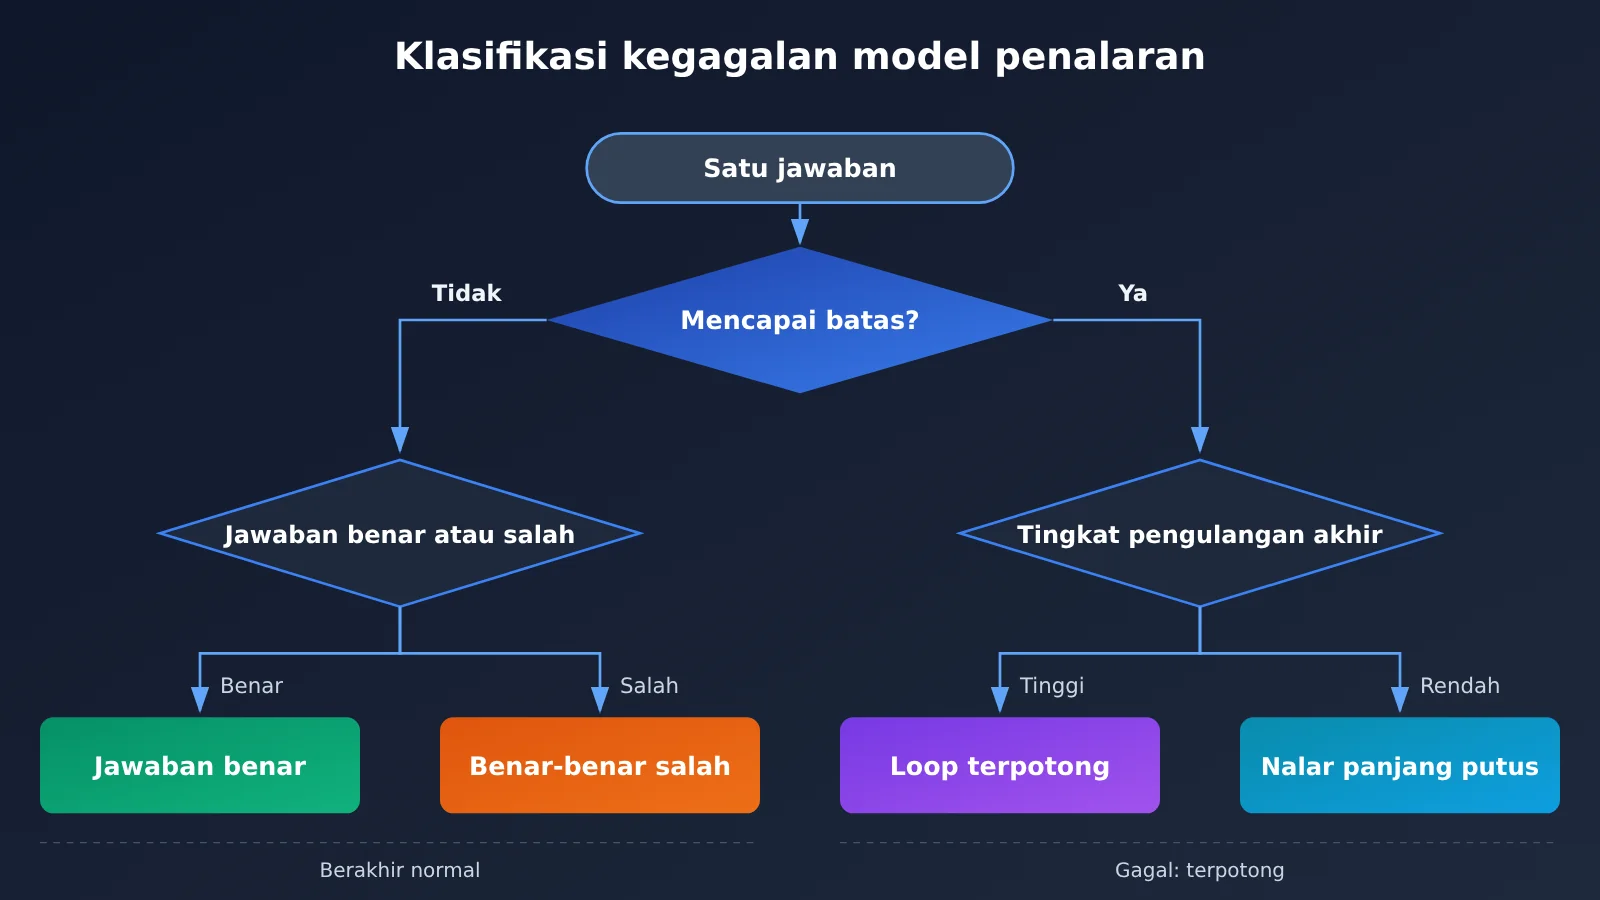
Rincian data evaluasi model penalaran: seluruh kenaikan berasal dari soal yang jawabannya terpotong
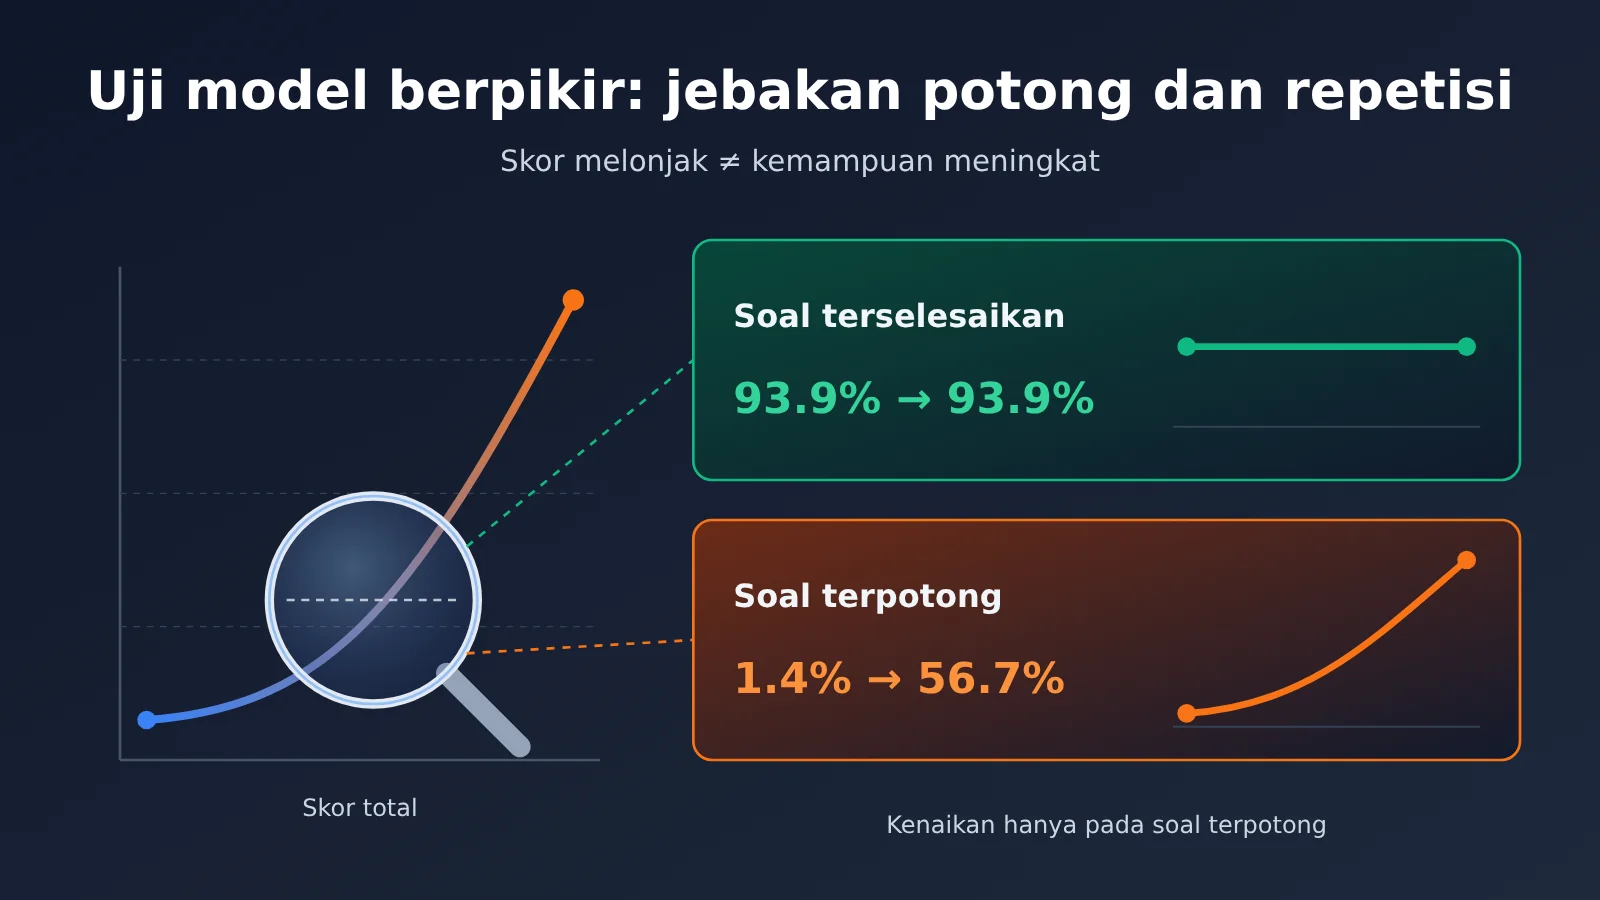
Bukti paling meyakinkan dalam tinjauan ini adalah pengujian berpasangan sebelum dan sesudah perubahan pada 1.152 soal latihan yang disisihkan. Ketika soal dibagi berdasarkan apakah jawabannya semula terpotong atau tidak, hasilnya sangat jelas.
| Kelompok soal | Jumlah soal | Akurasi sebelum perubahan | Akurasi setelah perubahan | Perubahan |
|---|---|---|---|---|
| Soal yang semula selesai dijawab | 114 | 93.9% | 93.9% | Tidak berubah |
| Soal yang jawabannya semula terpotong | 1,038 | 1.4% | 56.7% | Sumber seluruh kenaikan |
| Berubah dari salah menjadi benar | 579 | — | — | 576 di antaranya semula terpotong |
| Berubah dari benar menjadi salah | 5 | — | — | Dalam kisaran noise |
Ada detail lain yang mudah terlewat: sebelum perubahan, hanya 7 soal yang selesai dijawab tetapi salah. Setelah perubahan, jumlahnya menjadi 245. Begitu pengulangan berhenti, kesalahan perhitungan model yang sebenarnya mulai terlihat. Pada MATH-500 resmi, panjang rata-rata jawaban turun dari 30,868 token menjadi 22,037 token. Penurunan ini juga terkonsentrasi pada jawaban yang semula mencapai batas.
Memvalidasi kesimpulan evaluasi dengan model pembanding
Para peneliti juga menyadari hal ini, sehingga mereka melakukan eksperimen yang sama pada Gemma 3 270M. Perbandingan kedua eksperimen ini menunjukkan bahwa “menyingkirkan hambatan” dan “menambah kemampuan” adalah dua hal yang berbeda.
| Aspek perbandingan | Qwen3.5-0.8B | Gemma 3 270M |
|---|---|---|
| Persentase jawaban yang mencapai batas | Sekitar 93% | Sekitar 8.5% |
| Jenis kegagalan utama | Pengulangan terus-menerus, jawaban tidak selesai | Kesalahan aritmetika, langkah penalaran tidak valid |
| MATH-500 setelah perubahan bobot | 7.9%→48.1% | 6.8%→maksimal 7.7% |
| Sifat perbaikan | Menyingkirkan hambatan yang menutupi kemampuan | Hampir tidak bisa menambahkan kemampuan yang sebelumnya tidak ada |
Artikel blog aslinya juga mengakui bahwa perubahan bobot dapat menyingkirkan hambatan yang menutupi kemampuan, tetapi tidak bisa menambahkan kemampuan yang tidak dimiliki model. Bagi evaluator, artinya adalah: “kenaikan skor yang besar” bisa memiliki makna yang sama sekali berbeda, bergantung pada pola kegagalannya.
Jebakan parameter dalam evaluasi model berpikir: suhu dan mode berpikir
Ada satu hal yang sering luput dalam perdebatan ini: pengaturan evaluasi itu sendiri dapat memicu model mengulang-ulang respons. Informasi dari model card resmi Qwen3.5-0.8B yang dikutip dalam ulasan berbeda dari pengaturan yang digunakan peneliti.
| Parameter | Keterangan model card | Pengaturan eksperimen | Dampak |
|---|---|---|---|
| Mode berpikir | Pada 0.8B, mode ini dinonaktifkan secara default | Dipaksa aktif | Model kecil lebih mudah terjebak dalam perulangan proses berpikir |
| Suhu (tugas teks dalam mode berpikir) | Direkomendasikan 1.0 | 0.6 | Dalam model card, 0.6 ditujukan untuk tugas memahami gambar dan menulis kode |
| Saran penanganan perulangan | Sesuaikan parameter sampling dan hentikan output streaming tepat waktu | Dibiarkan berjalan hingga batas 32.768 token | Banyak jawaban dinilai gagal |
Perlu dicatat, isi model card di atas bersumber dari kutipan dalam ulasan media. Sebelum melakukan evaluasi, sebaiknya periksa langsung model card resmi Qwen. Yang perlu ditekankan di sini adalah metodenya: pada model yang sama, perubahan parameter sampling dapat menghasilkan “baseline” yang sama sekali berbeda. Jika baseline diukur dengan pengaturan yang mudah memicu perulangan, perubahan apa pun yang membuat model “bisa berhenti” akan tampak seperti lompatan kemampuan.
Daftar periksa evaluasi model penalaran: pisahkan jawaban terpotong sebelum menarik kesimpulan
Dari pelajaran yang didapat dalam tinjauan ini, kita bisa menyusun proses evaluasi yang berlaku untuk model penalaran apa pun. Baik saat memilih model, menyetel parameter, maupun menguji perubahan pada fine-tuning atau petunjuk, gunakan tabel berikut sebagai panduan.
| Aspek pemeriksaan | Cara melakukannya | Indikator |
|---|---|---|
| 1. Pisahkan berdasarkan pemotongan | Hitung persentase finish_reason == "length", lalu hitung akurasi tiap kelompok |
Jika tingkat pemotongan di atas 10%, skor keseluruhan tidak bisa langsung dibandingkan |
| 2. Periksa tingkat pengulangan | Hitung pengulangan n-gram di bagian akhir jawaban yang terpotong | Tingkat pengulangan yang tinggi menunjukkan adanya loop, bukan proses penalaran yang terlalu panjang |
| 3. Periksa parameter sampling | Cocokkan temperature, top_p, dan pengaturan penalaran dengan model card | Jika tidak sesuai dengan rekomendasi resmi, cantumkan secara terpisah |
| 4. Bandingkan secara berpasangan | Bandingkan setiap soal sebelum dan sesudah perubahan; hitung jawaban yang berubah dari salah menjadi benar dan sebaliknya | Jika peningkatan terkonsentrasi pada kelompok yang terpotong, artinya perubahan tersebut hanya “menyingkirkan hambatan” |
| 5. Bandingkan dengan model lain | Tambahkan model pembanding dengan tingkat pemotongan rendah menggunakan petunjuk dan parameter yang sama | Jika skor model pembanding tidak naik, peningkatan tersebut bukan berasal dari peningkatan kemampuan |
🎯 Saran evaluasi: Saat membandingkan model, bagian yang paling merepotkan adalah menulis kode pemanggilan terpisah untuk setiap penyedia. Melalui antarmuka kompatibel OpenAI dari APIYI apiyi.com, Anda bisa memanggil berbagai model populer dengan satu skrip serta petunjuk dan parameter yang sama. Ini memudahkan Anda mencantumkan “tingkat pemotongan” sebagai kolom statistik tetap.
Skrip evaluasi model penalaran: contoh minimalis
Kode berikut menghitung proporsi soal yang responsnya terpotong karena batas panjang. Nilai finish_reason berupa length menandakan respons telah mencapai max_tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

questions = ["计算 17 * 23 的结果", "求 1 到 100 的整数和"]
truncated = 0
for q in questions:
    r = client.chat.completions.create(
        model="your-thinking-model",  # Ganti dengan nama model yang sebenarnya
        messages=[{"role": "user", "content": q}],
        max_tokens=4096,
    )
    if r.choices[0].finish_reason == "length":
        truncated += 1
print(f"截断率: {truncated / len(questions):.1%}")
Lihat kode implementasi lengkap (termasuk tingkat jawaban benar per kelompok dan tingkat pengulangan di akhir teks)
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def tail_repetition_ratio(text: str, n: int = 8, tail_words: int = 400) -> float:
    """Hitung proporsi pengulangan n-gram di akhir teks (teks Tionghoa dapat dipisahkan berdasarkan karakter)"""
    words = text.split()[-tail_words:]
    if len(words) < n * 2:
        return 0.0
    grams = [tuple(words[i:i + n]) for i in range(len(words) - n + 1)]
    counts = Counter(grams)
    repeated = sum(c for c in counts.values() if c > 1)
    return repeated / len(grams)

def evaluate(dataset, model, temperature, max_tokens, judge):
    """dataset: [(question, answer)], judge: fungsi untuk menentukan apakah jawaban benar"""
    stats = {"done": [0, 0], "truncated": [0, 0], "loop": 0}
    for q, ans in dataset:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": q}],
            temperature=temperature,
            max_tokens=max_tokens,
        )
        choice = r.choices[0]
        text = choice.message.content or ""
        group = "truncated" if choice.finish_reason == "length" else "done"
        stats[group][0] += 1
        stats[group][1] += int(judge(text, ans))
        if group == "truncated" and tail_repetition_ratio(text) > 0.5:
            stats["loop"] += 1

    for g in ("done", "truncated"):
        total, correct = stats[g]
        rate = correct / total if total else 0
        print(f"{g}: {total} 题,正确率 {rate:.1%}")
    t = stats["truncated"][0]
    print(f"截断题中疑似循环: {stats['loop']} / {t}")
    return stats
Perlu diingat, parameter untuk mengaktifkan atau menonaktifkan mode penalaran berbeda-beda antar model. Ada yang dikendalikan melalui field permintaan, dibedakan berdasarkan nama model, atau ditulis dalam templat petunjuk. Apakah isi penalaran dihitung dalam max_tokens dan dikembalikan secara terpisah juga bergantung pada model. Pastikan untuk memeriksa dokumentasi masing-masing sebelum melakukan evaluasi.
🚀 Mulai cepat: Jika hanya ingin menguji metode pengelompokan ini terlebih dahulu, daftar di APIYI apiyi.com dan gunakan kuota uji coba gratis. Pilih dua atau tiga model penalaran, jalankan beberapa puluh soal, lalu bandingkan tingkat respons yang terpotong sebelum memutuskan apakah perlu memperluas evaluasi.
Analisis Dampak Insiden Evaluasi Model Berpikir
Dampak bagi Developer
- Skor total tidak lagi bisa diandalkan: Jika hanya melihat tingkat jawaban benar secara keseluruhan, jawaban yang “belum selesai” akan tercampur dengan jawaban yang “salah”. Laporan evaluasi sebelum peluncuran setidaknya perlu mencantumkan kolom tingkat pemotongan dan tingkat jawaban benar per kelompok.
- Manfaat penyesuaian parameter bisa disalahartikan: Menaikkan batas output, menyesuaikan temperature, atau menambahkan penalti pengulangan dapat meningkatkan skor secara signifikan. Namun, ini hanya “menyingkirkan hambatan”, bukan berarti modelnya berubah.
- Lingkungan produksi juga terdampak: Pemotongan yang terjadi saat evaluasi dapat muncul di lingkungan produksi sebagai respons yang terlalu panjang, biaya yang tak terkendali, dan waktu tunggu pengguna yang lama. Kartu model sendiri menyarankan output streaming yang dipadukan dengan deteksi pengulangan dan pemotongan dini.
Dampak bagi Penelitian Evaluasi Model
- Klaim “peningkatan besar” perlu diuraikan buktinya: Tinjauan ini menunjukkan bahwa hasil yang tampak seperti lompatan kemampuan mungkin hanya berasal dari perbaikan bug setelah dianalisis berdasarkan pemotongan. Ke depannya, setiap klaim peningkatan pada model kecil atau model berpikir perlu disertai pertanyaan tentang perubahan tingkat pemotongan.
- Desain kelompok kontrol semakin penting: Eksperimen tambahan pada Gemma 3 270M dan kontrol dengan arah acak yang dilakukan Astra sendiri, yang hanya mengubah skor sekitar 1,5 poin persentase, menunjukkan bahwa desain kontrol adalah kunci untuk membedakan sinyal nyata dari noise.
Pertanyaan Umum (FAQ)
Q1: Apa itu “jebakan pemotongan” dalam evaluasi model penalaran?
Ini terjadi ketika model terjebak dalam pengulangan saat berpikir, terus menulis hingga mencapai batas token tanpa memberikan jawaban, lalu dinilai salah oleh sistem evaluasi. Dalam kasus ini, skor rendah menunjukkan bahwa model “belum selesai”, bukan “tidak mampu menjawab”.
Q2: Bagaimana membedakan skor rendah akibat pemotongan dari skor rendah akibat keterbatasan kemampuan?
Bagi soal menjadi dua kelompok berdasarkan apakah model mencapai batas token, lalu hitung akurasi masing-masing. Jika akurasi soal yang selesai tinggi tetapi kelompok yang terpotong mendekati nol, masalahnya ada pada pengulangan. Jika soal yang selesai pun banyak yang salah, barulah itu menunjukkan keterbatasan kemampuan. Perbandingan Qwen dan Gemma menunjukkan kedua situasi ini.
Q3: Kapan eksperimen Astra yang memodifikasi Qwen ini dipublikasikan?
Blog aslinya diterbitkan pada 2 November 2026, sedangkan artikel ulasan media berdasarkan log repositori publik diterbitkan pada 5 November. Data dalam artikel ini mengacu pada ulasan tersebut. Untuk detail kartu model, sebaiknya periksa tulisan resmi Qwen.
Q4: Metode evaluasi ini cocok untuk skenario apa saja?
– **Pemilihan model**: membandingkan performa berbagai model penalaran pada tugas matematika atau kode
– **Penyesuaian parameter**: menilai dampak nyata perubahan temperature, batas token, dan pengaturan penalaran
– **Validasi peningkatan**: menentukan apakah fine-tuning, petunjuk, atau pengeditan bobot meningkatkan kemampuan atau hanya menghilangkan hambatan
Q5: Bagaimana mengevaluasi beberapa model penalaran secara berdampingan melalui antarmuka terpadu?
1. Daftar akun di APIYI apiyi.com dan dapatkan kunci API
2. Atur base_url skrip dalam artikel ini menjadi `https://api.apiyi.com/v1`
3. Gunakan petunjuk, temperature, dan max_tokens yang sama, lalu ganti nama model saja. Tampilkan tingkat pemotongan dan akurasi setiap kelompok
Cara mengaktifkan penalaran berbeda pada setiap model, jadi parameter permintaan perlu disesuaikan dengan dokumentasi masing-masing.
Q6: Apa keterbatasan metode pemisahan ini?
Pemisahan berdasarkan pemotongan hanya dapat mengidentifikasi jawaban yang “belum selesai”, bukan memastikan apakah jawaban yang selesai benar karena kebetulan. Ambang tingkat pengulangan di bagian akhir perlu disesuaikan dengan bahasa dan tugas; untuk teks Mandarin, sebaiknya pisahkan berdasarkan karakter, bukan spasi. Selain itu, sebagian model tidak mengembalikan konten penalaran secara lengkap, sehingga perlu memeriksa statistik token dalam usage. Jika anggaran terbatas, Anda bisa mencoba sampel kecil terlebih dahulu di APIYI apiyi.com, lalu memperbesar skala setelah memastikan metode perhitungannya.
Poin Penting Evaluasi Model Penalaran
- Sumber kenaikan: Tingkat akurasi pada 114 soal yang diselesaikan Qwen tetap 93,9% sebelum dan sesudah perubahan. Seluruh kenaikan berasal dari soal dengan jawaban yang terpotong.
- Jenis kegagalan: Pada pengujian awal, 93% jawaban mencapai batas output, dan sekitar 95% bagian akhir jawaban berisi pengulangan.
- Perbedaan parameter: Suhu evaluasi 0,6 berbeda dari suhu 1,0 yang direkomendasikan kartu model untuk teks penalaran.
- Bukti pembanding: Gemma 3 270M memiliki tingkat pemotongan rendah. Setelah bobotnya diubah, skor MATH-500 naik kurang dari 1 poin persentase.
- Inti metode: Kelompokkan jawaban yang terpotong berdasarkan
finish_reason, lalu bandingkan tingkat akurasinya. - Cara memulai: Gunakan antarmuka terpadu APIYI apiyi.com untuk menghitung tingkat pemotongan pada beberapa model dengan parameter yang sama.
Kesimpulan
Kontroversi “Astra mengubah bobot Qwen” ini menjadi pengingat bagi siapa pun yang mengevaluasi model penalaran:
- Uraikan dulu lonjakan skor: Kelompokkan hasil berdasarkan apakah jawaban mencapai batas token, lalu lihat dari kelompok mana kenaikannya berasal.
- Parameter adalah bagian dari baseline: Suhu, pengaturan penalaran, dan batas output harus diperiksa terhadap kartu model dan dicantumkan dalam laporan.
- Bedakan menyingkirkan hambatan dari meningkatkan kemampuan: Gunakan model pembanding dengan tingkat pemotongan rendah untuk memastikan apa yang sebenarnya membaik.
Lain kali saat melihat klaim bahwa “suatu perubahan melipatgandakan skor”, tanyakan dulu: seberapa besar tingkat pemotongannya berubah? Pertanyaan ini sering kali lebih menjelaskan keadaan sebenarnya daripada skor total.
Jika kamu sedang bersiap mengevaluasi beberapa model penalaran sebelum diluncurkan, coba gunakan APIYI apiyi.com untuk menghitung tingkat pemotongan dengan skrip dan parameter yang sama sebelum menentukan model pilihan.
📚 Referensi
- Artikel ulasan SiliconStar Pro (diterbitkan ulang oleh 36Kr): Kehebohan tentang “Astra memodifikasi otak Qwen” tidak banyak berkaitan dengan RSI yang kita inginkan
- Tautan:
36kr.com/p/4056494372181124 -
Keterangan: Data uji berpasangan yang dihitung ulang berdasarkan catatan setiap soal di repositori publik; sumber data utama artikel ini
-
Blog peneliti MIT CSAIL: Sparks of Weight-Space Programming
-
Keterangan: Deskripsi asli eksperimen dan tabel hasil. Sebaiknya baca pengaturan eksperimen 8 dengan mengacu pada sumber aslinya
-
Kartu model resmi Qwen3.5-0.8B: Penjelasan parameter sampling dan mode berpikir
- Keterangan: Untuk memeriksa status bawaan mode berpikir, suhu yang disarankan, dan saran penanganan loop
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui situs resmi APIYI di apiyi.com. Panduan pemanggilan selengkapnya tersedia di pusat dokumentasi docs.apiyi.com