Catatan penulis: Setelah model baru dirilis, bagaimana cara memvalidasi dengan tugas jangka panjang Anda sendiri apakah model tersebut layak untuk diganti? Artikel ini memecah pertanyaan itu menjadi alur kerja 5 langkah yang dapat dieksekusi.
Model baru hampir setiap bulan dirilis, dan papan skor benchmark juga terus diperbarui. Ambil contoh Tencent Hunyuan Hy4 yang resmi dirilis pada November 2026 — pihak resmi menyatakan bahwa dibandingkan versi preview, model ini telah dioptimalkan secara khusus pada kemampuan Agent dan tugas jangka panjang, serta masuk ke jajaran teratas model open-source di beberapa Benchmark. Namun bagi developer, sebenarnya hanya ada satu pertanyaan: apakah model ini lebih baik pada tugas saya dibandingkan model yang saya gunakan sekarang? Artikel ini memperkenalkan metode validasi komparatif model baru berbasis tugas jangka panjang milik Anda sendiri, yang membantu Anda menghasilkan kesimpulan berbasis data dalam satu atau dua hari.
Ini bukan sekadar artikel interpretasi skor benchmark lainnya. Peringkat mengukur kemampuan umum, sedangkan bisnis Anda mengukur: apakah model bisa menyelesaikan sesuatu yang multi-langkah dari awal hingga akhir, apakah bisa memperbaiki dirinya sendiri setelah terjadi kesalahan, dan berapa biaya yang dikeluarkan untuk setiap penyelesaian.
Nilai inti: Setelah membaca artikel ini, Anda akan belajar membangun set validasi tugas jangka panjang yang kecil namun akurat, membandingkan model baru dan lama menggunakan 6 metrik, serta menghitung “biaya per pengiriman yang berhasil” berdasarkan penagihan aktual, lalu membuat keputusan untuk beralih atau tidak.
Poin Kunci Validasi Tugas Jangka Panjang untuk Model Baru
Sebelum mulai, pahami dulu perbedaan antara validasi tugas jangka panjang dan pengujian satu putaran biasa. Pengujian satu putaran menilai “apakah satu jawaban terlihat bagus”, sedangkan validasi tugas jangka panjang menilai “apakah tujuan masih terjaga setelah puluhan langkah berturut-turut”.
| Poin | Penjelasan | Nilai |
|---|---|---|
| Gunakan tugas Anda sendiri | Ambil 3-5 tugas multi-langkah dari bisnis nyata, bukan soal publik | Kesimpulan langsung berkaitan dengan manfaat bisnis |
| Tetapkan kelompok kontrol | Model yang sedang dipakai dan model baru dijalankan pada tugas yang sama dengan rantai alat yang sama | Menghilangkan perbedaan petunjuk dan lingkungan |
| Prioritaskan metrik proses | Catat pemeliharaan tujuan, koreksi diri, dan jumlah intervensi manual | Menemukan masalah stabilitas yang tidak terlihat dari skor |
| Hitung biaya per hasil | Hitung biaya token dengan satuan “setiap pengiriman yang berhasil” | Menghindari kesalahan penilaian karena hanya melihat harga satuan |
| Tetapkan ambang pergantian model | Tulis lebih dulu standar “seberapa besar peningkatan agar layak berganti model” | Mencegah terbawa oleh satu kasus yang mengesankan |
Mengapa validasi tugas jangka panjang lebih andal daripada skor benchmark
Soal pada papan peringkat publik biasanya tertutup dan berantai pendek, sedangkan pekerjaan Agent yang sebenarnya justru sebaliknya. Dalam evaluasi referensi, salah satu tugas jangka panjang untuk Hy4 menuntut mulai dari riset, pengembangan, peninjauan, perbaikan, hingga menjadi game 3D yang bisa dimainkan, di tengahnya ditambahkan video referensi dan kebutuhan baru. Tugas seperti ini menguji apakah model, saat langkah terus bertambah, masih mengingat rencana awal, membedakan hal yang sudah dan belum selesai, serta menyesuaikan rencana ketika hasil antara tidak sesuai harapan.
Fenomena lain yang patut diperhatikan adalah efek sinergi “model + rantai alat”. Dalam evaluasi yang sama, Hy4 di WorkBuddy menghasilkan 14 PPT, satu Excel, dan satu dokumen Word 19 halaman dalam waktu setengah jam. Evaluator juga secara eksplisit menyatakan bahwa model bertanggung jawab untuk memahami, merencanakan, dan menilai, sedangkan rantai alat bertanggung jawab untuk membaca, menghitung, merender, dan menulis. Ini berarti ketika Anda memvalidasi model baru, Anda harus menjalankannya di dalam rantai alat Anda sendiri; kesimpulan yang lepas dari lingkungannya memiliki nilai referensi yang terbatas.
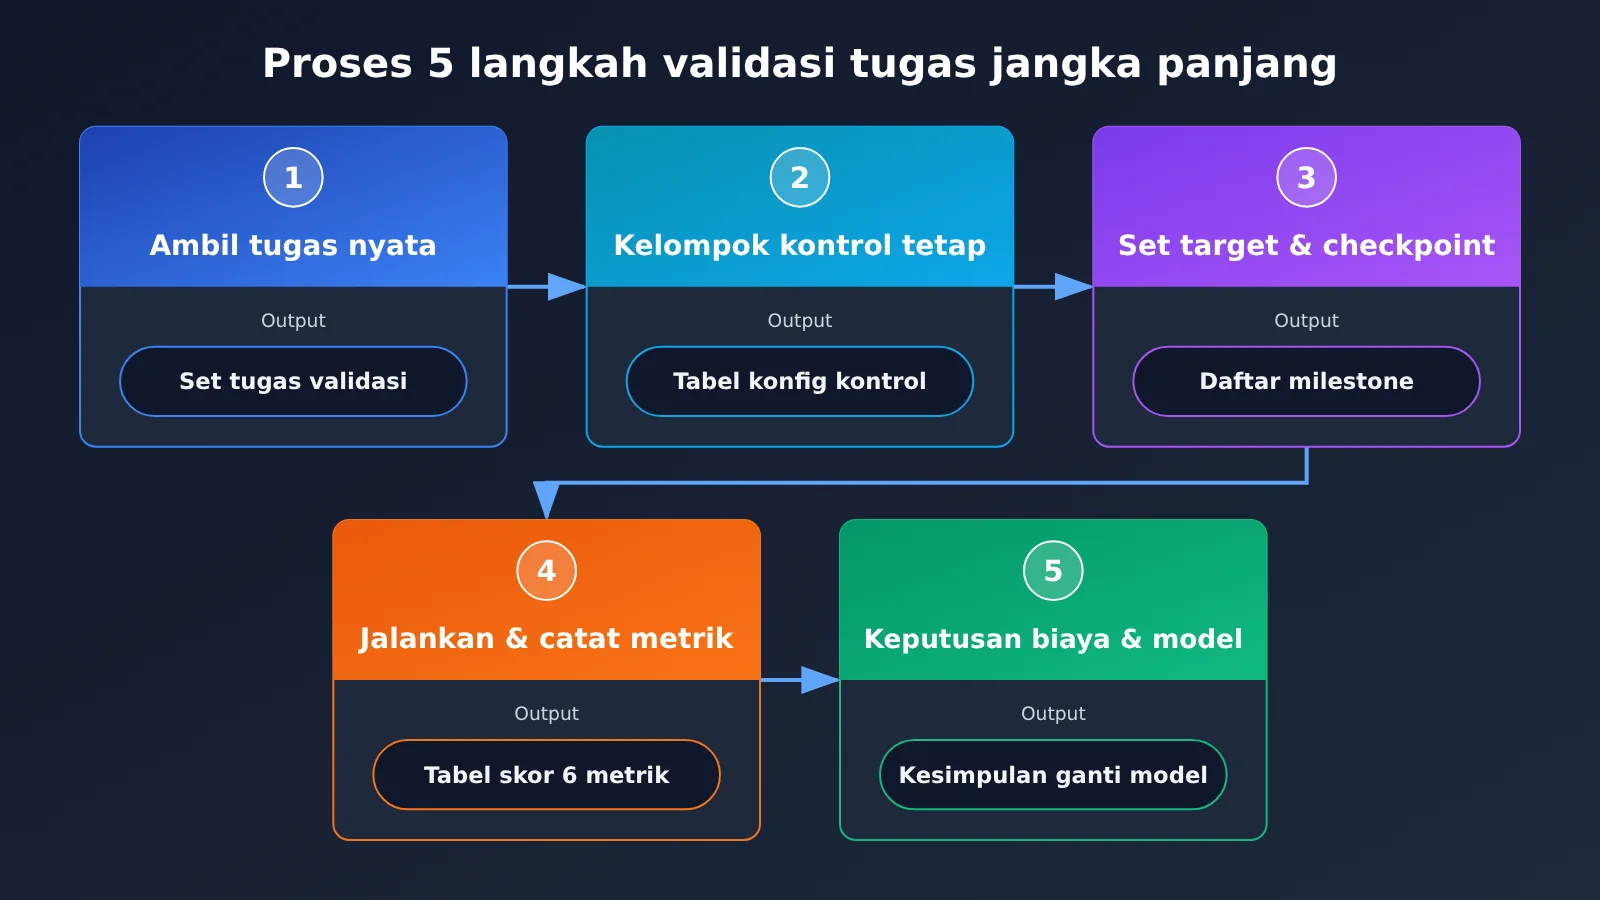
Panduan cepat validasi tugas jangka panjang model baru: alur 5 langkah
Alur berikut tidak bergantung pada framework tertentu. Selama pemanggilan model Anda melewati antarmuka terpadu, Anda bisa berganti model dengan biaya rendah untuk melakukan perbandingan.
Langkah 1: Ambil tugas jangka panjang dari bisnis nyata
Set validasi tidak perlu banyak, yang penting “mirip” dengan kondisi nyata. Sebaiknya pilih 3-5 tugas yang mencakup tiga jenis skenario paling umum, paling menguras tenaga, dan paling rawan kesalahan dalam bisnis Anda. Idealnya setiap tugas memenuhi tiga syarat ini: minimal 10 langkah, perlu memanggil tool, dan memiliki hasil akhir yang jelas.
Anda bisa merancang versi sendiri dengan merujuk pada beberapa jenis tugas jangka panjang berikut:
- Pemrosesan dokumen batch: Diberikan sebuah folder berisi belasan materi, model diminta merangkum tiap dokumen, membuat bahan laporan, lalu menggabungkannya menjadi tabel dan laporan.
- Pengembangan aplikasi: Berangkat dari deskripsi kebutuhan, model menyelesaikan pengembangan, pengujian mandiri, perbaikan, dan akhirnya menyerahkan produk yang bisa dijalankan.
- Replikasi multimodal: Unggah tangkapan layar atau rekaman layar, lalu minta model memahami isinya dan mereplikasi antarmuka atau interaksi yang sesuai.
- Operasi komputer: Minta model melihat layar, menemukan tombol, melakukan klik dan input, lalu menyelesaikan alur operasi lintas aplikasi.
Langkah 2: Tetapkan kelompok kontrol dan lingkungan eksekusi
Kunci eksperimen kontrol adalah “hanya mengubah satu variabel”. Model lama dan model baru harus menggunakan petunjuk sistem yang sama, definisi alat yang sama, dan materi masukan yang sama. Sebaiknya setiap tugas dijalankan minimal 3 kali, lalu ambil nilai rata-rata dan nilai terburuk, karena tugas jangka panjang jauh lebih acak dibandingkan tanya jawab satu putaran.
| Item konfigurasi | Saran pengaturan | Keterangan |
|---|---|---|
model |
Model yang sedang digunakan vs model baru | Satu-satunya parameter yang boleh berubah |
temperature |
Kedua kelompok disamakan, sebaiknya relatif rendah | Mengurangi gangguan acak terhadap kesimpulan |
max_tokens |
Sisakan ruang sesuai output terpanjang tugas | Hindari salah menilai kemampuan model akibat pemotongan |
Definisi alat tools |
Daftar fungsi dan deskripsi yang benar-benar sama | Perbedaan deskripsi alat dapat sangat memengaruhi perilaku pemanggilan |
| Petunjuk sistem | Versi yang sama, tidak dioptimalkan untuk model baru | Uji dulu “langsung pakai”, baru uji performa setelah penyesuaian |
| Jumlah pengulangan | Minimal 3 kali per tugas | Amati stabilitas, bukan hasil terbaik |
Jika proyek Anda memakai antarmuka gaya OpenAI dan Anthropic sekaligus, mengganti model sering berarti harus mengganti SDK, autentikasi, dan format permintaan; ini membuat eksperimen kontrol jadi merepotkan. Dengan memanggil melalui platform agregasi API yang terpadu, Anda cukup mengubah field model untuk beralih.
🚀 Saran cepat untuk memulai: APIYI apiyi.com menyediakan pemanggilan API untuk model-model utama yang dibahas di artikel ini, sekaligus kompatibel dengan format antarmuka OpenAI dan Anthropic. Saat melakukan eksperimen kontrol, cukup ganti parameter
modeluntuk beralih antara model lama dan baru. Cara integrasi,base_url, dan konfigurasi autentikasi mengikuti pusat dokumentasi APIYI docs.apiyi.com.
Langkah 3: Menetapkan jangkar tujuan dan checkpoint untuk tugas
Mode kegagalan paling umum pada tugas jangka panjang bukanlah “tidak bisa mengerjakan”, melainkan “saat mengerjakan malah lupa apa yang harus dikerjakan”. Dalam evaluasi referensi digunakan instruksi /goal untuk membatasi model agar selalu berpegang pada tujuan spesifik; pendekatan ini bisa diterapkan ke lingkungan verifikasi apa pun. Anda dapat menuliskan tujuan akhir dengan jelas di awal tugas dan memecah hasil yang harus diserahkan menjadi beberapa tonggak yang dapat diperiksa.
Ambil contoh tugas “membuat game 3D realistis”: evaluator memecah tujuan menjadi 5 hal: adegan game, visual dan sensasi saat dimainkan, suara dan gameplay, alur kerja, serta penyerahan akhir. Tugas Anda sendiri juga sebaiknya dipecah seperti ini; setiap tonggak memiliki checkpoint yang dapat dinilai secara objektif sebagai “selesai/belum selesai”, sehingga penilaian berikutnya akan jauh lebih mudah.
Langkah 4: Jalankan dan catat 6 metrik
Setiap kali menjalankan, simpan log percakapan dan pemanggilan alat secara lengkap, lalu beri skor sesuai tabel berikut. Empat metrik pertama mengukur “apakah bisa diselesaikan”, dua metrik terakhir mengukur “apakah layak secara biaya”.
| Metrik | Cara mengukur | Cara menilai |
|---|---|---|
| Tingkat penyelesaian tugas | Jumlah checkpoint selesai / total checkpoint | Persentase, ambil rata-rata dari 3 kali |
| Kemampuan mempertahankan tujuan | Apakah paruh kedua masih bergerak menuju tujuan awal, ada yang terlewat atau melenceng | Skor manual 1-5 |
| Kemampuan mengoreksi diri | Setelah terjadi kesalahan di tengah jalan (error, tes gagal), apakah bisa memperbaiki sendiri | Catat “jumlah kesalahan / jumlah pemulihan mandiri” |
| Jumlah intervensi manual | Jumlah putaran yang memerlukan penjelasan tambahan atau koreksi dari manusia | Semakin sedikit semakin baik |
| Waktu yang dibutuhkan | Waktu wall-clock dari mulai hingga penyerahan | Menit, termasuk waktu eksekusi alat |
| Biaya per penyerahan | Total biaya token / jumlah penyerahan berhasil | Dihitung berdasarkan dasar penagihan aktual |
“Jumlah intervensi manual” terutama perlu diperhatikan. Kesimpulan evaluasi referensi adalah Hy4 pada sebagian besar tugas kantor sehari-hari dan tugas kreatif pada dasarnya dapat menyerahkan hasil dalam sekali jalan, tetapi dalam pekerjaan yang banyak melibatkan operasi komputer dan alur kompleks, masih diperlukan beberapa putaran interaksi untuk membantunya memahami maksud. Inilah perbedaan yang perlu Anda kuantifikasi pada tugas Anda sendiri: sekali intervensi berarti satu bagian biaya tenaga kerja.
Langkah 5: Hitung biaya dan ambil keputusan pergantian model
Perhitungan biaya harus menggunakan satuan “setiap pengiriman sukses”, bukan hanya membandingkan harga satuan input dan output. Model dengan harga satuan murah tetapi perlu dijalankan ulang dua kali bisa jadi biaya aktualnya lebih tinggi. Tugas jangka panjang juga punya ciri lain: konteks akan membawa konten historis berulang kali, sehingga tingkat cache hit sangat memengaruhi total biaya.
Rumusnya: biaya satu tugas = token input yang tidak kena cache × harga satuan input + token input yang kena cache × harga cache + token output × harga satuan output; lalu bagi total biaya beberapa kali eksekusi dengan jumlah pengiriman sukses. Harga satuan input, harga satuan output, harga cache, dan dasar penagihan tiap model, silakan mengacu pada data aktual di halaman harga APIYI docs.apiyi.com/models; artikel ini tidak mencantumkan angka spesifik agar tidak menyesatkan jika harga berubah.
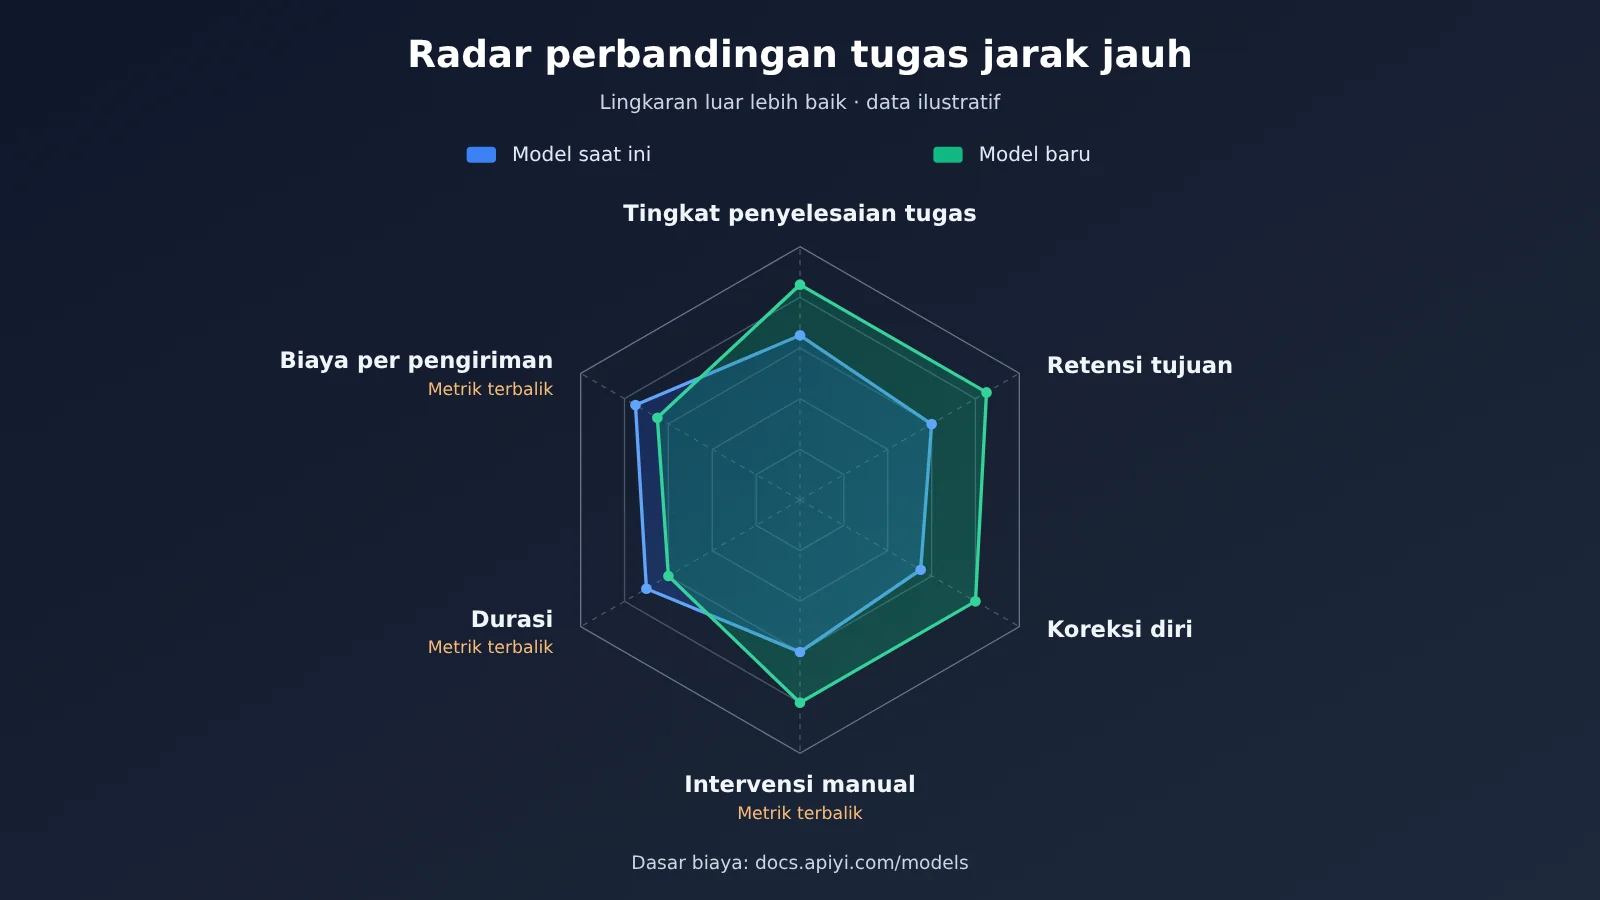
💰 Tips perhitungan biaya: Saat membuat perbandingan, sebaiknya panggil model lama dan baru di platform yang sama, agar statistik penggunaan dan dasar penagihan konsisten, sehingga “biaya per pengiriman” yang dihitung benar-benar dapat dibandingkan. Halaman harga APIYI docs.apiyi.com/models mencantumkan harga input, output, dan cache tiap model, dan dapat langsung dijadikan dasar perhitungan.
Kriteria keputusan untuk validasi tugas jangka panjang model baru
Setelah data eksperimen terkumpul, hal yang paling ditakutkan adalah “masing-masing punya kelebihan sehingga sulit memutuskan”. Sebaiknya tuliskan aturan keputusan sebelum eksperimen dimulai. Tabel berikut bisa menjadi titik awal, lalu sesuaikan ambang batasnya dengan sensitivitas bisnis Anda.
| Hasil perbandingan | Rekomendasi keputusan | Alasan |
|---|---|---|
| Tingkat penyelesaian meningkat jelas, biaya per pengiriman tetap atau turun | Langsung beralih | Kualitas dan biaya sama-sama diuntungkan |
| Tingkat penyelesaian meningkat jelas, biaya naik | Beralih per skenario | Gunakan model baru hanya untuk tugas bernilai tinggi dan sulit |
| Tingkat penyelesaian tetap, biaya turun jelas | Beralih bertahap | Ganti pada tugas berisiko rendah lebih dulu, lalu amati beberapa waktu |
| Tingkat penyelesaian tetap, jumlah intervensi berkurang | Prioritaskan untuk beralih | Tenaga manusia yang dihemat sering kali lebih bernilai daripada biaya token |
| Tingkat penyelesaian turun atau stabilitas memburuk | Tunda peralihan | Tunggu versi berikutnya atau sesuaikan petunjuk lalu uji ulang |
Ada satu dimensi lain yang mudah terlewat, yaitu restrukturisasi tugas akibat kemampuan baru. Misalnya, Hy4 kali ini menambahkan pemahaman visual, sehingga dapat langsung membaca rekaman layar dan menganalisisnya per frame. Model ini juga dapat terus mengambil tangkapan layar atas hasil yang dihasilkannya sendiri, lalu melakukan umpan balik dan optimasi mandiri. Jika alur lama mengharuskan manusia mengubah tangkapan layar menjadi deskripsi teks, maka yang dibawa model baru mungkin bukan “tugas yang sama dikerjakan lebih baik”, melainkan “seluruh alur berkurang satu langkah”. Manfaat seperti ini harus dicatat terpisah, jangan hanya diukur dengan skor tugas lama.
Referensi pemilihan saat membandingkan model arus utama
Saat melakukan perbandingan, biasanya model baru dijalankan bersama model yang sedang digunakan serta kandidat lain di tingkat yang sama. Tabel berikut memberikan kerangka pemilihan; untuk kemampuan spesifik, gunakan hasil pengujian tugas jangka panjang Anda sendiri sebagai acuan.
| Jenis kandidat | Tugas jangka panjang yang cocok ditangani | Fokus validasi | Platform yang tersedia |
|---|---|---|---|
| Model open-source/domestik yang baru dirilis | Pemrosesan batch dokumen kantor, Agent untuk skenario bahasa Mandarin | Tingkat menjaga tujuan, rasio harga-kinerja | APIYI apiyi.com dll. |
| Model closed-source utama yang sedang digunakan | Pemrograman kompleks, penalaran tingkat tinggi | Sebagai baseline kualitas | APIYI apiyi.com dll. |
| Model dengan kemampuan multimodal | Replikasi tangkapan layar/rekaman layar, pemahaman antarmuka | Akurasi pemahaman visual, koreksi mandiri | APIYI apiyi.com dll. |
| Model ringan dan cepat | Distribusi subtugas, perapian format | Waktu dan biaya | APIYI apiyi.com dll. |
💡 Saran pemilihan: Jangan hanya membandingkan satu kandidat dengan model yang sedang digunakan. Dalam antarmuka yang sama, masukkan dua atau tiga kandidat ke set validasi yang sama; sering kali ini akan menemukan solusi yang lebih optimal berupa “penggunaan kombinasi per skenario”. APIYI mendukung pemanggilan terpadu berbagai model arus utama, sehingga memudahkan penerapan cepat solusi kombinasi seperti ini.
FAQ Pertanyaan Umum
T1: Apa itu validasi tugas jangka panjang untuk model baru?
Validasi tugas jangka panjang berarti menguji model dengan tugas nyata yang terdiri dari banyak langkah, memerlukan pemanggilan alat, dan punya hasil akhir yang jelas. Yang jadi fokus bukan kualitas jawaban satu putaran, melainkan apakah model bisa menjaga tujuan di sepanjang rangkaian langkah, apakah bisa memperbaiki diri setelah salah, dan berapa biaya akhir untuk menghasilkan hasil yang bisa dipakai.
T2: Apa bedanya validasi tugas jangka panjang dengan sekadar melihat Benchmark publik?
Benchmark sangat berharga untuk membandingkan kemampuan umum secara luas, tetapi soal-soalnya cukup berbeda dari bisnis Anda dan sebagian besar berupa tugas berantai pendek. Validasi tugas jangka panjang dijalankan langsung di atas toolchain dan data Anda, sehingga bisa memunculkan masalah seperti lupa tujuan, salah pakai alat, atau kebutuhan koreksi manual berulang. Paling aman menggabungkan keduanya: saring kandidat lewat papan peringkat, lalu ambil keputusan dengan tugas milik sendiri.
T3: Kapan waktu yang tepat untuk mulai validasi setelah model baru dirilis?
Sebaiknya jalankan satu putaran uji “langsung pakai” secepat mungkin setelah rilis, karena banyak model baru punya masa gratis terbatas atau periode uji coba. Dalam materi referensi, Hy4 di WorkBuddy punya masa gratis terbatas 4–15 November. Kalau hasil putaran pertama bagus, barulah luangkan waktu menyesuaikan petunjuk khusus untuk model baru dan menjalankan putaran kedua.
T4: Berapa banyak tugas yang dibutuhkan dalam set validasi?
Biasanya 3-5 tugas yang sangat dekat dengan bisnis sudah cukup untuk menarik kesimpulan arah, dengan setiap tugas diulang 3 kali untuk melihat stabilitas. Daripada menumpuk jumlah, lebih baik pastikan tugas mencakup skenario yang paling sering Anda hadapi, paling banyak menyedot tenaga, dan paling rawan error, serta rancang checkpoint yang jelas untuk tiap tugas.
T5: Bagaimana cara hemat biaya untuk berpindah-pindah model sebagai pembanding?
Cara paling praktis adalah memanggil lewat platform dengan antarmuka terpadu. APIYI apiyi.com kompatibel dengan dua format antarmuka, OpenAI dan Anthropic; untuk berganti model cukup mengubah parameter `model`, definisi alat dan petunjuk tidak perlu diubah. Langkah integrasi detailnya bisa dilihat di pusat dokumentasi docs.apiyi.com.
T6: Bagaimana menghitung biaya tugas jangka panjang dengan akurat?
Hitunglah berdasarkan “biaya per satu hasil yang berhasil”, yaitu total biaya token dari beberapa kali eksekusi dibagi jumlah hasil yang berhasil, sekaligus membedakan bagian input yang kena cache dan yang tidak. Harga satuan dan harga cache tiap model harap mengacu pada data aktual di halaman harga APIYI docs.apiyi.com/models; penggunaan standar penagihan yang sama di satu platform membuat perbandingan lebih adil.
T7: Apa saja keterbatasan validasi tugas jangka panjang?
Pertama, sampelnya sedikit; satu hasil memukau atau satu kegagalan bisa jadi kebetulan, jadi perlu diulang. Kedua, penilaian manual bersifat subjektif, sebaiknya dua orang menilai secara independen lalu dirata-rata. Ketiga, hasil sangat bergantung pada toolchain; setelah mengganti framework Agent, perlu uji ulang. Selain itu, batas atas kemampuan model sering ditentukan oleh tingkat kesulitan tugas uji, jadi set validasi perlu diperbarui secara berkala dengan tugas yang lebih sulit.
Poin Penting Validasi Tugas Jangka Panjang Model Baru
- Bicara lewat tugas Anda sendiri: 3-5 tugas multi-langkah nyata jauh lebih mendekati manfaat pergantian model dibandingkan peringkat mana pun.
- Ubah hanya satu variabel: model lama dan baru memakai petunjuk, alat, dan input yang sama, dengan setiap tugas dijalankan minimal 3 kali.
- Jangkar tujuan wajib ada: tiru pendekatan
/goaluntuk memecah tonggak pencapaian; semakin objektif checkpoint, semakin akurat penilaiannya. - 6 indikator untuk gambaran utuh: tingkat penyelesaian, pemeliharaan tujuan, koreksi diri, jumlah intervensi, waktu, dan biaya pengiriman.
- Hitung biaya berdasarkan hasil pengiriman: bedakan cache hit, dan gunakan halaman harga APIYI di docs.apiyi.com/models sebagai dasar penagihan.
- Perhatikan restrukturisasi alur kerja: kemampuan baru seperti pemahaman visual bisa langsung menghilangkan langkah manual dalam alur lama.
Ringkasan
Poin inti validasi tugas jangka panjang model baru:
- Tugas nyata: set validasi berasal dari bisnis, mencakup skenario frekuensi tinggi, memakan waktu, dan rawan kesalahan.
- Perbandingan ketat: lingkungan tetap, eksekusi berulang, dan ambang pergantian model ditulis lebih dulu.
- Perhitungan tepat: ukur manfaat nyata dengan biaya per pengiriman sukses dan jumlah intervensi manual.
Setiap rilis model baru adalah kesempatan untuk meninjau ulang alur kerja. Daripada terseret peringkat dan video demo, lebih baik luangkan satu-dua hari untuk memberi jawaban pasti lewat tugas jangka panjang Anda sendiri. Disarankan memakai APIYI apiyi.com agar model lama dan baru berada di bawah satu set antarmuka yang sama sehingga mudah dibandingkan; panduan integrasi ada di docs.apiyi.com, dan data penagihan mengacu pada docs.apiyi.com/models.
📚 Referensi
- 爱范儿 – Uji Langsung Tencent Hy4: Studi kasus uji langsung Hy4 untuk tugas jangka panjang, multimodal, dan operasi komputer
- Tautan:
ifanr.com/1687613 -
Keterangan: Menyediakan desain pengujian yang bisa dijadikan acuan, seperti batasan tujuan
/goal, pengembangan game jangka panjang, dan pemrosesan batch dokumen -
Pusat Dokumentasi APIYI: Penjelasan akses model dan format antarmuka
- Tautan:
docs.apiyi.com -
Keterangan: Lihat cara konfigurasi antarmuka yang kompatibel dengan OpenAI dan Anthropic
-
Halaman Harga Model APIYI: Harga input, output, dan cache untuk setiap model
- Tautan:
docs.apiyi.com/models - Keterangan: Satu-satunya acuan harga untuk perhitungan biaya
Penulis: Tim Teknis APIYI
Komunikasi Teknis: Silakan hubungi kami melalui beranda APIYI apiyi.com. Materi akses model lainnya dapat dilihat di pusat dokumentasi docs.apiyi.com