Catatan penulis: Saat membandingkan biaya model, melihat harga per juta token saja bisa membuat kita salah pilih. Artikel ini menjelaskan kerangka perhitungan “harga satuan × konsumsi token aktual” dan langkah lengkap untuk menguji ulangnya dengan sampel kecil dari tugas Anda sendiri.
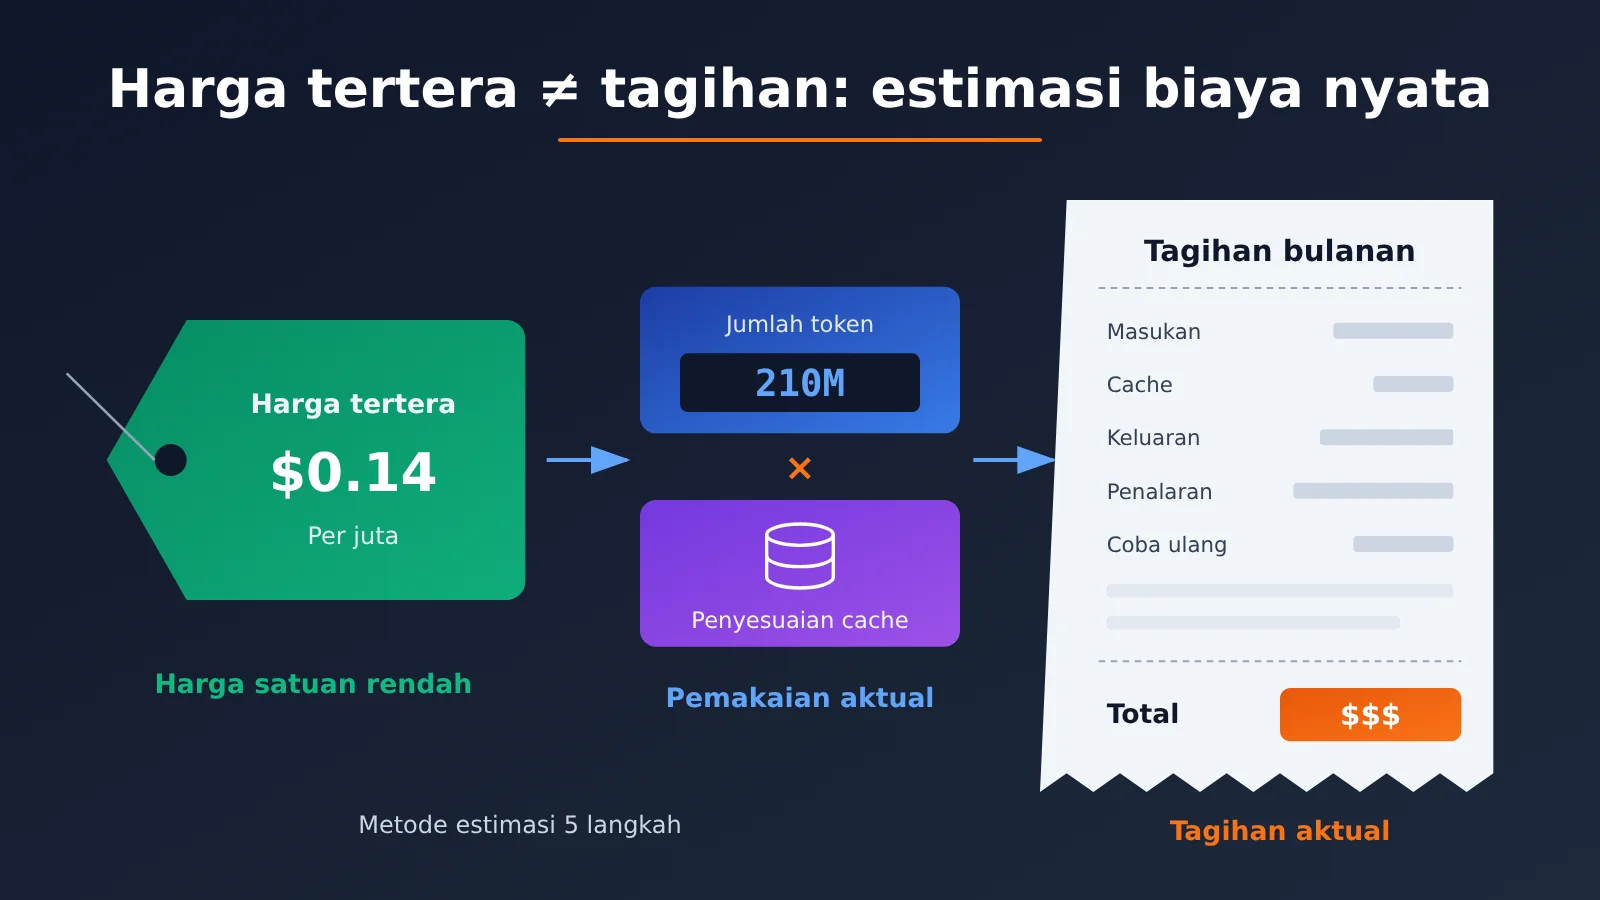
Banyak tim memulai pemilihan model dengan membuka halaman harga. Ketika melihat model A hanya seharga beberapa sen per juta token, sementara model B beberapa dolar, mereka langsung menyimpulkan bahwa model A lebih hemat. Namun, tagihan di akhir bulan sering kali tidak sesuai harapan. Terkadang, model yang “murah” justru menghabiskan lebih banyak biaya. Artikel ini membahas metode menghitung biaya sebenarnya: “harga satuan × konsumsi token aktual + penyesuaian cache”, supaya Anda bisa memperkirakan biayanya sejak tahap pemilihan model.
Ini bukan sekadar rangkuman daftar harga. Daftar harga bisa berubah, tetapi metode perhitungannya tetap bisa digunakan. Kita akan merangkum temuan dari perhitungan yang dipublikasikan menjadi kerangka umum, lalu mengujinya kembali pada tugas Anda sendiri.
Manfaat utama: Setelah membaca artikel ini, Anda bisa menjelaskan mengapa “harga satuan murah tidak berarti tagihan lebih murah”, serta mengukur biaya per tugas untuk setiap model kandidat menggunakan 20 hingga 50 permintaan nyata.
Poin Utama tentang Biaya Nyata Model
| Poin | Penjelasan | Dampak pada pemilihan model |
|---|---|---|
| Harga satuan hanya salah satu faktor | Tagihan = jumlah setiap jenis token × harga satuannya masing-masing, lalu dijumlahkan | Membandingkan harga satuan saja berarti baru melihat separuh rumus |
| Perbedaan tokenisasi | Teks yang sama dapat dipecah menjadi jumlah token yang berbeda oleh setiap model | Biaya input perlu dihitung berdasarkan jumlah token aktual pada setiap model |
| Token penalaran | Proses berpikir model penalaran biasanya ditagihkan sebagai output meski tidak terlihat oleh pengguna | Jawaban yang terlihat bisa singkat, tetapi tagihannya tinggi |
| Cache hit | Prefiks berulang yang ditemukan di cache ditagihkan dengan harga cache yang lebih rendah | Perbedaannya signifikan untuk petunjuk sistem yang panjang dan percakapan multi-putaran |
| Tingkat keberhasilan dan percobaan ulang | Jawaban yang salah atau format yang tidak sesuai perlu diproses ulang | Biaya efektif = biaya per percobaan ÷ tingkat keberhasilan |
Mengapa harga per juta token saja bisa menyesatkan saat menghitung biaya nyata
Harga per juta token menunjukkan “berapa biaya per token”, sedangkan tagihan menunjukkan “berapa biaya untuk menyelesaikan satu tugas”. Di antara keduanya ada satu variabel penting: berapa banyak token yang dibutuhkan untuk menyelesaikan tugas tersebut. Perbedaan antar-model pada variabel ini sering kali lebih besar daripada perbedaan harga satuannya.
Salah satu contohnya berasal dari perhitungan blog pihak ketiga pada 1 Agustus 2026: DeepSeek V4 Flash dan Gemini 3.6 Flash sama-sama mendapat skor 50 di Artificial Analysis. Harga yang pertama adalah $0.14/M, sedangkan yang kedua $1.50/M, selisih sekitar 10 kali lipat. Namun, dalam rangkaian evaluasi yang sama, model pertama menggunakan sekitar 210 juta token, sedangkan model kedua sekitar 59 juta—selisih lebih dari 3 kali lipat. Sebagian besar keunggulan harga satuan itu tergerus oleh jumlah token yang digunakan, sehingga selisih biaya nyatanya jauh lebih kecil dari 10 kali lipat.
Contoh lain adalah perbedaan tokenisasi. Artikel dari sumber yang sama pada 12 Agustus 2026 menghitung jumlah token dalam dokumen yang sama persis menggunakan 9 model. Hasilnya berkisar antara 614 hingga 957 token, dengan selisih sekitar 56% antara yang terbesar dan terkecil. Artinya, sekalipun harga input dua model sama persis, biaya input untuk petunjuk yang sama bisa berbeda lebih dari setengahnya.
💡 Catatan data: Angka-angka di atas berasal dari satu kali pengukuran oleh blog pihak ketiga. Tugas evaluasi, versi model, dan harga dapat berubah seiring waktu, sehingga angka tersebut hanya bisa digunakan sebagai bukti bahwa perbedaan ini memang ada, bukan langsung untuk menyusun anggaran. Anda perlu menguji ulang dengan tugas Anda sendiri.
Komponen tagihan model: jenis token yang menentukan biaya sebenarnya
Untuk menghitung biaya secara akurat, kita perlu tahu dulu apa saja komponen yang ditagihkan. Sebagian besar penyedia membagi biaya ke dalam kategori berikut. Nama dan penerapan biaya terpisahnya bisa berbeda, jadi periksa dokumentasi resmi masing-masing penyedia.
| Komponen biaya | Pengertian | Cara penetapan harga yang umum | Hal yang mudah terlewat |
|---|---|---|---|
| Input tanpa cache hit | petunjuk baru yang dikirim dalam permintaan ini dan tidak ditemukan di cache | Harga satuan input | Dipengaruhi tokenizer; teks yang sama bisa menghasilkan biaya berbeda |
| Input dengan cache hit | Bagian awal yang sama dengan permintaan sebelumnya | Harga pembacaan cache, biasanya jauh lebih rendah daripada harga input | Bagian awal harus sama persis agar terjadi cache hit |
| Penulisan cache | Sebagian penyedia mengenakan biaya terpisah saat data pertama kali ditulis ke cache | Bisa lebih tinggi daripada harga input biasa | Jika tingkat cache hit rendah, biayanya justru lebih mahal |
| Output yang terlihat | Jawaban akhir yang dilihat pengguna | Harga satuan output | Harga satuan output biasanya beberapa kali lipat harga input |
| Token penalaran | Proses berpikir internal model | Umumnya dikenakan harga satuan output | Tidak ditampilkan dalam jawaban, tetapi tetap masuk tagihan |
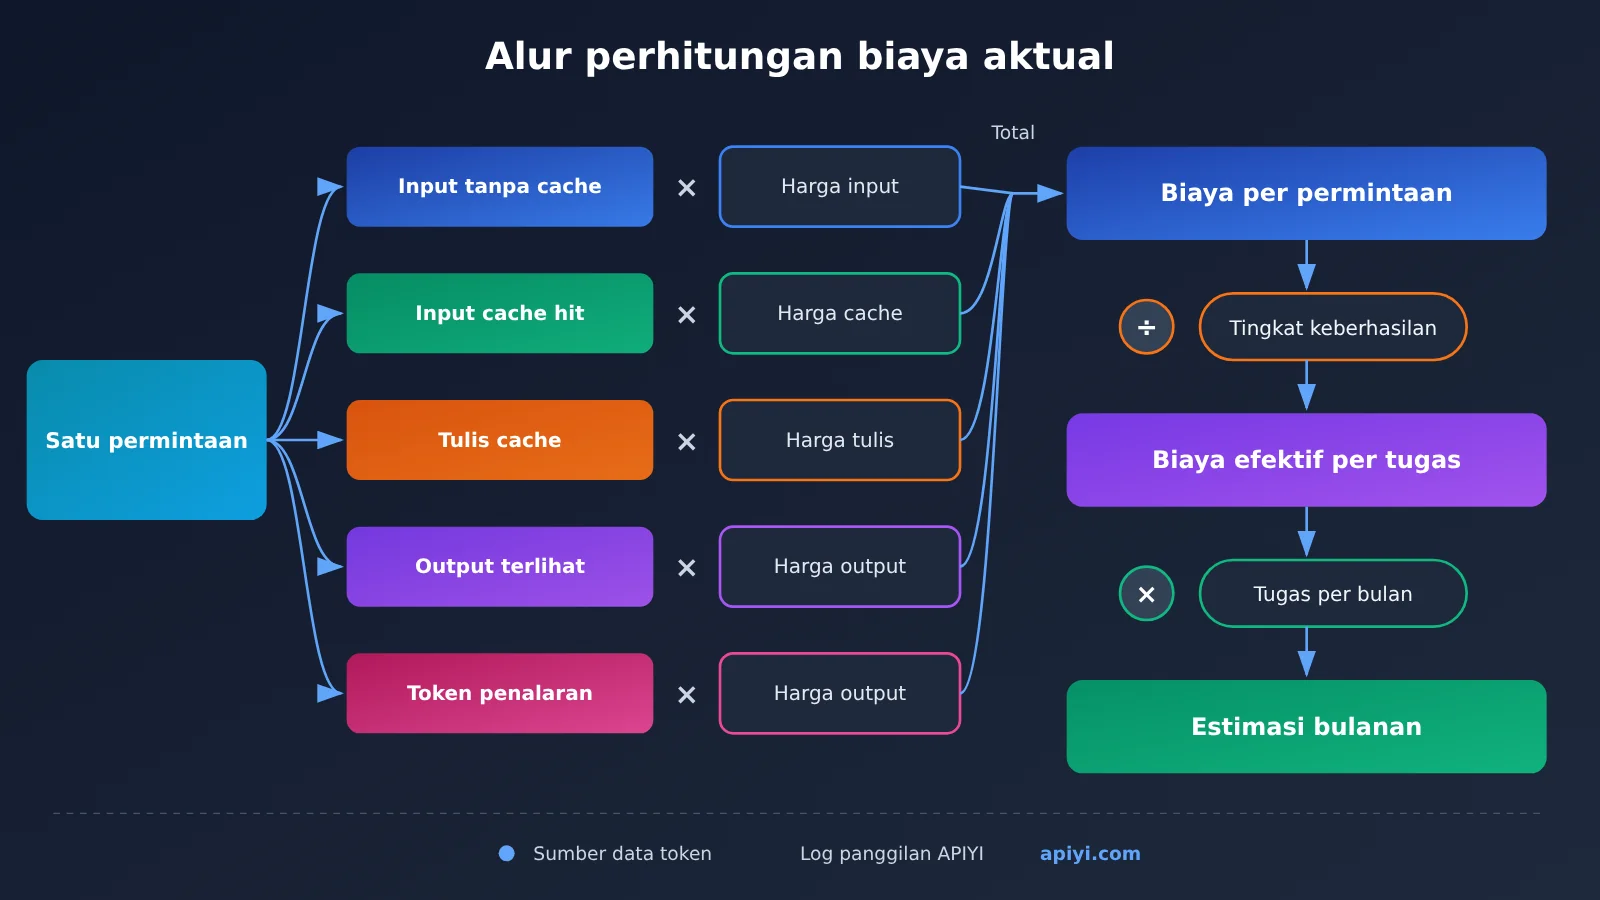
Jika dirangkum dalam rumus, komponen-komponen ini menjadi dasar perhitungan dalam artikel ini:
- Biaya per permintaan = token input tanpa cache hit × harga satuan input + token dengan cache hit × harga satuan cache + token penulisan cache × harga satuan penulisan + (output yang terlihat + token penalaran) × harga satuan output
- Biaya efektif per tugas = biaya per permintaan × rata-rata jumlah pemanggilan ÷ tingkat keberhasilan tugas
- Estimasi bulanan = biaya efektif per tugas × jumlah tugas bulanan
Dampak cache sering kali diremehkan. Artikel dari sumber yang sama pada 6 Agustus 2026 menyebutkan bahwa harga cache hit DeepSeek V4 Flash sekitar 50 kali lebih murah daripada harga tanpa cache hit, sedangkan selisih harga cache antarpenyedia hosting bisa mencapai 28 kali lipat. Artinya, tagihan untuk “model yang sama melalui penyedia berbeda” pun bisa sangat berbeda. Pastikan untuk memeriksa harga cache pada penyedia yang benar-benar Anda gunakan.
Dampak pengganda token penalaran terhadap biaya aktual
Model penalaran adalah salah satu penyebab paling umum dari situasi “harga tertera murah, tagihan mahal”. Pengguna mungkin hanya mengajukan satu pertanyaan dan model menjawab dalam 200 karakter, tetapi di balik layar model bisa lebih dulu menggunakan ribuan token untuk bernalar. Token ini biasanya ditagih dengan tarif output, yang memang beberapa kali lebih tinggi daripada tarif input.
Perhitungan publik dari pihak ketiga juga menunjukkan hal ini. Sebuah artikel tertanggal 4 Agustus 2026 menyebutkan bahwa Qwen 3.8 Max mendapat skor 3 poin lebih tinggi daripada DeepSeek V4 Flash di Artificial Analysis. Namun, dalam pengujian tiga tugas, biayanya sekitar 345 kali lebih tinggi dan kecepatannya sekitar 6 kali lebih lambat. Artikel lain dalam seri yang sama, dengan metode evaluasi yang sama, melaporkan: Kimi K3 mendapat skor 57 dengan biaya $2,437, DeepSeek V4 Flash mendapat skor 50 dengan biaya $72, dan Qwen 3.7 Max mendapat skor 46 dengan biaya $1,604. Skor lebih rendah dengan biaya lebih tinggi memang bisa terjadi, dan penyebabnya sering kali terletak pada jumlah token yang digunakan.
Perbedaan juga bisa muncul antarversi dari penyedia yang sama. Sebuah artikel menyebutkan bahwa Claude Opus 4.5 hingga 4.8 dan Opus 5 memiliki harga tertera yang sama, yaitu $5/$25, tetapi pengujian menunjukkan perbedaan penggunaan token sekitar 1,30 kali lipat. Harga tetap sama, tetapi tagihan bisa berubah 30%—hal yang mudah terlewat saat meningkatkan versi model.
Memperkirakan biaya sebenarnya dari penggunaan token: mulai dalam 5 langkah
Berikut alur pengukuran dengan sampel kecil yang bisa dijalankan tanpa menulis skrip rumit. Prinsip utamanya hanya satu: untuk tugas dan input yang sama, hitung token input, output, cache, dan penalaran secara terpisah.
Langkah 1: Siapkan sampel tugas yang representatif
Pilih 20 hingga 50 permintaan dari lingkungan produksi atau kebutuhan nyata, yang mencakup jenis utama seperti tanya jawab singkat, dokumen panjang, dan percakapan multi-giliran. Pastikan sampel menyertakan petunjuk sistem dan konteks secara lengkap, karena cache terutama mengenai awalan berulang tersebut. Jangan hanya menguji dengan satu kalimat seperti “Halo”, karena itu tidak akan menunjukkan perbedaan tokenisasi dan efek cache.
Langkah 2: Tetapkan variabel, lalu panggil setiap model kandidat
Gunakan petunjuk sistem, input pengguna, max_tokens, dan pengaturan suhu yang sama untuk setiap model kandidat. Jika model penalaran mendukung parameter tingkat penalaran, catat tingkat yang digunakan. Jumlah token penalaran bisa sangat berbeda pada setiap tingkat.
Pada tahap ini, satu akses terpadu bisa mengurangi banyak kerepotan. Melalui platform agregator seperti APIYI apiyi.com, Anda bisa beralih antar-model dari berbagai penyedia dengan satu kunci API dan metode pemanggilan yang kompatibel dengan OpenAI. Cukup ubah nama model untuk menjalankan seluruh perbandingan, tanpa perlu membuat akun, mengisi saldo, dan menyesuaikan SDK untuk setiap penyedia.
Langkah 3: Catat setiap jenis token
Setelah setiap pemanggilan, baca jumlah token dari kolom usage dalam respons. Sebagai contoh, dalam format yang kompatibel dengan OpenAI, kolom yang umum digunakan meliputi:
usage.prompt_tokens: jumlah total token inputusage.prompt_tokens_details.cached_tokens: bagian token input yang ditemukan dalam cacheusage.completion_tokens: jumlah total token outputusage.completion_tokens_details.reasoning_tokens: bagian token output yang digunakan untuk penalaran
Nama kolom tidak selalu sama di setiap penyedia. Misalnya, format Anthropic menggunakan cache_read_input_tokens dan cache_creation_input_tokens untuk membedakan pembacaan dan penulisan cache. Periksa dokumentasi masing-masing penyedia untuk detailnya.
Jika tidak ingin mengurai respons sendiri, Anda juga bisa langsung melihat catatan di platform. APIYI menyediakan log dan statistik penggunaan untuk setiap pemanggilan, sehingga Anda bisa membandingkan konsumsi dari kumpulan sampel yang sama di berbagai model. Perlu diperhatikan bahwa pencatatan terpisah untuk token cache dan token penalaran, serta penagihan terpisah untuk hit cache, bergantung pada tampilan konsol dan ketentuan penagihan platform. Pastikan hal ini sebelum melakukan perhitungan.
🚀 Mulai cepat: Coba jalankan perbandingan skala kecil dengan 20 sampel di APIYI apiyi.com untuk mengetahui kisaran konsumsi token setiap model, lalu tentukan apakah perlu menambah sampel. Dengan penagihan menggunakan satu saldo, biaya pengujian berbagai model terkumpul dalam satu akun sehingga lebih mudah diperiksa setelahnya.
Langkah 4: Rangkum menggunakan templat perhitungan
Masukkan hasil pencatatan ke templat berikut, dengan satu baris untuk setiap model. Pastikan untuk mencantumkan tanggal pengecekan dan sumber harga satuan.
| Kolom | Petunjuk pengisian | Sumber data |
|---|---|---|
| Model dan versi | Cantumkan nomor versi atau akhiran tanggal secara spesifik | Parameter pemanggilan |
| Harga satuan dan tanggal pengecekan | Buat kolom terpisah untuk input, output, pembacaan cache, dan penulisan cache | Halaman harga resmi atau halaman harga platform yang digunakan |
| Rata-rata token input tanpa cache | Rata-rata sampel | usage dalam respons atau log platform |
| Rata-rata token yang terkena cache | Rata-rata sampel, beserta tingkat cache hit | usage dalam respons atau log platform (seperti statistik penggunaan APIYI) |
| Rata-rata token output yang terlihat | Total output dikurangi bagian penalaran | usage dalam respons |
| Rata-rata token penalaran | Catat secara terpisah untuk model penalaran | usage dalam respons |
| Tingkat keberhasilan tugas | Persentase yang dinyatakan lolos secara manual atau berdasarkan aturan | Catatan evaluasi |
| Biaya efektif per tugas | Hitung menggunakan rumus sebelumnya | Perhitungan rangkuman |
Langkah 5: Ambil keputusan berdasarkan biaya efektif per tugas
Pada akhirnya, yang dibandingkan bukan harga satuan, melainkan “biaya efektif per tugas”. Contoh berikut menggunakan harga ilustrasi untuk menunjukkan cara menghitungnya. Angkanya dibuat untuk menjelaskan metode dan tidak mewakili harga nyata model mana pun.
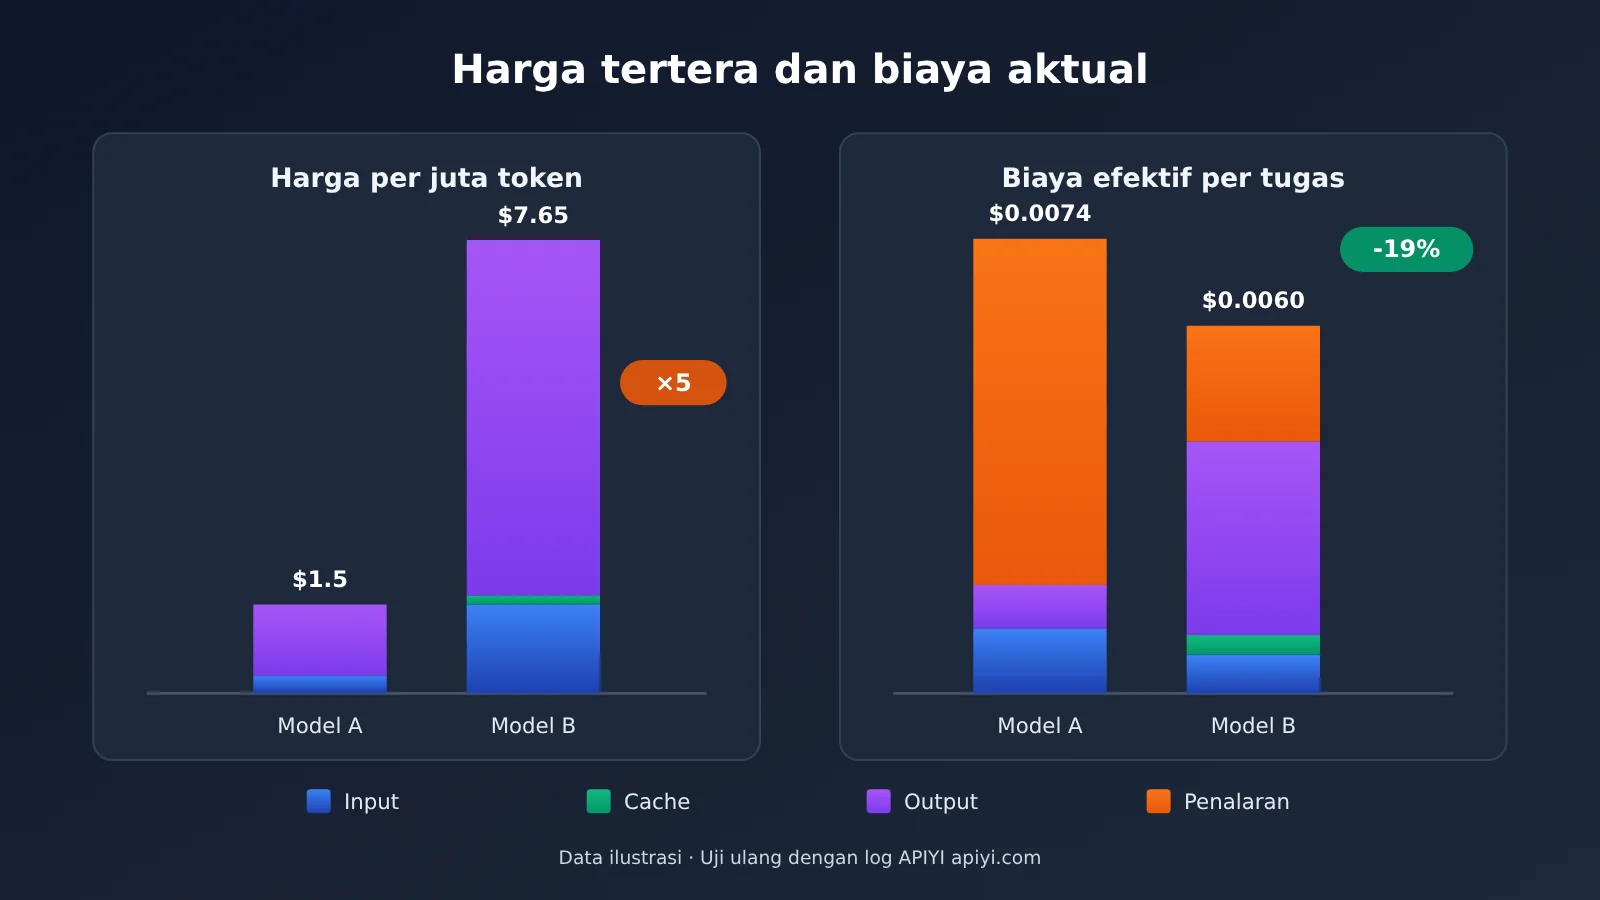
Misalkan model A memiliki harga input $0.3/M dan output $1.2/M; model B memiliki harga input $1.5/M, output $6/M, dan pembacaan cache $0.15/M. Harga satuan model B 5 kali lebih mahal daripada A.
| Komponen perhitungan | Model A (harga lebih rendah) | Model B (harga lebih tinggi) |
|---|---|---|
| Token input tanpa cache | 3,000 | 400 |
| Token yang terkena cache | 0 | 2,000 |
| Token output yang terlihat + token penalaran | 500 + 4,000 | 500 + 300 |
| Biaya input | $0.0009 | $0.0006 + $0.0003 |
| Biaya output | $0.0054 | $0.0048 |
| Biaya per permintaan | $0.0063 | $0.0057 |
| Tingkat keberhasilan tugas | 85% | 95% |
| Biaya efektif per tugas | sekitar $0.0074 | sekitar $0.0060 |
Dalam contoh ini, tokenisasi model B lebih ringkas sehingga total inputnya lebih sedikit 600 token; sebagian besar petunjuk sistemnya yang panjang terkena cache; dan proses penalarannya juga jauh lebih singkat. Hasilnya, meski harga satuan B 5 kali lebih mahal, biaya efektifnya justru sekitar 19% lebih rendah daripada A. Dalam praktiknya, hasilnya bisa saja berkebalikan. Itulah sebabnya Anda perlu mengujinya kembali dengan tugas Anda sendiri.
Hal yang perlu diperhatikan saat menghitung biaya riil
Kerangka perhitungannya sendiri tidak rumit, tetapi ada beberapa hal yang bisa membuat hasilnya meleset. Sebelum mulai, periksa poin-poin berikut satu per satu:
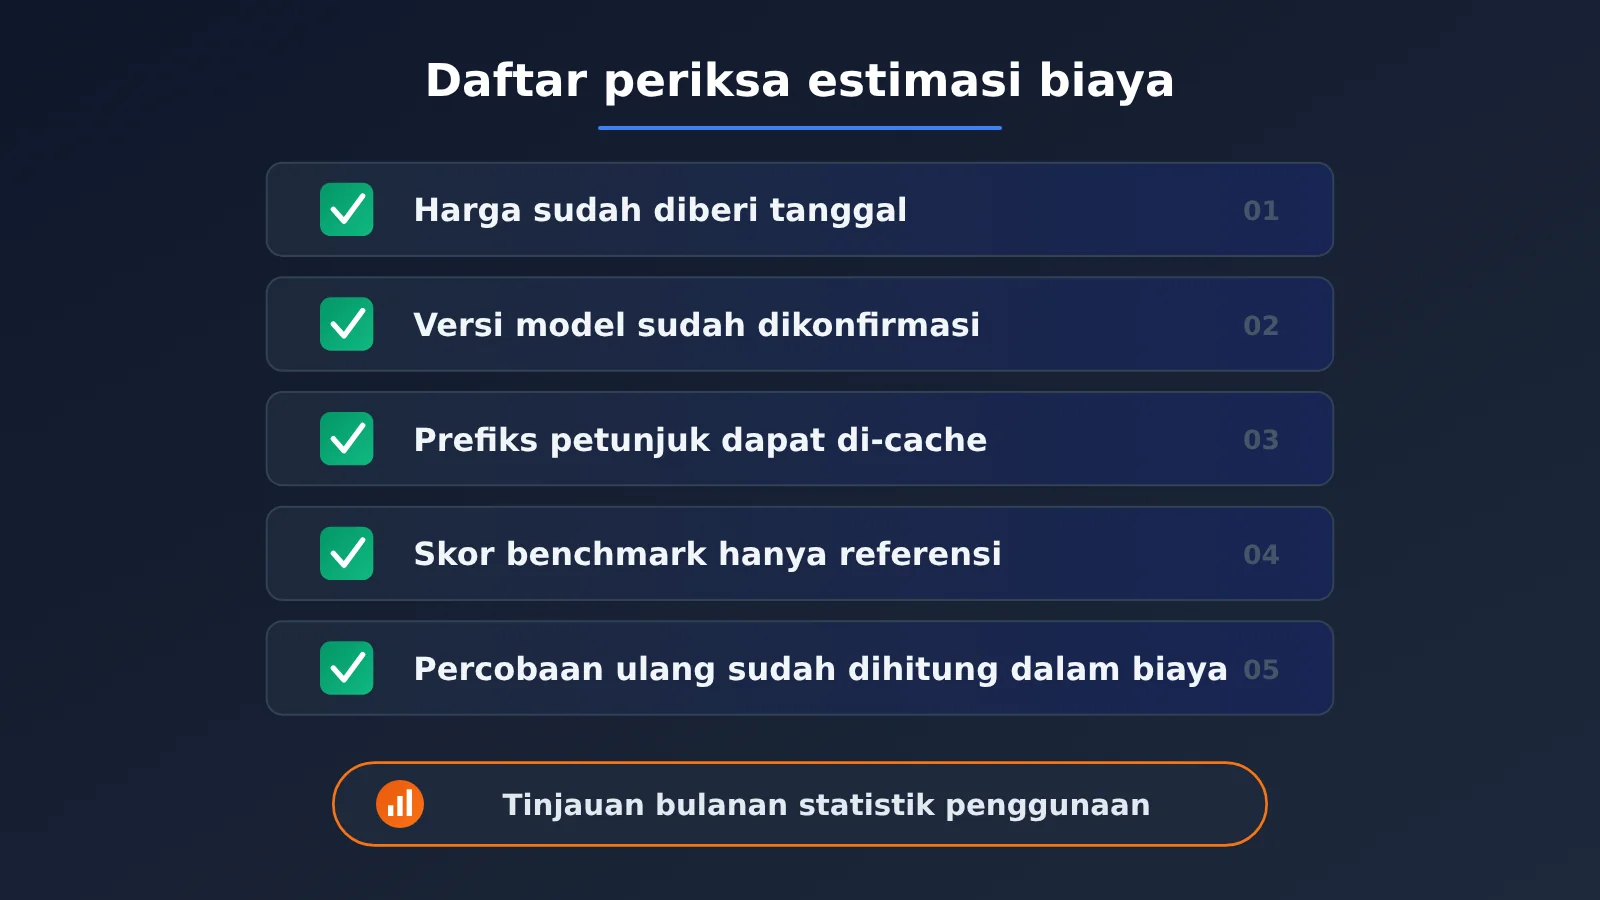
- Cantumkan tanggal pada harga: Harga model sering berubah. Misalnya, materi referensi menyebutkan bahwa DeepSeek V4 Pro 0813 menerapkan tarif berbeda untuk jam sibuk dan di luar jam sibuk mulai 16 Agustus 2026. Harga model yang sama juga bisa berbeda menurut waktu dan kanal yang digunakan.
- Perhatikan versi yang dituju oleh alias model: Ada artikel yang menyebutkan bahwa nama model yang tampak “paling umum digunakan” ternyata memanggil versi lama. Catat identitas model yang dikembalikan dalam respons agar tidak menguji versi A tetapi meluncurkan versi B.
- Cache hanya bisa digunakan jika prefiksnya konsisten: Menempatkan konten dinamis, seperti stempel waktu atau ID pengguna, di awal petunjuk akan membuat prefiks berbeda setiap kali, sehingga cache hampir tidak pernah digunakan. Saat menghitung biaya, gunakan struktur petunjuk yang sama dengan lingkungan produksi.
- Jadikan skor benchmark pihak ketiga sebagai referensi saja: Skor gabungan seperti yang diberikan Artificial Analysis, serta biaya yang dihitung per tugas, mencerminkan distribusi tugas lembaga penguji dan belum tentu sesuai dengan skenario bisnis Anda.
- Sertakan percobaan ulang dalam biaya: Pemanggilan ulang akibat pembatasan laju 429, kesalahan format, atau jawaban yang tidak memenuhi syarat tetap menimbulkan biaya. Hitung tingkat keberhasilan berdasarkan hasil penilaian aktual.
💰 Saran optimasi biaya: Setelah perhitungan selesai, Anda bisa menjadikan “biaya efektif per tugas” sebagai metrik utama untuk memilih model, sementara skor benchmark dan latensi menjadi batasan. Di APIYI apiyi.com, Anda hanya perlu mengubah nama model untuk beralih model. Ini memudahkan penyesuaian konfigurasi produksi ketika kesimpulan perhitungan berubah, sekaligus memungkinkan Anda terus memantau penggunaan aktual melalui log pemanggilan.
Pertanyaan Umum FAQ
Q1: Apa yang dimaksud dengan “biaya nyata” model?
Biaya nyata adalah jumlah yang benar-benar dibayarkan untuk menyelesaikan tugas tertentu, bukan harga yang tercantum per satu juta token. Biaya ini dihitung dengan mengalikan jumlah aktual setiap jenis token—input tanpa cache hit, cache hit, penulisan cache, output yang terlihat, dan penalaran—dengan harga masing-masing, lalu memperhitungkan tingkat keberhasilan dan percobaan ulang untuk mendapatkan biaya efektif per tugas.
Q2: Mengapa jumlah token untuk dokumen yang sama berbeda di setiap model?
Setiap model menggunakan tokenizer yang berbeda, sehingga cara memecah teks bahasa Mandarin, kode, dan tanda baca juga berbeda. Dalam perhitungan yang dipublikasikan, dokumen yang sama menghasilkan 614 hingga 957 token di 9 model. Jadi, biaya input harus dihitung berdasarkan jumlah token yang dilaporkan masing-masing model, bukan menggunakan hitungan satu model untuk model lainnya.
Q3: Apakah token penalaran harus dimasukkan ke dalam biaya?
Ya. Sebagian besar penyedia memasukkan token penalaran ke dalam output dan mengenakannya dengan harga token output. Token ini tidak muncul dalam teks jawaban, tetapi bisa mencakup sebagian besar output. Saat menghitung biaya model penalaran, sebaiknya catat `reasoning_tokens` secara terpisah dan bandingkan model pada tingkat intensitas penalaran yang sama.
Q4: Berapa banyak biaya yang bisa dihemat dengan cache hit?
Itu bergantung pada harga cache penyedia dan tingkat cache hit kamu. Referensi menyebutkan bahwa harga cache hit DeepSeek V4 Flash sekitar 1/50 dari harga tanpa cache hit, tetapi harga cache antarpenyedia hosting bisa berbeda hingga 28 kali lipat. Penghematan paling besar biasanya terjadi pada petunjuk sistem yang panjang, awalan basis pengetahuan yang tetap, dan percakapan multigilir. Untuk angka pastinya, periksa informasi harga dari penyedia yang kamu gunakan.
Q5: Bagaimana cara cepat menghitung biaya beberapa model dengan sampel kecil?
Gunakan platform yang menyediakan akses terpadu ke berbagai model:
1. Daftar di APIYI apiyi.com dan dapatkan kunci API
2. Siapkan 20 hingga 50 sampel tugas nyata, lalu tetapkan petunjuk dan parameter yang sama
3. Panggil setiap model dengan mengganti nama model, lalu rangkum setiap jenis token menggunakan log pemanggilan dan statistik penggunaan
4. Hitung biaya efektif per tugas menggunakan templat dalam artikel ini
Dengan begitu, semua perbandingan bisa dilakukan menggunakan satu akun dan satu metode pemanggilan, sehingga mengurangi biaya pendaftaran akun dan rekonsiliasi tagihan di berbagai penyedia.
Q6: Apakah angka “biaya per tugas” dari blog pihak ketiga bisa langsung digunakan?
Sebaiknya jangan langsung digunakan untuk menyusun anggaran. Data seperti ini berguna untuk menemukan kombinasi model yang mungkin memiliki perbedaan konsumsi token dan mempersempit pilihan. Namun, tugas evaluasi, versi model, harga, dan kondisi cache bisa berbeda dari kebutuhan bisnis kamu, sehingga angka akhirnya perlu diuji ulang dengan sampel sendiri.
Q7: Apa saja keterbatasan metode perhitungan ini?
Sampel kecil hanya mencerminkan jenis tugas yang tercakup di dalamnya. Jika distribusi tugas bisnis berubah, pengujian perlu diulang. Selain itu, log beberapa platform mungkin tidak membedakan token cache dan penalaran. Dalam kasus ini, kamu perlu mengumpulkannya sendiri dari kolom `usage` pada respons model. Harga dan versi model juga bisa berubah, jadi sebaiknya lakukan pengujian ulang setiap kali ada perubahan harga atau peningkatan versi.
Poin Penting Menghitung Biaya Riil Model
- Harga satuan hanya separuh dari perhitungan: tagihan ditentukan oleh harga satuan dikalikan jumlah token yang benar-benar digunakan.
- Perbedaan tokenisasi tidak bisa diabaikan: jumlah token untuk dokumen yang sama bisa berbeda lebih dari 50% antar-model.
- Token penalaran menambah biaya output: proses berpikir yang tidak terlihat juga dikenakan tarif output.
- Harga cache berbeda menurut penyedia: tingkat cache hit dan harga satuan cache sama-sama menentukan biaya untuk petunjuk yang panjang.
- Ambil keputusan berdasarkan biaya efektif per tugas: sertakan tingkat keberhasilan dan percobaan ulang dalam perhitungan.
- Gunakan satu pintu akses untuk pengujian ulang: dengan antarmuka terpadu dan log pemanggilan APIYI, pengujian beberapa model menggunakan sampel yang sama jadi lebih mudah.
Kesimpulan
Ada tiga hal utama untuk memperkirakan biaya riil model berdasarkan konsumsi token dan cache:
- Rinci tagihan: hitung secara terpisah input yang tidak terkena cache, cache hit, penulisan cache, output yang terlihat, dan token penalaran. Kalikan masing-masing dengan harga satuannya.
- Uji ulang dengan tugas sendiri: skor benchmark pihak ketiga dan harga hanya bisa dijadikan referensi. Data pengujian langsung dengan tugas dan input yang sama lebih dapat diandalkan.
- Bandingkan biaya efektif per tugas: perhitungkan tingkat keberhasilan dan percobaan ulang, lalu susun anggaran berdasarkan jumlah tugas per bulan.
Harga model akan berubah dan model baru terus bermunculan, tetapi metode perhitungan ini bisa digunakan dalam jangka panjang. Sebelum memilih model berikutnya, coba bandingkan model menggunakan 20 sampel nyata, lalu putuskan model mana yang akan digunakan. Jika perlu beralih dengan cepat untuk menguji model dari beberapa penyedia, gunakan akses terpadu APIYI di apiyi.com dan periksa konsumsi aktual setiap model langsung melalui log pemanggilan.
📚 Referensi
- Ofox.ai Blog Halaman 23: Berisi ringkasan artikel tentang perbandingan konsumsi token DeepSeek V4 Flash dan Gemini 3.6 Flash, perbedaan harga cache, serta estimasi biaya seri Qwen
- Tautan:
ofox.ai/blog/page/23/ -
Keterangan: Artikel diterbitkan pada Agustus 2026. Data berasal dari satu kali pengukuran oleh pihak ketiga dan hanya sebagai referensi
-
Ofox.ai Blog Halaman 22: Berisi perbandingan jumlah token untuk dokumen yang sama di 9 model, perbedaan konsumsi token antarversi Claude, serta tarif DeepSeek V4 Pro berdasarkan waktu
- Tautan:
ofox.ai/blog/page/22/ -
Keterangan: Cocok untuk memahami contoh konkret perbedaan tokenisasi dan perbedaan antarversi
-
Ofox.ai Blog Halaman 25: Berisi perbandingan biaya per tugas antara Kimi K3, GLM-5.2, dan Opus 4.8
- Tautan:
ofox.ai/blog/page/25/ - Keterangan: Harga dan skor benchmark dapat berubah. Sebelum digunakan, periksa halaman harga resmi masing-masing penyedia
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs APIYI apiyi.com. Untuk panduan integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com