Catatan penulis: Menguraikan secara terpisah skor komposit pihak ketiga, daftar harga resmi, cache read, dan perbandingan per-item antara GPT-6.2 Sol dan Claude Fable 5.2, sekaligus menjelaskan angka mana yang bisa langsung dibandingkan dan mana yang tidak bisa diringkas dengan satu kalimat “siapa yang lebih unggul”.
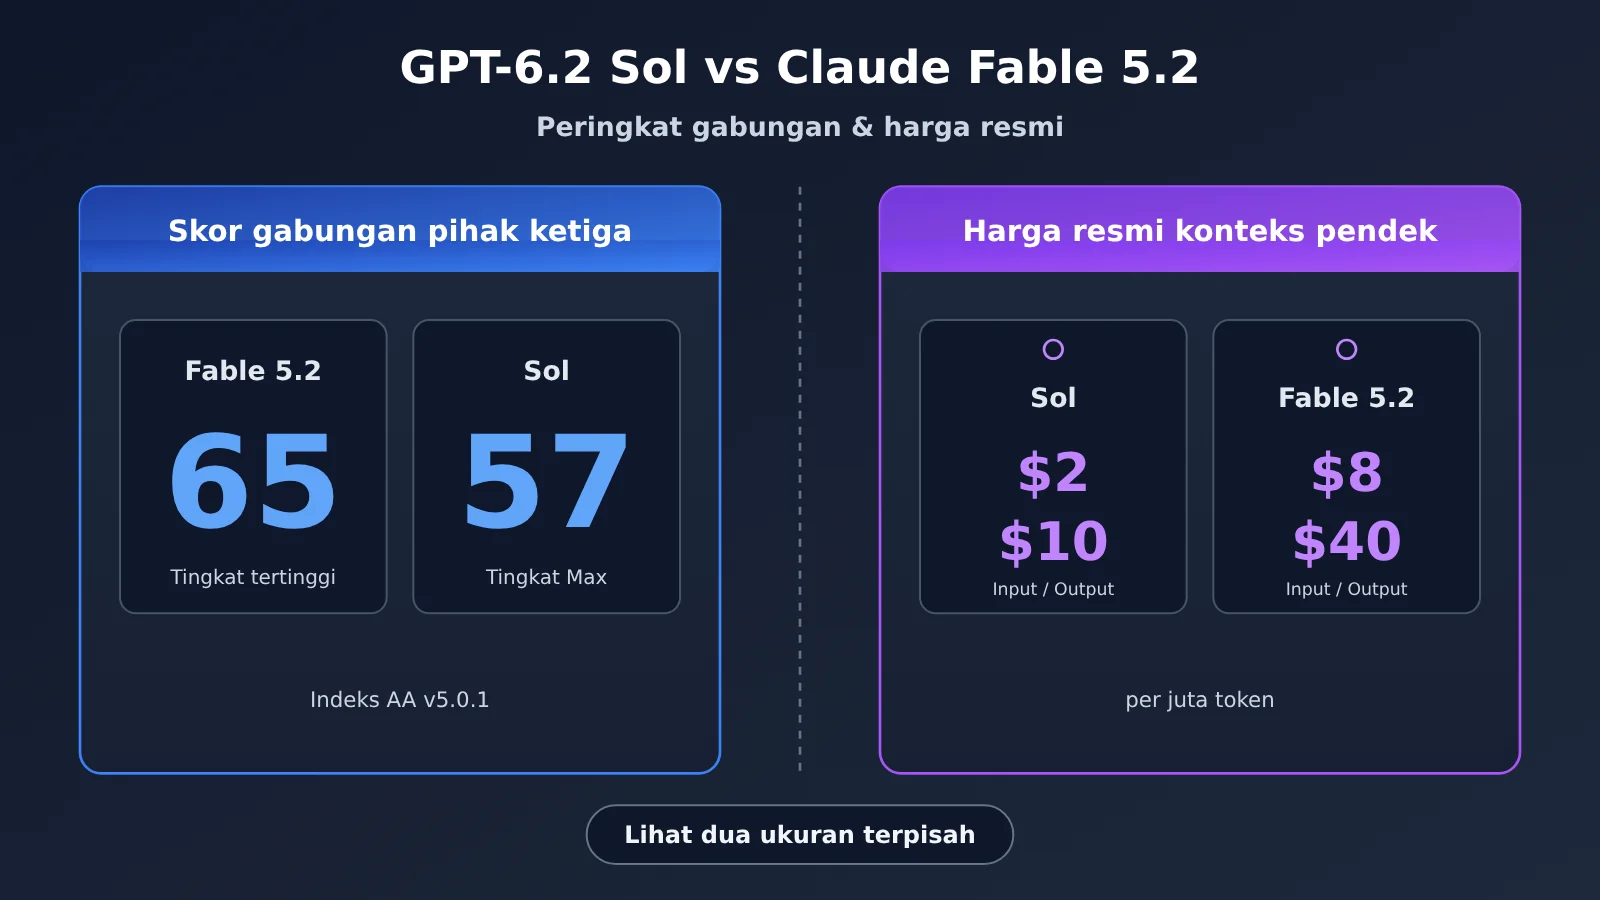
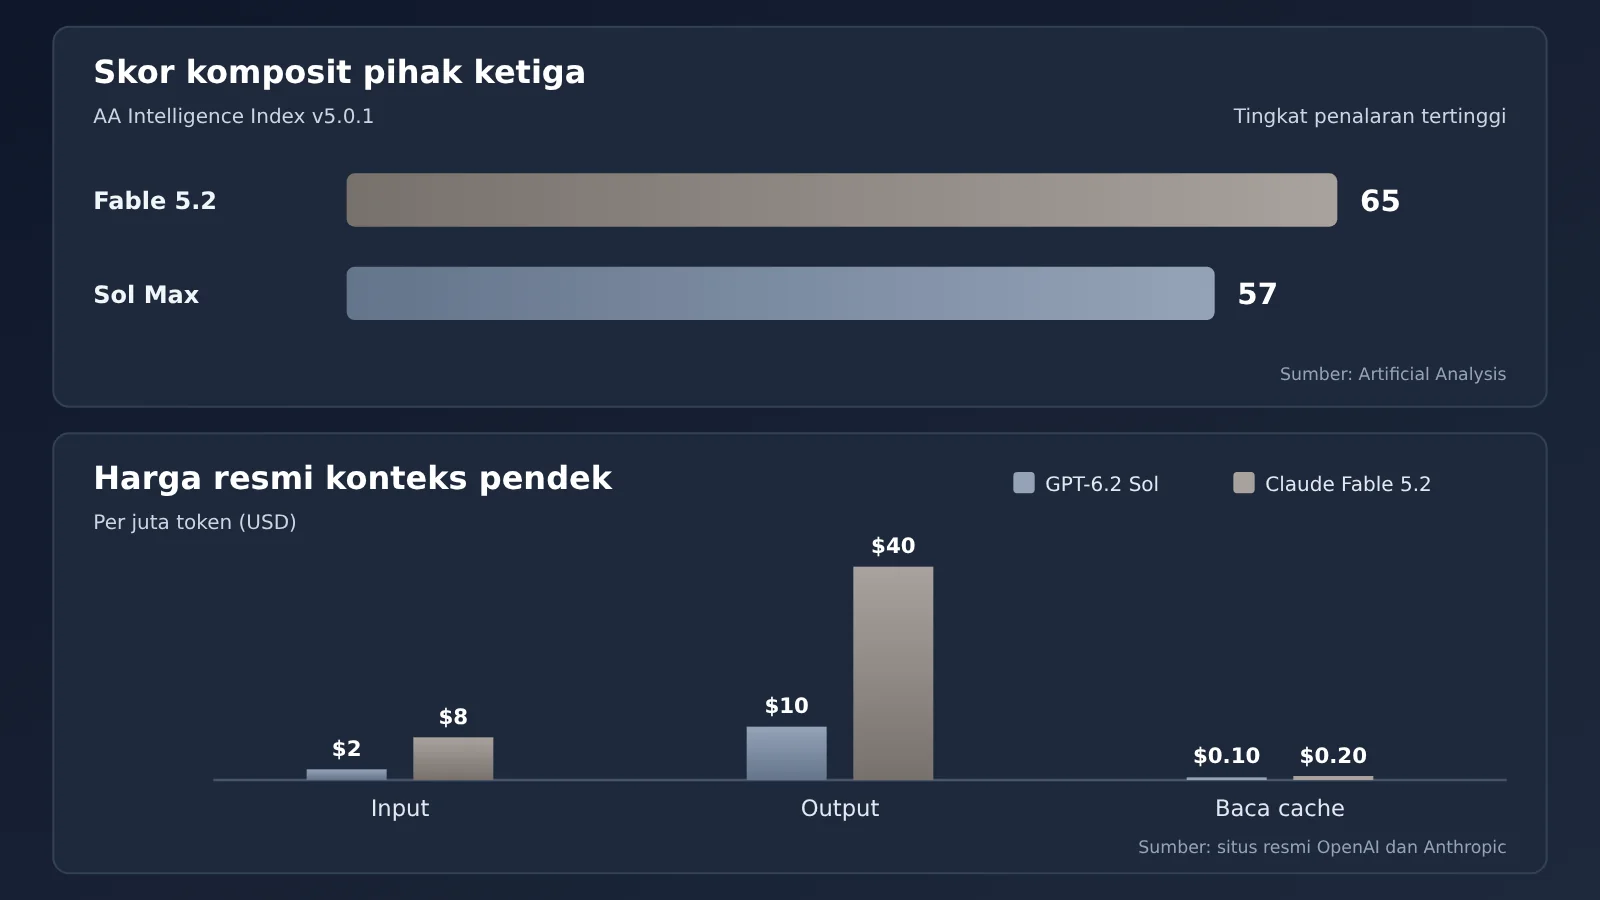
Saat menaruh GPT-6.2 Sol dan Claude Fable 5.2 berdampingan untuk dibandingkan, kesalahan yang paling mudah terjadi adalah menutupi semua angka dengan satu kesimpulan “siapa yang lebih unggul”. Pada 17 November 2026, OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol, dan lembaga pihak ketiga Artificial Analysis memperbarui papan peringkat kompositnya di hari yang sama: Claude Fable 5.2 mencetak 65 poin di tingkat penalaran tertingginya, sementara GPT-6.2 Sol mencetak 57 poin di tingkat Max. Di sisi lain, berdasarkan daftar harga konteks pendek resmi dari kedua perusahaan, harga satuan input maupun output Sol hanya seperempat dari Fable.
Selisih skornya besar, selisih harganya juga besar; keduanya sama-sama fakta, tapi tidak bisa saling meniadakan, apalagi digabung menjadi satu kesimpulan. Artikel ini bukan artikel yang memihak salah satu untukmu. Angka yang dilaporkan vendor sendiri, papan peringkat pihak ketiga, dan daftar harga resmi adalah tiga standar pengukuran yang berbeda—artikel ini membedahnya lapis demi lapis, dan secara terpisah mencantumkan item mana saja yang sebenarnya tidak punya perbandingan resmi langsung antara Sol dan Fable.
Nilai inti: Setelah membaca artikel ini, kamu akan membawa pulang tiga kelompok angka yang bisa diverifikasi—skor komposit, daftar harga, dan cache read—paham item mana yang tidak boleh dipakai untuk membandingkan Sol dengan Fable, dan bisa memutuskan data sisi mana yang perlu dicek lebih dulu sesuai tugasmu.
GPT-6.2 Sol dan Claude Fable 5.2: Poin-Poin Penting
Tabel di bawah ini memberikan angka di tingkat kesimpulan terlebih dahulu, dengan setiap baris mencantumkan acuan pengukurannya. Bab-bab berikutnya akan membahasnya baris demi baris.
| Poin | Angka | Acuan dan cara membacanya |
|---|---|---|
| Skor keseluruhan | Fable 5.2 sebesar 65, Sol (Max) sebesar 57 | Indeks pihak ketiga Artificial Analysis Intelligence Index v5.0.1, pada mode penalaran tertinggi masing-masing |
| Harga daftar input/output konteks pendek | Sol $2 / $10, Fable $8 / $40 (per 1 juta token) | Harga daftar resmi kedua perusahaan, Sol seperempat dari Fable, hanya berlaku untuk dua item ini |
| Harga daftar pembacaan cache | Sol $0.10, Fable $0.20 | Harga daftar resmi, Sol setengah dari Fable, bukan seperempat |
| Perbandingan langsung dalam materi resmi | Elo penilaian buta oleh manusia AA-3D: Sol 1259, Fable 1271 | Diutip dari sumber resmi; sebagian besar item tunggal resmi lainnya membandingkan Astra dengan Fable, atau Sol dengan model lama mereka sendiri |
| Ketersediaan di APIYI | claude-fable-5-2 sudah tersedia; gpt-6.2-sol belum tersedia |
Merujuk pada daftar model di platform |
Mengenai harga GPT-6.2 Sol di tabel: angka di atas adalah harga resmi OpenAI, model ini belum tersedia di platform, dan kami akan segera merilisnya; model dan harga mengacu pada daftar model di platform.
Mengapa Perbandingan GPT-6.2 Sol dan Claude Fable 5.2 Perlu Diurai Berlapis
Indeks gabungan memadatkan puluhan tugas menjadi satu skor, cocok untuk menjawab “secara keseluruhan ada di level mana”, tetapi tidak bisa menjawab “untuk tugas saya ini, mana yang lebih tepat”. Harga daftar menjawab berapa biaya per satu juta token, dan itu tidak sama dengan biaya untuk menyelesaikan satu tugas, karena mode penalaran, jumlah token pemikiran, serta tingkat cache hit di kedua sisi semuanya akan mengubah tagihan aktual.
Tugas individual adalah lapisan ketiga. Dalam postingan rilis OpenAI, item tunggal Fable yang disebutkan itu kebanyakan membandingkan dengan GPT-6.2 Astra, bukan dengan Sol. Memindahkan hasil Astra ke Sol adalah kesalahan pembacaan yang paling umum dalam perbandingan semacam ini, dan artikel ini akan secara khusus memisahkannya.
GPT-6.2 Sol vs Claude Fable 5.2: Perbedaan Utama
Skor Komposit Pihak Ketiga untuk GPT-6.2 Sol dan Claude Fable 5.2
Artificial Analysis adalah lembaga evaluasi pihak ketiga, jadi angka-angka di bawah ini bukan laporan sendiri dari OpenAI atau Anthropic. Lembaga ini memberi skor kepada setiap model berdasarkan tingkat penalaran (reasoning tier) masing-masing pada Intelligence Index v5.0.1, jadi saat membandingkan, pastikan mencantumkan dengan jelas tingkat mana yang dipakai.
| Model | Tingkat Penalaran | Intelligence Index v5.0.1 | Biaya Per Tugas Indeks Komposit (dari halaman model masing-masing) |
|---|---|---|---|
| Claude Fable 5.2 | Tingkat penalaran tertinggi | 65 (peringkat pertama di papan peringkat) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | Tingkat tertinggi | 60 | — |
| Claude Opus 5.5 | Tingkat tertinggi | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
Menurut Artificial Analysis, Sol naik 2 poin dari GPT-6.1 Sol hingga mencapai 57 poin, menyamai GPT-6 Astra, dengan biaya per tugas hanya sekitar 15% dari Astra. “Biaya per tugas” dalam tabel adalah pengeluaran pihak ketiga saat menjalankan rangkaian indeks ini, yang mencerminkan gabungan dari tingkat penalaran, panjang proses berpikir, dan harga resmi — bukan harga API resmi.
Perlu dicatat, OpenAI secara resmi menyatakan bahwa biaya Astra pada Agents’ Last Exam hanya sekitar 5% dari Fable — tapi itu rangkaian tugas yang berbeda. Jadi jangan mengonversi $26.54 dengan angka “5%” resmi tersebut, dan jangan pula menerapkannya pada Sol.
Harga resmi dan cache GPT-6.2 Sol dan Claude Fable 5.2
Mari mulai dari GPT-6.2 Sol. Halaman model OpenAI mencantumkan harga standar untuk konteks pendek sebagai berikut: input $2, pembacaan cache $0.10, penulisan cache (retensi 30 menit) $2.50, penulisan cache 12 jam $5, dan output $10. Model ini belum tersedia di platform kami, dan kami akan segera menambahkannya; nama model dan harga mengacu pada daftar model di platform. Dalam pengumuman peluncurannya disebutkan bahwa Sol tetap memakai harga token API yang sama dengan GPT-6.1 Sol.
Dokumentasi Anthropic untuk Claude Fable 5.2 mencantumkan harga: input $8, output $40, penulisan cache 5 menit $10, penulisan cache 1 jam $16, dan pembacaan cache $0.20. Di tabel model lengkap APIYI (apiyi.com), claude-fable-5-2 dan claude-fable-5-2-thinking tercantum dengan input, output, dan pembacaan cache sebesar $8 / $40 / $0.2, konsisten dengan harga resmi; halaman penjelasan kedua model tersebut saat ini mengembalikan 404, jadi gunakan harga di tabel lengkap sebagai acuan.
| Item harga (per 1 juta token) | GPT-6.2 Sol (resmi OpenAI) | Claude Fable 5.2 (resmi Anthropic) | Hubungan keduanya |
|---|---|---|---|
| Input (konteks pendek) | $2 | $8 | Seperempat |
| Output (konteks pendek) | $10 | $40 | Seperempat |
| Pembacaan cache | $0.10 | $0.20 | Setengah |
| Penulisan cache | 30 menit $2.50; 12 jam $5 | 5 menit $10; 1 jam $16 | Durasi retensi berbeda, tidak bisa dibandingkan langsung |
| Batch | 50% dari harga standar | Input dan output diskon 50% | Aturannya hampir sama |
| Tier akselerasi | Fast 2x harga standar; Ultrafast 3x sampai 2027-02-28, lalu 6x mulai 2027-03-01 | Fast mode input $16, output $80, kecepatan maksimal sekitar 2.5x | Mekanismenya berbeda |
Angka-angka GPT-6.2 Sol pada tabel di atas adalah harga resmi dari OpenAI. Model ini belum tersedia di platform kami, dan kami akan segera menambahkannya; nama model dan harga mengacu pada daftar model di platform.
Klaim “Sol seperempat dari Fable” hanya berlaku untuk input dan output pada konteks pendek. Halaman model OpenAI juga punya aturan tambahan: jika input dalam satu permintaan melebihi 272K token, harga satuan input dan cache digandakan, output dihitung 1.5x tarif konteks pendek, dan tarif ini berlaku untuk seluruh permintaan. Pada kondisi ini, harga satuan output Sol bukan lagi $10, jadi estimasi memakai rasio seperempat akan keliru; untuk harga konteks panjang di sisi Fable, jadikan dokumentasi Anthropic sebagai acuan.
Spesifikasi dan Antarmuka GPT-6.2 Sol dan Claude Fable 5.2
Kedua model sama-sama punya jendela konteks dalam skala jutaan, dan output maksimalnya juga sama, yaitu 128K. Perbedaannya ada di modalitas input, sakelar reasoning, dan antarmuka—dan justru bagian-bagian inilah yang menentukan cara Anda mengintegrasikannya.
| Aspek | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| Jendela konteks / Output maksimal | 1,050,000 (input maksimal 922,000) / 128,000 | 1M / 128K |
| Input / Output | Teks, gambar / Teks | Sesuai dokumentasi Anthropic |
| Batas pengetahuan | 2026-06-01 | 2026-06 |
| Pengaturan reasoning | API tidak mengizinkan reasoning effort disetel ke none | Effort bawaan high, thinking aktif dan tidak bisa dimatikan |
| Endpoint resmi | Chat Completions, Responses, Batch | Anthropic API |
| APIYI | Belum tersedia | claude-fable-5-2, claude-fable-5-2-thinking, endpoint chat, messages |
Saat memanggil Fable yang sudah tersedia di APIYI, base URL untuk jalur kompatibel OpenAI adalah https://api.apiyi.com/v1, dan nama model diisi claude-fable-5-2; kalau proyek Anda memang sudah memakai protokol Anthropic Messages, Anda juga bisa langsung menggunakan endpoint messages milik platform. Untuk urusan pengelompokan, tabel utama mencantumkan ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, dan SVIP.
GPT-6.2 Sol dan Claude Fable 5.2: Melihat Per Tugas Secara Terpisah
Ini bagian terpenting dari artikel ini. Postingan rilis OpenAI memuat cukup banyak skor per tugas, tetapi perbandingan langsung “Sol vs Fable” di dalamnya sangat sedikit. Tabel berikut merinci item demi item berdasarkan sumber dan pasangan pembandingnya.
| Item tugas | Sumber | Pasangan pembanding dan hasil | Perbandingan langsung Sol vs Fable? |
|---|---|---|---|
| Intelligence Index v5.0.1 | AA pihak ketiga, tingkat penalaran tertinggi | Fable 65, Sol (Max) 57 | Ya (skor komposit pihak ketiga) |
| AA-3D Elo (penilaian buta oleh manusia) | Kutipan resmi | Sol 1259, Fable 1271 | Ya (satu-satunya item dalam materi resmi) |
| AA-Robotics v0.1 | AA pihak ketiga, pratinjau riset | Sol 78, Fable 75 | Ya (pratinjau pihak ketiga, tingkat penalaran mengacu pada halaman AA) |
| Agents’ Last Exam | Laporan resmi sendiri | Astra 5,5 poin di atas Fable, biaya sekitar 5% | Tidak, ini Astra vs Fable |
| Harvey LAB-AA v1.1 | Laporan resmi sendiri | Tingkat kelulusan Astra lebih dari dua kali lipat Fable, biaya sekitar seperenam | Tidak, ini Astra vs Fable |
| FrontierCode 2.0 | Laporan resmi sendiri | Selisih Sol dan Astra kurang dari 0,5 poin, biaya sekitar seperlima, keduanya sama-sama tingkat Max | Tidak, ini Sol vs Astra |
| LifeVal | Laporan resmi sendiri | Sol di atas GPT-6 Astra, biaya sekitar seperetujuh | Tidak |
| GDPval v2 | Laporan resmi sendiri | Sol 5,3 poin di atas GPT-6.1 Sol | Tidak |
| Coding Agent Index | AA pihak ketiga, tingkat max | Sol 3 poin di bawah GPT-6.1 Sol | Tidak |
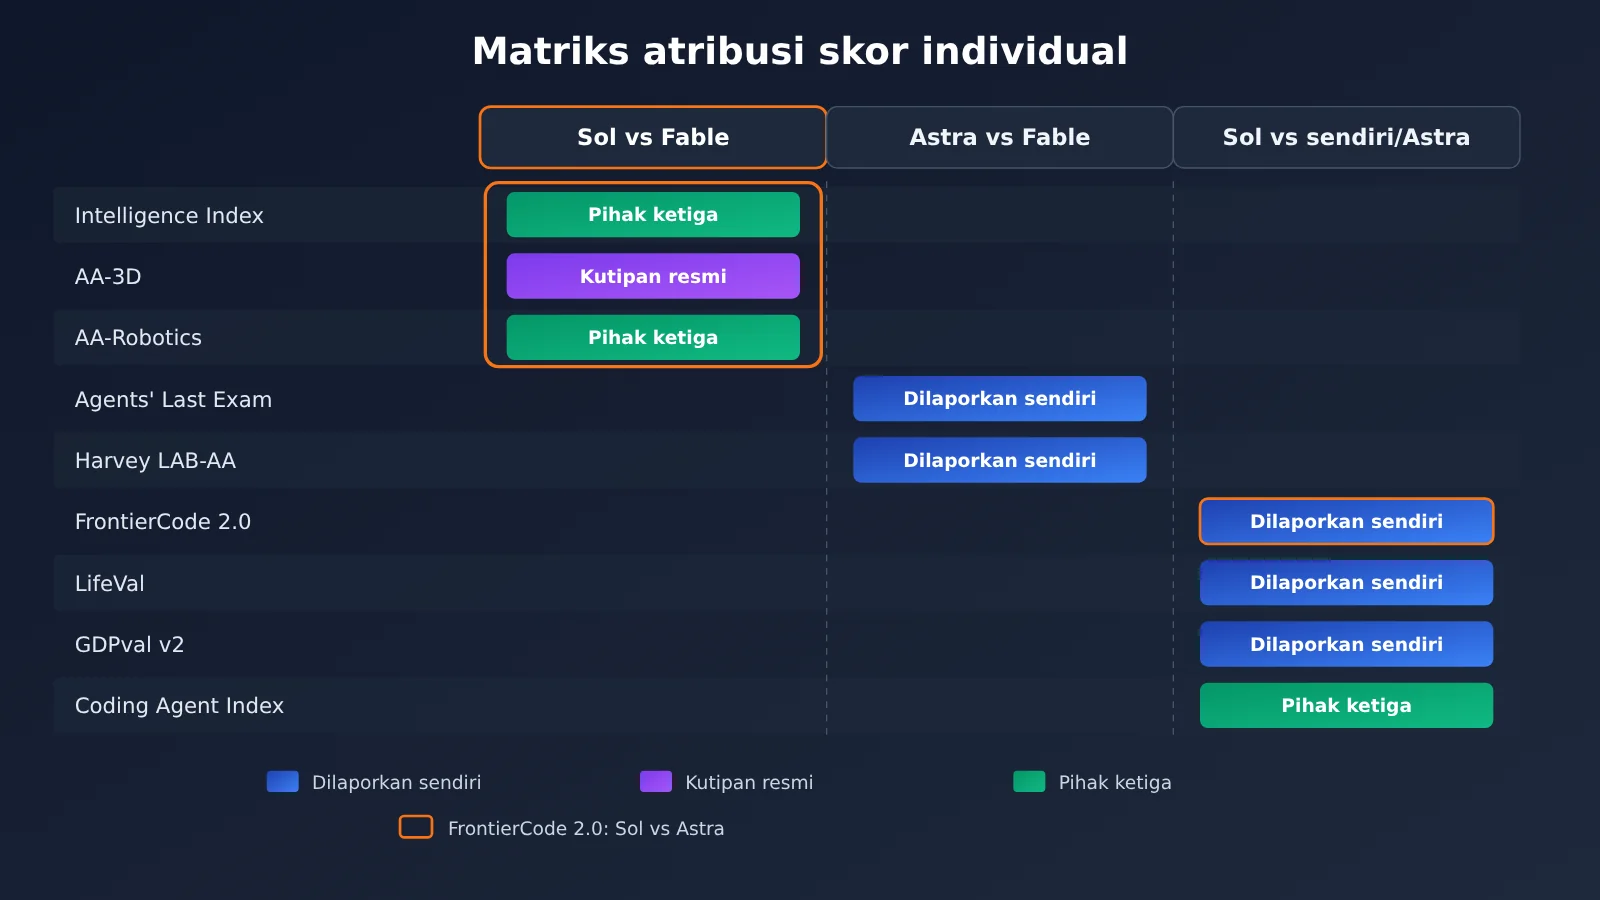
Skor FrontierCode 2.0 milik GPT-6.2 Sol tidak bisa dipindahkan untuk dibandingkan dengan Fable
FrontierCode 2.0 dirancang oleh Cognition untuk menguji apakah perubahan pada codebase nyata bisa di-merge oleh maintainer. Hasil laporan resmi sendiri menunjukkan selisih Sol dengan Astra kurang dari 0,5 poin, biayanya sekitar seperlima Astra, dan keduanya sama-sama di tingkat Max. Fable tidak terlibat di sini, jadi tidak bisa ditulis sebagai “Sol di FrontierCode hanya berbeda kurang dari 0,5 poin dengan Fable”.
Dengan logika yang sama, yang unggul atas Fable di Agents’ Last Exam dan Harvey LAB-AA adalah Astra. Bagaimana posisi Sol dibandingkan dengan Fable pada dua item ini tidak disebutkan dalam postingan rilis, jadi tidak boleh disimpulkan sendiri.
Item sains dan koding GPT-6.2 Sol dan Claude Fable 5.2
Terminal-Bench-Science 0.1 juga perlu dicermati. Laporan resmi sendiri menyebut Astra 9 poin persentase di atas GPT-6 Astra; di catatan kaki, Fable 5.2 mencantumkan dua angka—satu berasal dari pengujian Artificial Analysis yang memakai mini-swe-agent, satu lagi adalah 74,6% pada Claude Code dengan intensitas penalaran Max yang dilaporkan Anthropic. Kedua angka Fable ini berasal dari pengujian yang berbeda, tidak bisa diperlakukan sebagai satu perbandingan yang sama, dan keduanya pun bukan skor Sol.
Dari sisi pihak ketiga, Artificial Analysis menyebutkan bahwa di Coding Agent Index (Codex harness, max), Sol 3 poin lebih rendah dari GPT-6.1 Sol, terutama karena SWE-Atlas-QnA-AA turun 14 poin sehingga lebih mudah melewatkan fakta kunci. Tingkat halusinasi AA-Omniscience yang mereka ukur (Max) untuk Sol adalah 55%. Angka-angka ini tidak memiliki nilai Fable yang setara, sehingga hanya bisa dipakai untuk memahami kelemahan Sol sendiri.
Rekomendasi Skenario GPT-6.2 Sol dan Claude Fable 5.2
Bagian ini tidak akan memutuskan untuk Anda mana yang harus dipakai, hanya menjelaskan data mana yang sebaiknya dicek lebih dulu untuk setiap jenis tugas.
Tugas yang sebaiknya cek data Claude Fable 5.2 dulu
- Tugas komprehensif yang panjang, sulit, dan multi-langkah: lihat dulu skor komprehensif pihak ketiga. Fable mencatat 65 pada tingkat penalaran tertinggi di Intelligence Index v5.0.1 dan menduduki puncak peringkat — inilah data komprehensif yang saat ini bisa langsung dibandingkan dengan Sol.
- Proyek yang perlu segera diintegrasikan:
claude-fable-5-2sudah tersedia di APIYI, jadi Anda bisa langsung mengujinya dengan sampel sendiri. - Proyek yang perlu memperhitungkan overhead thinking: fitur thinking Fable aktif secara default dan tidak bisa dimatikan, dengan nilai effort default high, jadi saat menyusun anggaran pastikan token thinking ikut dihitung.
Tugas yang sebaiknya cek data GPT-6.2 Sol dulu
- Tugas sehari-hari dan tugas batch yang sensitif terhadap harga: lihat dulu harga resmi untuk jendela konteks pendek dan aturan Batch, baru lihat capaian tugas sehari-hari yang dilaporkan resmi seperti LifeVal dan GDPval v2.
- Permintaan yang umumnya berada dalam rentang 272K: selisih harga antara input Sol dan output yang harganya seperempat terutama muncul di rentang ini.
- Tim yang sudah menggunakan ChatGPT Work atau Codex: pihak resmi menyatakan Plus, Pro, Enterprise, dan Edu tersedia mulai hari ini; Pro 200 untuk pertama kalinya mendapatkan Ultrafast, yang mulai disediakan sejak Sol.
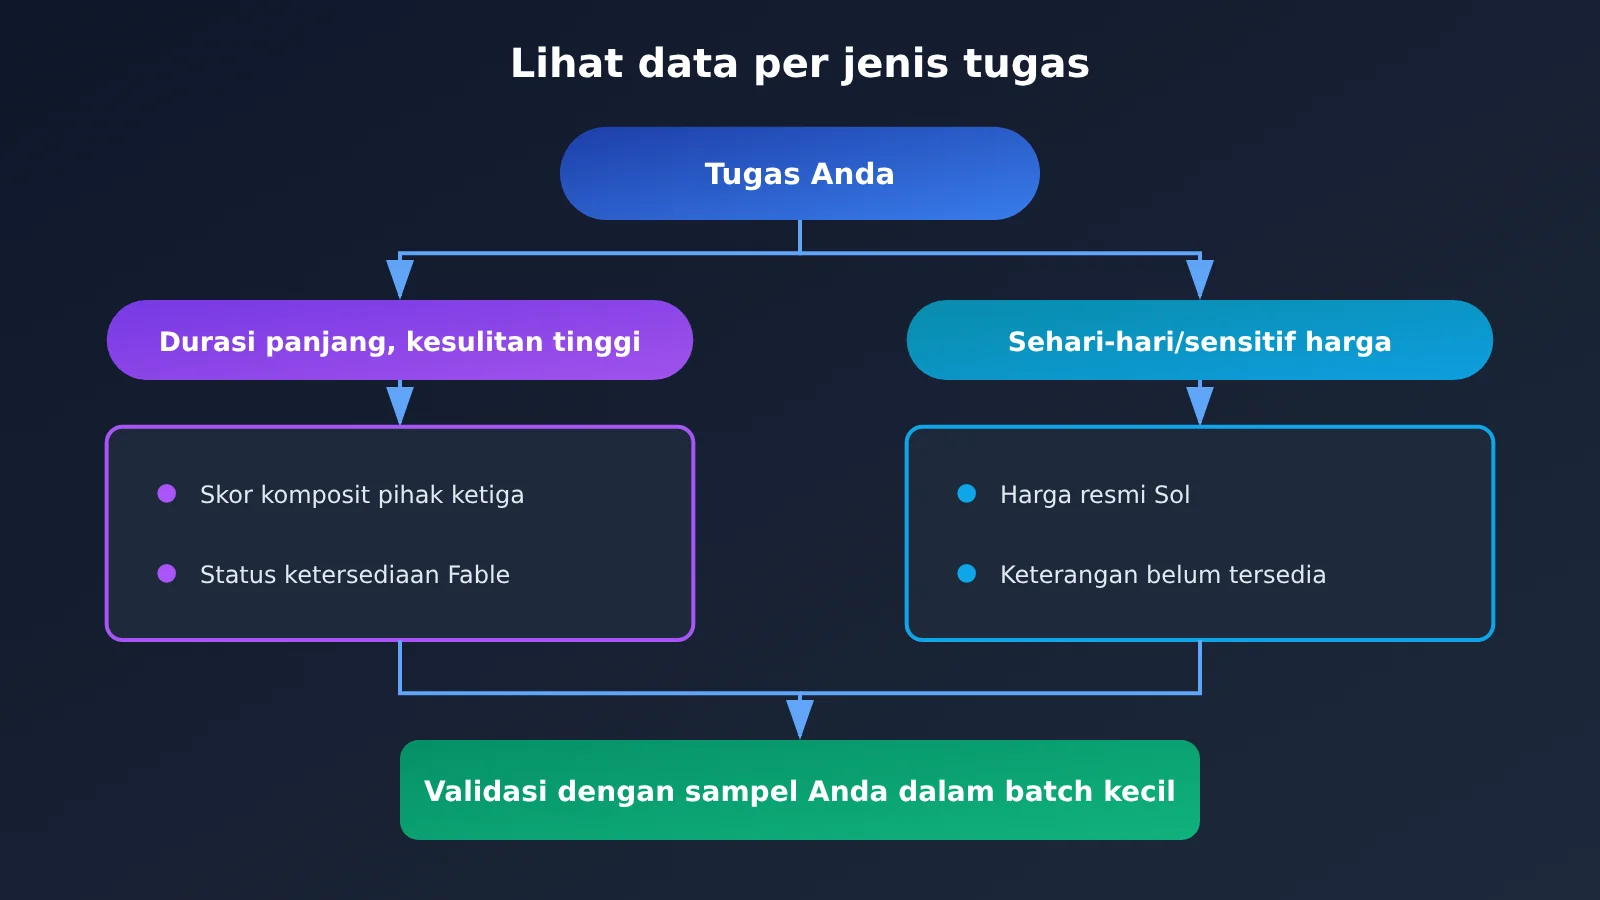
Panduan Cepat GPT-6.2 Sol dan Claude Fable 5.2
Bagian ini menyusun urutan langkah berdasarkan jenis tugas. Sepanjang artikel tidak ada kode yang ditampilkan; nama model dan alamat ditulis langsung di dalam kalimat.
Tugas jangka panjang yang sulit: periksa dulu skor gabungan dan ketersediaan Fable. Buat kunci API di konsol APIYI, ubah base URL pada SDK yang kompatibel dengan OpenAI menjadi https://api.apiyi.com/v1, lalu isi parameter model dengan claude-fable-5-2; jika ingin nama model yang secara eksplisit menyertakan mode berpikir, gunakan claude-fable-5-2-thinking. Tabel ringkasan mencantumkan harga input $8, output $40, dan cache read $0.2, sejalan dengan harga resmi Anthropic. Sebaiknya jalankan dulu 20 hingga 50 tugas nyata milik Anda sendiri untuk mencatat tingkat penyelesaian dan penggunaan token, baru putuskan apakah skor 65 benar-benar terasa di skenario Anda.
Tugas sehari-hari yang sensitif terhadap harga: baru periksa harga resmi Sol dan keterangan belum tersedianya model. Harga resmi OpenAI untuk GPT-6.2 Sol adalah input $2, cache read $0.10, dan output $10. Model ini belum tersedia di platform, dan kami akan menambahkannya sesegera mungkin; nama model dan harga mengacu pada daftar model di platform. Sebelum model itu masuk ke daftar, periksa daftar model di apiyi.com secara berkala. Jangan memakai gpt-6.1-sol atau gpt-6-sol yang ada di platform sebagai pengganti untuk pengujian, karena keduanya bukan versi 6.2, dan harga cache read gpt-6-sol juga berbeda.
Setelah Sol tersedia, ada tiga hal yang perlu diperhatikan: reasoning effort tidak boleh diatur ke none; input yang melebihi 272K akan dikenakan kenaikan harga untuk seluruh pesanan; endpoint resmi mendukung Chat Completions dan Responses, sedangkan endpoint di platform mengikuti daftar model.
🚀 Mulai Cepat: Satu kunci API yang sama bisa dipakai untuk memanggil berbagai model di platform. Sebaiknya jalankan dulu Fable di APIYI apiyi.com dengan kuota uji gratis, siapkan skrip evaluasi dan sampelnya, lalu begitu Sol tersedia, cukup ganti nama model untuk perbandingan dengan sampel yang sama.
Rekomendasi Keputusan: GPT-6.2 Sol dan Claude Fable 5.2
Berikut daftar periksa yang membantumu menempatkan angka-angka tadi kembali ke konteks tugas kamu sendiri.
- Pastikan dulu acuan perbandingannya: Angka yang dikutip itu skor gabungan dari pihak ketiga, skor per-kategori yang dilaporkan resmi sendiri, atau harga resmi? Jangan menjumlahkan ketiganya, dan jangan saling mengonversi satu sama lain.
- Periksa tingkat reasoning: Skor 57 milik Sol itu pada tingkat Max; tingkat High dapat 55, dan tingkat Low hanya 41. Kalau di praktik memakai tingkat tertentu, ya gunakan skor dari tingkat tersebut.
- Hitung berdasarkan panjang permintaan: Di bawah 272K, input dan output bisa diestimasi dengan angka seperempat; setelah melebihi 272K, hitung ulang sesuai aturan tagihan keseluruhan (per-order) dari OpenAI.
- Hitung cache secara terpisah: Cache read-nya $0.10 versus $0.20, selisihnya dua kali lipat; durasi retensi cache write juga berbeda, jadi estimasinya perlu dihitung masing-masing sesuai strategi cache kamu.
- Pastikan perbandingan per-kategori memang tersedia: Kalau kategori yang kamu pedulikan hanya punya data Astra vs Fable atau Sol vs Astra, jangan dijadikan kesimpulan untuk Sol vs Fable.
- Pertimbangkan kebijakan keamanan: Menurut keterangan resmi, kedua model 6.2 mencapai tingkat “kritis” untuk keamanan siber dalam kerangka kesiapan (Preparedness Framework), sehingga perlindungannya lebih ketat dan sebagian permintaan riset kerentanan yang sah bisa ditolak.
💡 Saran pemilihan: Model mana yang dipakai bergantung pada panjang tugas, tingkat reasoning, dan cache hit rate. Kamu bisa menjalankan batch sampel yang sama di platform APIYI untuk masing-masing model, lalu biarkan tagihan dan tingkat penyelesaian yang bicara — tidak perlu bergantung pada satu leaderboard saja.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa itu GPT-6.2 Sol dan Claude Fable 5.2?
GPT-6.2 Sol adalah model yang dirilis OpenAI pada 2026-11-17 bersama dengan GPT-6.2 Astra, dengan ID model `gpt-6.2-sol`, menerima input teks dan gambar, menghasilkan output teks, serta jendela konteks 1.050.000. Claude Fable 5.2 adalah model yang dirilis Anthropic pada 2026-11-09, dengan jendela konteks 1M, output maksimal 128K, dan mode thinking yang aktif secara bawaan serta tidak bisa dimatikan.
Q2: Di leaderboard gabungan nilainya 65 berbanding 57 — apakah itu berarti Claude Fable 5.2 unggul menyeluruh atas GPT-6.2 Sol?
Tidak. Angka 65 berbanding 57 adalah hasil pada indeks pihak ketiga Artificial Analysis Intelligence Index v5.0.1, di mana Fable menggunakan tingkat reasoning tertinggi, sementara Sol menggunakan tingkat Max. Angka tersebut mencerminkan keseluruhan level indeks ini, dan tidak berarti setiap kategori punya selisih sebesar itu. Sementara pada data Elo uji buta oleh manusia AA-3D yang dikutip dari pihak resmi, Sol 1259 dan Fable 1271, selisihnya jelas lebih kecil; sedangkan pada pratinjau riset AA-Robotics v0.1 dari pihak ketiga, Sol 78 dan Fable 75.
Q3: Apakah harga GPT-6.2 Sol benar-benar hanya seperempat dari Claude Fable 5.2?
Klaim ini hanya berlaku untuk input dan output dengan konteks pendek. Berdasarkan daftar harga resmi, Sol $2 untuk input dan $10 untuk output, sedangkan Fable $8 untuk input dan $40 untuk output. Model ini belum tersedia di platform untuk saat ini; kami akan segera menambahkannya. Model dan harga mengacu pada daftar model di platform. Untuk cache read harganya $0.10 berbanding $0.20, atau setengahnya; ketika input melebihi 272K, Sol menerapkan penambahan harga pada keseluruhan permintaan dan output menjadi 1,5 kali lipat dari harga konteks pendek — pada kondisi ini perkiraan seperempat tidak berlaku lagi.
Q4: Seberapa besar selisih GPT-6.2 Sol dan Claude Fable 5.2 di FrontierCode 2.0?
Materi resmi tidak memuat perbandingan ini. Yang dimaksud dengan “selisih kurang dari 0,5 poin” di FrontierCode 2.0 adalah perbandingan antara GPT-6.2 Sol dan GPT-6.2 Astra — keduanya sama-sama menggunakan tingkat Max, dan biaya Sol hanya sekitar seperlima. Fable tidak ikut serta dalam perbandingan ini.
Q5: Bagaimana cara memanggil GPT-6.2 Sol dan Claude Fable 5.2 melalui API?
Langkah-langkahnya sebagai berikut:
1. Daftar di APIYI (apiyi.com) dan dapatkan API Key serta kuota uji coba gratis.
2. Atur base URL SDK yang kompatibel dengan OpenAI ke alamat platform, isi kolom model dengan `claude-fable-5-2`, dan Anda bisa langsung memanggil Fable.
3. `gpt-6.2-sol` saat ini belum tersedia di platform; setelah tersedia, model dan harga mengacu pada daftar model di platform, lalu lakukan pengujian dengan set sampel yang sama.
Q6: Apa saja keterbatasan yang diketahui dari GPT-6.2 Sol dan Claude Fable 5.2?
Di sisi Sol: hasil pengujian pihak ketiga AA menunjukkan tingkat halusinasi 55% pada tingkat Max, dan skor Coding Agent Index-nya 3 poin lebih rendah dibanding GPT-6.1 Sol, terutama karena model ini lebih mudah melewatkan fakta-fakta penting; reasoning effort tidak bisa diatur ke none; proteksi keamanan sibernya lebih ketat, sehingga sebagian riset kerentanan yang legal bisa ditolak. Di sisi Fable: thinking tidak bisa dimatikan, effort bawaannya high, dan thinking token ikut diperhitungkan dalam biaya; harga satuan Fast mode adalah $16 untuk input dan $80 untuk output.
Q7: Pihak resmi menyebut biaya Astra hanya 5% dari Fable — bisakah angka ini dicocokkan dengan $26.54 versi pihak ketiga?
Tidak bisa. Angka “sekitar 5%” adalah biaya Agents’ Last Exam yang dilaporkan sendiri secara resmi, dengan objek perbandingan Astra dan Fable; sedangkan $26.54 adalah biaya per tugas Fable saat Artificial Analysis menjalankan indeks komprehensifnya. Keduanya berbeda tugas dan berbeda sumber, jadi tidak bisa saling dibagi, dan juga tidak bisa dipakai untuk memperkirakan biaya Sol. Kalau hanya ingin mengetahui besaran kasarnya saja, mencatat tagihan aktual dengan sampel sendiri di platform APIYI akan lebih andal.
Poin-Poin Utama GPT-6.2 Sol dan Claude Fable 5.2 (Key Takeaways)
- Skor komprehensif: Dalam indeks AA dari pihak ketiga, Fable di tingkat penalaran tertinggi mencapai 65, sedangkan Sol di tingkat Max mencapai 57 — keduanya menjadi perbandingan langsung dalam papan peringkat yang sama.
- Harga resmi: Untuk input dan output konteks pendek, Sol hanya seperempat dari Fable ($2 vs $8, $10 vs $40).
- Baca cache: $0.10 vs $0.20, hanya berbeda separuhnya, jadi rasio seperempat tidak bisa diterapkan di sini.
- Konteks panjang: Begitu input Sol melebihi 272K, kenaikan harga berlaku untuk keseluruhan permintaan, sehingga rasio semula tidak berlaku lagi.
- Perbandingan langsung terbatas: Dalam materi resmi, Sol vs Fable hanya ada satu item, yaitu AA-3D dengan skor 1259 vs 1271.
- Jangan salah gunakan skor: FrontierCode 2.0 adalah perbandingan Sol vs Astra, sedangkan ALE dan Harvey adalah Astra vs Fable.
- Ketersediaan: Fable bisa langsung dipanggil melalui APIYI di apiyi.com, sedangkan Sol belum tersedia untuk saat ini — silakan merujuk ke daftar model sebagai acuan.
Ringkasan
Kalau mau membandingkan GPT-6.2 Sol dengan Claude Fable 5.2, kuncinya adalah memisahkan tiga lapis angka:
- Skor komposit pihak ketiga: Fable 65, Sol (Max) 57, dipakai untuk menilai posisi keseluruhan keduanya berada di tingkatan yang mana.
- Harga resmi: input dan output untuk konteks pendek berbeda seperempat, cache read berbeda separuh, sementara konteks panjang dihitung terpisah sesuai aturan masing-masing.
- Hasil per tugas: sebagian besar hasil per tugas resmi bukan perbandingan langsung Sol vs Fable, jadi pastikan dulu siapa saja yang dibandingkan sebelum mengutip.
Perbedaan skor dan perbedaan harga tidak bisa dipadatkan menjadi satu kalimat “mana yang lebih sepadan”. Cara yang lebih aman: gunakan sampel sendiri, tetapkan tingkat penalaran secara konsisten, lalu catat tingkat penyelesaian dan tagihan masing-masing secara terpisah. Fable bisa langsung diuji sekarang di APIYI apiyi.com; GPT-6.2 Sol belum tersedia — kami akan menambahkan model ini sesegera mungkin, dan jenis model serta harga mengacu pada daftar model di platform.
📚 Referensi
-
Pengumuman rilis OpenAI: catatan rilis GPT-6.2 Astra dan Sol beserta hasil per tugas yang dilaporkan resmi
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: ringkasan hasil per tugas yang dilaporkan sendiri oleh resmi, cakupan ketersediaan, dan harga resmi
- Tautan:
-
Halaman model OpenAI – GPT-6.2 Sol: spesifikasi, harga resmi, dan aturan penagihan 272K
- Tautan:
platform.openai.com/docs/models/gpt-6.2-sol - Keterangan: harga cache write, biaya tambahan konteks panjang, dan pengali tingkat akselerasi mengacu ke sumber ini
- Tautan:
-
System Card OpenAI: evaluasi keamanan GPT-6.2 Astra dan Sol
- Tautan:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Keterangan: klasifikasi Preparedness Framework dan evaluasi alignment
- Tautan:
-
Artikel dan halaman model Artificial Analysis: Intelligence Index v5.0.1 dari pihak ketiga
- Tautan:
artificialanalysis.ai/models/claude-fable-5-2 - Keterangan: skor komposit per tingkatan, biaya per tugas, dan Coding Agent Index
- Tautan:
-
Dokumentasi Anthropic – Claude Fable 5.2: harga resmi dan spesifikasi
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: cache write, cache read, Fast mode, dan pengaturan effort
- Tautan:
-
Tabel lengkap model APIYI: model yang tersedia di platform beserta harganya
- Tautan:
docs.apiyi.com/models.md - Keterangan: waktu data 2026-11-17 15:54 (UTC+8), jenis model dan harga mengacu pada daftar model di platform
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs resmi APIYI. Untuk informasi lebih lanjut tentang model dan API, silakan cek pusat dokumentasi docs.apiyi.com