作者注:本文逐项解读 Gemini Omni 1.2 Flash 的 15 秒时长、参考遵循、多轮编辑、语音与镜头控制,以及降价 30% 和官方承认的短板,帮开发者判断是否把它纳入视频生成方案评估。
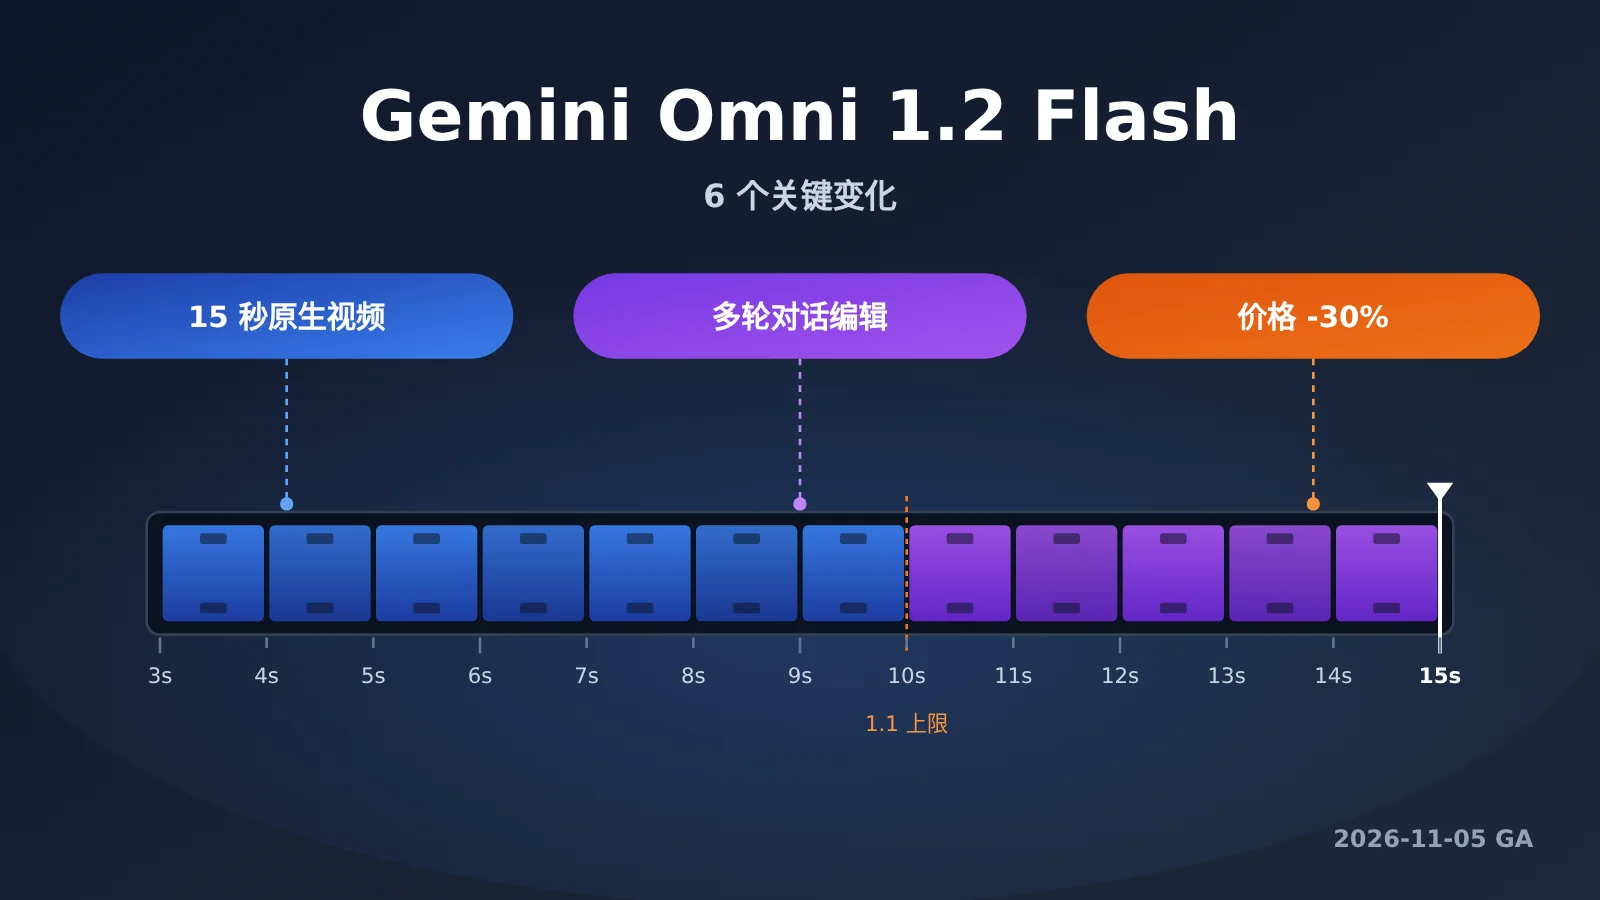
Google 于 2026 年 11 月 5 日发布 Gemini Omni 1.2 Flash,并在 Gemini API 与 Gemini for business 上同步 GA。这一版带来 原生 15 秒视频、多轮对话式编辑、720p 每秒 0.07 美元(较 1.1 降价 30%) 三项核心更新,参考遵循、一致性、语音和镜头控制也有改进。
这不是坊间传言,以上信息均来自 Google 官方博客的发布文章,由 Google DeepMind 产品经理署名。不过官方文章偏重效果展示,对开发者真正关心的参数、模型 ID 和速率限制着墨很少。本文会把营销表述还原成规格与边界,并标出哪些仍需你在自己的素材上验证。
核心价值:用几分钟弄清 Gemini Omni 1.2 Flash 相比 1.1 改了什么、哪些是 API 能力、哪些只是 Google 应用内的功能,以及现在值不值得投入评估。
Gemini Omni 1.2 Flash 核心信息速览
先用一张表把发布要点汇总清楚。表中所有内容都来自官方发布文章,没有提到的参数(模型 ID、接口形式、速率限制等)我们没有填写,留到后文的“待验证”部分。
| 信息项 | Gemini Omni 1.2 Flash 详情 |
|---|---|
| 发布时间 | 2026-11-05,同日 GA(正式可用) |
| 发布方 | Google / Google DeepMind |
| 视频时长 | 3–15 秒,按 1 秒为单位设定(1.1 版本上限 10 秒) |
| 价格 | 720p 每秒 0.07 美元(视频输出每 100 万 tokens 12 美元、720p 每秒 5,792 tokens 折算),较 Omni 1.1 下降 30% |
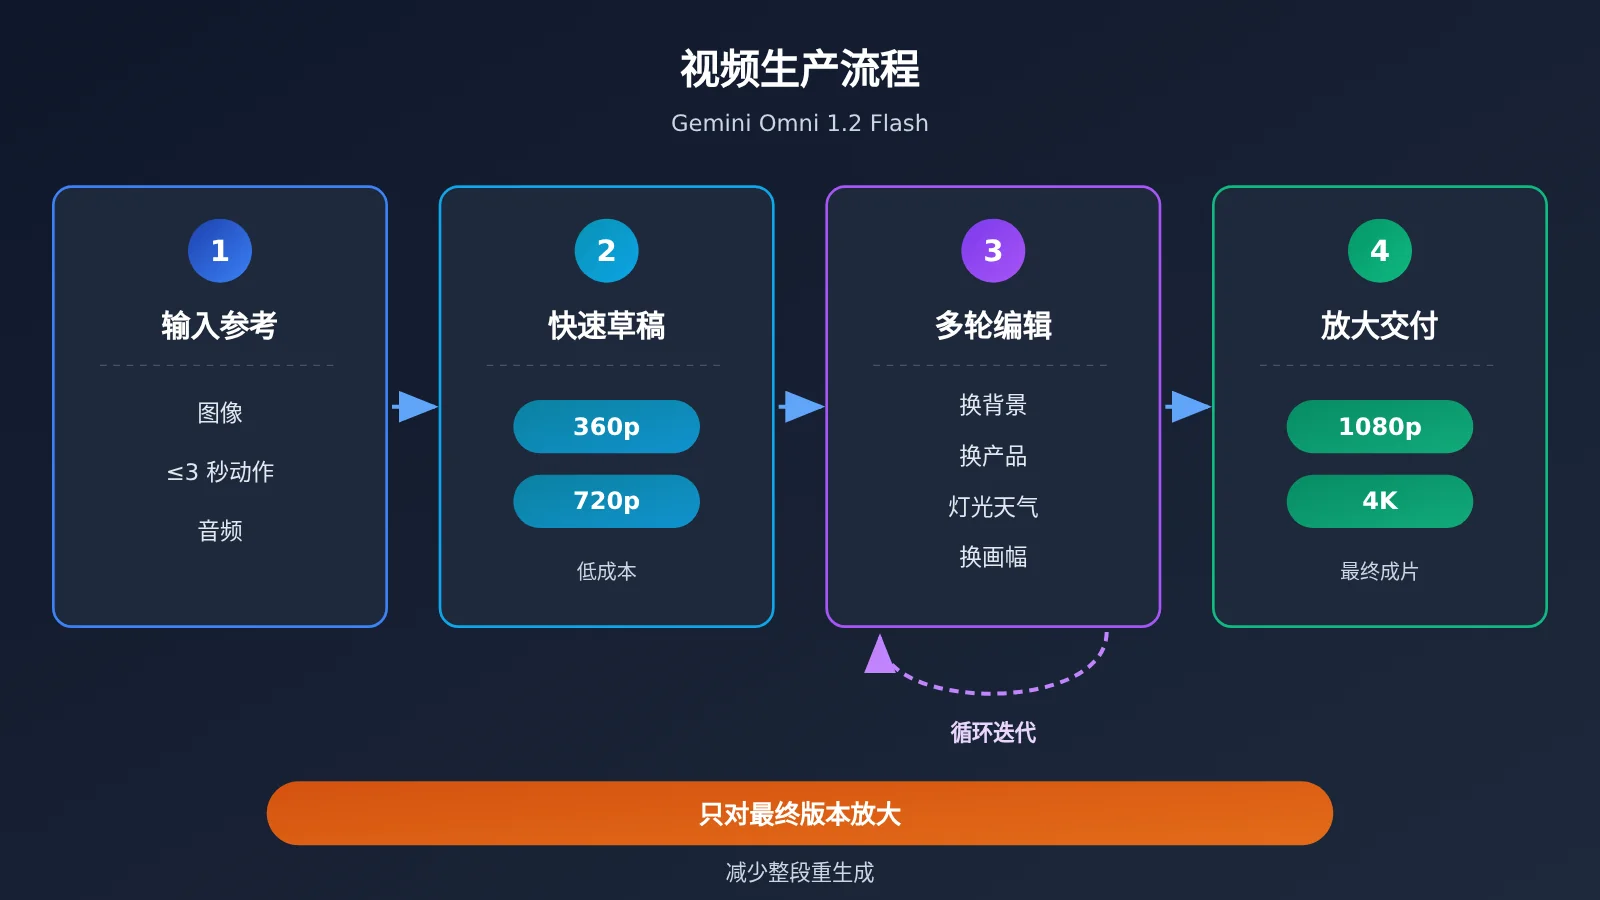
| 分辨率工作流 | 先用 360p / 720p 快速出稿,再把满意结果放大到 1080p 或 4K |
| 参考输入 | 角色/产品/风格图像、最长 3 秒的动作片段、音频提示 |
| 编辑方式 | 多轮对话式编辑,覆盖完整 15 秒片段 |
| 企业能力 | 基于 Google Cloud 基础设施,提供 Provisioned Throughput |
| 内容标识 | 输出内嵌不可感知的 SynthID 水印 |
| 官方承认的短板 | 快速体育动作、快速的脚本变化、复杂物理仍在改进中 |
Gemini Omni 1.2 Flash 的 GA 与 Provisioned Throughput 是什么意思
官方特别强调,这是 Gemini Omni 第一次达到 GA 状态。对开发者来说,GA 代表模型离开了预览或实验阶段,可以放心用在生产环境,通常也意味着接口和行为会比预览版更稳定。
Provisioned Throughput 是 Google Cloud 的预留吞吐能力:企业预先购买一定的处理容量,换取高峰期更可预期的可用性和延迟。如果你的业务需要批量生成广告素材,或者对出片时效有 SLA 要求,这一点比单价更重要。发布文章没有给出它的具体计费方式,需要到 Google Cloud 的定价页确认。
Gemini Omni 1.2 Flash 相比 1.1 的 6 个关键变化
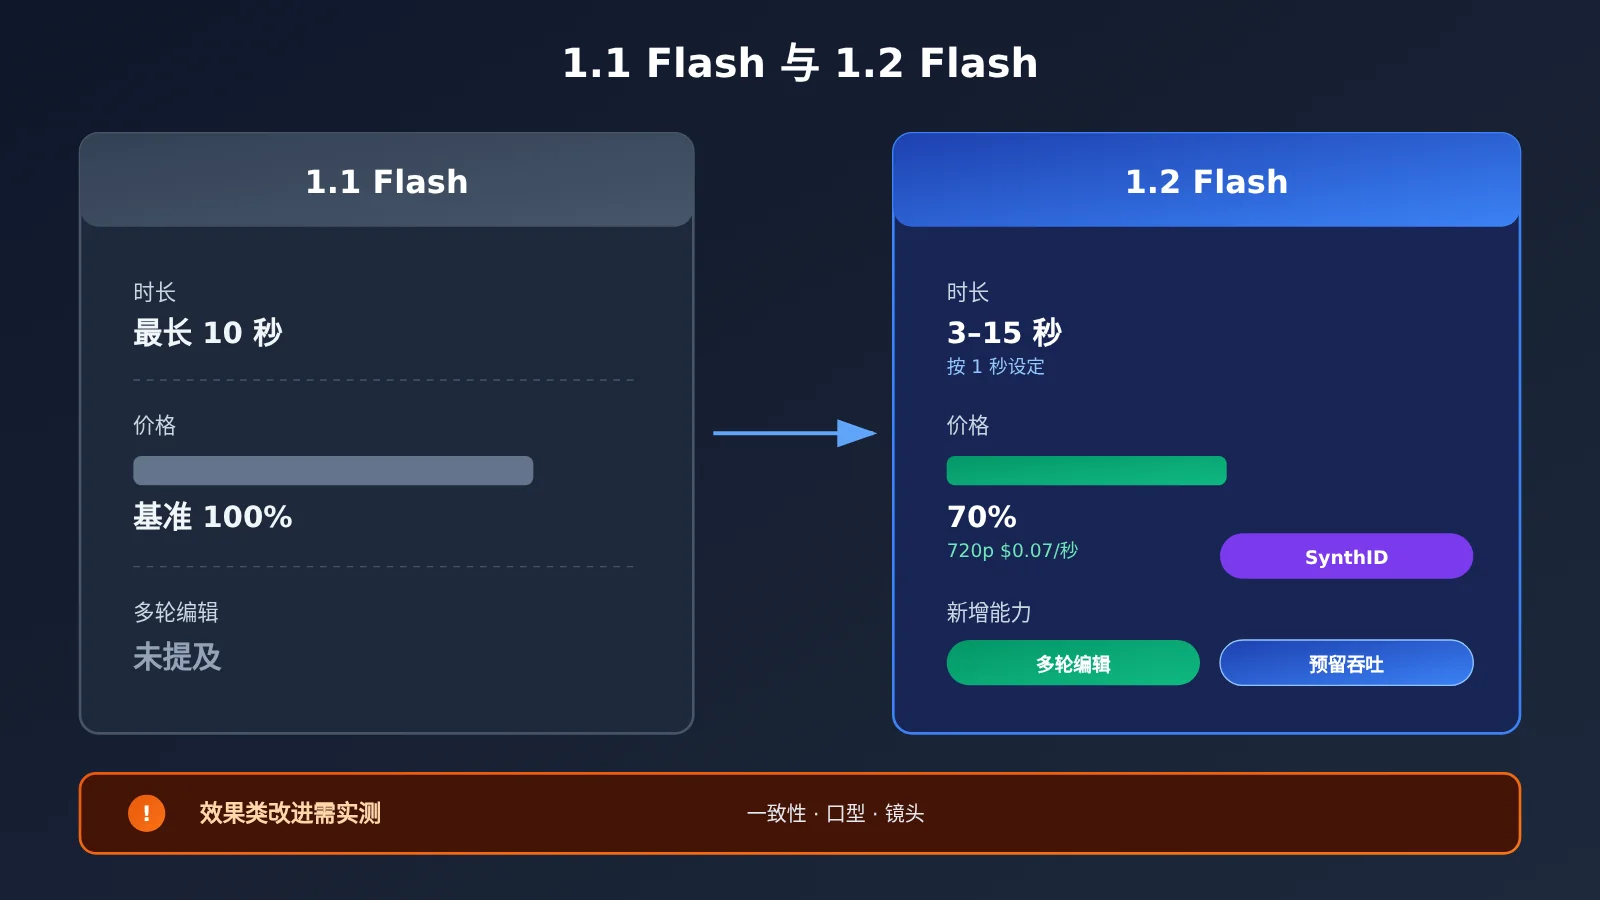
官方文章用了大量示例视频来说明进步,我们把这些描述整理成开发者视角的变化清单,并区分“可量化的规格变化”和“效果层面的改进”。前者可以直接写进技术方案,后者必须实测。
| 维度 | Gemini Omni 1.1 Flash | Gemini Omni 1.2 Flash | 变化类型 |
|---|---|---|---|
| 最长时长 | 10 秒 | 15 秒,3–15 秒按 1 秒设定 | 规格变化 |
| 720p 价格 | 0.10 美元/秒(视频输出每 100 万 tokens 17.50 美元) | 0.07 美元/秒(视频输出每 100 万 tokens 12 美元) | 价格变化 |
| 参考遵循 | 官方示例中对参考图贴合度较弱 | 面部、服装、包装字体、品牌色跨机位保持一致 | 效果改进 |
| 首尾帧一致性 | 示例中出现屋顶的猫、汤勺变筷子等细节偏差 | 细节漂移和形变更少 | 效果改进 |
| 多轮编辑 | 发布文章未提及 | 可逐轮替换产品/背景、灯光/天气、画幅比例 | 新增能力 |
| GA 状态 | 非 GA | 首次 GA,支持 Provisioned Throughput | 规格变化 |
💡 定价说明:Google 的视频输出按 token 计费,不按秒,所以文中的「每秒多少钱」都是折算值。两个数字都来自 Gemini API 定价页:1.1 的视频输出每 100 万 tokens 17.50 美元,1.2 是 12 美元;按 720p 每秒 5,792 个输出 tokens 折算,分别约 0.10 美元/秒和 0.07 美元/秒,降幅约 30%。定价页还说明,从 2026 年 12 月 3 日起,发给 gemini-omni-1.1-flash 的请求会自动路由到 1.2,并按 1.2 的价格计费。
变化一:Gemini Omni 1.2 Flash 支持 3–15 秒灵活时长
时长从 10 秒提升到 15 秒,看起来只多了 5 秒,但对很多场景是质变。一条完整的社交广告、一个产品功能讲解、一个带起承转合的短故事,往往卡在 12–15 秒这个区间,以前要拼接两段,现在可以一次生成。
另一个容易被忽略的细节是按 1 秒为单位设定时长。按秒计费的模型里,能精确指定 7 秒就不必为 10 秒付费,这对批量生成的成本控制很有意义。
变化二:参考遵循覆盖图像、动作片段与音频
1.2 Flash 允许组合多种参考:角色、产品或风格图像,最长 3 秒的动作片段,以及音频提示。官方示例里,用一张模特照加三套服装的正反面产品图,生成了 15 秒的虚拟试穿视频,模特身份和每件衣服的剪裁、垂坠、背部细节在 360 度转身中保持一致。
这类能力最直接的落地方向是电商:把现有的产品摄影或角色设定图,转成试穿片段、商品 360 度展示和品牌广告。需要注意,“动作片段最长 3 秒”是硬约束,如果你的动作参考素材更长,需要提前裁剪。
变化三:首尾帧与片段延长的一致性提升
官方称角色、物体和场景从第一帧到最后一帧都更稳定,运动和镜头切换时的视觉漂移、形变更少。这同时适用于两种用法:在首帧和尾帧之间插值,以及延长已有片段来构建更长的序列。
有意思的是,官方在 1.1 与 1.2 的首尾帧对比中坦诚指出了细微差异,比如屋顶上的猫、汤勺变成筷子等。这说明一致性是“明显改善”而非“彻底解决”,对细节敏感的场景依然需要人工检查。
变化四:Gemini Omni 1.2 Flash 的多轮对话式编辑
这是本次更新对工作流影响最大的一项。你可以对同一段视频逐轮修改,比如替换产品或背景、改变灯光或天气、切换画幅比例,而不必从头重新生成。官方示例从一段生成视频出发,连续五轮更换背景,两位角色的表演、盔甲反光和镜头构图都保持不变。
多轮编辑覆盖完整 15 秒片段,官方给出的典型用途是为不同受众和投放位置批量做广告变体。另一个示例是“动作迁移”:第一轮生成一只摆动的章鱼,第二轮替换成一位舞者,舞裙复刻了章鱼的流体运动。
变化五:更自然的语音与多人对话
1.2 Flash 的对话更流畅,口型同步更清晰,并支持区分多个说话人。官方示例用一张场景图配合四组角色、口型和 1 秒语音参考,让每段采样声音分配到正确的角色。
需要区分的是,官方在这一节提到的落地形态大多是 Google 应用:Flow 里的多角色对话、Gemini for business 里的讲解视频、Google Vids 里带虚拟形象和旁白的成片。语音能力在 API 层面如何调用、参数怎么传,发布文章没有说明。
变化六:更可控的连续镜头运动
官方称复杂的连续运镜(FPV 穿越、戏剧性拉远、环绕)中,非预期的跳切明显减少,比例更稳定。示例包括依据两张建筑照片完成一条从广场穿过铜门、上升到万神殿穹顶的无剪辑 FPV 飞行,以及一个 10 秒从海岸特写拉到岛屿全景的连续镜头。
Gemini Omni 1.2 Flash 的成本工作流如何运作
降价 30% 只是一部分,官方更强调的是一套“控制总成本”的工作流:低分辨率快速出稿 → 用多轮编辑修细节 → 只对最终满意的版本做放大。这和过去“不满意就整段重生成”的做法相比,能显著减少废片开销。
在 Google AI Studio 里,这个模型的卡片显示的是 token 价:输入每 100 万 tokens 1.50 美元、文本输出每 100 万 tokens 9 美元、视频输出每 100 万 tokens 12 美元。这和上文「每秒 0.07 美元」是同一笔账,只是计费单位不同。官方定价页按 720p 每秒 5,792 个输出 tokens 折算成秒价,其他分辨率也一并给出:
- 360p:每秒 1,931 个输出 tokens,约 0.023 美元/秒
- 720p:每秒 5,792 个输出 tokens,约 0.07 美元/秒
- 1080p(升采样):每秒 8,688 个输出 tokens,约 0.104 美元/秒
- 4K(升采样):每秒 17,376 个输出 tokens,约 0.209 美元/秒
按 720p 的单价,单段成本大致是这样:
| 时长 | 720p 单段成本(0.07 美元/秒) | 典型用途 |
|---|---|---|
| 3 秒 | 约 0.21 美元 | 镜头测试、动态封面 |
| 6 秒 | 约 0.42 美元 | 短信息流广告 |
| 10 秒 | 约 0.70 美元 | 产品亮点展示 |
| 15 秒 | 约 1.05 美元 | 完整广告、产品讲解 |
多轮编辑每一轮是否按完整时长计费,发布文章没有说明,这会直接决定“编辑比重生成更省钱”的幅度。建议在小规模试用时记录每轮的实际扣费。
视频生成的另一大成本是提示词反复试错。很多团队会先用文本大模型把创意 brief 拆成分镜脚本和逐轮编辑指令,再交给视频模型执行,以减少无效生成。最简版本用 OpenAI 兼容接口调用文本模型,一次产出多轮编辑提示词:
- 装好 SDK:在 Python 里
import openai,再用openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")建客户端。base_url 指向 API易 的 OpenAI 兼容接口,Key 用控制台里的那把。 - 选写提示词的模型:把
YOUR_TEXT_MODEL换成平台模型列表里可用的 Gemini、GPT 或 Claude 文本模型。这一步只负责写提示词,视频模型另外调用。 - 把 brief 作为一条 user 消息发出去:
messages=[{"role": "user", "content": "为一段 15 秒运动鞋广告写 4 轮编辑指令:换背景、换天气、换灯光、切 9:16"}],连同模型 ID 一起传给client.chat.completions.create(...)。 - 读回结果:
print(resp.choices[0].message.content)就是那几轮指令,按顺序一轮一轮喂给视频模型,让后一轮在前一轮的成片上改,而不是整段重生成。
想让同一份脚本服务不同 brief,就看下面这版固定了输出结构的写法。
- 写系统提示词:用 Python 字符串定义,让模型扮演视频广告分镜师,只输出 JSON,三个键分别是
duration_sec(3 到 15 的整数)、base_prompt(首轮生成提示词)、edit_turns(第 2 轮及之后的编辑指令)。再加一条规则:每轮只改一个变量(背景、产品、灯光、天气或画幅),角色和镜头不变。 - 定义函数
build_video_plan(brief, variants, model="YOUR_TEXT_MODEL"),入参是创意 brief 和想要的变体列表。 - 拼 user 消息:用 f-string,把 brief 接在
创意简报:后面,把变体用逗号拼在需要的变体:后面。 - 一次发两条消息给文本模型:系统提示词放
system,拼好的字符串放user,并加response_format={"type": "json_object"},让回复能直接解析成 JSON。 - 解析并收敛时长:先
plan = json.loads(resp.choices[0].message.content),再plan["duration_sec"] = max(3, min(15, int(plan.get("duration_sec", 15)))),因为这个模型的时长是 3 到 15 秒、按 1 秒步进。 - 拿真实 brief 跑一次:比如「跑步鞋新品,城市晨跑,强调轻量与回弹」,变体给「雨天街道」「黄昏海边」「切换 9:16 竖屏」,用
json.dumps(plan, ensure_ascii=False, indent=2)打印出来。 - 交给视频模型:把
base_prompt和edit_turns传给你用的视频 API,按顺序执行每一轮。批量跑很多轮之前,先记下每轮实际扣费。
🚀 快速上手建议:分镜和编辑指令的生成适合交给文本模型批量完成。你可以通过 API易 apiyi.com 用同一个 API Key 对比不同文本模型写提示词的质量,新用户有免费测试额度。需要说明的是,Gemini Omni 视频模型本身请以 Google 官方渠道为准;API易 是否已接入该视频模型,请以平台模型列表为准。
Gemini Omni 1.2 Flash 对开发者的影响分析
区分 Gemini Omni 1.2 Flash 的 API 能力与 Google 应用功能
官方文章把 API、云平台和多个 Google 应用混在一起介绍,评估时很容易误判“某个功能能不能用 API 调”。下表按渠道拆开,便于对照。
| 渠道 | 面向人群 | 官方描述的能力 | 选型注意 |
|---|---|---|---|
| Gemini API / Google AI Studio | 开发者 | GA,可在 AI Studio 原型验证,有交互式 starter apps 和开发者文档 | 具体参数、模型 ID、速率限制需查官方文档 |
| Google Cloud 控制台 | 企业 | GA,企业级基础设施与安全,Provisioned Throughput | 适合有 SLA 和批量需求的团队 |
| Flow | 创作者 | 场景导演、多轮编辑、多角色对话 | 应用内功能,不等同于 API 能力 |
| Google Vids | Google 账号 / Workspace 用户 | 15 秒片段,无额外费用 | 应用内功能,适合非技术团队试效果 |
| Gemini 应用 | Google AI Ultra 订阅用户 | 15 秒视频,逐步推送中 | 推送节奏可能因地区和账户而异 |
| Google Ads | 广告投放团队 | 扩展视频营销活动 | 面向投放场景 |
| 文本辅助(分镜/提示词) | 开发者 | 非 Omni 官方渠道,用文本模型生成脚本与编辑指令 | 可通过 API易 apiyi.com 等平台调用多种文本模型 |
对应用开发者的影响
- 工作流设计会变化:多轮编辑让“生成一次、编辑多次”成为可行模式,产品里可以设计类似聊天的视频修改界面,而不是每次都让用户重写完整提示词。
- 成本模型需要重算:按秒计费加 1 秒粒度的时长设定,配合低分辨率草稿,单位成本有下降空间,但编辑轮次的计费规则必须先弄清。
- 合规更省心:SynthID 水印默认内嵌,对需要标识 AI 生成内容的平台是加分项。
对内容创作者和产品负责人的影响
- 电商与品牌素材最受益:参考遵循和一致性的提升,正好对应虚拟试穿、商品 360 度展示、多版本广告变体这几类高频需求。
- 短板场景暂缓重押:官方明确说快速体育动作、快速的脚本变化、复杂物理仍在改进,体育、动作类内容和强物理交互的镜头暂不适合作为主力方案。
Gemini Omni 1.2 Flash 选型自查清单
官方示例都是精心挑选的展示案例,独立的效果测试目前还很少。以下事项建议在你自己的素材上逐一验证后,再决定是否纳入方案。
| 验证项 | 为什么要测 | 建议做法 |
|---|---|---|
| 参考一致性 | 官方示例不等于你的产品图和角色设定 | 用自有产品图、带文字的包装做 10–20 次生成,统计变形率 |
| 快速运动与复杂物理 | 官方承认的短板 | 专门准备跑跳、碰撞、液体等镜头测试 |
| 多轮编辑的稳定性 | 轮次越多越可能累积漂移 | 连续编辑 5 轮以上,检查角色与构图是否保持 |
| 编辑计费规则 | 决定实际省钱幅度 | 小额试用,记录每轮扣费 |
| 接口参数与速率限制 | 发布文章未给出 | 查阅 Gemini API 开发者文档并压测 |
| 语音与口型 | 中文等非英语对白效果未知 | 用目标语言做多人对话测试 |
常见问题 FAQ
Q1:什么是 Gemini Omni 1.2 Flash?
Gemini Omni 1.2 Flash 是 Google 于 2026-11-05 发布并 GA 的视频生成模型,主打快速、低成本,支持 3–15 秒原生视频、多种参考输入和多轮对话式编辑,720p 定价为每秒 0.07 美元。
Q2:Gemini Omni 1.2 Flash 和 1.1 有什么区别?
1.1 最长 10 秒,1.2 提升到 15 秒并可按 1 秒设定;价格下降 30%;新增多轮对话编辑;参考遵循、首尾帧一致性、语音口型和连续运镜都有改善;同时首次达到 GA,并提供 Provisioned Throughput。
Q3:Gemini Omni 1.2 Flash 现在可以用了吗?
可以。它已在 Gemini API 和 Google Cloud 上 GA,开发者可在 Google AI Studio 原型验证。Google Vids、Flow、Google Ads 同步上线,Gemini 应用则正向 Google AI Ultra 订阅用户逐步推送。
Q4:Gemini Omni 1.2 Flash 最适合哪些场景?
– **电商虚拟试穿与商品展示**:用模特照和产品图生成试穿、360 度展示片段
– **广告变体批量生产**:一段素材多轮编辑,产出不同背景、天气、画幅的版本
– **产品讲解与科普短片**:15 秒内完成多镜头讲解,官方示例中标注文字拼写准确
– **连续运镜的空间展示**:建筑、景区的 FPV 穿越与拉远镜头
Q5:能通过 API易 调用 Gemini Omni 1.2 Flash 吗?
API易 已提供 Gemini 系列文本模型的接入,但 Gemini Omni 视频模型目前请以平台的模型列表为准,本文不作承诺。在等待期间,你可以先通过 API易 apiyi.com 调用文本模型生成分镜脚本和多轮编辑指令,视频生成本身走 Google 官方渠道,两者组合使用。
Q6:Gemini Omni 1.2 Flash 有哪些已知限制?
官方承认快速体育动作、快速的脚本变化和复杂物理仍在改进中;首尾帧示例里也能看到细微的细节偏差。此外,API 参数、模型 ID 和速率限制发布文章没给,需要查官方文档;放大到 1080p 约 0.104 美元/秒、4K 约 0.209 美元/秒,定价页上都能查到。
Q7:如何降低视频生成的提示词试错成本?
先用文本模型把 brief 拆成结构化分镜和“每轮只改一个变量”的编辑指令,再交给视频模型执行,能明显减少废片。借助 API易 apiyi.com 的统一接口,可以快速对比不同文本模型写提示词的效果,选出最适合你业务的那个。
Gemini Omni 1.2 Flash 核心要点 Key Takeaways
- 时长升级:最长 15 秒,3–15 秒按 1 秒设定,一次生成完整广告
- 价格下调:720p 每秒 0.07 美元,较 1.1 降价 30%
- 省钱工作流:低分辨率草稿 + 多轮编辑 + 只放大最终版
- 参考更稳:图像、≤3 秒动作片段、音频共同约束,跨机位保持一致
- 首次 GA:支持 Provisioned Throughput,输出内嵌 SynthID 水印
- 短板明确:快速运动、复杂物理仍需谨慎,务必用自有素材实测
- 辅助链路:分镜与编辑指令可经 API易 apiyi.com 调用文本模型批量生成
总结:Gemini Omni 1.2 Flash 值得现在评估吗
Gemini Omni 1.2 Flash 的核心要点:
- 规格实打实提升:15 秒时长、1 秒粒度、降价 30%、首次 GA,可以直接写进技术方案
- 多轮编辑改变工作流:从“整段重生成”转向“逐轮修改”,对广告变体和电商素材价值最大
- 效果改进需要实测:一致性、口型、运镜的进步来自官方示例,在你的素材上表现如何,还要自己验证
如果你正在做电商、品牌广告或产品讲解类视频,现在就值得在 Google AI Studio 里拿自有素材跑一轮对比;如果主要内容是体育、高速动作或强物理交互,可以先观望后续版本。
在评估过程中,推荐通过 API易 apiyi.com 用同一个 Key 调用多种文本模型来生成分镜和编辑指令,把提示词试错成本先降下来,平台提供新用户免费测试额度。
📚 参考资料
- Google 官方博客 – Gemini Omni 1.2 Flash 发布文章:本文全部事实来源
- 链接:
blog.google/innovation-and-ai/technology/developers-tools/introducing-gemini-omni-1-2-flash/ -
说明: 包含时长、价格、参考输入、多轮编辑、可用渠道和已知短板的官方描述
-
Google AI Studio:Gemini API 原型验证入口
- 链接:
aistudio.google.com - 说明: 官方推荐的开发者试用渠道,可查看 starter apps 与开发者文档
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心