作者注:Gemini 4 Carbon 的介绍价 11 月 30 日到期。本文帮你在到期前把账重新算一遍,并把接入层改成「换模型只改 ID 和端点」的结构。
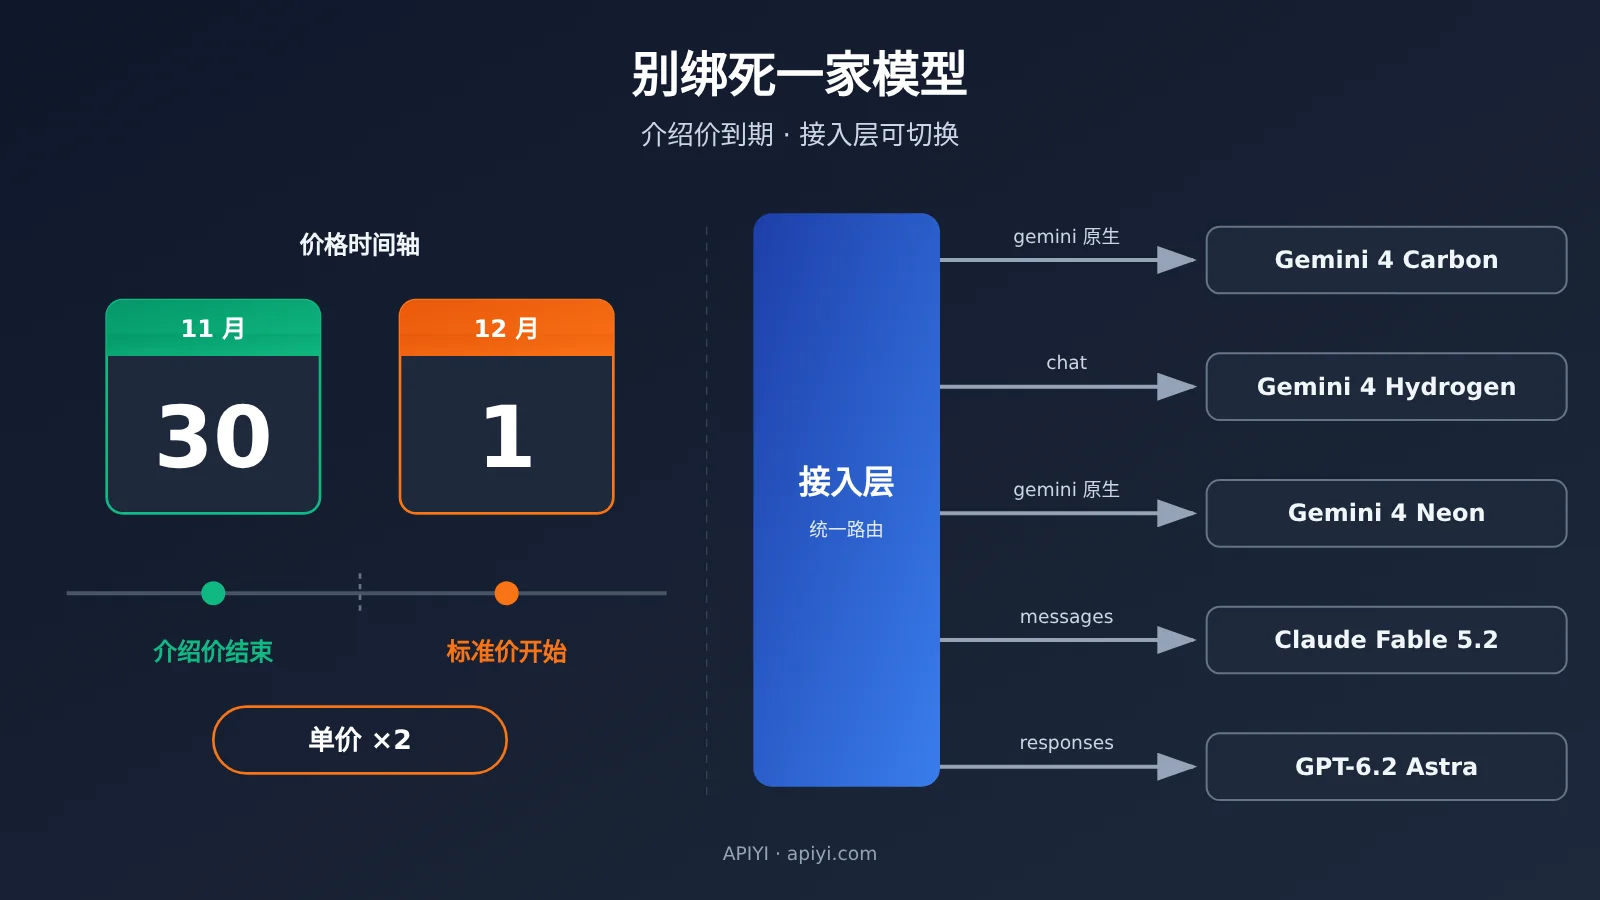
如果你的业务已经接上 Gemini 4 Carbon,接下来这 10 天值得认真对待。Google 开发者页面写明,Gemini 4 Carbon 的介绍价持续到 2026-11-30,2026-12-01 起切换为标准价,输入和输出单价都翻倍。今天是 2026-11-20,介绍价还没有结束,现在动手调整成本模型和接入代码,时间是够的。
这不是一篇劝你立刻换模型的文章。换过去不一定更便宜,效果也不一定等价。本文要解决两件更实际的事:一是到期之后怎么重新算账,二是怎么把调用层改造成能随时切换的结构,让下一次价格或上下文窗口变化时,你只需改模型 ID 和端点,不必重写整个调用。
核心价值:读完本文,你会拿到明确的到期日、介绍价和标准价两套数字,以及换到 Hydrogen、Neon、Fable 或 Astra 时各自应该走的端点。
Gemini 4 Carbon 介绍价到期核心要点
先把关键事实集中列出。表中数字来自 Google 开发者页面,以及 API易 在 2026-11-20 核对的价格信息,单位为美元每百万 token。
| 要点 | 说明 | 对你的影响 |
|---|---|---|
| 介绍价截止日 | 到 2026-11-30 为止 |
11 月账单按介绍价计算 |
| 介绍价 | 输入 2、输出 10、缓存读 0.10 |
当前成本基线 |
| 标准价(12 月 1 日起) | 输入 4、输出 20、缓存读 0.20 |
同等用量下成本约翻倍 |
| API易 当前货架 | gemini-4-carbon 输入 2、缓存读 0.1、输出 10 |
与介绍价一致,到期后以平台型号列表为准 |
| 可替换型号 | Hydrogen、Neon、Fable、Astra | 端点不同,不能共用一个请求体 |
Gemini 4 Carbon 两套价格怎么理解
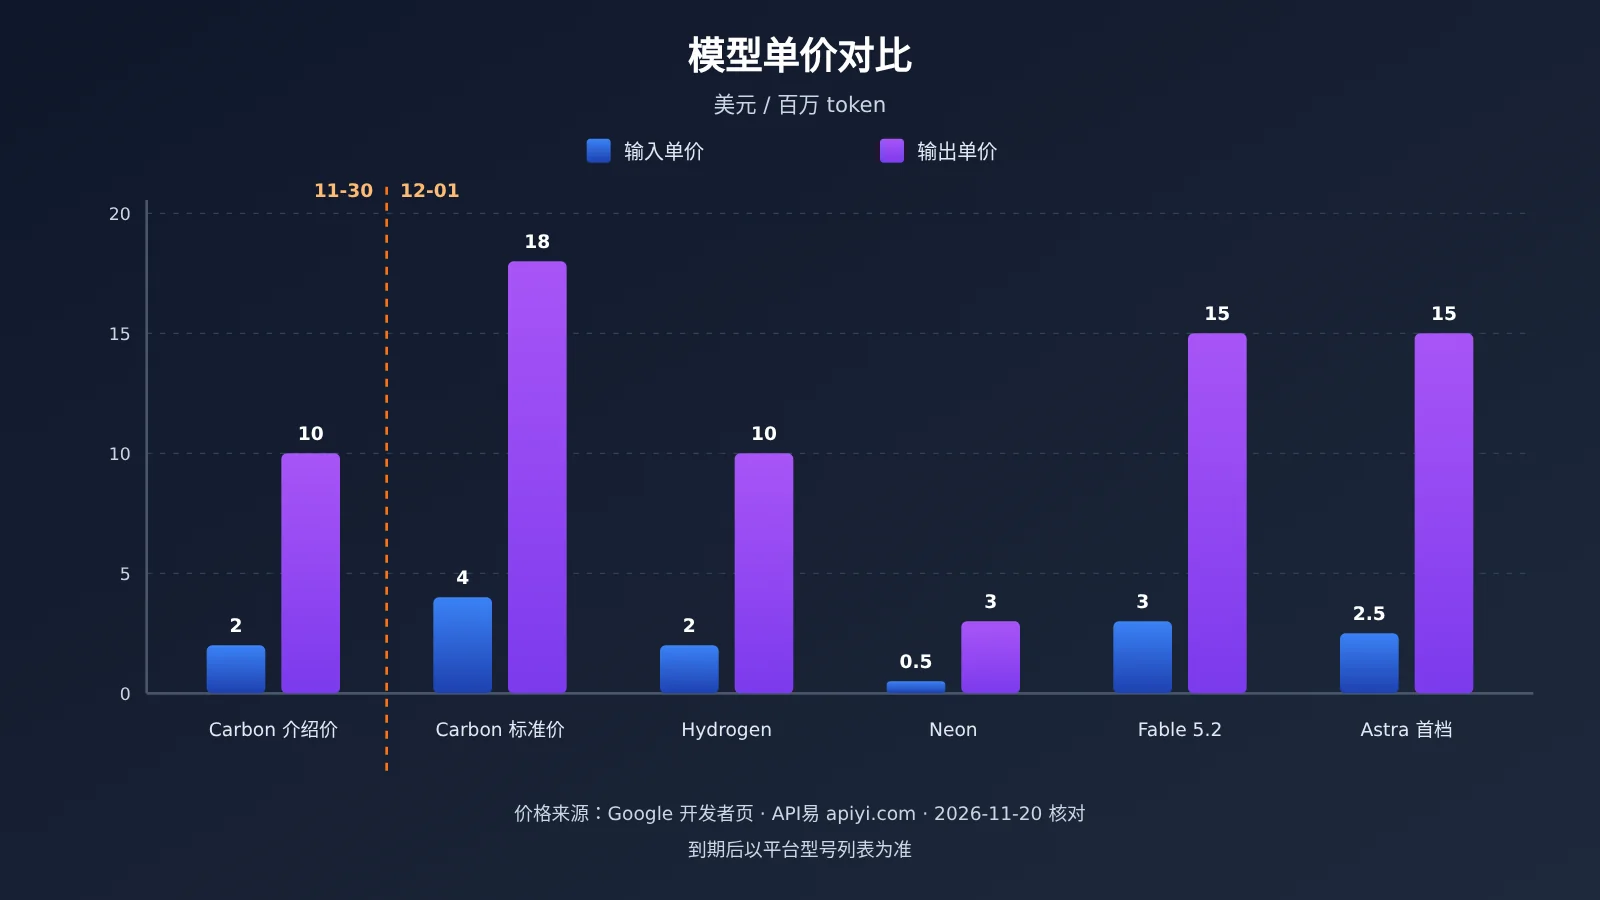
介绍价和标准价的差别很直接:输入从 2 涨到 4,输出从 10 涨到 20,缓存读从 0.10 涨到 0.20,三项都是两倍。所以 12 月以后的成本几乎就是「11 月同等用量乘以 2」。如果你的提示词里有大量可复用前缀、缓存命中率高,缓存读部分的绝对增量会小一些,但比例同样是翻倍。
需要特别区分的是 API易 apiyi.com 的货架价。根据 2026-11-20 的核对,平台上 gemini-4-carbon 标的是输入 2、缓存读 0.1、输出 10,对应的是 Google 介绍价,不是 12 月 1 日之后的标准价。到期以后平台怎么调整,应以当时的平台型号列表为准,不要把现在看到的货架价当作 12 月以后的保证。
为什么不能绑死一家模型
只接一家模型,风险主要来自三个方向。第一是价格改口,介绍期结束、促销调整都会直接改变单位成本。第二是模型下线或更名,原来的 ID 突然不可用,调用会大面积报错。第三是同一模型在不同入口的思考档位、上下文窗口不一致,你在一个入口调好的参数,到另一个入口可能不生效。
这三类变化都不是你能控制的,但你能控制的是:变化发生时,改动范围有多大。如果模型 ID、端点类型、价格参数都写死在业务代码里,每次变化都要改代码、重新测试、重新上线。如果这些都收敛到接入层的配置中,变化就只是改一行配置。
Gemini 4 Carbon 到期后如何重算成本
用你自己的用量套两套价格
重算其实只需要三个数字:月输入 token、月输出 token、月缓存读 token。把它们分别乘以对应单价再相加,就得到月成本。下面用一个假设的用量做演示:每月输入 100M token、输出 20M token,暂不计缓存。这个用量只是示意,请替换成你自己账单里的真实值。
| 计费方案 | 输入单价 | 输出单价 | 假设用量下的月成本 |
|---|---|---|---|
| Carbon 介绍价(至 11-30) | 2 |
10 |
100×2 + 20×10 = 400 美元 |
| Carbon 标准价(12-01 起) | 4 |
20 |
100×4 + 20×20 = 800 美元 |
gemini-4-hydrogen |
1.5 |
7.5 |
100×1.5 + 20×7.5 = 300 美元 |
gemini-4-neon |
3 |
15 |
100×3 + 20×15 = 600 美元 |
claude-fable-5-2 |
8 |
40 |
100×8 + 20×40 = 1600 美元 |
gpt-6.2-astra(首档) |
8 |
40 |
100×8 + 20×40 = 1600 美元 |
这张表只算了单价,没有算效果。Hydrogen 的单价最低,但能不能替代 Carbon,取决于你的任务对推理质量、格式稳定性的要求。Fable 和 Astra 单价更高,适合那些对质量要求高、愿意为效果付费的环节,而不是作为降本方案。换句话说,重算的目的是让你看清每条路的成本,而不是默认换过去就更省。
价格数据从哪里核对
API易 的价格有两个来源可以对照。一个是模型总表,2026-11-20 核对的版本更新于 2026-11-19 10:59(UTC+8)。另一个是定价接口 api.apiyi.com/api/pricing,版本为 shell-api-modelmak-v1,其中 model_ratio 为 1 时等于输入 2 美元每百万 token,输出和缓存分别通过 completion_ratio 和 cache_ratio 换算。
以 gemini-4-neon 为例,该版总表里没有这一行,但定价接口里有:model_ratio 为 1.5,completion_ratio 为 5,cache_ratio 为 0.05。换算下来是输入 3、输出 15、缓存读 0.15,和 Google 的标价一致。建议你在做预算时以定价接口为准,总表作为辅助阅读。
gpt-6.2-astra 有分档计价,需要两处都看。总表写的首档是输入 8、缓存读 0.4、输出 40,超过 272000 token 时输入变为 16;定价接口则显示超过 272000 token 时输出按 60、缓存读按 0.8 计算。如果你的单次请求经常有很长的上下文,这个分档对成本影响很大,必须单独估算。
💰 成本核对建议:到期前后各拉一次 API易 apiyi.com 的定价接口和型号列表,把单价写进你的路由配置,而不是写死在代码注释里。这样每月对账时,只需对比配置和平台数据是否一致。
Gemini 4 Carbon 替换型号的端点对照
换模型先对端点,不要假设请求体通用
这是最容易踩坑的一步。很多团队以为「都走 OpenAI 兼容接口,换个 model 字段就行」,结果某些模型推荐的端点根本不同,请求体字段也不一样。下表整理了可替换型号推荐的端点类型,所有调用统一走 https://api.apiyi.com/v1 这个基础地址。
| 模型 ID | 推荐端点 | 输入 / 缓存读 / 输出单价 | 切换注意 |
|---|---|---|---|
gemini-4-carbon |
chat 或 gemini 原生 | 2 / 0.1 / 10(当前货架) |
到期后以型号列表为准 |
gemini-4-hydrogen |
chat 或 gemini 原生 | 1.5 / 0.075 / 7.5 |
与 Carbon 端点一致,改动最小 |
gemini-4-neon |
chat 或 gemini 原生 | 3 / 0.15 / 15 |
价格以定价接口为准 |
claude-fable-5-2 |
chat 或 messages | 8 / 0.2 / 40 |
原生能力走 messages 更完整 |
claude-fable-5-2-thinking |
chat 或 messages | 8 / 0.2 / 40 |
思考档是独立 ID |
gpt-6.2-astra |
推荐 responses | 首档 8 / 0.4 / 40 |
超过 272000 token 分档计价 |
另外,gemini-4-argon 在总表里也有,标价为输入 2、缓存读 0.1、输出 10,和 Carbon 当前货架价相同。它的端点信息本文参考资料未覆盖,如果你考虑它,请先在平台文档里确认推荐端点再接入。
三类端点的差异在哪里
chat 端点即 OpenAI 兼容的对话补全格式,请求体核心是 model 和 messages 数组,大多数 SDK 默认就是这一类。gemini 原生端点使用 Gemini 自己的请求结构,适合需要原生参数(比如特定的思考配置)的场景。messages 端点是 Claude 原生格式,system 提示词的放置方式、内容块结构都与 chat 不同。responses 端点是 OpenAI 较新的接口形态,gpt-6.2-astra 推荐走这里。
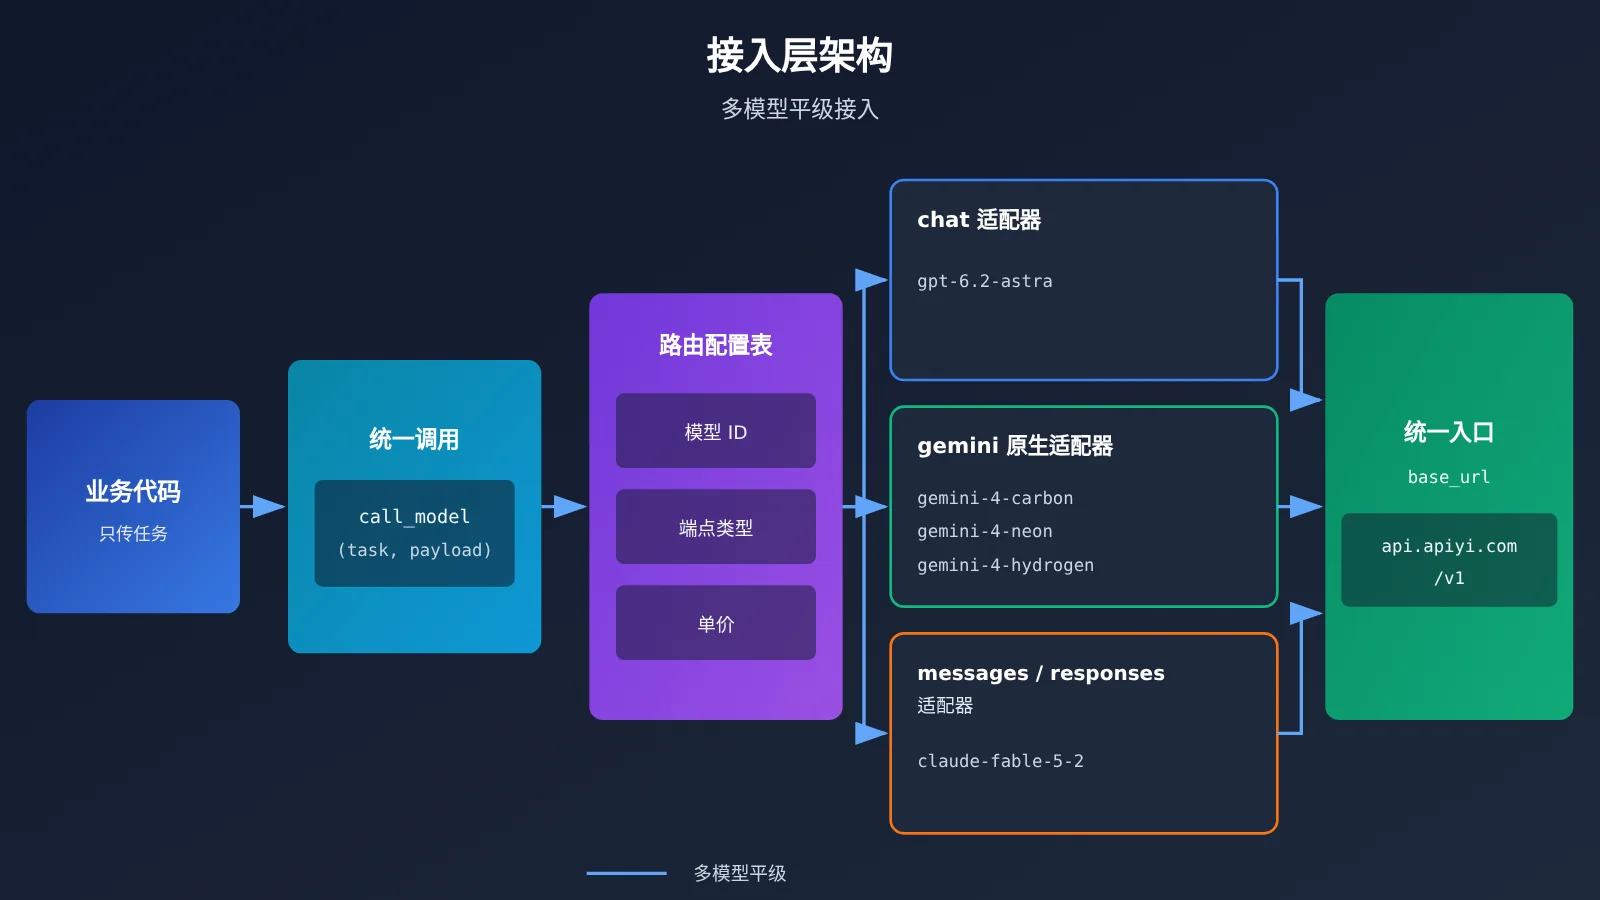
所以一个稳妥的接入层,应该为每种端点准备一个独立的适配器,业务代码只传入「任务类型 + 内容」,由适配器负责拼装对应格式。具体的端点路径和字段,请以 API易 文档中心的说明为准。
🎯 技术建议:切换前先用 API易 apiyi.com 的同一个 API Key,分别对候选模型的推荐端点各发几条真实业务请求,确认返回结构、思考档行为和上下文长度都符合预期,再改路由配置。
Gemini 4 Carbon 可切换接入层快速上手
极简示例:统一客户端
本节不贴大段代码,只给出关键配置。OpenAI 兼容 SDK 初始化客户端时,只需要两个参数:client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")。之后调用 chat 端点时写 client.chat.completions.create(model="gemini-4-carbon", messages=msgs),想切到 Hydrogen,只需把 model 改成 gemini-4-hydrogen,因为两者共用 chat 端点,请求体不用动。
切到 gpt-6.2-astra 时情况就不同了。推荐写法是 client.responses.create(model="gpt-6.2-astra", input=msgs),参数名从 messages 变成了 input,返回结构也不同。这正是为什么接入层必须按端点拆分适配器,而不是只换模型名。
完整改造步骤
把单模型调用改造成可切换结构,可以按下面的顺序做:
- 抽出路由配置:建一个配置表,每一行包含任务名、模型 ID、端点类型、输入单价、输出单价、缓存读单价。业务代码只认任务名。
- 按端点写适配器:分别实现 chat、gemini 原生、messages、responses 四个适配器,每个适配器负责把统一输入转成对应请求体,并把返回值转成统一结构。
- 统一基础地址和密钥:所有适配器共享同一个
base_url和 API Key,切换模型时不用新增密钥管理。 - 加回退链:为关键任务配置主模型和备用模型,比如主用
gemini-4-carbon、备用gemini-4-hydrogen,主模型报错或下线时自动走备用。 - 成本埋点:每次调用记录模型 ID 和 token 用量,用配置表里的单价实时估算成本,月底和账单对照。
查看路由配置表示例字段
一条典型的路由配置可以包含这些字段:`task: “summary”`、`model: “gemini-4-carbon”`、`endpoint: “chat”`、`price_in: 2`、`price_out: 10`、`price_cache: 0.1`、`fallback: “gemini-4-hydrogen”`。12 月 1 日之后,你只需要根据平台型号列表更新 `price_in` 和 `price_out`,或者把 `model` 和 `endpoint` 换掉,业务代码完全不用改。
对于 `gpt-6.2-astra` 这种分档计价的模型,建议额外加 `tier_threshold: 272000` 和对应的高档单价字段,由成本埋点模块根据单次请求的 token 数判断落在哪一档。
🚀 快速开始:如果你还没有统一入口,可以先在 API易 apiyi.com 注册获取 API Key 和免费测试额度,用一个 Key 把 Carbon、Hydrogen、Neon、Fable、Astra 都跑通一遍,再决定路由怎么配。
到期前的检查清单
| 检查项 | 截止建议 | 说明 |
|---|---|---|
| 导出 11 月用量 | 11-25 前 | 拿到输入、输出、缓存读三项真实 token 数 |
| 套算两套价格 | 11-26 前 | 用介绍价和标准价分别算出月成本 |
| 候选模型试跑 | 11-28 前 | 按推荐端点各跑一批真实请求 |
| 路由配置上线 | 11-30 前 | 主备模型和单价都进配置 |
| 复核平台价格 | 12-01 后 | 以平台型号列表为准更新单价 |
常见问题 FAQ
Q1:Gemini 4 Carbon 的介绍价具体到哪一天?
根据 Google 开发者页面,介绍价持续到 2026-11-30,期间输入 `2`、输出 `10`、缓存读 `0.10` 美元每百万 token。2026-12-01 起改为标准价:输入 `4`、输出 `20`、缓存读 `0.20`。
Q2:API易 上的 Carbon 价格 12 月以后会变成多少?
目前 API易 货架上 `gemini-4-carbon` 是输入 `2`、缓存读 `0.1`、输出 `10`,对应的是介绍价。12 月 1 日之后的价格请以平台型号列表为准,本文不对之后的货架价做任何保证,建议到期后直接在 API易 apiyi.com 核对。
Q3:从 Carbon 换到 Hydrogen 需要改多少代码?
改动最小。两者推荐端点相同,都是 chat 或 gemini 原生,如果你已经走 chat 端点,只需把 `model` 字段从 `gemini-4-carbon` 改成 `gemini-4-hydrogen`。但仍建议先用真实请求验证效果,单价更低不代表任务质量等价。
Q4:换到 Claude Fable 或 GPT Astra 为什么不能直接改模型名?
因为推荐端点不同。`claude-fable-5-2` 可走 chat 或 messages,原生能力走 messages 更完整;`gpt-6.2-astra` 推荐走 responses,请求参数和返回结构都和 chat 不同。直接改模型名,往往会遇到字段不识别或解析失败。
Q5:Gemini 4 Neon 的价格以哪里为准?
2026-11-19 版的模型总表里没有 Neon 这一行,但定价接口里有,换算为输入 `3`、输出 `15`、缓存读 `0.15`,与 Google 标价一致。做预算时以定价接口为准即可,端点同样是 chat 或 gemini 原生。
Q6:怎么用一个 Key 快速对比几个候选模型?
推荐用 API 聚合平台统一测试:
1. 在 API易 apiyi.com 注册,获取 API Key 和免费测试额度
2. 把客户端的 `base_url` 设为统一地址,按各模型推荐端点分别调用
3. 记录每个模型的 token 用量和输出质量,再套入本文的重算表
Q7:这套可切换接入层有哪些局限?
接入层只能降低切换成本,不能消除效果差异。不同模型对同一提示词的理解、格式遵循和思考档行为都可能不同,切换后仍需回归测试。另外分档计价模型(如 Astra 超过 `272000` token)需要单独估算,统一的成本公式会低估长上下文请求。
Gemini 4 Carbon 介绍价到期 Key Takeaways
- 到期日明确:介绍价到 2026-11-30,12 月 1 日起转标准价
- 成本约翻倍:输入、输出、缓存读三项标准价都是介绍价的两倍
- 货架价不等于承诺:API易 当前 Carbon 价对应介绍价,到期后以型号列表为准
- 端点各不相同:Hydrogen、Neon 走 chat 或 gemini,Fable 走 chat 或 messages,Astra 推荐 responses
- 换了不一定更省:Hydrogen 单价低,Fable 和 Astra 单价高,需结合效果判断
- 配置化是关键:模型 ID、端点、单价都进路由配置,业务代码只认任务名
- 统一入口便于验证:用 API易 一个 Key 跑通多个候选模型再决定路由
总结
Gemini 4 Carbon 介绍价到期这件事,核心要点有三个:
- 先算账:用真实用量分别套介绍价和标准价,12 月以后同等用量的成本约为原来的两倍。
- 再对端点:替换型号的推荐端点并不相同,换模型前先确认 chat、gemini、messages、responses 各自的请求格式。
- 最后配置化:把模型 ID、端点类型和单价收敛进路由配置,下次价格或窗口再变,只改配置不改代码。
距离 11 月 30 日还有 10 天,足够你完成用量导出、两套价格重算和候选模型试跑。别把业务绑死在一个模型的一个价格上,接入层留好能换的口,才是对下一次变化最稳妥的准备。
推荐通过 API易 apiyi.com 统一接入,用一个 Key 在多个模型和端点之间验证效果、对比成本。
📚 参考资料
-
Google 开发者页面 – Gemini 定价说明:Gemini 4 Carbon 介绍价与标准价
- 链接:
ai.google.dev - 说明:介绍价截止日期及 12 月 1 日起的标准价
- 链接:
-
API易 模型总表:各模型输入、输出、缓存读单价
- 链接:
docs.apiyi.com/models.md - 说明:2026-11-20 核对版本更新于 2026-11-19 10:59(UTC+8)
- 链接:
-
API易 定价接口:按倍率换算的实时价格
- 链接:
api.apiyi.com/api/pricing - 说明:版本
shell-api-modelmak-v1,适合程序化读取单价
- 链接:
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,各模型端点与参数说明可在文档中心查阅