Note de l’auteur : décryptage de l’impact du Prompt Cache de 12 heures d’OpenAI sur les coûts de l’API GPT-6, avec une formule de rentabilité et 5 critères pour déterminer dans quels scénarios activer le cache permet d’économiser, et dans lesquels les gains restent limités.
OpenAI ajoute une capacité de rétention du cache de 12 heures au Prompt Cache, un signal qui mérite de recalculer les coûts pour les équipes qui appellent l’API GPT-6. Auparavant, le cache ne restait généralement valide que quelques minutes d’inactivité, et beaucoup de requêtes à faible fréquence ne profitaient jamais de la remise ; maintenant que la fenêtre de cache s’allonge, un grand nombre de requêtes « qui ne reviennent qu’après quelques heures » ont aussi une chance de toucher le cache.
Ce n’est pas un argument marketing du type « activez le cache et vous économisez automatiquement la moitié ». Les économies dépendent de la stabilité du préfixe, de l’intervalle entre les requêtes, de la taille du préfixe par requête, et du coût éventuel d’écriture du cache. Cet article utilise une formule de rentabilité simple pour vous aider à déterminer si votre activité devrait ou non activer le cache de 12 heures.
Valeur essentielle : comprendre en 5 minutes le changement de mécanisme du Prompt Cache de 12 heures, et apprendre à utiliser 5 critères pour juger quand le cache de l’API GPT-6 permet vraiment d’économiser.
L’essentiel du Prompt Cache 12 heures d’OpenAI
Commençons par un tableau pour clarifier les informations clés de cette mise à jour. Comme les tarifs et paramètres officiels évoluent en permanence, les éléments du tableau concernant la facturation se basent sur la documentation et la page tarifaire officielles d’OpenAI.
| Élément | Détail |
|---|---|
| Mise à jour | Le Prompt Cache ajoute une option de conservation de 12 heures |
| Éditeur | OpenAI |
| Modèles concernés | GPT-6 API et autres modèles prenant en charge le Prompt Caching (voir la liste officielle des modèles) |
| Logique de facturation | Les tokens d’entrée qui correspondent au cache sont facturés à un prix unitaire inférieur à celui des entrées classiques ; le détail de la remise est à vérifier sur la page tarifaire officielle |
| Changement clé | Le cache passe d’une invalidation après quelques minutes d’inactivité à une conservation pouvant aller jusqu’à 12 heures |
| Portée | Invites système longues, définitions d’outils d’agents, connaissances fixes RAG, conversations multi-tours, etc. |
Comment fonctionne le Prompt Cache
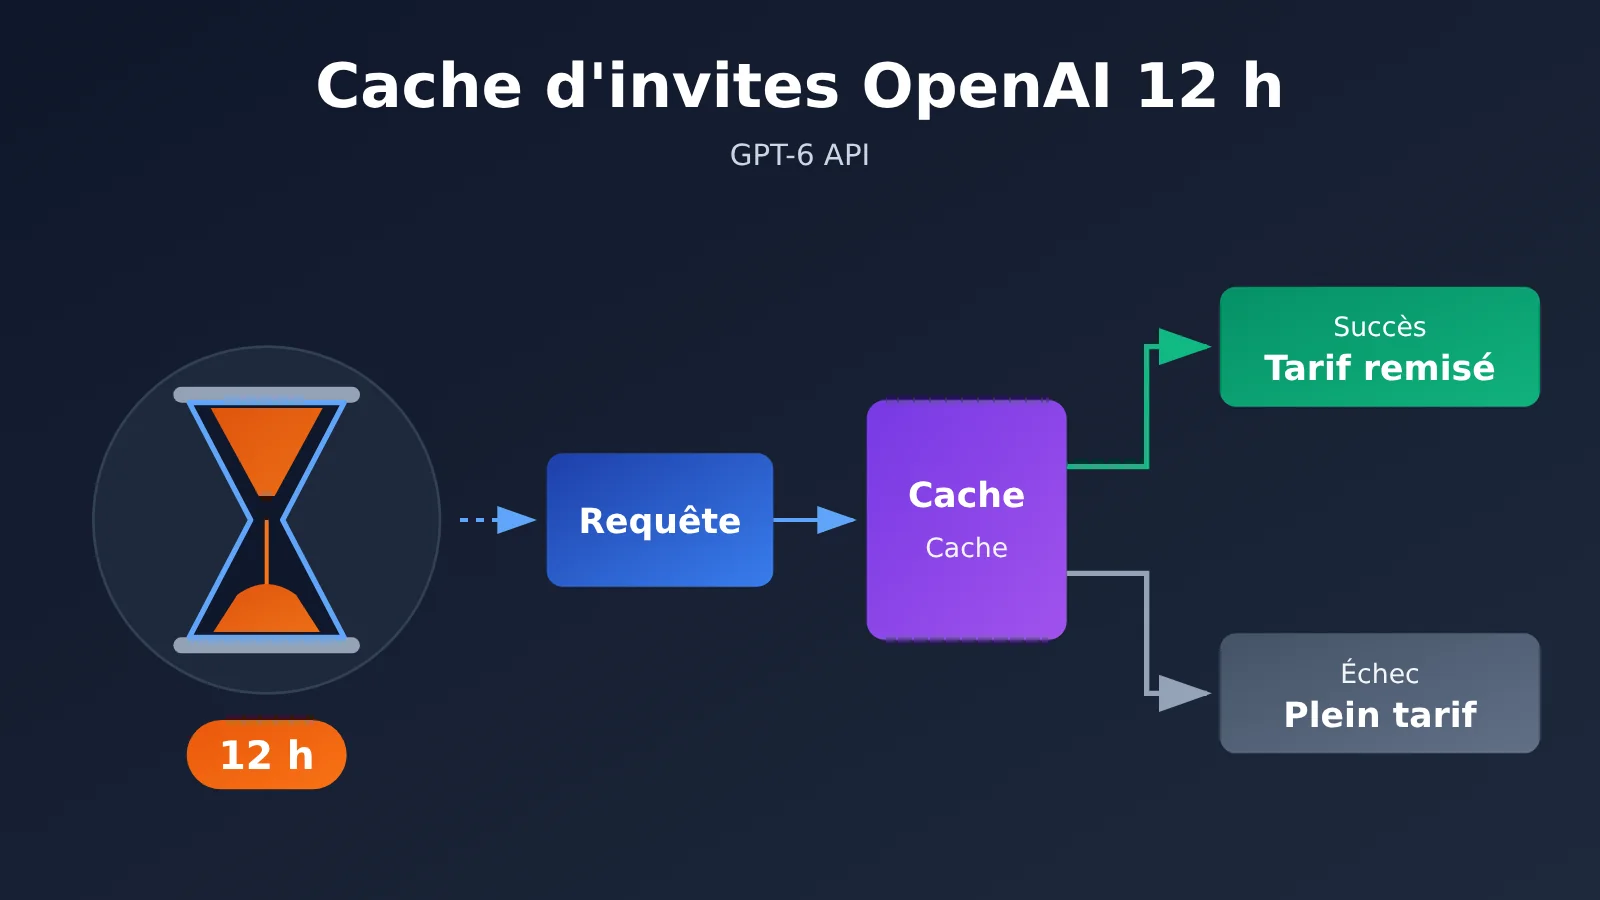
Le Prompt Caching d’OpenAI repose sur un mécanisme de « correspondance de préfixe ». Lorsque le début d’une requête (invite système, définitions d’outils, documents fixes, etc.) est identique à celui d’une requête récente et que sa longueur atteint le seuil minimum défini par OpenAI, ces tokens sont reconnus comme une correspondance de cache. Ils sont alors facturés au tarif réduit, et la latence du premier token baisse nettement.
À noter : le cache ne reconnaît que la partie « identique de façon continue depuis le premier token ». Si un horodatage ou un ID utilisateur s’insère au milieu du préfixe, tout ce qui suit ne peut plus correspondre. La conception de la structure des invites compte donc plus que le simple fait d’activer ou non le cache : placez le contenu statique au début et le contenu dynamique à la fin.
Différence entre le cache 12 heures et le cache court
L’ancien cache court était effacé après quelques minutes d’inactivité ; seules les requêtes fréquentes et consécutives pouvaient toucher le cache de façon stable. Avec la conservation de 12 heures, la « fenêtre de correspondance » passe de quelques minutes à une demi-journée, ce qui change directement la structure de coûts des scénarios à faible fréquence.
| Critère de comparaison | Cache court par défaut | Cache 12 heures |
|---|---|---|
| Durée de conservation | Invalidation après quelques minutes d’inactivité | Jusqu’à environ 12 heures |
| Fréquence de requêtes adaptée | Requêtes fréquentes et consécutives | Requêtes à fréquence moyenne ou faible, intermittentes |
| Scénarios typiquement bénéfiques | Support client en temps réel, appels batch consécutifs | Retour d’un utilisateur dans une conversation après plusieurs heures, tâches planifiées dans la journée |
| Stabilité du taux de correspondance | Fortement affecté par les variations de trafic | Plus favorable aux périodes de faible trafic |
| Coût supplémentaire | Généralement aucun frais d’écriture | L’existence de frais supplémentaires dépend des indications officielles |
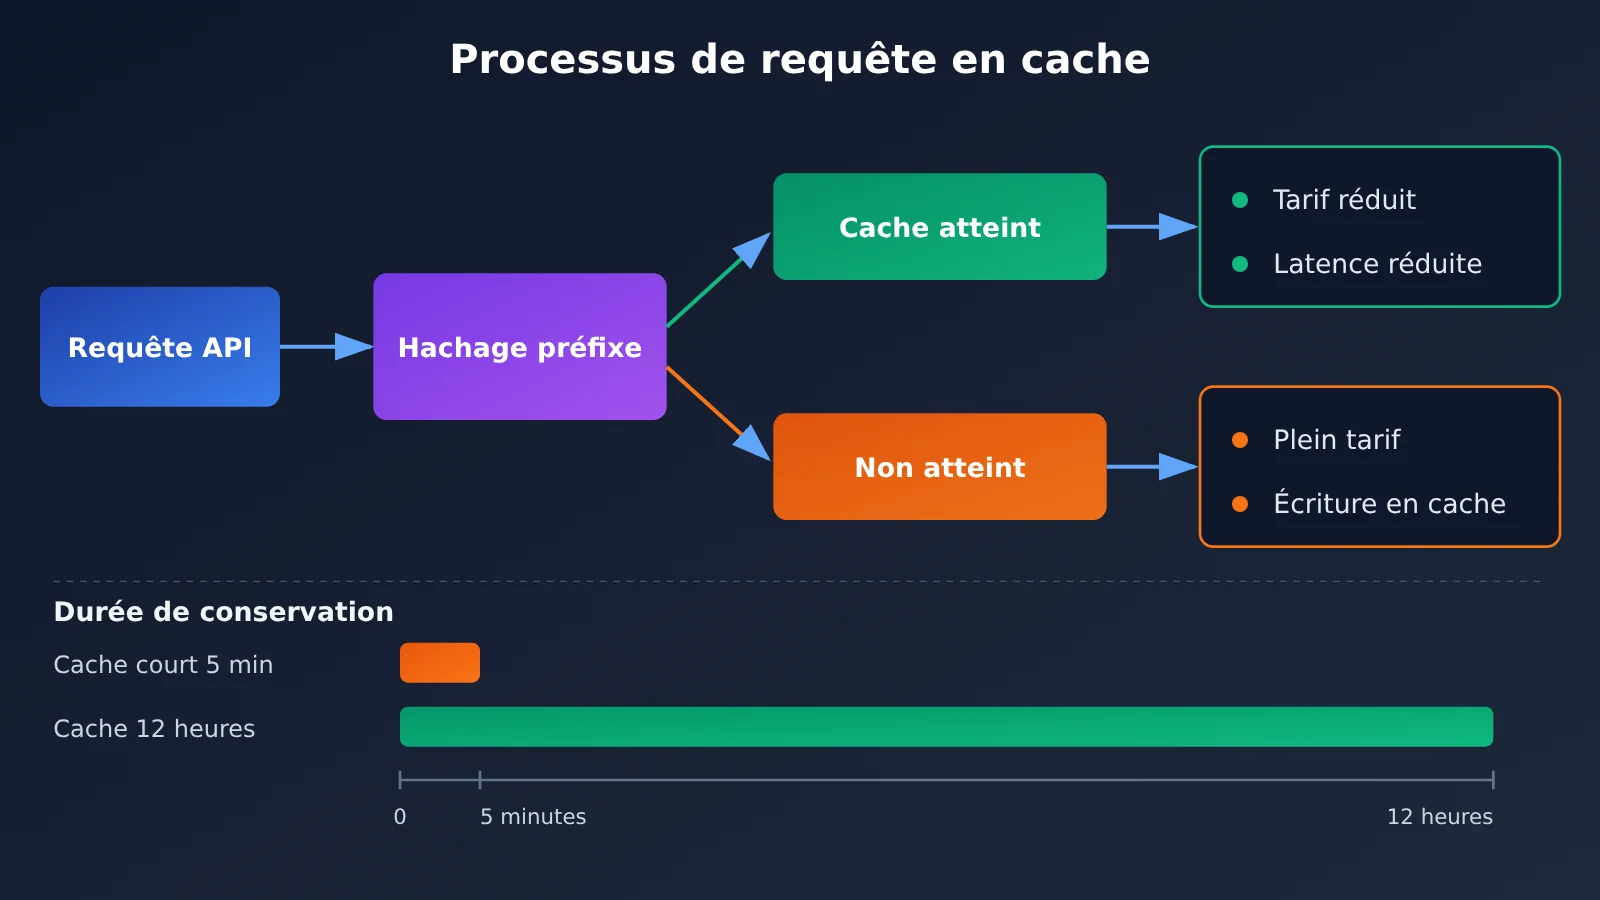
Beaucoup d’articles se contentent de dire que « le cache permet d’économiser », sans préciser combien ni dans quelles conditions. Voici une formule générique pour quantifier la question : il vous suffit d’y injecter vos propres paramètres métier.
Démonstration de la formule de rentabilité du cache de prompt
Posons les variables suivantes :
L: nombre de tokens du préfixe cachableP: prix unitaire d’entrée standardd: ratio du prix unitaire en cas de cache hit par rapport au prix standard (0 < d < 1)w: ratio de coût supplémentaire pour la première écriture dans le cache (w = 0 en l’absence de frais supplémentaires)N: nombre d’appels du même préfixe pendant la durée de validité du cache
Sans cache, le coût total du préfixe est N × L × P. Avec le cache, le premier appel est facturé au coût d’écriture, les suivants au prix de hit, soit un coût total de L × P × (1 + w) + (N − 1) × L × P × d.
En soustrayant les deux, on obtient une condition de rentabilité très simple : N > 1 + w / (1 − d). Cette formule dit deux choses : si l’écriture n’a pas de frais supplémentaires (w = 0), il suffit que le même préfixe soit réutilisé une seule fois pendant la période de validité pour commencer à économiser ; s’il y a des frais d’écriture, il faut dépasser un certain seuil de réutilisation pour rentrer dans ses frais, et plus la remise est importante (d plus petit), plus le retour sur investissement est rapide.
Estimations de rentabilité selon les scénarios
Voici un calcul indicatif basé sur des « paramètres hypothétiques », uniquement pour illustrer l’usage de la formule ; cela ne reflète pas les tarifs réels d’OpenAI. On suppose que le prix d’un cache hit représente une certaine proportion du prix standard, et on observe le nombre d’appels nécessaires pour rentrer dans ses frais, avec et sans frais d’écriture.
| Hypothèse de scénario | Frais d’écriture w | Remise sur hit d | Appels nécessaires pour rentabilité N | Conclusion |
|---|---|---|---|---|
| Sans frais d’écriture | 0 | Quelconque | N > 1 | Économique dès 1 réutilisation |
| Frais d’écriture faibles | Faibles | Remise importante | Environ 2 | Rentable dans la grande majorité des cas |
| Frais d’écriture élevés | Élevés | Remise faible | Plus de 3 | Rentable uniquement en cas de forte réutilisation |
On le voit : la vraie valeur d’un cache de 12 heures ne réside pas dans « la remise en elle-même », mais dans le fait d’augmenter N. Une requête qui n’arrive qu’une fois toutes les quelques heures a un N pratiquement égal à 1 avec un cache court : impossible de parler d’économies. En allongeant la durée à 12 heures, le même préfixe est réutilisé plusieurs fois dans la journée, et l’économie devient réellement tangible.
🚀 Pour démarrer rapidement : pour vérifier la formule de rentabilité sur du trafic réel, je recommande de passer par APIYI apiyi.com et d’utiliser la même clé API pour comparer les taux de cache hit de différents modèles. La plateforme propose une interface compatible OpenAI, et les nouveaux utilisateurs peuvent bénéficier d’un crédit de test gratuit.
Comment vérifier les hits de Prompt Cache dans l’API GPT-6
Le moyen le plus fiable de savoir si le cache vous fait économiser de l’argent, c’est de lire le champ usage renvoyé dans la réponse. L’interface compatible OpenAI expose le nombre de tokens servis depuis le cache dans usage.prompt_tokens_details.cached_tokens : vous pouvez donc en déduire le taux de hit réel.
Exemple minimal
Le code ci-dessous envoie deux requêtes successives avec le même préfixe. On regarde si cached_tokens est supérieur à 0 à la deuxième :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI : interface unifiée, compatible OpenAI
)

SYSTEM_PROMPT = "Tu es un consultant technique senior… (placez ici une invite longue et fixe, au-dessus du seuil minimal de cache)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # utilisez le nom exact repris dans la liste des modèles de la plateforme
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"Question n°{i+1} : comment optimiser le coût des appels API ?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"Requête n°{i+1}, tokens servis depuis le cache : {cached}")
Voir le code complet (avec statistiques de hit et clé de routage du cache)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """Le contenu statique en premier, le contenu dynamique à la fin : le préfixe reste stable"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key aide à router les requêtes de même préfixe vers le même cache
        # Pour activer la rétention de 12 heures, ajoutez le paramètre correspondant
        # en suivant la documentation officielle OpenAI
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["Comment concevoir une invite adaptée au cache ?", "Où placer les définitions d'outils ?", "Comment calculer le taux de hit ?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"Taux de hit global du cache : {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"Requête {idx} : prompt={p}, cached={c}")
Conseil : commencez par une journée sur un faible volume, relevez le taux de hit global et la distribution des intervalles entre requêtes, puis décidez si vous activez le cache 12 heures en production. Un quota de test récupéré via APIYI apiyi.com suffit pour ce type de vérification, sans avoir à ouvrir plusieurs comptes officiels séparément.
5 critères pour économiser avec le cache d’invites de 12 heures
En appliquant la formule de rentabilité à des cas concrets, on peut la résumer en 5 critères. Plus vous en remplissez, plus l’activation du cache de 12 heures est intéressante.
- Un préfixe suffisamment long : la partie fixe pouvant être mise en cache doit atteindre le seuil minimum officiel, et plus elle est longue, plus la réduction totale est importante. Même si une invite courte de quelques centaines de tokens touche le cache, les économies restent limitées.
- Un préfixe suffisamment stable : l’invite système, les définitions d’outils et l’ordre des schémas restent identiques pendant une journée. Des modifications fréquentes de l’invite invalident le cache à répétition.
- Un intervalle entre requêtes inférieur à 12 heures : si le même préfixe est appelé toutes les quelques dizaines de minutes à quelques heures, c’est précisément la zone où le cache de 12 heures apporte le plus par rapport à un cache court.
- Un nombre de réutilisations supérieur au seuil de rentabilité : faites le calcul avec
N > 1 + w / (1 − d)et vérifiez que le nombre de réutilisations dans la journée reste durablement au-dessus du seuil. - Une part élevée de coût d’entrée : si votre facture vient surtout des tokens de sortie, le cache n’optimise que l’entrée et la baisse globale sera diluée.
Pertinence du cache de 12 heures selon les cas d’usage
| Cas d’usage | Caractéristiques de l’intervalle entre requêtes | Effet du cache court | Valeur ajoutée du cache de 12 heures |
|---|---|---|---|
| Chatbot de support en temps réel | Haute fréquence continue | Déjà bon | Moyen ; comble surtout les creux de trafic |
| RAG sur base de connaissances d’entreprise | Fréquence moyenne, préfixe de documents fixe | Variable | Net ; réutilisation plusieurs fois par jour de connaissances fixes |
| Session d’agent de programmation | L’utilisateur revient par intermittence dans la session | Souvent invalidé | Très élevé ; réutilisation de longs contextes sur plusieurs heures |
| Traitement par lots planifié dans la journée | Un lot toutes quelques heures | Quasiment inefficace | Très élevé ; même gabarit pour plusieurs lots dans la journée |
| Analyse ponctuelle de documents longs | Un seul appel | Inefficace | Presque nul ; N = 1 ne permet pas de rentabiliser |
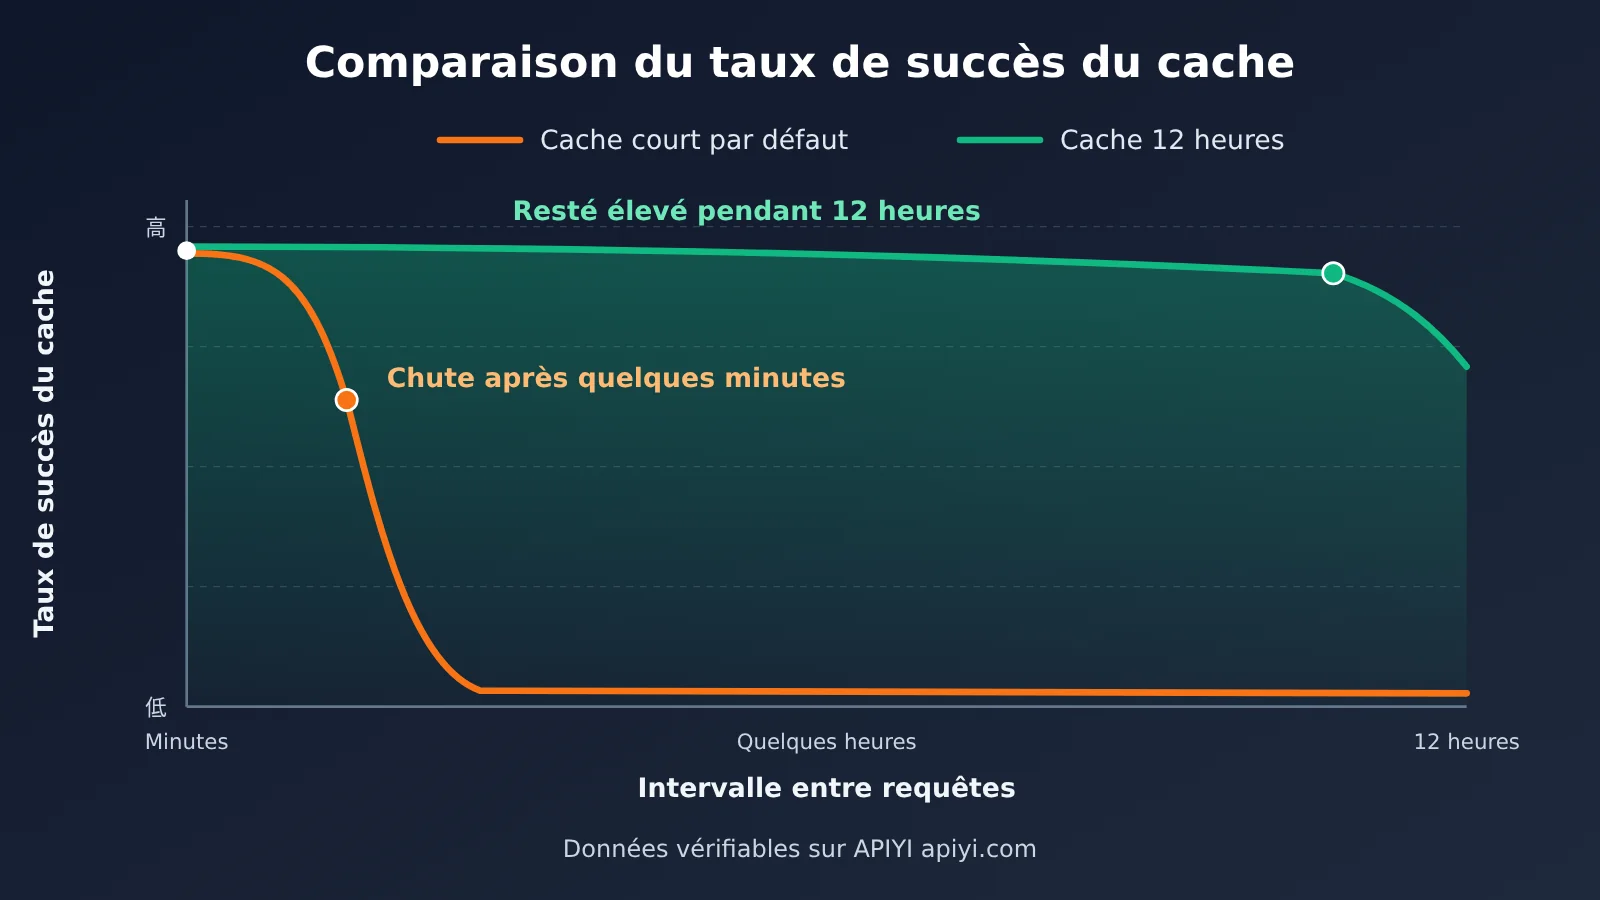
Note de comparaison : le graphique ci-dessus montre la différence de tendance du taux de succès des deux stratégies de cache selon l’intervalle entre requêtes. Le taux réel dépend de la stabilité de votre préfixe et de la distribution du trafic ; nous vous conseillons de comparer avec vos propres journaux de requêtes.
Cache de prompts OpenAI de 12 heures : analyse d’impact
Impact pour les développeurs
- L’ingénierie des prompts doit évoluer vers une « ingénierie du cache » : il faut organiser les prompts système, les définitions d’outils et les connaissances fixes en blocs de préfixe stables, et gérer explicitement les versions pour éviter qu’une petite modification invalide tout le cache.
- L’évaluation des coûts passe du « prix unitaire » au « prix unitaire effectif » : avec la même API GPT-6, une équipe qui obtient un bon taux de succès du cache et une autre qui en obtient un faible peuvent avoir des coûts réels très différents pour 1 000 requêtes. Le suivi de
cached_tokensdevrait devenir un indicateur courant. - Les Agents à contexte long deviennent plus viables : les assistants de programmation et les agents de recherche ont souvent un contexte très long. Avant, si un utilisateur s’absentait un moment puis revenait, tout était recalculé au prix fort. Aujourd’hui, la réutilisation sur plusieurs heures améliore nettement la rentabilité des longues sessions.
- La latence s’améliore aussi : les requêtes qui touchent le cache ont une latence du premier token plus faible, ce qui constitue un gain supplémentaire pour les produits où l’expérience interactive compte.
Impact pour le secteur
- Le cache devient un axe de concurrence sur la tarification des modèles : les principaux fournisseurs proposent chacun leur propre solution de cache d’invites. La durée de conservation, le niveau de remise et l’existence éventuelle de frais d’écriture deviennent des critères importants au moment de choisir.
- La comparaison multi-modèles proposée par les plateformes d’agrégation prend de la valeur : les règles de cache varient beaucoup d’un fournisseur à l’autre. Comparer les factures réelles côte à côte via une interface unifiée est plus parlant que de regarder uniquement les tarifs officiels.
- L’architecture RAG pourrait être réévaluée : lorsqu’un préfixe de document long peut être réutilisé à faible coût pendant une demi-journée, certains cas de bases de connaissances de taille petite ou moyenne pourraient passer d’une logique de « découpage en segments pour la recherche » à « document entier dans le contexte + cache ».
Référence pour choisir une solution de cache multi-modèles
| Famille de modèle | Caractéristiques du cache (voir la documentation officielle de chaque fournisseur) | Cas d’usage | Plateformes disponibles |
|---|---|---|---|
| API GPT-6 | Cache de préfixe automatique, nouvelle option de conservation de 12 heures | Prompts système longs, sessions d’Agent | APIYI apiyi.com, OpenAI officiel |
| Série Claude | Nécessite de marquer explicitement les points de rupture du cache, prend en charge différentes durées de conservation | Scénarios nécessitant un contrôle fin de l’emplacement du cache | APIYI, Anthropic officiel |
| Série Gemini | Prend en charge le cache de contexte implicite et explicite | Documents très longs, contexte multimodal | APIYI, Google officiel |
💡 Conseil de choix : les règles de cache varient beaucoup d’un modèle à l’autre. Je vous conseille de tester le même prompt métier sur plusieurs modèles pour mesurer le taux de succès du cache et la facture réelle, puis de décider en tenant compte des résultats.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que le Prompt Cache 12 heures d’OpenAI ?
Il s’agit d’une option de rétention prolongée du mécanisme OpenAI Prompt Caching. Les requêtes partageant le même préfixe ont la possibilité de toucher le cache pendant une durée pouvant aller jusqu’à environ 12 heures. Les tokens d’entrée correspondant à la partie en cache sont facturés à un tarif réduit, et la latence du premier token s’en trouve diminuée.
Q2 : Quelle est la différence entre le cache 12 heures et le cache court par défaut ?
Le cache court par défaut expire après quelques minutes d’inactivité : il ne convient qu’aux requêtes consécutives à haute fréquence. Le cache 12 heures, lui, couvre les requêtes à fréquence moyenne ou faible, et intermittentes. Pour un scénario à haute fréquence comme le service client en temps réel, la différence entre les deux est minime ; en revanche, pour un scénario où les appels sont espacés de plusieurs heures, comme les sessions d’Agent ou le traitement par lots planifié, le gain supplémentaire apporté par le cache 12 heures est nettement visible.
Q3 : Activer le cache 12 heures permet-il forcément d’économiser ?
Pas forcément. Si l’écriture dans le cache n’entraîne pas de surcoût, il suffit que le même préfixe soit réutilisé une fois pendant la période de validité pour commencer à économiser. En revanche, s’il y a un surcoût, il faut dépasser `1 + w / (1 − d)` réutilisations pour rentrer dans ses frais. Dans les cas d’un appel unique, d’un préfixe qui change souvent ou d’un préfixe très court, le gain reste très limité.
Q4 : Comment améliorer le taux de réussite du cache de l’API GPT-6 ?
Le principe central est « le statique devant, le dynamique derrière » :
– Placer l’invite système, les définitions d’outils et les documents fixes tout au début des messages, en conservant toujours le même ordre
– Placer les contenus dynamiques (horodatages, ID utilisateur, résultats de recherche, etc.) à la fin
– Utiliser une clé de routage de cache fixe pour une même catégorie de requêtes, afin d’augmenter la probabilité d’être routé vers le même cache
– Regrouper les modifications d’invite en une seule publication, pour éviter les petites retouches fréquentes au cours de la journée
Q5 : Comment tester rapidement l’effet du cache 12 heures via l’API ?
Je recommande de tester avec une plateforme d’agrégation d’API prenant en charge plusieurs modèles :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte
2. Récupérez votre clé API et votre quota de test gratuit
3. Utilisez l’exemple de code de cet article (en remplaçant `base_url` par `https://api.apiyi.com/v1`) et lisez `cached_tokens` pour calculer le taux de réussite du cache
APIYI utilise une interface compatible OpenAI : une seule clé suffit pour comparer les performances de cache de GPT, Claude et Gemini.
Q6 : Quelles sont les limites connues du Prompt Cache ?
Le cache ne s’applique qu’aux préfixes continus atteignant le seuil de longueur minimale, et il n’optimise que le coût côté entrée : les tokens de sortie ne bénéficient d’aucune réduction. Le cache est un mécanisme « au mieux » : en cas de forte concurrence ou de changement de routage du trafic, des échecs de cache peuvent survenir. Il ne faut donc pas considérer le taux de réussite comme garanti à 100 %. Pour le mode de facturation exact et les modèles pris en charge par la rétention de 12 heures, référez-vous à la documentation officielle d’OpenAI.
Points clés du Prompt Cache de 12 heures
- Fonctionnement : correspondance exacte du préfixe ; les tokens d’entrée concernés sont facturés à tarif réduit.
- Changement clé : la durée de conservation passe de quelques minutes à environ 12 heures, ce qui couvre les requêtes peu fréquentes.
- Formule de rentabilité : il faut que N > 1 + w / (1 − d) pour commencer à économiser.
- Scénarios les plus rentables : longues sessions d’agent, RAG sur base de connaissances, traitement par lots planifié dans la journée.
- Scénarios à gain limité : appels uniques, préfixes courts, invites modifiées fréquemment.
- Clé de mise en œuvre : placer le contenu statique en premier et surveiller en continu le taux de cache hit avec cached_tokens.
- Comment valider : effectuer un test à petite échelle avec du trafic réel via APIYI apiyi.com, puis généraliser.
Résumé
Les effets clés du Prompt Cache de 12 heures d’OpenAI sur les coûts de l’API GPT-6 :
- Le nombre de réutilisations est le vrai levier d’économie : avec une fenêtre de 12 heures, même les requêtes peu fréquentes peuvent réutiliser plusieurs fois le même préfixe. C’est en faisant passer N au-delà de 1 que l’on obtient la vraie valeur ajoutée.
- Le coût d’écriture détermine le seuil de rentabilité : sans frais d’écriture supplémentaires, le gain est presque acquis ; avec des frais, il faut vérifier avec la formule de rentabilité.
- La structure du prompt compte plus que l’activation : placer le statique en premier, gérer les versions et suivre le taux de cache hit sont indispensables pour que la remise sur cache se retrouve réellement sur la facture.
Commencez par les scénarios à fort rendement, comme les longs prompts système et les sessions d’agent, faites tourner une journée de trafic réel pour mesurer le taux de cache hit, puis décidez de l’ampleur du déploiement. Pour comparer rapidement l’efficacité du cache entre plusieurs modèles, passez par APIYI apiyi.com : la plateforme propose un quota de test gratuit et une interface unifiée compatible OpenAI.
📚 Ressources
- Guide officiel d’OpenAI sur le Prompt Caching : mécanisme de cache, seuil minimum et description du champ
usage - Lien :
platform.openai.com/docs/guides/prompt-caching -
Description : la source de référence pour comprendre les règles de hit du cache et les derniers paramètres de durée de rétention
-
Page tarifs de l’API OpenAI : prix unitaires par modèle pour l’entrée standard, l’entrée mise en cache et la sortie
- Lien :
openai.com/api/pricing -
Description : pour appliquer la formule de rentabilité, référez-vous aux prix en temps réel de cette page
-
Référence de l’API OpenAI : description des paramètres des interfaces Chat Completions et Responses
- Lien :
platform.openai.com/docs/api-reference - Description : pour consulter l’utilisation concrète des paramètres liés au cache, comme
prompt_cache_key
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI pour en savoir plus sur l’intégration des modèles et les solutions d’optimisation des coûts