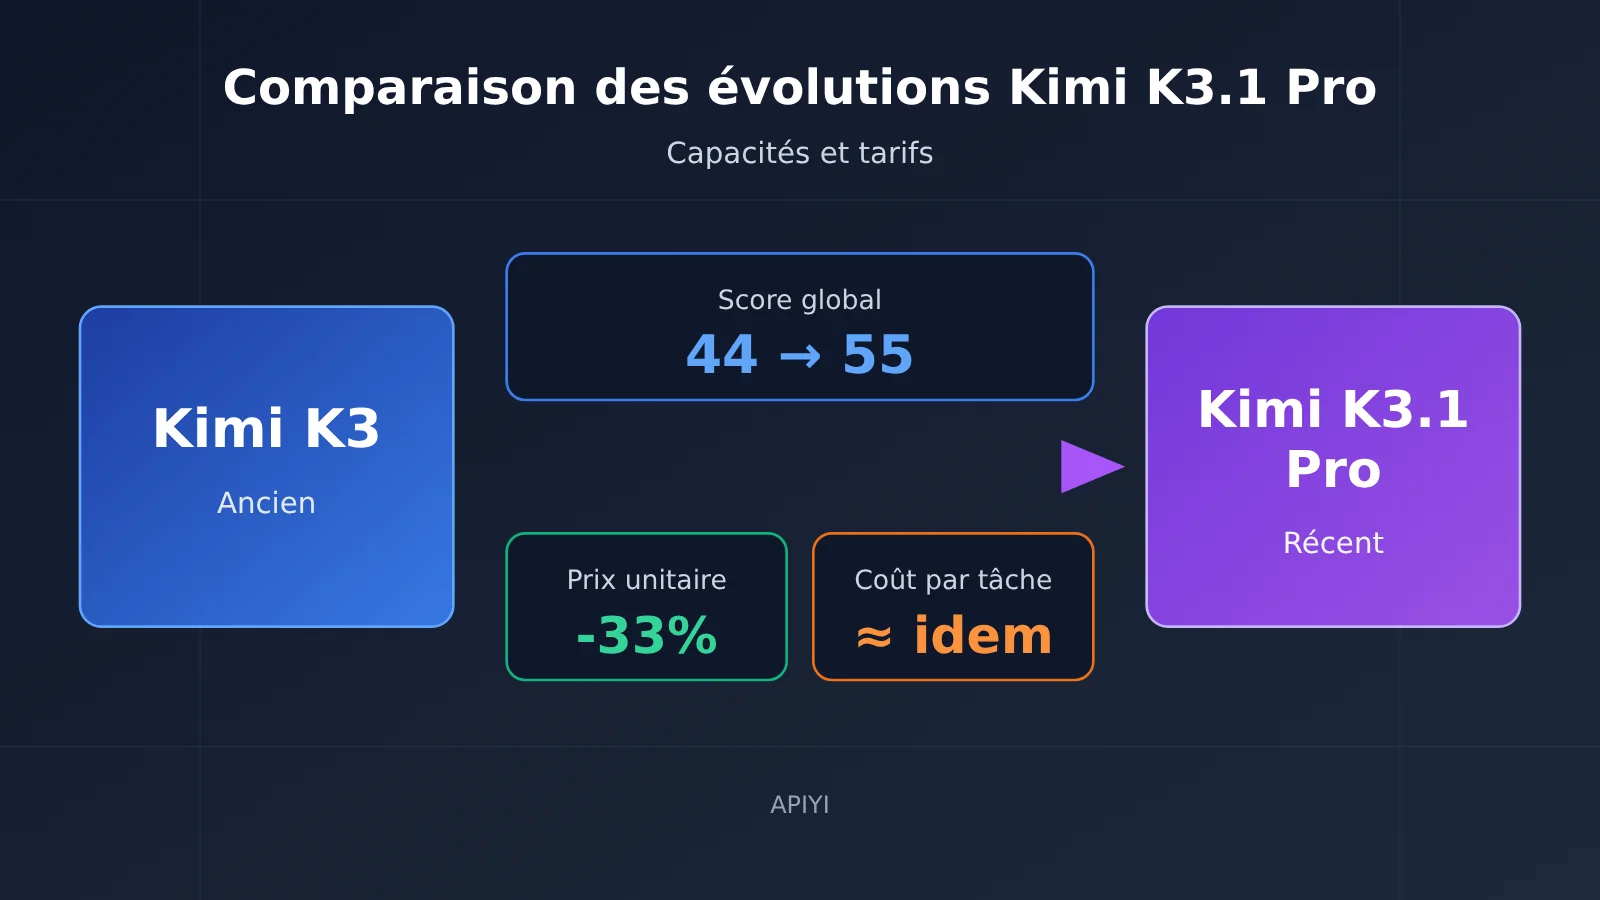
Sur le plan des capacités, Kimi K3.1 Pro progresse nettement par rapport à K3 : le score global établi par le tiers Artificial Analysis passe de 44 à 55, et le score de l’agent de programmation sur Terminal-Bench 4.0 grimpe de 13 % à 67 %. En revanche, les prix baissent de 30 % : les tarifs unitaires des entrées, des sorties et du cache sont tous inférieurs de 33 % à ceux de K3. Mais ses réponses sont plus longues et il est toujours en mode réflexion. Au final, le coût d’exécution d’une tâche reste à peu près le même qu’avec K3.
Voici les éléments qui étayent ces comparaisons. Chaque information est classée selon sa source : « déclaration officielle », « source tierce » ou « non vérifiée ». Cet article n’est ni un compte rendu de lancement ni une incitation à tout changer immédiatement. Il vise à aider les développeurs qui utilisent K3 à déterminer si leur activité gagnerait à migrer, à quel moment le faire et quels points surveiller lors de la transition.
1. Les 5 principales différences entre Kimi K3.1 Pro et la génération précédente
K3.1 Pro n’est pas un nouveau modèle entraîné de zéro : il repose sur K3, qui a bénéficié d’un vaste « post-entraînement ». Le post-entraînement consiste à ajuster la manière dont un modèle accomplit ses tâches après l’entraînement initial, à l’aide de données et de retours supplémentaires. Selon l’annonce officielle, il s’agit du « premier modèle de la série K3.1 » et du « modèle à poids ouverts de 3T le plus puissant ». Les poids ouverts désignent des fichiers de paramètres accessibles au public, que l’on peut télécharger pour déployer le modèle soi-même. Artificial Analysis indique un total de 2,8 T de paramètres, dont 104 B activés à chaque calcul.
| Critère | Kimi K3 | Kimi K3.1 Pro | Source |
|---|---|---|---|
| Méthode d’entraînement | Version de base | Post-entraînement à partir de K3, avec des moyens de calcul largement accrus | Déclaration officielle |
| Capacités globales | Intelligence Index : 44 | 55, 4e du classement général | Tiers (AA, 2026-10-23) |
| Prix unitaire | Entrée : 3 $ / sortie : 15 $ | Entrée : 2 $ / sortie : 10 $, soit une baisse de 33 % | Tarifs officiels |
| Volume de sortie par tâche | 48 K tokens en moyenne | 55 K tokens en moyenne, soit 14 % de plus | Tiers (AA) |
| Contexte / modalités | 1 M / texte + image | 1 M / texte + image, inchangé | Déclaration officielle |
Les tokens sont l’unité de base utilisée pour mesurer et facturer les modèles. On peut les assimiler à des fragments de mots : un caractère chinois correspond généralement à un ou deux tokens. Pour lire ce tableau, retenez d’abord deux évolutions : le score de capacités augmente et le prix unitaire baisse. La troisième ligne, « Volume de sortie par tâche », détermine les économies réelles après la baisse de prix. Nous y revenons en détail à la section 4.
Concernant les poids, l’annonce officielle promet leur publication complète avant le 4 novembre 2026. À la date actuelle (24 octobre 2026), il s’agit toujours d’une promesse qui n’a pas encore été tenue : l’information reste donc « non vérifiée ». Selon l’analyse d’Artificial Analysis, une fois les poids publiés, K3.1 Pro deviendra le modèle à poids ouverts ayant obtenu le meilleur score dans son classement. L’écart entre le modèle à poids ouverts le mieux classé et le modèle fermé le mieux classé passera alors de 12 à 3 points.
2. Comparaison des scores de Kimi K3.1 Pro : mesures officielles et évaluations indépendantes
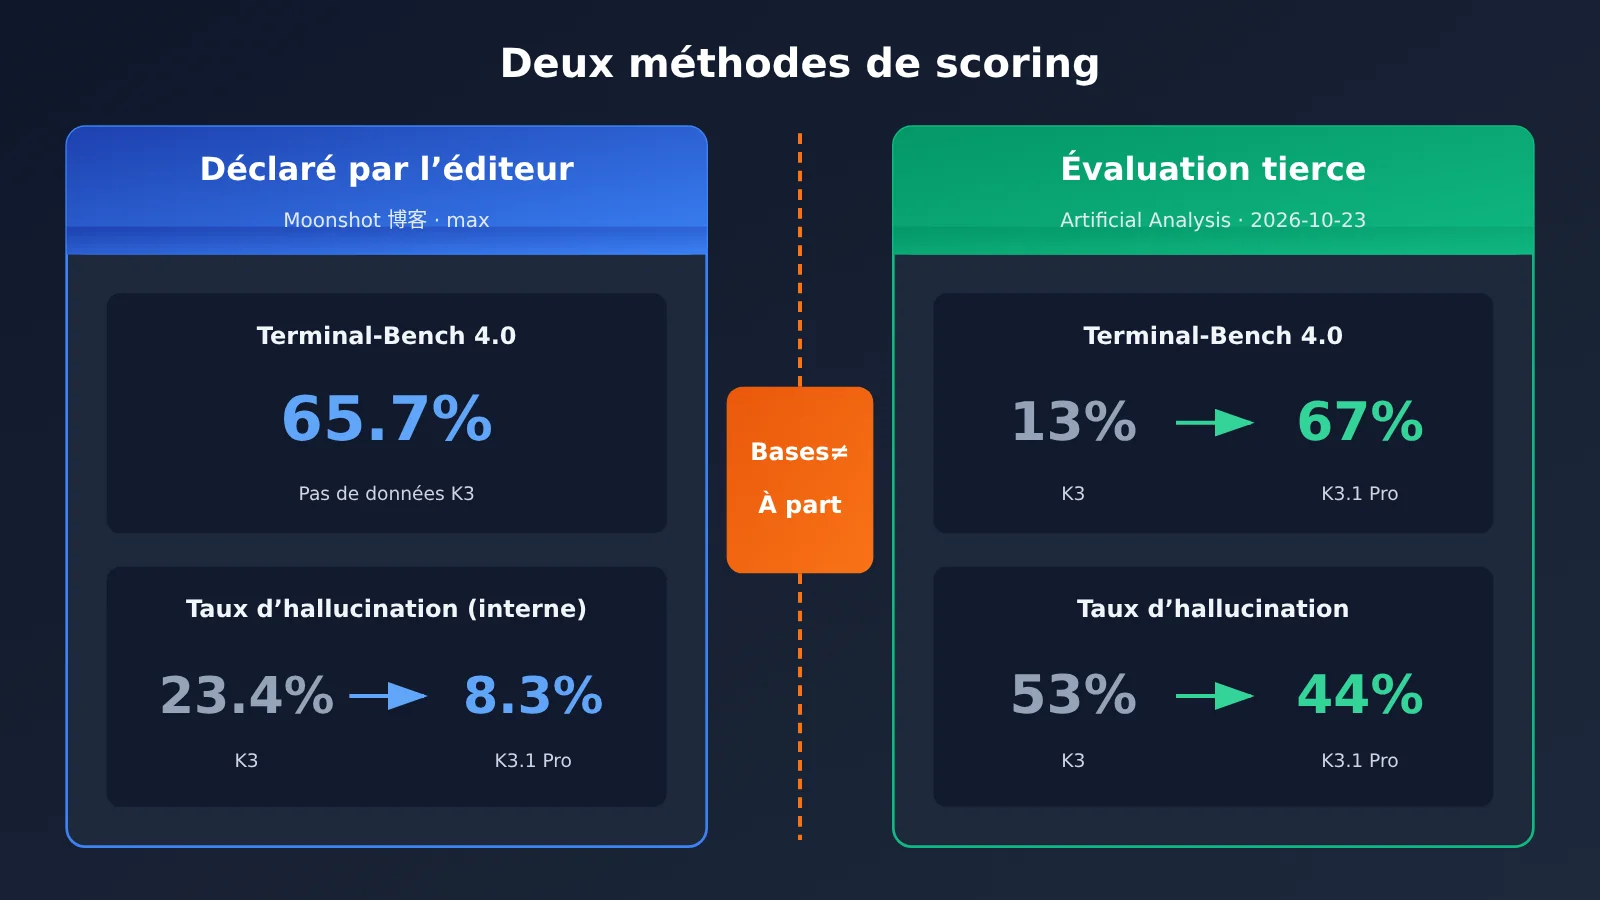
Un point important avant de commencer : les deux tableaux ci-dessous proviennent d’organismes différents et ont été établis dans des conditions de test différentes. Il ne faut donc pas les comparer directement. Terminal-Bench 4.0 en est l’exemple le plus parlant : le score officiel annoncé est de 65,7 %, tandis qu’Artificial Analysis a mesuré 67 % de façon indépendante. Ce sont deux résultats issus de deux tests distincts, et non deux estimations du même score. Moonshot n’a par ailleurs pas publié de résultat de K3 sur Terminal-Bench 4.0 : le score de 13 % pour K3 vient uniquement d’Artificial Analysis.
2.1 Scores officiels annoncés par Moonshot pour Kimi K3.1 Pro
Source : blog officiel de Moonshot. Conditions de test : sauf indication contraire, tous les tests ont été réalisés avec reasoning_effort=max (intensité de raisonnement réglée au maximum), temperature=1.0 et top_p=0.95. La mention « interne » désigne un jeu de tests créé par Moonshot, que des organismes externes ne peuvent pas reproduire.
| Épreuve | K3.1 Pro | Comparaison | Remarques |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | GPT-6 Astra : 58,2 % ; Claude Opus 5.5 : 66,4 % | Opus 5.5 a été évalué avec le framework Claude Code |
| Kimi Code Bench 3.0 Long-horizon | 61,2 % | K3 : 55,95 % | Interne ; tâches de programmation à long terme |
| BenchCAD | 92,7 % (avec outils) | Opus 5.5 : 96,2 % ; GPT-6 Astra : 95,9 % | Reconstitution de code CAD à partir de plans en plusieurs vues |
| OfficeQA Pro v2 | 64,4 | Supérieur à K3 | Analyse de documents financiers réels ; Moonshot revendique un état de l’art |
| Financial Modeling / Research | 7,2 / 11,6 points de plus que K3 | K3 | Interne |
| Business Operation | Environ 4,2 fois le score de K3 | K3 | Simulation interne de gestion d’entreprise |
| Kimi Hallu Bench Hard | Taux d’hallucination au niveau des affirmations : 8,3 % | K3 : 23,4 % | Test interne de résistance à l’évaluation factuelle |
| xdev-bench-hard (pass@3) | 81,0 % | Version de référence sans filtrage de sécurité : 90,5 % | Recherche de vulnérabilités |
Quelques termes à connaître : un harness est le « cadre de pilotage » qui entoure le modèle pendant les tests. Il gère l’utilisation des outils et l’exécution des commandes. Les scores peuvent varier d’un framework à l’autre ; il faut donc examiner séparément le résultat d’Opus 5.5. pass@3 signifie que le modèle dispose de trois essais pour répondre à une même question : une seule bonne réponse suffit pour que le test soit réussi. Enfin, la dernière ligne indique que Moonshot a volontairement réduit les capacités de recherche de vulnérabilités du modèle pour des raisons de sécurité. La version officielle obtient ainsi environ 9,5 points de pourcentage de moins que la version interne, non restreinte.
2.2 Évaluations tierces de Kimi K3.1 Pro (Artificial Analysis)
Source : Artificial Analysis. Données au 23 octobre 2026. L’organisme a exécuté les tests selon une procédure uniforme ; K3 et K3.1 Pro ont été évalués avec la même méthode.
| Indicateur | K3.1 Pro | K3 | Évolution |
|---|---|---|---|
| Intelligence Index | 55 (4e place) | 44 | +11 |
| GDPval-AA (Elo pour des tâches professionnelles réelles) | 1846 (3e place) | 1534 | +312 |
| Terminal-Bench 4.0 | 67 % | 13 % | +54 points de pourcentage |
| AutomationBench-AA (flux de travail SaaS) | 73 % | 58 % | +15 |
| Humanity’s Last Exam | 52 % | 47 % | +5 |
| CritPt / SciCode | 25 % / 61 % | 23 % / 59 % | +2 / +2 |
| AA-Omniscience Index | 30 | 20 | +10 |
| Taux d’hallucination / précision | 44 % / 51 % | 53 % / 48 % | Hallucinations : -9 |
| Nombre moyen de tokens générés par tâche | 55K | 48K | +14 % |
Dans le classement d’Artificial Analysis, K3.1 Pro occupe la 4e place, derrière Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) et Muse Wonder Full (56). Avec 67 %, K3.1 Pro obtient le meilleur score jamais mesuré par l’organisme sur Terminal-Bench 4.0 ; Sonnet 5.5 atteint 64 %.
Les deux évaluations vont dans le même sens concernant les hallucinations, mais leurs chiffres diffèrent fortement : les tests de résistance internes de l’entreprise font état d’une baisse de 23,4 % à 8,3 %, tandis que ceux d’AA indiquent une baisse de 53 % à 44 %. Les deux évaluations ne portent pas sur les mêmes questions et diffèrent aussi par leur difficulté et leur méthode de calcul. Lorsque vous citez ces résultats, indiquez leur source et évitez de les fusionner en une formule comme « le taux d’hallucination est tombé à 8 % ».
3. Les 5 domaines où Kimi K3.1 Pro progresse nettement
Cette section se concentre sur les domaines où les deux jeux de données montrent des progrès, ou dans lesquels l’ampleur des progrès est suffisamment importante.
- Agents de programmation et tâches sur terminal. Un agent est un assistant IA capable de décomposer une tâche, d’utiliser des outils et de l’exécuter en plusieurs étapes. Selon AA, le score de Terminal-Bench 4.0 passe de 13 % à 67 %, tandis que celui des tests internes de programmation sur de longues séquences d’actions passe de 55,95 % à 61,2 %. Si, avec K3, votre agent de programmation bloque souvent lors de l’exécution de commandes, de la gestion de fichiers ou du débogage en plusieurs étapes, c’est le domaine où le progrès est le plus marqué.
- Tâches professionnelles réelles. GDPval-AA mesure, à l’aide d’un score Elo, la capacité du modèle à accomplir des tâches professionnelles réelles. L’Elo est un système de classement utilisé notamment aux échecs : plus l’écart de score est grand, plus la différence de chances de gagner est importante. K3.1 Pro devance K3 de 312 points et se classe troisième. Cela indique une nette amélioration pour des tâches courantes comme rédiger des propositions, créer des tableaux ou organiser des documents.
- Automatisation des flux de travail SaaS. AutomationBench-AA évalue la capacité du modèle à automatiser des processus entre différents logiciels en ligne, par exemple lire des courriels, modifier des tickets ou synchroniser des tableaux. Le score passe de 58 % à 73 %. Le test interne de simulation de gestion (Business Operation) atteint environ 4,2 fois le score de K3, ce qui va également dans le sens d’une meilleure exécution des processus longs. Il s’agit toutefois de données internes, à prendre avec prudence.
- Fiabilité factuelle et hallucinations. Une hallucination se produit lorsque le modèle invente des faits inexistants en les présentant avec assurance. Dans les tests internes officiels, le taux d’hallucinations au niveau des affirmations (calculé pour chaque énoncé factuel) passe de 23,4 % à 8,3 %. Le nombre de réponses contenant au moins une erreur factuelle tombe à 42,4 % de celui de K3. Selon AA, le taux d’hallucinations passe de 53 % à 44 %, tandis que la précision progresse de 48 % à 51 %.
- Modélisation financière et rapports de recherche. Selon l’éditeur, le score de 64,4 obtenu à OfficeQA Pro v2 constitue le meilleur résultat actuel (SOTA). En interne, Financial Modeling et Financial Research dépassent respectivement K3 de 7,2 et 11,6 points. Ces résultats n’ont pas encore été vérifiés de manière indépendante par des tiers : ils relèvent donc de la catégorie « déclarations officielles ».
Les indicateurs de raisonnement scientifique (Humanity’s Last Exam, CritPt et SciCode) progressent également, mais seulement de 2 à 5 points de pourcentage. Si votre activité repose principalement sur les questions-réponses universitaires ou le code scientifique, les progrès de K3.1 Pro sont moins importants que pour les tâches d’agent. Les utilisateurs concernés n’ont donc pas besoin de se précipiter pour migrer.
4. Ce qui change peu avec Kimi K3.1 Pro et son coût réel
4.1 Les trois éléments qui n’ont pas changé avec Kimi K3.1 Pro
- La fenêtre de contexte reste à 1M : 1 048 576 tokens, comme pour K3. On peut voir le contexte comme la quantité totale de contenu que le modèle peut « lire » en une fois.
- Les modalités restent limitées au texte et aux images : aucun nouveau mode d’entrée, comme l’audio ou la vidéo, n’a été ajouté.
- Aucun benchmark de vitesse officiel n’a été publié : AA a mesuré une vitesse de génération de 80,7 tokens par seconde, ce qui place le modèle au niveau 2 sur 4 dans la classification de vitesse de cet organisme. L’éditeur affirme que la version highspeed est 2 à 3 fois plus rapide, sans toutefois fournir de conditions de test reproductibles. Cette affirmation reste donc « non vérifiée ».
4.2 Comparaison des cinq tarifs de Kimi K3.1 Pro
Voici les tarifs officiels, relevés le 24/10/2026, en dollars par million de tokens, hors taxes.
| Modèle | Entrée | Sortie | Cache : lecture | Cache : écriture pendant 5 min | Cache : écriture pendant 1 h |
|---|---|---|---|---|---|
kimi-k3.1-pro |
$2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
kimi-k3 |
$3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
La lecture du cache correspond à la réutilisation d’un contenu de préfixe identique envoyé plusieurs fois — par exemple, une invite système fixe ou le même long document — et est facturée au tarif réduit à partir de la deuxième requête. Les tarifs d’écriture pendant 5 minutes et 1 heure s’appliquent au stockage du contenu dans le cache : plus la durée de conservation est longue, plus le coût augmente. Le cache est très utile pour les agents ou les questions-réponses sur de longs documents. Si la structure de l’invite reste stable, il peut réduire sensiblement le coût de la partie entrée de la facture.
4.3 Le coût réel de Kimi K3.1 Pro : une baisse de prix ne signifie pas forcément des économies
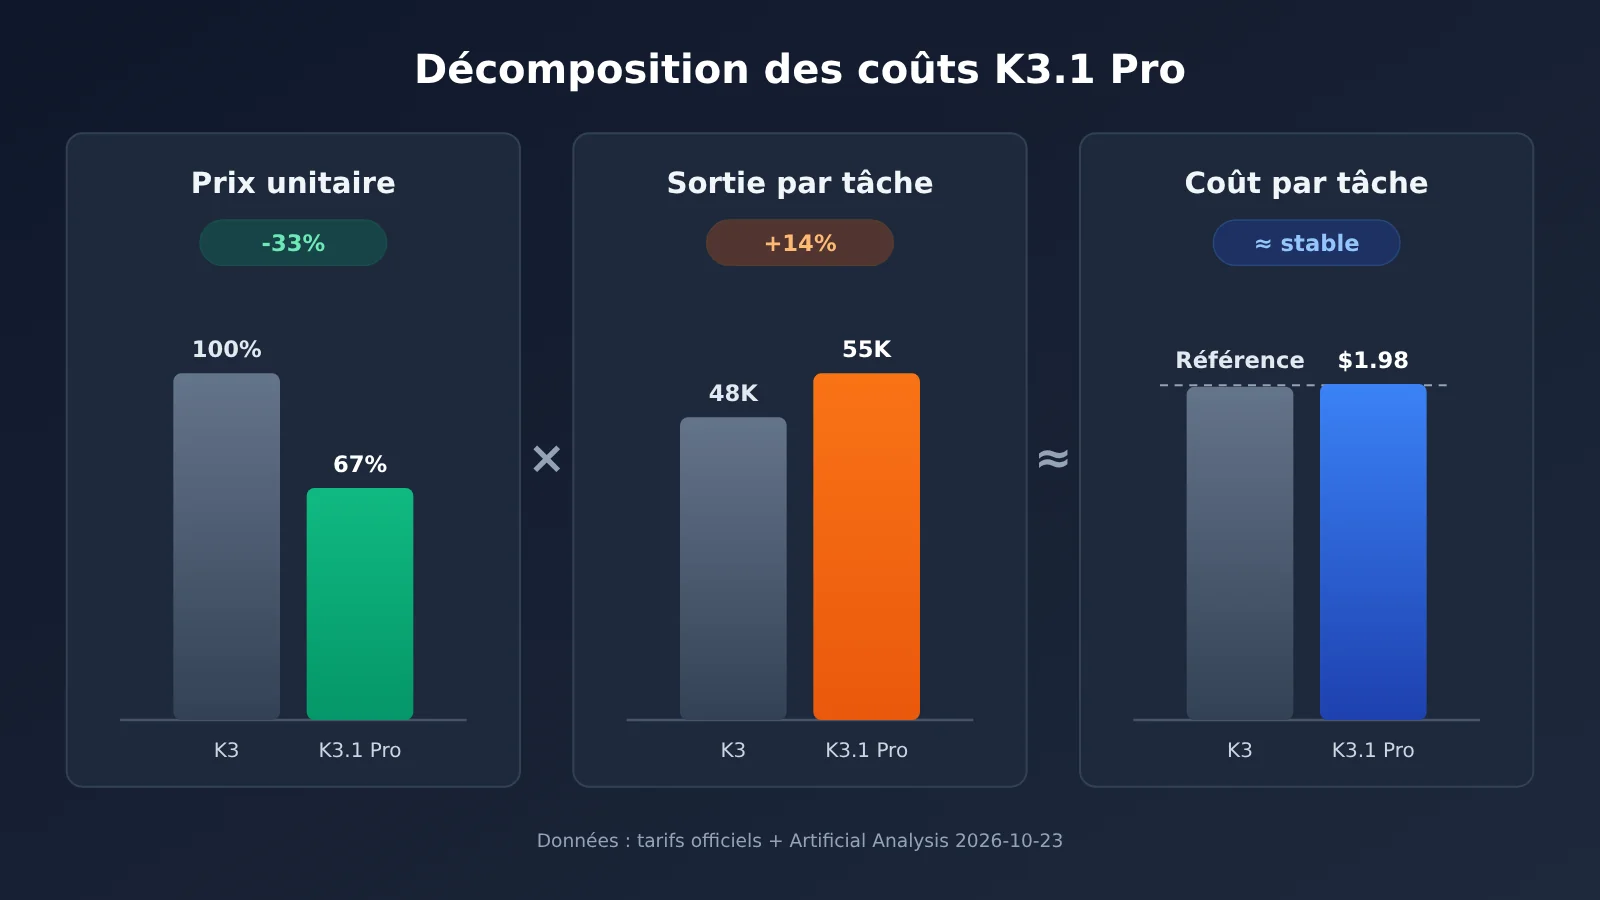
K3.1 Pro réfléchit systématiquement : avant chaque réponse, il effectue un raisonnement interne, facturé comme des tokens de sortie. AA a mesuré une moyenne de 55 000 tokens générés par tâche, soit 14 % de plus que les 48 000 de K3.
À prix unitaire, une baisse de 33 % devrait se traduire par des économies importantes. Pourtant, AA a mesuré un coût d’environ 1,98 $ par tâche (la page détaillée du modèle indique 2,11 $), soit un montant globalement comparable à celui de K3. L’organisme n’a pas publié de ventilation des coûts : aucune explication officielle ne permet donc de comprendre pourquoi les économies attendues ne se concrétisent pas. Une possibilité est que le nombre de tokens d’entrée augmente lui aussi lors des appels successifs d’une tâche d’agent. Cela reste une hypothèse, donc « non vérifiée ».
Par ailleurs, la version highspeed coûte deux fois plus cher que la version standard. Pour les équipes attentives aux coûts, mieux vaut tester un échantillon de tâches réelles avant de basculer et comparer la dépense totale, plutôt que le seul prix unitaire.
Pour comparer les dépenses réelles de K3 et K3.1 Pro dans une même base de code, vous pouvez commencer par intégrer l’interface compatible OpenAI d’APIYI, sur apiyi.com, et utiliser kimi-k3 comme référence. Pour connaître le modèle et le tarif de K3.1 Pro sur la plateforme, consultez la liste des modèles disponibles. Nous proposerons ce modèle prochainement.
5. Kimi K3.1 Pro : dans quels cas passer au nouveau modèle, et quand attendre
Voici nos recommandations par type de tâche, à l’intention des utilisateurs actuels de K3.
| Type de tâche | Recommandation | Raison |
|---|---|---|
| Agents de programmation, automatisation du terminal | Passer au nouveau modèle rapidement | Sur Terminal-Bench, le score de tiers passe de 13 % à 67 %. Le score officiel progresse de plus de 5 points pour les tâches de programmation à longue chaîne. |
| Analyse de documents, rapports de recherche et modélisation financière | Passer au nouveau modèle | Le score Elo sur GDPval gagne 312 points. Les tests officiels portant sur les rapports financiers et les rapports de recherche affichent une nette avance sur K3, avec une baisse marquée des hallucinations. |
| Flux de travail SaaS, processus métier en plusieurs étapes | Passer au nouveau modèle | Le score sur AutomationBench-AA passe de 58 % à 73 %. |
| Petites tâches en volume (classification, extraction, reformulation) | Rien ne presse | Le coût par tâche reste comparable à celui de K3. Le mode de réflexion permanent génère davantage de tokens en sortie, mais le gain de capacité apporte peu pour les tâches simples. |
| Scénarios sensibles à la latence (conversation en temps réel, service client en ligne) | Tester avant de décider | Aucune donnée de vitesse n’est publiée officiellement. Le mode de réflexion permanent allonge le délai avant le premier token, et l’offre highspeed coûte deux fois plus cher. |
« Rien ne presse » ne signifie pas que K3 n’est pas performant. Pour les tâches simples, K3 est déjà tout à fait adapté, et ses délais comme ses coûts sont plus faciles à prévoir. Il n’est donc pas nécessaire de réécrire tout un pipeline de traitement par lots pour obtenir un meilleur score global. Vous pouvez attendre la publication des poids de K3.1 Pro et des données de vitesse plus complètes provenant de tiers avant de réévaluer la situation.
5.1 Cas d’usage typiques pour Kimi K3.1 Pro
- Corriger des bugs, refactoriser du code et écrire des tests à l’échelle d’un dépôt, lorsque le modèle doit exécuter des commandes, examiner les erreurs, puis modifier le code de lui-même.
- Répondre à des questions sur de longs rapports financiers, contrats et rapports de recherche, ou en produire des résumés, avec une exigence élevée de précision factuelle.
- Automatiser des processus faisant appel à plusieurs outils en ligne, avec plus d’une dizaine d’étapes par tâche.
5.2 Cas d’usage typiques où conserver Kimi K3 pour le moment
- Classer des étiquettes ou extraire des champs pour des centaines de milliers d’enregistrements par jour, avec un coût calculé à la tâche.
- Assurer des interactions en temps réel avec une latence faible et stable, lorsque les délais d’attente et les paramètres de nouvelle tentative ont déjà été ajustés pour K3.
Conseil : la méthode la plus fiable consiste à prendre 50 à 100 exemples réels issus de votre activité, à les traiter avec les deux modèles, puis à comparer le taux de réussite et le coût total. Avec APIYI apiyi.com, une seule clé API permet de passer d’un modèle à l’autre, ce qui facilite ce type de test comparatif. Avant la mise en service de K3.1 Pro, vous pouvez établir une référence avec
kimi-k3. Consultez la liste des modèles de la plateforme pour connaître le nom et le prix de K3.1 Pro ; nous proposerons ce modèle dès que possible.
6. Recommandations et points de vigilance pour migrer vers Kimi K3.1 Pro
6.1 Calendrier de retrait de la série Kimi K2
Si vous utilisez encore un modèle de la série K2, commencez par planifier sa migration. D’après la documentation officielle, à partir du 31 octobre 2026, les nouveaux utilisateurs ne pourront plus accéder à la série K2, qui sera entièrement retirée d’ici la fin de l’année 2026. Les utilisateurs existants pourront encore l’utiliser temporairement, mais mieux vaut effectuer la migration dans les deux prochains mois et passer directement à K3 ou K3.1 Pro, sans attendre le retrait.
6.2 Trois conseils pratiques pour passer à Kimi K3.1 Pro
- Ouvrez une nouvelle session plutôt que de changer de modèle en cours de conversation. L’équipe recommande d’utiliser K3.1 Pro dans une nouvelle session. Reprendre l’historique d’une conversation K3 avec K3.1 Pro peut entraîner des problèmes de compatibilité avec le format du contexte ou le contenu de raisonnement.
- Privilégiez les interfaces natives. Les interfaces Responses, Chat Completions et Messages sont les plus fiables, selon la documentation officielle.
- Vérifiez soigneusement le nom du modèle. Si vous faites une faute en saisissant
kimi-k3.1-prodans un outil tiers, la requête basculera vers K2.8 Preview, qui ne raisonne pas. L’erreur ne déclenche aucun message : vous obtiendrez simplement des résultats moins bons, ce qui peut rendre le diagnostic fastidieux. Avant la mise en production, vérifiez le champ indiquant le modèle dans la réponse.
6.3 Différences entre les formules d’abonnement Kimi Code
L’accès aux nouveaux modèles dans Kimi Code dépend de votre formule d’abonnement :
k3.1-pronécessite un abonnement Plus ou supérieur.- Le contexte de 1M nécessite un abonnement Pro ou supérieur.
- La version highspeed nécessite un abonnement Pro ou supérieur et consomme environ deux fois plus de quota.
Avec un abonnement Plus, vous pouvez utiliser K3.1 Pro, mais pas bénéficier de toute la fenêtre de contexte de 1M. Si vous comptez surtout sur un très long contexte pour analyser l’ensemble d’un dépôt de code, vérifiez votre formule avant de décider de passer à l’offre supérieure.
6.4 Liste de vérification pour l’intégration via API
- Renseignez
base_urlavechttps://api.apiyi.com/v1, l’adresse compatible avec OpenAI d’APIYI (apiyi.com). Pour le code existant utilisant le SDK OpenAI, il suffit de modifier cette valeur et la clé API. - Pour commencer, utilisez
kimi-k3afin de vérifier le bon fonctionnement du processus, puis renseignez l’identifiant exact de K3.1 Pro indiqué dans la liste des modèles de la plateforme. L’identifiant et le prix de K3.1 Pro sont ceux affichés dans cette liste. Nous proposerons ce modèle dès que possible. - Augmentez raisonnablement le délai d’expiration : le raisonnement systématique peut ralentir les réponses.
- Ne définissez pas une valeur trop faible pour
max_tokens, au risque que le contenu de raisonnement prenne la place de la réponse principale.
FAQ
Q1 : Qu’est-ce que Kimi K3.1 Pro et quel est son lien avec K3 ?
K3.1 Pro est une nouvelle version de K3, entraînée par Moonshot avec davantage de calcul lors du post-entraînement. Selon l’entreprise, c’est le premier modèle de la série K3.1. Sa fenêtre de contexte et ses modalités d’entrée sont identiques à celles de K3. Les principales améliorations concernent les agents de programmation, les tâches professionnelles réelles et l’exactitude factuelle.
Q2 : Le score de Kimi K3.1 Pro à Terminal-Bench est-il de 65,7 % ou de 67 % ?
Les deux chiffres sont corrects, mais ils proviennent de sources différentes. Le score de 65,7 % est celui annoncé par l’entreprise, tandis que celui de 67 % a été mesuré indépendamment par Artificial Analysis. Les environnements de test et les harnais étant différents, ces scores ne sont pas directement comparables. Pensez à préciser la source lorsque vous les citez.
Q3 : Le prix de Kimi K3.1 Pro a baissé de 33 %. Pourquoi ne permet-il pas de faire des économies ?
Le modèle réfléchit systématiquement, et le nombre moyen de tokens générés par tâche est supérieur de 14 % à celui de K3. Selon les mesures d’AA, le coût par tâche est d’environ 1,98 $ (la page du modèle indique 2,11 $), soit à peu près le même que pour K3. L’organisme n’a pas détaillé les raisons de cet écart. Le mieux est donc de faire vos propres tests avec vos tâches.
Q4 : Quand les poids de Kimi K3.1 Pro seront-ils disponibles ?
L’entreprise s’est engagée à publier les poids complets avant le 4 novembre 2026. Au 24 octobre 2026, cet engagement n’a pas encore été tenu. Si vous prévoyez un déploiement autonome, fiez-vous à la date de publication effective annoncée par l’entreprise.
Q5 : Comment comparer rapidement Kimi K3.1 Pro et K3 via une API ?
Vous pouvez créer un compte sur APIYI apiyi.com pour obtenir une clé API et un crédit de test gratuit. Utilisez d’abord l’interface compatible avec OpenAI pour tester `kimi-k3` comme référence. Le nom du modèle et son prix sur la plateforme dépendront de la liste des modèles proposée. Nous ajouterons ce modèle dès que possible ; une fois disponible, il vous suffira de modifier le paramètre `model` pour faire la comparaison.
Q6 : Quelles sont les limites connues de Kimi K3.1 Pro ?
– L’entreprise n’a pas publié de mesures de vitesse, et la version highspeed coûte deux fois plus cher.
– Le modèle réfléchit systématiquement : il n’est donc pas adapté aux scénarios qui exigent une latence très faible.
– Certains résultats particulièrement impressionnants proviennent de jeux de test internes, impossibles à reproduire depuis l’extérieur.
– Ses capacités de recherche de vulnérabilités sont limitées par des mesures de sécurité et sont inférieures à celles de la version non filtrée.
Q7 : J’utilise encore K2. Dois-je passer directement à K3.1 Pro ?
À partir du 31 octobre 2026, la série K2 ne sera plus accessible aux nouveaux utilisateurs et sera retirée avant la fin de l’année : la migration est donc incontournable. Pour les agents de programmation et les tâches liées aux documents, vous pouvez passer directement à K3.1 Pro. Pour les tâches simples en lot, K3 sera plus pratique. Sur APIYI apiyi.com, vous pouvez commencer la migration avec `kimi-k3`. Le nom du modèle et son prix pour K3.1 Pro dépendront de la liste des modèles proposée. Nous ajouterons ce modèle dès que possible.
Points clés de Kimi K3.1 Pro
- Des capacités nettement améliorées : le score global AA passe de 44 à 55, pour une 4ᵉ place, derrière seulement trois modèles propriétaires.
- Les agents de programmation progressent le plus : sur Terminal-Bench 4.0, un test indépendant fait état d’une hausse de 13 % à 67 %.
- Ne confondez pas les deux jeux de données : les chiffres communiqués par l’éditeur et ceux de l’évaluation AA ne reposent pas sur la même méthodologie. Pensez à toujours préciser leur source.
- Une baisse de prix ne signifie pas une baisse des coûts : le prix unitaire diminue de 33 %, mais le coût par tâche reste à peu près au même niveau qu’avec K3.
- Les caractéristiques de base restent inchangées : fenêtre de contexte de 1M, prise en charge du texte et des images ; aucune donnée officielle sur la vitesse.
- Indiquez précisément le nom du modèle lors de la migration : en cas d’erreur, vous risquez de basculer sur K2.8 Preview, sans mode de raisonnement.
- Pour l’intégration : vous pouvez commencer par établir une référence avec K3 via APIYI (apiyi.com). Le nom et le prix de K3.1 Pro dépendront de la liste des modèles de la plateforme. Ce modèle sera disponible dès que possible.
En résumé : faut-il migrer de K3 à Kimi K3.1 Pro ?
Les différences entre Kimi K3.1 Pro et la génération précédente se résument à trois points :
- Capacités : les agents de programmation, les tâches sur terminal, les tâches professionnelles réelles, l’automatisation SaaS et la factualité progressent nettement. Les résultats des évaluations indépendantes et les données officielles vont dans le même sens.
- Prix : le prix unitaire baisse de 33 % dans les cinq catégories, mais le mode de raisonnement activé en permanence génère des réponses plus longues. Le coût par tâche diminue donc très peu.
- Migration : pour les activités liées aux agents de programmation et aux documents de recherche, mieux vaut migrer rapidement. Pour les petites tâches en volume et les cas sensibles à la latence, testez d’abord avant de décider. Les utilisateurs de K2 doivent terminer leur migration avant la fin de l’année.
APIYI (apiyi.com) propose déjà plusieurs modèles Kimi, dont kimi-k3 (3 $ en entrée et 15 $ en sortie). Vous pouvez utiliser la même clé et une interface compatible avec OpenAI pour établir une référence en matière de coûts et de performances. Le nom et le prix de Kimi K3.1 Pro sur la plateforme seront indiqués dans la liste des modèles. Ce modèle sera disponible dès que possible ; il vous suffira alors de remplacer le nom du modèle pour comparer les résultats.
Références
- Blog officiel de Moonshot : annonce de lancement de Kimi K3.1 Pro et résultats de benchmark communiqués par l’éditeur
- Remarque : source des données de la catégorie « données communiquées par l’éditeur » dans cet article. Conditions de test :
reasoning_effort=max,temperature=1.0,top_p=0.95 - Documentation officielle de Moonshot : tarifs, calendrier de retrait de K2, recommandations pour changer de modèle et informations sur l’abonnement Kimi Code
- Remarque : tarifs relevés le 24 octobre 2026, en dollars par million de tokens, hors taxes
- Artificial Analysis : évaluation indépendante de modèles par un organisme tiers
- Lien :
artificialanalysis.ai - Remarque : source des données de la catégorie « données de tiers » dans cet article, datées du 23 octobre 2026
Auteur : équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel d’APIYI. Pour plus d’informations sur l’intégration, consultez le centre de documentation à docs.apiyi.com. Le nom du modèle et son prix pour Kimi K3.1 Pro sont ceux indiqués dans la liste des modèles de la plateforme. Nous proposerons ce modèle dès que possible.