Note de l’auteur : retour sur la manière dont Claude a retrouvé l’origine des graines des courbes elliptiques du NIST, sur les limites de cette conclusion et sur trois façons d’utiliser un agent IA en recherche, avec du code et des conseils pour maîtriser les coûts.
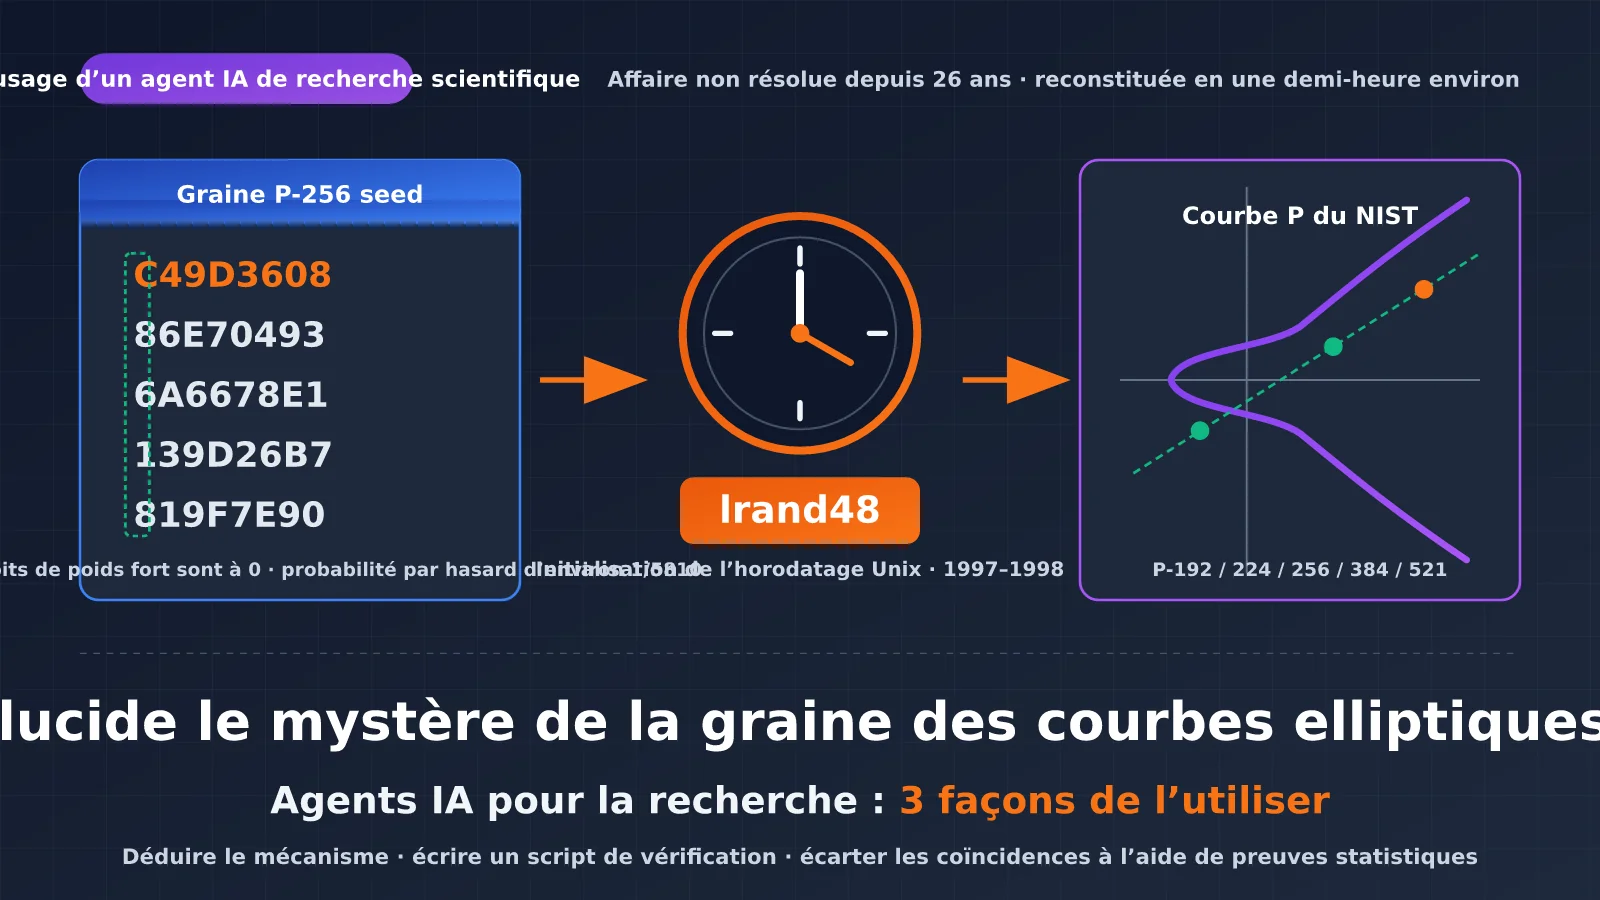
Le 17 octobre 2026, l’équipe Frontier Red Team d’Anthropic a publié une étude : sans aucune invite, un modèle de recherche interne a retrouvé en une trentaine de minutes la méthode de génération des graines des cinq courbes NIST P-192, P-224, P-256, P-384 et P-521. Ces graines n’avaient été soumises à aucun algorithme de hachage : elles provenaient du générateur pseudo-aléatoire lrand48, intégré aux bibliothèques C des années 1990, avec un horodatage Unix comme valeur initiale. Le message officiel d’@AnthropicAI se résumait à « It is just timestamps. » et a recueilli environ 855 000 vues.
Il ne s’agit ni d’une attaque cryptographique ni d’une nouvelle vulnérabilité. Pour les chercheurs, l’intérêt de cet exemple tient à la méthode de Claude : déduire le mécanisme, écrire un script pour le vérifier, puis écarter les coïncidences à l’aide de preuves statistiques. Cette démarche peut être directement adaptée à vos propres travaux.
L’essentiel : vous saurez ce que cet exemple démontre — et ce qu’il ne démontre pas — et découvrirez trois méthodes de travail avec un agent IA de recherche à mettre en pratique dès maintenant. Chacune comprend des étapes détaillées et du code exécutable.
Le mystère des graines des courbes elliptiques du NIST résolu par Claude : les points essentiels
| Point clé | Explication | Ce que cela signifie pour les chercheurs |
|---|---|---|
| Contexte | En 2000, le NIST a adopté l’ECDSA dans la norme FIPS 186-2. Les graines des courbes ont été fournies par la NSA, sans explication sur leur origine. | Un problème resté sans solution pendant 26 ans peut servir à évaluer les capacités de raisonnement de l’IA. |
| Conclusion | Les graines proviennent de sorties de lrand48, initialisé à partir d’horodatages compris entre mai 1997 et avril 1998. |
La conclusion est reproductible par tout le monde et facile à vérifier. |
| Méthode clé | Déduire comment le logiciel avait été écrit, créer son propre outil de balayage, repérer des caractéristiques statistiques, puis retrouver l’état du générateur. | Ces trois étapes peuvent être adaptées à l’analyse de données expérimentales, à la modélisation inverse et à d’autres tâches. |
| Conséquences pour la sécurité | Il ne s’agit pas d’une vulnérabilité : les utilisateurs n’ont pas besoin de modifier leur configuration ni de migrer. | Dans un article de synthèse ou un rapport, il faut présenter les faits avec précision, sans les exagérer. |
| Questions en suspens | La graine de B-163 n’a pas été résolue, et la méthode de génération du point de base G pour P-224 à P-521 reste inconnue. | Les conclusions de l’IA ont elles aussi leurs limites : il faut consigner les questions qui restent sans réponse. |
Le mystère des graines des courbes elliptiques du NIST : ce que cette découverte démontre
La norme ECDSA publie une graine pour chaque courbe. Le hachage de cette graine sert à déterminer le coefficient b de la courbe. La graine de P-256 est C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. Comme son origine n’a jamais été expliquée, la communauté a longtemps craint que la NSA ait délibérément choisi des paramètres comportant une faiblesse. Koblitz et Menezes ont publié une synthèse intitulée A Riddle Wrapped in an Enigma, et Filippo Valsorda a même offert une prime de 36 864 dollars pour résoudre le mystère. Une rumeur a un temps attribué la graine au hachage d’une plaisanterie de Jerry Solinas, mais cette hypothèse a depuis été réfutée.
Cette découverte renforce en pratique la confiance accordée à ces courbes. Les graines ont été générées par un générateur de nombres pseudo-aléatoires ordinaire, initialisé à partir de l’horloge : il n’y avait donc pas de marge pour les choisir à la main, et n’importe qui peut reproduire le processus. Le texte d’origine indique aussi qu’un petit nombre de courbes candidates, pourtant utilisables, ont été écartées sans que l’on sache pourquoi. Elles sont toutefois trop peu nombreuses pour suggérer une sélection délibérée de courbes faibles. La prime sera versée à l’Internet Security Research Group.
Pour citer cette découverte dans un article ou lors d’une réunion d’équipe, une formulation précise serait : « L’IA a reconstitué le processus de génération d’un paramètre historique et l’a rendu reproductible. » Évitez d’écrire que « l’IA a cassé les courbes elliptiques ».
Les 4 étapes du raisonnement de Claude sur les graines
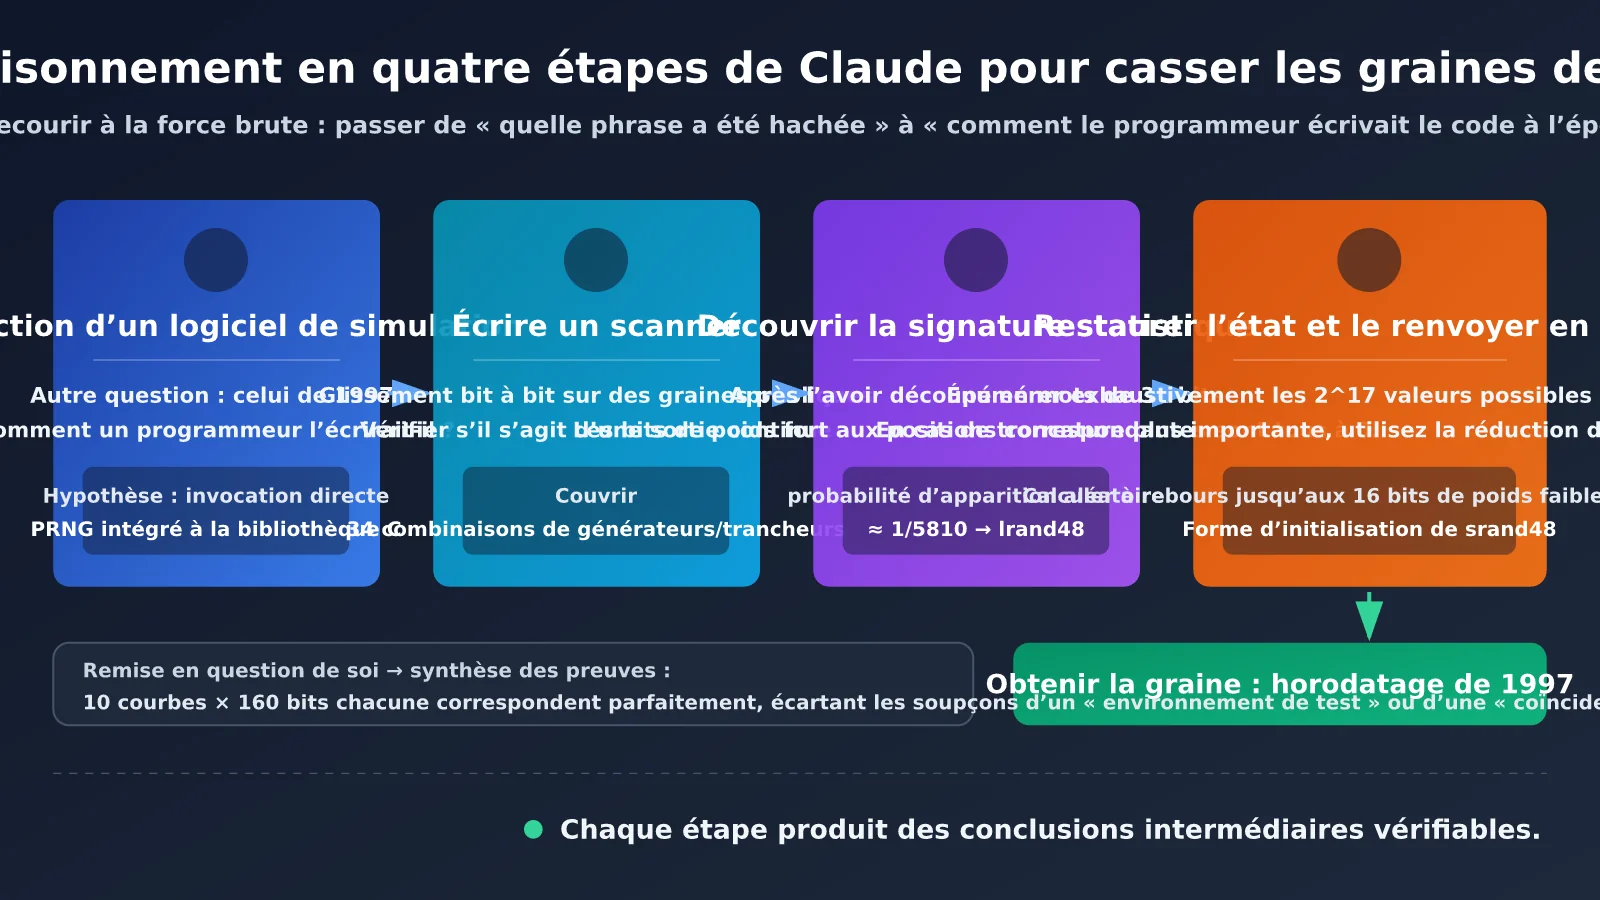
Ce raisonnement ne reposait pas sur des suppositions faites par force brute. Il suivait une chaîne logique que l’on peut vérifier :
- Reformuler le problème : au lieu de chercher « quelle phrase a été hachée », déduire comment les auteurs du programme de génération des courbes, en 1997, auraient probablement écrit leur code. Conclusion : ils ont vraisemblablement utilisé le générateur de nombres aléatoires intégré à la bibliothèque C.
- Écrire un outil de balayage : faire glisser une fenêtre sur les graines publiées et vérifier si des segments voisins ressemblent aux sorties consécutives d’un générateur des années 1990. Au total, 34 combinaisons de générateurs et de découpages ont été testées.
- Repérer une signature statistique : après avoir découpé les graines en mots de 32 bits, les bits de poids fort étaient tous nuls aux positions correspondantes. La probabilité que cela arrive par hasard est d’environ 1 sur 5 810. Cela correspond à la particularité de
lrand48, qui ne renvoie que les 31 bits de poids fort de son état de 48 bits. - Retrouver l’état et remonter le temps : tester les 2^17 valeurs possibles des 17 bits cachés, puis vérifier les mots suivants. Pour les graines tronquées davantage, résoudre le problème avec la réduction de base de réseau LLL. Enfin, remonter l’état jusqu’à retrouver la forme initiale de
srand48, où les 16 bits de poids faible valent0x330E.
Un détail mérite aussi d’être relevé : le modèle a un moment soupçonné se trouver dans un environnement de test. Il a ensuite écarté cette hypothèse en s’appuyant sur un argument simple : « 10 courbes, 160 bits chacune, tous concordants : ce ne peut pas être une coïncidence. » Cette démarche — d’abord remettre en question sa propre conclusion, puis s’appuyer sur les preuves pour trancher — est précisément ce qu’on attend d’un agent de recherche.
Prise en main rapide d’un agent IA pour la recherche : un seul Key pour appeler un modèle phare
Avant de vous lancer, commencez par vérifier que la chaîne d’appel à l’API fonctionne. APIYI propose une interface compatible avec OpenAI : une seule clé permet d’appeler claude-opus-5-5 et de passer aux modèles phares de la gamme GPT ou Gemini pour effectuer des vérifications croisées.
Inutile de reprendre ici les étapes de connexion : consultez directement le guide de démarrage rapide officiel d’APIYI à l’adresse docs.apiyi.com/getting-started. Suivez les instructions pour créer une clé dans la console, récupérer le base_url (https://api.apiyi.com/v1) et vérifier que tout fonctionne à l’aide de l’exemple fourni. Les tarifs et les modèles disponibles sont ceux indiqués dans la console.
Les trois méthodes présentées plus loin utilisent le même petit module, à enregistrer sous research_client.py. Il se limite à deux fonctions : choisir un modèle en fonction de l’étape et cumuler l’utilisation des tokens pour maîtriser les coûts.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
Maîtriser le coût d’un agent IA de recherche : déboguer avec un modèle économique, réserver le modèle phare aux vérifications importantes
Les tâches de recherche demandent souvent plusieurs cycles d’itération. Si vous utilisez un modèle phare à chaque étape, vous risquez de dépenser votre quota pour des problèmes peu importants, comme des erreurs de format ou des échecs d’analyse JSON. Une approche plus sûre consiste à répartir les modèles selon les étapes :
| Étape | Modèle recommandé | Critère d’évaluation | Valeur typique de max_tokens |
|---|---|---|---|
| Débogage du flux (format de l’invite, analyse, évaluation) | Modèle léger et économique | Le processus fonctionne de bout en bout sans erreur | 512-1024 |
| Génération d’hypothèses (liste de mécanismes possibles) | Privilégier un modèle léger, puis passer au modèle phare si la couverture est insuffisante | La liste couvre les principales hypothèses déjà connues | 1024-2048 |
| Raisonnement sur les mécanismes et vérifications importantes | claude-opus-5-5 | La conclusion sera intégrée à un article ou déterminera les prochains investissements expérimentaux | 2048-4096 |
| Vérification croisée | Passer à un autre modèle phare avec la même clé | Les deux modèles aboutissent indépendamment à la même conclusion | 2048 |
En pratique, retenez cette règle : pour la première exécution du script, utilisez un modèle économique ; pour la première conclusion concrète, utilisez un modèle phare.
Agent IA pour la recherche, méthode 1 : commencer par raisonner sur les mécanismes, puis les vérifier
Cette étape reprend l’approche de Claude qui consiste à « reformuler la question » : au lieu de deviner directement la réponse, on commence par raisonner sur les mécanismes qui ont produit les données, puis on les met à l’épreuve. Cette méthode convient notamment lorsqu’une série de données expérimentales présente des régularités inattendues, qu’il faut reconstituer le processus historique ayant généré des données ou que les paramètres utilisés dans un article sont introuvables.
Étapes
- Décrivez uniquement les observations, sans avancer d’hypothèse : transmettez au modèle les données observées, les contraintes connues et le contexte historique. Évitez d’écrire « je pense que XX en est la cause », afin de ne pas l’orienter.
- Demandez une liste de mécanismes et de prédictions réfutables : associez à chaque mécanisme envisagé une prédiction du type « si ce mécanisme est correct, quelle caractéristique devrait apparaître dans les données ? ».
- Classez les mécanismes selon leur coût de vérification : demandez au modèle de les trier par durée de vérification croissante et commencez par les plus rapides à tester.
- Faites réexaminer le classement par un modèle phare : vous pouvez générer une première liste avec un modèle économique, puis confier le classement final et le raisonnement à claude-opus-5-5.
Modèle d’invite
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
Pour vérifier que cette étape est bien menée, appuyez-vous sur deux critères : chaque mécanisme doit être associé à une prédiction réfutable, et la vérification classée en tête doit pouvoir être réalisée en moins d’une heure. Si l’un de ces critères n’est pas respecté, demandez au modèle de recommencer.
Deuxième usage d’un agent IA de recherche : demander au modèle d’écrire des scripts de balayage et de validation
Cette étape reprend la démarche de Claude, qui a écrit un outil de balayage couvrant 34 combinaisons de générateurs et de découpages. L’enjeu est de transformer une ressemblance apparente en un résultat statistiquement peu susceptible d’être dû au hasard. Cette approche convient notamment au balayage de paramètres, à la détection de signaux et à la recherche de structures cachées dans des données.
Étapes
- Transmettez au modèle la prédiction de l’usage un dont le coût de validation est le plus faible et demandez-lui d’écrire un script de balayage qui ne dépend que de la bibliothèque standard.
- Demandez au script de lancer également un groupe témoin aléatoire et d’afficher le « taux de correspondance des données réelles » et le « taux de correspondance des données aléatoires ».
- Exécutez le script localement. Le modèle écrit le code, mais ne rend pas compte des résultats.
- Si les résultats sont significatifs, demandez ensuite à un modèle phare d’écrire un script plus rigoureux de récupération d’état ou d’ajustement.
Exemple : reproduire une signature statistique où « tous les bits de poids fort sont à 0 »
Le script ci-dessous illustre le principe de la signature observée dans ce cas. lrand48 renvoie les 31 bits de poids fort d’un état de 48 bits. Ainsi, une fois la valeur placée dans un mot de 32 bits, son bit de poids fort est toujours à 0. Pour des données véritablement aléatoires, la probabilité que le bit de poids fort de chaque mot soit à 0 n’est que de moitié.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # Initialisation de srand48 : les 16 bits de poids faible sont fixés à 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 ne renvoie que les 31 bits de poids fort
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # Un horodatage Unix de la période autour de 1997
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("Proportion de bits de poids fort à 0 avec lrand48 :", top_bit_zero_ratio(lr))   # Toujours égale à 1.0
print("Proportion de bits de poids fort à 0 avec des données aléatoires :", top_bit_zero_ratio(rnd))  # Fluctue autour de 0.5
Vérifier la conclusion finale avec le code officiel
La page de recherche d’Anthropic fournit le code de reproduction, publié sous licence CC0. D’après les instructions officielles, les paramètres ci-dessous doivent produire la graine de la norme P-256 :
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("Conforme à la norme :", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
Le script initialise lrand48 à partir de l’horodatage, puis combine chaque série de 20 valeurs en une graine candidate de 20 octets. La 1 842ᵉ candidate est celle de la norme. La vérification complète s’exécute en moins d’une seconde sur un ordinateur portable ordinaire. La structure idéale pour ce type de recherche est la suivante : « formuler une hypothèse coûte cher, mais vérifier la conclusion coûte peu ».
Troisième usage d’un agent IA de recherche : ajouter un évaluateur automatique et itérer jusqu’à stabilisation du score
Les deux premiers usages reposent sur un jugement humain ; le troisième confie l’évaluation à un programme. Vous écrivez un évaluateur, le modèle soumet une proposition à chaque tour, et l’évaluateur renvoie un score et les exemples en échec. Le modèle s’appuie sur ces retours pour ajuster sa proposition jusqu’à ce que le score cesse de progresser. Cette méthode convient aux règles d’extraction de données, à la recherche de la forme d’une fonction d’ajustement ou à l’exploration de paramètres expérimentaux, dès lors que la tâche dispose d’un critère d’évaluation clair.
Étapes
- Écrivez d’abord l’évaluateur, puis choisissez le modèle : l’évaluateur doit être un programme déterministe qui ne dépend pas de la propre évaluation du modèle.
- Séparez les données de développement des données de validation : les retours doivent se baser uniquement sur les données de développement ; utilisez les données de validation à la fin pour détecter un éventuel surajustement.
- Limitez le format des réponses : demandez au modèle de fournir des données comme du JSON ou des expressions régulières, plutôt que d’exécuter directement le code généré. Si l’exécution de code est indispensable, faites-la dans un bac à sable.
- Définissez une condition d’arrêt : arrêtez-vous dès que l’une de ces conditions est remplie : score maximal, absence d’amélioration pendant 2 tours consécutifs ou nombre maximal de tours atteint.
- Mettez d’abord la boucle au point avec un modèle moins coûteux, puis passez à un modèle phare pour l’expérience officielle.
Exemple : itérer sur des expressions régulières pour extraire des paramètres de comptes rendus expérimentaux
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
À noter : si le modèle obtient le score maximal sur les données de développement, mais que son score baisse nettement sur les données de validation, c’est qu’il « mémorise les réponses ». Dans ce cas, mieux vaut enrichir les données de développement plutôt que de poursuivre les itérations.
Comparaison des trois usages d’un agent IA de recherche
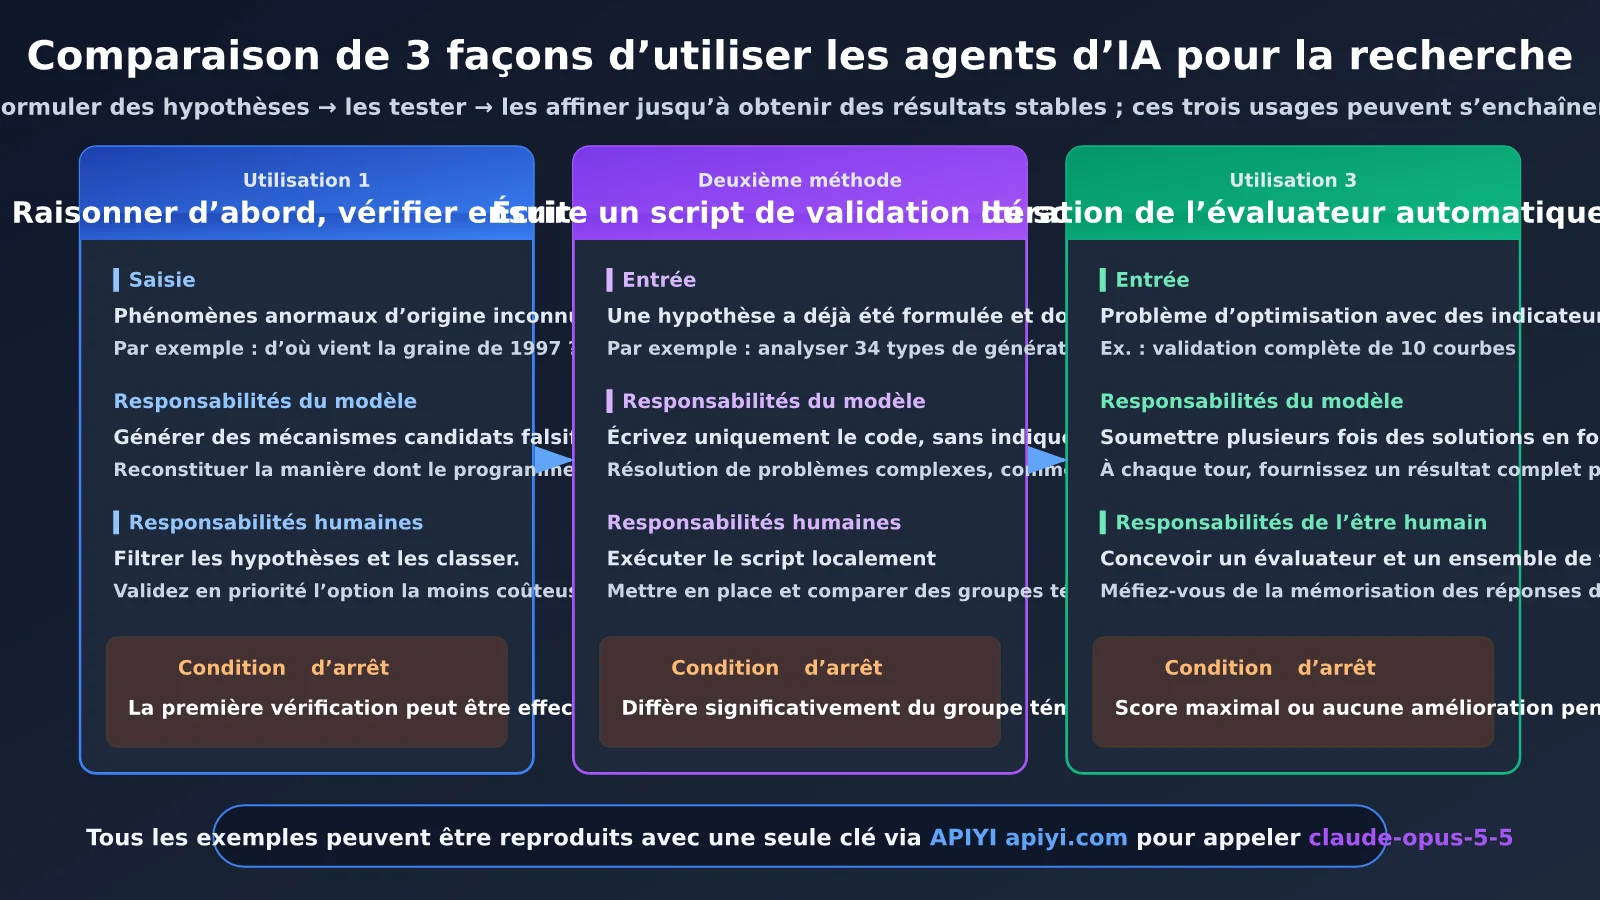
| Critère | Usage un : déduire le mécanisme | Usage deux : script de balayage et de validation | Usage trois : itération avec évaluation automatique |
|---|---|---|---|
| Étape correspondante du cas | Déduire comment le programme a été écrit en 1997 | Balayer 34 générateurs et rechercher une signature statistique | Après la récupération de l’état, vérifier les 10 courbes dans leur intégralité |
| Tâches adaptées | Anomalies dont la cause est inconnue, hypothèses de rétro-ingénierie | Hypothèse déjà formulée, à vérifier quantitativement | Problèmes d’optimisation avec un indicateur clair |
| Rôle du modèle | Générer des mécanismes candidats réfutables | Écrire le code, sans rendre compte des résultats | Soumettre des propositions de façon itérative |
| Rôle de la personne | Filtrer et classer les hypothèses | Exécuter le script localement et examiner le groupe témoin | Concevoir l’évaluateur et les données de validation |
| Quand faire intervenir un modèle phare | Pour la déduction et le classement finaux | Pour écrire un solveur complexe, comme LLL | Pour les tours de l’expérience officielle |
| Condition d’arrêt | Première vérification réalisable en moins d’une heure | Écart significatif par rapport au groupe témoin aléatoire | Score maximal ou aucune amélioration pendant 2 tours |
| Mode d’appel | Interface unifiée APIYI apiyi.com | Idem | Idem |
Ces trois usages peuvent s’enchaîner : l’usage un produit une hypothèse, l’usage deux la vérifie, et l’usage trois affine la solution validée jusqu’à ce qu’elle soit stable.
Pourquoi les tâches de recherche comme celles de Claude nécessitent un modèle phare
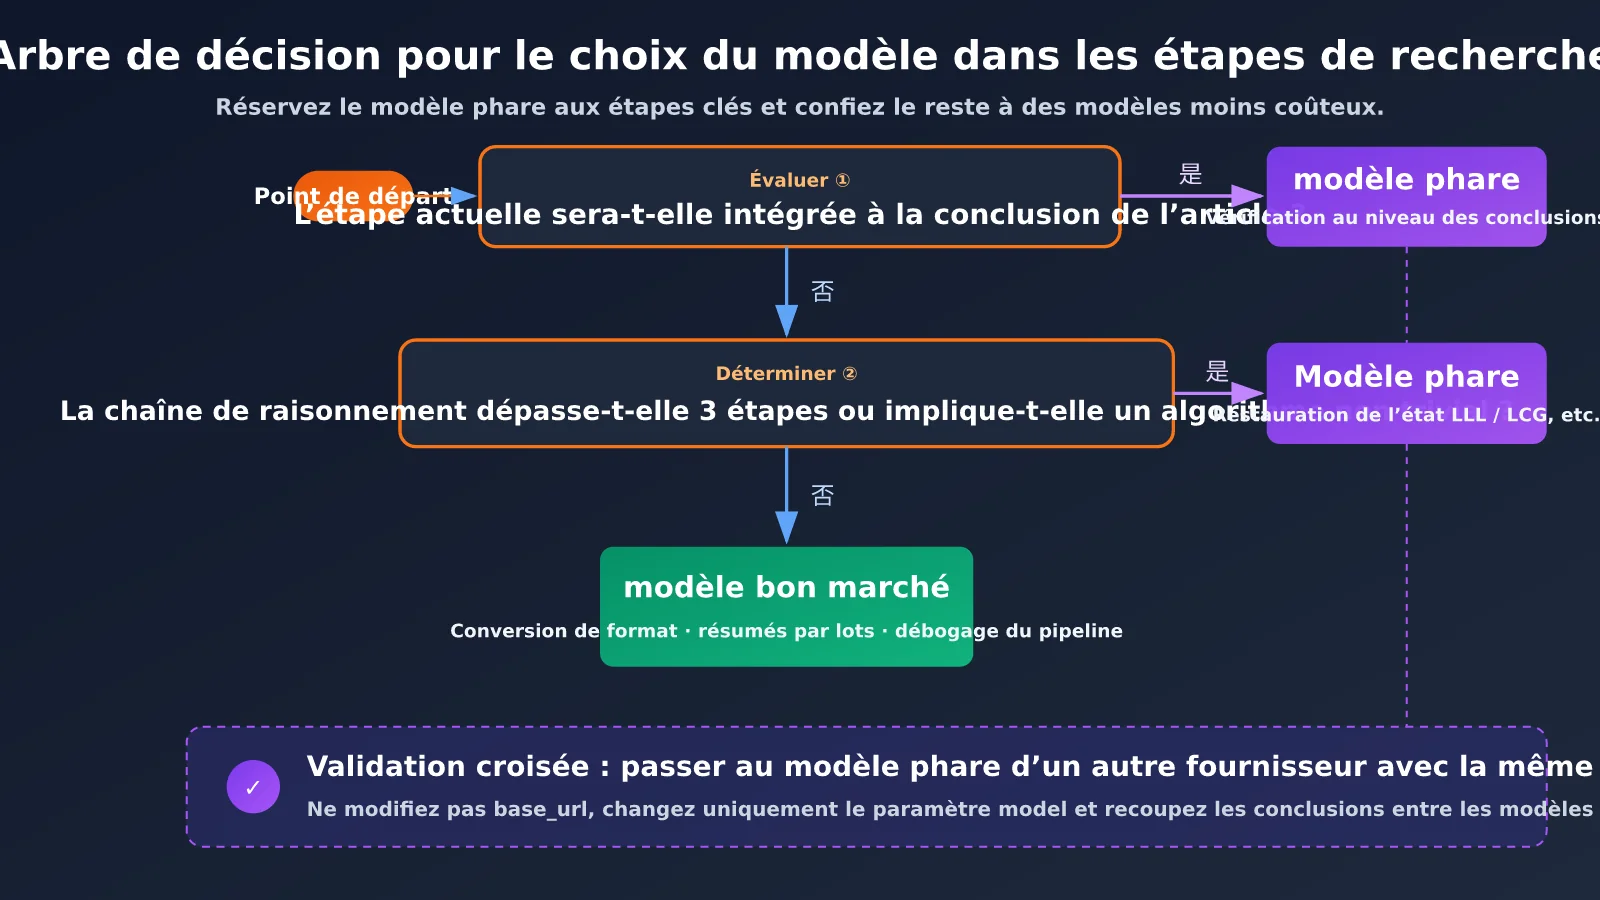
Toutes les étapes d’une recherche ne nécessitent pas un modèle phare, mais certaines deviennent pratiquement impossibles avec un modèle plus petit. Le tableau ci-dessous vous aidera à faire le bon choix :
| Critère | Modèle phare recommandé si… | Pourquoi |
|---|---|---|
| Il faut faire des rapprochements entre différents domaines | Par exemple, passer de « graines de courbe » aux détails d’implémentation d’une bibliothèque C des années 1990 | Les petits modèles ont tendance à rester à la surface du problème, par exemple en continuant à deviner des expressions |
| Le raisonnement comporte plus de 3 étapes, chacune dépendant de la précédente | Par exemple : déduire → scanner → signer → restaurer l’état | Une erreur à n’importe quelle étape entraîne les suivantes dans la mauvaise direction |
| Il faut remettre ses propres hypothèses en question | Par exemple, se demander : « Suis-je en train de tester dans un environnement de test ? » | Un modèle phare est plus susceptible de chercher activement des contre-exemples |
| Le problème implique un algorithme non trivial | Par exemple, la réduction de base LLL ou la restauration de l’état d’un LCG tronqué | La justesse du code détermine directement la validité de la vérification |
| La conclusion sera publiée dans un article ou déterminera les moyens consacrés à une expérience | Toute conclusion destinée à être diffusée | Le coût d’une erreur dépasse largement celui de l’invocation |
À l’inverse, les conversions de format, les résumés en lot et le débogage d’un pipeline d’évaluation peuvent être confiés à un modèle moins coûteux. Pour maîtriser les coûts, l’essentiel n’est pas de moins utiliser les modèles phares, mais de les réserver aux cas du tableau ci-dessus.
FAQ : questions fréquentes
Q1 : Claude a-t-il cassé la courbe elliptique du NIST ?
Non. Claude a retrouvé le processus de génération de la graine, issue de l’algorithme lrand48 initialisé à partir d’un horodatage. Il ne s’agit ni d’une nouvelle méthode d’attaque ni d’une vulnérabilité : les utilisateurs n’ont pas besoin de modifier leur configuration ou de migrer. Cette conclusion montre au contraire que la graine n’a pas été choisie manuellement.
Q2 : En quoi cette méthode diffère-t-elle d’une recherche exhaustive classique ?
Une recherche exhaustive consiste à parcourir toutes les possibilités dans un espace d’hypothèses donné. Claude a d’abord changé d’espace d’hypothèses : au lieu de se demander « quelle phrase a été hachée ? », il s’est demandé « quel générateur de nombres aléatoires a été utilisé ? ». Ce n’est qu’ensuite qu’il a procédé à une recherche exhaustive limitée (2^17 bits cachés). C’est cette première étape qui a vraiment déterminé le succès de la démarche.
Q3 : Quand cette recherche a-t-elle été publiée ? Quelles questions restent ouvertes ?
La page de recherche d’Anthropic et la publication de @AnthropicAI datent toutes deux du 17 octobre 2026. La graine de B-163 n’a pas encore été retrouvée. La méthode de génération du point de base G pour P-224 à P-521 reste également inconnue. Enfin, quelques courbes candidates ont été écartées, sans que l’on sache pourquoi.
Q4 : Dans quels contextes de recherche peut-on appliquer ces 3 méthodes ?
– **Recherche de l’origine d’anomalies expérimentales** : si des artefacts périodiques apparaissent dans les données d’un instrument, utilisez la méthode 1 pour déduire le fonctionnement du logiciel d’acquisition.
– **Reproduction d’articles anciens** : si certains paramètres manquent, utilisez la méthode 2 pour parcourir différentes combinaisons de paramètres candidates.
– **Extraction et nettoyage de données** : utilisez la méthode 3 avec un évaluateur pour affiner progressivement des règles stables.
Q5 : Comment utiliser une seule clé pour appeler plusieurs modèles phares et effectuer une validation croisée ?
Inscrivez-vous sur APIYI, à l’adresse apiyi.com, et créez une clé. Définissez `base_url` sur `https://api.apiyi.com/v1` ; il vous suffira ensuite de modifier le paramètre `model` pour passer de claude-opus-5-5 aux modèles phares de la famille GPT ou Gemini. Consultez la liste des modèles dans la console pour connaître les noms disponibles.
Q6 : Quelles sont les limites connues des agents d’IA pour la recherche ?
– Le modèle peut inventer des mécanismes qui semblent plausibles. Chaque conclusion doit donc être accompagnée d’un script de vérification exécutable localement.
– Les évaluations successives peuvent entraîner un surapprentissage sur le jeu de développement : conservez toujours un jeu de données de validation distinct.
– Le coût des appels s’accumule au fil des échanges. Commencez par mettre au point le processus avec un modèle moins coûteux et consignez les données d’utilisation. Les modalités de facturation sont indiquées dans la console APIYI, sur apiyi.com.
Points clés sur les agents IA pour la recherche
- Limites des conclusions : Claude a retrouvé l’origine de la graine, pas découvert de faille cryptographique. La confiance dans la courbe s’en trouve renforcée.
- Étape décisive : changer l’espace des hypothèses est plus efficace que d’augmenter la puissance de calcul dans l’ancien.
- La vérification d’abord : le modèle écrit les scripts, l’humain les exécute, et les résultats sont systématiquement comparés à une référence aléatoire.
- Boucle avec un évaluateur : associez une évaluation déterministe à un jeu de données de validation, puis arrêtez les itérations lorsque le score converge.
- Des modèles adaptés à chaque tâche : utilisez des modèles économiques pour mettre le processus au point et réservez les modèles haut de gamme aux raisonnements et vérifications essentiels.
- Pour commencer : avec une seule clé, appelez claude-opus-5-5 via APIYI apiyi.com et passez à d’autres modèles pour effectuer des vérifications croisées.
Conclusion
Claude a résolu le mystère de la graine des courbes elliptiques du NIST. Les chercheurs peuvent en tirer trois enseignements principaux :
- Commencez par comprendre le mécanisme : cherchez à savoir comment les données ont été produites au lieu de deviner directement la réponse.
- Laissez les scripts trancher : chaque hypothèse doit être accompagnée d’un code de vérification exécutable et d’un contrôle aléatoire.
- Mettez en place une boucle avec un évaluateur : confiez l’évaluation à un programme déterministe, itérez jusqu’à convergence et utilisez un jeu de données de validation pour détecter le surapprentissage.
La maîtrise des coûts reste essentielle : commencez par faire fonctionner le processus avec des modèles économiques, puis passez à des modèles haut de gamme pour les étapes qui touchent aux conclusions de l’article ou à des algorithmes complexes. Nous vous recommandons d’exécuter l’intégralité du code de cet article via APIYI apiyi.com : commencez par confirmer la graine P-256 à l’aide du code officiel de reproduction, puis appliquez ces trois méthodes à vos propres travaux de recherche.
Pour aller plus loin
- 📘 Comment appeler les modèles Claude avec le SDK OpenAI – Découvrez les différences de paramètres entre les interfaces compatibles
- 📊 Maîtriser le coût des appels aux API de grands modèles de langage – Apprenez à exploiter les statistiques
usageet à configurer des alertes budgétaires - 🚀 Mettre en place un workflow de validation croisée entre plusieurs modèles – Faites vérifier les conclusions des différents modèles de pointe
📚 Références
- Page de recherche de l’équipe Frontier Red Team d’Anthropic : étude sur l’origine des graines des courbes ECDSA
- Lien :
www.anthropic.com/research/ecdsa-curve-origins -
À propos : source primaire présentant la méthode complète, les questions en suspens et le code de reproduction sous licence CC0
-
Publication officielle d’@AnthropicAI sur X (17/10/2026) : « It is just timestamps. »
- Lien :
x.com/AnthropicAI -
À propos : déclaration officielle ; consultez les échanges de la communauté à partir de cette publication
-
Centre de documentation d’APIYI : guide d’utilisation des interfaces compatibles avec OpenAI
- Lien :
docs.apiyi.com - À propos : configuration de
base_url, liste des modèles et informations sur la facturation
Auteur : équipe technique d’APIYI
Échanges techniques : partagez dans les commentaires vos façons d’utiliser des agents IA dans vos recherches. Pour en savoir plus sur les solutions d’intégration, consultez le centre de documentation d’APIYI à l’adresse docs.apiyi.com.