« gpt-4o-mini est-il sur le point d’être abandonné ? » C’est une question qui revient régulièrement dans les communautés techniques. Elle a été directement déclenchée par la publication successive d’annonces de retrait de modèles sur Azure OpenAI Service, ainsi que par le recul continu de gpt-4o-mini dans les différents classements de performances. De nombreuses équipes ont donc commencé à réévaluer leur choix de modèles.
Cet article s’appuie sur la documentation officielle d’OpenAI, les annonces de retrait publiées dans Microsoft Learn et les données de référence d’Artificial Analysis. Il commence par clarifier la confusion autour des rumeurs de retrait de gpt-4o-mini, puis compare, selon le prix et les performances, cinq modèles de remplacement aux tarifs similaires : GPT-5 mini, GPT-5 nano, Gemini 2.5 Flash-Lite, DeepSeek V4 Flash et Claude Haiku 4.5. L’objectif est de vous aider à déterminer s’il est nécessaire de migrer et, le cas échéant, vers quel modèle cette migration serait la plus avantageuse.
À retenir : après avoir lu cet article, vous saurez clairement si gpt-4o-mini fait l’objet d’un « retrait partiel » ou si la situation a été largement mal interprétée. Vous découvrirez également quel modèle de remplacement peut offrir l’amélioration la plus nette sans augmenter significativement votre budget.
Si cette confusion se propage autant, c’est en grande partie parce que plusieurs sujets sont discutés ensemble : les annonces de retrait côté Azure, la suppression de certains modèles dans l’interface web de ChatGPT et les affirmations générales de la communauté selon lesquelles « OpenAI abandonne ses anciens modèles ». Il manque souvent une vue claire, séparée par plateforme et par type de déploiement. La suite distingue ces différentes chronologies afin de vous éviter une migration précipitée pour une rumeur qui n’est pas encore réellement entrée en vigueur, tout en vous permettant de ne pas négliger les dates de retrait Azure qui, elles, sont réellement urgentes.
Situation de gpt-4o-mini : seulement 7 points aux évaluations, les rumeurs de retrait sont-elles fondées ?
Commençons par la conclusion : les rumeurs de retrait de gpt-4o-mini reposent sur une confusion manifeste. Azure et l’API officielle d’OpenAI suivent deux calendriers totalement différents. Il est donc incorrect d’affirmer de manière générale que « gpt-4o-mini va être retiré ».
Tarifs et performances actuels de gpt-4o-mini
| Indicateur | Valeur | Description |
|---|---|---|
| Tarif des entrées | 0,15 $ / 1 M de tokens | Tarif de l’API officielle d’OpenAI |
| Tarif des entrées mises en cache | 0,075 $ / 1 M de tokens | Tarif réduit de moitié en cas d’utilisation du cache |
| Tarif des sorties | 0,60 $ / 1 M de tokens | Tarif de l’API officielle d’OpenAI |
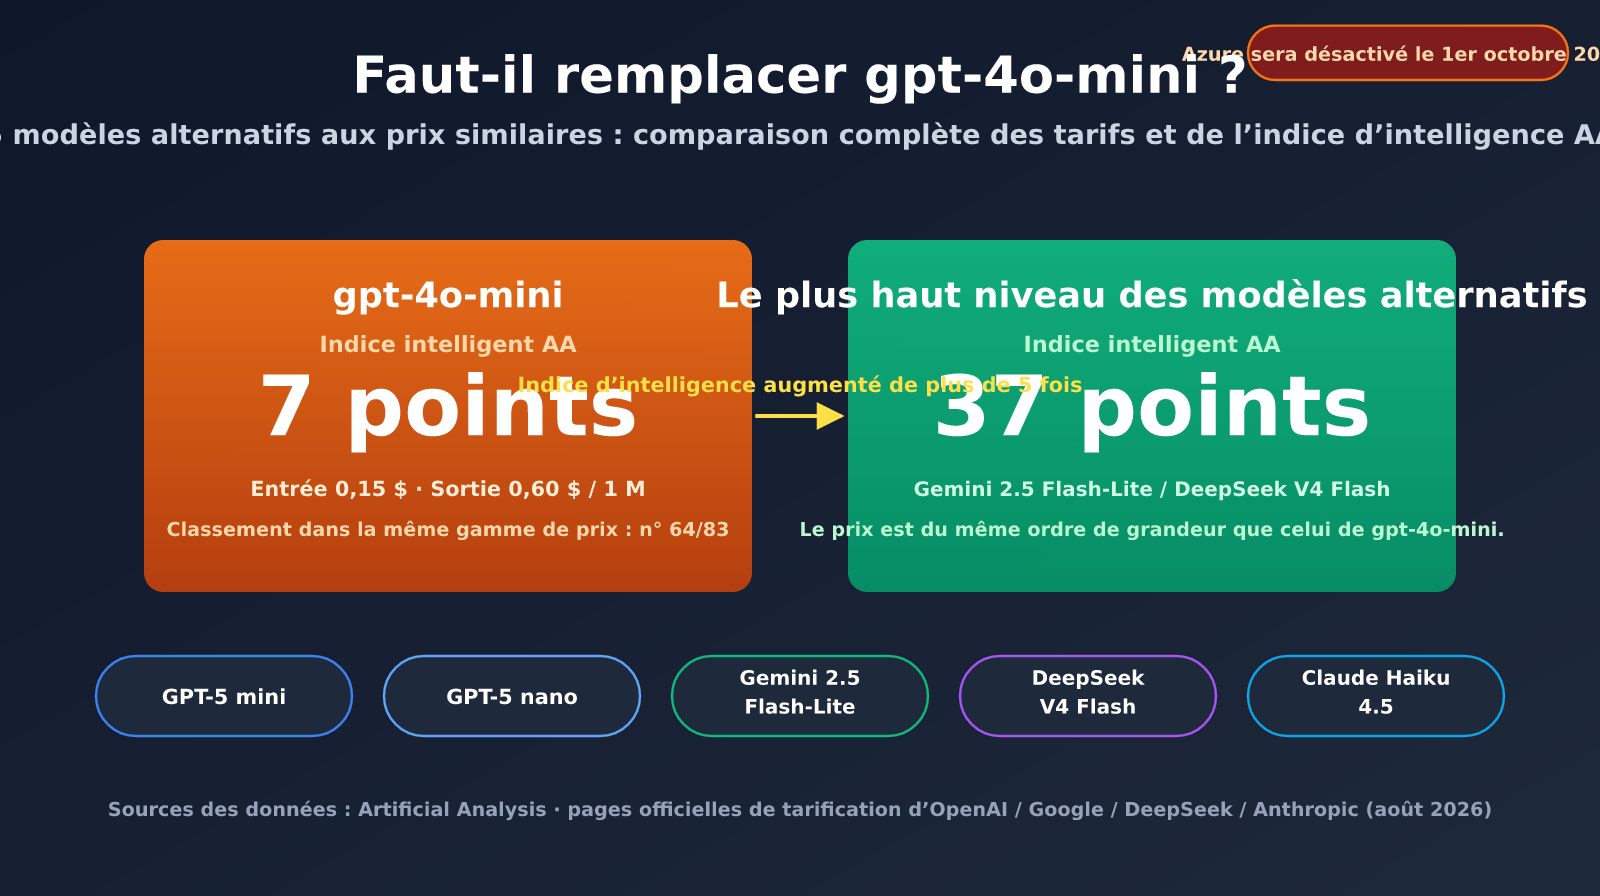
| Indice d’intelligence AA | 7 points | Évaluation d’Artificial Analysis, classé n° 64 sur 83 dans la tranche de prix comparable |
| Vitesse de génération | 100,9 tokens/s | Inférieure à la moyenne de 102,1 tokens/s des modèles comparables |
Si gpt-4o-mini est autant remis en question en 2026, ce n’est pas principalement parce que son prix aurait changé, mais parce que son indice d’intelligence Artificial Analysis n’est que de 7 points. Parmi les 83 modèles de la même tranche tarifaire, il se classe 64ᵉ, nettement sous le niveau médian de cette catégorie. Autrement dit, gpt-4o-mini reste bon marché, mais « bon marché » ne signifie plus automatiquement « excellent rapport qualité-prix » : avec le même budget, il est désormais possible d’utiliser des modèles bien plus performants.
Précisons la valeur de référence de l’indice d’intelligence AA. Artificial Analysis le calcule en pondérant plusieurs évaluations publiques, qui couvrent notamment le raisonnement, le code et les mathématiques. Son principal avantage est de couvrir un grand nombre de modèles et d’être mis à jour fréquemment, ce qui permet de comparer les modèles de différents fournisseurs selon une même échelle. Sa limite est de refléter un niveau moyen de compétences générales : il ne peut pas remplacer complètement les tests effectués sur vos propres données métier. Il est donc préférable de le considérer comme un premier filtre pour sélectionner des modèles candidats, et non comme l’unique base de votre choix final.
Calendrier de retrait de gpt-4o-mini : Azure et l’API OpenAI suivent des règles totalement différentes
| Plateforme / mode de déploiement | État | Date de retrait |
|---|---|---|
| API officielle d’OpenAI (gpt-4o-mini lui-même) | Aucune date de retrait définie | Aucune pour le moment |
| Version ajustée d’OpenAI ft-gpt-4o-mini | Plan annoncé | Fin de l’entraînement au plus tôt le 1ᵉʳ avril 2027, fin du déploiement le 1ᵉʳ octobre 2027 |
| Déploiement Azure OpenAI Standard | Retiré | 31 mars 2026 |
| Provisioned / Global Standard / Data Zone Standard sur Azure | Retrait prochain | 1ᵉʳ octobre 2026 |
Il faut également clarifier un point important : le 13 février 2026, OpenAI a effectivement retiré GPT-4o, GPT-4.1, GPT-4.1 mini et o4-mini de l’interface produit de ChatGPT. Il s’agissait toutefois d’une modification du sélecteur de modèles de la version web de ChatGPT. L’annonce officielle précise explicitement que l’API n’est pas concernée, et gpt-4o-mini ne figurait pas lui-même dans cette liste de retraits. Le calendrier qui mérite réellement votre attention est celui d’Azure : le déploiement Standard de gpt-4o-mini sur Azure OpenAI a été retiré le 31 mars 2026. Les déploiements Provisioned, Global Standard et Data Zone Standard cesseront également de fonctionner le 1ᵉʳ octobre 2026. Il reste moins de deux mois avant cette échéance, après quoi les appels renverront directement une erreur 410 Gone. Si votre activité repose sur Azure, ce calendrier est bien plus important que la question de savoir si « OpenAI retire le modèle ».
Autre détail souvent négligé : même lorsqu’ils portent le même nom « gpt-4o-mini », les différents modes de déploiement sur Azure — Standard, Provisioned, Global Standard et Data Zone Standard — ne suivent pas nécessairement le même calendrier de retrait. Les équipes qui utilisent plusieurs modes de déploiement peuvent facilement se tromper en consultant l’annonce correspondant à un seul d’entre eux et en extrapolant à l’ensemble du service. Avant d’analyser la situation, vérifiez donc dans le portail Azure le type de déploiement que vous utilisez exactement, puis contrôlez chaque date de retrait dans le tableau ci-dessus. Vous éviterez ainsi l’écart entre « on dit que le modèle va être retiré » et « combien de temps peut-il réellement encore être utilisé ».
gpt-4o-mini vs 5 modèles alternatifs : comparaison complète des prix et des scores
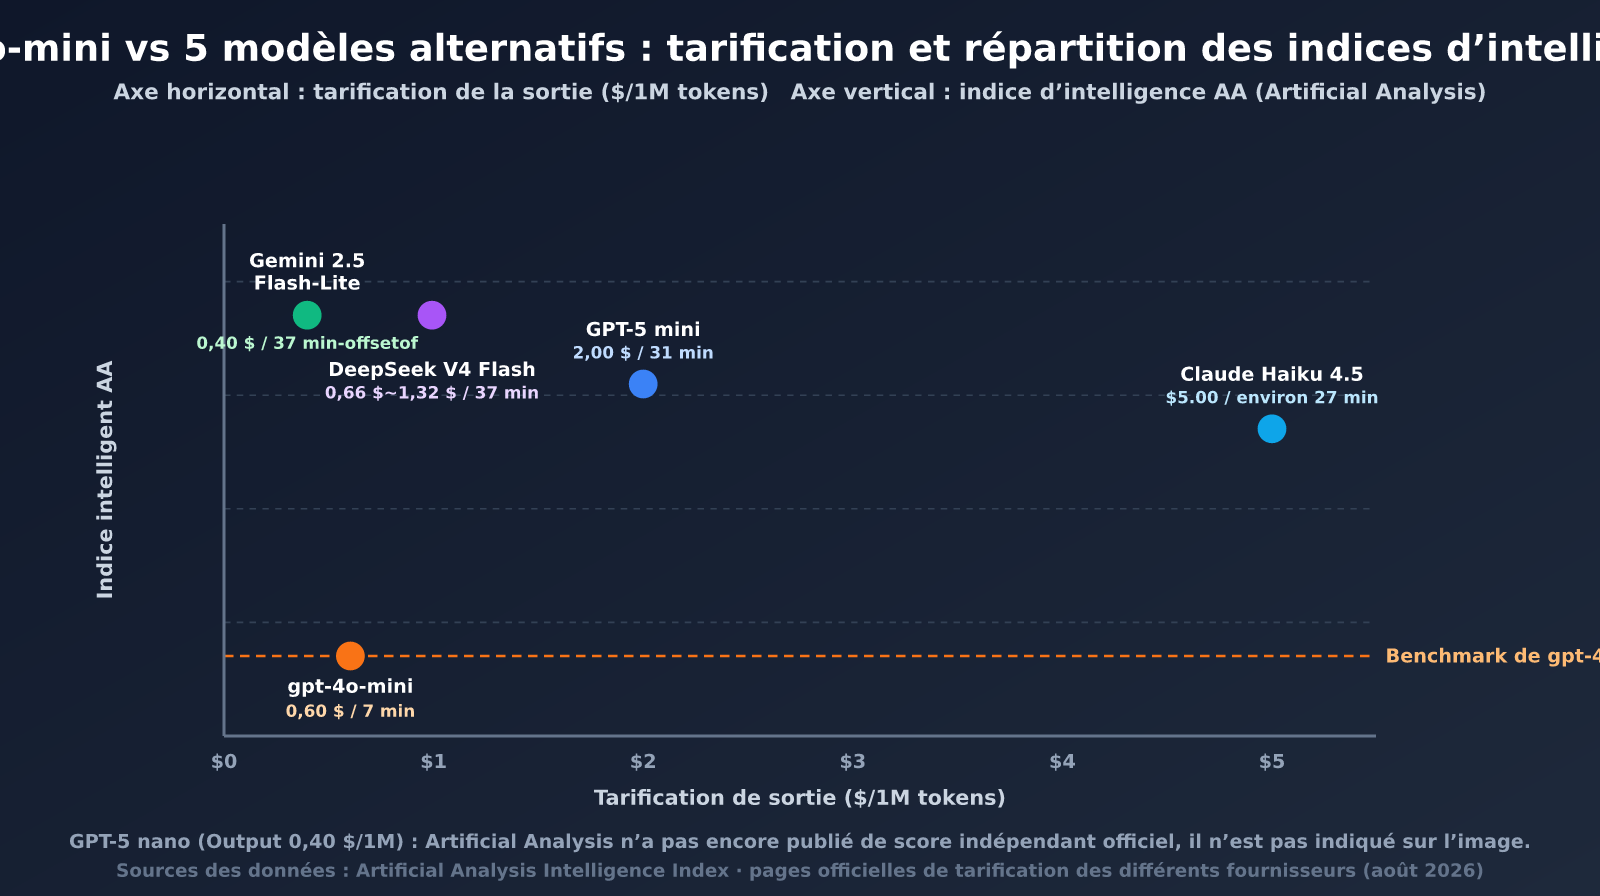
Si vous évaluez une stratégie de migration, le tableau ci-dessous récapitule 5 modèles alternatifs dont les tarifs sont proches de ceux de gpt-4o-mini et qui disposent de données officielles ou publiées par des sources tierces de référence. Vous pourrez ainsi affiner rapidement votre sélection en fonction de votre budget et de vos besoins en performances.
| Modèle | Entrée / Sortie ($/1 M) | Indice d’intelligence AA | Atout principal |
|---|---|---|---|
| gpt-4o-mini (référence) | $0.15 / $0.60 | 7 points (#64/83) | Écosystème mature et bonne compatibilité |
| GPT-5 nano | $0.05 / $0.40 | Score officiel non publié séparément | L’option la moins chère de la série |
| GPT-5 mini | $0.25 / $2.00 | 31 points (niveau de raisonnement medium) | L’alternative officielle la plus directe au sein de l’écosystème OpenAI |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 points | Prix proche de gpt-4o-mini, avec une nette amélioration de l’indice d’intelligence |
| DeepSeek V4 Flash | $0.22~$0.44 / $0.66~$1.32 (tarification selon les périodes) | 37 points (niveau de raisonnement élevé) | Tarification selon les créneaux horaires, avec un coût minimal de $0.007/1 M en cas de cache |
| Claude Haiku 4.5 | $1.00 / $5.00 | Environ 24 à 30 points (selon le niveau de raisonnement) | Fenêtre de contexte étendue et meilleures capacités d’appel d’outils |
🎯 Conseil technique : pour vos tests, nous vous recommandons d’utiliser la plateforme APIYI apiyi.com afin de tester individuellement les modèles ci-dessus via leurs API. Elle prend en charge, avec une interface API unifiée, gpt-4o-mini, la série GPT-5, Gemini, DeepSeek et Claude, ce qui facilite le changement de modèle et la comparaison des résultats dans une même base de code.
En dehors de ces 5 modèles, Qwen3.5 Flash d’Alibaba Cloud constitue également une option dont la fourchette de prix est proche. Les comparateurs tiers indiquent un tarif d’environ $0.10 / $0.40. Toutefois, comme celui-ci n’a pas été confirmé directement sur la page officielle de tarification de DashScope, il est préférable de vérifier le prix affiché dans la console officielle avant toute migration définitive, afin d’éviter les écarts liés à la région ou au taux de change. De même, aucun score indépendant publié officiellement ou par Artificial Analysis n’a pour l’instant été trouvé pour GPT-5 nano. Nous le signalons donc honnêtement comme « non publié », plutôt que d’inventer un chiffre.
Dans l’ensemble, Gemini 2.5 Flash-Lite est l’option à tester en priorité : son prix n’est que légèrement supérieur à celui de gpt-4o-mini, tandis que son indice d’intelligence AA passe de 7 à 37 points. C’est le modèle qui offre l’amélioration de rapport qualité-prix la plus nette dans cette tranche tarifaire. Si la compatibilité avec l’écosystème OpenAI est votre priorité, GPT-5 mini coûte certes plus du double de gpt-4o-mini, mais le gain de performances est lui aussi significatif. Pour les cas d’usage particulièrement sensibles au budget, vous pouvez vous tourner vers GPT-5 nano et vers les tarifs hors pointe de DeepSeek V4 Flash.
Le mécanisme de tarification de DeepSeek V4 Flash mérite une explication à part : le modèle utilise deux grilles, selon les heures creuses ou pleines. En dehors des heures de pointe, l’entrée et la sortie coûtent seulement $0.22/$0.66, contre $0.44/$1.32 pendant les périodes de pointe. En cas d’utilisation du cache, le tarif peut encore descendre à $0.007~$0.014 par million de tokens. Pour les tâches hors ligne pouvant être exécutées en dehors des heures de pointe, comme la génération de résumés en lot pendant la nuit ou l’analyse de journaux, cette tarification est souvent plus avantageuse que celle des modèles à prix fixe. En revanche, si votre activité repose sur des requêtes en temps réel pendant les heures de pointe, vous devrez recalculer les coûts sur la base du tarif maximal. Claude Haiku 4.5 suit une approche différente : son prix unitaire est nettement supérieur à celui de gpt-4o-mini, mais il offre en contrepartie une meilleure stabilité sur les longues fenêtres de contexte et de meilleures capacités d’appel d’outils. Il convient donc davantage au traitement de documents volumineux et à l’orchestration de plusieurs outils au fil de conversations, plutôt qu’au simple remplacement d’un modèle pour des questions courtes.
Recommandations par scénario : quel modèle choisir selon vos besoins ?
| Scénario d’application | Modèle recommandé | Raisons |
|---|---|---|
| Service client à fort volume / robot FAQ | Gemini 2.5 Flash-Lite | Prix comparable à gpt-4o-mini, avec un indice d’intelligence multiplié par plus de 5 |
| Raisonnement complexe / tâches Agent en plusieurs étapes | GPT-5 mini | Meilleure compatibilité avec l’écosystème OpenAI, capacités de raisonnement nettement supérieures à celles de gpt-4o-mini |
| Traitement massif à très faible coût (étiquetage de contenu, résumés) | GPT-5 nano / DeepSeek V4 Flash en dehors des heures de pointe | Tarif unitaire pouvant descendre à environ un tiers de celui de gpt-4o-mini |
| Analyse de documents longs / contexte étendu | Claude Haiku 4.5 | Meilleure stabilité avec les contextes longs et capacités d’appel d’outils plus avancées |
| Validation de prototypes avec un budget très limité | DeepSeek V4 Flash lorsque le cache est utilisé | Le coût peut être réduit à un niveau extrêmement bas en cas d’accès au cache |
💡 Conseil pour choisir : le choix du modèle dépend principalement de votre scénario d’application et de vos exigences en matière de qualité. Nous vous recommandons d’effectuer des tests réels via la plateforme APIYI apiyi.com, afin de comparer, avec le même budget, les différences de performances entre les modèles sur vos propres données métier, plutôt que de vous baser uniquement sur les scores publics.
Gardez toutefois à l’esprit que le tableau ci-dessus présente des « recommandations par défaut ». Le choix final doit également tenir compte de la longueur du contexte, du volume de requêtes simultanées et des exigences de latence. Par exemple, dans un scénario de service client, si l’historique des échanges est très long et doit être fréquemment réutilisé, l’avantage économique de Gemini 2.5 Flash-Lite peut être partiellement réduit par la consommation d’un prompt plus volumineux. Dans ce cas, il peut être utile d’inclure Claude Haiku 4.5 dans un test comparatif. De même, pour les tâches Agent complexes soumises à de fortes exigences de latence, testez le temps d’exécution de bout en bout de GPT-5 mini avec votre chaîne d’outils concrète, plutôt que de vous fier uniquement à l’indice d’intelligence publié officiellement.
Migration rapide : passer de gpt-4o-mini à un modèle alternatif en deux étapes
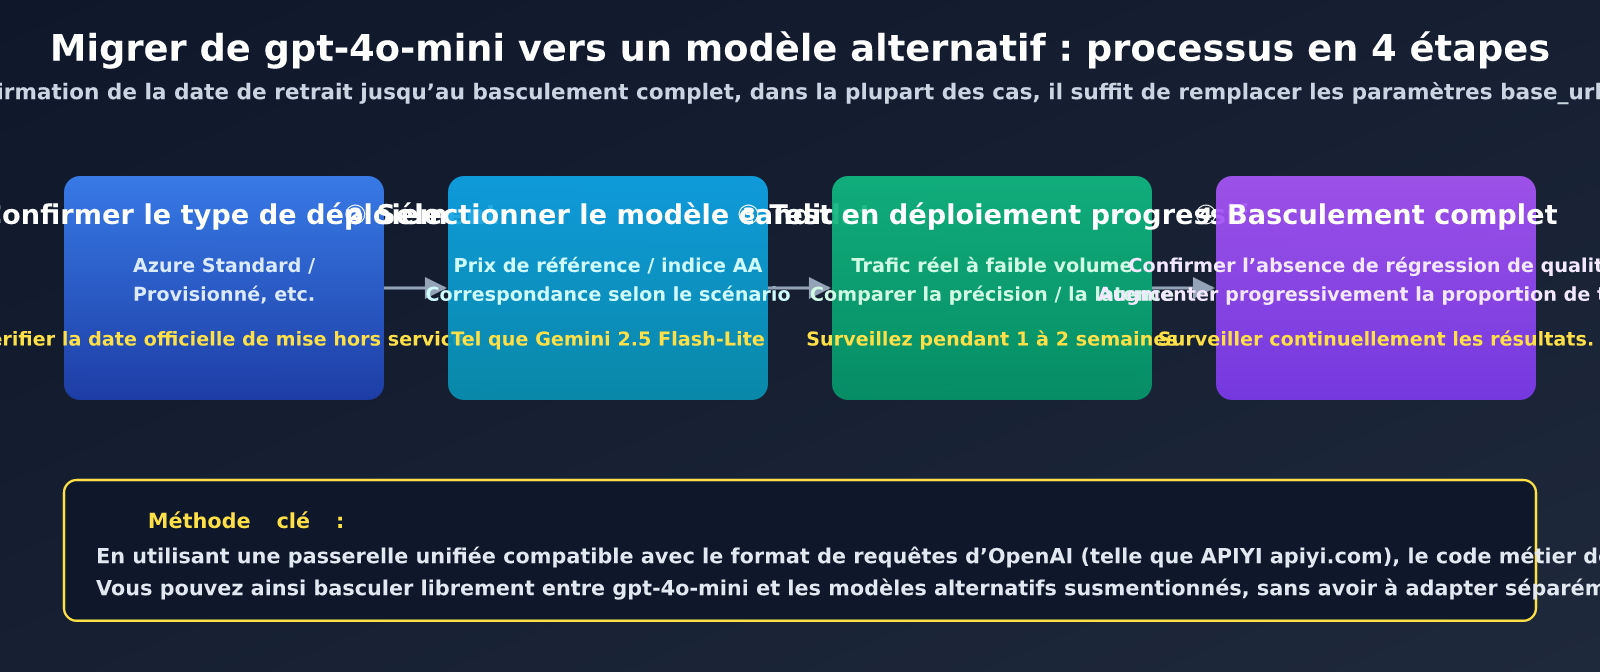
La plupart des migrations se limitent à modifier les deux paramètres base_url et model. Si vous utilisez déjà le SDK OpenAI ou un client compatible avec son format, il n’est pas nécessaire de réécrire la moindre logique métier.
Les difficultés se situent généralement moins au niveau du code que dans les différences entre les interfaces natives des différents fournisseurs : format des messages, champs liés aux appels d’outils ou stratégies de limitation du débit ne sont pas toujours identiques. Passer directement au SDK natif de Gemini ou de Claude impose souvent de réécrire le corps des requêtes et la logique d’analyse des réponses. Une passerelle unifiée compatible avec le format des requêtes OpenAI permet de masquer ces différences. Le code métier n’a alors besoin de conserver qu’une seule méthode d’appel. C’est également la raison pour laquelle, dans l’exemple ci-dessous, model est défini comme un paramètre configurable au lieu de créer un client distinct pour chaque fournisseur.
Exemple minimal
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI : une seule intégration pour changer de modèle
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # Passer de gpt-4o-mini à un modèle alternatif
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
Afficher le code complet de migration (avec sélecteur de modèle et nouvelle tentative en cas d’erreur)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, compatible avec le format d’appel du SDK OpenAI
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("Résume le calendrier de retrait de gpt-4o-mini", profile="gemini"))
🚀 Pour commencer rapidement : nous vous recommandons d’utiliser la plateforme APIYI apiyi.com pour effectuer des tests comparatifs avant la migration. La plateforme intègre une facturation unifiée pour plusieurs modèles : il n’est pas nécessaire de demander une clé API ni de créer un compte distinct pour chaque nouveau modèle. Vous pouvez tester l’ensemble des modèles candidats du tableau ci-dessus en quelques minutes.
Questions fréquentes
Q1 : J’utilise actuellement gpt-4o-mini sur Azure OpenAI. Combien de temps pourrai-je encore l’utiliser ?
Tout dépend du type de déploiement. Si vous utilisez un déploiement Standard, celui-ci a été retiré le 31 mars 2026 et devrait donc déjà être indisponible. Pour les déploiements Provisioned, Global Standard ou Data Zone Standard, la date de retrait est fixée au 1er octobre 2026 : il reste donc moins de deux mois. Nous vous recommandons de commencer rapidement vos tests de migration via une plateforme prenant en charge plusieurs modèles, comme APIYI apiyi.com, afin d’éviter toute interruption de service à l’échéance.
Q2 : J’utilise l’API officielle d’OpenAI. Dois-je moi aussi migrer immédiatement ?
Non, ce n’est pas obligatoire. D’après la page officielle des modèles retirés d’OpenAI, gpt-4o-mini n’est actuellement pas concerné par un retrait. Seule sa version fine-tunée, ft-gpt-4o-mini, dispose d’un calendrier plus tardif. Si votre priorité est de maîtriser les coûts, vous pouvez donc encore attendre. Toutefois, avec un indice d’intelligence AA de seulement 7 pour gpt-4o-mini, une comparaison des performances avec des modèles de prix similaire via la plateforme APIYI apiyi.com peut généralement offrir une nette amélioration de la qualité sans augmenter votre budget.
Q3 : Après la migration vers un nouveau modèle, comment vérifier que les performances n’ont pas diminué ?
Ne vous fiez pas uniquement à votre impression. Commencez par constituer un ensemble représentatif d’exemples issus de votre activité réelle, plutôt que quelques cas de test rédigés à la hâte. Faites ensuite traiter les mêmes entrées par gpt-4o-mini et par le modèle candidat, puis comparez les résultats selon trois critères : le taux de précision, le taux de conformité au format et le temps de réponse moyen. Pendant la phase de déploiement progressif, vous pouvez limiter le nouveau modèle à une petite partie du trafic réel et observer ses performances en production pendant une à deux semaines. Si vous ne constatez pas de dégradation notable de la qualité ou de la latence, augmentez progressivement sa part de trafic jusqu’à un déploiement complet.
Synthèse et recommandations pour la prise de décision
| Point de contrôle | Description |
|---|---|
| Confirmer le type de déploiement | Les dates de retrait diffèrent pour Azure Standard, Provisioned, Global Standard et Data Zone Standard |
| Vérifier la tarification officielle | Les prix peuvent varier selon la région et les périodes de pointe ou de faible demande ; référez-vous aux pages officielles |
| Comparer l’indice d’intelligence AA | Consultez en priorité des classements publics tiers comme ceux d’Artificial Analysis, plutôt que de vous fier uniquement à la communication des fournisseurs |
| Déploiement progressif | Vérifiez d’abord les performances sur des parcours non critiques, puis augmentez progressivement la part de trafic |
| Unifier les appels d’API | Utilisez un service proxy API compatible avec le format du SDK OpenAI afin de réduire le coût du changement de modèle |
En résumé, gpt-4o-mini n’a pas été retiré dans son ensemble de l’API officielle d’OpenAI. En revanche, le calendrier de retrait côté Azure est désormais très serré, et son retard dans les évaluations de performance est un fait objectif. Pour la plupart des cas d’usage, Gemini 2.5 Flash-Lite et GPT-5 mini sont deux options prioritaires offrant un prix similaire et une amélioration sensible des performances. Si votre budget est extrêmement limité, vous pouvez également étudier GPT-5 nano et la tarification selon les périodes de pointe et de faible demande de DeepSeek V4 Flash.
Rappel important : nous vous déconseillons de changer précipitamment de modèle simplement parce qu’il est « moins cher » ou parce que vous avez entendu dire qu’il allait être retiré. Le prix et les scores ne sont que la première étape pour constituer une liste de candidats. La véritable décision — savoir s’il faut migrer et vers quel modèle — doit reposer sur des tests réalisés avec vos propres données métier. Une période d’évaluation d’une à deux semaines, couvrant suffisamment de scénarios réels, est plus fiable que le suivi des variations de scores dans les classements. Nous vous recommandons finalement de réaliser un test comparatif sur des données métier réelles via la plateforme APIYI apiyi.com, puis de choisir le modèle vers lequel migrer.
Si vous rencontrez un problème précis pendant la migration, n’hésitez pas à contacter le support technique d’APIYI apiyi.com. Nous continuerons à suivre l’évolution de la tarification officielle de gpt-4o-mini et des modèles alternatifs, et à mettre à jour les données de cet article.