Note de l’auteur : Gemini 4 Hydrogen réunit dans un seul et même modèle la programmation du quotidien, le traitement de documents et l’exécution de tâches par agents. Cet article passe en revue ses nouvelles capacités, son accès gratuit et la répartition des rôles avec les autres modèles de la même famille.
Résumé en une phrase : Gemini 4 Hydrogen est le modèle d’exécution à haute efficacité lancé par Google au sein de la famille Gemini 4 ; il est axé sur la programmation du quotidien, les agents multi-outils et le traitement de documents de formats variés. Les utilisateurs de l’offre gratuite peuvent l’essayer via le mode Auto de Gemini App ou via le niveau gratuit de Google AI Studio.
À savoir : 5 termes à connaître avant de lire
- Agent : système dans lequel le modèle et l’environnement d’exécution des outils accomplissent ensemble une tâche en plusieurs étapes — par exemple, rechercher des fichiers, modifier le code, puis lancer les tests.
- Token : unité de mesure des informations traitées par le modèle, comme le texte ; la facturation API et le quota de contexte sont calculés en tokens.
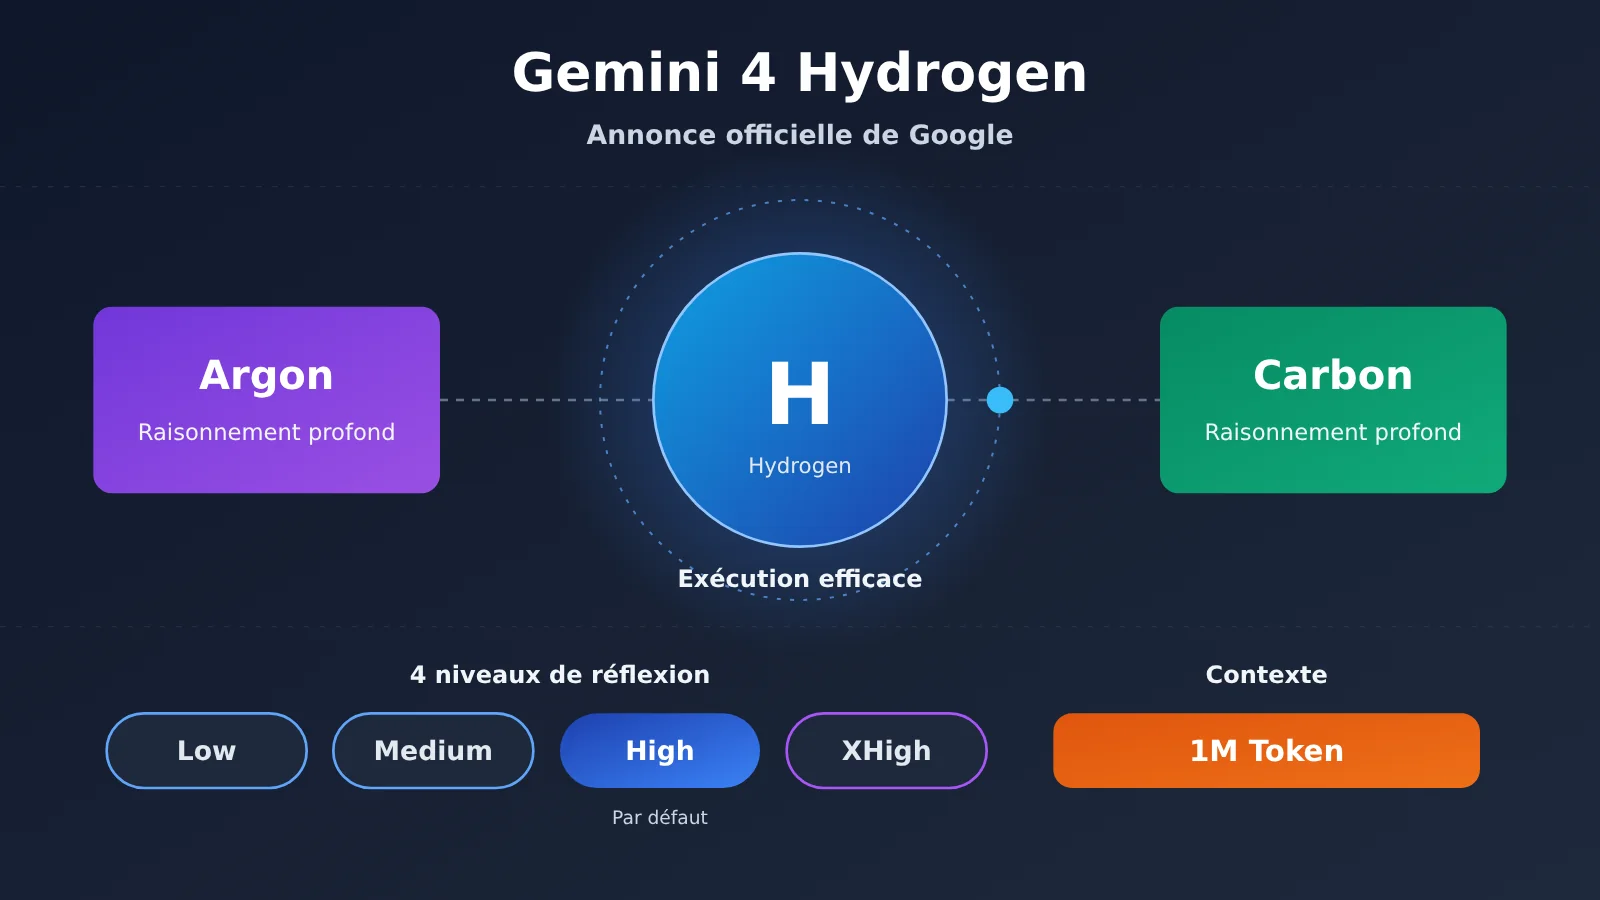
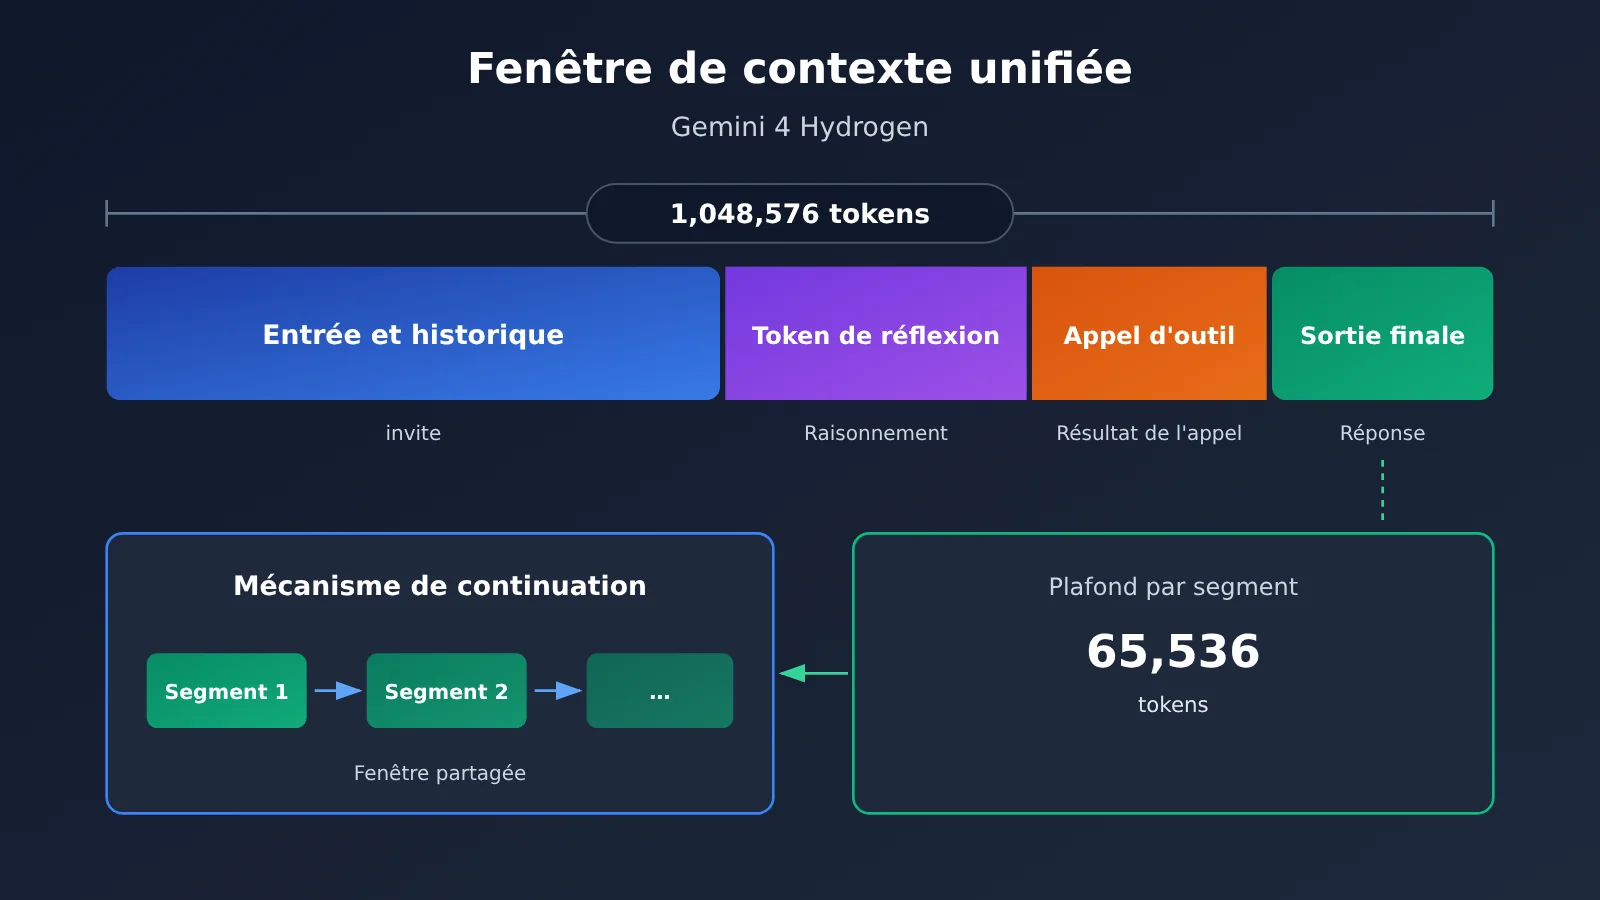
- Fenêtre de contexte : étendue d’informations qu’un traitement du modèle peut contenir en une seule fois ; le quota exact est défini par le modèle. Pour Hydrogen, les entrées, la réflexion, les appels d’outils et les sorties totalisent 1 048 576 tokens.
- thinking_level : paramètre de niveau de réflexion qui contrôle la profondeur du raisonnement du modèle. Hydrogen propose quatre niveaux : Low, Medium, High et XHigh.
- Grounding : consiste à associer les réponses générées à des preuves externes récupérées, par exemple avec Google Search Grounding et Google Maps Grounding.
Google a officiellement lancé Gemini 4 Hydrogen le 12 novembre 2026, et a commencé à le déployer progressivement dans Gemini API, Google AI Studio, Gemini App et Google Search. Son principal changement : il apporte le niveau d’intelligence de la famille Gemini 4 aux tâches quotidiennes les plus fréquentes. Sur Terminal-Bench 4.1, le score officiel atteint 57,0 %, contre 18,2 % pour Gemini 3.8 Flash, le modèle de la génération précédente.
Il ne s’agit pas d’une fuite ni d’un simple teaser. Le blog officiel de Google, la fiche modèle de Google DeepMind, la documentation technique de Google Cloud et le blog officiel de Google en chinois ont tous corroboré cette annonce ; TechCrunch, Ars Technica, 9to5Google et The Verge en ont également rendu compte.
L’essentiel : quelques minutes suffisent pour comprendre ce que Gemini 4 Hydrogen améliore, où l’utiliser gratuitement et s’il est adapté à votre travail.
Google publie officiellement Gemini 4 Hydrogen : un nouveau membre rejoint la famille Gemini 4
Gemini 4 Hydrogen : l’essentiel en un coup d’œil
| Élément | Détails vérifiés |
|---|---|
| Date de sortie | 12 novembre 2026, déploiement progressif dans le monde entier |
| Éditeur | Google DeepMind |
| ID du modèle API | gemini-4-hydrogen |
| Positionnement officiel | Modèle d’exécution à haute efficacité pour la programmation quotidienne et les agents IA |
| Modèles de la même famille | Gemini 4 Carbon, Gemini 4 Argon |
| Quota de contexte | Entrée, réflexion, appels d’outils et sortie : 1,048,576 tokens au total |
| Niveaux de réflexion | Low / Medium / High / XHigh, la valeur par défaut de l’API étant High |
| Coupure des connaissances | mars 2026 |
| Statut du produit | Disponible en version officielle (Google Cloud le classe en GA de courte durée, avec un préavis d’au moins 45 jours avant le retrait) |
Au sein de la famille Gemini 4, la répartition des rôles entre les trois modèles est assez claire. Carbon et Argon se chargent du raisonnement approfondi, complexe et long ; Hydrogen mise davantage sur la vitesse, la programmation au quotidien, les appels d’outils multiples et l’exécution automatisée. La fiche modèle officielle indique aussi qu’Hydrogen est dérivé de Gemini 4 Carbon, mais Google n’a pas publié la taille précise des paramètres.
Hydrogen peut s’utiliser seul, ou bien servir d’exécuteur ou de vérificateur dans un système d’agents multi-modèles. L’approche habituelle consiste à laisser Carbon ou Argon trancher, puis à Hydrogen de passer à l’action. Ars Technica lit dans cette annonce une prise de relais d’Hydrogen sur le créneau de la gamme Flash.
Les résultats officiels de Gemini 4 Hydrogen face à 3.8 Flash
| Élément d’évaluation | Gemini 4 Hydrogen | Gemini 3.8 Flash | Source des données |
|---|---|---|---|
| Terminal-Bench 4.1 | 57.0% | 18.2% | Google officiel |
| Vitesse d’achèvement des tâches dans des conditions de test identiques | environ 2.5 fois plus rapide | référence | Google officiel |
| Fréquence des faits inventés | réduite de plus de 5 fois | référence | Google officiel |
| Tâches sur données d’entreprise (données de graphes, SQL, etc.) | vitesse d’exécution 2-2.8 fois supérieure, consommation de tokens réduite de 12%-23% | référence | Tests de partenaires |
Ces chiffres sont publiés par Google ou issus de tests de partenaires : on ne peut pas en déduire que toutes les tâches sont 2.5 fois plus rapides. Dans l’évaluation croisée des modèles de la fiche DeepMind, Hydrogen atteint 76.1% sur AutomationBench-AA, 71.6% sur Agents’ Last Exam v1.1 et 58.8% sur HLE-Diamond. En revanche, sur Terminal-Bench 4.1 (57.0%) et OSWorld-2.1 (77.6%), il reste derrière Claude Sonnet 5.5, qui obtient 63.9% et 83.9%. La méthodologie officielle précise également que certaines notes de concurrents proviennent des éditeurs eux-mêmes ou de classements publics, et que les configurations de test ne sont pas parfaitement identiques.
Quelles capacités Gemini 4 Hydrogen améliore-t-il ?
Des améliorations sur quatre types de tâches concrètes
Les scénarios phares listés par Google peuvent être regroupés en quatre catégories, chacune correspondant à un maillon bien précis du travail quotidien :
- Modification et débogage de code : comprendre un dépôt de code, localiser les erreurs, corriger les bugs, mettre à jour les dépendances et lancer les tests. Le point sur lequel Google a particulièrement insisté cette fois, c’est l’édition précise : ne modifier que ce qui doit l’être, sans toucher au code sans rapport.
- Exécution d’agents multi-étapes : appeler des outils à la suite, parcourir des fichiers en parallèle, exécuter des opérations. Quand un appel d’outil échoue, le modèle sait ajuster sa stratégie et continuer à avancer.
- Compréhension de documents et multimodale : lecture de PDF, DOC/DOCX, PPT/PPTX, XLS/XLSX, OpenDocument, graphiques et pages web. Une seule requête peut contenir jusqu’à 3000 images ou documents ; une vidéo avec audio dure environ 45 minutes, sans audio environ 1 heure, et l’audio peut atteindre environ 8,4 heures.
- Développement web interactif : génération de pages interactives, de prototypes de sites, de composants exécutables et de contenus de visualisation.
À noter : la sortie de Hydrogen est uniquement textuelle ; les images, l’audio et la vidéo ne peuvent être que des entrées. Il comprend la vidéo et peut participer au processus de création vidéo, mais il n’est pas lui-même un modèle de génération vidéo. Les exemples de montage vidéo présentés par Google reposent sur des compétences personnalisées et des outils externes.
Cas concrets de Gemini 4 Hydrogen : Box, Pixelcut et les démos Google
Les données partenaires ci-dessous proviennent de tests préliminaires publiés dans l’annonce de Google ; elles n’ont pas été revérifiées par un tiers indépendant. Box utilise Hydrogen pour traiter des documents d’entreprise, des feuilles de calcul et des calculs de données : environ 2 fois plus rapide que 3.8 Flash, avec une consommation de tokens réduite de 12 %. Pixelcut a réalisé 276 exécutions sur des tâches de design automatisé et de génération de code, avec une vitesse 1.8 fois plus élevée et une propreté du code améliorée de 30 %.
Les démos de Google mettent surtout l’accent sur la visualisation. Par exemple, générer en temps réel des structures 3D sur une île voxel partagée à partir de langage naturel (Geminisland), créer une maquette de site e-commerce avec des effets WebGL2 et des composants produits en 3D, ou encore générer des Google Slides à partir d’une vidéo de présentation YouTube et d’un modèle, avec vérification et correction automatiques des chevauchements de texte. Ces exemples montrent que Google a déjà fait tourner ces workflows de bout en bout, mais qu’un utilisateur ordinaire ne réussira pas forcément du premier coup avec la même invite.
Contexte unifié d’un million de tokens et quatre niveaux de réflexion
Les 1,048,576 tokens de Hydrogen constituent un quota unifié : entrées, historique de contexte, tokens de réflexion, tokens d’appel d’outils et sortie finale sont tous décomptés de ce quota. Ce n’est donc pas « 1 million en entrée, puis 1 million en sortie ». Une génération synchrone est généralement plafonnée à 65,536 tokens par segment ; les sorties plus longues doivent passer par une continuation avec continuation_token ou par le mécanisme de génération longue en arrière-plan, et restent soumises au quota unifié.
Le niveau de réflexion influence beaucoup les performances réelles. Voici l’évaluation indépendante réalisée par Artificial Analysis le 12 novembre, qui relève de données tierces :
| Niveau de réflexion | Usage recommandé par Google | Indice d’intelligence | Durée moyenne des tâches de référence | Coût moyen des tâches de référence |
|---|---|---|---|---|
| Low | Tâches simples comme la classification | 27 | 1.3 minutes | $0.29 |
| Medium | Programmation courante | 41 | 3.7 minutes | $0.80 |
| High (par défaut dans l’API) | Agent multi-étapes | 51 | 8.3 minutes | $1.87 |
| XHigh | Raisonnement complexe et approfondi | 54 | 13.5 minutes | $3.16 |
Les durées et coûts de ce tableau proviennent des tâches d’évaluation standardisées de l’Artificial Analysis Intelligence Index v5.0.1 ; ils ne représentent pas la durée ni le coût réels de chaque message dans une conversation ordinaire. Deux enseignements ressortent des données. Premièrement, sous un même nom de modèle, il y a 10 points d’écart entre High et Medium ; toute comparaison doit donc préciser le niveau de réflexion utilisé. Deuxièmement, XHigh ne gagne que 3 points par rapport à High, alors que le coût moyen passe de $1.87 à $3.16 ; le niveau le plus élevé n’est donc pas forcément rentable.
Comment essayer Gemini 4 Hydrogen gratuitement ? Trois entrées expliquées en détail
Les modes d’utilisation de Gemini 4 Hydrogen selon le niveau
| Entrée / Niveau d’utilisateur | Mode d’utilisation de Hydrogen | Explication |
|---|---|---|
| Compte gratuit Gemini App | Déclenchement par routage automatique Auto | Les questions simples utilisent surtout Flash-Lite ; les requêtes nécessitant du raisonnement peuvent être confiées à Hydrogen |
| Google AI Plus | Sélection manuelle possible | Bascule via le sélecteur de modèle |
| Google AI Pro | Sélection manuelle possible et utilisation dans Tasks | Ouverture progressive dans Antigravity |
| Google AI Ultra | Sélection manuelle possible et accès à des modèles de niveau supérieur | Orchestrator (Carbon/Argon) disponible |
| Niveau gratuit de Google AI Studio | Sélection directe de l’ID du modèle | Limité par le quota du niveau gratuit |
| Niveau gratuit de Gemini API | Appel de gemini-4-hydrogen |
Limites RPM/TPM/RPD calculées par projet |
Entrée 1 : Gemini App. Lorsqu’un utilisateur gratuit active Auto, le système sélectionne automatiquement le modèle en fonction de la difficulté de la tâche. Les requêtes qui demandent du raisonnement peuvent être confiées à Hydrogen. Une fois Auto désactivé, un compte gratuit utilise Flash-Lite. Il y a aussi un point facile à confondre : dans Gemini App, lorsque vous sélectionnez manuellement un modèle sans préciser de niveau de réflexion, le niveau par défaut est Low, alors que le niveau par défaut de l’API Hydrogen est High.
Pour vérifier quel modèle a produit une réponse, sur ordinateur, vous pouvez suivre les indications du centre d’aide officiel : cliquez sur More → Show thinking steps sous la réponse, puis faites défiler jusqu’en bas pour consulter les informations du modèle. L’interface peut varier selon le client et la région ; fiez-vous à ce qui s’affiche réellement.
Entrée 2 : Google AI Studio. Dans la liste des modèles, sélectionnez directement Gemini 4 Hydrogen pour tester la conversation. C’est pratique pour valider l’effet de l’invite et du niveau de réflexion avant d’écrire du code. Le niveau gratuit n’a pas un nombre fixe d’appels : il prend en compte simultanément, par projet, le RPM (requêtes par minute), le TPM (jetons d’entrée par minute) et le RPD (requêtes par jour, réinitialisées à minuit, heure du Pacifique). Le quota réel correspond aux limites valides affichées dans AI Studio.
Entrée 3 : Gemini API. Elle peut être appelée depuis le niveau gratuit comme depuis le niveau payant, mais les limites diffèrent. Par ailleurs, le contenu du niveau gratuit de l’API peut être utilisé pour améliorer les produits Google ; la page tarifaire officielle indique que le contenu du niveau payant n’est pas utilisé à cette fin. Il faut en tenir compte lorsque l’on traite des données métier sensibles.
Google parle d’un « déploiement progressif ». Le jour de la publication, des utilisateurs ont signalé que l’option du modèle dans Gemini App était apparue brièvement avant de disparaître, ou que le modèle était visible dans Antigravity mais que l’appel échouait. Un déploiement mondial ne signifie pas non plus que l’accès réseau, l’éligibilité du compte et les politiques de service en Chine continentale ne sont pas soumis à restrictions.
Exemple d’appel à l’API Gemini 4 Hydrogen
Si vous souhaitez intégrer le modèle à un projet existant via l’interface compatible OpenAI, vous pouvez vous inspirer de l’exemple ci-dessous :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",  # Le nom de modèle réellement disponible dépend de la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "帮我定位这段 Python 代码的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Voir le code complet avec invite système et gestion des exceptions
import openai
from typing import Optional

def ask_hydrogen(
    prompt: str,
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000
) -> str:
    """Appelle Gemini 4 Hydrogen pour traiter des tâches courantes de programmation ou de mise en forme de documents"""
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        # Remarque : Hydrogen ignore les valeurs personnalisées de temperature/top_p/top_k, inutile de les définir
        # Les tokens de réflexion sont facturés dans la sortie, max_tokens doit donc réserver de la place pour la réflexion
        response = client.chat.completions.create(
            model="gemini-4-hydrogen",
            messages=messages,
            max_tokens=max_tokens
        )
        return response.choices[0].message.content
    except Exception as e:
        return f"Error: {str(e)}"

print(ask_hydrogen(
    prompt="把这份会议纪要整理为三级标题的 Markdown 文档",
    system_prompt="严格遵守用户指定的格式,不添加无关内容"
))
🚀 Démarrage rapide : APIYI (apiyi.com) propose une interface compatible OpenAI : une seule clé API suffit pour appeler OpenAI, Claude, Gemini et les autres grands modèles, et les nouveaux utilisateurs disposent d’un quota de test gratuit. Avant de vous connecter, vérifiez dans la liste des modèles de la plateforme que Hydrogen est bien disponible ainsi que son nom exact ; la manière de transmettre des paramètres comme le niveau de réflexion est décrite dans la documentation de la plateforme.
Les développeurs qui migrent depuis 3.8 Flash doivent faire attention à plusieurs changements incompatibles :
thinking_budgetetMINIMALne sont plus pris en charge ; continuer à les utiliser renvoie une erreur HTTP 400.- Le niveau de réflexion par défaut passe de Medium à High.
- Le cache de contexte explicite n’est plus pris en charge : seul reste disponible le cache implicite, avec un minimum de 4096 tokens.
- Les appels d’outils sur plusieurs tours nécessitent de sauvegarder et de renvoyer correctement les thought signatures.
Gemini 4 Hydrogen, Flash, Argon, Carbon : comment choisir ?
Répartition selon la difficulté de la tâche, la vitesse de réponse et la complexité d’exécution
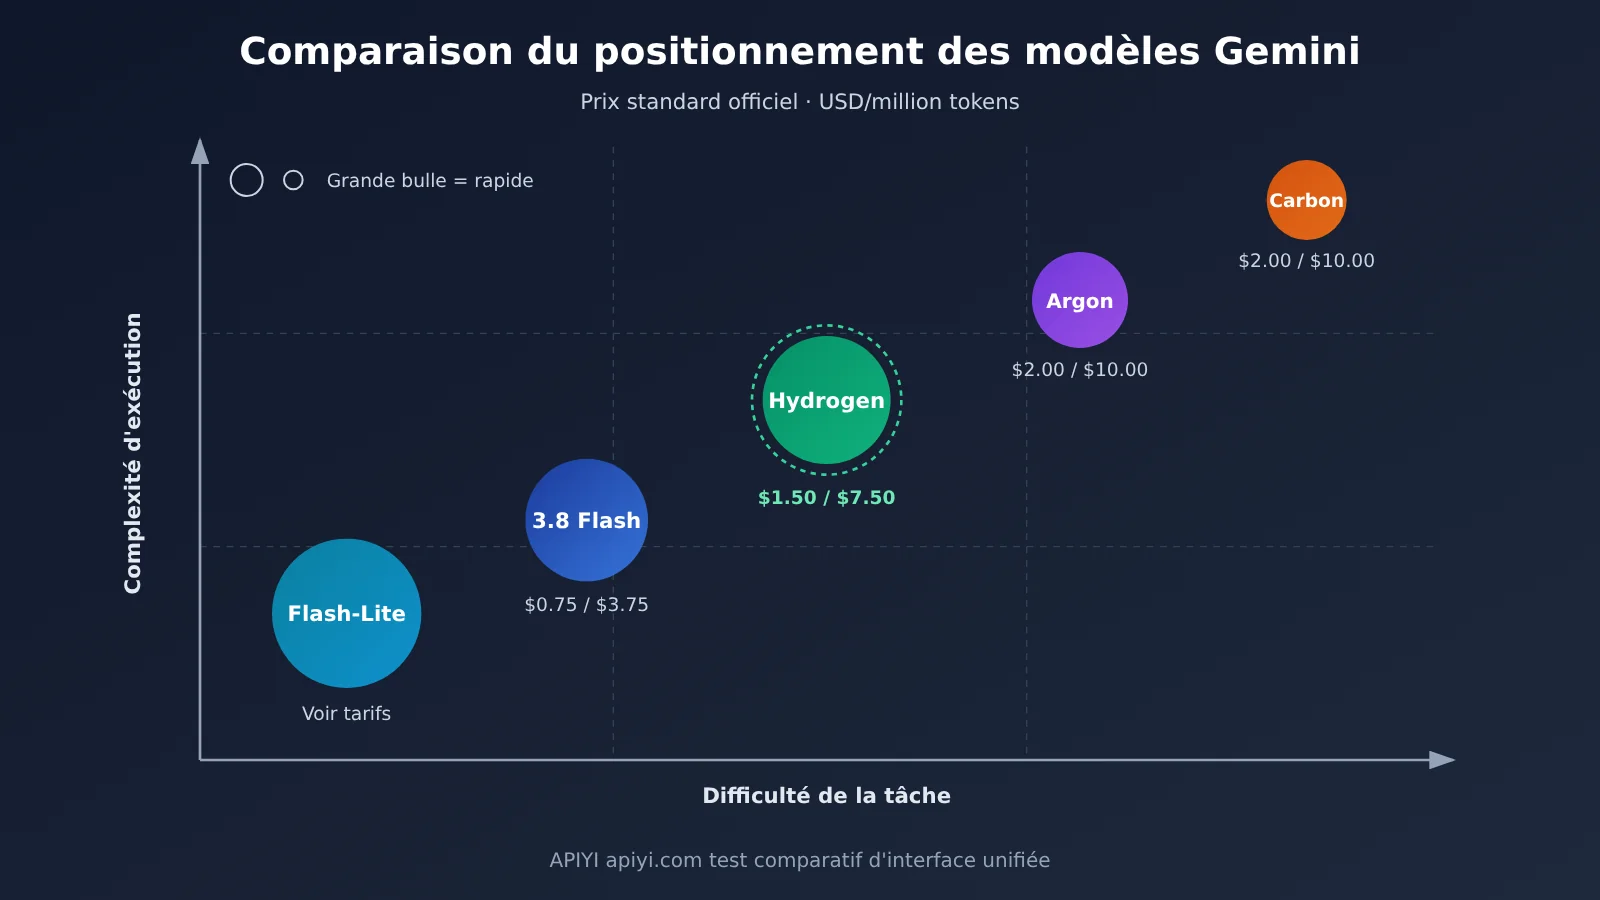
| Modèle | Difficulté de la tâche | Vitesse de réponse | Complexité d’exécution | Tâches typiques | Prix standard officiel de l’API (entrée/sortie) | Plateformes disponibles |
|---|---|---|---|---|---|---|
| Flash-Lite | Faible | La plus rapide | Faible | Questions-réponses simples | Non communiqué | Gemini App, etc. |
| Gemini 3.8 Flash | Moyenne-faible | Rapide | Moyenne | Tâches quotidiennes légères | 0,75 $ / 3,75 $ (jusqu’au 31 décembre 2026) | Gemini API, APIYI apiyi.com (voir la liste des modèles) |
| Gemini 4 Hydrogen | Moyenne-élevée | Rapide | Élevée (multi-outils) | Programmation quotidienne, traitement de documents, exécution d’agents | 1,50 $ / 7,50 $ | Gemini API, AI Studio, APIYI apiyi.com (voir la liste des modèles) |
| Gemini 4 Argon | Élevée | Moyenne | Élevée | Workflows complexes | 2,00 $ / 10,00 $ (jusqu’au 30 novembre 2026) | Gemini API, etc. |
| Gemini 4 Carbon | La plus élevée | Lente | La plus élevée | Conception d’architecture poussée, tâches longues et difficiles | 2,00 $ / 10,00 $ (jusqu’au 30 novembre 2026) | Gemini API, etc. |
Les prix proviennent de la page tarifaire officielle de Google AI Studio ; ils sont exprimés en dollars par million de tokens, ont été vérifiés le 13 novembre 2026 et sont calculés sur la base des appels Standard. Cette page précise que 3.8 Flash passera à 1,50 $/7,50 $ à compter du 1er janvier 2027, qu’Argon et Carbon passeront à 4 $/20 $ à compter du 1er décembre 2026, et qu’aucun ajustement tarifaire de ce type n’est annoncé pour Hydrogen pour le moment. Les tarifs Batch et Flex de Hydrogen sont de 0,75 $/3,75 $, et le tarif Priority de 2,70 $/13,50 $.
À sa sortie, le prix standard par token de Hydrogen est donc le double du tarif actuel de 3.8 Flash, et non un tarif plus avantageux. Les tokens de réflexion étant facturés au tarif de sortie, le coût total d’une tâche réelle dépend de la longueur de la réflexion, du nombre de tentatives, du volume d’appels d’outils et de l’efficacité avec laquelle la tâche est menée à terme. Sur les offres payantes, les 5 000 premières requêtes Google Search Grounding de chaque mois sont gratuites (quota partagé avec Gemini 3 et les modèles plus récents), puis facturées 14 dollars par 1 000 requêtes ; le niveau gratuit de l’API ne bénéficie pas de cette gratuité.
Différence entre utilisation seule et collaboration multi-modèles
Pour associer les tâches aux modèles, on peut voir les choses ainsi : les questions-réponses simples reviennent à Flash-Lite ; pour la programmation quotidienne, l’organisation de documents et les tâches Agent de complexité moyenne, Hydrogen offre un bon équilibre entre qualité et coût ; pour une conception architecturale approfondie nécessitant un raisonnement inter-modules, mieux vaut confier le travail à Carbon ou Argon. Utiliser Hydrogen seul convient aux tâches avec un objectif clair et des étapes bien définies. Face à des problèmes difficiles où il faut réévaluer la direction à plusieurs reprises, s’appuyer uniquement sur lui risque de faire trop d’étapes dans la mauvaise direction.
L’exemple type de collaboration multi-modèles est Google Antigravity Orchestrator, lancé à la même période. Dans ce flux de travail, Carbon analyse d’abord le dépôt de code et détermine le plan de modification, Hydrogen se charge des modifications concrètes, de la mise à niveau des dépendances et de l’exécution des tests, puis les erreurs complexes sont renvoyées à Carbon pour qu’il tranche. Google indique dans son rapport officiel que, dans le test Terminal-Bench 4.1, cette approche réduit en moyenne de 24 % la consommation de quota par rapport à Carbon utilisé seul, augmente de 19 % la vitesse d’achèvement et obtient des résultats proches de Carbon en termes de réussite.
💡 Conseil de sélection : Le choix du modèle dépend de la difficulté de la tâche et du budget. Je vous conseille de commencer par un même lot de tâches réelles, en exécutant séparément Hydrogen aux niveaux Medium et High, puis Argon, et de comparer le taux de réussite et la consommation de tokens. APIYI apiyi.com prend en charge les appels via une interface unifiée pour plusieurs modèles : pour changer de modèle, il suffit de modifier le paramètre model, ce qui facilite ce type de comparaison.
Analyse d’impact de Gemini 4 Hydrogen
Impact pour les développeurs
- Une nouvelle option pour la couche d’exécution des agents : sur les appels multi-outils et les tâches d’automatisation, les résultats officiels de Hydrogen dépassent nettement ceux de 3.8 Flash, ce qui en fait un bon exécuteur et vérificateur dans un système d’agents.
- La migration demande de modifier la configuration : les paramètres de réflexion, le mécanisme de cache, les paramètres d’échantillonnage et les signatures d’appel d’outils ont tous changé ; remplacer directement le nom du modèle risque de provoquer des erreurs.
- La méthode d’estimation des coûts doit changer : le prix unitaire double, mais l’efficacité d’exécution des tâches peut augmenter ; il faut calculer le coût total par tâche complète, et non par requête individuelle.
Impact sur le secteur et les utilisateurs ordinaires
- Une expérience de recherche améliorée : Hydrogen est déjà utilisé dans Google Search pour mieux traiter les questions complexes à conditions multiples, les fautes de frappe, les requêtes à chemins multiples et les réponses visuelles.
- « Planification par un grand modèle, exécution par un petit modèle » devient une pratique courante : Orchestrator a fait de la répartition des tâches entre modèles une fonctionnalité produit, ce qui abaisse le seuil d’entrée pour l’orchestration multi-modèles.
- Les limites subsistent : la fiche officielle du modèle montre que l’indicateur de refus injustifiés de Hydrogen s’est dégradé de 5,57 points de pourcentage par rapport à 3.8 Flash, et le rapport de sécurité complet n’a pas encore été publié. Sur Hacker News, certains utilisateurs signalent aussi des problèmes de sur-exécution dans certaines tâches d’agents.
FAQ – Questions fréquentes sur Gemini 4 Hydrogen
Q1 : Qu’est-ce que Gemini 4 Hydrogen ?
C’est le modèle de la série Gemini 4 officiellement lancé par Google DeepMind le 12 novembre 2026. Son ID de modèle API est `gemini-4-hydrogen`. Il est positionné comme un modèle d’exécution efficace pour la programmation quotidienne et les AI Agents, avec un contexte unifié d’un million de tokens et quatre niveaux de réflexion.
Q2 : Quelle est la différence avec Gemini 3.8 Flash ?
Selon les données officielles, Hydrogen obtient 57,0 % à Terminal-Bench 4.1 contre 18,2 % pour 3.8 Flash, et termine les tâches environ 2,5 fois plus vite dans les mêmes conditions. En revanche, son prix unitaire API standard est le double du prix actuel de 3.8 Flash, et la migration implique aussi de gérer des paramètres incompatibles.
Q3 : Les utilisateurs gratuits peuvent-ils utiliser Gemini 4 Hydrogen ?
Oui. Avec un compte gratuit sur Gemini App, une fois l’option Auto activée, les requêtes qui nécessitent une réflexion peuvent être confiées à Hydrogen. Dans la couche gratuite de Google AI Studio, vous pouvez sélectionner directement ce modèle, mais sous réserve des limites RPM, TPM et RPD.
Q4 : Pour quels cas d’usage est-il le plus adapté ?
– **Correction de bugs et mise à jour des dépendances dans un dépôt de code** : il privilégie les modifications précises et évite autant que possible de toucher au code sans rapport.
– **Synthèse de documents multi-formats** : il peut analyser simultanément des PDF, Excel, PPT, graphiques et pages web.
– **Exécution d’agents multi-outils** : il peut fonctionner seul, ou exécuter des étapes concrètes sous la planification de Carbon/Argon.
Q5 : Comment appeler rapidement Gemini 4 Hydrogen via l’API ?
Outre l’API Gemini officielle de Google, vous pouvez aussi passer par une plateforme d’agrégation compatible OpenAI :
1. Créez un compte sur APIYI apiyi.com pour obtenir une clé API et un quota d’essai gratuit.
2. Vérifiez dans la liste des modèles que Hydrogen est bien disponible et son nom de modèle.
3. Définissez le `base_url` du code de cet article sur `https://api.apiyi.com/v1`, puis lancez la vérification.
Q6 : Quelles sont les limitations connues de Gemini 4 Hydrogen ?
Il peut encore produire des hallucinations, ses connaissances s’arrêtent à mars 2026 et les événements récents nécessitent une recherche. Les niveaux de réflexion élevés augmentent nettement le temps et le coût, avec parfois des dépassements de délai. Il ne prend pas en charge la Live API, le cache explicite ni le Fine-tuning. Si vous souhaitez comparer d’autres modèles comme alternatives, vous pouvez tester le changement de modèle avec le même code sur APIYI apiyi.com.
Gemini 4 Hydrogen : les points clés à retenir
- Sortie officielle : mise en ligne le 12 novembre 2026, confirmée par le blog officiel, la fiche modèle et la documentation technique.
- Positionnement : le modèle d’exécution efficace de la famille Gemini 4, chargé des tâches courantes de programmation et d’agents.
- Règle de contexte : 1,048,576 tokens partagés entre l’entrée, la réflexion, les appels d’outils et la sortie.
- Quatre niveaux de réflexion : High est le niveau par défaut, le plus équilibré en rapport qualité-prix ; XHigh fait nettement grimper le coût.
- Points d’entrée gratuits : le mode Auto de Gemini App, le niveau gratuit d’AI Studio, le niveau gratuit de l’API Gemini.
- Alerte coût : le prix unitaire standard est le double du tarif actuel de 3.8 Flash ; il faut calculer le coût total sur une tâche complète.
- Pour démarrer : côté intégration, on peut comparer et valider rapidement via l’interface unifiée d’APIYI apiyi.com.
En résumé : qui devrait essayer Gemini 4 Hydrogen en priorité ?
Chaque profil peut partir d’un point d’entrée différent :
- Utilisateurs grand public : ouvrez Auto dans Gemini App, puis vérifiez le modèle réellement appelé via More → Show thinking steps.
- Créateurs de contenu : testez dans le niveau gratuit d’AI Studio la synthèse de longs documents, la réécriture formatée et la combinaison de sources multi-formats.
- Développeurs : concentrez-vous sur la modification et le débogage de code ; avant de migrer, vérifiez d’abord les paramètres thinking et la configuration du cache.
- Constructeurs d’agents : utilisez Hydrogen comme couche d’exécution, confiez les décisions complexes à Carbon ou Argon, et comparez le coût total sur des tâches réelles.
Pour choisir votre parcours de départ : si vous voulez simplement essayer, prenez Gemini App ou Google AI Studio ; pour une intégration côté développement, prenez l’API. Si vous souhaitez comparer avec une seule clé les performances de Gemini, Claude, OpenAI et d’autres modèles dans votre propre activité, passez par APIYI apiyi.com pour valider rapidement — les nouveaux utilisateurs disposent d’un quota de test gratuit.
📚 Références
- Blog officiel de Google : Introducing Gemini 4 Hydrogen : annonce de lancement et cas d’usage des partenaires
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Description : positionnement officiel, comparaison des performances et cas de démonstration
-
Blog officiel de Google en chinois : annonce de lancement en chinois
-
Lien :
china.googleblog.com/2026/11/gemini-4-hydrogen.html -
Fiche modèle et méthodologie d’évaluation de Google DeepMind : évaluation inter-modèles et données de sécurité
- Lien :
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Lien :
deepmind.google/models/evals-methodology/gemini-4-hydrogen/ -
Documentation technique Google Cloud : caractéristiques techniques et guide de migration
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Page tarifs et limites de requêtes de Google AI Studio : tarifs de l’API et règles du niveau gratuit
- Lien :
aistudio.google.com/docs/pricing -
Lien :
ai.google.dev/gemini-api/docs/rate-limits -
Centre d’aide Gemini Apps : niveaux d’abonnement, mode Auto et manière de consulter le modèle
-
Lien :
support.google.com/gemini/answer/18648722 -
Évaluation indépendante d’Artificial Analysis : indice d’intelligence de réflexion sur quatre niveaux
-
Lien :
artificialanalysis.ai/models/gemini-4-hydrogen -
Blog Google Antigravity : orchestration multi-modèles Orchestrator
-
Lien :
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity -
Articles de presse tiers : TechCrunch, Ars Technica, 9to5Google, The Verge
- Lien :
arstechnica.com/google/2026/11/google-rolls-out-gemini-4-hydrogen-finally-replacing-3-8-flash/ - Lien :
9to5google.com/2026/11/12/gemini-4-hydrogen-launch/
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; pour davantage de ressources d’intégration, consultez le centre de documentation docs.apiyi.com