Nota del autor: Gemini 4 Hydrogen reúne en un mismo modelo la programación cotidiana, el procesamiento de documentos y la ejecución de agentes. Este artículo repasa sus nuevas capacidades, las vías de acceso gratuito y cómo se reparte el trabajo con los demás modelos de la misma familia.
Resumen en una frase: Gemini 4 Hydrogen es el modelo de ejecución de alta eficiencia que Google presenta dentro de la familia Gemini 4, pensado para programación cotidiana, agentes con múltiples herramientas y procesamiento de documentos en varios formatos. Los usuarios gratuitos pueden probarlo mediante el modo Auto de Gemini App o el nivel gratuito de Google AI Studio.
Para saber: 5 términos que conviene conocer antes de leer
- Agente: sistema en el que el modelo y un entorno de ejecución de herramientas completan juntos tareas de varios pasos; por ejemplo, primero buscan archivos, luego modifican el código y al final ejecutan pruebas.
- Token: unidad de medida con la que el modelo procesa texto y otro tipo de información. Tanto la facturación de la API como el límite de contexto se calculan en tokens.
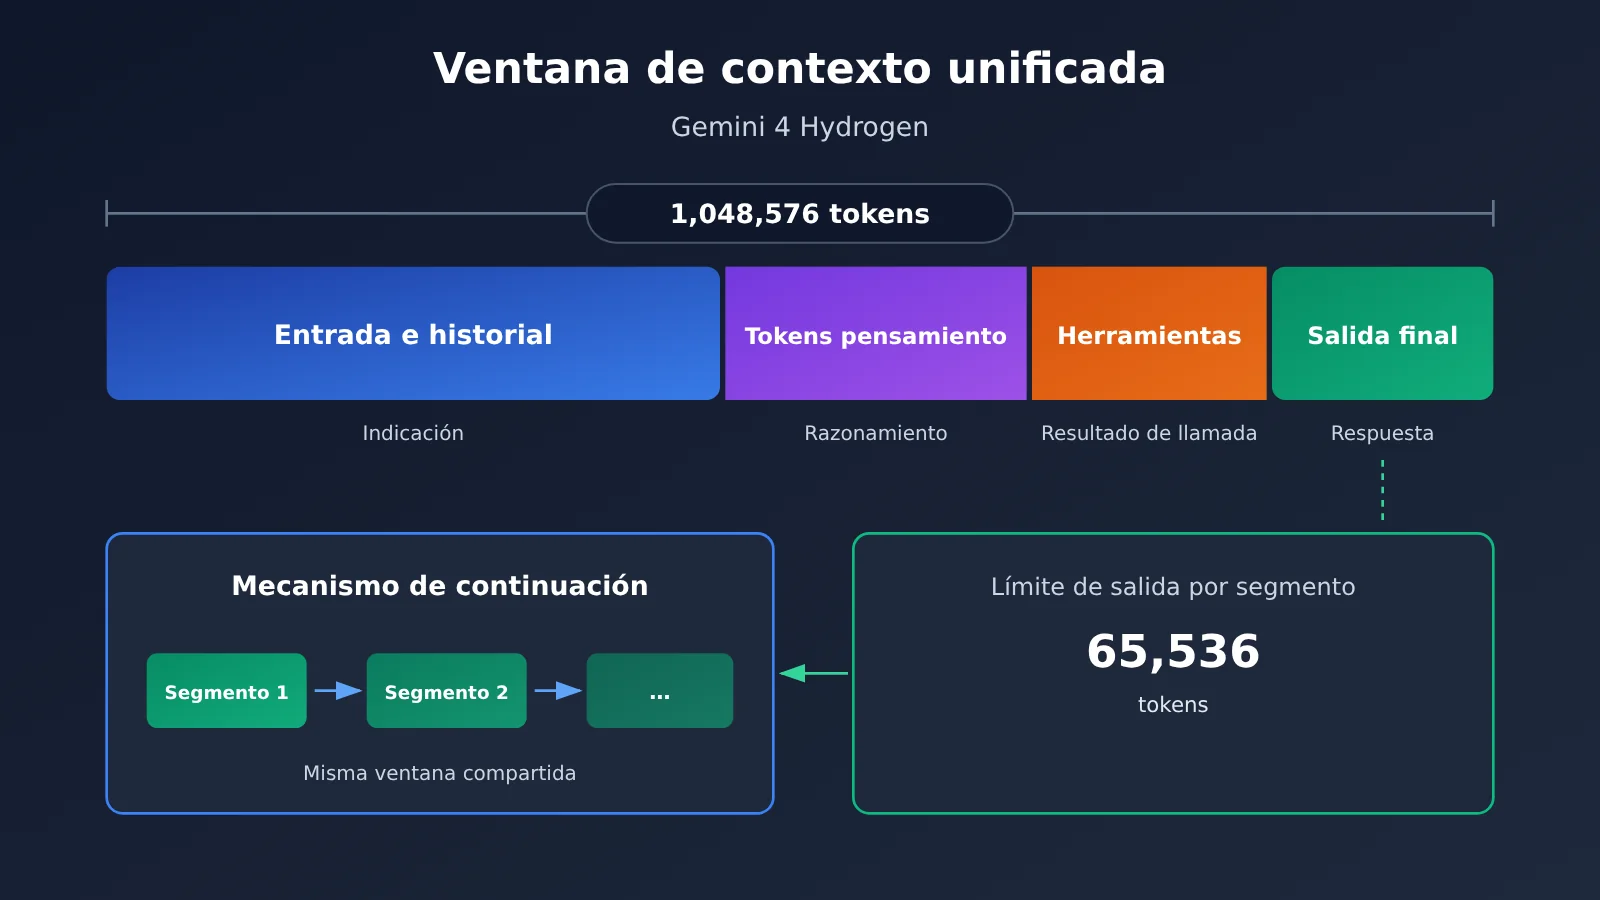
- Ventana de contexto: rango de información que puede contener una sola invocación del modelo; el límite concreto lo define cada modelo. En Hydrogen, la entrada, el razonamiento, las llamadas a herramientas y la salida suman 1,048,576 tokens.
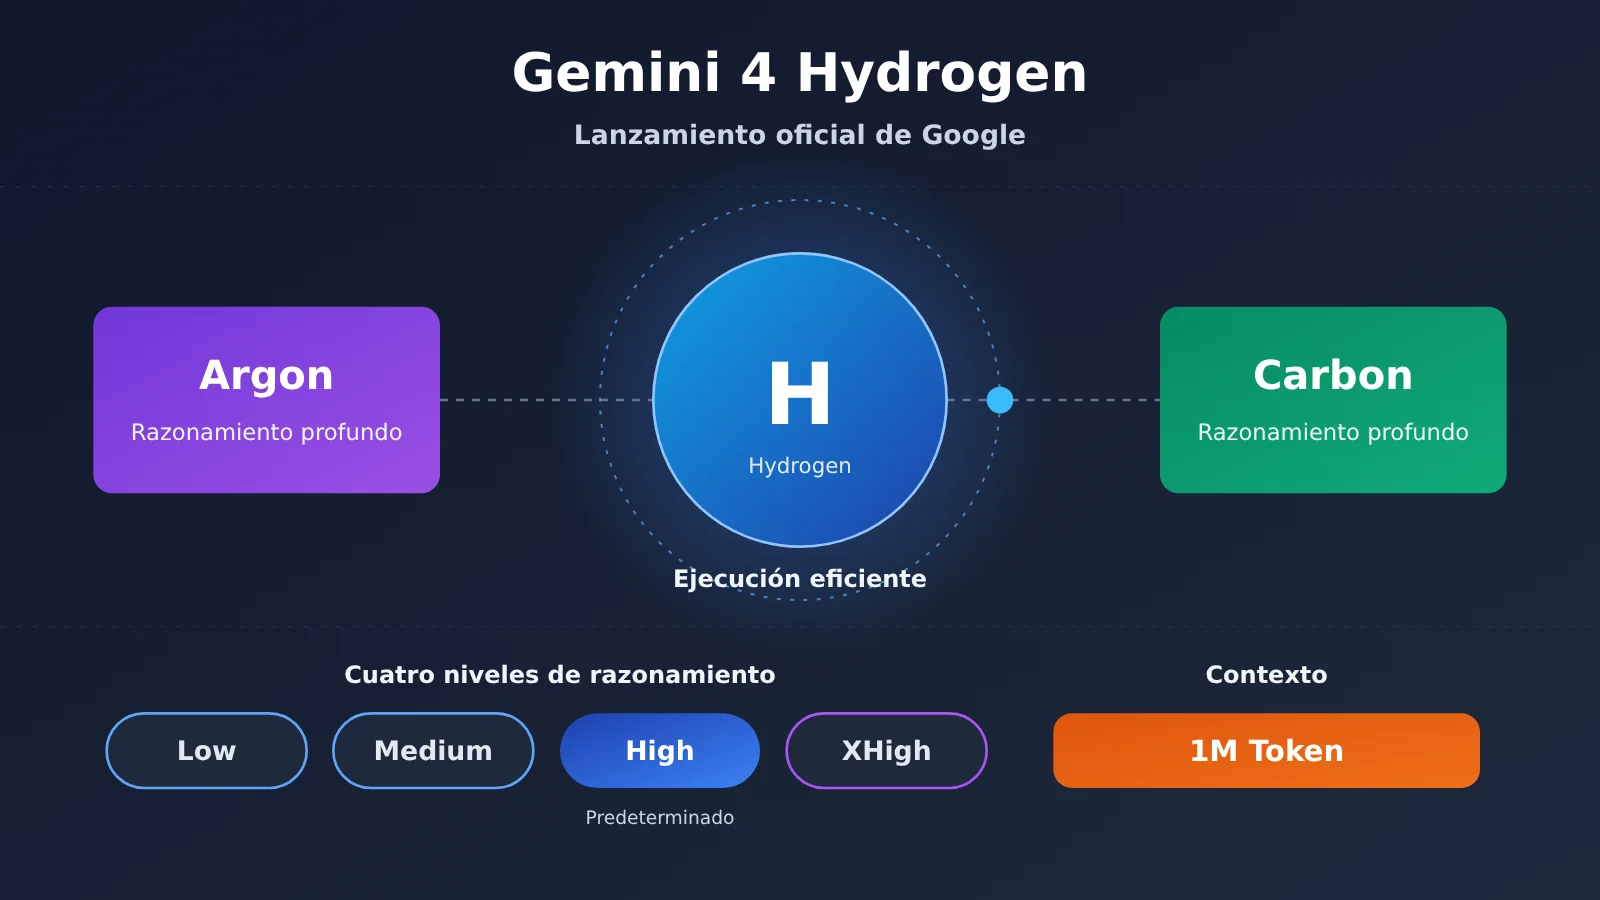
- thinking_level: parámetro del nivel de pensamiento que controla la profundidad de razonamiento del modelo. Hydrogen ofrece cuatro niveles: Low, Medium, High y XHigh.
- Grounding: vincular la respuesta generada con evidencia externa recuperada, por ejemplo Google Search Grounding y Google Maps Grounding.
Google lanzó oficialmente Gemini 4 Hydrogen el 12 de noviembre de 2026 y comenzó a desplegarlo de forma gradual en Gemini API, Google AI Studio, Gemini App y Google Search. Su mayor cambio esta vez es llevar el nivel de inteligencia de la familia Gemini 4 a tareas cotidianas de alta frecuencia. En Terminal-Bench 4.1, el resultado oficial es del 57.0%, frente al 18.2% de la generación anterior, Gemini 3.8 Flash.
No se trata de una filtración ni de un adelanto. El blog oficial de Google, la ficha del modelo de Google DeepMind, la documentación técnica de Google Cloud y el blog oficial de Google en chino han confirmado de forma cruzada este lanzamiento; TechCrunch, Ars Technica, 9to5Google y The Verge también lo han cubierto.
Valor central: en unos minutos puedes entender qué mejora Gemini 4 Hydrogen, desde dónde usarlo gratis y si encaja con tu trabajo.
Google lanza oficialmente Gemini 4 Hydrogen: la familia Gemini 4 suma un nuevo integrante
Información clave sobre Gemini 4 Hydrogen
| Elemento | Detalles verificados |
|---|---|
| Fecha de lanzamiento | 12 de noviembre de 2026, despliegue gradual en todo el mundo |
| Publicado por | Google DeepMind |
| ID del modelo en la API | gemini-4-hydrogen |
| Posicionamiento oficial | Modelo de ejecución eficiente para programación diaria y agentes de IA |
| Modelos de la misma serie | Gemini 4 Carbon, Gemini 4 Argon |
| Límite de contexto | Entrada, pensamiento, llamadas a herramientas y salida: 1.048.576 tokens en total |
| Niveles de pensamiento | Low / Medium / High / XHigh; en la API, High por defecto |
| Fecha de corte de conocimiento | Marzo de 2026 |
| Estado del producto | Disponibilidad general (Google Cloud lo marca como GA a corto plazo; con notificación mínima de 45 días antes de la retirada) |
Dentro de la familia Gemini 4, la división de tareas entre los tres modelos es bastante clara. Carbon y Argon se encargan del razonamiento profundo, complejo y prolongado; Hydrogen prioriza la velocidad, la programación cotidiana, las llamadas a múltiples herramientas y la ejecución automatizada. La ficha oficial del modelo también indica que Hydrogen deriva de Gemini 4 Carbon, pero Google no ha publicado el número exacto de parámetros.
Hydrogen puede usarse por sí solo o desempeñar el papel de ejecutor o validador en sistemas de agentes multimodelo. Una práctica habitual es dejar que Carbon o Argon tomen las decisiones y luego Hydrogen se encargue de ejecutar. Ars Technica interpretó este lanzamiento como una toma de relevo de la serie Flash por parte de Hydrogen.
Resultados oficiales de Gemini 4 Hydrogen frente a Gemini 3.8 Flash
| Prueba | Gemini 4 Hydrogen | Gemini 3.8 Flash | Fuente de los datos |
|---|---|---|---|
| Terminal-Bench 4.1 | 57,0% | 18,2% | Oficial de Google |
| Velocidad de finalización de tareas en las mismas condiciones de prueba | Aproximadamente 2,5 veces más rápido | Referencia | Oficial de Google |
| Frecuencia de invención de hechos | Más de 5 veces menor | Referencia | Oficial de Google |
| Tareas empresariales con datos de grafos, SQL y similares | Velocidad de ejecución 2-2,8 veces mayor; uso de tokens 12%-23% menor | Referencia | Pruebas de socios |
Estas cifras proceden de datos oficiales o de pruebas de socios, así que no permiten concluir directamente que Hydrogen sea 2,5 veces más rápido en todas las tareas. En la evaluación cruzada de modelos de la ficha de DeepMind, Hydrogen obtiene 76,1% en AutomationBench-AA, 71,6% en Agents’ Last Exam v1.1 y 58,8% en HLE-Diamond. Pero en Terminal-Bench 4.1 (57,0%) y OSWorld-2.1 (77,6%) queda por debajo de Claude Sonnet 5.5, que obtiene 63,9% y 83,9%. La nota metodológica oficial también señala que algunas puntuaciones de la competencia provienen de los propios fabricantes o de clasificaciones públicas, y que las configuraciones de prueba no son del todo equivalentes.
¿Qué capacidades ha mejorado Gemini 4 Hydrogen?
Mejoras en cuatro tipos de tareas específicas
Los escenarios clave que Google ha enumerado oficialmente se pueden agrupar en cuatro categorías, y cada una corresponde a un aspecto concreto del trabajo diario:
- Modificación y depuración de código: comprender el repositorio de código, localizar errores, corregir bugs, modificar dependencias y ejecutar pruebas. La mejora clave de esta versión es la edición precisa, es decir, cambiar solo lo que debe cambiarse sin tocar el código no relacionado.
- Ejecución de agentes de múltiples pasos: llamar herramientas de forma continua, buscar archivos en paralelo y ejecutar operaciones. Cuando falla una llamada a herramienta, puede ajustar la estrategia y seguir avanzando.
- Comprensión de documentos y multimodal: puede leer PDF, DOC/DOCX, PPT/PPTX, XLS/XLSX, OpenDocument, gráficos y páginas web. Una sola solicitud puede incluir hasta 3000 imágenes o documentos, una entrada de video con audio de aproximadamente 45 minutos, sin audio de aproximadamente 1 hora, y audio de hasta aproximadamente 8.4 horas.
- Desarrollo web interactivo: generar páginas interactivas, prototipos de sitios web, componentes ejecutables y contenido visual.
Cabe señalar que la salida de Hydrogen es solo texto; las imágenes, el audio y el video solo pueden utilizarse como entrada. Puede comprender video y también participar en el flujo de producción de video, pero no es en sí mismo un modelo de generación de video. Los casos de edición de video que Google mostró dependen de habilidades personalizadas y herramientas externas.
Casos reales de Gemini 4 Hydrogen: Box, Pixelcut y la demostración de Google
Los datos de los socios que aparecen a continuación provienen de las pruebas iniciales divulgadas en el anuncio de Google y no han sido replicados por terceros independientes. Box usa Hydrogen para procesar documentos empresariales, hojas de cálculo y cálculos de datos; es aproximadamente 2 veces más rápido que 3.8 Flash y reduce el uso de tokens en 12%. Pixelcut realizó 276 ejecuciones en diseño automatizado y generación de código, con una velocidad 1.8 veces mayor y una limpieza del código 30% mejor.
Las demostraciones de Google se inclinan hacia lo visual. Por ejemplo, generar en tiempo real estructuras 3D en una isla de voxels compartida usando lenguaje natural (Geminisland), crear prototipos de sitios de comercio electrónico con efectos WebGL2 y componentes 3D de productos, y generar Google Slides a partir de videos de charlas de YouTube y plantillas, con verificación y corrección automática de la superposición de texto. Estos casos muestran que Google ya ha validado los flujos de trabajo correspondientes, pero un usuario común no necesariamente tendrá éxito al primer intento con las mismas indicaciones.
Contexto unificado de un millón de tokens y cuatro niveles de razonamiento
Los 1,048,576 tokens de Hydrogen son una cuota unificada: la entrada, el contexto histórico, los tokens de razonamiento, los tokens de llamadas a herramientas y la salida final se descuentan de esta cuota. Por eso no es «1 millón de entrada y luego 1 millón de salida». La generación en primer plano de un solo tramo suele tener un límite de 65,536 tokens; las salidas más largas necesitan continuar mediante continuation_token o el mecanismo de generación larga en segundo plano, y aun así siguen sujetas a la cuota unificada.
Los niveles de razonamiento influyen mucho en el rendimiento real. A continuación se presentan los resultados de la evaluación independiente que Artificial Analysis completó el 12 de noviembre; se trata de datos de terceros:
| Nivel de razonamiento | Uso recomendado oficial | Índice de inteligencia | Tiempo medio en tareas de referencia | Costo medio en tareas de referencia |
|---|---|---|---|---|
| Low | Tareas simples como clasificación | 27 | 1.3 minutos | $0.29 |
| Medium | Programación habitual | 41 | 3.7 minutos | $0.80 |
| High (predeterminado de API) | Agentes de varios pasos | 51 | 8.3 minutos | $1.87 |
| XHigh | Razonamiento profundo complejo | 54 | 13.5 minutos | $3.16 |
Los tiempos y costos de esta tabla son resultados de las tareas de evaluación estandarizadas de Artificial Analysis Intelligence Index v5.0.1, y no representan el tiempo ni el costo reales de cada conversación normal. Los datos permiten ver dos cosas. Primero, dentro del mismo nombre de modelo, High y Medium difieren en 10 puntos, por lo que al compararlos hay que indicar el nivel. Segundo, XHigh solo aventaja a High en 3 puntos, pero el costo medio sube de 1.87 a 3.16 dólares, así que el nivel más alto no necesariamente resulta conveniente.
¿Cómo probar Gemini 4 Hydrogen gratis? Las tres vías de acceso explicadas
Cómo usar Gemini 4 Hydrogen en cada nivel
| Vía de acceso / nivel de usuario | Forma de uso de Hydrogen | Descripción |
|---|---|---|
| Cuenta gratuita de Gemini App | Se activa mediante el enrutamiento automático de Auto | Las preguntas simples suelen usar Flash-Lite; las solicitudes que requieren razonamiento pueden enviarse a Hydrogen |
| Google AI Plus | Selección manual disponible | Cambiar desde el selector de modelos |
| Google AI Pro | Selección manual disponible y también se puede usar en Tasks | Despliegue gradual en Antigravity |
| Google AI Ultra | Selección manual disponible y acceso a modelos de nivel superior | Orchestrator disponible (Carbon/Argon) |
| Nivel gratuito de Google AI Studio | Seleccionar directamente el ID del modelo | Sujeto a los límites del nivel gratuito |
| Nivel gratuito de Gemini API | Llamar a gemini-4-hydrogen |
Los límites de RPM/TPM/RPD se calculan por proyecto |
Vía de acceso 1: Gemini App. Cuando un usuario gratuito activa Auto, el sistema elige el modelo automáticamente según la dificultad de la tarea, y las solicitudes que requieren razonamiento pueden enviarse a Hydrogen. Si desactivas Auto, la cuenta gratuita usará Flash-Lite. Hay un detalle que suele generar confusión: al seleccionar manualmente un modelo en Gemini App, si no se especifica otro nivel de pensamiento, el valor predeterminado es Low; en cambio, el nivel predeterminado de la API de Hydrogen es High.
Para confirmar qué modelo se usó en una respuesta, en computadora puedes seguir las instrucciones del Centro de Ayuda oficial: haz clic en Más → Mostrar pasos de pensamiento debajo de la respuesta y desplázate hasta el final para ver la información del modelo. La interfaz puede variar según el cliente y la región, así que guíate por lo que aparezca en pantalla.
Vía de acceso 2: Google AI Studio. En la lista de modelos, basta con seleccionar Gemini 4 Hydrogen para probarlo en una conversación; es ideal para validar el efecto de las indicaciones y del nivel de pensamiento antes de escribir código. El nivel gratuito no tiene un número fijo de invocaciones; en su lugar, se aplican límites por proyecto de RPM (solicitudes por minuto), TPM (tokens de entrada por minuto) y RPD (solicitudes por día, reiniciado a medianoche hora del Pacífico). Los límites reales son los que AI Studio muestre como límites efectivos.
Vía de acceso 3: Gemini API. Tanto el nivel gratuito como el de pago pueden llamar a la API, pero con límites distintos. Además, el contenido del nivel gratuito de la API puede usarse para mejorar productos de Google; la página oficial de precios indica que el contenido del nivel de pago no se usa para ese fin. Si manejas datos comerciales sensibles, debes tenerlo en cuenta.
Google lo describe como un «despliegue gradual»; el mismo día del lanzamiento, algunos usuarios informaron que la opción del modelo apareció brevemente en Gemini App y luego desapareció, o que el modelo era visible en Antigravity pero las llamadas fallaban. Un lanzamiento global tampoco significa que el acceso a la red, la elegibilidad de cuentas y las políticas de servicio en China continental no tengan restricciones.
Ejemplo de invocación de la API de Gemini 4 Hydrogen
Si necesitas integrarlo en un proyecto existente a través de la interfaz compatible con OpenAI, puedes inspirarte en el siguiente enfoque:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",  # El nombre real del modelo disponible está sujeto a la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "帮我定位这段 Python 代码的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Ver el código completo con indicación de sistema y manejo de excepciones
import openai
from typing import Optional

def ask_hydrogen(
    prompt: str,
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000
) -> str:
    """Llama a Gemini 4 Hydrogen para tareas cotidianas de programación u organización de materiales"""
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        # Nota: Hydrogen ignora temperature/top_p/top_k personalizados, no hace falta configurarlos
        # Los tokens de pensamiento cuentan en la facturación de salida; max_tokens debe reservar espacio para el pensamiento
        response = client.chat.completions.create(
            model="gemini-4-hydrogen",
            messages=messages,
            max_tokens=max_tokens
        )
        return response.choices[0].message.content
    except Exception as e:
        return f"Error: {str(e)}"

print(ask_hydrogen(
    prompt="把这份会议纪要整理为三级标题的 Markdown 文档",
    system_prompt="严格遵守用户指定的格式,不添加无关内容"
))
🚀 Inicio rápido: APIYI apiyi.com ofrece una interfaz compatible con OpenAI; con una sola clave API puedes invocar modelos populares como OpenAI, Claude y Gemini, y los nuevos usuarios disponen de cuota de prueba gratuita. Antes de integrarte, confirma en la lista de modelos de la plataforma el estado de disponibilidad y el nombre del modelo Hydrogen; la forma de pasar parámetros como el nivel de pensamiento está sujeta a la documentación de la plataforma.
Los desarrolladores que migran desde 3.8 Flash deben prestar especial atención a varios cambios incompatibles:
thinking_budgetyMINIMALya no son compatibles; si los sigues usando, recibirás un HTTP 400.- El nivel de pensamiento predeterminado cambió de Medium a High.
- La caché de contexto explícita ya no es compatible; solo existe caché implícita de mínimo 4096 tokens.
- Las llamadas a herramientas en múltiples turnos requieren guardar y devolver correctamente las thought signatures.
Gemini 4 Hydrogen, Flash, Argon y Carbon: ¿cómo elegirlos?
Cómo repartir el trabajo según la dificultad de la tarea, la velocidad de respuesta y la complejidad de ejecución
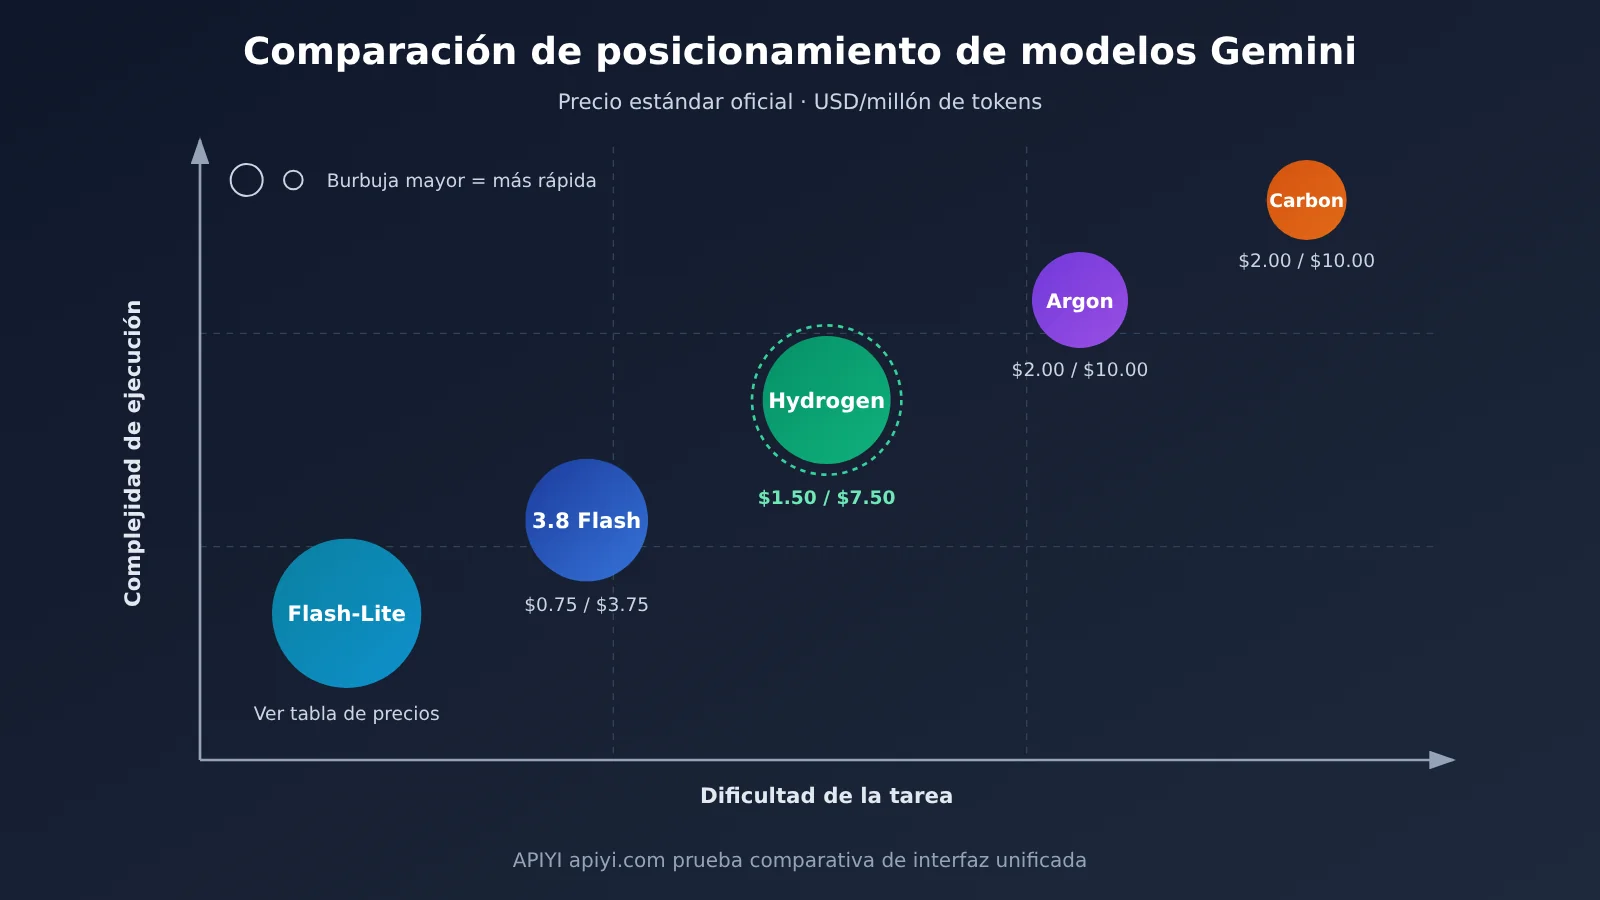
| Modelo | Dificultad de la tarea | Velocidad de respuesta | Complejidad de ejecución | Tareas típicas | Precio estándar oficial de la API (entrada/salida) | Plataformas disponibles |
|---|---|---|---|---|---|---|
| Flash-Lite | Baja | La más rápida | Baja | Preguntas y respuestas simples | Datos no disponibles | Gemini App, etc. |
| Gemini 3.8 Flash | Media-baja | Rápida | Media | Tareas cotidianas ligeras | $0.75 / $3.75 (hasta el 31 de diciembre de 2026) | Gemini API, APIYI apiyi.com (consultar la lista de modelos) |
| Gemini 4 Hydrogen | Media-alta | Rápida | Alta (con múltiples herramientas) | Programación cotidiana, procesamiento de documentos, ejecución de agentes | $1.50 / $7.50 | Gemini API, AI Studio, APIYI apiyi.com (consultar la lista de modelos) |
| Gemini 4 Argon | Alta | Media | Alta | Flujos de trabajo complejos | $2.00 / $10.00 (hasta el 30 de noviembre de 2026) | Gemini API, etc. |
| Gemini 4 Carbon | La más alta | Lenta | La más alta | Diseño de arquitectura complejo, tareas difíciles de larga duración | $2.00 / $10.00 (hasta el 30 de noviembre de 2026) | Gemini API, etc. |
Los precios provienen de la página oficial de precios de Google AI Studio, están en dólares por millón de tokens, se verificaron el 13 de noviembre de 2026 y se calculan según la llamada estándar Standard. La página de precios indica que 3.8 Flash se ajustará a $1.50/$7.50 a partir del 1 de enero de 2027, mientras que Argon y Carbon se ajustarán a $4/$20 a partir del 1 de diciembre de 2026. Por ahora no se ha anunciado un ajuste similar para Hydrogen. Los precios Batch y Flex de Hydrogen son $0.75/$3.75, y Priority es $2.70/$13.50.
Por lo tanto, en el momento de la publicación, el precio estándar por token de Hydrogen es el doble del precio actual de 3.8 Flash, no más barato. Los tokens de razonamiento se contabilizan en el precio de salida, por lo que el coste total real de una tarea depende de la longitud del razonamiento, el número de reintentos, la cantidad de llamadas a herramientas y la eficiencia de finalización. En el nivel de pago, Google Search Grounding es gratuito para las primeras 5000 llamadas de cada mes (compartido con Gemini 3 y modelos más recientes); después cuesta 14 dólares por cada 1000 llamadas. El nivel gratuito de API no incluye esta cuota gratuita.
Diferencias entre el uso individual y la colaboración multi-modelo
Para asignar tareas a los modelos, se puede entender así: las preguntas y respuestas sencillas se delegan a Flash-Lite; para programación diaria, organización de documentación y tareas de Agent de complejidad media, Hydrogen es la opción con el equilibrio más razonable entre coste y rendimiento; para diseños de arquitectura profunda que requieren razonamiento entre módulos, se delega a Carbon o Argon. Usar Hydrogen de forma individual es adecuado para tareas con objetivos claros y pasos bien definidos. Cuando se enfrenta a problemas difíciles que exigen juzgar la dirección una y otra vez, apoyarse solo en él fácilmente lleva a dar demasiados pasos en la dirección equivocada.
El representante de la colaboración multi-modelo es el Google Antigravity Orchestrator, publicado al mismo tiempo. En este flujo, Carbon primero analiza el repositorio de código y determina el plan de modificación; Hydrogen se encarga de la edición concreta, actualizar dependencias y ejecutar las pruebas; y cuando aparece un error complejo, se devuelve a Carbon para que juzgue. Google informa oficialmente que, en la prueba Terminal-Bench 4.1, este método reduce el consumo de cuota una media del 24% en comparación con usar Carbon solo, aumenta la velocidad de finalización un 19% y el rendimiento de éxito se acerca al de Carbon.
💡 Recomendación de elección: qué modelo elegir depende de la dificultad de la tarea y del presupuesto. Se recomienda primero tomar el mismo lote de tareas reales y ejecutar por separado Hydrogen en los niveles Medium y High, así como Argon, para comparar la tasa de finalización y el consumo de Token. APIYI apiyi.com admite llamadas unificadas de interfaz para múltiples modelos; cambiar de modelo solo requiere modificar el parámetro model, lo que facilita este tipo de comparativas.
Análisis de impacto de Gemini 4 Hydrogen
Impacto para desarrolladores
- Nueva opción para la capa de ejecución de agentes: en tareas de invocación de múltiples herramientas y automatización, los resultados oficiales de Hydrogen mejoran notablemente respecto a 3.8 Flash, por lo que encaja bien como ejecutor y verificador dentro de sistemas de agentes.
- La migración exige cambiar la configuración: los parámetros de razonamiento, el mecanismo de caché, los parámetros de muestreo y la firma de invocación de herramientas han cambiado; sustituir directamente el nombre del modelo puede provocar errores.
- Cambia la forma de estimar costos: el precio unitario se duplica y, al mismo tiempo, la eficiencia de finalización de tareas puede aumentar; conviene calcular el costo total por tarea completa, no por solicitud individual.
Impacto en la industria y en los usuarios comunes
- Mejora en la experiencia de búsqueda: Hydrogen ya se usa en Google Search para mejorar el tratamiento de preguntas complejas con múltiples condiciones, errores tipográficos, consultas por varias rutas y respuestas visuales.
- «El modelo grande planifica, el modelo pequeño ejecuta» se vuelve una práctica habitual: Orchestrator convierte la división de tareas entre modelos en una función de producto, lo que reduce la barrera para la orquestación de múltiples modelos.
- Las limitaciones siguen existiendo: la ficha oficial del modelo muestra que la métrica de rechazos injustificados de Hydrogen empeoró 5.57 puntos porcentuales frente a 3.8 Flash, y el informe completo de seguridad aún no se ha publicado. En Hacker News también hay usuarios que señalan problemas de ejecución excesiva en algunas tareas de agentes.
Preguntas frecuentes sobre Gemini 4 Hydrogen
Q1: ¿Qué es Gemini 4 Hydrogen?
Es un modelo de la familia Gemini 4 que Google DeepMind lanzó oficialmente el 12 de noviembre de 2026. Su ID de modelo de API es `gemini-4-hydrogen` y está posicionado como un modelo eficiente para programación cotidiana y ejecución de agentes de IA. Es compatible con una ventana de contexto unificada de un millón de tokens y cuatro niveles de pensamiento.
Q2: ¿En qué se diferencia Gemini 4 Hydrogen de Gemini 3.8 Flash?
Según datos oficiales, Hydrogen obtiene 57.0% en Terminal-Bench 4.1, mientras que 3.8 Flash obtiene 18.2%; en las mismas condiciones, la velocidad de finalización de tareas es aproximadamente 2.5 veces mayor. Sin embargo, el precio unitario estándar de su API duplica el precio actual de 3.8 Flash, y al migrar también hay que lidiar con problemas de incompatibilidad de parámetros.
Q3: ¿Los usuarios gratuitos pueden usar Gemini 4 Hydrogen?
Sí. Cuando una cuenta gratuita de Gemini App activa el modo Auto, las solicitudes que requieran razonamiento pueden enviarse a Hydrogen. En el nivel gratuito de Google AI Studio se puede seleccionar directamente este modelo, pero está sujeto a los límites de RPM, TPM y RPD.
Q4: ¿En qué escenarios encaja mejor Gemini 4 Hydrogen?
– **Corrección de errores y actualización de dependencias dentro de repositorios de código**: prioriza ediciones precisas y evita tocar código no relacionado.
– **Síntesis de material en múltiples formatos**: puede analizar al mismo tiempo PDF, Excel, PPT, gráficos y páginas web.
– **Ejecución de agentes con múltiples herramientas**: puede ejecutarse por sí solo o llevar a cabo pasos concretos bajo la planificación de Carbon/Argon.
Q5: ¿Cómo invocar rápidamente Gemini 4 Hydrogen mediante la API?
Además de la API Gemini oficial de Google, también puedes usar plataformas agregadoras compatibles con OpenAI:
1. Regístrate en APIYI apiyi.com, obtén una clave API y un crédito de prueba gratuito.
2. Comprueba en la lista de modelos el estado de disponibilidad de Hydrogen y el nombre del modelo.
3. Configura base_url en el código de este artículo como `https://api.apiyi.com/v1` y luego ejecuta la verificación.
Q6: ¿Qué limitaciones conocidas tiene Gemini 4 Hydrogen?
Todavía puede alucinar; su conocimiento se corta en marzo de 2026, por lo que los eventos más recientes requieren búsqueda. Los niveles de pensamiento altos aumentan claramente el tiempo y el costo, y ocasionalmente pueden agotar el tiempo de espera. No es compatible con la API Live, el almacenamiento en caché explícito ni el ajuste fino (Fine-tuning). Si necesitas comparar otros modelos como alternativas, puedes usar el mismo código en APIYI apiyi.com para cambiar de modelo y probar.
Puntos clave de Gemini 4 Hydrogen
- Lanzamiento oficial: disponible desde el 12 de noviembre de 2026, confirmado por el blog oficial, la ficha del modelo y la documentación técnica.
- Posicionamiento principal: modelo de ejecución eficiente dentro de la familia Gemini 4, encargado de tareas cotidianas de programación y de agentes.
- Reglas de contexto: 1.048.576 tokens compartidos entre entrada, pensamiento, llamadas a herramientas y salida.
- Cuatro niveles de pensamiento: High es el nivel predeterminado con mejor equilibrio entre prestaciones y costo; XHigh aumenta claramente el costo.
- Accesos gratuitos: modo Auto de Gemini App, nivel gratuito de AI Studio y nivel gratuito de Gemini API.
- Aviso de costo: el precio unitario estándar duplica el precio actual de 3.8 Flash; conviene calcular el costo total por tarea completa.
- Cómo empezar: para integración de desarrollo, puedes usar APIYI apiyi.com y su interfaz unificada para comparar y validar rápidamente.
Resumen: ¿quién debería probar Gemini 4 Hydrogen primero?
Distintos usuarios pueden empezar por diferentes entradas:
- Usuarios generales: abre Auto en Gemini App y, mediante More → Show thinking steps, confirma qué modelo se está invocando realmente.
- Creadores de contenido: prueba en el nivel gratuito de AI Studio la organización de documentos largos, la reescritura con formato y la síntesis de materiales en varios formatos.
- Desarrolladores: céntrate en la modificación y depuración de código; antes de migrar, revisa los parámetros de pensamiento y la configuración de caché.
- Creadores de agentes: usa Hydrogen como capa de ejecución, deja las decisiones complejas a Carbon o Argon y compara el costo total con tareas reales.
Así puedes elegir el punto de partida: si solo quieres probarlo, elige Gemini App o Google AI Studio; si necesitas integración de desarrollo, elige la API. Si quieres usar una misma clave API para comparar Gemini, Claude, OpenAI y otros modelos en tu propio negocio, puedes validarlo rápidamente con APIYI apiyi.com; los nuevos usuarios disponen de crédito de prueba gratuito.
📚 Referencias
- Blog oficial de Google: Introducing Gemini 4 Hydrogen: anuncio de lanzamiento y casos de partners
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descripción: posicionamiento oficial, comparativas de rendimiento y casos de demostración
-
Blog oficial de Google en chino: anuncio de lanzamiento en chino
-
Enlace:
china.googleblog.com/2026/11/gemini-4-hydrogen.html -
Fichas de modelo y metodología de evaluación de Google DeepMind: evaluaciones entre modelos y datos de seguridad
- Enlace:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Enlace:
deepmind.google/models/evals-methodology/gemini-4-hydrogen/ -
Documentación técnica de Google Cloud: especificaciones y guía de migración
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Página de precios y límites de velocidad de Google AI Studio: precios de API y reglas del nivel gratuito
- Enlace:
aistudio.google.com/docs/pricing -
Enlace:
ai.google.dev/gemini-api/docs/rate-limits -
Centro de ayuda de Gemini Apps: niveles de suscripción, modo Auto y cómo consultar los modelos
-
Enlace:
support.google.com/gemini/answer/18648722 -
Evaluación independiente de Artificial Analysis: índice de inteligencia de razonamiento en cuatro niveles
-
Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen -
Blog de Google Antigravity: orquestación multimodelo con Orchestrator
-
Enlace:
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity -
Cobertura de terceros: TechCrunch, Ars Technica, 9to5Google, The Verge
- Enlace:
arstechnica.com/google/2026/11/google-rolls-out-gemini-4-hydrogen-finally-replacing-3-8-flash/ - Enlace:
9to5google.com/2026/11/12/gemini-4-hydrogen-launch/
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal del sitio oficial de APIYI; para más material de integración, visita el centro de documentación docs.apiyi.com