Note de l’auteur : depuis que l’API DeepSeek a introduit une tarification heures pleines / heures creuses et une facturation des appels d’outils, la vieille estimation « prix unitaire × Token » ne tient plus. Cet article propose, en 5 étapes, de recalculer le coût réel d’un appel d’application selon quatre dimensions : le créneau horaire, le type de Token, le cache et l’invocation d’outils.
Beaucoup de développeurs en sont encore à cette formule de tableau de coûts : « prix unitaire d’entrée × Tokens d’entrée + prix unitaire de sortie × Tokens de sortie ». Depuis que l’API DeepSeek a introduit la tarification heures pleines / heures creuses et la facturation des appels d’outils, cette formule a perdu deux variables : à quel créneau horaire la requête est envoyée, et combien de fois des outils ont été appelés. Pour une même application, avec une consommation de Tokens identique, le passage d’un créneau à l’autre peut faire varier la facture de manière sensible.
Ce n’est pas un article de recopie de prix. Nous n’y donnerons aucun prix unitaire non vérifié ; pour tous les prix, remises par créneau et périmètres de cache, référez-vous aux données en temps réel de la page de tarifs APIYI docs.apiyi.com/models ainsi qu’aux annonces officielles de DeepSeek. Ce que cet article traite, c’est une question de méthode : une fois la grille tarifaire en main, comment l’appliquer correctement à vos propres journaux métier.
Valeur essentielle : à la fin de cet article, vous disposerez d’un cadre réutilisable d’estimation des coûts de l’API DeepSeek, capable de déterminer quelles requêtes méritent d’être déplacées vers les heures creuses, quels appels d’outils méritent d’être rationalisés, et où récupérer des données tarifaires fiables.
L’essentiel des coûts après la tarification heures pleines/heures creuses de l’API DeepSeek
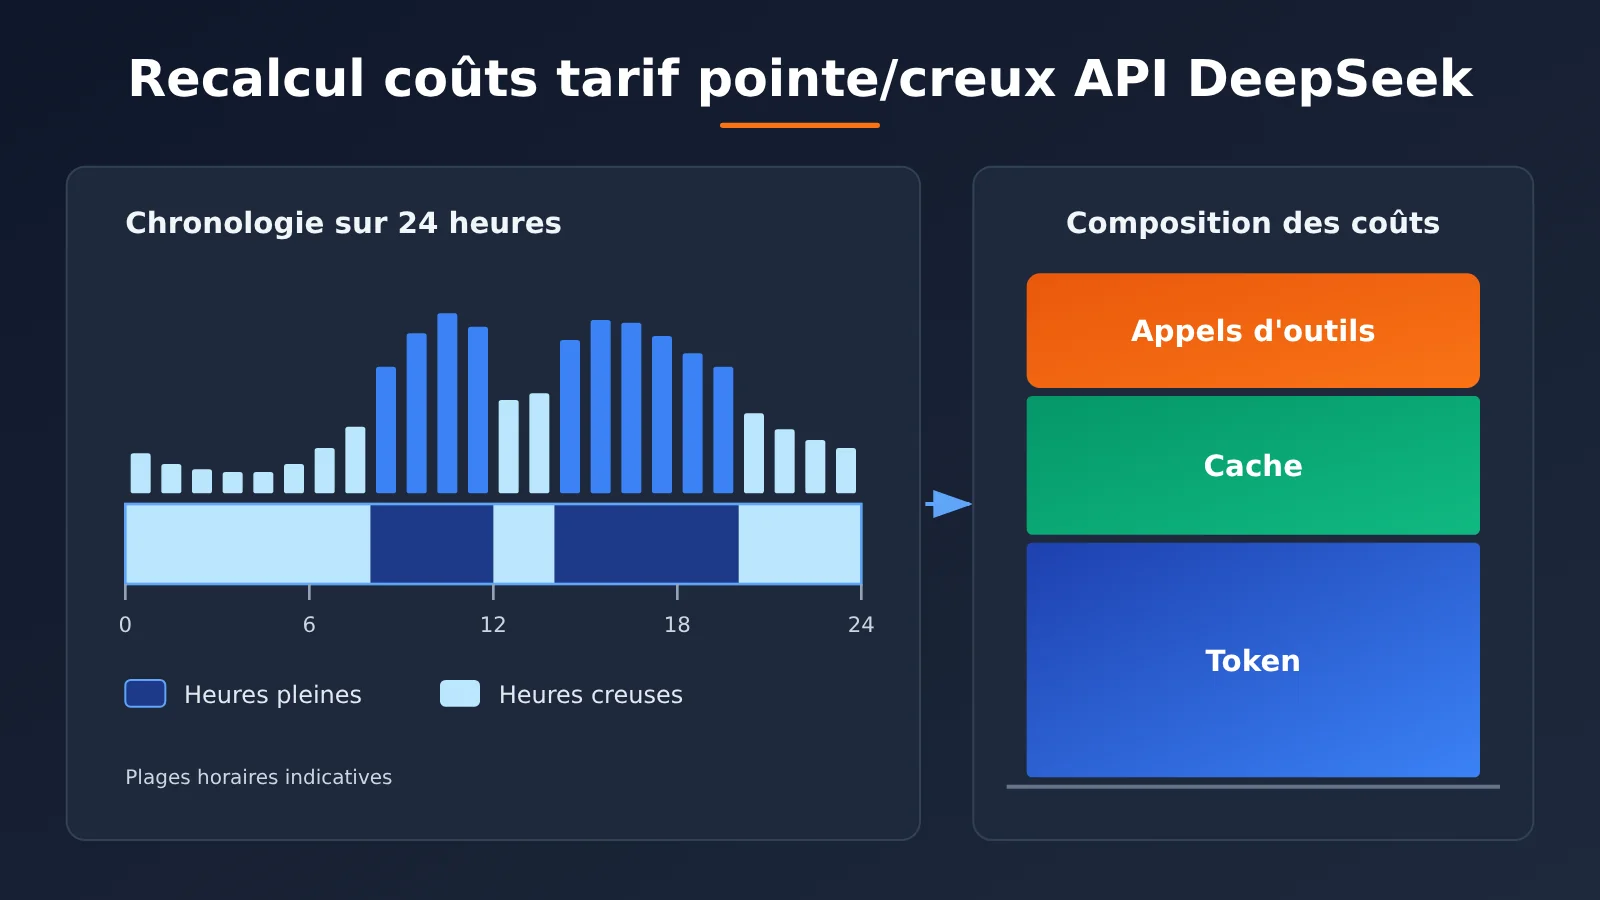
Récemment, les médias se sont nettement plus intéressés à la stratégie de commercialisation de DeepSeek (par exemple, le reportage de 36Kr « Liang Wenfeng descend de la montagne : que cherche DeepSeek ? »). L’évolution de la structure tarifaire est aussi un point de vigilance pour les développeurs. Quelle que soit la logique commerciale derrière, pour les équipes qui appellent l’API, l’impact le plus direct est que le modèle de coûts passe d’une seule dimension à plusieurs dimensions. Le tableau ci-dessous décompose la nouvelle structure de coûts.
| Dimension de coût | Description | Impact sur le calcul |
|---|---|---|
| Coefficient de période | Des tarifs différents s’appliquent aux heures pleines et aux heures creuses | Il faut répartir les statistiques par tranche horaire de la requête, et non utiliser une moyenne sur la journée |
| Tokens d’entrée (cache atteint) | Partie de l’entrée qui touche le cache de contexte | Le prix unitaire diffère de celui de la partie non touchée ; il faut les compter séparément |
| Tokens d’entrée (cache non atteint) | Entrée vue pour la première fois ou dont le cache a expiré | Les applications avec de longues invites système en représentent la plus grande part |
| Tokens de sortie | Inclut les tokens du processus de réflexion des modèles de raisonnement | Le volume de sortie des modèles de raisonnement est souvent sous-estimé |
| Frais d’appel d’outils | Utilisation d’outils facturée au nombre d’appels ou selon d’autres critères | Nouvel élément de coût indépendant, qui augmente aussi les tokens |
Les chiffres précis n’apparaissent pas dans le tableau, et c’est volontaire. La tarification de DeepSeek a été modifiée plusieurs fois ces derniers temps ; elle avait même déjà proposé une remise pour les créneaux nocturnes décalés avant de revoir sa stratégie. Si vous codez en dur dans votre modèle de coûts les chiffres vus un jour donné, ils seront erronés quelques mois plus tard. La bonne méthode est de faire du prix unitaire un « paramètre d’entrée » du modèle, lu en temps réel depuis la page des tarifs.
Détails essentiels de la facturation par période de l’API DeepSeek
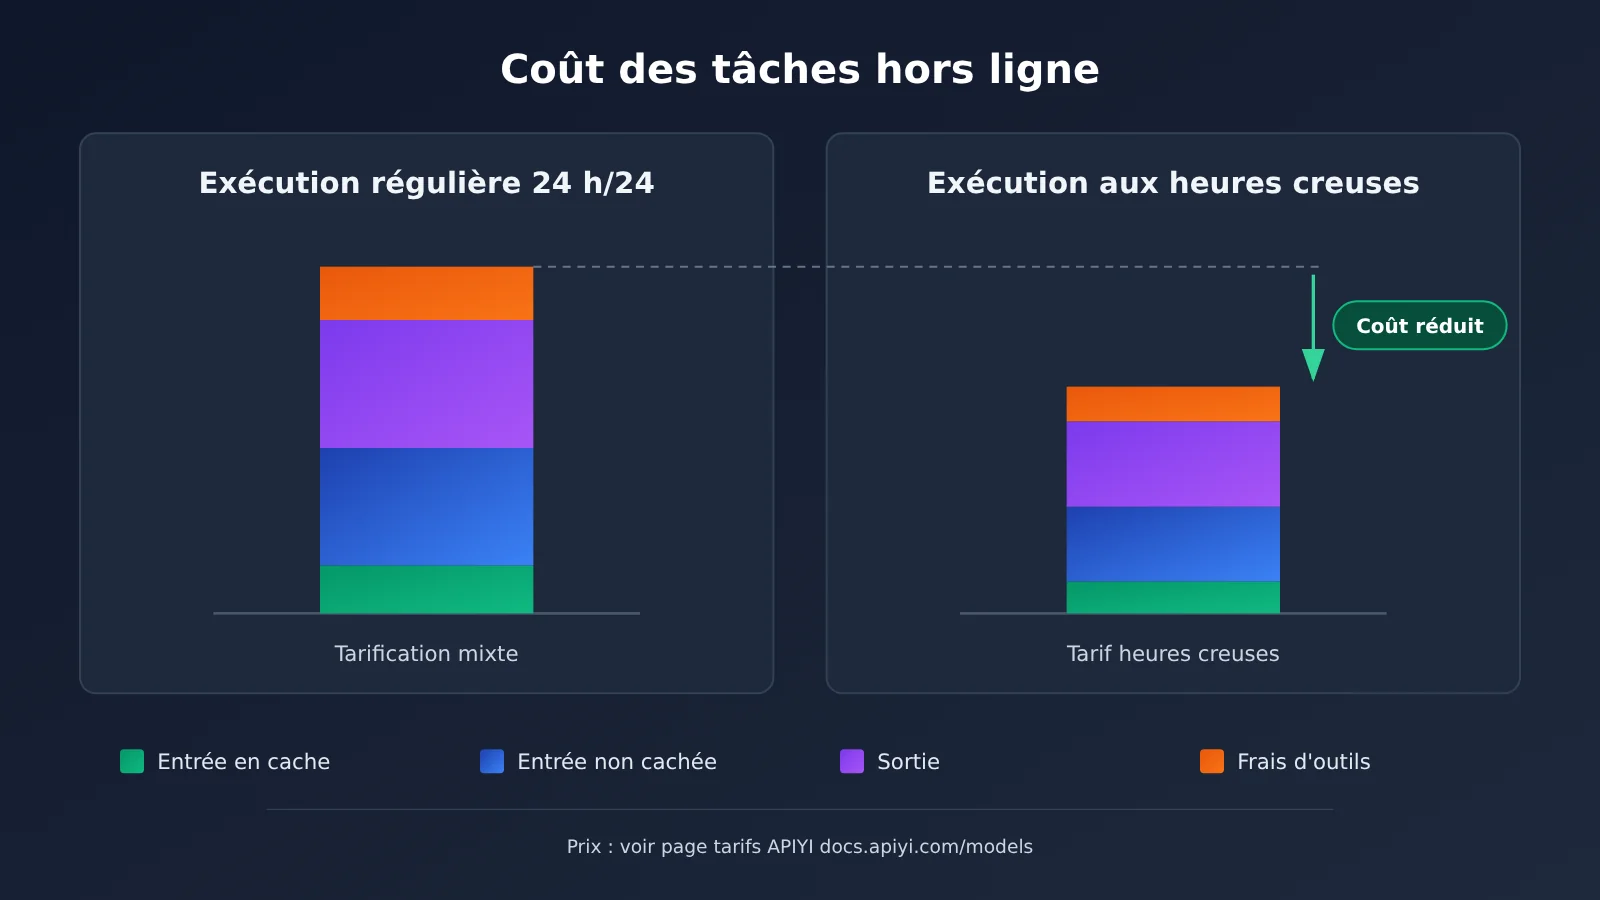
Au fond, la tarification heures pleines/heures creuses consiste à proposer des tarifs réduits sur les créneaux où la puissance de calcul est sous-utilisée, pour les tâches qui peuvent être différées. Pour les calculs, trois détails sont particulièrement sources d’erreurs. Le premier est le fuseau horaire : les périodes officielles sont généralement définies en heure de Pékin (UTC+8), alors que beaucoup de journaux de serveur enregistrent par défaut l’heure UTC. Sans conversion, on classe toute une série de requêtes dans la mauvaise tranche. Le deuxième concerne les requêtes à cheval sur deux périodes : une requête de streaming longue peut commencer en heures pleines et finir en heures creuses. Pour savoir si la facturation se fait sur l’heure de début ou de fin, il faut se référer aux règles officielles. Le troisième est la nouvelle tentative : une requête réessayée après un échec peut tomber dans une autre période ; il faut la compter à l’heure de la requête réellement réussie.
Détails essentiels de la facturation des outils de l’API DeepSeek
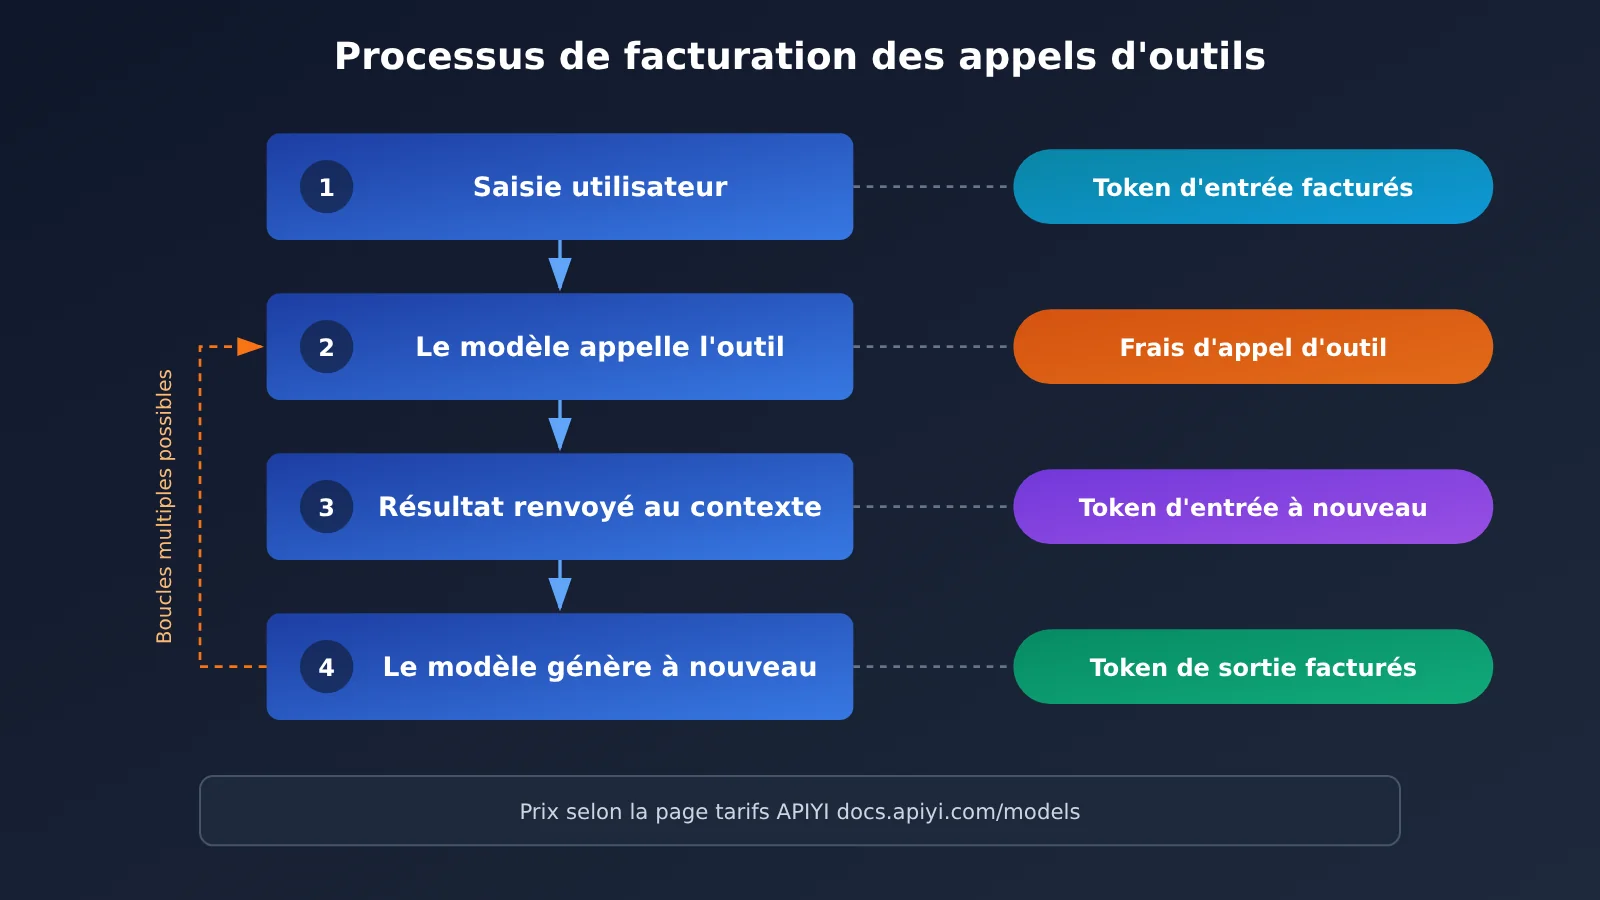
Le piège de la facturation des outils, c’est la « double facturation ». Prenons l’exemple d’un outil comme la recherche web : un appel peut certes générer des frais d’outil facturés à l’appel, mais les résultats renvoyés sont aussi injectés dans le contexte et refacturés comme tokens d’entrée au tour suivant. Si le modèle enchaîne trois ou quatre appels d’outils dans une même conversation, le coût en tokens grimpe à mesure que le contexte s’accumule. Donc, pour estimer le coût des outils, il faut compter à la fois le « nombre d’appels » et les « tokens d’entrée supplémentaires apportés par les résultats des outils » ; les deux sont indispensables.
Coût des appels à l’API DeepSeek : recalculer en 5 étapes, guide express
La procédure ci-dessous ne demande pas une seule ligne de code : un export de journaux et un tableur suffisent. Si vous disposez déjà d’une plateforme de données, il suffit de traduire ces étapes en requêtes SQL ou en rapports.
Étape 1 : préparer la table des paramètres tarifaires
Commencez par créer une « table des paramètres tarifaires » : chaque ligne correspond à une variable de facturation, et tous les prix unitaires sont relevés sur la page de tarifs, avec la date du relevé. C’est cette étape qui détermine la fiabilité de tous les calculs qui suivent.
| Nom de la variable | Signification | Source des données |
|---|---|---|
| Prix unitaire d’entrée, cache touché, heures pleines | Prix de l’entrée lorsque le cache est touché, pendant les heures pleines | Page de tarifs APIYI docs.apiyi.com/models |
| Prix unitaire d’entrée, cache non touché, heures pleines | Prix de l’entrée lorsque le cache n’est pas touché, pendant les heures pleines | Page de tarifs APIYI docs.apiyi.com/models |
| Prix unitaire de sortie, heures pleines | Prix des tokens de sortie pendant les heures pleines | Page de tarifs APIYI docs.apiyi.com/models |
| Les trois prix unitaires correspondants, heures creuses | Prix d’entrée, de cache et de sortie pendant les heures creuses | Page de tarifs APIYI et annonces officielles |
| Prix unitaire des appels d’outils | Base de facturation et prix unitaire pour chaque type d’outil | Page de tarifs APIYI et annonces officielles |
| Limites des plages horaires | Heures de début et de fin des périodes pleines et creuses, et fuseau horaire | Annonces officielles DeepSeek |
💡 Conseil sur les sources de données : pensez à mettre régulièrement à jour la table des paramètres tarifaires en la comparant à la page de tarifs APIYI docs.apiyi.com/models, et notez dans le tableau la « date de relevé ». Si les tarifs officiels changent, il suffit de modifier cette table pour que l’ensemble du modèle de coûts se mette à jour automatiquement.
Étape 2 : Exporter les journaux d’utilisation horodatés
Chaque entrée de journal de requête doit contenir au minimum les champs suivants : heure de début de la requête, nom du modèle, nombre de tokens d’entrée, dont le nombre de tokens ayant bénéficié d’un cache hit, nombre de tokens de sortie, nombre d’appels d’outils et type d’outil. Le champ usage de la réponse DeepSeek renvoie les statistiques de tokens avec et sans cache hit ; pour les modèles de raisonnement, les tokens de réflexion sont eux aussi comptés dans la sortie. Si vos journaux n’enregistrent que le total de tokens, mieux vaut compléter l’instrumentation au préalable, faute de quoi les estimations qui suivent ne seront que des approximations grossières.
Étape 3 : Répartir les requêtes par tranches horaires
Convertissez d’abord tous les horodatages en heure de Pékin, puis attribuez à chaque requête une étiquette « pic » ou « creux » selon les frontières entre heures pleines et heures creuses. Je vous conseille de subdiviser également par heure, ce qui permet de visualiser la forme d’onde du trafic métier et de disposer d’une base pour l’ordonnancement ultérieur. Bien des équipes ne s’en aperçoivent qu’à ce stade : une part non négligeable de leurs requêtes provient en réalité de tâches planifiées, qui pourraient parfaitement être déplacées vers les heures creuses.
Étape 4 : calculer séparément le coût des tokens et le coût des outils
Pour chaque tranche horaire, calculez séparément : coût des tokens = entrée avec cache hit × prix unitaire correspondant + entrée sans cache hit × prix unitaire correspondant + sortie × prix unitaire correspondant ; coût des outils = nombre d’appels par type d’outil × prix unitaire de l’outil correspondant. Il suffit ensuite d’additionner les deux tranches (heures pleines et heures creuses) pour obtenir le coût total selon la nouvelle méthode.
Prenons un exemple illustratif basé uniquement sur les volumes, sans les prix : imaginez une application de service client qui traite 10 000 requêtes par jour, avec une entrée moyenne de 3 000 tokens dont environ 60 % touchent le cache, une sortie de 500 tokens, et un outil de recherche déclenché en moyenne une fois toutes les 5 requêtes. On obtient alors chaque jour environ 12 millions de tokens d’entrée avec cache hit, environ 18 millions de tokens d’entrée sans cache hit, environ 5 millions de tokens de sortie, environ 2 000 appels d’outils, plus les tokens d’entrée supplémentaires générés par la réinjection des résultats d’outils. Répartissez ces volumes selon le ratio heures pleines / heures creuses, puis multipliez par les prix unitaires du tableau des paramètres tarifaires pour obtenir le coût journalier réel.
Étape 5 : comparer avec l’ancienne méthode pour identifier les marges d’optimisation
Comparez côte à côte le résultat de la nouvelle méthode avec l’estimation « prix moyen unique » de l’ancienne : les postes où l’écart est le plus important sont ceux à optimiser en priorité. On retrouve généralement trois conclusions types : une part trop élevée d’heures pleines, des appels d’outils trop fréquents, ou un taux de cache hit trop faible. La section suivante propose des actions concrètes pour chacune de ces trois situations.
🚀 Démarrage rapide : si vous souhaitez tester, avec la même interface, les écarts de coût entre DeepSeek et d’autres modèles, vous pouvez passer par APIYI apiyi.com. APIYI met à disposition les API des modèles DeepSeek présentés dans cet article, tout en restant compatible avec les formats d’interface OpenAI et Anthropic : votre code existant ne demande généralement qu’une modification du base_url et de la clé API pour être branché. Les adresses et paramètres précis sont disponibles dans le centre de documentation docs.apiyi.com.
Scénarios d’application et stratégie de coûts avec la tarification heures pleines/heures creuses de l’API DeepSeek
Les différents types d’applications ne réagissent pas du tout de la même manière à la tarification heures pleines/heures creuses ni aux frais liés aux outils. Mieux vaut d’abord identifier votre catégorie, puis choisir l’axe d’optimisation, plutôt que de tout basculer la nuit sans discernement.
| Type d’application | Souplesse horaire | Dépendance aux outils | Stratégie recommandée | Plateformes disponibles |
|---|---|---|---|---|
| Service client en ligne / chatbot | Faible, réponse en temps réel obligatoire | Moyenne | Améliorer le taux de réussite du cache et alléger les appels d’outils | APIYI apiyi.com, DeepSeek officiel |
| Traitement de documents par lots / annotation de données | Élevée, exécution différée possible | Faible | Tout planifier sur les heures creuses | APIYI apiyi.com, DeepSeek officiel |
| Recherche IA / assistant de recherche | Moyenne | Élevée | Limiter le nombre de tours d’appels d’outils et compresser les contenus réinjectés | APIYI apiyi.com, DeepSeek officiel |
| Agent de code | Moyenne | Élevée | Fusionner les appels d’outils et raccourcir le contexte | APIYI apiyi.com, DeepSeek officiel |
| Tâches planifiées de génération de contenu | Élevée | Moyenne | Génération par lots en heures creuses, seulement relecture en heures pleines | APIYI apiyi.com, DeepSeek officiel |
Optimisation des coûts de l’API DeepSeek pour les applications en temps réel
Les applications en temps réel ne peuvent pas éviter les heures pleines. L’accent doit donc être mis sur le cache et les outils. Placez l’invite système fixe, les résumés de base de connaissances et les exemples Few-shot au début du message, en gardant une stabilité au niveau des octets : cela améliore nettement le taux de réussite du cache. Côté outils, on peut d’abord effectuer une évaluation légère pour décider « faut-il vraiment lancer une recherche ? », afin d’éviter que le modèle appelle les outils en boucle dans des situations où ce n’est pas nécessaire.
Planification en heures creuses de l’API DeepSeek pour les applications hors ligne
Les tâches hors ligne sont les grandes gagnantes de la tarification heures pleines/heures creuses. L’idée est d’ajouter une couche de file de tâches entre le système métier et l’appel au modèle : en heures pleines, on se contente de mettre en file ; en heures creuses, des consommateurs traitent le tout. Deux points à surveiller : d’une part, la concurrence se concentre pendant les heures creuses, il faut donc évaluer à l’avance les limites de débit et, si nécessaire, limiter par lots ; d’autre part, prévoyez un délai d’expiration de secours pour les tâches, afin d’éviter que celles qui ne peuvent pas être traitées pendant les heures creuses ne débordent sur les heures pleines suivantes et soient facturées au tarif élevé.
Comparatif des solutions d’optimisation pour la facturation des outils de l’API DeepSeek
La facturation des outils est une nouveauté, et c’est aussi le poste le plus difficile à maîtriser, car sa consommation est décidée de manière autonome par le modèle. Le tableau ci-dessous compare plusieurs moyens de contrôle courants.
| Solution d’optimisation | Source d’économies | Cas d’usage | Points d’attention |
|---|---|---|---|
| Filtrage d’intention en amont | Réduit le nombre d’appels d’outils inutiles | Assistants de recherche, service client | Le filtrage consomme lui aussi des tokens ; utilisez une invite légère |
| Limiter le nombre maximal de cycles d’appel | Plafonne les frais d’outils par requête | Applications de type Agent | Trop peu de cycles peut nuire à la qualité de la réponse |
| Compresser les résultats renvoyés par les outils | Réduit les tokens d’entrée réinjectés | Outils de recherche, de récupération | Ne conserver que le résumé et les champs clés |
| Réutiliser le cache de résultats | Évite de rappeler l’outil pour une même requête | Scénarios où les questions fréquentes sont concentrées | Définir une durée d’expiration raisonnable pour éviter les informations obsolètes |
| Remplacer par une recherche interne | Utiliser sa propre base de connaissances au lieu d’un outil payant | Activités à base de connaissances métier stables | Évaluer le coût de construction et de maintenance |
Lecture comparative
Le filtrage d’intention en amont a l’effet le plus direct sur la fréquence des appels et convient à la plupart des scénarios conversationnels. En revanche, il ajoute un petit surcoût de filtrage à chaque requête, ce qui peut ne pas être rentable sur les conversations courtes. À l’inverse, la compression des résultats renvoyés par les outils n’a presque aucun effet secondaire : c’est une pratique à activer par défaut dans toute application dotée d’outils. Limiter le nombre maximal de cycles d’appel ressemble davantage à un fusible : il évite que certaines requêtes génèrent des factures anormales parce que le modèle appelle les outils de façon répétée.
💡 Conseil de choix : L’effet de l’optimisation des coûts des outils varie fortement selon l’activité. Je vous conseille de commencer par un test A/B sur un faible volume de trafic. Avec APIYI apiyi.com, vous pouvez changer de modèle dans le même format d’interface pour faire des tests comparatifs. En combinant avec les prix unitaires en temps réel de la page tarifs docs.apiyi.com/models, vous calculez plus vite le gain réel de chaque solution.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que la tarification heures pleines / heures creuses de l’API DeepSeek ?
La tarification heures pleines / heures creuses signifie qu’un même modèle applique des barèmes différents selon le créneau horaire : le prix est généralement plus bas en heures creuses, afin d’inciter les tâches différables à utiliser la puissance de calcul en décalé. Les bornes exactes des créneaux et l’ampleur de la remise sont à vérifier dans les annonces officielles de DeepSeek et sur la page tarifs d’APIYI.
Q2 : Par rapport à l’ancienne tarification unique, quelle différence dans la méthode de calcul ?
Avec une tarification unique, il suffit de faire « total de tokens × prix unitaire ». Avec la tarification par créneaux, il faut d’abord répartir les requêtes par heure, appliquer le prix de chaque créneau séparément, puis ajouter les frais d’appel d’outils. Estimer avec un prix moyen sur la journée masque le biais lié à la part d’heures pleines, surtout pour les activités dont le trafic se concentre en journée.
Q3 : Si une requête chevauche un changement de créneau, quel horaire est facturé ?
Cela dépend des règles de facturation officielles ; la convention courante est de se baser sur l’heure de début de la requête, mais il ne faut pas le supposer. Je recommande de rendre le « point de référence temporel de facturation » configurable dans le modèle de calcul, de le renseigner après confirmation de la règle officielle, et de marquer séparément les requêtes en streaming long pour les vérifier par échantillonnage.
Q4 : Pourquoi la facturation des outils fait-elle « doubler » les coûts ?
Parce qu’un appel d’outil génère souvent deux frais : le coût d’appel de l’outil lui-même, et le fait que le résultat de l’outil, réinjecté dans le contexte, est facturé une nouvelle fois comme tokens d’entrée. Sur plusieurs tours d’appels d’outils, le contexte ne cesse de s’allonger, et chaque tour suivant paie pour les résultats des tours précédents. Il faut donc maîtriser à la fois le nombre d’appels et la longueur du contenu réinjecté.
Q5 : Comment appeler rapidement DeepSeek via l’API et vérifier les coûts ?
Voici les étapes :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et obtenir une clé API
2. Consultez l’adresse d’accès dans le centre de documentation docs.apiyi.com et choisissez le format compatible OpenAI ou Anthropic
3. Consultez la page tarifs docs.apiyi.com/models pour connaître les prix d’entrée, de sortie et de cache des modèles DeepSeek concernés
4. Lancez une requête à faible volume pour dérouler les 5 étapes de calcul de cet article, puis calibrez par rapport au relevé de facturation
APIYI propose l’appel des modèles DeepSeek abordés dans cet article, avec un format d’interface compatible avec les SDK courants, ce qui facilite le remplacement et la validation directement dans vos projets existants.
Q6 : En passant par une plateforme tierce, les règles de créneaux et de facturation des outils sont-elles identiques ?
Les règles de facturation peuvent différer de celles de l’officiel selon les plateformes, par exemple sur la distinction des créneaux ou la conversion des frais d’outils. Lorsque vous passez par APIYI, fiez-vous aux données réelles indiquées sur la page tarifs docs.apiyi.com/models et n’appliquez pas directement la grille officielle : vérifier ce point avant tout calcul permet d’éviter la majorité des écarts de rapprochement.
Q7 : Quelles sont les limites connues du calcul de coût de l’API DeepSeek ?
Il y en a trois principales. Premièrement, les prix évoluent : le modèle doit permettre une mise à jour paramétrable. Deuxièmement, la longueur des tokens de réflexion des modèles de raisonnement varie fortement, et une estimation par la moyenne produit une erreur élevée : mieux vaut utiliser des quantiles. Troisièmement, le nombre d’appels d’outils est décidé par le modèle lui-même, avec des écarts marqués pour une même invite selon les entrées : il faut donc un suivi continu plutôt qu’une estimation ponctuelle.
Points clés du calcul des coûts de la tarification heures pleines / heures creuses de l’API DeepSeek
- Le coût devient multidimensionnel : plage horaire, cache, sortie et outils déterminent ensemble la facture
- Les prix unitaires doivent être paramétrés : référez-vous aux données en temps réel de la page tarifs d’APIYI, ne codez rien en dur
- Alignez d’abord les fuseaux horaires : convertissez tous les journaux en heure de Pékin avant de répartir par tranche, pour éviter de fausser tout un lot
- Les outils sont facturés deux fois : frais d’appel plus Tokens de remplissage, pensez à comptabiliser les deux
- Décalez les tâches hors ligne vers les heures creuses : lisser les pics via une file de tâches est l’optimisation la plus rentable
- Les tâches temps réel reposent sur le cache : gardez un préfixe fixe inchangé pour améliorer le taux de succès du cache
- Le calcul se vérifie rapidement : faites un petit test à faible trafic via l’interface compatible d’APIYI, puis calibrez le modèle en comparant avec la facture
En résumé
Depuis l’introduction de la tarification heures pleines / heures creuses et de la facturation des outils par l’API DeepSeek, les changements essentiels du calcul des coûts se résument en trois points :
- Du total global à la répartition par tranches : divisez les requêtes par plage horaire et appliquez le tarif adapté à chacune pour voir la vraie structure de coûts
- Des Tokens aux Tokens plus outils : les frais d’outils constituent un poste de coût à part entière, et ils font aussi grimper les Tokens d’entrée
- De l’estimation statique à la surveillance continue : les prix changent, les usages aussi ; le modèle de calcul doit être paramétré et recalibré régulièrement
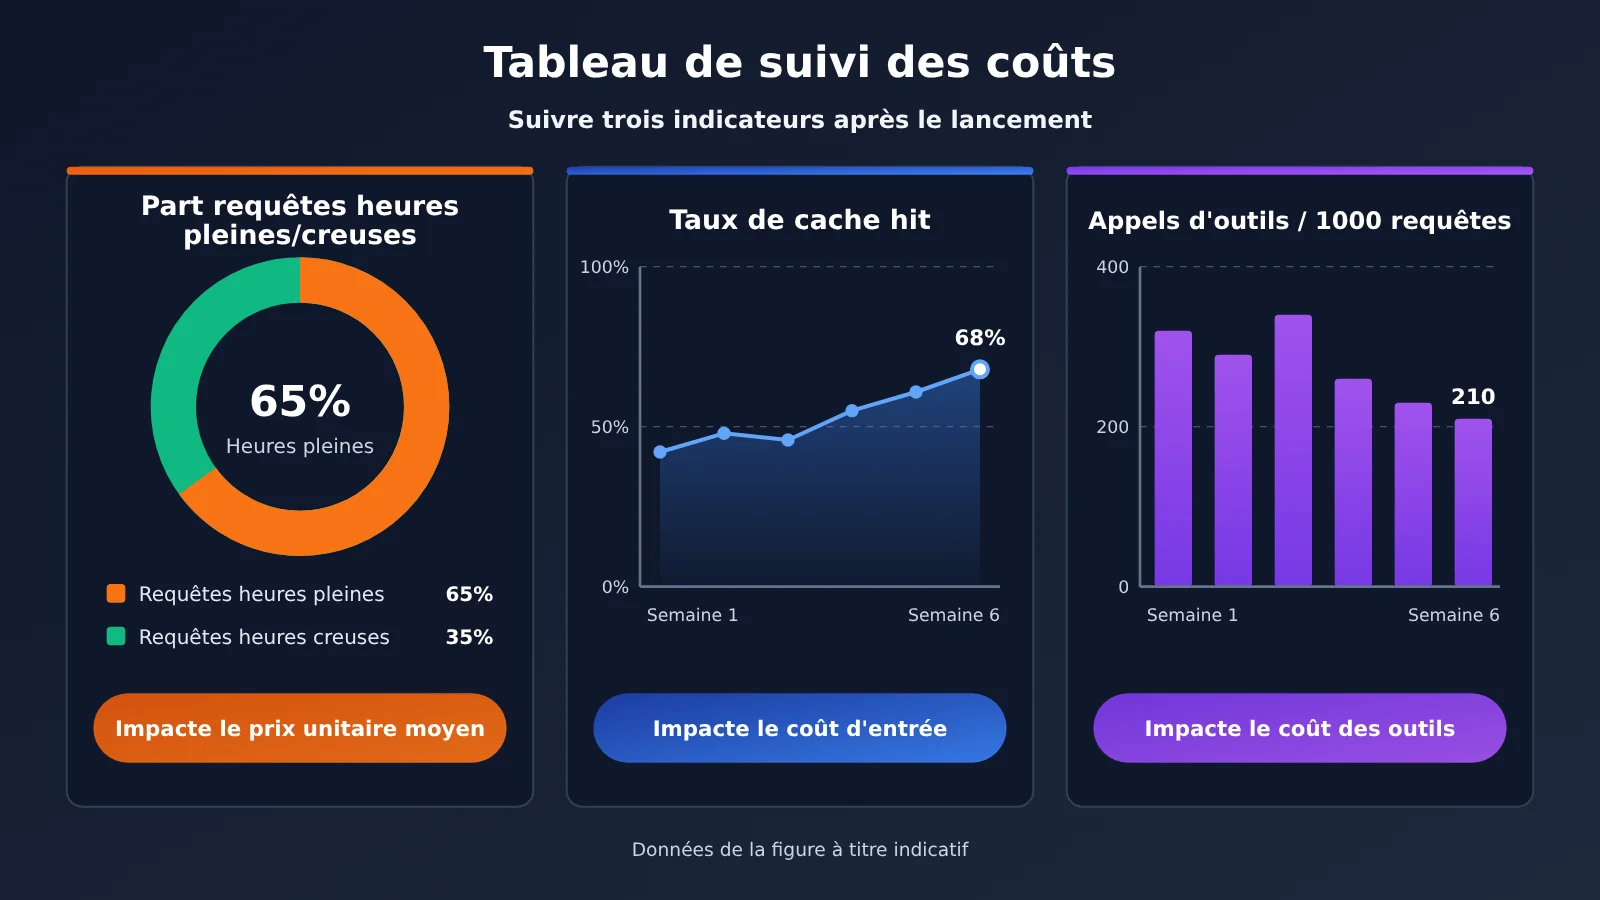
Je vous conseille de commencer par dérouler les 5 étapes de cet article sur les journaux de la semaine dernière, d’identifier trois indicateurs clés — la part des heures pleines, la fréquence d’appel des outils et le taux de succès du cache — puis d’optimiser en conséquence. Si vous souhaitez tester DeepSeek et d’autres modèles derrière une interface unifiée, vous pouvez passer par APIYI apiyi.com ; la méthode d’intégration est décrite dans le centre de documentation docs.apiyi.com. Pour tous les prix unitaires, référez-vous aux données réelles de la page tarifs docs.apiyi.com/models.
📚 Références
- Reportage de 36氪 : « Liang Wenfeng descend de la montagne, que cherche DeepSeek ? »
- Lien :
36kr.com/p/4055279154779015 -
Description : un article de presse sur les récentes orientations commerciales de DeepSeek, à consulter pour mieux comprendre le contexte de l’ajustement des prix
-
Page de tarifs APIYI : prix unitaires d’entrée, de sortie et de cache pour DeepSeek et d’autres modèles
- Lien :
docs.apiyi.com/models -
Description : source des valeurs de tous les paramètres de prix utilisés dans cet article ; pensez à les vérifier avant de faire vos calculs
-
Centre de documentation APIYI : modes d’intégration et description des formats d’interface
- Lien :
docs.apiyi.com -
Description : inclut les instructions d’intégration pour les formats compatibles OpenAI et Anthropic
-
Documentation officielle de l’API DeepSeek : règles de facturation et description du champ usage
- Lien :
api-docs.deepseek.com - Description : les limites des heures pleines et creuses, le mécanisme de cache et les modalités de facturation des outils font référence selon la documentation officielle
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez un problème lors du calcul des coûts ou de l’intégration, contactez-nous via le site officiel APIYI, apiyi.com. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com